

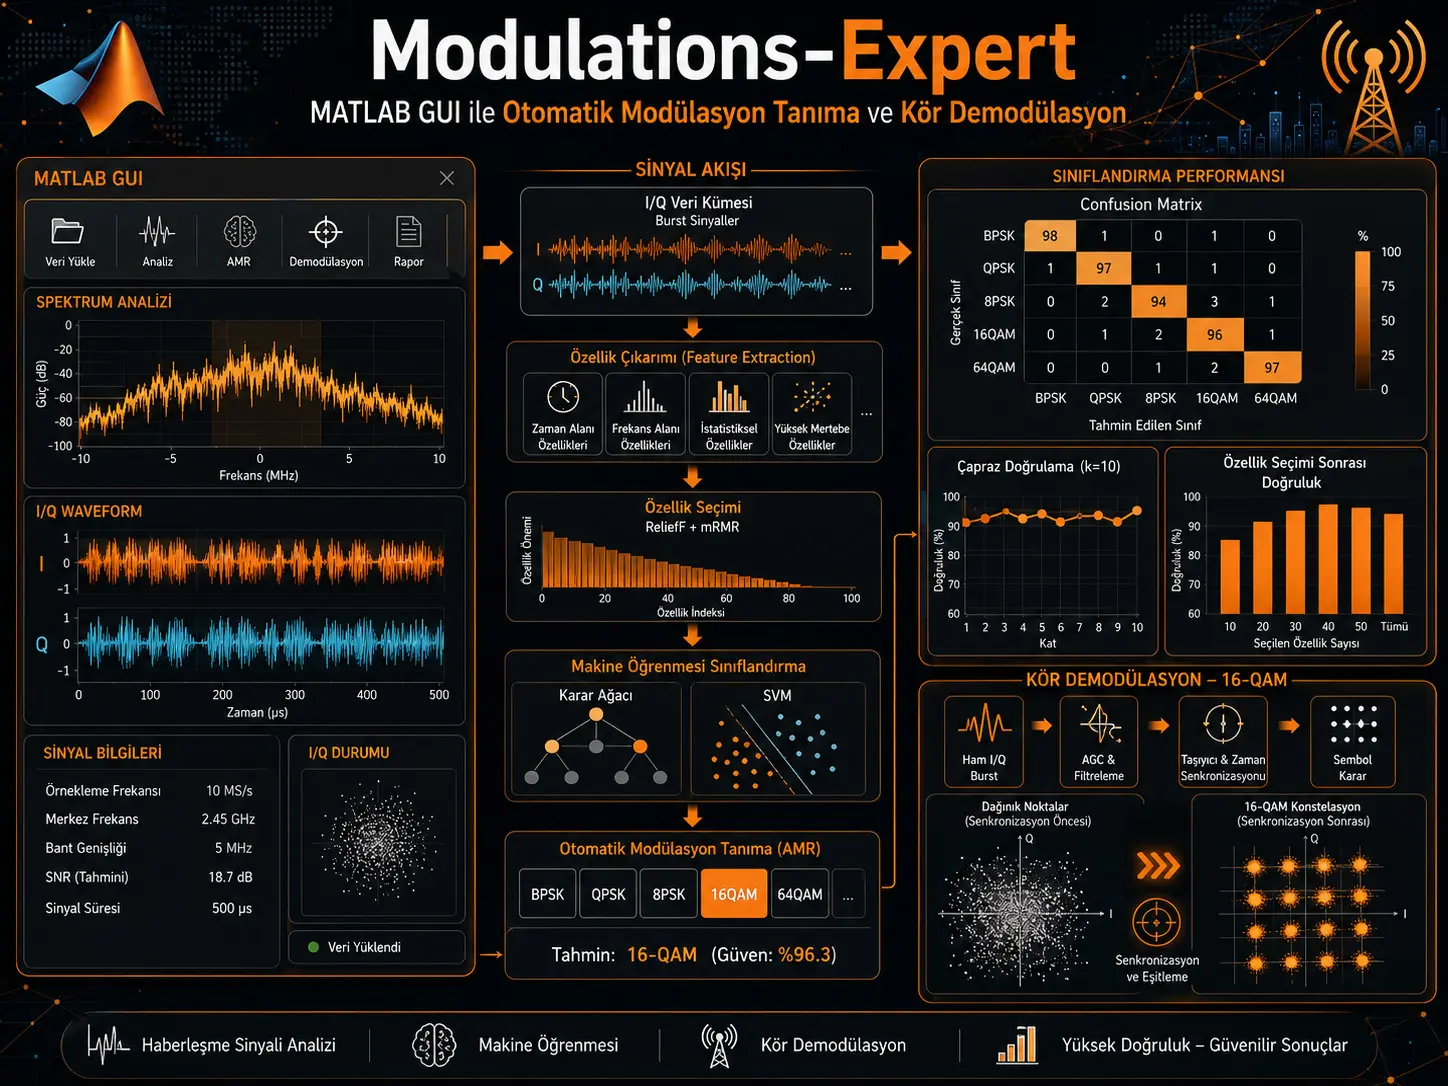
Modulations-Expert, analog ve dijital haberleşme sinyallerinin otomatik modülasyon tanınması için geliştirilmiş modüler bir MATLAB GUI araç kutusudur. Yazılım ASK, FSK, PSK, DPSK, OQPSK, QAM, MSK, GMSK, AM, DSB, USB, LSB, ISB, FM ve PM dahil çok sayıda modülasyon yapısını desteklemekte; kullanıcıya sentetik I/Q burst veri kümeleri oluşturma, dışarıdan kaydedilmiş I/Q sinyallerini içe aktarma, altı ayrı istatistiksel özellik ailesi çıkarma, farklı makine öğrenmesi sınıflandırıcılarını eğitme ve sonuçları confusion matrix, PCA, t-SNE, histogram ve box-plot gibi yöntemlerle inceleme olanağı vermektedir. Kaynak örneğinde sekiz dijital modülasyon sınıfı için 80.000 örnek ve 454 özellikten oluşan bir veri kümesi üretilmiş, karar ağacıyla %81,16 ortalama doğrulama doğruluğu elde edilmiştir. FSK–GMSK ikili problemi için embedded özellik seçimi sonrasında yedi baskın özellikle eğitilen SVM ise 5-fold cross-validation sonucunda belirli hiperparametre ayarında %100 ortalama doğruluk vermiştir. Ayrı 16-QAM deneyinde, 15 dB AWGN koşulundaki bilinmeyen sinyal %98'in üzerinde QAM olasılığıyla tanınmış; gerçek 4,1 samples/symbol değerine karşı 4,158 samples/symbol sembol süresi tahmin edilmiş ve kör demodülasyon sonunda yaklaşık 0,01 BER raporlanmıştır. Bu sonuçların, makaledeki belirli sentetik veri üretim koşulları ve örnek deneyler için geçerli olduğu unutulmamalıdır.
Otomatik modülasyon tanıma problemi nedir?
Çalışmanın ele aldığı temel problem Automatic Modulation Recognition — AMR'dır. Burada alıcı taraf, kendisine ulaşan sinyalin hangi modülasyon biçimini kullandığını önceden bilmemektedir.
Kaynak AMR'nin özellikle:
- non-cooperative communications,
- cognitive radio,
- spectrum monitoring,
- signal intelligence
uygulamalarında önemli olduğunu belirtmektedir.
Dolayısıyla problem yalnız bir sinyali görmek değildir. Alıcının bilinmeyen sinyalden yeterli bilgi çıkarıp örneğin bunun:
- ASK,
- FSK,
- GMSK,
- MSK,
- OQPSK,
- PSK,
- DPSK
- veya QAM
olduğuna karar vermesi gerekir.
Neden MATLAB GUI yaklaşımı kullanılmıştır?
Kaynağın motivasyonuna göre AMR üzerine çok sayıda makine öğrenmesi ve derin öğrenme yöntemi geliştirilmiş olsa da birçok uygulama belirli veri kümelerine veya belirli deney senaryolarına bağlıdır. Ayrıca erişilebilir grafik kullanıcı arayüzünün bulunmaması, yöntemlerin tekrarlanmasını ve farklı senaryolara uygulanmasını zorlaştırabilmektedir.
Modulations-Expert bu nedenle tek bir AMR algoritması sunmak yerine çeşitli işlemleri aynı grafik arayüz altında bir araya getirmektedir.
Kullanıcı doğrudan MATLAB kodunun her ayrıntısını yazmak zorunda kalmadan:
- sinyal oluşturabilir,
- kanal koşullarını belirleyebilir,
- dataset oluşturabilir,
- özellik çıkarabilir,
- bir sınıflandırıcı eğitebilir,
- doğrulayabilir,
- özellik seçebilir,
- bilinmeyen sinyali sınıflandırabilir,
- ve desteklenen durumlarda kör demodülasyon gerçekleştirebilir.
Yazılımın üç ana bölümü
Kaynak Modulations-Expert'in iç mimarisini üç temel çalışma alanına ayırmaktadır:
| Bölüm | Kaynakta tanımlanan görevler |
|---|---|
| Modem Section | Sinyal üretimi, modülasyon, kanal modelleme ve demodülasyon |
| Machine Learning Section | Özellik çıkarımı, dataset üretimi, classifier training, feature selection ve visualization |
| AMR Section | Bilinmeyen sinyalin otomatik modülasyon tanınması, parameter estimation ve blind demodulation |
Bu ayrım MATLAB yazılım tasarımı açısından önemlidir. Kullanıcı arayüzünde tek program görülse bile sinyal üretimi, veri mühendisliği, makine öğrenmesi ve gerçek bilinmeyen sinyal analizi mantıksal olarak ayrı modüllerde tutulmaktadır.
Verianla Live: Modulations-Expert'in uçtan uca AMR çalışma zinciri
Bu süreç kaynak makalenin yazılım mimarisi ve örnek deney bölümlerine dayanır. Kaynakta olmayan ara algoritmalar eklenmemiştir.
| Aşama | Modulations-Expert işlemi | Ortaya çıkan veri/sonuç | Kaynak |
|---|---|---|---|
| 1. Modülasyon seçimi | Analog veya dijital modülasyon ve ilgili parametreler belirlenir | İletişim sinyali modeli | Bölüm 2.2 |
| 2. Burst üretimi | Farklı SNR, modulation order, samples/symbol ve pulse-shaping koşullarında I/Q burst'ler oluşturulur | Ham I/Q burst dataset | Bölüm 2.2 ve 3.1 |
| 3. Özellik çıkarımı | Altı istatistiksel özellik ailesi uygulanır | Özellik vektörleri | Bölüm 2.2 ve Şekil 1 |
| 4. MATLAB dataset | Özellikler otomatik olarak sınıflandırma veri kümesinde düzenlenir | 80.000 × 454 örnek deney veri yapısı | Bölüm 3.1 |
| 5. Classifier training | Karar ağacı veya desteklenen başka makine öğrenmesi yöntemi eğitilir | Decision machine | Bölüm 2.2 ve 3.2 |
| 6. Model değerlendirme | Validation, testing, cross-validation ve confusion matrix analizi yapılır | Sınıflandırma performansı | Bölüm 2.2–3.3 |
| 7. Feature selection | En bilgilendirici özellikler seçilir | Azaltılmış özellik veri kümesi | Bölüm 3.3 |
| 8. Bilinmeyen sinyal | Önceden eğitilmiş decision machine sinyali sınıflandırır | Modülasyon sınıfı ve olasılık | Bölüm 3.4 |
| 9. Parameter estimation | Desteklenen sinyal parametreleri tahmin edilir | Örnekte symbol duration | Bölüm 3.4 |
| 10. Blind demodulation | Tanınan sinyal demodüle edilir | Bit dizisi / BER | Bölüm 3.4 ve Şekil 6 |
Yazılım hangi modülasyonları destekliyor?
Kaynak Modulations-Expert v2.1 için aşağıdaki analog ve dijital modülasyon ailelerini açıkça listelemektedir:
| Kaynakta listelenen modülasyonlar |
|---|
| ASK |
| FSK |
| PSK |
| DPSK |
| OQPSK |
| QAM |
| MSK |
| GMSK |
| AM |
| DSB |
| USB |
| LSB |
| ISB |
| FM |
| PM |
Kaynak, her modülasyon ailesinin bütün matematiksel formüllerini bu yazılım makalesinde açıklamamaktadır. Dolayısıyla bu Verianla yazısında kaynakta bulunmayan modülatör denklemleri eklenmemiştir.
Kullanıcı hangi sinyal parametrelerini değiştirebiliyor?
Grafik arayüz üzerinden kaynakta açıkça belirtilen ayarlanabilir değişkenler arasında:
- modulation order,
- pulse-shaping özellikleri,
- symbol rate,
- samples per symbol
bulunmaktadır.
Dataset üretimi sırasında ayrıca:
- signal-to-noise ratio — SNR,
- burst length,
- modulation order,
- pulse-shaping parameters,
- samples per symbol
değiştirilebilmektedir.
I/Q burst nedir ve bu çalışmada nasıl kullanılıyor?
Kaynak veri yapısını complex I/Q bursts olarak tanımlamaktadır. Modulations-Expert sentetik I/Q burst'leri kendi içinde oluşturabildiği gibi dışarıdan kaydedilmiş I/Q waveform dosyalarından da burst çıkarabilmektedir.
Önemli ayrım şudur:
AMR sınıflandırıcısı doğrudan yalnız modülasyon etiketiyle çalıştırılmamakta; önce ham I/Q burst'lerden istatistiksel özellikler çıkarılmaktadır.
Bu nedenle çalışma klasik feature-engineering tabanlı bir AMR örneği sunmaktadır.
Kaç farklı özellik çıkarım yöntemi bulunuyor?
Kaynak altı özellik ailesini açıkça belirtmektedir:
| No | Özellik çıkarım ailesi |
|---|---|
| 1 | Spectral-based features |
| 2 | Wavelet transform-based features |
| 3 | High-order cumulants |
| 4 | Cyclostationary features |
| 5 | High-order moments |
| 6 | Amplitude histogram features |
Bu özellikler ham burst'ten çıkarıldıktan sonra MATLAB sınıflandırma veri kümesinin sütunlarını oluşturmaktadır.
Sayfa 7'deki özellik çıkarım ekranı neden önemli?
Kaynak Şekil 1'de teorik olarak “özellik çıkarıyoruz” demekle kalmaz; özellik çıkarım fonksiyonlarının GUI üzerinden hangi parametrelerle kontrol edildiğini de gösterir.
Görselde açıkça okunabilen örnek ayarlardan bazıları şunlardır:
| GUI ayarı | Şekil 1'deki değer |
|---|---|
| Düşük genlikli örnekleri belirleme eşiği | 0,5 |
| Wavelet scales | 2:16 |
| Wavelet tabanlı özellikler için maksimum moment mertebesi | 5 |
| High-order cumulant ön işlemesinde FFT nokta sayısı | 1024 |
| Cyclostationary analysis için FFT nokta sayısı | 128 |
| Cyclostationary moving-average filtre uzunluğu | 10 |
| Amplitude histogram bin sayısı | 64 |
Bu ekran MATLAB eğitimi açısından önemli bir kavramı gösterir: özellik çıkarma yöntemi tek başına yeterli değildir; yöntemin kendi parametreleri de dataset'in yapısını değiştiren deney değişkenleridir.
Özellikler çıkarıldıktan sonra ne oluyor?
Kaynak, çıkarılan özelliklerin otomatik biçimde MATLAB dataset'lerine dönüştürüldüğünü belirtmektedir. Böylece her burst bir örnek, her çıkarılmış istatistiksel ölçüt ise sınıflandırıcıya verilen bir özellik hâline gelmektedir.
Örnek çalışmada sekiz dijital sınıf kullanılmıştır:
- ASK,
- FSK,
- GMSK,
- MSK,
- OQPSK,
- PSK,
- DPSK,
- QAM.
Dataset tam olarak nasıl oluşturuldu?
Her modülasyon türü için:
\[ 10.000\ \text{burst} \]
üretilmiştir.
Her burst:
\[ 4096\ \text{sample} \]
uzunluğundadır.
Sekiz sınıf olduğuna göre kaynak toplam veri kümesini doğrudan:
\[ 80.000\ \text{sample} \]
olarak raporlamaktadır.
Altı özellik çıkarım yönteminin birlikte uygulanmasının ardından her örnek:
\[ 454\ \text{istatistiksel özellik} \]
ile temsil edilmiştir.
| Örnek deney veri yapısı | Kaynak değeri |
|---|---|
| Sınıf sayısı | 8 |
| Her sınıftaki burst | 10.000 |
| Toplam örnek | 80.000 |
| Her burst uzunluğu | 4096 sample |
| Her örneğin özellik sayısı | 454 |
| Özellik çıkarım ailesi | 6 |
Dataset yalnız tek bir koşul altında mı üretildi?
Hayır. Kaynak, burst'lerin değişken:
- SNR,
- modulation order,
- samples per symbol,
- pulse-shaping roll-off factor
koşullarında üretildiğini belirtmektedir.
Bu ayrım önemlidir; çünkü sınıflandırıcıya bütün örneklerin aynı ideal parametreden gelmesi yerine farklı sinyal koşulları gösterilmektedir.
Hangi makine öğrenmesi algoritmaları destekleniyor?
Kaynak Modulations-Expert için şu sınıflandırıcıları açıkça listelemektedir:
| Desteklenen sınıflandırıcı |
|---|
| Decision trees |
| Support vector machines |
| Random forests |
| Ensemble k-nearest neighbors |
| Naïve Bayes classifiers |
| Linear discriminant analysis |
| Neural networks |
Kullanıcı GUI üzerinden modelleri yalnız eğitmekle kalmayıp:
- train,
- validate,
- test,
- cross-validate
işlemlerini de gerçekleştirebilmektedir.
Başka hangi makine öğrenmesi işlemleri bulunuyor?
Kaynak yazılımın ayrıca şu yeteneklere sahip olduğunu belirtmektedir:
- feature selection,
- dimensionality reduction,
- dataset scaling,
- weighting strategies,
- confusion matrix analysis,
- PCA visualization,
- t-SNE visualization,
- histograms,
- box plots.
İlk sınıflandırma deneyi: karar ağacı
80.000 örnek ve 454 özellikten oluşan veri kümesi kullanılarak GUI içindeki Train Decision Machine seçeneğiyle bir karar ağacı eğitilmiştir.
Kaynak tarafından raporlanan ortalama validation accuracy:
[ 81.16% ]
değeridir.
Confusion matrix neden tek doğruluk sayısından daha öğreticidir?
%81,16 ortalama doğruluk bize modelin genel başarısını söyler; fakat hangi sınıfların birbirine karıştırıldığını göstermez.
Kaynağın sayfa 8 / Şekil 2'deki confusion matrix'i bunu ayrıntılı biçimde göstermektedir.
| Gerçek ↓ / Tahmin → | ASK | DPSK | FSK | GMSK | MSK | OQPSK | PSK | QAM |
|---|---|---|---|---|---|---|---|---|
| ASK | 99,75 | 0 | 0 | 0 | 0 | 0 | 0 | 0,25 |
| DPSK | 0 | 52,15 | 0,45 | 0 | 0 | 0,75 | 46,20 | 0,45 |
| FSK | 0 | 0 | 95,30 | 0,50 | 3,70 | 0,50 | 0 | 0 |
| GMSK | 0 | 0 | 1,85 | 73,15 | 24,40 | 0,60 | 0 | 0 |
| MSK | 0 | 0 | 3,75 | 11,50 | 84,25 | 0,50 | 0 | 0 |
| OQPSK | 0 | 0,85 | 0,95 | 0,50 | 0,15 | 97,55 | 0 | 0 |
| PSK | 0 | 50,35 | 0,15 | 0 | 0 | 0,25 | 48,45 | 0,80 |
| QAM | 0,35 | 0,05 | 0 | 0 | 0 | 0 | 0,90 | 98,70 |
Değerler yüzde olarak kaynak Şekil 2'den aktarılmıştır.
Confusion matrix'in bize söylediği en önemli şey nedir?
ASK, FSK, OQPSK ve QAM sınıfları bu örnekte oldukça yüksek doğru sınıflandırma oranlarına sahiptir:
| Sınıf | Doğru sınıflandırma (%) |
|---|---|
| ASK | 99,75 |
| FSK | 95,30 |
| OQPSK | 97,55 |
| QAM | 98,70 |
Buna karşılık PSK ve DPSK ciddi biçimde birbirine karışmaktadır:
- DPSK örneklerinin %46,20'si PSK olarak sınıflandırılmıştır.
- PSK örneklerinin %50,35'i DPSK olarak sınıflandırılmıştır.
- DPSK'nin kendi sınıfında doğru oranı %52,15'tir.
- PSK'nin kendi sınıfında doğru oranı %48,45'tir.
Kaynak metni bu durumu PSK ve DPSK'nin signal space benzerliğiyle ilişkilendirmektedir. Burada confusion matrix'i görmek, yalnız %81,16 genel doğruluğu okumaktan çok daha bilgilendiricidir.
Feature selection neden yapılmıştır?
454 özelliğin tamamı her sınıflandırma problemi için aynı düzeyde bilgi taşımak zorunda değildir. Çalışma bu durumu göstermek için genel sekiz sınıflı problemi bırakıp yalnız FSK ve GMSK sınıflarından oluşan bir sub-dataset üretmektedir.
Ardından embedded feature-selection yöntemi uygulanmaktadır.
Sayfa 9'daki feature-selection penceresinde ne görüyoruz?
Kaynağın Şekil 3'ünde karar ağacında anlamlı katkı gösteren 12 özellik listelenmiştir.
Metne göre bunların içinden yedi baskın özellik seçilerek azaltılmış bir veri kümesi oluşturulmuştur.
Bu, MATLAB/makine öğrenmesi eğitiminde önemli bir ayrımı gösterir:
“Modelde 454 özellik var” ile “model karar vermek için 454 özelliğin tamamına gerçekten ihtiyaç duyuyor” aynı şey değildir.
Azaltılmış özelliklerle hangi model kullanıldı?
Yedi baskın özellik kullanılarak bir SVM eğitilmiş ve kaynak bu azaltılmış FSK–GMSK problemi için:
\[ 100%\ \text{validation accuracy} \]
raporlamıştır.
Ancak çalışmada bununla yetinilmemiş ve ayrıca 5-fold cross-validation yapılmıştır.
Cross-validation neden ayrı yapılmıştır?
Kaynak, Cross-Validation of Decision Machine menüsünü kullanarak modelin farklı veri bölünmelerinde tekrar test edildiğini belirtmektedir.
Beş katlı doğrulamada GUI kullanıcısına çalışma durumunu göstermek için bir progress bar da sunmaktadır.
Kaynakta optimum olarak bildirilen SVM ayarları:
| SVM parametresi | En iyi kaynak değeri |
|---|---|
| Box constraint | 1,5 |
| Scaling kernel | 1 |
| 5-fold ortalama doğruluk | %100 |
şeklindedir.
Sayfa 10'daki 3B MATLAB grafiğini nasıl okumalıyız?
Şekil 4'te iki SVM parametresi yatay eksenler boyunca değiştirilmekte, dikey eksende ise Average Weighted Accuracy gösterilmektedir.
Grafiğin üzerinde işaretlenen optimum noktada:
- X = 1,5,
- Y = 1,
- Z = 100
görülmektedir.
Bu şekil, MATLAB'ın yalnız sınıflandırma yapmak için değil, model hiperparametrelerinin performans yüzeyini üç boyutlu olarak görselleştirmek için de kullanılabileceğini göstermektedir.
En önemli FSK–GMSK özelliği hangisi?
Kaynak bu ikili ayrım için en önemli özelliği açıkça:
WTn_med_M_1_T_5
olarak raporlamaktadır.
Şekil 5'te bu özelliğin FSK ve GMSK sınıflarındaki dağılımları ayrı box-plot'larla gösterilmektedir.
Sayfa 11'deki box-plot bize ne anlatıyor?
Grafik, söz konusu özelliğin iki sınıf için aynı dağılıma sahip olmadığını görsel olarak göstermektedir. FSK grubunun kutu ve medyan bölgesi GMSK grubundan daha yüksek konumdadır.
Kaynak bu özelliği FSK–GMSK ayrımındaki en önemli özellik olarak tanımlamaktadır.
Burada verilmesi gereken MATLAB dersi şudur:
Feature importance yalnız bir sıralama tablosu olarak bırakılmamalı; mümkünse seçilen özelliğin sınıflar arasındaki dağılımı da görselleştirilmelidir.
Genel karar ağacı ile FSK–GMSK SVM sonucu neden karşılaştırılmamalıdır?
Çünkü iki deney aynı sınıflandırma problemini çözmemektedir.
| Deney | Sınıf yapısı | Özellik yapısı | Kaynak sonucu |
|---|---|---|---|
| Decision tree | 8 modülasyon | 454 özellik | %81,16 ortalama validation accuracy |
| SVM | Yalnız FSK ve GMSK | Seçilmiş 7 baskın özellik | %100 validation ve 5-fold ortalama accuracy |
Dolayısıyla “SVM %100 olduğu için bütün AMR problemini kusursuz çözüyor” sonucu kaynak tarafından desteklenmemektedir.
Blind modulation recognition nasıl test edilmiştir?
Çalışmanın son örneğinde önce:
\[ 10.000\ \text{bit} \]
uzunluğunda rastgele binary stream oluşturulmuştur.
Bu bitler:
16-QAM
ile modüle edilmiştir.
Sinyal daha sonra:
- AWGN channel,
- SNR = 15 dB,
- one-sample delay
koşullarından geçirilmiştir.
AMR modülü bu sinyali nasıl işledi?
Bilinmeyen sinyal, daha önce sekiz sınıf üzerinde eğitilmiş decision-tree classifier kullanılarak değerlendirilmiştir.
AMR bölümünde:
\[ 4096\ \text{sample} \]
uzunluğunda, overlap kullanılmayan burst'ler üzerinden değerlendirme yapılmıştır.
Yazılım sinyalin QAM olduğunu:
[ > 98% > ]
olasılıkla doğru tanımıştır.
Tanımadan sonra neden parameter estimation gerekiyor?
Bir sinyalin “QAM” olduğunu bilmek, onu doğrudan doğru bitlere dönüştürmek için gerekli bütün alıcı parametrelerinin bilindiği anlamına gelmez.
Çalışmada AMR sonrasında ayrı parameter-estimation modülü devreye girmektedir.
Örnekte gerçek symbol duration:
\[ 4.1\ \text{samples/symbol} \]
iken araç:
\[ 4.158\ \text{samples/symbol} \]
tahmin etmiştir.
Kaynak bu iki değeri açıkça vermektedir; Verianla tarafından ek hata yüzdesi üretilmemiştir.
Blind demodulation aşamasının sonucu nedir?
Parametre tahmininin ardından kör demodülasyon uygulanmış ve kaynak yaklaşık:
\[ BER\approx0.01 \]
raporlamıştır.
Bu değer, söz konusu 16-QAM örneği ve belirtilen 15 dB AWGN / bir örnek gecikme koşulları içindir.
Verianla Live: 16-QAM bilinmeyen sinyalden bitlere giden örnek akış
| Aşama | Kaynakta kullanılan değer / işlem | Sonuç |
|---|---|---|
| Kaynak bitler | 10.000 rastgele binary bit | Dijital veri |
| Modülasyon | 16-QAM | Modüle I/Q sinyali |
| Kanal | AWGN, 15 dB SNR, 1-sample delay | Bozulmuş bilinmeyen sinyal |
| Burst analizi | 4096 sample, overlap yok | AMR girişleri |
| Modülasyon tanıma | Önceden eğitilmiş decision tree | QAM, >%98 olasılık |
| Parameter estimation | Gerçek: 4,1 samples/symbol | Tahmin: 4,158 samples/symbol |
| Blind demodulation | Alıcı senkronizasyon ve demodülasyon zinciri | BER ≈ 0,01 |
Sayfa 12'deki dört takımyıldız grafiği ne gösteriyor?
Kaynağın son görseli blind demodulation işlemini tek nihai sonuç olarak değil, dört ara aşama üzerinden göstermektedir:
- Matched Filter Output: 2 Samples/Symbol
- Symbol Synchronization
- Coarse Carrier Synchronization
- Fine Carrier Synchronization
İlk panelde örnekler oldukça yayılmış bir bulut görünümündedir. Symbol synchronization sonrasında yapı değişir; coarse carrier synchronization aşamasında QAM takımyıldızının kümelenmeleri görünür hâle gelir; fine carrier synchronization panelinde kümeler daha düzenli konumlara yerleşir.
Bu görsel MATLAB öğrenimi açısından önemli bir noktayı ortaya koymaktadır:
Bir demodülatörün yalnız nihai BER değerini görmek yerine ara sinyal işleme aşamalarını görselleştirmek, sistemde hangi düzeltmenin ne zaman gerçekleştiğini anlamayı kolaylaştırır.
Blind demodulation neden “blind” olarak adlandırılıyor?
Kaynak bu çalışma bağlamında sistemi, bilinmeyen modülasyon sinyalinin önce AMR ile tanınması, ardından parametrelerin tahmin edilmesi ve son olarak demodülasyon yapılması biçiminde düzenlemektedir.
Dolayısıyla kullanıcı verici tarafından kullanılan bütün parametreleri baştan programa vermek yerine sinyal analizi ve parameter estimation aşamalarından yararlanmaktadır.
Yazılım eğitim açısından neden önemli olabilir?
Kaynak doğrudan Modulations-Expert'in dijital iletişim ve makine öğrenmesi derslerinde eğitim amacıyla kullanılabileceğini belirtmektedir.
Bunun nedeni, normalde birbirinden ayrı öğretilen birçok konunun aynı deney zincirinde görülmesidir:
- haberleşme sinyali üretimi,
- kanal etkisi,
- I/Q veri yapısı,
- feature engineering,
- dataset hazırlama,
- classification,
- cross-validation,
- feature importance,
- confusion matrix,
- parameter estimation,
- demodulation,
- BER.
Bu çalışma MATLAB öğrenen birine hangi çalışma disiplinini gösteriyor?
Bu kaynakta MATLAB bir sonuç hesaplayıcısı değil, uçtan uca deney platformu hâline gelmektedir.
Öğretici olarak takip edilebilecek çalışma mantığı şudur:
- Problemi tanımla: hangi modülasyonları ayırmak istiyoruz?
- Veriyi oluştur: kaç burst, kaç sample, hangi SNR aralığı?
- Özellik çıkar: hangi feature family kullanılacak?
- Dataset'i oluştur: satırlar örnek, sütunlar özellik olacak şekilde düzenle.
- Model eğit: decision tree, SVM veya desteklenen başka classifier.
- Validation yap: yalnız training accuracy'ye bakma.
- Confusion matrix'i incele: model hangi sınıfları birbirine karıştırıyor?
- Feature selection yap: gerçekten gerekli özellikleri bul.
- Cross-validation yap: belirli bir veri bölünmesine aşırı bağımlı sonucu kontrol et.
- Özellikleri görselleştir: modelin kullandığı ayrımı anlamaya çalış.
- Bilinmeyen sinyali dene: eğitim veri kümesinden sonraki gerçek kullanım adımına geç.
- Parametreleri tahmin et.
- Blind demodulation uygula.
- BER ile nihai iletişim başarısını ölç.
Bu sıralama kaynak makalenin örnek çalışma düzeninden çıkarılan öğretici bir organizasyondur; yeni bir AMR algoritması olarak sunulmamaktadır.
Çalışmanın desteklediği sonuçlar
- Modulations-Expert v2.1, MATLAB tabanlı grafik arayüz altında AMR ve blind demodulation işlemlerini birleştirmektedir.
- Analog ve dijital çok sayıda modülasyon türünü desteklemektedir.
- Sentetik complex I/Q burst dataset oluşturabilir ve dış I/Q dosyalarından burst çıkarabilir.
- Altı ayrı feature-extraction ailesi bulunmaktadır.
- Birden fazla klasik machine-learning classifier desteklenmektedir.
- GUI üzerinden training, validation, testing ve cross-validation gerçekleştirilebilir.
- Feature selection, dimensionality reduction, scaling ve visualization araçları bulunmaktadır.
- Örnek sekiz sınıflı dataset 80.000 örnek ve 454 özellikten oluşmaktadır.
- Karar ağacı örneği %81,16 ortalama validation accuracy üretmiştir.
- FSK–GMSK alt probleminde yedi seçili özellikle SVM %100 doğruluk üretmiştir.
- 5-fold cross-validation'da belirtilen SVM ayarlarıyla %100 ortalama accuracy raporlanmıştır.
- 16-QAM örneği %98'in üzerinde QAM olasılığıyla tanınmıştır.
- 4,1 samples/symbol gerçek değere karşı 4,158 samples/symbol tahmin edilmiştir.
- Kör demodülasyon örneğinde yaklaşık 0,01 BER elde edilmiştir.
Çalışmanın desteklemediği veya göstermediği sonuçlar
- %100 SVM sonucu bütün modülasyonların genel sınıflandırma doğruluğu değildir.
- Kaynak bütün gerçek RF ortamlarında %81,16 veya %100 doğruluk garanti etmemektedir.
- Örnek veri seti sentetik olarak üretilmiştir; bütün sonuçlar bağımsız geniş saha RF kayıtları üzerinde doğrulanmış değildir.
- Deep learning yöntemleri mevcut örneklerin ana doğrulama sistemi değildir; kaynak bunların gelecekte modüler mimariye eklenebileceğini belirtmektedir.
- Kaynak bütün desteklenen analog ve dijital modülasyonlar için ayrı performans benchmark'ı vermemektedir.
- Kör demodülasyon sonucu tüm modülasyon tipleri için aynı BER performansını kanıtlamamaktadır.
- PSK ve DPSK için karar ağacı örneğindeki yüksek karışma çözülmüş değildir.
- Yazılımın Windows dışındaki işletim sistemleri için destek durumu kaynakta belirtilmemektedir; gereksinim alanı Windows için verilmiştir.
- Makalede tam çalıştırma zamanı veya CPU/GPU performans benchmark'ı bulunmamaktadır.
- 80.000 örneklik deney veri kümesinin ayrı kalıcı veri deposu kaynakta verilmemiştir.
Türkiye açısından neden ilginç olabilir?
Çalışma İran'daki University of Tehran kaynaklıdır ve Türkiye'ye özgü bir haberleşme sistemi üzerinde test edilmemiştir. Bununla birlikte AMR; akademik haberleşme araştırmaları, spektrum izleme, bilişsel radyo ve sinyal analizi açısından ülkeye özgü olmayan genel bir mühendislik problemidir.
Türkiye'deki bir araştırma veya eğitim uygulamasında aynı yazılım kullanılacaksa yerel RF kayıtları, kanal koşulları, gerçek donanımdan alınan I/Q verileri ve hedeflenen modülasyon sınıfları ayrıca test edilmelidir. Kaynaktaki sentetik deney performansının yerel gerçek RF ortamına doğrudan taşındığı varsayılmamalıdır.
Çalışmanın Yöntemi ve Bulguları
Deney 1 — sekiz sınıflı AMR veri setinin oluşturulması
Çalışmanın temel deneyinde aşağıdaki dijital modülasyon sınıfları kullanılmıştır:
| Sınıf no | Modülasyon | Burst sayısı |
|---|---|---|
| 1 | ASK | 10.000 |
| 2 | FSK | 10.000 |
| 3 | GMSK | 10.000 |
| 4 | MSK | 10.000 |
| 5 | OQPSK | 10.000 |
| 6 | PSK | 10.000 |
| 7 | DPSK | 10.000 |
| 8 | QAM | 10.000 |
Her burst 4096 örnek uzunluğundadır. SNR, modulation order, samples per symbol ve pulse-shaping roll-off factor değiştirilmektedir.
Deney 2 — altı feature-extraction ailesinin birlikte kullanılması
Bütün burst'lere:
- spectral-based,
- wavelet transform-based,
- high-order cumulant,
- cyclostationary,
- high-order moment,
- amplitude histogram
özellikleri uygulanmıştır.
Sonuç:
| Dataset ölçütü | Değer |
|---|---|
| Örnek sayısı | 80.000 |
| İstatistiksel özellik sayısı | 454 |
Deney 3 — sekiz sınıflı decision-tree classifier
Kaynak modeli Train Decision Machine seçeneğiyle eğitmektedir.
Raporlanan ortalama validation accuracy:
[ 81.16%. ]
Confusion matrix, performansın sınıflar arasında homojen olmadığını göstermektedir.
Verianla Live: Genel karar ağacı ve özel FSK–GMSK SVM deneyinin ayrımı
| Deney | Sınıf sayısı | Özellik sayısı | Raporlanan doğruluk (%) |
|---|---|---|---|
| Genel karar ağacı | 8 | 454 | 81,16 |
| FSK–GMSK SVM | 2 | 7 seçili baskın özellik | 100 |
İki performans aynı görev için değildir. %100 değer yalnız FSK–GMSK ikili alt problemine aittir.
Deney 4 — FSK ve GMSK için feature selection
Önce yalnız FSK ve GMSK sınıflarını içeren sub-dataset oluşturulmuştur.
Embedded feature-selection sonucunda:
- karar ağacına anlamlı katkısı bulunan 12 özellik görüntülenmiş,
- bunların içinden yedi baskın özellik seçilmiştir.
En önemli özellik:
WTn_med_M_1_T_5
olarak raporlanmıştır.
Deney 5 — SVM ve beş katlı çapraz doğrulama
Yedi özellikli azaltılmış dataset üzerinde SVM eğitilmiş ve %100 validation accuracy elde edilmiştir.
Daha sonra 5-fold cross-validation uygulanmıştır.
| Parametre / sonuç | En iyi kaynak ayarı |
|---|---|
| Box constraint | 1,5 |
| Kernel scaling | 1 |
| Average accuracy | %100 |
Deney 6 — 16-QAM AMR ve blind demodulation
| Deney değişkeni | Kaynak değeri |
|---|---|
| Binary stream | 10.000 bit |
| Modülasyon | 16-QAM |
| Kanal | AWGN |
| SNR | 15 dB |
| Gecikme | 1 sample |
| AMR burst uzunluğu | 4096 sample |
| Burst overlap | Yok |
| QAM tanıma olasılığı | >%98 |
| Gerçek symbol duration | 4,1 samples/symbol |
| Tahmin edilen symbol duration | 4,158 samples/symbol |
| Blind demodulation BER | ≈0,01 |
Blind-demodulation görselindeki dört işlem aşaması
Kaynağın Şekil 6'sında tek bir nihai QAM takımyıldızı yerine ardışık dört aşama verilmiştir:
| Aşama | Şekil 6'daki başlık |
|---|---|
| 1 | Matched Filter Output: 2 Samples/Symbol |
| 2 | Symbol Synchronization |
| 3 | Coarse Carrier Synchronization |
| 4 | Fine Carrier Synchronization |
Bu görsel, kör demodülasyonun yalnız “QAM olduğunu bul ve bitleri çıkar” şeklinde tek aşamalı bir işlem olmadığını; sinyalin alıcı tarafında kademeli olarak düzenlendiğini kaynak örnek üzerinden görünür kılmaktadır.
Sonuçların bilimsel anlamı
Makale, Modulations-Expert'in tek bir makine öğrenmesi algoritmasında yüksek doğruluk elde etmesinden daha geniş bir katkı iddia etmektedir. Asıl katkı, AMR araştırmalarındaki birbirine bağlı deney aşamalarının aynı MATLAB GUI ortamında tekrar kullanılabilir şekilde birleştirilmesidir.
Özellikle kaynak örneği şu gerçeği açık biçimde göstermektedir:
İyi bir AMR çalışması yalnız classifier accuracy sayısından oluşmaz.
Dataset'in nasıl üretildiği, burst uzunluğu, kanal/SNR koşulları, çıkarılan özellikler, sınıfların confusion matrix içindeki davranışı, feature selection, cross-validation, bilinmeyen sinyal testi ve nihai demodülasyon performansı birlikte incelenmelidir.
Yöntemsel sınırlılıklar
- Örnek ana veri kümesi sentetik olarak oluşturulmuştur.
- Genel sekiz sınıflı classifier performansı %81,16'dır ve PSK–DPSK ayrımı belirgin biçimde zayıftır.
- %100 sonuç yalnız iki sınıflı FSK–GMSK deneyine aittir.
- Makale bütün desteklenen modulation schemes için ayrı benchmark vermemektedir.
- Blind-demodulation örneği 16-QAM ve belirtilen kanal koşullarına aittir.
- Derin öğrenme yöntemleri gelecekte eklenebilecek yapı olarak belirtilmekte, mevcut örneklerin temel sistemi değildir.
- Makale geniş kapsamlı gerçek saha RF dataset karşılaştırması sunmamaktadır.
- Kaynakta hesaplama süresi, bellek gereksinimi veya donanım ölçeklenmesi benchmark'ı verilmemiştir.
- Yazılım gereksinimi 64-bit MATLAB R2015b+ for Windows şeklinde verilmiştir; diğer işletim sistemleri için kaynakta doğrulanmış uyumluluk iddiası bulunmamaktadır.
MATLAB eğitimi açısından çıkarılabilecek en önemli çalışma prensibi
Bu araştırma, MATLAB'da makine öğrenmesini yalnız:
model = fit(...)
benzeri tek bir eğitim çağrısına indirgememek gerektiğini gösteren iyi bir örnektir.
Gerçek problem zinciri:
Fiziksel sinyal → veri → özellik → model → doğrulama → hata analizi → özellik seçimi → yeniden modelleme → bilinmeyen veri → parametre tahmini → fiziksel çıktı
biçimindedir.
Modulations-Expert'in bilimsel ve eğitimsel değeri, bu zincirin tamamını aynı MATLAB çalışma ortamında görünür hâle getirmesidir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Modulations-Expert: A MATLAB GUI Toolbox for Automatic Modulation Recognition and Blind Demodulation
Yazar: Mehdi Teimouri.
Yazar sırası: Tek yazarlı çalışma.
Eş katkı/eş birinci yazar: Uygulanabilir değildir.
Temas yazarı: Mehdi Teimouri.
Kurum: Faculty of Intelligent Systems, University of Tehran, Tehran, Iran.
Kaynak türü: MATLAB tabanlı bilimsel yazılım / AMR ve blind-demodulation preprint'i.
Platform: SSRN.
SSRN kimliği: 6864984.
DOI: 10.2139/ssrn.6864984.
SSRN yayın tarihi: 1 Haziran 2026.
Hakemlik durumu: Bu çalışma hakem değerlendirmesinden geçmemiş bir preprinttir; sonuçları bu yayın aşaması dikkate alınarak değerlendirilmelidir.
Resmî kayıt: https://ssrn.com/abstract=6864984
Yazılım adı: Modulations-Expert.
Kod sürümü: V2.1.
Yazılım ortamı: MATLAB, MATLAB GUI, Machine Learning Toolbox, Signal Processing Toolbox.
Çalışma gereksinimi: Kaynakta 64-bit MATLAB R2015b veya daha yeni Windows sürümü belirtilmiştir.
Kod lisansı: GNU General Public License v3.0 — GPL-3.0.
Kod sürümleme sistemi: Git.
Kod deposu: https://github.com/mehditeimouri-UT/Modulations-Expert
Geliştirici dokümantasyonu: Kaynak metaverisinde N/A.
Destek e-postası: mehditeimouri@ut.ac.ir
Makale telifi: SSRN bibliyografik kaydı “All rights reserved. No reuse allowed without permission” bilgisini vermektedir. Kodun GPL-3.0 lisansı ile makalenin görsel/telif durumu birbirinden ayrı değerlendirilmiştir. Kaynağın özgün GUI ekran görüntüleri bu nedenle Verianla HTML'sine birebir aktarılmamıştır.
Finansman: Yüklenen preprintte açık finansman beyanı bulunmamaktadır.
Çıkar çatışması: Yüklenen preprintte ayrı çıkar çatışması beyanı bulunmamaktadır.
CRediT/yazar katkıları: Ayrı CRediT beyanı bulunmamaktadır.
Veri erişimi: Araç sentetik dataset oluşturabilmekte ve dış I/Q waveform dosyalarından burst çıkarabilmektedir. Makaledeki 80.000 örneklik deney veri kümesi için ayrı kalıcı açık veri deposu belirtilmemiştir.
Bilimsel içerik kaynağı: Bu Verianla makalesindeki yazılım mimarisi, desteklenen modülasyonlar, feature extraction aileleri, dataset yapısı, classifier listesi, confusion matrix değerleri, feature-selection sonuçları, SVM ayarları, 16-QAM deneyi, parameter estimation değerleri ve BER sonucu yüklenen 12 sayfalık kaynağa dayanmaktadır. Dış kaynak yalnız başlık, yazar, DOI, SSRN tarihi, temas yazarı ve makale telif durumunu bibliyografik olarak doğrulamak için kullanılmıştır.
Görsel inceleme notu: Kaynak PDF'nin 7–12. sayfalarındaki bütün görünür şekiller incelenmiştir. Sayısal olarak açık biçimde okunabilen confusion matrix ve deney değerleri tablolaştırılmış; kaynak ekran görüntüleri yeniden yayımlanmamıştır.
Temel bilimsel sınır: Çalışma yazılımın işlevselliğini sentetik AMR örnekleriyle göstermektedir. Raporlanan performans değerleri bütün haberleşme ortamları, RF cihazları, kanal türleri veya modülasyon sınıfları için evrensel performans garantisi değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir