

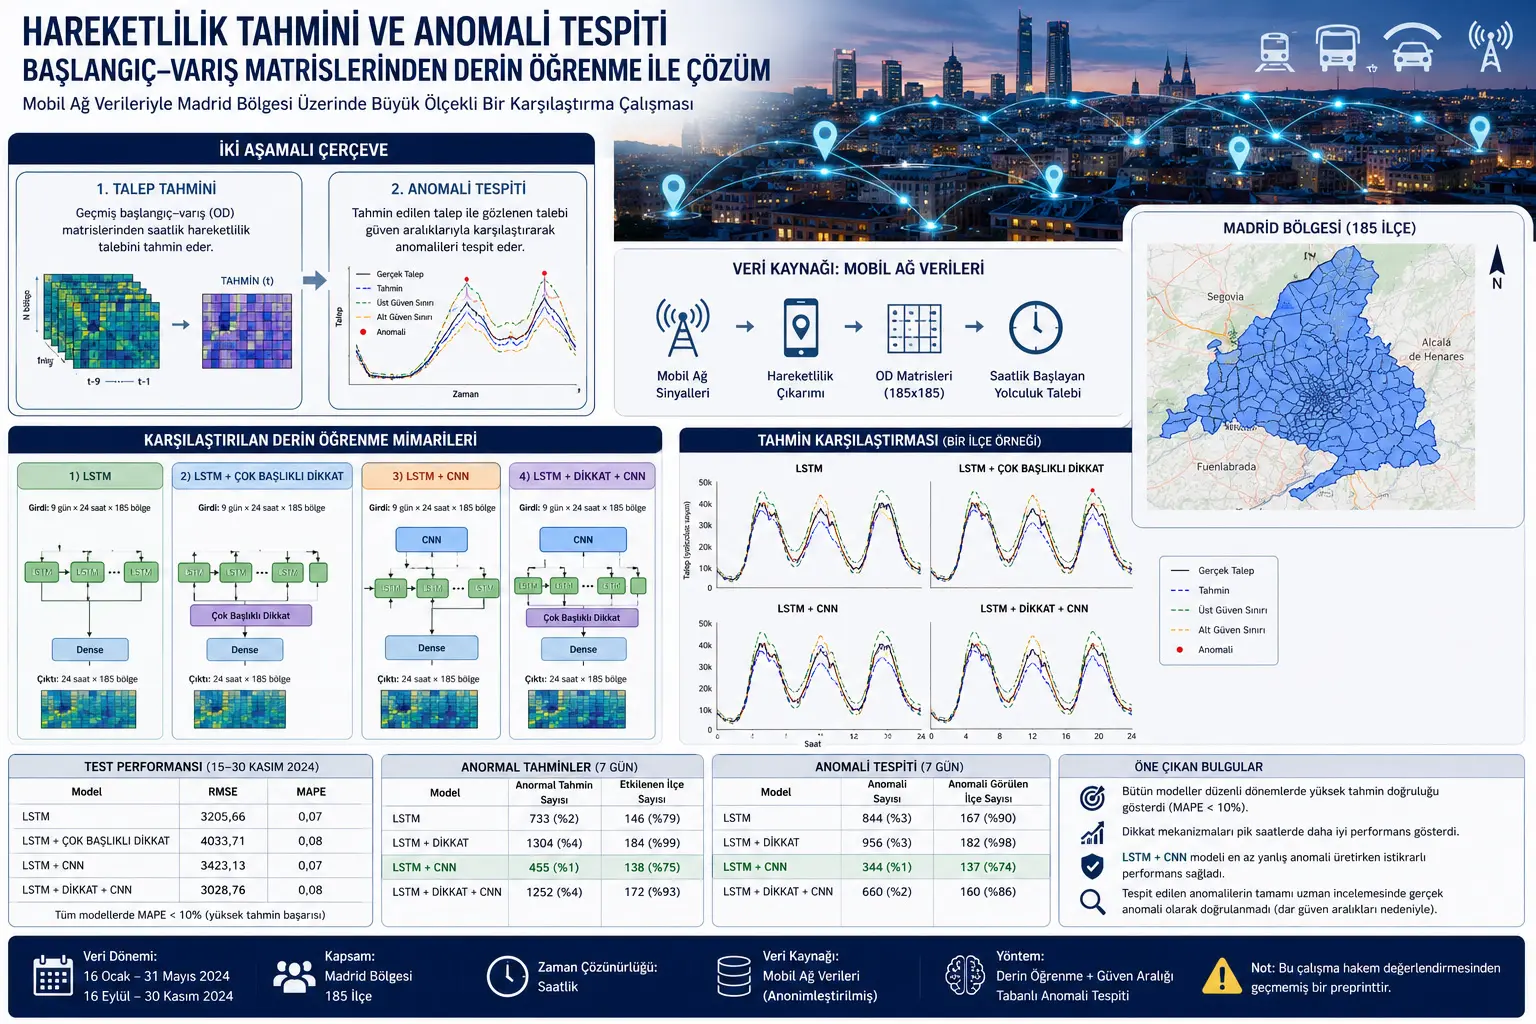
Ulaşım planlamasında en kritik sorulardan biri şudur: İnsanlar hangi bölgeden hangi bölgeye, hangi saatlerde ve hangi yoğunlukta hareket ediyor? Bu soruya verilen cevap, toplu taşıma kapasitesinden trafik yönetimine, yol bakım planlamasından özel etkinlik günlerindeki operasyon kararlarına kadar birçok alanda doğrudan etkilidir.
Bu tür hareketlilik bilgisi genellikle başlangıç-varış matrisleriyle ifade edilir. Başlangıç-varış matrisi, belirli bir zaman diliminde bir bölgeden diğer bölgeye kaç kişinin yolculuk yaptığını gösteren veri yapısıdır. Örneğin bir şehrin ilçeleri satır ve sütunlara yerleştirildiğinde, satır başlangıç bölgesini, sütun varış bölgesini temsil eder. Matrisin her hücresi de belirli bir başlangıç-varış çifti arasındaki yolculuk sayısını gösterir.
Çalışmanın temel problemi, bu hareketlilik talebini geçmiş verilerden öğrenerek geleceğe yönelik tahmin etmek ve beklenen davranıştan olağan dışı sapmaları tespit etmektir. Ulaşım sisteminde bir anomali; tatil, grev, spor etkinliği, hava durumu, kaza, altyapı kesintisi veya beklenmeyen toplumsal hareketlilik nedeniyle normal örüntüden farklılaşan talep anlamına gelebilir. Bu tür sapmalar erken fark edilirse, ulaşım işletmecileri sefer sıklığını artırabilir, belirli bölgelerde kapasite ayarlayabilir, trafik yönetim merkezleri önlem alabilir veya özel durum planlarını devreye sokabilir.
Bu problem neden önemli?
Şehir hareketliliği rastgele değildir. Hafta içi sabah işe gidiş, öğle saatlerinde daha düşük hareketlilik, akşam iş çıkışı yoğunluğu, hafta sonu farklı eğilimler ve tatil günlerinde değişen seyahat davranışı gibi tekrar eden örüntüler vardır. Ancak bu örüntüler her zaman aynı kalmaz. Bir konser, futbol maçı, kötü hava, grev veya yol kapanması belirli bölgelerde talebi normalden çok daha yüksek veya düşük hale getirebilir.
Ulaşım yönetimi açısından sorun yalnızca “kaç kişi hareket edecek?” sorusu değildir. Daha önemli soru, “beklenen talebe göre olağan dışı bir durum var mı ve bu durum nerede ortaya çıkıyor?” sorusudur. Çünkü sistem normal günde iyi çalışırken, olağan dışı bir günde aynı plan yetersiz kalabilir. Eğer anormal talep önceden veya erken aşamada tespit edilirse, ulaşım sistemi daha proaktif yönetilebilir.
Bu çalışma, hareketlilik tahmini ve anomali tespitini aynı çerçevede ele aldığı için önemlidir. Yalnızca iyi tahmin yapan bir model, karar vericiye anomalinin nerede ve ne zaman oluştuğunu söylemeyebilir. Yalnızca anomali tespiti yapan bir sistem de güçlü bir beklenen talep tahminine sahip değilse, normal dalgalanmaları yanlışlıkla anomali sayabilir. Araştırma bu iki ihtiyacı birleştirerek önce beklenen talebi hesaplamayı, sonra bu beklentiye göre sapmaları değerlendirmeyi amaçlamaktadır.
Mobil ağ verileri neden kullanılıyor?
Çalışmada kullanılan veriler, mobil ağ verilerinden üretilmiş başlangıç-varış matrisleridir. Mobil ağ verileri, insanların telefonlarının baz istasyonlarıyla kurduğu bağlantılardan hareket örüntülerini çıkarmaya imkân verir. Bu veriler bireysel izleme amacıyla değil, hareketlilik akışlarını toplu ve anonimleştirilmiş şekilde anlamak için kullanıldığında, şehir ölçeğinde çok değerli bir veri kaynağı olabilir.
Mobil ağ verilerinin ulaşım planlamasında önemli avantajları vardır. Geleneksel anketler pahalıdır, sınırlı örneklemle yapılır ve belirli dönemleri kapsar. Sensörler, kameralar veya turnike verileri ise yalnızca belirli noktalardaki hareketi görebilir. Mobil ağ verileri ise geniş alanı, uzun zaman aralığını ve farklı bölgeler arası hareketi daha bütüncül şekilde temsil edebilir.
Çalışmada kullanılan OD matrisleri, Nommon tarafından İspanya Ulaştırma ve Sürdürülebilir Hareketlilik Bakanlığı için üretilmiştir. Mobil ağ verileri Nommon Mobility Insights çözümüyle işlenmiş, örneklenen cep telefonu kullanıcıları için aktivite-seyahat günlükleri oluşturulmuş ve nüfus sayımı verileriyle toplam nüfusa genişletilmiştir. Matrisler yalnızca bölgesel hareketi değil; günün saati, yolculuk amacı, mesafe, yaş, cinsiyet, ikamet yeri ve gelir gibi özelliklere göre de bölümlenebilecek zengin bir veri yapısı sunmaktadır.
Literatürdeki boşluk nedir?
Ulaşım talebi tahmini ve anomali tespiti literatüründe farklı yöntemler kullanılmıştır. Bazı çalışmalar istatistiksel yöntemlere dayanır. Kalman filtreleri, Gaussian kernel tabanlı yöntemler, Z-score ölçütleri ve güven aralıkları bu alanda kullanılan klasik araçlardır. Bu yöntemlerin yorumlanabilirliği yüksektir; ancak büyük ölçekli, çok boyutlu OD matrislerinde ölçeklenebilirlik sorunu yaşayabilirler.
Makine öğrenmesi yöntemleri bu sınırlılıkları azaltmak için kullanılmaya başlanmıştır. Destek vektör makineleri, rastgele ormanlar, k-en yakın komşu, doğrusal modeller ve boyut indirgeme için PCA gibi yöntemler çeşitli çalışmalarda uygulanmıştır. Ancak güçlü anomaliler ve durağan olmayan hareketlilik örüntüleri, bu modellerin kararlılığını etkileyebilir.
Derin öğrenme, özellikle LSTM ağları, zaman serilerindeki uzun dönemli bağımlılıkları yakalayabildiği için ulaşım talebi tahmininde öne çıkmıştır. Fakat literatürde hâlâ önemli bir boşluk vardır: Çoğu çalışma ya tahmin doğruluğuna ya da anomali tespitine odaklanır; farklı derin öğrenme mimarilerinin hem tahmin hem de anomali tespiti üzerindeki etkisini büyük ölçekli OD verileriyle sistematik biçimde karşılaştıran çalışmalar daha sınırlıdır.
Bu çalışma bu boşluğa odaklanır. Dört farklı derin öğrenme mimarisini aynı veri ve değerlendirme çerçevesinde karşılaştırır. Böylece LSTM, dikkat mekanizması ve CNN bileşenlerinin hangi koşullarda daha iyi çalıştığını, düşük talep ve yoğun saatlerde nasıl farklılaştığını ve anomali tespitinde yanlış işaretleme davranışını nasıl etkilediğini gösterir.
Önerilen iki aşamalı yöntem nasıl çalışıyor?
Çalışmanın yöntemi iki aşamalıdır. İlk aşama talep tahminidir. Derin öğrenme tabanlı zaman serisi modeli, geçmiş çok boyutlu OD talep verilerini kullanarak bir sonraki günün saatlik talebini üretir. Modelin girdisi önceki dokuz günün saatlik talebidir; çıktısı ise 185 ilçe için 24 saatlik talep tahminidir. Yani her tahmin, 185 × 24 boyutlu bir talep matrisi üretir.
İkinci aşama anomali tespitidir. Bu aşamada modelin tahmini doğrudan “doğru referans” kabul edilmez. Önce tahmin edilen talebin tarihsel talep davranışıyla uyumlu olup olmadığı kontrol edilir. Daha sonra gerçek gözlenen talep, doğrulanmış tahminle karşılaştırılır. Eğer gerçek talep güven aralığının dışına çıkarsa, anomali adayı olarak işaretlenir.
Bu iki aşamalı yapı önemlidir. Çünkü kötü bir tahminin ürettiği fark, gerçek anomali gibi görünebilir. Çalışma bu riski azaltmak için önce tahminin tarihsel örüntüyle tutarlılığını denetler. Böylece sistem, “gerçek talep anormal mi?” sorusunu sormadan önce “modelin beklediği talep makul mü?” sorusunu kontrol eder.
Beklenen talebin tarihsel davranışla doğrulanması
Çalışmada ilk güven aralığı, tahmin edilen talebin geçmiş aynı gün örüntüsüyle uyumlu olup olmadığını test etmek için kullanılır. Örneğin bir salı günü tahmini yapılıyorsa, önceki salı günleri dikkate alınır. Bu günler üzerinden ortalama talep ve standart sapma hesaplanır.
Çalışmada verilen güven aralığı şu şekildedir:
\[ [(1-\alpha)avg_n-k\cdot std_n,\ (1+\alpha)avg_n+k\cdot std_n] \]
Burada avg_n, önceki n aynı hafta günü için hesaplanan ortalama talebi ifade eder. std_n, aynı tarihsel gözlemlerin standart sapmasıdır. k, güven aralığının standart sapma cinsinden ne kadar genişletileceğini belirleyen parametredir. n, kaç geçmiş dönemin kullanılacağını belirtir. α ise talepte standart sapmayla tam yakalanamayan küçük dalgalanmalara esneklik eklemek için kullanılır.
Bu formülün gündelik anlamı şudur: “Geçmiş benzer günlerde bu bölgede talep yaklaşık hangi aralıkta gerçekleşiyordu? Modelin bugünkü tahmini bu beklenen davranış bandının içinde mi?” Eğer tahmin bu aralıkta kalıyorsa, modelin tahmini tarihsel davranışla uyumlu kabul edilir. Eğer dışında kalıyorsa, bu durum ya gerçekten değişen bir talep örüntüsüne ya da model performansında bozulmaya işaret edebilir.
Gerçek talep ile tahmin edilen talebin karşılaştırılması
Tahmin tarihsel davranış açısından makul bulunduktan sonra, ikinci aşamada gerçek gözlemle karşılaştırılır. Burada güven aralığı bu kez tahmin değerinin çevresinde kurulur:
\[ [(1-\alpha)prediction-\ell\cdot std_n,\ (1+\alpha)prediction+\ell\cdot std_n] \]
Burada prediction, modelin tahmin ettiği talep değeridir. std_n, önceki n benzer günün standart sapmasıdır. ℓ, anomali tespitinde kullanılacak aralığın genişliğini belirleyen kalibrasyon parametresidir. α, önceki adımla tutarlı olacak şekilde esneklik sağlar.
Bu aralığın içinde kalan gerçek gözlemler normal kabul edilir. Dışında kalan değerler ise anomali adayı olarak işaretlenir. Burada “anomali adayı” ifadesi özellikle önemlidir. Çalışmada işaretlenen her değer otomatik olarak gerçek anomali sayılmamış, uzman doğrulaması gerektiği vurgulanmıştır. Çünkü istatistiksel olarak aralığın dışına çıkan küçük sapmalar, gerçek bir olaydan değil, çok dar güven aralıklarından veya doğal değişkenlikten kaynaklanabilir.
Madrid Bölgesi uygulaması
Yöntem Madrid Bölgesi üzerinde test edilmiştir. Bölge 185 ilçeye ayrılmıştır. Çalışmada bölge haritası üzerinde bu ilçelerin mekânsal dağılımı gösterilmekte ve mavi alanlarla analiz bölgesinin kapsamı ifade edilmektedir. Bu harita, çalışmanın küçük bir koridor veya tek bir istasyon verisiyle değil, geniş bölgesel hareketlilik verisiyle çalıştığını göstermesi açısından önemlidir.
OD matrisleri, her ilçe için saatlik başlayan yolculuklara dönüştürülmüştür. Böylece model, aynı anda 185 farklı ilçenin saatlik talep zaman serisini tahmin etmiştir. Bu, klasik tek zaman serisi tahmininden çok daha zor bir problemdir; çünkü her ilçenin kendi talep ritmi olduğu gibi, bölgeler arası ilişkiler ve ortak zaman örüntüleri de vardır.
Deney veri seti yalnızca 2024 yılındaki tam ve düzenli haftalardan oluşturulmuştur. Tatiller veya büyük bozulmalar dışarıda bırakılmıştır. Analiz dönemi 16 Ocak–31 Mayıs 2024 ve 16 Eylül–30 Kasım 2024 aralıklarını kapsar. Paskalya haftası ve Madrid bölgesel tatil haftası hariç tutulmuştur. Bu seçim, yöntemin önce düzenli talep koşullarında ne kadar iyi çalıştığını anlamaya yöneliktir. Tatil ve büyük olay dönemleri daha karmaşık olduğundan gelecek çalışmalar için ayrı değerlendirilmesi gereken bir alandır.
Karşılaştırılan derin öğrenme mimarileri
Çalışmada dört sinir ağı mimarisi karşılaştırılmıştır. İlk model temel LSTM mimarisidir. LSTM ağları, uzun dönemli zaman bağımlılıklarını öğrenmek için tasarlanmıştır. Bu nedenle geçmiş günlerdeki ve saatlerdeki hareketlilik örüntülerinden gelecekteki talebi tahmin etmek için uygundur. Temel mimaride üç adet 128 birimli LSTM katmanı, 0,3 dropout oranı, 1024 nöronlu tam bağlantılı katman ve 24 × 185 boyutlu çıktı katmanı kullanılmıştır.
İkinci model, çok başlıklı dikkat mekanizmalı LSTM’dir. Dikkat mekanizması, modelin geçmiş gözlemler arasında daha önemli olan zaman adımlarına daha fazla ağırlık vermesini sağlar. Örneğin bir bölgenin talebi belirli saatlerde veya belirli hafta günlerinde daha anlamlı örüntüler taşıyorsa, dikkat mekanizması bu ilişkileri daha iyi yakalayabilir. Bu çalışmada dikkat modülü dört başlık, 32 anahtar boyutu ve 0,1 dropout oranıyla LSTM yığını ile yoğun katmanlar arasına eklenmiştir.
Üçüncü model, LSTM ile CNN birleşimidir. CNN katmanı, giriş aşamasında yerel zamansal ve mekânsal örüntüleri yakalamak için kullanılır. Hareketlilik verilerinde komşu veya işlevsel olarak bağlantılı bölgeler arasında ilişkiler olabilir. Bir bölgede oluşan yoğunluk, başka bir bölgedeki talebi etkileyebilir. CNN bileşeni, bu tür kısa dönemli ve yerel örüntüleri çıkarmaya yardımcı olur. Bu modelde temel LSTM mimarisine 64 filtreli ve kernel boyutu 5 olan bir konvolüsyon katmanı eklenmiştir.
Dördüncü model ise LSTM, çok başlıklı dikkat ve CNN bileşenlerini birlikte kullanır. Bu en karmaşık mimari, konvolüsyon katmanı, üç LSTM katmanı, çok başlıklı dikkat modülü, global average pooling ve yoğun çıktı katmanlarından oluşur. Amaç, CNN’in yerel örüntü yakalama gücü, LSTM’in uzun dönemli bağımlılık öğrenme kapasitesi ve dikkat mekanizmasının önemli zaman adımlarına odaklanma becerisini birleştirmektir.
Eğitim ve test düzeni
Tüm modeller MAE yani ortalama mutlak hata kayıp fonksiyonuyla eğitilmiş ve Adam optimizasyon algoritmasıyla optimize edilmiştir. Veri seti eğitim ve test alt kümelerine ayrılmıştır. Eğitim seti 14 Kasım 2024’e kadar olan tüm gözlemleri içerir. Test seti ise 15–30 Kasım 2024 arasındaki sonraki 16 günü kapsar ve yalnızca genelleme performansını değerlendirmek için kullanılmıştır.
Girdi-çıktı örnekleri dokuz günlük kayan pencereyle oluşturulmuştur. Model, önceki dokuz günün saatlik talebine bakarak tek bir günün 24 saatlik talebini tahmin eder. Her tahmin 185 ilçe ve 24 saatten oluştuğu için çıktı matrisi 185 × 24 boyutundadır.
Model performansı RMSE ve MAPE ile değerlendirilmiştir. RMSE büyük hataları daha fazla cezalandırır; bu nedenle yüksek talep dönemlerindeki büyük sapmaları daha görünür hale getirir. MAPE ise gözlenen değere göre göreli hatayı ölçer; düşük talep dönemlerinde küçük mutlak farklar bile yüksek yüzdelik hataya dönüşebilir. Bu nedenle iki metriğin birlikte kullanılması önemlidir.
RMSE ve MAPE ne anlama gelir?
Çalışmada formülleri açıkça verilmemiş olsa da kullanılan metrikleri anlamak için temel ilişkiler şu şekilde ifade edilebilir. Bu formüller çalışmanın mantığını açıklamak için verilen arka plan formülleridir:
\[ RMSE=\sqrt{\frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2} \]
Burada y_i gerçek talebi, \hat{y}_i tahmin edilen talebi, N toplam gözlem sayısını ifade eder. RMSE, hataların karesini aldığı için büyük hatalara daha duyarlıdır. Yoğun saatlerde tahmin çok saparsa RMSE bunu güçlü biçimde cezalandırır.
\[ MAPE=\frac{100}{N}\sum_{i=1}^{N}\left|\frac{y_i-\hat{y}_i}{y_i}\right| \]
Burada MAPE, hatayı gerçek değerin yüzdesi olarak verir. Talep düşükken küçük mutlak sapmalar bile büyük yüzde hataya dönüşebilir. Bu nedenle çalışma, dikkat mekanizmalı modellerin yoğun saatlerde iyi, düşük talepte ise daha zayıf görünmesini RMSE ve MAPE’nin farklı hassasiyetleri üzerinden açıklamaktadır.
Tahmin sonuçları: Hangi model daha başarılı?
Test seti üzerinde dört modelin hata değerleri şöyledir:
| Model | RMSE | MAPE |
|---|---|---|
| LSTM | 3205,66 | 0,07 |
| LSTM + çok başlıklı dikkat | 4033,71 | 0,08 |
| LSTM + CNN | 3423,13 | 0,07 |
| LSTM + çok başlıklı dikkat + CNN | 3028,76 | 0,08 |
Bütün modeller yüksek tahmin başarısı göstermiştir. MAPE değerlerinin tamamı 0,07–0,08 aralığındadır; yani göreli hata yüzde 10’un altındadır. Bu, düzenli işletme dönemlerinde hareketlilik talebinin derin öğrenme modelleriyle başarılı biçimde tahmin edilebildiğini gösterir.
En düşük RMSE, LSTM + çok başlıklı dikkat + CNN modelinde 3028,76 olarak elde edilmiştir. Bu, modelin özellikle yüksek talep dönemlerindeki büyük sapmaları azaltmada güçlü olduğunu gösterir. Ancak aynı modelin MAPE değeri 0,08’dir; bu da düşük talep saatlerinde göreli hata açısından daha zayıf olabileceğini düşündürür. Temel LSTM ve LSTM-CNN modelleri MAPE açısından 0,07 ile daha iyi görünmektedir.
Çalışmanın önemli yorumu şudur: Dikkat mekanizmalı modeller pik talep saatlerini daha iyi yakalar; fakat düşük talep dönemlerinde daha zayıf performans gösterebilir. Dikkat içermeyen daha basit modeller düşük talep saatlerini daha iyi temsil eder; ancak günlük talebin üç tepe noktasını yakalamada daha sınırlı kalabilir. Bu nedenle “en iyi model” tek bir cevap değildir. Eğer uygulama yoğun saat tahminine daha çok önem veriyorsa dikkat tabanlı modeller avantajlı olabilir. Eğer düşük talep saatlerinde göreli hata veya yanlış anomali üretmemek daha önemliyse, daha basit LSTM veya LSTM-CNN modelleri daha uygun olabilir.
Şekillerde tahmin eğrileri ne gösteriyor?
Çalışmadaki tahmin karşılaştırması grafikleri, seçilen bir temsilî ilçe için dört modelin gerçek talep ile tahmin eğrisini göstermektedir. Günlük hareketlilikte belirgin bir dalga yapısı vardır: gece ve sabahın erken saatlerinde düşük talep, gün içinde yükselen hareketlilik ve bazı saatlerde tepe noktaları görülür.
Grafikler, bütün modellerin genel günlük örüntüyü yakaladığını göstermektedir. Ancak mimariler arasında sistematik farklar vardır. Dikkat mekanizması olmayan modeller düşük talep saatlerinde gerçek eğriye daha yakın görünürken, pik saatlerde tepe noktalarını tam yakalamakta zorlanır. Dikkat mekanizmalı modeller ise tepe saatlerini daha doğru temsil eder; fakat düşük talep dönemlerinde göreli sapmalar artabilir.
Bu grafiklerin önemli tarafı, yalnızca hata tablosunu görsel olarak doğrulaması değildir. Aynı zamanda hareketlilik tahmininde farklı saatlerin farklı zorluk taşıdığını gösterir. Bir model yoğun talep saatlerinde başarılıyken, gece düşük talep döneminde fazla veya eksik tahmin yapabilir. Bu fark, anomali tespitinde de kritik hale gelir; çünkü düşük değişkenlikli saatlerde güven aralıkları daralır ve küçük sapmalar yanlış anomali olarak işaretlenebilir.
Anomali tespiti sonuçları
Çalışmada saatlik tahminler 185 ilçe için yedi günlük analizde değerlendirilmiştir. Toplam tahmin sayısı 31.080’dir. Her model için anormal tahmin sayıları ve etkilenen ilçe sayıları şöyledir:
| Model | Anormal tahmin sayısı | Anormal tahmin görülen ilçe sayısı |
|---|---|---|
| LSTM | 733 (%2) | 146 (%79) |
| LSTM + çok başlıklı dikkat | 1304 (%4) | 184 (%99) |
| LSTM + CNN | 455 (%1) | 138 (%75) |
| LSTM + çok başlıklı dikkat + CNN | 1252 (%4) | 172 (%93) |
Bu tablo, LSTM-CNN modelinin en az anormal tahmin üreten model olduğunu göstermektedir. Çok başlıklı dikkat içeren modeller daha fazla anormal tahmin üretmiştir. Bu durum, özellikle düşük talep dönemlerindeki göreli tahmin zayıflığı ve dar güven aralıklarıyla ilişkilendirilmiştir.
Sonraki aşamada, gerçek gözlenen talebe göre anomali olarak işaretlenen değerler değerlendirilmiştir:
| Model | Anomali sayısı | Anomali görülen ilçe sayısı |
|---|---|---|
| LSTM | 844 (%3) | 167 (%90) |
| LSTM + çok başlıklı dikkat | 956 (%3) | 182 (%98) |
| LSTM + CNN | 344 (%1) | 137 (%74) |
| LSTM + çok başlıklı dikkat + CNN | 660 (%2) | 160 (%86) |
Burada da LSTM-CNN modelinin en iyi anomali tespiti davranışını ürettiği görülmektedir. Bu model 344 anomali işaretlemiş, diğer modellerden belirgin biçimde daha düşük yanlış işaretleme üretmiştir. Çalışmanın yorumu, LSTM-CNN’in LSTM’in uzun dönemli zamansal bağımlılıkları öğrenme gücü ile CNN’in kısa dönemli ve mekânsal örüntüleri yakalama kapasitesini birleştirdiği için daha kararlı tahminler ve daha güvenilir güven aralıkları ürettiği yönündedir.
Tespit edilen anomaliler gerçek anomali mi?
Çalışmada çok önemli bir sonuç vardır: Analiz edilen test setindeki tespitlerin hiçbiri gerçek anormal durum olarak değerlendirilmemiştir. İşaretlenen değerler geçerli talep gözlemleridir. Anomali olarak görünmelerinin nedeni, çoğu durumda güven aralıklarının fazla dar olmasıdır.
Güven aralığı dar olduğunda, gerçek talep normal davranışa çok yakın olsa bile aralığın dışına taşabilir. Bu özellikle önceki günlerde talep değişkenliği çok düşükse olur. Standart sapma küçük olduğunda, formüldeki std_n terimi güven bandını daraltır. Böylece çok küçük dalgalanmalar bile istatistiksel olarak anomali adayı gibi işaretlenebilir.
Çalışmadaki görseller, anormal tahminlerin ve tespit edilen anomalilerin güven aralığı sınırlarına çok yakın olduğunu göstermektedir. Bu, gerçek bir ulaşım bozulması veya büyük talep değişimi olmadığını; daha çok kalibrasyon hassasiyetiyle ilişkili olduğunu düşündürmektedir.
Bollinger bandı benzeri güven aralıkları neden dikkatli kalibre edilmeli?
Çalışmada güven aralıkları Bollinger bandı yaklaşımının bir varyasyonu olarak kurulmuştur. Bu yapı, ortalama ve standart sapmaya dayandığı için anlaşılır ve uygulanabilir bir yöntemdir. Ancak standart sapma düşük olduğunda aralık fazla daralabilir; standart sapma yüksek olduğunda ise aralık fazla genişleyebilir ve gerçek anomaliler kaçabilir.
Bu nedenle araştırmada parametre kalibrasyonu uzman doğrulamasıyla desteklenmiştir. Nommon hareketlilik uzmanları, tespit edilen olayların zaman serilerini inceleyerek bunların gerçek anomali olup olmadığını değerlendirmiştir. Son seçilen yapı; altı dönemlik hareketli ortalama, k = ℓ = 2 standart sapma katsayısı ve α = 1 esneklik parametresidir. Bu konfigürasyonun duyarlılık ile sağlamlık arasında uygun denge sunduğu belirtilmiştir.
Çalışmada ayrıca cuma günleri için güven aralıklarının daha geniş olduğu gözlenmiştir. Bunun nedenlerinden biri, tarihsel örnekte 1 Kasım’ın, yani İspanya’da resmi tatil olan bir günün yer almasıdır. Bu tatil, tarihsel cuma örüntüsündeki değişkenliği artırmış ve sonraki cumalar için güven bandının genişlemesine yol açmıştır. Bu detay, takvim etkilerinin anomali tespitinde ne kadar önemli olduğunu gösterir.
Gündelik yaşama etkisi ne olabilir?
Bu tür bir sistem şehir yönetiminde birçok pratik fayda sağlayabilir. Örneğin toplu taşıma işletmecisi belirli bir ilçede belirli saatlerde beklenenin üzerinde başlayan yolculuk olduğunu erken fark ederse, ek sefer veya araç yönlendirmesi planlayabilir. Trafik yönetim merkezi, beklenenden yüksek hareketliliğin belirli bir etkinlik, kaza veya hava durumu nedeniyle oluşup oluşmadığını inceleyebilir. Uzun vadede ise planlamacılar, şehirdeki düzenli ve düzensiz hareketlilik örüntülerini daha iyi anlayarak altyapı ve hizmet kararlarını güçlendirebilir.
Bu yaklaşım yalnızca kriz günleri için değil, normal günlerin daha iyi anlaşılması için de değerlidir. Eğer bir model düzenli dönemlerde güvenilir tahminler üretebiliyorsa, olağan dışı dönemler daha net fark edilebilir. Bir başka deyişle, “normalin ne olduğunu” iyi tanımlamak, “anormali” doğru yakalamanın ön koşuludur.
Çalışmanın güçlü yönleri
Çalışmanın güçlü yönlerinden biri, büyük ölçekli ve yüksek boyutlu hareketlilik verisi üzerinde çalışmasıdır. 185 ilçe için saatlik talep tahmini, yalnızca tek bir yol veya küçük bir OD çifti tahmini değildir. Bu ölçek, yöntemin gerçek bölgesel ulaşım planlamasına daha yakın bir problem üzerinde test edildiğini gösterir.
İkinci güçlü yön, dört farklı derin öğrenme mimarisinin sistematik biçimde karşılaştırılmasıdır. Temel LSTM modelinin referans olarak kullanılması, dikkat mekanizması ve CNN bileşenlerinin katkısını daha net yorumlamaya imkân verir. Çalışma yalnızca “en karmaşık model en iyidir” dememekte; model seçiminin pik talep, düşük talep ve anomali tespiti hedeflerine göre değişebileceğini göstermektedir.
Üçüncü güçlü yön, insan uzman doğrulamasının sürece dahil edilmesidir. Anomali tespiti tamamen otomatik bırakılmamış, işaretlenen değerlerin gerçek anomali olup olmadığı hareketlilik uzmanlarının değerlendirmesiyle yorumlanmıştır. Bu, özellikle ulaşım planlaması gibi operasyonel kararlarla bağlantılı alanlarda önemlidir.
Çalışmanın sınırlılıkları
Çalışmanın en önemli sınırlılığı, deney veri setinin düzenli haftalardan seçilmiş olmasıdır. Tatiller, büyük bozulmalar ve önemli düzensizlikler özellikle dışarıda bırakılmıştır. Bu seçim, modelin normal koşullardaki tahmin ve yanlış anomali davranışını anlamak için uygundur; fakat gerçek anomalilerin yoğun olduğu olay dönemlerinde yöntemin nasıl çalışacağını doğrudan göstermez.
İkinci sınırlılık, tespit edilen anomalilerin analiz edilen test haftasında gerçek anomaliye karşılık gelmemesidir. Bu durum, yöntemin yanlış pozitif üretimini anlamak açısından değerlidir; ancak gerçek olayları yakalama başarısını ölçmek için daha düzensiz ve olay içeren veri setleri gerekir.
Üçüncü sınırlılık, anomali yorumunun dışsal değişkenlerle tam bütünleşmemiş olmasıdır. Çalışma gelecekte hava durumu, etkinlik verileri, takvim etkileri ve başka dış faktörlerin entegre edilmesini önermektedir. Bu entegrasyon olmadan sistem bir sapmayı işaretleyebilir; fakat sapmanın nedenini otomatik olarak açıklamakta sınırlı kalır.
Dördüncü olarak, çalışma preprinttir ve hakem değerlendirmesinden geçmemiştir. Bu nedenle sonuçlar değerli bir teknik karşılaştırma olarak görülmeli, fakat nihai doğrulanmış bilimsel kanıt veya uygulama standardı gibi sunulmamalıdır.
Çalışma ne söylüyor, ne söylemiyor?
Çalışma, mobil ağ verilerinden üretilen OD matrisleriyle Madrid Bölgesi’nde saatlik hareketlilik talebinin derin öğrenme modelleriyle yüksek doğrulukta tahmin edilebildiğini göstermektedir. Düzenli dönemlerde tüm modellerin MAPE değerleri yüzde 10’un altında kalmıştır. Ayrıca LSTM-CNN mimarisi, anomali tespiti açısından daha az yanlış işaretleme üreten, kararlı bir seçenek olarak öne çıkmıştır.
Çalışma, gerçek düzensiz olaylarda tüm anomalilerin kesin olarak yakalanacağını söylemez. Gerçek zamanlı operasyon sistemine doğrudan hazır bir ürün sunduğunu iddia etmez. Mobil ağ verilerinin her şehirde aynı kalite ve kapsamda bulunacağını garanti etmez. Ayrıca anomali nedenlerinin otomatik sınıflandırılması bu çalışmanın ana kapsamı değildir; bu gelecekte hava durumu ve etkinlik verileri gibi dışsal değişkenlerin eklenmesiyle geliştirilecek bir alan olarak bırakılmıştır.
Çalışmanın Yöntemi ve Bulguları
Yöntem adımları
- Veri kaynağı: Mobil ağ verilerinden üretilmiş başlangıç-varış matrisleri kullanılmıştır.
- Çalışma alanı: Madrid Bölgesi 185 ilçeye ayrılmıştır.
- Talep serileri: OD matrisleri saatlik başlayan yolculuk talebine dönüştürülmüş ve 185 paralel saatlik zaman serisi elde edilmiştir.
- Veri seçimi: 2024 yılındaki düzenli ve tam haftalar seçilmiş; tatil ve büyük bozulma dönemleri dışarıda bırakılmıştır.
- Girdi-çıktı yapısı: Önceki dokuz günün saatlik talebi kullanılarak sonraki bir günün 24 saatlik talebi tahmin edilmiştir.
- Model karşılaştırması: LSTM, LSTM + çok başlıklı dikkat, LSTM + CNN ve LSTM + çok başlıklı dikkat + CNN mimarileri test edilmiştir.
- Performans ölçümü: Tahmin performansı RMSE ve MAPE ile değerlendirilmiştir.
- Anomali tespiti: Tahmin ve gözlem değerleri, Bollinger bandı benzeri güven aralıklarıyla karşılaştırılmıştır.
- Uzman doğrulaması: Tespit edilen sapmalar hareketlilik uzmanlarıyla incelenmiş ve kalibrasyon buna göre değerlendirilmiştir.
Temel formüller
| Formül | Açıklama |
|---|---|
| [ [(1-\alpha)avg_n-k\cdot std_n,\ (1+\alpha)avg_n+k\cdot std_n] ] | Tahminin geçmiş aynı hafta günü davranışıyla uyumlu olup olmadığını kontrol eden güven aralığıdır. |
| [ [(1-\alpha)prediction-\ell\cdot std_n,\ (1+\alpha)prediction+\ell\cdot std_n] ] | Gerçek gözlenen talebin tahmin çevresindeki normal aralıkta kalıp kalmadığını belirleyen anomali tespit aralığıdır. |
| [ RMSE=\sqrt{\frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2} ] | Çalışmanın kullandığı RMSE metriğinin arka plan formülüdür; büyük hataları daha güçlü cezalandırır. |
| [ MAPE=\frac{100}{N}\sum_{i=1}^{N}\left|\frac{y_i-\hat{y}_i}{y_i}\right| ] | Çalışmanın kullandığı MAPE metriğinin arka plan formülüdür; hatayı gözlenen değere göre yüzde olarak ifade eder. |
Tahmin performansı
| Model | RMSE | MAPE | Yorum |
|---|---|---|---|
| LSTM | 3205,66 | 0,07 | Güçlü genel performans; düşük talep dönemlerinde göreli hata açısından başarılı. |
| LSTM + çok başlıklı dikkat | 4033,71 | 0,08 | Pik dönemleri yakalamada faydalı; ancak düşük talep saatlerinde göreli hata artabiliyor. |
| LSTM + CNN | 3423,13 | 0,07 | Tahmin doğruluğu ve anomali tespiti kararlılığı açısından dengeli sonuç veriyor. |
| LSTM + çok başlıklı dikkat + CNN | 3028,76 | 0,08 | En düşük RMSE değerini veriyor; yüksek talep dönemlerinde güçlü, düşük talepte MAPE daha yüksek. |
Anormal tahmin ve anomali tespiti
| Model | Anormal tahmin | Anomali | Teknik yorum |
|---|---|---|---|
| LSTM | 733 | 844 | Genel olarak iyi tahmin üretse de güven aralığı dışı işaretlemeler LSTM-CNN’den daha fazladır. |
| LSTM + çok başlıklı dikkat | 1304 | 956 | Düşük talep saatlerindeki göreli sapmalar nedeniyle daha fazla yanlış işaretleme üretmiştir. |
| LSTM + CNN | 455 | 344 | En az yanlış anomali üreten ve anomali tespiti açısından en dengeli modeldir. |
| LSTM + çok başlıklı dikkat + CNN | 1252 | 660 | RMSE açısından güçlü olsa da anomali tespitinde LSTM-CNN kadar kararlı değildir. |
Şekil ve tabloların anlattığı ana sonuçlar
Madrid Bölgesi’nin ilçelere ayrıldığını gösteren harita, çalışmanın geniş bölgesel ölçekte yürütüldüğünü ve 185 mekânsal birimi kapsadığını ortaya koymaktadır. Bu, yöntemin küçük bir laboratuvar verisiyle değil, gerçek bölgesel hareketlilik yapısına yakın yüksek boyutlu veriyle test edildiğini gösterir.
Tahmin karşılaştırması grafikleri, bütün modellerin günlük talep dalgasını yakaladığını; ancak dikkat mekanizmalı modellerin pik saatleri, dikkat içermeyen modellerin ise düşük talep saatlerini daha iyi temsil ettiğini göstermektedir. Bu bulgu, RMSE ve MAPE sonuçlarıyla uyumludur.
Anormal tahmin ve anomali grafiklerinde işaretlenen noktalar güven aralığı sınırlarına çok yakın görünmektedir. Bu görsel sonuç, çalışmanın metinsel yorumunu destekler: Test haftasında tespit edilen değerler gerçek anomali değil, dar güven aralıklarından kaynaklanan küçük sapmalardır.
Tablolar, LSTM-CNN modelinin anomali tespiti açısından en avantajlı mimari olduğunu açık biçimde göstermektedir. Bu model hem tahmin doğruluğunu korumuş hem de yanlış anomali işaretlemelerini azaltmıştır.
Genel teknik sonuç
Çalışmanın ana teknik sonucu, büyük ölçekli hareketlilik talebi tahmini için derin öğrenme mimarilerinin güçlü performans gösterdiği; ancak model seçiminin kullanım amacına göre yapılması gerektiğidir. Pik talep saatlerinin yakalanması öncelikse dikkat tabanlı mimariler avantajlıdır. Düşük talep dönemlerinde kararlı göreli hata ve daha az yanlış anomali isteniyorsa LSTM-CNN gibi dikkat içermeyen hibrit mimariler daha dengeli sonuç verebilir.
Anomali tespiti açısından sonuçlar, yalnızca iyi tahmin yapmanın yeterli olmadığını göstermektedir. Güven aralıklarının genişliği, tarihsel değişkenlik, takvim etkileri ve uzman doğrulaması tespit başarısını doğrudan etkiler. Bu nedenle çalışma, otomatik anomali tespitini insan uzman doğrulamasıyla birlikte ele alan daha güvenli bir operasyonel yaklaşım önermektedir.
Kaynak ve Yöntem Notu
Bu makale, Raquel Sánchez-Cauce, Oliva G. Cantú Ros, Miguel Picornell, Pablo Ruiz ve Sergio Teso tarafından hazırlanan “Mobility Demand Forecasting and Anomaly Detection from Origin–Destination Matrices: A Benchmark of Deep Learning Architectures” başlıklı çalışmaya dayanarak hazırlanmıştır. Yazarlar Nommon Solutions and Technologies bağlantılıdır. Çalışma, Avrupa Birliği Horizon Europe programı kapsamında fonlanan CONDUCTOR projesinin bir parçasıdır.
Kaynak metin SSRN üzerinde yer alan bir preprint araştırma makalesidir. Metinde açıkça “This preprint research paper has not been peer reviewed” ifadesi bulunduğu için çalışma hakem değerlendirmesinden geçmemiştir. Bu nedenle sonuçlar, hakemli bir dergide kesin olarak doğrulanmış bulgular gibi değil, teknik olarak ayrıntılı fakat hakemlik süreci tamamlanmamış preprint sonuçları olarak okunmalıdır.
Bu içerik, PDF’deki çalışma esas alınarak hazırlanmıştır. PDF’de olmayan saha uygulaması garantisi, ticari başarı, gerçek zamanlı sistemde kesin performans, tüm şehirlerde genellenebilirlik veya tüm anomalileri kesin yakalama iddiası eklenmemiştir. Çalışmanın yöntemi mobil ağ verilerinden üretilmiş OD matrislerine, derin öğrenme tabanlı zaman serisi tahminine ve güven aralığı temelli anomali tespitine dayanmaktadır.
Çalışma düzenli haftalar üzerinde test edilmiştir; tatil ve büyük bozulma dönemleri özellikle dışarıda bırakılmıştır. Bu nedenle yöntem, düzenli talep koşullarında tahmin doğruluğu ve yanlış anomali davranışı açısından değerlendirilmiştir. Gerçek anomali olaylarının bulunduğu daha düzensiz dönemlerde performansın ayrıca test edilmesi gerekir. Ayrıca hava durumu, etkinlik verileri ve takvim etkileri gibi dışsal değişkenlerin modele daha güçlü biçimde entegre edilmesi gelecek çalışma konusu olarak belirtilmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir