

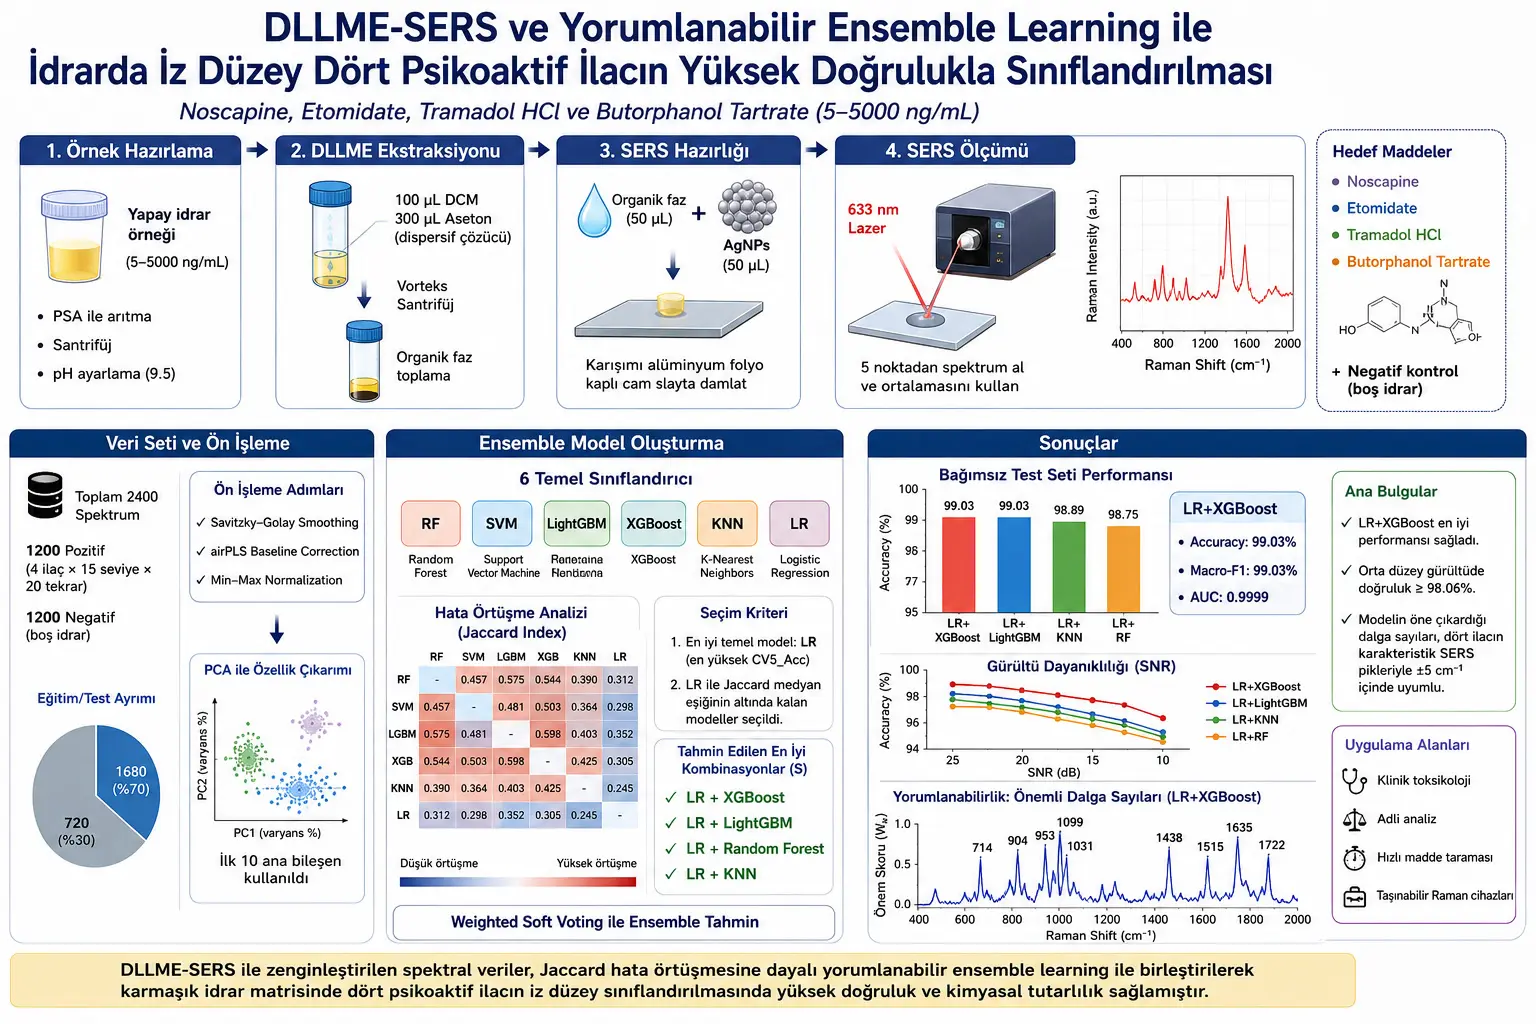
Психоактивдүү заттарды кыянаттык менен колдонуу коомдук саламаттык сактоо жана соттук илимдер үчүн барган сайын маанилүү маселеге айланып баратат. Айрыкча бир нече дары же химиялык түзүлүшү окшош заттар бир биологиялык чөйрөдө чогуу болушу мүмкүн болгон учурларда талдоо “зат барбы?” деген суроо менен гана чектелбейт. Кайсы зат бар экени, ал кайсы концентрациялык аралыкта экени жана сигнал чындап эле ошол молекулага таандыкпы же жокпу — мунун баары ишенимдүү түрдө аныкталышы керек.
Заара заттарды скринингдөөдө көп колдонулган биологиялык үлгүлөрдүн бири. Мунун себеби үлгү алуу салыштырмалуу жеңил жана инвазивдүү эмес болушунда. Бирок заараны химиялык жактан талдоо жөнөкөй эмес. Белоктор, мочевина, туздар, метаболиттер жана башка эндогендик компоненттер максаттуу заттардын сигналдарын жаап коюшу мүмкүн. Мындан тышкары, изилдөөдө баса белгиленгендей, максаттуу аналиттер ng/mL деңгээлинде болушу мүмкүн. Демек, талданган заттын көлөмү өтө аз жана күчтүү сигналды күчөтүү же алдын ала байытуу стратегиясы талап кылынат.
Салттуу ыкмалардын арасында GC-MS жана LC-MS/MS сыяктуу хроматография-масс-спектрометрия ыкмалары күчтүү жана ишенимдүү деп эсептелет. Бирок мындай системалар кымбат жабдууну, даярдыктан өткөн кызматкерлерди, татаал даярдоо процесстерин жана лабораториялык инфраструктураны талап кылат. Иммунохроматографиялык тесттер ылдам болушу мүмкүн; бирок кайчылаш реакция, жалган оң натыйжа жана бир нече затты айырмалоодогу чектөөлөр сыяктуу көйгөйлөргө туш болушу мүмкүн. Ошондуктан изилдөөчүлөр ылдамыраак, арзаныраак жана молекулалык манжа изин бере алган спектроскопиялык ыкмаларга көңүл бурушууда.
Раман спектроскопиясы молекулалардын термелүү моддоруна жараша “химиялык манжа изин” түзүүчү ыкма. Ар бир молекула байланыш түзүлүшүнө жана термелүү касиеттерине жараша белгилүү толкун сандарында сигнал берет. Бирок кадимки Раман сигналы көбүнчө алсыз болот. Бул жерде SERS ыкмасы ишке кирет. Күмүш же алтын сыяктуу асыл металл нанотүзүмдөрү молекулага жакын аймактагы электромагниттик талааны күчөтүп, Раман сигналын бир нече даражага жогорулата алат. Мунун натыйжасында кадимки шартта өтө алсыз болуп кала турган из деңгээлиндеги молекулалык сигналдарды өлчөөгө мүмкүнчүлүк түзүлөт.
Бул изилдөөдө SERS алдында DLLME колдонулган. DLLMEнин максаты — заарадагы максаттуу заттарды кичинекей органикалык фазага өткөрүп, сигнал алууга ылайыктуу түрдө топтоо. Күнүмдүк мисал менен айтсак, чоң стакандагы сууда өтө аз өлчөмдө эриген зат бар деп элестетели. Аны түз өлчөө кыйын болушу мүмкүн. Бирок ошол затты кичинекей тамчыга топтой алсаңыз, өлчөө кыйла так байкалат. DLLME ушуга окшош логика менен иштейт: татаал үлгүдөгү аз концентрациядагы максаттуу молекулаларды аз көлөмдүү эриткич фазасына байытат.
Изилдөөдө үлгү даярдоо бир нече кадамдан турат. Адегенде жасалма заара үлгүлөрүнө максаттуу дарылар кошулган. Заараны тазалоо үчүн 2.0 mL spiked artificial urine, башкача айтканда зат кошулган жасалма заара үлгүсү алынып, ага 100 mg PSA кошулган, аралашма вортексте аралаштырылып, центрифугаланган. Андан кийин үстүңкү фазадан 1.0 mL алынып, экстракция баскычына өткөн.
DLLME баскычында үлгүнүн pH көрсөткүчү 9.5 деңгээлине жөнгө салынган. Андан соң 100 μL дихлорметан экстракциялык эриткичи жана 300 μL ацетон дисперсиялык эриткичи тез кошулган. Аралашма вортексте иштетилип, булут сымал эмульсия түзүлгөн; центрифугалоодон кийин төмөнкү органикалык фаза микрошприц менен чогултулган. Бул баскыч максаттуу молекулаларды талдоо үчүн ылайыктуу фазада топтоого мүмкүндүк берет.
SERS сигналын күчөтүү үчүн күмүш нанобөлүкчөлөр колдонулган. AgNPs деп кыскартылган бул бөлүкчөлөр Lee-Meisel цитраттык калыбына келтирүү ыкмасы менен даярдалган. Изилдөөдө күмүш нитратынын эритмеси кайнатылып, тринатрий цитратынын эритмеси кошулган жана эритменин сары-жашыл түскө өтүшү менен нанобөлүкчөлөрдүн түзүлүшү байкалган. SEM мүнөздөмөсү боюнча бөлүкчөлөр орточо болжол менен 60 nm диаметрдеги жарым шар сымал морфология көрсөткөн.
Спектрдик өлчөөдө лабораторияда чогултулган көчмө Раман аныктоо системасы колдонулган. Система 633 nm лазер менен иштеген. Органикалык фазадан 50 μL алынып, ошончо көлөмдөгү концентрацияланган күмүш нанобөлүкчө эритмеси менен аралаштырылган, андан кийин 10 μL аралашма алюминий фольгасы менен капталган таза айнек слайдга тамчылатылган. Ар бир үлгү үчүн тамчынын ар башка беш чекитинен беш спектр алынып, алардын орточо мааниси ошол үлгүнүн өкүлчүлүктүү спектри катары колдонулган.
Маалымат топтому абдан тартиптүү түзүлгөн. Ар бир максаттуу дары үчүн 15 концентрация деңгээлинде 20 өз алдынча даярдалган үлгү өлчөнгөн. Бул 4 дары × 15 концентрация × 20 үлгү эсеби менен 1200 оң спектр дегенди билдирет. Мындан тышкары, ошол эле процедурадан өткөрүлгөн бош жасалма заарадан 1200 терс спектр алынган. Ошентип, жалпысынан 2400 спектр алынган. Спектрдик аралык 159–1996 cm⁻¹ деп көрсөтүлгөн.
Чийки Raman/SERS спектрлери модельге түз берилген эмес. Адегенде Savitzky-Golay smoothing менен ызы-чуу азайтылып, airPLS baseline correction аркылуу фондук сызык оңдолгон жана Min-Max normalization менен сигналдар 0–1 аралыгына масштабдалган. Мындай алдын ала иштетүү кадамдары спектроскопияда өтө маанилүү; анткени модель чыныгы химиялык айырмачылыктардын ордуна прибордун ызы-чуусун, базалык сызыктын жылышын же интенсивдүүлүк масштабындагы айырманы үйрөнүп албашы керек.
Андан кийин маалымат топтому 7:3 катышында окутуу жана көз карандысыз тест топтомуна бөлүнгөн. 1680 спектр окутуу топтомуна, 720 спектр көз карандысыз тест топтомуна киргизилген. Өзгөчө маанилүү жагы — PCA жана StandardScaler параметрлери окутуу топтомунда гана үйрөнүлүп, тест топтому ошол эле трансформация менен проекцияланган. Бул ыкма маалыматтын агып кетишин алдын алуу үчүн маанилүү. Эгер тест топтомунан алынган маалымат алдын ала иштетүүдө модельге кирип кетсе, тесттин көрсөткүчү чыныгыдан жогору көрүнүшү мүмкүн.
Белгилерди чыгаруу үчүн PCA, башкача айтканда principal component analysis колдонулган. PCA жогорку өлчөмдүү спектрдик маалыматты азыраак компонентке кыскартат. Спектрде жүздөгөн же миңдеген толкун санынын чекиттери болушу мүмкүн; бирок алардын баары классификация үчүн бирдей деңгээлде маалымат бербейт. PCA маалыматтагы эң чоң вариация булактарын жаңы окторго айландырып, модель үчүн башкарууга ыңгайлуу белгилер мейкиндигин түзөт.
Изилдөөдө PCA компоненттеринин саны LightGBM probe model аркылуу бааланган. 3a-сүрөттө көрсөтүлгөндөй, тактык n=8 чамасында платого жетип, n=10 маанисинен кийин олуттуу жакшырган эмес. Ошондуктан алгачкы 10 негизги компонент сакталган. Бул модель чийки спектрдин ордуна 10 өлчөмдүү PCA белгилер мейкиндигинде иштегенин билдирет.
3b жана 3c-сүрөттөр класстар ортосундагы ажырымды PCAнын үч өлчөмдүү чачыранды графиги жана t-SNE жайгаштыруу ыкмасы аркылуу көрсөтөт. Алгачкы үч негизги компонентти караганда класстар арасында белгилүү топтолуу багыты көрүнөт; бирок чек аралар толук так эмес. Айрыкча noscapine, etomidate жана терс контролдун ортосунда катмарлашуу байкалат. t-SNE көрүнүшү etomidate жана tramadol hydrochloride үчүн тыгызыраак топторду көрсөтсө, терс контролдун айрым класс чек араларына чачыраганын көрсөтөт. Бул жөнөкөй сызыктуу бөлүү жетишсиз экенин жана классификаторлор майда айырмалоочу маалыматты чыгара алышы керек экенин көрсөтөт.
Изилдөөнүн машиналык үйрөнүү бөлүгүндө алты негизги классификатор бааланган: Random Forest, Support Vector Machine, LightGBM, XGBoost, K-Nearest Neighbors жана Logistic Regression. Бул моделдер ар башка алгоритмдик үй-бүлөлөрдү билдирет. Logistic Regression көбүрөөк сызыктуу жана статистикалык мамиле сунуштайт, ал эми XGBoost жана LightGBM градиенттик күчөтүүгө негизделген дарак моделдери. SVM чечим чек арасын табууга багытталат, KNN кошуналык мамилеге таянат, Random Forest болсо көптөгөн чечим дарактарынын орточо жыйынтыгын колдонот.
Бул алты моделдин ар бири 5 катмарлуу кайчылаш текшерүү жана grid search менен оптималдаштырылган. Натыйжалар боюнча бардык негизги моделдер %97.3 көрсөткүчүнөн жогору кайчылаш текшерүү тактыгына жеткен. Logistic Regression эң мыкты негизги модель катары %99.29 ± 0.24 CV5_Acc көрсөткүчүн берген. Андан кийин SVM жана XGBoost келген. Бирок жалгыз моделдердин көрсөткүчү ансыз деле жогору болгондуктан, кошумча жакшыртуу үчүн ensemble ыкмасы керек деп эсептелген.
Изилдөөнүн өзгөчө жагы дал ушул жерден көрүнөт. Ensemble learning бир нече моделди бириктирип, күчтүүрөөк чечим чыгарууну көздөйт. Бирок ар бир модель айкалышы пайдалуу боло бербейт. Эгер эки модель бир эле үлгүлөрдө жаңылса, аларды бириктирүү чоң пайда бербейт. Тескерисинче, эки модель ар башка үлгүлөрдө жаңылса, бири экинчисинин катасын оңдой алат. Изилдөө бул ойду Jaccard error overlap index аркылуу сандык түрдө көрсөтөт.
Изилдөөдө Jaccard ката дал келүү индекси төмөнкү логика менен аныкталган:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Бул формулада Mi жана Mj эки башка негизги классификаторду билдирет. Ei — i моделинин туура эмес классификациялаган үлгүлөрүнүн топтому. Ej — j моделинин туура эмес классификациялаган үлгүлөрүнүн топтому. Ei ∩ Ej эки модель тең бирдей жаңылган үлгүлөрдү; Ei ∪ Ej жок дегенде бир модель жаңылган жалпы үлгүлөр топтомун көрсөтөт. J мааниси 0 менен 1 маанисинин ортосунда өзгөрөт. Маани төмөн болсо, эки моделдин ката үлгүсү көбүрөөк айырмаланат; демек ensemble ичинде бири-бирин толуктоо мүмкүнчүлүгү жогору болушу мүмкүн.
Күнүмдүк мисал келтирсек, эки текшерүү кызматкерин элестетели. Эгер экөө тең дайыма бир эле каталарды өткөрүп жиберсе, чогуу иштеши көп пайда бербейт. Бирок бири A түрүндөгү каталарды, экинчиси B түрүндөгү каталарды жакшыраак байкаса, чогуу иштегенде натыйжа ишенимдүү болот. Jaccard ката дал келүү индекси моделдер “бир эле каталарды жасап жатабы же ар башка каталардыбы?” деген суроого сандык жооп берет.
Изилдөөчүлөр бул индексти колдонуп select-the-best, pair-the-best деп аталган эки кадамдуу тандоо критерийин сунушташкан. Биринчи кадамда CV5_Acc мааниси эң жогору болгон негизги модель милдеттүү мүчө катары тандалган. Бул модель Logistic Regression. Экинчи кадамда Logistic Regression менен башка моделдердин Jaccard ката дал келүүсү эсептелип, бардык жуптук Jaccard маанилеринин медианасы босого катары алынган. LR менен ушул босогодон төмөн ката дал келүүсүн көрсөткөн моделдер жакшы айкалышууга талапкер деп эсептелген.
Жыйынтыгында болжолдонгон эң мыкты комбинациялар топтому төмөнкүдөй түзүлгөн:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Бул жерде S теориялык жактан артыкчылыктуу болушу күтүлгөн экилик ensemble айкалыштарын билдирет. Изилдөөнүн маанилүү жагы — бул топтом болжол деңгээлинде эле калтырылган эмес. Изилдөөчүлөр алты моделден түзүлө турган бардык 15 экилик айкалышты exhaustive comparison, башкача айтканда толук салыштыруу аркылуу текшеришкен.
Толук салыштыруунун жыйынтыгында CV5_Acc рейтингиндеги алгачкы төрт айкалыш чындап эле LR+XGBoost, LR+LightGBM, LR+RF жана LR+KNN болгон. Бул Jaccard ката дал келүүсүнө негизделген “select-the-best, pair-the-best” критерийинин алдын ала айтуу мүмкүнчүлүгүн колдойт. Айрыкча LR+XGBoost айкалышы %99.40 ± 0.42 CV5_Acc көрсөткүчү менен биринчи орунга чыккан. LR+LightGBM %99.35 ± 0.39, ал эми LR+RF жана LR+KNN %99.29 ± 0.24 көрсөткүчтөрүнө жеткен.
Көз карандысыз тест топтомундагы натыйжалар да бул түзүлүштү колдойт. S топтомундагы төрт айкалыштын тактыгы %98.75 менен %99.03 аралыгында өзгөргөн. LR+XGBoost жана LR+LightGBM эң жакшы жалпы көрсөткүчтү берип, экөө тең %99.03 Accuracy жана %99.03 Macro-F1 маанисине жеткен. Контролдук айкалыштардын ичинен LightGBM+XGBoost болгону %97.92 тактык көрсөткөн. Бул бир алгоритмдик үй-бүлөгө жакын жана ката дал келүүсү жогору моделдерди бириктирүү дайыма эле жакшы натыйжа бербесин көрсөтөт.
Изилдөөдөгү класска жараша баалоо модель кайсы заттарда көбүрөөк кыйналганын да көрсөтөт. Терс контроль, noscapine жана butorphanol tartrate жогорку recall көрсөткүчтөрүн берген, ал эми etomidate жана tramadol hydrochloride төмөнүрөөк recall багытын көрсөткөн. Мунун химиялык себеби — эки заттын бензол шакегинин дем алуу термелүүлөрү болжол менен 1000 cm⁻¹ аймагында олуттуу дал келет. Демек моделдин кыйналган жери кокустук ката эмес, химиялык спектрлер чындап жакындашкан аймак.
Изилдөөдө ызы-чууга туруктуулук өзүнчө текшерилген. Тест топтомуна 25, 20, 15 жана 10 dB SNR деңгээлдеринде Гаусстук ак ызы-чуу кошулган. Орточо ызы-чуу шартында, өзгөчө 15 dB SNR болгондо, S топтомундагы төрт айкалыштын тактыгы %98.06 көрсөткүчүнөн жогору бойдон калган. Катуу ызы-чуу шарты болгон 10 dBде да бул айкалыштардын тактыгы %96.53 деңгээлинде сакталган. Бул тандалган моделдер таза спектрлерде гана эмес, сигнал бузулган учурда да салыштырмалуу туруктуу экенин көрсөтөт.
Бирок бул натыйжаларды этият окуу керек. Ызы-чууга туруктуулук чыныгы клиникалык үлгүлөрдөгү бардык татаалдыкты чагылдырбайт. Чыныгы заара үлгүлөрү адамдар аралык метаболизм айырмачылыктары, дары метаболиттери, ар башка pH, кошумча заттар, бөйрөк функциясы, тамактануу, оору, булгануу жана үлгүнү сактоо шарттары сыяктуу көптөгөн өзгөрмөлөргө ээ. Изилдөө жасалма заарада жүргүзүлгөндүктөн, чыныгы клиникалык/соттук текшерүү кийинки кадам катары талап кылынат.
Изилдөөнүн дагы бир күчтүү жагы — түшүндүрмөлүүлүк чынжыры. Машиналык үйрөнүү моделдери жогорку тактык берсе да, химиялык анализде “модель эмне үчүн мындай чечим чыгарды?” деген суроо өтө маанилүү. Эгер моделдин чечими чыныгы молекулалык чокуларга эмес, маалымат иштетүү артефакттарына же кокустук ызы-чууга таянса, жогорку тактык ишенимдүү химиялык далил дегенди билдирбеши мүмкүн. Ошондуктан изилдөөчүлөр permutation importance маанилерин PCA жүктөрү аркылуу баштапкы толкун саны мейкиндигине кайра проекциялашкан.
Бул түшүндүрмөлүүлүк үчүн колдонулган байланыш изилдөөдө төмөнкүдөй берилген:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Бул формулада Wk k-чы толкун саны чекитинин жалпы маанилүүлүк упайын көрсөтөт. PIi i-чи негизги компоненттин permutation importance мааниси. Lik — k-чы толкун санынын i-чи негизги компоненттеги жүктөө коэффициенти. n — сакталган негизги компоненттердин саны. Изилдөөдө n=10 деп белгиленген. Формуланын максаты — моделдин PCA мейкиндигиндеги чечим салымын кайра баштапкы Раман толкун саны огуна өткөрүү.
Муну мындай түшүнүүгө болот: Модель чийки спектрди түз үйрөнгөн жок, PCA компоненттери аркылуу үйрөндү. Бирок химиялык түшүндүрмө чийки толкун сандарында жүргүзүлөт. Ошондуктан “модель үчүн кайсы PCA компоненти маанилүү болду?” деген суроону “бул маанилүүлүк кайсы Раман толкун сандарына туура келет?” деген суроого айландыруу керек. Back-projection, башкача айтканда кайра проекциялоо муну камсыз кылат.
Түшүндүрмөлүүлүк анализинде өзгөчө маанилүү болгон толкун сандары төрт дарынын мүнөздүү SERS чокулары менен негизинен шайкеш келген. Noscapine үчүн 904 cm⁻¹ жана 1635 cm⁻¹, etomidate үчүн 952/953 cm⁻¹, 1030/1031 cm⁻¹ жана 1726/1722 cm⁻¹, tramadol hydrochloride үчүн 715/714 cm⁻¹ жана 1000/999 cm⁻¹, butorphanol tartrate үчүн 1437/1438 cm⁻¹ жана 1515 cm⁻¹ аймактары чечүүчү деп табылган. Изилдөөдө бул айырмалар 5 cm⁻¹ чегинде калганы айтылат.
Бул илимий жактан маанилүү. Анткени модель жөн гана статистикалык классификатор катары иштеген эмес; чечимдеринде чыныгы химиялык термелүү моддоруна туура келген аймактарды колдонгон. Мисалы, noscapineдин лактон шакегиндеги C-O-C созулуу термелүүсү 904 cm⁻¹ чамасында моделдин эң маанилүү чокусу катары табылган. Butorphanol tartrate үчүн 1438 cm⁻¹ аймагы ароматтык C=C созулуусу менен байланышкан. Tramadol жана etomidate үчүн 1000 cm⁻¹ чамасындагы дал келүү бул эки классты айырмалоо эмне үчүн кыйыныраак экенин химиялык жактан түшүндүрөт.
Изилдөөнүн графикалык жыйынтыгы жана 1-сүрөт ыкманын жалпы агымын көрсөтөт. Биринчи бөлүктө заара үлгүсү, DLLME аркылуу экстракция, AgNPs менен SERS сигналын алуу жана спектрдик өлчөө көрсөтүлгөн. Орто бөлүктө RF, SVM, LightGBM, XGBoost, KNN жана LR моделдерин тандоо, Jaccard ката дал келүү матрицасы жана LR борборлуу айкалыштарды түзүү берилген. Акыркы бөлүктө ensemble моделин баалоо, ызы-чууга туруктуулук жана толкун санынын маанилүүлүк графиктери көрсөтүлгөн. Бул сүрөт лабораториялык химия менен жасалма интеллект моделин тандоону бирдиктүү процесс катары курганын даана көрсөтөт.
2-сүрөт төрт дарынын ар башка концентрациядагы DLLME-SERS спектрлерин көрсөтөт. Концентрация көбөйгөн сайын мүнөздүү чокулардын интенсивдүүлүгү өсүп, чоку жайгашкан жерлер туруктуу бойдон калганы айтылат. Бул ыкма концентрация өзгөрүшүнө сезимтал сигнал жаратарын, бирок молекулалык манжа изи жайгашкан жерлерди сактарын көрсөтөт. Ошол эле учурда etomidate жана tramadol hydrochloride үчүн 1000 cm⁻¹ чамасында чокулар дал келгендиктен, аларды көз менен айырмалоо кыйындашы мүмкүн экени түшүнүктүү болот.
4-сүрөт моделди тандоо эмне үчүн “эң жогорку тактыктагы эки моделди бириктир” деген логика менен гана жүргүзүлбөшү керек экенин көрсөтөт. Негизги моделдердин жеке көрсөткүчтөрү жогору; бирок ката дал келүү матрицасы айрым моделдер окшош каталарды кетирерин көрсөтөт. Айрыкча даракка негизделген моделдердин ортосунда ката дал келүүсүнүн жогору болушу аларды бириктирүү ensemble пайдасын чектеши мүмкүн экенин көрсөтөт. Ал эми LR менен KNN, RF, LightGBM жана XGBoost ортосундагы төмөнүрөөк Jaccard маанилери бири-бирин толуктоо мүмкүнчүлүгүн көрсөтөт.
5-сүрөт көз карандысыз тест топтомунун көрсөткүчүн, класска жараша метрикаларды, ызы-чууга туруктуулукту жана түшүндүрүлө турган толкун санынын маанилүүлүк бөлүштүрүлүшүн чогуу берет. Бул сүрөттүн эң маанилүү билдирүүсү — модель жогорку тактыкты гана бербестен, ызы-чуу шартында да туруктуу болуп, чечимдерин химиялык мааниси бар толкун саны аймактарына негиздеген.
Изилдөөнүн тарыхый мааниси SERS-ML адабиятындагы эки жетишпестикти бутага алууда. Биринчиси, ensemble моделдеринин мүчөлөрү көп учурда сандык негиздемесиз тандалат. Экинчиси, модель чечимдери кайсы Раман жылыштарына таянары химиялык жактан байкалбай калат. Бул изилдөө модель тандоону каталардын бири-бирин толуктоосу менен негиздөөгө жана модель чечимин химиялык чокулар менен байланыштырып түшүндүрүүгө аракет кылат.
Бүгүнкү күн үчүн изилдөө ылдам скринингге болгон муктаждыкка жооп берет. Клиникалык токсикологияда, соттук лабораторияларда жана заттарды кыянат колдонууга мониторинг жүргүзүүдө сезгич, ылдам жана көчмө системалар керек. DLLME-SERS сыяктуу спектроскопиялык ыкмалар масс-спектрометриядай акыркы ырастоо күчүн убада кылбаса да, ылдам алдын ала скрининг же талаага жакын анализ үчүн баалуу болушу мүмкүн.
Келечек үчүн изилдөө түшүндүрүлө турган химиялык жасалма интеллект моделдеринин маанисин көрсөтөт. Аналитикалык химияда жасалма интеллект “туура болжол берген кара куту” болуу менен чектелбеши керек. Айрыкча соттук жана клиникалык контекстте модель эмне үчүн чечим чыгарганы, кайсы химиялык чокуга таянганы жана бул чечим чыныгы молекулалык термелүүлөргө туура келеби же жокпу — түшүндүрүлүшү зарыл. Бул изилдөө PCA жүктөрү аркылуу кайра проекциялоо менен permutation importance айкалышын ушул максатта колдонот.
Изилдөөнүн күчтүү жактарына тартиптүү маалымат топтомун түзүү, көз карандысыз тест топтомун колдонуу, маалыматтын агып кетишин алдын алуу үчүн окутуу/тест бөлүүсү, бардык 15 экилик айкалышты салыштыруу, ызы-чууга туруктуулук тести жана химиялык түшүндүрмөлүүлүк анализи кирет. Мындан тышкары, моделдин чечим чыгарган толкун сандары мүнөздүү SERS чокуларына туура келерин көрсөтүү натыйжаларды химиялык жактан маңыздуу чечмелөөгө мүмкүндүк берет.
Ошол эле учурда чектөөлөр да так айтылышы керек. Изилдөө рецензиядан өтпөгөн preprint. Үлгүлөр чыныгы клиникалык заара эмес, жасалма заара. Болгону төрт дары менен чектелген. Jaccard негизиндеги тандоо критерийи алты талапкер классификатордо текшерилген; чоңураак модель топтомдорунда ошол эле натыйжа береби — өзүнчө изилдениши керек. Ошондой эле чыныгы соттук үлгүлөрдө аралашмалар, метаболиттер, бузулуу продуктулары, ар башка адамдардын заара курамы жана бир нече заттын бир убакта болушу кыйла татаал болушу мүмкүн.
Изилдөөнүн айтканы ушул: DLLME-SERS аркылуу алынган из деңгээлиндеги спектрдик маалыматтарды туура алдын ала иштетүү, PCA негизиндеги белгилерди чыгаруу, Jaccard ката толуктоочулугуна жараша тандалган ensemble моделдери жана химиялык түшүндүрмөлүүлүк чынжыры менен жогорку тактыкта классификациялоого болот. Изилдөөнүн айтпаганы болсо ушул: Бул ыкма азыртан эле чыныгы клиникалык/соттук заара үлгүлөрүндө так диагноз же укуктук далил катары колдонууга даяр. Ал үчүн чыныгы үлгүлөрдө, кеңири дары панелдеринде, аралашма сценарийлеринде жана көз карандысыз лабораториялык текшерүүлөрдө кошумча изилдөөлөр талап кылынат.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Изилдөө жасалма заара матрицасында төрт психоактивдүү дарыны из деңгээлинде классификациялоо үчүн лабораториялык анализ менен машиналык үйрөнүүнү айкалыштырган эксперименттик жана эсептөөчү изилдөө дизайнына ээ.
Максаттуу заттар:
| Зат | Изилдөөдөгү Ролу | Негизги SERS Чоку Аймактары |
| Noscapine | Төрт максаттуу психоактивдүү дарынын бири. | 904 cm⁻¹ жана 1635 cm⁻¹. |
| Etomidate | Бензол шакегинин термелүүлөрү аркылуу айырмалоого аракет кылынган максаттуу зат. | 952, 1004, 1030 жана 1726 cm⁻¹. |
| Tramadol hydrochloride | 1000 cm⁻¹ чамасында etomidate менен чоку дал келүүсүн көрсөткөн максаттуу зат. | 715 жана 1000 cm⁻¹. |
| Butorphanol tartrate | Ароматтык C=C созулуу аймактары аркылуу айырмаланган максаттуу зат. | 1437 жана 1515 cm⁻¹. |
Үлгү даярдоо жана SERS өлчөөсү:
- Жасалма заара үлгүлөрүнө максаттуу заттар spike кылынган.
- Заараны тазалоо үчүн 2.0 mL үлгүгө 100 mg PSA кошулуп, вортексте аралаштыруу жана центрифугалоо жүргүзүлгөн.
- DLLME үчүн pH 9.5 деңгээлине жөнгө салынган, 100 μL дихлорметан жана 300 μL ацетон колдонулган.
- Күмүш нанобөлүкчөлөр Lee-Meisel цитраттык калыбына келтирүү ыкмасы менен даярдалган.
- AgNP бөлүкчөлөрүнүн орточо болжол менен 60 nm диаметрдеги жарым шар сымал түзүлүшкө ээ экени көрсөтүлгөн.
- SERS өлчөөлөрү 633 nm лазердүү көчмө Раман системасы менен жүргүзүлгөн.
- Ар бир үлгү үчүн беш башка чекиттен спектр алынып, орточо спектр колдонулган.
Маалымат топтому:
| Маалымат Элементи | Маани | Түшүндүрмө |
| Максаттуу дары саны | 4 | Noscapine, etomidate, tramadol hydrochloride, butorphanol tartrate. |
| Концентрация аралыгы | 5–5000 ng/mL | Из деңгээлинен жогорку деңгээлге чейин созулган классификация аралыгы. |
| Концентрация деңгээли | 15 | Ар бир дары үчүн ар башка концентрация чекиттери колдонулган. |
| Ар бир концентрациядагы өз алдынча үлгү | 20 | Ар бир максаттуу дары үчүн 15 × 20 үлгү даярдалган. |
| Оң спектр | 1200 | 4 × 15 × 20 эсеби менен алынган. |
| Терс спектр | 1200 | Бош жасалма заара үлгүлөрүнөн алынган. |
| Жалпы спектр | 2400 | Моделдөө үчүн колдонулган жалпы маалымат. |
| Окутуу/тест бөлүнүшү | 1680 / 720 | 7:3 катышында бөлүнгөн. |
| Спектрдик аралык | 159–1996 cm⁻¹ | SERS өлчөөсүнүн толкун саны аралыгы. |
Алдын ала иштетүү кадамдары:
- Savitzky-Golay smoothing: терезе өлчөмү 11, полином даражасы 3.
- airPLS baseline correction: λ = 10⁵, максимум итерация 100, жакындашуу толеранттуулугу 10⁻⁶.
- Min-Max normalization: сигналдар 0–1 аралыгына масштабдалган.
- PCA менен белгилер чыгарылган.
- Алгачкы 10 негизги компонент моделдөө үчүн сакталган.
- Маалымат агып кетпеши үчүн PCA жана StandardScaler окутуу топтомунда гана fit кылынган.
Колдонулган негизги классификаторлор:
| Модель | Кыскартылышы | Изилдөөдөгү Ролу |
| Random Forest | RF | Дарак негизиндеги ensemble негизги модель. |
| Support Vector Machine | SVM | Чечим чек арасына багытталган классификатор. |
| LightGBM | LGBM | Градиенттик күчөтүүгө негизделген дарак модели. |
| XGBoost | XGB | Күчтүү градиенттик күчөтүүчү дарак модели. |
| K-Nearest Neighbors | KNN | Кошуналык мамилеге негизделген классификатор. |
| Logistic Regression | LR | Эң жогорку негизги CV5_Acc маанисин берген милдеттүү ensemble мүчөсү. |
Jaccard ката дал келүү формуласы:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Бул формулада Ei жана Ej эки башка модель туура эмес классификациялаган үлгүлөрдүн топтомдору. J мааниси төмөн болсо, моделдердин ката үлгүлөрү көбүрөөк айырмаланат жана ensemble ичинде бири-бирин толуктоо ыктымалдыгы жогору болот.
Модель тандоо критерийи:
- Select-the-best: CV5_Acc мааниси эң жогору болгон негизги модель тандалат. Бул изилдөөдө LR тандалган.
- Pair-the-best: LR менен башка моделдердин Jaccard ката дал келүүсү эсептелет.
- Бардык 15 экилик Jaccard маанисинин медианасы босого катары алынган.
- LR менен босогодон төмөн ката дал келүүсүн көрсөткөн моделдер жакшы айкалышууга талапкер деп эсептелген.
Болжолдонгон эң мыкты ensemble топтому:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Негизги модель жана ensemble жыйынтыктары:
| Жыйынтык | Сандык Натыйжа | Түшүндүрмө |
| Бардык негизги моделдердин CV5_Acc мааниси | Эң аз %97.3 | 10 өлчөмдүү PCA белгилер мейкиндиги күчтүү классификациялык маалыматты камтыйт. |
| Эң мыкты негизги модель | LR, %99.29 ± 0.24 CV5_Acc | Эң жогорку жеке көрсөткүчтү бергендиктен, милдеттүү ensemble мүчөсү катары алынган. |
| Jaccard аралыгы | 0.245–0.575 | Моделдердин ката дал келүүсү олуттуу айырмаланган. |
| Медианалык Jaccard босогосу | 0.361 | LR менен ушул босогодон төмөн калган моделдер тандалган. |
| LR+XGBoost CV5_Acc | %99.40 ± 0.42 | Толук салыштырууда эң жогорку айкалыш болгон. |
| LR+LightGBM CV5_Acc | %99.35 ± 0.39 | Экинчи күчтүү айкалыштардын бири. |
| LR+RF жана LR+KNN CV5_Acc | %99.29 ± 0.24 | Болжолдонгон жакшы айкалыштар топтомуна туура келет. |
Көз карандысыз тест топтомунун жыйынтыктары:
| Модель / Айкалыш | Жыйынтык | Түшүндүрмө |
| LR+XGBoost | %99.03 Accuracy, %99.03 Macro-F1, AUC 0.9999 | Эң жакшы жалпы көрсөткүч берген айкалыштардын бири. |
| LR+LightGBM | %99.03 Accuracy жана Macro-F1 | LR+XGBoost менен бирдей тест тактыгына жеткен. |
| LR+KNN | %98.89 Accuracy | Болжолдонгон жакшы топтомдун ичинде. |
| LR+RF | %98.75 Accuracy | Болжолдонгон жакшы топтомдун ичинде. |
| SVM+LR | %98.72 Accuracy | Көрсөткүчү жакын болгону менен ката дал келүүсү жогору. |
| LightGBM+XGBoost | %97.92 Accuracy | Бир үй-бүлөгө жакын моделдердин ката дал келүүсүнүн жогору болушу ensemble пайдасын чектеген. |
Ызы-чууга туруктуулук:
- Тест топтомуна 25, 20, 15 жана 10 dB SNR деңгээлдеринде Гаусстук ак ызы-чуу кошулган.
- 15 dB сыяктуу орточо ызы-чуу шартында S топтомундагы төрт айкалыш %98.06 көрсөткүчүнөн жогорку тактык көрсөткөн.
- 10 dB сыяктуу катуу ызы-чуу шартында да тактык %96.53 деңгээлинде калган.
- LR+LightGBM 25 dB SNRде %99.17 тактык көрсөткөн; бул айырма 720 үлгүнүн ичинен бир гана үлгүгө туура келген майда термелүү экени белгиленген.
- S топтомундагы айкалыштар бир тектүү ката үлгүсүнө ээ LightGBM+XGBoost контролуна караганда туруктуураак көрүнгөн.
Химиялык түшүндүрмөлүүлүк формуласы:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Бул формулада Wk k-чы толкун саны чекитинин жалпы маанилүүлүк упайын; PIi i-чи негизги компоненттин permutation importance маанисин; Lik k-чы толкун санынын i-чи PCA компонентиндеги жүгүн; n болсо колдонулган негизги компоненттердин санын көрсөтөт. Бул кайра проекциялоо модель чечими кайсы Раман толкун саны аймактарына таянганын түшүндүрүү үчүн колдонулган.
Модель бөлүп көрсөткөн химиялык толкун сандары:
| Толкун Саны | Байланышкан Булак | Химиялык Мааниси |
| 904 cm⁻¹ | Noscapine | Лактон шакегинин C-O-C созулуусу. |
| 1438 cm⁻¹ | Butorphanol tartrate | Ароматтык C=C созулуу аймагы. |
| 1635 cm⁻¹ | Noscapine | Ароматтык C=C созулуусу. |
| 953 cm⁻¹ | Etomidate | Бензол шакегинин тегиздиктен тышкаркы деформациясы. |
| 999 cm⁻¹ | Tramadol / Etomidate | Дал келген бензол шакегинин дем алуу режими. |
| 714 cm⁻¹ | Tramadol hydrochloride | Бензол шакеги менен байланышкан термелүү. |
| 1031 cm⁻¹ | Etomidate | Бензол/имидазол шакегинин термелүүсү. |
| 1515 cm⁻¹ | Butorphanol tartrate | Ароматтык C=C созулуусу. |
| 1722 cm⁻¹ | Etomidate | Карбонил C=O созулуусу. |
| 449 жана 1397 cm⁻¹ | Субстрат / матрица | AgNP/цитрат же заара матрицасы менен байланышкан фондук өзгөрүүлөр. |
Изилдөөнүн негизги жыйынтыктары:
- DLLME-SERS жасалма заарада төрт психоактивдүү дарыны 5–5000 ng/mL аралыгында из деңгээлинде классификациялоого жарактуу спектрдик маалымат берген.
- Концентрация жогорулаган сайын мүнөздүү чокулардын интенсивдүүлүгү көбөйүп, чоку жайгашкан жерлер туруктуу калган.
- Etomidate жана tramadol hydrochlorideдин болжол менен 1000 cm⁻¹ аймагындагы чокуларынын дал келиши визуалдык айырмалоону кыйындаткан.
- Алгачкы 10 PCA компоненти классификация үчүн жетиштүү белгилер мейкиндиги катары тандалган.
- Jaccard ката дал келүү индекси ensemble мүчөлөрүнүн ката толуктоочулугун сандык баалаган.
- “Select-the-best, pair-the-best” критерийи 15 экилик айкалыштын ичинен эң мыкты төрт айкалышты туура алдын ала айткан.
- LR+XGBoost жана LR+LightGBM көз карандысыз тест топтомунда %99.03 тактык жана Macro-F1 маанилерине жеткен.
- LR+XGBoost жалпы көрсөткүч жана туруктуулук тең салмагы боюнча химиялык түшүндүрмөлүүлүк анализи үчүн өкүлчүлүктүү модель катары тандалган.
- Модель айырмалоочу деп тапкан толкун сандары төрт дарынын мүнөздүү SERS чокуларына 5 cm⁻¹ чегинде туура келген.
Изилдөөнүн чектөөлөрү:
- Изилдөө рецензиядан өтпөгөн preprint.
- Үлгүлөр чыныгы клиникалык/соттук заара эмес, жасалма заара.
- Болгону төрт максаттуу зат бааланган.
- Jaccard негизиндеги тандоо критерийи алты талапкер классификатордо текшерилген; чоңураак модель топтомдору үчүн кошумча изилдөө керек.
- Чыныгы үлгүлөрдө метаболиттер, аралашмалар, ар башка заара курамы жана бир нече заттын чогуу болушу ыкманын көрсөткүчүн өзгөртүшү мүмкүн.
- Изилдөө ылдам скрининг үчүн методологиялык багыт бергени менен түз клиникалык/соттук акыркы ырастоо талабын койбойт.
Булак жана Ыкма Жөнүндө Эскертүү
Бул макала Ruzhen Xiang, Shijie Zheng, Nan Yin, Haixia Zhao, Liwei Hou, Qinhong Wang жана Li Chen даярдаган “Interpretable Ensemble Learning Combined with DLLME-SERS for High-Accuracy Classification and Identification of Four Trace Psychoactive Drugs in Urine” аттуу эмгекке негизделип даярдалган.
Изилдөө текстте ачык көрсөтүлгөндөй preprint изилдөө макаласы жана рецензиядан өтпөгөн. Ошондуктан жыйынтыктар рецензияланган журналда жарыяланып, көз карандысыз текшерүүдөн өткөн акыркы клиникалык/соттук ыкма катары эмес, кошумча текшерүүнү талап кылган изилдөө сунушу жана эксперименттик-методологиялык салым катары окулушу керек.
Изилдөө лабораториялык шартта жасалма заара үлгүлөрүндө жүргүзүлгөн. Колдонулган ыкма DLLME аркылуу үлгүнү байытуу, AgNP колдоосу менен SERS өлчөө, спектрдик алдын ала иштетүү, PCA негизинде белгилерди чыгаруу, алты негизги классификаторду окутуу, Jaccard ката дал келүүсүнө жараша ensemble мүчөлөрүн тандоо, weighted soft voting, көз карандысыз тест топтомун баалоо, ызы-чууга туруктуулук тести жана permutation importance-PCA loading кайра проекциясы аркылуу химиялык түшүндүрмөлүүлүк анализинен турат.
Бул мазмунда PDFде жок клиникалык ийгилик, соттук жарактуулук, талаада так колдонуу, чыныгы бейтап үлгүлөрүндө кепилденген көрсөткүч же жөнгө салуучу жактыруу тууралуу доомат кошулган эмес. Изилдөөдөгү %99.03 тактык, 0.9999 AUC, орточо ызы-чууда %98.06 көрсөткүчүнөн жогору тактык жана 5 cm⁻¹ чегиндеги чоку шайкештиги сыяктуу маанилер изилдөөдө колдонулган жасалма заара маалымат топтому жана эксперименттик шарттар контекстинде гана берилген.
Изилдөөнүн эң маанилүү илимий салымы SERS-ML тармагында жогорку тактыкты химиялык түшүндүрмөлүүлүк менен айкалыштырууга аракет кылышында. Модель тандоодо каталардын бири-бирин толуктоосун колдонуу жана модель чечимдерин баштапкы Раман толкун саны мейкиндигине кайра проекциялоо натыйжаларды статистикалык көрсөткүч менен гана эмес, химиялык манжа изи менен да бекемдөөгө багытталган.
Келечекте ыкма чыныгы клиникалык/соттук заара үлгүлөрү, кеңири зат панелдери, аралашма сценарийлери, ар башка приборлор жана көз карандысыз лабораториялар менен текшерилиши керек. Бул текшерүүлөр жүргүзүлмөйүнчө, изилдөө так диагностикалык же укуктук чечим куралы катары эмес, ылдам скрининг жана түшүндүрмөлүү спектроскопиялык жасалма интеллект изилдөөсү үчүн күчтүү методологиялык кадам катары бааланууга тийиш.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген