

Psixoaktiv maddələrdən sui-istifadə həm ictimai sağlamlıq, həm də məhkəmə elmləri baxımından getdikcə daha mühüm problemə çevrilir. Xüsusilə birdən çox dərmanın və ya oxşar kimyəvi quruluşa malik maddələrin eyni bioloji mühitdə mövcud ola bildiyi hallarda analiz yalnız “maddə varmı?” sualı ilə məhdudlaşmır. Hansı maddənin mövcud olduğu, hansı konsentrasiya intervalında olduğu və siqnalın həqiqətən həmin molekula aid olub-olmadığı da etibarlı şəkildə müəyyən edilməlidir.
Sidik maddə skrininqlərində tez-tez istifadə edilən bioloji nümunələrdən biridir. Bunun səbəbi nümunə götürülməsinin nisbətən asan və qeyri-invaziv olmasıdır. Lakin sidik analizi kimyəvi baxımdan sadə deyil. Zülallar, sidik cövhəri, duzlar, metabolitlər və digər endogen komponentlər hədəf maddələrin siqnallarını örtə bilər. Üstəlik, tədqiqatda vurğulandığı kimi, hədəf analitlər ng/mL səviyyəsində ola bilər. Yəni analiz edilən maddənin miqdarı çox aşağıdır və güclü siqnal artırma və ya ilkin zənginləşdirmə strategiyası tələb olunur.
Ənənəvi üsullar arasında GC-MS və LC-MS/MS kimi xromatoqrafiya-kütlə spektrometriyası texnikaları güclü və etibarlı hesab olunur. Lakin bu sistemlər bahalı cihazlar, təlim keçmiş personal, mürəkkəb hazırlıq prosesləri və laboratoriya infrastrukturu tələb edir. İmmunoxromatoqrafik testlər sürətli ola bilər; lakin çarpaz reaksiya, yanlış müsbət nəticə və çoxlu maddələrin fərqləndirilməsində məhdudiyyət kimi problemlər daşıya bilər. Buna görə tədqiqatçılar daha sürətli, daha aşağı xərcli və molekulyar barmaq izi verə bilən spektroskopik yanaşmalara yönəlirlər.
Raman spektroskopiyası molekulların vibrasiya modlarından asılı olaraq “kimyəvi barmaq izi” yaradan texnikadır. Hər molekul rabitə quruluşuna və vibrasiya xüsusiyyətlərinə uyğun olaraq müəyyən dalğa ədədlərində siqnal verir. Lakin adi Raman siqnalı çox vaxt zəif olur. Burada SERS üsulu işə düşür. Gümüş və ya qızıl kimi nəcib metal nanostrukturlar molekula yaxın sahədə elektromaqnit sahəsini gücləndirərək Raman siqnalını bir neçə tərtib artıra bilər. Beləliklə, normalda çox zəif qalacaq iz səviyyəli molekulyar siqnallar ölçülə bilən hala gəlir.
Bu tədqiqatda SERS-dən əvvəl DLLME tətbiq edilmişdir. DLLME-nin məqsədi sidikdəki hədəf maddələri kiçik bir üzvi fazaya çəkmək və siqnal alınacaq şəkildə konsentrə etməkdir. Gündəlik bir bənzətmə ilə, böyük bir stəkan suyun içində çox az miqdarda həll olmuş maddə olduğunu düşünək. Bu maddəni birbaşa ölçmək çətin ola bilər. Lakin onu kiçik bir damcı daxilində konsentrə edə bilsəniz, ölçüm xeyli daha aydın olar. DLLME oxşar məntiqlə işləyir: mürəkkəb nümunədə aşağı səviyyədə olan hədəf molekulları kiçik həcmli həlledici fazada zənginləşdirir.
Tədqiqatda nümunənin hazırlanması prosesi bir neçə mərhələdən ibarətdir. Əvvəlcə süni sidik nümunələrinə hədəf dərmanlar əlavə edilmişdir. Sidiyin təmizlənməsi üçün 2.0 mL spiked artificial urine, yəni maddə əlavə edilmiş süni sidik nümunəsi götürülmüş, üzərinə 100 mg PSA əlavə edilmiş, qarışıq vortekslənmiş və sentrifuqadan keçirilmişdir. Daha sonra üst fazadan 1.0 mL götürülərək ekstraksiya mərhələsinə keçilmişdir.
DLLME mərhələsində nümunənin pH dəyəri 9.5-ə tənzimlənmişdir. Ardınca 100 μL diklorometan ekstraksiya həlledicisi və 300 μL aseton dispersiv həlledicisi sürətlə əlavə edilmişdir. Qarışıq vortekslənərək bulanıq emulsiya yaradılmış, sentrifuqadan sonra aşağı üzvi faza mikroşprislə toplanmışdır. Bu mərhələ hədəf molekulların analiz üçün daha münasib fazada konsentrə edilməsini təmin edir.
SERS siqnalının gücləndirilməsi üçün gümüş nanohissəciklərdən istifadə edilmişdir. AgNPs kimi qısaldılan bu hissəciklər Lee-Meisel sitrat reduksiya üsulu ilə hazırlanmışdır. Tədqiqatda gümüş nitrat məhlulu qaynadılmış, trisodium sitrat məhlulu əlavə edilmiş və məhlulun sarı-yaşıl rəngə çevrilməsi ilə nanohissəciklərin yaranması müşahidə edilmişdir. SEM xarakterizasiyasına görə hissəciklər təxminən 60 nm orta diametrə malik yarımsferik morfologiya göstərmişdir.
Spektral ölçmədə laboratoriyada qurulmuş daşına bilən Raman aşkarlama sistemindən istifadə edilmişdir. Sistem 633 nm lazerlə işləmişdir. Üzvi fazadan 50 μL götürülmüş, bərabər həcmdə konsentrə edilmiş gümüş nanohissəcik məhlulu ilə qarışdırılmış, sonra 10 μL qarışıq alüminium folqa ilə örtülmüş təmiz şüşə slaydın üzərinə damızdırılmışdır. Hər nümunə üçün damcı səthinin müxtəlif nöqtələrindən beş spektr götürülmüş və onların ortalaması həmin nümunənin təmsilçi spektri kimi istifadə edilmişdir.
Məlumat dəsti olduqca nizamlı şəkildə qurulmuşdur. Hər hədəf dərman üçün 15 konsentrasiya səviyyəsində 20 müstəqil hazırlanmış nümunə ölçülmüşdür. Bu, 4 dərman × 15 konsentrasiya × 20 nümunə hesabı ilə 1200 müsbət spektr deməkdir. Bundan əlavə, eyni prosedurdan keçirilmiş boş süni sidikdən 1200 mənfi spektr alınmışdır. Beləliklə, ümumilikdə 2400 spektr əldə edilmişdir. Spektral diapazon 159–1996 cm⁻¹ kimi göstərilmişdir.
Xam Raman/SERS spektrləri birbaşa modelə verilməmişdir. Əvvəlcə Savitzky-Golay smoothing ilə səs-küy azaldılmış, airPLS baseline correction ilə fon əyrisi düzəldilmiş və Min-Max normalization ilə siqnallar 0–1 intervalına miqyaslandırılmışdır. Bu cür ilkin emal mərhələləri spektroskopiyada çox vacibdir; çünki modelin həqiqi kimyəvi fərqlər əvəzinə cihaz səs-küyünü, baza xətti sürüşməsini və ya intensivlik miqyası fərqlərini öyrənməsi arzuolunmazdır.
Daha sonra məlumat dəsti 7:3 nisbətində təlim və müstəqil test dəstinə ayrılmışdır. 1680 spektr təlim dəstinə, 720 spektr isə müstəqil test dəstinə daxil edilmişdir. Xüsusilə diqqət edilməli məqam PCA və StandardScaler parametrlərinin yalnız təlim dəsti üzərində öyrənilməsi və test dəstinin eyni transformasiya ilə proyeksiya edilməsidir. Bu yanaşma informasiya sızmasının qarşısını almaq baxımından vacibdir. Əgər test dəstindən gələn məlumat ilkin emal mərhələsində modelə sızarsa, test performansı olduğundan daha yüksək görünə bilər.
Xüsusiyyət çıxarılması üçün PCA, yəni principal component analysis istifadə edilmişdir. PCA yüksəkölçülü spektral məlumatı daha az sayda komponentə endirir. Spektrdə yüzlərlə və ya minlərlə dalğa ədədi nöqtəsi ola bilər; lakin onların hamısı təsnifat üçün eyni dərəcədə məlumat daşımır. PCA məlumatdakı ən böyük variasiya mənbələrini yeni oxlara çevirərək modelə daha idarəolunan xüsusiyyət fəzası verir.
Tədqiqatda PCA komponentlərinin sayı LightGBM probe modelindən istifadə etməklə qiymətləndirilmişdir. Şəkil 3a-da göstərildiyi kimi, dəqiqlik n=8 ətrafında plato yaratmış və n=10-dan sonra nəzərəçarpacaq yaxşılaşma göstərməmişdir. Buna görə ilk 10 əsas komponent saxlanılmışdır. Bu, modelin xam spektr əvəzinə 10 ölçülü PCA xüsusiyyət fəzasında işlədiyi deməkdir.
Şəkil 3b və 3c siniflər arasındakı ayrılmanı PCA üçölçülü səpələnmə qrafiki və t-SNE yerləşdirmə üsulu ilə vizuallaşdırır. İlk üç əsas komponentə baxıldıqda siniflər arasında bəzi klasterləşmə meylləri mövcuddur; lakin sərhədlər tam aydın deyil. Xüsusilə noscapine, etomidate və mənfi nəzarət arasında üst-üstə düşmə görünə bilər. t-SNE təsviri etomidate və tramadol hydrochloride üçün daha kompakt klasterlər göstərərkən, mənfi nəzarətin bəzi sinif sərhədlərinə yayıldığını ortaya qoyur. Bu, yalnız sadə xətti ayrımın kifayət etmədiyini və təsnifatçıların daha incə fərqləndirici məlumatları çıxarmalı olduğunu göstərir.
Tədqiqatın maşın öyrənməsi hissəsində altı əsas təsnifatçı qiymətləndirilmişdir: Random Forest, Support Vector Machine, LightGBM, XGBoost, K-Nearest Neighbors və Logistic Regression. Bu modellər müxtəlif alqoritmik ailələri təmsil edir. Logistic Regression daha xətti və statistik yanaşma təqdim etdiyi halda, XGBoost və LightGBM gradient boosting əsaslı ağac modelləridir. SVM qərar sərhədi tapmağa yönəlir, KNN qonşuluq əlaqəsinə əsaslanır, Random Forest isə çoxsaylı qərar ağaclarının ortalamasından istifadə edir.
Bu altı modelin hər biri 5 qatlı çarpaz yoxlama və grid search ilə optimallaşdırılmışdır. Nəticələrə görə bütün baza modelləri %97.3-dən yüksək çarpaz yoxlama dəqiqliyinə çatmışdır. Logistic Regression ən yaxşı baza model olaraq %99.29 ± 0.24 CV5_Acc dəyəri göstərmişdir. SVM və XGBoost onu izləmişdir. Lakin tək modellərin performansı onsuz da yüksək olduğuna görə, əlavə yaxşılaşma əldə etmək üçün ensemble yanaşması zəruri hesab edilmişdir.
Tədqiqatın özgün tərəfi burada daha aydın görünür. Ensemble learning bir neçə modeli birləşdirərək daha güclü qərar istehsal etməyi hədəfləyir. Lakin hər model kombinasiyası faydalı deyil. Əgər iki model eyni nümunələrdə səhv edirsə, onları birləşdirmək çox əlavə qazanc verməz. Əksinə, iki model müxtəlif nümunələrdə səhv edirsə, biri digərinin səhvini düzəldə bilər. Tədqiqat bu fikri Jaccard error overlap index ilə kəmiyyətləşdirir.
Tədqiqatda Jaccard səhv üst-üstə düşmə indeksi aşağıdakı məntiqlə müəyyən edilmişdir:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Bu formulda Mi və Mj iki fərqli baza təsnifatçısını təmsil edir. Ei, i modelinin səhv təsnif etdiyi nümunələr çoxluğudur. Ej, j modelinin səhv təsnif etdiyi nümunələr çoxluğudur. Ei ∩ Ej iki modelin ortaq səhv etdiyi nümunələri; Ei ∪ Ej isə ən azı bir modelin səhv etdiyi ümumi nümunələr çoxluğunu göstərir. J dəyəri 0 ilə 1 arasında dəyişir. Dəyər aşağı olduqda iki modelin səhv nümunəsi daha fərqlidir; bu da ensemble daxilində bir-birini tamamlama potensialının daha yüksək ola biləcəyini göstərir.
Gündəlik nümunə ilə desək, iki nəzarət əməkdaşını düşünək. Əgər hər ikisi həmişə eyni səhvləri gözdən qaçırırsa, birlikdə işləmələri çox əlavə fayda verməz. Lakin biri A tipli səhvləri, digəri B tipli səhvləri daha yaxşı aşkarlayırsa, birlikdə daha etibarlı nəticə verirlər. Jaccard səhv üst-üstə düşmə indeksi modellərin “eyni səhvləri edirlər, yoxsa fərqli səhvləri?” sualına rəqəmsal cavab verir.
Tədqiqatçılar bu indeksdən istifadə edərək select-the-best, pair-the-best adlı iki mərhələli seçim meyarı təklif etmişlər. İlk mərhələdə CV5_Acc dəyəri ən yüksək olan baza model məcburi üzv kimi seçilmişdir. Bu model Logistic Regression-dır. İkinci mərhələdə Logistic Regression ilə digər modellər arasındakı Jaccard səhv üst-üstə düşməsi hesablanmış, bütün ikili Jaccard dəyərlərinin medianı hədd kimi götürülmüşdür. LR ilə bu həddən aşağı səhv üst-üstə düşməsi göstərən modellər yaxşı uyğunlaşma namizədi hesab edilmişdir.
Nəticədə proqnozlaşdırılan ən yaxşı kombinasiya dəsti aşağıdakı kimi yaranmışdır:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Burada S nəzəri baxımdan üstün olması gözlənilən ikili ensemble kombinasiyalarını ifadə edir. Tədqiqatın mühüm cəhəti budur ki, bu dəst yalnız proqnoz olaraq saxlanılmamışdır. Tədqiqatçılar altı modeldən yarana biləcək bütün 15 ikili kombinasiyanı exhaustive comparison, yəni hərtərəfli müqayisə ilə sınaqdan keçirmişlər.
Hərtərəfli müqayisə nəticəsində CV5_Acc sıralamasında ilk dörd kombinasiya həqiqətən də LR+XGBoost, LR+LightGBM, LR+RF və LR+KNN olmuşdur. Bu nəticə Jaccard səhv üst-üstə düşməsi ilə istiqamətləndirilən “select-the-best, pair-the-best” meyarının proqnoz gücünü dəstəkləyir. Xüsusilə LR+XGBoost kombinasiyası %99.40 ± 0.42 CV5_Acc dəyəri ilə birinci yerdə olmuşdur. LR+LightGBM %99.35 ± 0.39, LR+RF və LR+KNN isə %99.29 ± 0.24 dəyərlərinə çatmışdır.
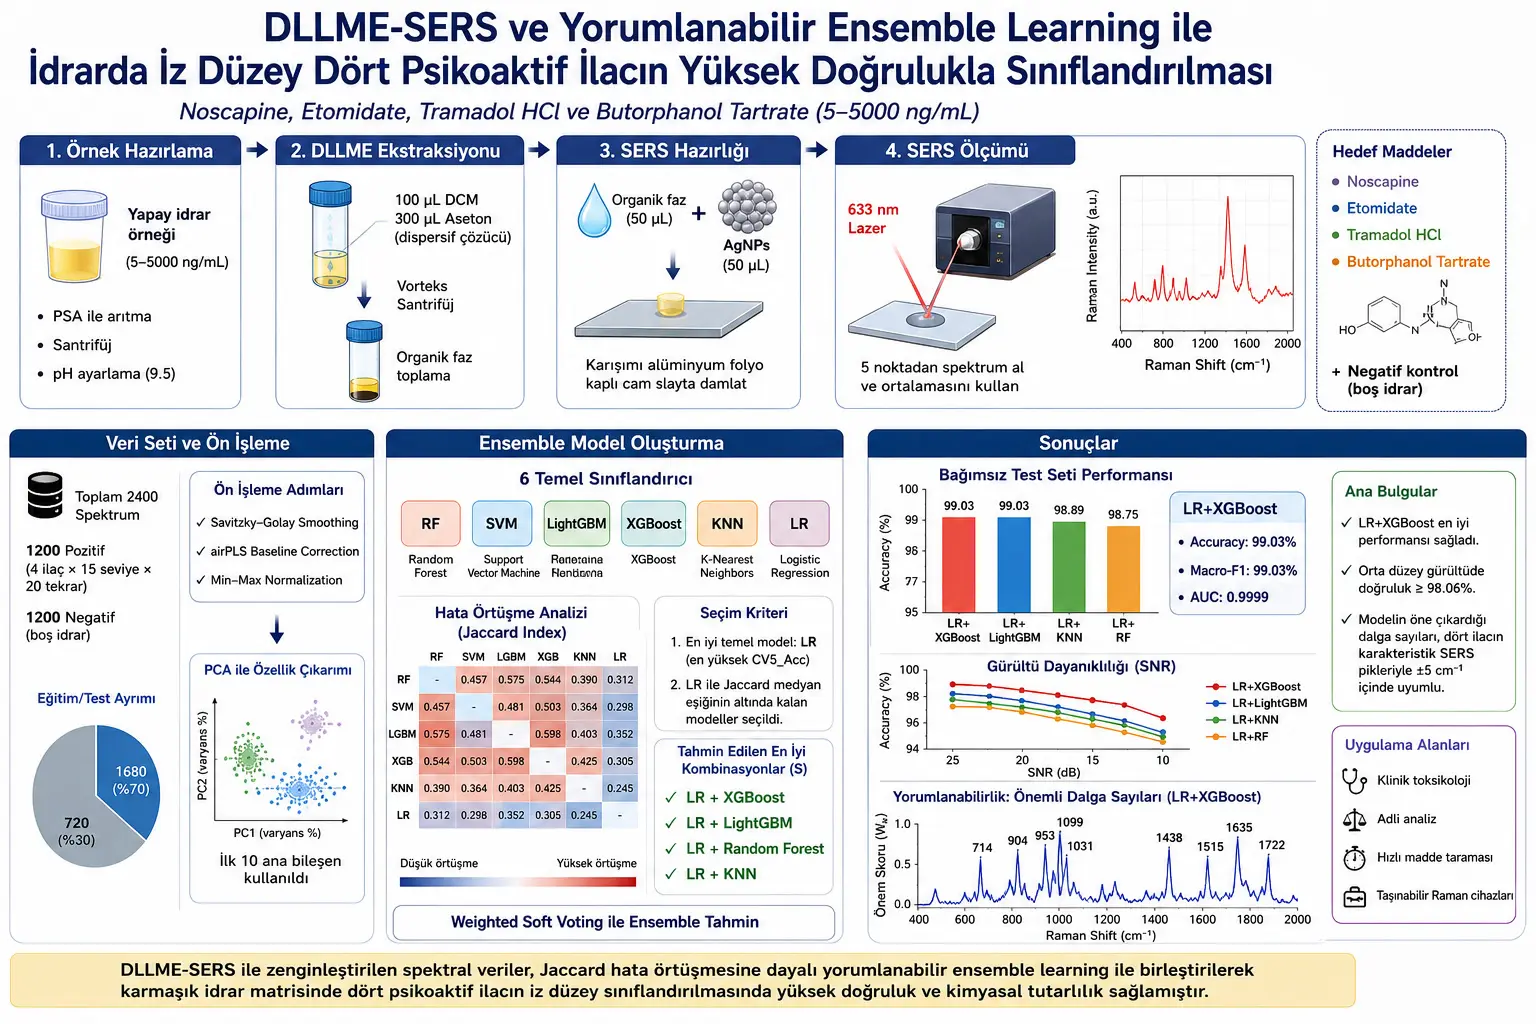
Müstəqil test dəstindəki nəticələr də bu çərçivəni dəstəkləyir. S dəstindəki dörd kombinasiyanın dəqiqlik göstəriciləri %98.75 ilə %99.03 arasında dəyişmişdir. LR+XGBoost və LR+LightGBM ən yaxşı ümumi performansı göstərmiş, hər ikisi %99.03 Accuracy və %99.03 Macro-F1 dəyərinə çatmışdır. Nəzarət kombinasiyalarından LightGBM+XGBoost yalnız %97.92 dəqiqlik vermişdir. Bu, eyni alqoritmik ailəyə yaxın və yüksək səhv üst-üstə düşməsinə malik modellərin birləşdirilməsinin hər zaman yaxşı nəticə vermədiyini göstərir.
Tədqiqatdakı sinif əsaslı qiymətləndirmə modelin hansı maddələrdə daha çox çətinlik çəkdiyini də ortaya qoyur. Mənfi nəzarət, noscapine və butorphanol tartrate daha yüksək recall dəyərləri göstərərkən, etomidate və tramadol hydrochloride daha aşağı recall meyli göstərmişdir. Bunun kimyəvi səbəbi iki maddənin benzol halqasının nəfəsalma vibrasiyalarının təxminən 1000 cm⁻¹ ətrafında ciddi şəkildə üst-üstə düşməsidir. Yəni modelin çətinlik çəkdiyi sahə təsadüfi səhv deyil, kimyəvi spektrlərin həqiqətən bir-birinə yaxınlaşdığı bölgədir.
Tədqiqatda səs-küyə davamlılıq ayrıca sınaqdan keçirilmişdir. Test dəstinə 25, 20, 15 və 10 dB SNR səviyyələrində Qauss ağ səs-küyü əlavə edilmişdir. Orta səviyyəli səs-küydə, xüsusilə 15 dB SNR şəraitində, S dəstindəki dörd kombinasiyanın dəqiqliyi %98.06-dan yüksək qalmışdır. Güclü səs-küy şəraiti olan 10 dB-də belə bu kombinasiyaların dəqiqliyi %96.53 səviyyəsində qalmışdır. Bu tapıntı seçilmiş modellərin yalnız təmiz spektrlərdə deyil, siqnal pozulduqda da nisbətən sabit qaldığını göstərir.
Lakin bu nəticələri şərh edərkən ehtiyatlı olmaq lazımdır. Səs-küyə davamlılıq real klinik nümunələrdəki bütün mürəkkəbliyi təmsil etmir. Real sidik nümunələri fərdlərarası metabolik fərqlər, dərman metabolitləri, müxtəlif pH, yanaşı maddələr, böyrək funksiyası, qidalanma, xəstəlik, kontaminasiya və nümunənin saxlanma şəraiti kimi çoxsaylı dəyişənlərə malikdir. Tədqiqat süni sidik üzərində aparıldığı üçün real klinik/məhkəmə doğrulaması növbəti mərhələ kimi zəruridir.
Tədqiqatın digər güclü cəhəti interpretasiya edilə bilənlik zənciridir. Maşın öyrənməsi modelləri yüksək dəqiqlik versə belə, kimyəvi analizdə “model niyə belə qərar verdi?” sualı çox vacibdir. Əgər modelin qərarı real molekulyar piklərə deyil, məlumat emalı artefaktlarına və ya təsadüfi səs-küyə əsaslanırsa, yüksək dəqiqlik etibarlı kimyəvi sübut anlamına gəlməyə bilər. Buna görə tədqiqatçılar permutation importance dəyərlərini PCA yükləri vasitəsilə orijinal dalğa ədədi fəzasına geri proyeksiya etmişlər.
Bu interpretasiya edilə bilənlik üçün istifadə olunan əlaqə tədqiqatda belə verilmişdir:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Bu formulda Wk k-cı dalğa ədədi nöqtəsinə aid ümumi əhəmiyyət balını göstərir. PIi i-ci əsas komponentin permutation importance dəyəridir. Lik k-cı dalğa ədədinin i-ci əsas komponentdəki yük əmsalıdır. n saxlanılan əsas komponentlərin sayıdır. Tədqiqatda n=10 olaraq müəyyən edilmişdir. Formulun məqsədi modelin PCA fəzasındakı qərar töhfəsini yenidən orijinal Raman dalğa ədədi oxuna daşımaqdır.
Bunu belə düşünə bilərik: Model xam spektri birbaşa deyil, PCA komponentlərindən istifadə etməklə öyrənmişdir. Lakin kimyəvi interpretasiya xam dalğa ədədlərində aparılır. Buna görə “model üçün hansı PCA komponenti mühüm idi?” sualını “bu əhəmiyyət hansı Raman dalğa ədədlərinə uyğun gəlir?” sualına çevirmək lazımdır. Back-projection, yəni geri proyeksiya bunu təmin edir.
Interpretasiya edilə bilənlik analizində önə çıxan dalğa ədədləri dörd dərmanın xarakterik SERS pikləri ilə böyük ölçüdə uyğun olmuşdur. Noscapine üçün 904 cm⁻¹ və 1635 cm⁻¹, etomidate üçün 952/953 cm⁻¹, 1030/1031 cm⁻¹ və 1726/1722 cm⁻¹, tramadol hydrochloride üçün 715/714 cm⁻¹ və 1000/999 cm⁻¹, butorphanol tartrate üçün 1437/1438 cm⁻¹ və 1515 cm⁻¹ sahələri həlledici kimi görünmüşdür. Tədqiqatda bu yayınmaların 5 cm⁻¹ daxilində qaldığı bildirilir.
Bu vəziyyət elmi baxımdan əhəmiyyətlidir. Çünki model yalnız statistik təsnifatçı kimi davranmamış; qərarlarında real kimyəvi vibrasiya modlarına uyğun bölgələrdən istifadə etmişdir. Məsələn, noscapine-in lakton halqasının C-O-C gərilməsi 904 cm⁻¹ ətrafında modelin ən vacib piki kimi tapılmışdır. Butorphanol tartrate üçün 1438 cm⁻¹ sahəsi aromatik C=C gərilməsi ilə əlaqələndirilmişdir. Tramadol və etomidate üçün 1000 cm⁻¹ ətrafındakı üst-üstə düşmə bu iki sinfin daha çətin ayrılmasının kimyəvi qarşılığını izah edir.
Tədqiqatın qrafik xülasəsi və Şəkil 1 metodun ümumi axınını vizual şəkildə izah edir. Birinci hissədə sidik nümunəsi, DLLME ilə ekstraksiya, AgNPs ilə SERS siqnalının alınması və spektral ölçmə göstərilir. Orta hissədə RF, SVM, LightGBM, XGBoost, KNN və LR modellərinin seçilməsi, Jaccard səhv üst-üstə düşmə matrisi və LR mərkəzli kombinasiyaların qurulması yer alır. Son hissədə ensemble modelinin qiymətləndirilməsi, səs-küyə davamlılıq və dalğa ədədi əhəmiyyət qrafikləri göstərilir. Bu vizual tədqiqatın laboratoriya kimyası ilə süni intellekt model seçimini vahid proses kimi qurduğunu aydın şəkildə göstərir.
Şəkil 2 dörd dərmanın müxtəlif konsentrasiyalardakı DLLME-SERS spektrlərini göstərir. Spektrlərdə konsentrasiya artdıqca xarakterik pik intensivliklərinin artdığı, pik mövqelərinin isə sabit qaldığı bildirilir. Bu, metodun konsentrasiya dəyişməsinə həssas siqnal yaratdığını, lakin molekulyar barmaq izi mövqelərini qoruduğunu göstərir. Eyni zamanda etomidate və tramadol hydrochloride üçün 1000 cm⁻¹ ətrafında pik üst-üstə düşməsi olduğuna görə çılpaq gözlə fərqləndirmənin çətinləşə biləcəyi anlaşılır.
Şəkil 4 model seçiminin niyə yalnız “ən yüksək dəqiqliyə malik iki modeli birləşdir” məntiqi ilə aparıla bilməyəcəyini göstərir. Baza modellərin fərdi performansları yüksəkdir; lakin səhv üst-üstə düşmə matrisi bəzi modellərin oxşar səhvlər etdiyini ortaya qoyur. Xüsusilə ağac əsaslı modellər arasında səhv üst-üstə düşməsinin yüksək olması onları birləşdirməyin məhdud ensemble qazancı verə biləcəyini göstərir. Əksinə, LR ilə KNN, RF, LightGBM və XGBoost arasındakı daha aşağı Jaccard dəyərləri tamamlayıcılıq potensialını göstərir.
Şəkil 5 müstəqil test dəsti performansını, sinif əsaslı metrikləri, səs-küyə davamlılığı və interpretasiya edilə bilən dalğa ədədi əhəmiyyət paylanmasını birlikdə təqdim edir. Bu şəklin ən vacib mesajı modelin yalnız yüksək dəqiqlik vermədiyi; həm də səs-küy altında sabit qaldığı və qərarlarını kimyəvi baxımdan mənalı dalğa ədədi sahələrinə əsaslandırdığıdır.
Tədqiqatın keçmiş baxımından əhəmiyyəti SERS-ML ədəbiyyatındakı iki çatışmazlığı hədəfləməsidir. Birincisi, ensemble model üzvlərinin çox vaxt kəmiyyət əsaslandırması olmadan seçilməsidir. İkincisi, model qərarlarının hansı Raman sürüşmələrinə əsaslandığının kimyəvi baxımdan izlənə bilməməsidir. Bu tədqiqat həm model seçimini səhv tamamlayıcılığı ilə əsaslandırmağa, həm də model qərarını kimyəvi piklərlə əlaqələndirməyə çalışır.
Bu gün baxımından tədqiqat sürətli skrininq ehtiyacına cavab verir. Klinik toksikologiya, məhkəmə laboratoriyaları və maddədən sui-istifadənin monitorinqi sahələrində yüksək həssaslığa malik, sürətli və daşına bilən sistemlərə ehtiyac vardır. DLLME-SERS kimi spektroskopik yanaşmalar kütlə spektrometriyası qədər yekun təsdiq gücü vəd etməsə də, sürətli ilkin skrininq və ya sahəyə yaxın analiz üçün dəyərli ola bilər.
Gələcək baxımından tədqiqat interpretasiya edilə bilən kimyəvi süni intellekt modellərinin əhəmiyyətini göstərir. Analitik kimyada süni intellektin yalnız “düzgün proqnoz verən qara qutu” olması kifayət deyil. Xüsusilə məhkəmə və klinik kontekstlərdə modelin niyə qərar verdiyi, hansı kimyəvi pikə əsaslandığı və bu qərarın real molekulyar vibrasiyalarla uyğun olub-olmadığı izah edilməlidir. Bu tədqiqat PCA yükləri ilə geri proyeksiya və permutation importance birləşməsindən bu məqsədlə istifadə edir.
Tədqiqatın güclü tərəfləri arasında nizamlı məlumat dəstinin qurulması, müstəqil test dəstindən istifadə, informasiya sızmasının qarşısını almağa yönəlmiş təlim/test ayrımı, bütün 15 ikili kombinasiyanın müqayisəsi, səs-küyə davamlılıq testi və kimyəvi interpretasiya edilə bilənlik analizi yer alır. Bundan əlavə, modelin qərar dalğa ədədlərinin xarakterik SERS pikləri ilə uyğunluğunun göstərilməsi nəticələrin kimyəvi baxımdan daha mənalı şərh edilməsinə imkan verir.
Bunun əksinə, məhdudiyyətlər də aydın şəkildə göstərilməlidir. Tədqiqat hakem rəyindən keçməmiş preprintdir. Nümunələr real klinik sidik deyil, süni sidikdir. Dörd dərmanla məhdudlaşır. Jaccard əsaslı seçim meyarı altı namizəd təsnifatçı üzərində sınaqdan keçirilmişdir; daha böyük model hovuzlarında eyni şəkildə işləyib-işləməyəcəyi araşdırılmalıdır. Bundan əlavə, real məhkəmə nümunələrində qarışıqlar, metabolitlər, parçalanma məhsulları, müxtəlif şəxslərin sidik tərkibi və çoxlu maddələrin mövcudluğu daha mürəkkəb ola bilər.
Tədqiqatın dediyi budur: DLLME-SERS ilə əldə edilən iz səviyyəli spektral məlumatlar düzgün ilkin emal, PCA əsaslı xüsusiyyət çıxarılması, Jaccard səhv tamamlayıcılığına görə seçilmiş ensemble modelləri və kimyəvi interpretasiya edilə bilənlik zənciri ilə yüksək dəqiqliklə təsnif edilə bilər. Tədqiqatın demədiyi isə budur: Bu metod bu gündən etibarən real klinik/məhkəmə sidik nümunələrində qəti diaqnoz və ya hüquqi sübut kimi istifadəyə hazırdır. Bunun üçün autentik nümunələrlə, daha geniş dərman panelləri ilə, qarışıq ssenariləri ilə və müstəqil laboratoriya doğrulamaları ilə əlavə tədqiqatlar tələb olunur.
Tədqiqatın Metodu və Nəticələri
Tədqiqat süni sidik matrisində dörd psixoaktiv dərmanın iz səviyyəli təsnifatı üçün laboratoriya analizini maşın öyrənməsi ilə birləşdirən eksperimental və hesablama əsaslı tədqiqat dizaynına malikdir.
Hədəf maddələr:
| Maddə | Tədqiqatdakı Rolu | Önə Çıxan SERS Pik Sahələri |
| Noscapine | Dörd hədəf psixoaktiv dərmandan biri. | 904 cm⁻¹ və 1635 cm⁻¹. |
| Etomidate | Benzol halqasının vibrasiyaları ilə fərqləndirilməyə çalışılan hədəf maddə. | 952, 1004, 1030 və 1726 cm⁻¹. |
| Tramadol hydrochloride | 1000 cm⁻¹ ətrafında etomidate ilə pik üst-üstə düşməsi göstərən hədəf maddə. | 715 və 1000 cm⁻¹. |
| Butorphanol tartrate | Aromatik C=C gərilmə sahələri ilə fərqləndirilən hədəf maddə. | 1437 və 1515 cm⁻¹. |
Nümunənin hazırlanması və SERS ölçümü:
- Süni sidik nümunələrinə hədəf maddələr spike edilmişdir.
- Sidiyin təmizlənməsi üçün 2.0 mL nümunəyə 100 mg PSA əlavə edilmiş, vorteksləmə və sentrifuqalama aparılmışdır.
- DLLME üçün pH 9.5-ə tənzimlənmiş, 100 μL diklorometan və 300 μL aseton istifadə edilmişdir.
- Gümüş nanohissəciklər Lee-Meisel sitrat reduksiya üsulu ilə hazırlanmışdır.
- AgNP-lərin təxminən 60 nm orta diametrə malik yarımsferik quruluşda olduğu bildirilmişdir.
- SERS ölçmələri 633 nm lazerli daşına bilən Raman sistemi ilə aparılmışdır.
- Hər nümunə üçün beş müxtəlif nöqtədən spektr götürülmüş və orta spektr istifadə edilmişdir.
Məlumat dəsti:
| Məlumat Elementi | Dəyər | Mənası |
| Hədəf dərman sayı | 4 | Noscapine, etomidate, tramadol hydrochloride, butorphanol tartrate. |
| Konsentrasiya intervalı | 5–5000 ng/mL | İz səviyyədən daha yüksək intervala qədər uzanan təsnifat diapazonu. |
| Konsentrasiya səviyyəsi | 15 | Hər dərman üçün müxtəlif konsentrasiya nöqtələrindən istifadə edilmişdir. |
| Hər konsentrasiyada müstəqil nümunə | 20 | Hər hədəf dərman üçün 15 × 20 nümunə hazırlanmışdır. |
| Müsbət spektr | 1200 | 4 × 15 × 20 hesabı ilə əldə edilmişdir. |
| Mənfi spektr | 1200 | Boş süni sidik nümunələrindən alınmışdır. |
| Ümumi spektr | 2400 | Modelləşdirmə üçün istifadə edilən ümumi məlumat. |
| Təlim/test bölgüsü | 1680 / 720 | 7:3 nisbətində bölünmüşdür. |
| Spektral diapazon | 159–1996 cm⁻¹ | SERS ölçüm dalğa ədədi diapazonu. |
İlkin emal mərhələləri:
- Savitzky-Golay smoothing: pəncərə ölçüsü 11, polinom dərəcəsi 3.
- airPLS baseline correction: λ = 10⁵, maksimum iterasiya 100, yaxınlaşma tolerantlığı 10⁻⁶.
- Min-Max normalization: siqnallar 0–1 intervalına miqyaslandırılmışdır.
- PCA ilə xüsusiyyət çıxarılması aparılmışdır.
- İlk 10 əsas komponent modelləşdirmə üçün saxlanılmışdır.
- İnformasiya sızmasının qarşısını almaq üçün PCA və StandardScaler yalnız təlim dəstində fit edilmişdir.
İstifadə olunan baza təsnifatçıları:
| Model | Qısaltma | Tədqiqatdakı Rolu |
| Random Forest | RF | Ağac əsaslı ensemble baza modeli. |
| Support Vector Machine | SVM | Qərar sərhədinə yönəlmiş təsnifatçı. |
| LightGBM | LGBM | Gradient boosting ağac modeli. |
| XGBoost | XGB | Güclü gradient boosting ağac modeli. |
| K-Nearest Neighbors | KNN | Qonşuluq əlaqəsinə əsaslanan təsnifatçı. |
| Logistic Regression | LR | Ən yüksək baza CV5_Acc dəyərini verən məcburi ensemble üzvü. |
Jaccard səhv üst-üstə düşmə formulu:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Bu formulda Ei və Ej iki fərqli modelin səhv təsnif etdiyi nümunə çoxluqlarıdır. J dəyəri aşağı olduqda modellərin səhv nümunələri daha fərqli olur və ensemble daxilində bir-birini tamamlama ehtimalı yüksəlir.
Model seçim meyarı:
- Select-the-best: CV5_Acc dəyəri ən yüksək baza model seçilir. Bu tədqiqatda LR seçilmişdir.
- Pair-the-best: LR ilə digər modellər arasındakı Jaccard səhv üst-üstə düşməsi hesablanır.
- Bütün 15 ikili Jaccard dəyərinin medianı hədd kimi götürülmüşdür.
- LR ilə həddən aşağı səhv üst-üstə düşməsi göstərən modellər yaxşı uyğunlaşma namizədi hesab edilmişdir.
Proqnozlaşdırılan ən yaxşı ensemble dəsti:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Baza model və ensemble nəticələri:
| Nəticə | Rəqəmsal Nəticə | Şərh |
| Bütün baza modellərinin CV5_Acc dəyəri | Ən az %97.3 | 10 ölçülü PCA xüsusiyyət fəzası güclü təsnifat məlumatı daşıyır. |
| Ən yaxşı baza model | LR, %99.29 ± 0.24 CV5_Acc | Ən yüksək fərdi performansı göstərdiyi üçün məcburi ensemble üzvü edilmişdir. |
| Jaccard intervalı | 0.245–0.575 | Modellərin səhv üst-üstə düşməsi əhəmiyyətli dərəcədə fərqlənmişdir. |
| Median Jaccard həddi | 0.361 | LR ilə bu həddən aşağı qalan modellər seçilmişdir. |
| LR+XGBoost CV5_Acc | %99.40 ± 0.42 | Hərtərəfli müqayisədə ən üst kombinasiya olmuşdur. |
| LR+LightGBM CV5_Acc | %99.35 ± 0.39 | İkinci ən güclü kombinasiyalardan biridir. |
| LR+RF və LR+KNN CV5_Acc | %99.29 ± 0.24 | Proqnozlaşdırılan yaxşı kombinasiya dəsti ilə uyğundur. |
Müstəqil test dəsti nəticələri:
| Model / Kombinasiya | Nəticə | Şərh |
| LR+XGBoost | %99.03 Accuracy, %99.03 Macro-F1, AUC 0.9999 | Ən yaxşı ümumi performans göstərən kombinasiyalardan biri. |
| LR+LightGBM | %99.03 Accuracy və Macro-F1 | LR+XGBoost ilə eyni test dəqiqliyinə çatmışdır. |
| LR+KNN | %98.89 Accuracy | Proqnozlaşdırılan yaxşı dəstin daxilindədir. |
| LR+RF | %98.75 Accuracy | Proqnozlaşdırılan yaxşı dəstin daxilindədir. |
| SVM+LR | %98.72 Accuracy | Performansı yaxın olsa da səhv üst-üstə düşməsi yüksəkdir. |
| LightGBM+XGBoost | %97.92 Accuracy | Eyni ailəyə yaxın modellərin yüksək səhv üst-üstə düşməsi ensemble qazancını məhdudlaşdırmışdır. |
Səs-küyə davamlılıq:
- Test dəstinə 25, 20, 15 və 10 dB SNR səviyyələrində Qauss ağ səs-küyü əlavə edilmişdir.
- 15 dB kimi orta səviyyəli səs-küy şəraitində S dəstindəki dörd kombinasiya %98.06-dan yüksək dəqiqlik göstərmişdir.
- 10 dB kimi daha güclü səs-küy şəraitində dəqiqlik %96.53 səviyyəsində qalmışdır.
- LR+LightGBM 25 dB SNR-də %99.17 dəqiqlik göstərmişdir; bu fərqin 720 nümunədən yalnız bir nümunəyə uyğun gələn kiçik dalğalanma olduğu bildirilmişdir.
- S dəstindəki kombinasiyalar homogen səhv nümunəsinə malik LightGBM+XGBoost nəzarətindən daha davamlı görünmüşdür.
Kimyəvi interpretasiya edilə bilənlik formulu:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Bu formulda Wk k-cı dalğa ədədi nöqtəsinin ümumi əhəmiyyət balını; PIi i-ci əsas komponentin permutation importance dəyərini; Lik k-cı dalğa ədədinin i-ci PCA komponentindəki yükünü; n isə istifadə olunan əsas komponent sayını göstərir. Bu geri proyeksiya model qərarının hansı Raman dalğa ədədi sahələrinə əsaslandığını izah etmək üçün istifadə edilmişdir.
Modelin önə çıxardığı kimyəvi dalğa ədədləri:
| Dalğa Ədədi | Əlaqələndirilən Mənbə | Kimyəvi Mənası |
| 904 cm⁻¹ | Noscapine | Lakton halqasının C-O-C gərilməsi. |
| 1438 cm⁻¹ | Butorphanol tartrate | Aromatik C=C gərilmə sahəsi. |
| 1635 cm⁻¹ | Noscapine | Aromatik C=C gərilməsi. |
| 953 cm⁻¹ | Etomidate | Benzol halqasının müstəvidənkənar deformasiyası. |
| 999 cm⁻¹ | Tramadol / Etomidate | Üst-üstə düşən benzol halqası nəfəsalma modu. |
| 714 cm⁻¹ | Tramadol hydrochloride | Benzol halqası ilə əlaqəli vibrasiya. |
| 1031 cm⁻¹ | Etomidate | Benzol/imidazol halqası vibrasiyası. |
| 1515 cm⁻¹ | Butorphanol tartrate | Aromatik C=C gərilməsi. |
| 1722 cm⁻¹ | Etomidate | Karbonil C=O gərilməsi. |
| 449 və 1397 cm⁻¹ | Substrat / matris | AgNP/sitrat və ya sidik matrisi ilə əlaqəli fon dəyişiklikləri. |
Tədqiqatın əsas nəticələri:
- DLLME-SERS süni sidikdə dörd psixoaktiv dərmanın 5–5000 ng/mL intervalında iz səviyyəli təsnifatı üçün istifadə edilə bilən spektral məlumat yaratmışdır.
- Konsentrasiya artdıqca xarakterik pik intensivlikləri artmış, pik mövqeləri sabit qalmışdır.
- Etomidate və tramadol hydrochloride-ın təxminən 1000 cm⁻¹ ətrafındakı pik üst-üstə düşməsi vizual ayrımı çətinləşdirmişdir.
- İlk 10 PCA komponenti təsnifat üçün kifayət edən xüsusiyyət fəzası kimi seçilmişdir.
- Jaccard səhv üst-üstə düşmə indeksi ensemble üzvlərinin səhv tamamlayıcılığını kəmiyyətcə qiymətləndirmişdir.
- “Select-the-best, pair-the-best” meyarı 15 ikili kombinasiya içindən ən yaxşı dörd kombinasiyanı düzgün proqnozlaşdırmışdır.
- LR+XGBoost və LR+LightGBM müstəqil test dəstində %99.03 dəqiqlik və Macro-F1 dəyərlərinə çatmışdır.
- LR+XGBoost ümumi performans və davamlılıq balansına görə kimyəvi interpretasiya edilə bilənlik analizi üçün təmsilçi model kimi seçilmişdir.
- Modelin fərqləndirici dalğa ədədləri dörd dərmanın xarakterik SERS pikləri ilə 5 cm⁻¹ daxilində uyğunluq göstərmişdir.
Tədqiqatın məhdudiyyətləri:
- Tədqiqat hakem rəyindən keçməmiş preprintdir.
- Nümunələr real klinik/məhkəmə sidiyi deyil, süni sidikdir.
- Yalnız dörd hədəf maddə qiymətləndirilmişdir.
- Jaccard əsaslı seçim meyarı altı namizəd təsnifatçı ilə sınaqdan keçirilmişdir; daha böyük model hovuzları üçün əlavə tədqiqat tələb olunur.
- Real nümunələrdə metabolitlər, qarışıqlar, müxtəlif sidik tərkibləri və çoxlu maddələrin mövcudluğu metodun performansını dəyişə bilər.
- Tədqiqat sürətli skrininq üçün metodoloji istinad təqdim etsə də, birbaşa klinik/məhkəmə qəti təsdiqi iddiası daşımır.
Mənbə və Metod Qeydi
Bu məqalə Ruzhen Xiang, Shijie Zheng, Nan Yin, Haixia Zhao, Liwei Hou, Qinhong Wang və Li Chen tərəfindən hazırlanmış “Interpretable Ensemble Learning Combined with DLLME-SERS for High-Accuracy Classification and Identification of Four Trace Psychoactive Drugs in Urine” başlıqlı tədqiqata əsaslanaraq hazırlanmışdır.
Tədqiqat mətnin özündə açıq şəkildə göstərildiyi kimi preprint tədqiqat məqaləsidir və hakem rəyindən keçməmişdir. Buna görə nəticələr hakemli jurnalda dərc olunmuş və müstəqil doğrulamalardan keçmiş yekun klinik/məhkəmə metodu kimi deyil, əlavə doğrulama tələb edən tədqiqat təklifi və eksperimental-metodoloji töhfə kimi oxunmalıdır.
Tədqiqat laboratoriya şəraitində süni sidik nümunələri ilə aparılmışdır. İstifadə olunan metod; DLLME ilə nümunənin zənginləşdirilməsi, AgNP dəstəkli SERS ölçümü, spektral ilkin emal, PCA əsaslı xüsusiyyət çıxarılması, altı baza təsnifatçısının öyrədilməsi, Jaccard səhv üst-üstə düşməsinə görə ensemble üzvlərinin seçilməsi, weighted soft voting, müstəqil test dəstinin qiymətləndirilməsi, səs-küyə davamlılıq testi və permutation importance-PCA loading geri proyeksiyası ilə kimyəvi interpretasiya edilə bilənlik analizindən ibarətdir.
Bu məzmuna PDF-də olmayan klinik uğur, məhkəmə etibarlılığı, sahədə qəti istifadə, real pasiyent nümunələrində zəmanətli performans və ya tənzimləyici təsdiq iddiası əlavə edilməmişdir. Tədqiqatdakı %99.03 dəqiqlik, 0.9999 AUC, orta səviyyəli səs-küydə %98.06-dan yuxarı dəqiqlik və 5 cm⁻¹ daxilində pik uyğunluğu kimi dəyərlər yalnız tədqiqatda istifadə olunan süni sidik məlumat dəsti və eksperimental şərait kontekstində təqdim edilmişdir.
Tədqiqatın ən mühüm elmi töhfəsi SERS-ML sahəsində yüksək dəqiqliyi kimyəvi interpretasiya edilə bilənliklə birləşdirməyə çalışmasıdır. Model seçimində səhv tamamlayıcılığından istifadə edilməsi və model qərarlarının orijinal Raman dalğa ədədi fəzasına geri proyeksiya edilməsi nəticələrin yalnız statistik performansla deyil, kimyəvi barmaq izi ilə də dəstəklənməsini hədəfləyir.
Gələcəkdə metodun real klinik/məhkəmə sidik nümunələri, daha geniş maddə panelləri, qarışıq ssenariləri, müxtəlif cihazlar və müstəqil laboratoriyalarda sınaqdan keçirilməsi tələb olunur. Bu doğrulamalar aparılmadan tədqiqat qəti diaqnostik və ya hüquqi qərar vasitəsi kimi deyil, sürətli skrininq və interpretasiya edilə bilən spektroskopik süni intellekt tədqiqatı üçün güclü metodoloji addım kimi qiymətləndirilməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib