

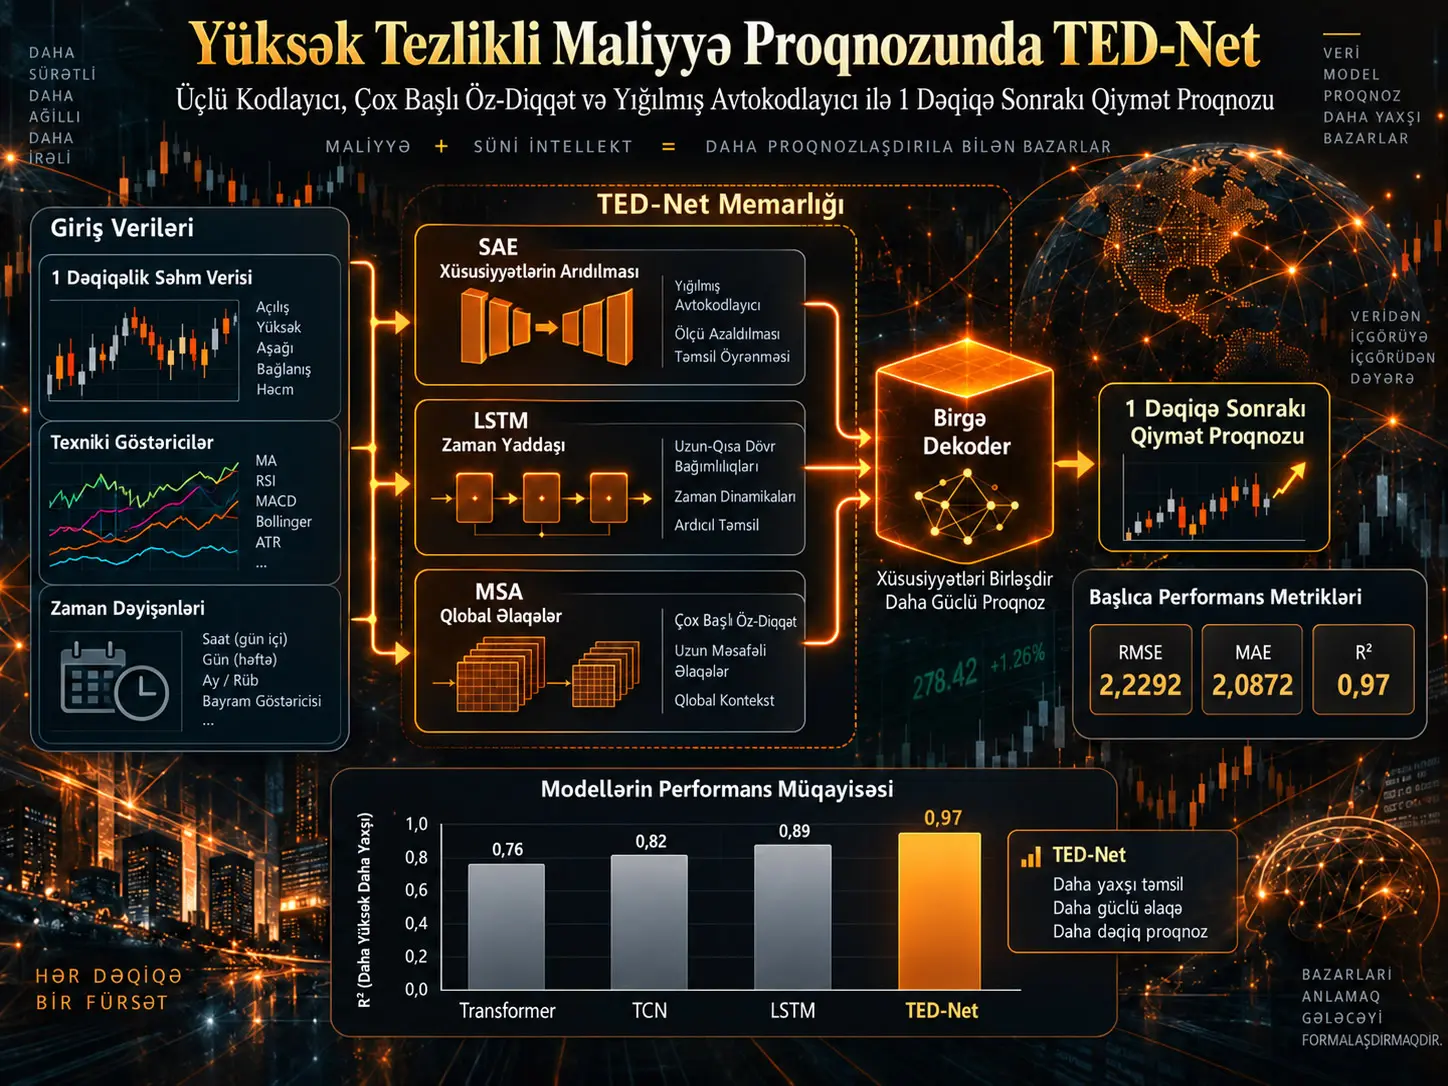
Maliyyə zaman sıraları qeyri-xətti quruluş, dəyişən statistik xüsusiyyətlər, yüksək səs-küy və uzunmüddətli asılılıqlar səbəbindən proqnoz modelləri üçün çətin məlumat mənbələridir. Bu tədqiqat bu problemləri eyni model daxilində həll etmək məqsədilə TED-Net (Triple Encoder-Decoder Network) adlı hibrid dərin öyrənmə arxitekturasını təklif edir. TED-Net üç ayrı kodlaşdırma mexanizmini birləşdirir: Stacked Autoencoder (SAE) xüsusiyyətləri təmizləyərək daha aşağıölçülü təqdimat yaradır; LSTM-Seq2Seq zaman daxilində qısa və uzunmüddətli asılılıqları öyrənir; Multi-Head Self-Attention (MSA) isə müxtəlif zaman nöqtələri və təqdimat alt-fəzaları arasındakı qlobal əlaqələri tutmağa çalışır. Bu üç məlumat mənbəyi gated fusion və attention istifadə edən collaborative decoder tərəfindən birləşdirilərək növbəti qiymət proqnozu yaradılır.
Təcrübələrdə müxtəlif sektor və bazar dəyərlərindən 15 A-share səhmi üçün hər biri 24.000 ədəd bir dəqiqəlik müşahidə istifadə edilmiş; ilk %80 təlim, son %20 doğrulama məlumatı kimi ayrılmışdır. Əsas proqnoz tapşırığında əvvəlki 30 dəqiqəlik məlumatla növbəti dəqiqənin bağlanış qiyməti proqnozlaşdırılır. Mənbədə TED-Net-in Transformer, TCN və LSTM-Seq2Seq müqayisələrində orta səhmlər üzrə cədvəllərin çoxunda və ya hamısında daha yüksək hesabatlaşdırılmış dəqiqlik göstərdiyi bildirilir. CATL üzərində aparılan ayrıca təcrübədə TED-Net üçün RMSE 2,2292, MAE 2,0872 və R² 0,97 hesabatlaşdırılmışdır.
Bununla belə, tədqiqatdakı “high-frequency trading” ifadəsi ehtiyatla şərh edilməlidir. İstifadə olunan məlumat bir dəqiqəlik zaman sıralarıdır və model real əmr dəftəri mesajları və ya mikro-saniyəlik execution axını üzərində işləmir. Bundan əlavə, tədqiqat əməliyyat strategiyasını deyil, qiymət proqnozunu sınaqdan keçirir; P&L, transaction cost, slippage, Sharpe ratio və ya canlı əmr icrası nəticələri təqdim edilmir.
| Komponent | Əsas vəzifəsi |
|---|---|
| Stacked Autoencoder — SAE | Xüsusiyyət səs-küyünü azaltmaq və daha kompakt təqdimat yaratmaq |
| LSTM-Seq2Seq | Qısa və uzunmüddətli zaman asılılıqlarını modelləşdirmək |
| Multi-Head Self-Attention — MSA | Müxtəlif zaman nöqtələri arasındakı qlobal əlaqələri tutmaq |
| Dynamic Window Attention | Uzun ardıcıllıqlarda attention hesablama sahəsini məhdudlaşdırmaq |
| Collaborative Decoder | Üç encoder-dan gələn məlumatı adaptiv şəkildə birləşdirmək |
| Çıxış | Növbəti dəqiqənin qiymət proqnozu |
TED-Net hansı üç problemi həll etməyə çalışır?
Mənbə tədqiqat yüksək tezlikli maliyyə proqnozlaşdırmasını üç əsas problem üzərindən müəyyənləşdirir.
Xüsusiyyət problemi: Maliyyə göstəriciləri bir-biri ilə yüksək korrelyasiya göstərə və əhəmiyyətli miqdarda səs-küy ehtiva edə bilər. Həddindən artıq oxşar və ya az informasiya daşıyan dəyişən modelin təlimini çətinləşdirə bilər.
Zaman problemi: Uzun ardıcıllıqlarda keçmiş məlumat zamanla itə bilər. LSTM klassik RNN-lərlə müqayisədə bu problemi azaltsa da, çox uzun ardıcıllıqlarda bütün tarixi məlumatı eyni dərəcədə qorumaqda yenə çətinlik çəkə bilər.
Korrelyasiya problemi: Tək bir ardıcıl model yaxın zaman əlaqələrini öyrənə bildiyi halda, ardıcıllığın müxtəlif hissələri arasındakı qlobal əlaqələri natamam təmsil edə bilər.
TED-Net bu üç problemə müvafiq olaraq SAE, LSTM və MSA ilə cavab verməyə çalışır.
Üçlü kodlaşdırma arxitekturası necə işləyir?
Mənbənin ümumi öyrənmə axını:
Xüsusiyyətlərin təmizlənməsi → Zaman modelləşdirilməsi → Qlobal korrelyasiyanın çıxarılması → Birgə decoding → Proqnoz
şəklində ümumiləşdirilə bilər.
SAE ilk mərhələdə maliyyə göstəricilərini daha kompakt latent təqdimata çevirir. Bu çıxış LSTM tərəfindən zaman ardıcıllığı kimi emal olunur. MSA ardıcıllıqdakı müxtəlif zaman nöqtələrinin bir-biri ilə əlaqələrini attention çəkiləri ilə hesablayır. Decoder daha sonra bu üç təqdimatı vahid proqnoz yaratmaq üçün birləşdirir.
Stacked Autoencoder niyə istifadə olunur?
Autoencoder girişi daha aşağıölçülü latent təqdimata kodlaşdırıb sonra onu yenidən qurmağa çalışan neyron şəbəkəsidir. Model yalnız mühüm nümunələri qoruyaraq girişi yenidən yaratmağı öyrəndikdə səs-küyün və lazımsız dəyişənlərin təsiri azaldıla bilər.
Mənbədə encoding qatları:
\[ h^{(l)} = \sigma \left( W^{(l)}h^{(l-1)}+b^{(l)} \right) \]
şəklində ifadə olunur.
TED-Net-də SAE yalnız müstəqil ilkin emal aləti deyil, üçlü encoder quruluşunun ilk komponentidir.
LSTM hansı məlumatı daşıyır?
LSTM yaddaş hüceyrəsi, input gate, forget gate və output gate vasitəsilə keçmiş məlumatın hansının saxlanacağını və ya unudulacağını öyrənir.
Mənbə əsas LSTM yenilənməsini:
\[ i_t=\sigma(W_{xi}x_t+W_{hi}h_{t-1}+W_{ci}c_{t-1}+b) \]
\[ f_t=\sigma(W_{xf}x_t+W_{hf}h_{t-1}+W_{cf}c_{t-1}+b) \]
\[ c_t=f_tc_{t-1}+i_t\tanh(W_{xc}x_t+W_{hc}h_{t-1}+b) \]
\[ o_t=\sigma(W_{xo}x_t+W_{ho}h_{t-1}+W_{co}c_t+b) \]
\[ h_t=o_t\tanh(c_t) \]
ilə müəyyənləşdirir.
Seq2Seq quruluşunda encoder keçmiş ardıcıllığı emal edir, decoder isə encoder-dan əldə olunan təqdimatın köməyi ilə gələcək hədəf ardıcıllığını və ya dəyəri yaradır.
Multi-Head Self-Attention niyə əlavə edilib?
LSTM ardıcıl işlədiyi üçün iki uzaq zaman nöqtəsi arasındakı əlaqə bir çox aralıq vəziyyət üzərindən daşınır. Self-attention isə bir zaman nöqtəsinin digər zaman nöqtələrinə birbaşa nə qədər diqqət yetirməli olduğunu hesablaya bilər.
Mənbə:
\[ Q=W_QX+b_Q,\qquad K=W_KX+b_K,\qquad V=W_VX+b_V \]
çevrilmələrindən istifadə edir.
Daha sonra attention çəkiləri:
\[ \alpha_t= Softmax \left( \frac{Q_tK_t^T}{\sqrt{d_h}} \right) \]
ilə hesablanır.
Dynamic Window Self-Attention nədir?
Tam self-attention uzun ardıcıllıqlarda bütün zaman nöqtələrinin bir-biri ilə müqayisəsini tələb etdiyindən hesablama xərci sürətlə arta bilər.
TED-Net buna görə hər \(t\) nöqtəsi üçün yalnız müəyyən bir \(S_t\) pəncərəsindəki key və value vektorlarından istifadə etməyi təklif edir.
Bu yanaşmanın məqsədi:
- attention xərcini azaltmaq,
- yaxın və əlaqəli zaman nöqtələrinə fokuslanmaq,
- uzun maliyyə ardıcıllıqlarında hesablama yükünü məhdudlaşdırmaqdır.
Mənbə pəncərə uzunluğunun dinamik olaraq necə seçildiyinə dair alqoritmi və ya optimallaşdırma qaydasını ətraflı vermir; əsas riyazi quruluş pəncərə daxilində self-attention hesablanmasıdır.
Model həqiqətən mikro-saniyəlik HFT məlumatından istifadə edirmi?
Xeyr. Mənbə giriş bölməsində HFT-nin mikro-saniyə səviyyəli təbiətindən bəhs etsə də, eksperimental məlumat bir dəqiqəlik tezlikdədir.
Əsas tapşırıq:
son 30 dəqiqəlik məlumat → növbəti 1 dəqiqənin bağlanış qiyməti
şəklindədir.
Bu səbəbdən tədqiqat order-book HFT və ya aşağı gecikməli execution araşdırması əvəzinə yüksək ayırdetməli maliyyə zaman sırası proqnozlaşdırması kontekstində qiymətləndirilməlidir.
Tədqiqatın Metodu və Nəticələri
Məlumat quruluşu
Tədqiqatda müxtəlif sektor və bazar dəyərlərindən 15 A-share səhmi seçilmişdir.
Hər səhm üçün:
- 24.000 ədəd bir dəqiqəlik müşahidə,
- %80 təlim,
- %20 validation,
- 30 dəqiqəlik qısamüddətli sequence,
- 120 dəqiqəlik uzunmüddətli sequence
müəyyənləşdirilir.
Mənbə eyni bölmədə modelin əvvəlki 30 dəqiqədən istifadə edərək növbəti bir dəqiqənin bağlanış qiymətini proqnozlaşdırdığını bildirir. 120 dəqiqəlik uzunmüddətli ardıcıllığın model daxilində dəqiq istifadə üsulu daha az ətraflı izah edilmişdir.
Xüsusiyyətlər
İlkin məlumat quruluşunda 15 indicator olduğu bildirilir. PCA-dan sonra mənbə yeddi göstərici hesabatlaşdırır:
- MACD,
- TRIX,
- VR,
- OBV,
- ROC,
- MTM,
- PSY.
Bunlara 0,78, 0,69, 0,76, 0,68, 0,75, 0,72 və 0,67 dəyərləri aid edilmişdir. Lakin mənbə bu dəyərlərin PCA loading-i, variance töhfəsi, yoxsa başqa bir feature score olduğunu açıqlamır.
Əsas təlim parametrləri
| Parametr | Dəyər |
|---|---|
| LSTM qatı | 3 |
| Hidden unit | 128 |
| Learning rate | 0,007 |
| Dropout | 0,03 əsas təcrübə; 0,1 müqayisəli təcrübə |
| Optimizer | Adam |
| Batch size | 100 |
| Sequence length | 30 |
| Loss | MSE + L2 regularization |
Müqayisəli təcrübədə Transformer üçün \(d_m=128\), səkkiz attention head və altı encoder/decoder layer; TCN üçün kernel size 3, dilation base 2, altı residual block və 64 filter verilmişdir.
Ablation təcrübələri
| Model | AUC | Precision | Recall | MF1 |
|---|---|---|---|---|
| LSTM-Seq2Seq | 0,83 | 0,95 | 0,80 | 0,87 |
| + SAE | 0,88 | 0,96 | 0,85 | 0,91 |
| TED-Net: SAE + MSA | 0,92 | 0,98 | 0,89 | 0,94 |
Cədvəl SAE və MSA əlavə olunduqca hesabatlaşdırılan metriklərin yüksəldiyini göstərir.
Lakin modelin əsas tapşırığı qiymət regressiyası olduğu halda bu cədvəldə təsnifat metriklərindən istifadə olunur. Proqnoz qiymətinin “rising / non-rising” etiketinə necə çevrildiyi, decision threshold və ya sinif bölgüsü mənbədə açıqlanmır. Buna görə bu ablation cədvəlinin tam şəkildə yenidən istehsalı mümkün deyil.
On beş səhm müqayisəsi
Mənbə Table 3-də Transformer, TCN, LSTM-Seq2Seq və TED-Net üçün 15 səhm üzrə “prediction accuracy” faizlərini verir.
| Səhm | Transformer | TCN | LSTM-Seq2Seq | TED-Net |
|---|---|---|---|---|
| ZTE | %87,73 | %86,04 | %87,18 | %89,12 |
| Gansu Consulting | %95,37 | %95,14 | %95,08 | %96,21 |
| East Money | %96,79 | %96,63 | %96,91 | %97,82 |
| BYD | %91,96 | %92,28 | %92,15 | %93,67 |
| Shanxi Coking | %71,13 | %68,28 | %72,79 | %75,06 |
TED-Net Table 3-də sadalanan 15 orta sətrin hamısında ən yüksək dəyəri göstərir.
Bununla belə, mənbə “prediction accuracy” ölçüsünün riyazi tərifini vermədiyi üçün bu faizləri klassik classification accuracy kimi şərh etmək təhlükəsiz deyil.
CATL təcrübəsinin məlumat dəsti
CATL üçün ayrıca təcrübədə:
- 8 iyul 2025 – 13 mart 2026,
- 39.604 ədəd bir dəqiqəlik observation,
- %80 training,
- %20 validation
istifadə edilmişdir.
Mənbə Figure 5-də optimal təlim müddətini təxminən 40 epoch kimi müəyyənləşdirir və loss-un təxminən 0,00575 səviyyəsində sabitləşdiyini bildirir.
CATL nəticələri
| Model | RMSE | MAE | R² |
|---|---|---|---|
| LSTM | 3,4521 | 2,8910 | 0,92 |
| TCN | 3,2145 | 2,7234 | 0,93 |
| Transformer | 3,0876 | 2,6012 | 0,94 |
| TED-Net | 2,2292 | 2,0872 | 0,97 |
Bu cədvəl TED-Net-in mənbə təcrübəsində ən aşağı RMSE və MAE ilə ən yüksək R² dəyərini verdiyini göstərir.
Mənbədə göstərilən %42 RMSE azalması yenidən istehsal oluna bilərmi?
Nəticə bölməsində TED-Net-in baseline ilə müqayisədə RMSE-ni %42,0 azaltdığı bildirilir. Lakin CATL Table 4 dəyərlərindən istifadə edildikdə:
- LSTM → TED-Net: təxminən %35,4 azalma,
- TCN → TED-Net: təxminən %30,7 azalma,
- Transformer → TED-Net: təxminən %27,8 azalma
alınır.
Mənbə %42 nisbətini hansı fərqli təcrübədən və ya baseline-dan hesabladığını açıqlamır. Buna görə Verianla bu nisbəti təsdiqlənmiş CATL nəticəsi kimi istifadə etmir.
Bu tədqiqat gəlirli HFT strategiyası göstərirmi?
Xeyr. Model növbəti dəqiqənin qiymətini proqnozlaşdırır.
Tədqiqatda:
- alış/satış qərar qaydası,
- mövqe ölçüsü,
- bid-ask spread,
- commission,
- slippage,
- queue position,
- network latency,
- reallaşmış əməliyyat P&L-si,
- Sharpe ratio,
- maximum drawdown
üzərindən trading backtest aparılmır.
Buna görə aşağı RMSE və ya yüksək R² birbaşa iqtisadi cəhətdən gəlirli əməliyyat strategiyasına bərabər deyil.
Tədqiqatın güclü tərəfləri
- SAE, LSTM və MSA-nı aydın rollarla vahid arxitekturda birləşdirməsi.
- Müxtəlif təqdimat növlərini collaborative decoder ilə inteqrasiya etməsi.
- On beş müxtəlif səhm üzərində müqayisə aparması.
- SAE və MSA üçün ablation nəticələri təqdim etməsi.
- CATL üzərində RMSE, MAE və R² kimi aydın regressiya metrikləri hesabatlaşdırması.
- Transformer və TCN kimi güclü zaman sırası modellərini benchmark kimi istifadə etməsi.
Əsas məhdudiyyətlər
- Tədqiqat hələ hakem qiymətləndirməsindən keçməmiş v1 preprintdir.
- Bir dəqiqəlik məlumat klassik mikro-saniyə HFT tərifi ilə eyni deyil.
- “Million-level” məlumat iddiası açıqlanan observation sayı ilə uyğun gəlmir.
- Regression və classification qiymətləndirmə metodologiyaları bir-birinə qarışır.
- Table 3 accuracy metrikinin tərifi verilmir.
- Müxtəlif təcrübələrdə giriş ölçüsü 10 və 8 olaraq dəyişir.
- 30 və 120 dəqiqəlik iki sequence quruluşunun birlikdə istifadəsi kifayət qədər izah edilmir.
- PCA nəticəsində verilən əmsalların mənası aydın deyil.
- RMSE %42 azalması CATL cədvəli ilə birbaşa təsdiqlənmir.
- “1,5 yuan average error” ifadəsi MAE 2,0872 ilə uyğun gəlmir.
- Trading profitability və ya execution backtest mövcud deyil.
- Mənbə mətndə redaktə placeholder-ları hələ də qalır.
Mənbə və Metod Qeydi
Orijinal başlıq: A Triple Encoder-Decoder Network with Multi-Head Self-Attention and Stacked Autoencoder for High-Frequency Trading Prediction
Müəlliflər: Zhuxi Zhang; Yan Zhang; Haolin Yuan; Min Zhu; Zihan Zhao.
Qurumlar: China Institute of Finance, University of International Business and Economics, Beijing; Digital Technology Research and Development Center, Beijing Research Institute of Ansteel Co., Ltd., Beijing.
Mənbə növü: Preprint / Article.
Platforma: Preprints.org.
Versiya: Version 1.
Təqdim edilib: 10 sentyabr 2026.
Yayımlanıb: 14 sentyabr 2026.
DOI: 10.20944/preprints202609.0978.v1.
Hakemlik statusu: Hakem qiymətləndirməsindən keçməyib. Mənbə və Preprints.org qeydi açıq şəkildə “Not peer-reviewed” ifadəsini daşıyır.
Lisenziya: Creative Commons Attribution 4.0 International — CC BY 4.0.
Əsas metod: Stacked Autoencoder + LSTM-Seq2Seq + Multi-Head Self-Attention + Dynamic Window Attention + collaborative decoder.
Əsas tapşırıq: Bir dəqiqəlik maliyyə məlumatından növbəti dəqiqənin səhm qiymətini regressiya yolu ilə proqnozlaşdırmaq.
Əsas təcrübə: 15 A-share səhmi × 24.000 ədəd bir dəqiqəlik müşahidə; %80 training və %20 validation.
CATL təcrübə dəsti: 8 iyul 2025–13 mart 2026 arasında 39.604 ədəd bir dəqiqəlik müşahidə.
CATL əsas nəticəsi: TED-Net RMSE 2,2292; MAE 2,0872; R² 0,97.
Maliyyələşdirmə: National Major Science and Technology Project of Intelligent Manufacturing Systems and Robots; grant 2025ZD1607900.
Məlumat əlçatanlığı: Müəlliflər məlumatın corresponding author-dan sorğu əsasında əldə edilə biləcəyini bildirirlər.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan edirlər.
Draft-status xəbərdarlığı: Author Contributions bölməsindəki redaktə təsdiq qeydi və Reference 22-dəki əskik müəllif placeholder-ı preprint versiyasında qalmışdır.
Metodoloji xəbərdarlıq: Ablation bölməsindəki classification metrikləri ilə əsas regression tapşırığı arasındakı çevrilmə açıqlanmır. Table 3 prediction-accuracy metrikinin tərifi də verilmir.
HFT terminologiyası xəbərdarlığı: Tədqiqat mikro-saniyəlik execution və ya tick-level limit-order-book HFT-ni sınaqdan keçirmir; təcrübələr bir dəqiqəlik zaman sıraları üzərində aparılır.
İqtisadi şərh sərhədi: Proqnoz dəqiqliyi və ya R², transaction cost və execution davranışını əhatə edən əməliyyat strategiyası nəticələri olmadan birbaşa gəlirlilik göstəricisi deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib