

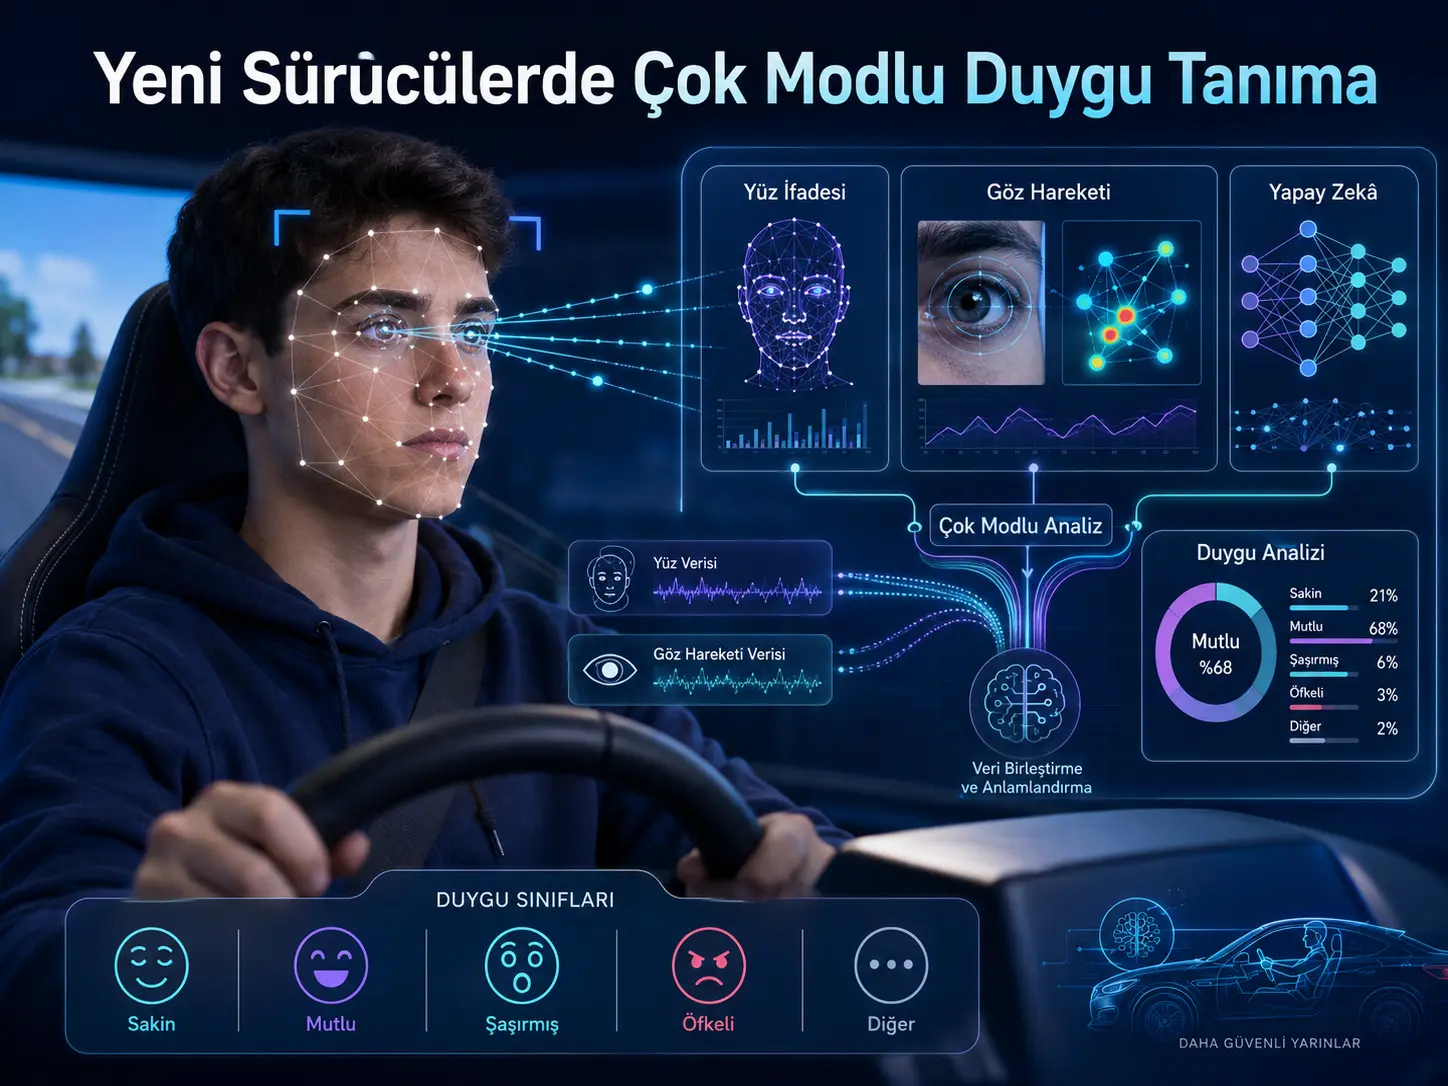
Ин таҳқиқот модели бисёрмодалии омӯзиши амиқро таҳия мекунад, ки барои арзёбии ҳолати эҳсосии ронандагони навкор бо таҷрибаи маҳдуди ронандагӣ на танҳо ифодаи чеҳра ё танҳо ҳаракати чашм, балки ҳар ду манбаи иттилоотро якҷо истифода мебарад. Модел тасвирҳои чеҳраро бо ViT-B/16 коркард мекунад, силсилаҳои вақти пайгирии чашмро бошад бо омезиши Bi-LSTM ва Transformer encoder таҳлил менамояд; сипас ду гурӯҳи хусусиятҳо тавассути механизми вазнгузории омӯзишшаванда бо номи Gated Weighted Fusion (GWF) муттаҳид шуда, ба персептрони бисёрқабата дода мешаванд. Синфҳои баромад панҷ категорияанд: ором, хушҳол, ҳайрон, хашмгин ва дигар.
Дар таҳқиқот аввал бо пурсише, ки 387 нафар иштирок карданд, муайян карда шуд, ки 17 садои гуногуни марбут ба ронандагӣ ё муҳити атроф бо кадом эҳсосот иртибот доранд. Сипас бо ронандагони навкори 18–25-сола дар шароити лабораторӣ тасвирҳои статикии ронандагӣ ва видеоҳои динамикии ронандагӣ истифода шуданд; тасвирҳои чеҳра ва маълумоти пайгирии чашм бо басомади 100 Hz ҳамзамон ҷамъоварӣ шуданд. Дар аввал 34 иштирокчӣ қабул шуда, пас аз хориҷ кардани онҳое, ки самаранокии таҷрибаашон аз %90 камтар буд, намунаи самаранок 32 нафар гузориш шудааст.
Барои модел 30.000 намунаи ҳаракати чашм ва 30.000 намунаи ифодаи чеҳра истифода шудааст; барои ҳар яке аз панҷ синфи эҳсосӣ 6000 намуна мавҷуд будааст. Маълумот дар сатҳи иштирокчӣ ба панҷ зермаҷмӯа ҷудо шуда, дар ҳар давр чор зермаҷмӯа барои омӯзиш ва як зермаҷмӯа барои validation истифода гардидааст ва subject-level панҷқабата cross-validation татбиқ шудааст. Омӯзиш бо 30 epoch, batch size 32, initial learning rate 10−3, Adam optimizer ва cross-entropy loss анҷом дода шудааст.
Тибқи натиҷаи асосии гузоришшудаи манбаъ, accuracy бо танҳо тасвири чеҳра %71,18, бо танҳо ҳаракати чашм %95,10 ва дар модели бар GWF асосёфта, ки ҳар ду модалиятро якҷо истифода мебарад, %98,72 будааст. Равиши оддии feature concatenation accuracy-и %95,45 додааст, дар ҳоле ки истифодаи GWF %98,72 гузориш шудааст. Бо вуҷуди ин, байни multimodal confusion matrix-и таҳқиқот ва натиҷаи %98,72 номувофиқии муҳими ададӣ вуҷуд дорад; бинобар ин нишондиҳандаи асосии муваффақият бояд ҳамчун натиҷаи аз ҷониби манбаъ гузоришшуда хонда шавад, на ҳамчун accuracy-и мустақилона дубора истеҳсолшуда.
Модел на танҳо дар маҷмӯаи додаҳои худи муҳаққиқон барои ронандагони навкор, балки дар се маҷмӯаи умумии додаҳои эҳсосӣ — AFFEC, SEED-IV ва AffectNet — низ арзёбӣ шудааст. Сохтори пешниҳодшуда дар ин маҷмӯаҳо мутаносибан accuracy-и %91,95, %90,44 ва %89,67 гузориш кардааст. Аммо худи таҳқиқот низ ошкоро таъкид мекунад, ки ин се маҷмӯаи додаҳо махсус барои ронандагони навкор ё ронандагии воқеӣ нестанд. Ин санҷишҳо қобилияти умумии feature extraction ва fusion-и моделро дастгирӣ мекунанд; онҳо нишон намедиҳанд, ки модел эҳсосоти ронандаи навкорро дар ҳаракати воқеӣ бо ҳамон дақиқӣ мешиносад.
Аз нигоҳи Туркия: Таҳқиқот дар Туркия гузаронида нашудааст ва аз номзадҳои ронандагии Туркия маълумот ҷамъ накардааст. Азбаски синну сол, заминаи фарҳангӣ, омӯзиши ронандагӣ, одатҳои ҳаракати роҳ, рафтори ифодаи чеҳра ва таъсири ангезандаҳои эҳсосии истифодашуда байни ҷомеаҳо фарқ карда метавонанд, нишондиҳандаҳои гузоришшудаи accuracy-ро мустақиман ба номзадҳои ронандагии Туркия татбиқ кардан мумкин нест. Системае, ки дар Туркия истифода мешавад, бояд бо иштирокчиёни маҳаллӣ, дар шароити воқеии автомобил, дар муҳитҳои гуногуни рӯшноӣ ва роҳ ва дар таҷҳизоти дохили автомобил алоҳида санҷида шавад.
Масъалаи асосии таҳқиқот чист?
Таҳқиқот ду маҳдудияти асосиро дар мониторинги ҳолати эҳсосӣ ҳангоми ронандагӣ ҳадаф мегирад. Якум, қисми зиёди таҳқиқоти қаблӣ ба гурӯҳҳои ронандагони таҷрибадор ё умумӣ равона шудаанд. Муҳаққиқон бар онанд, ки шахсони дорои таҷрибаи ками ронандагӣ метавонанд дар рӯ ба рӯ шудан бо сарбории маърифатӣ ва рӯйдодҳои ғайричашмдошт посухҳои эҳсосии дигар дошта бошанд.
Масъалаи дуюм ин аст, ки як модалияти ягонаи додаҳо метавонад эҳсосотро пурра ифода карда натавонад. Ифодаҳои чеҳра аз берун мустақиман мушоҳидашавандаанд, аммо дар эҳсосоти шиддаташон паст метавонанд равшан набошанд ё аз рафтори огоҳонаи шахс таъсир гиранд. Ҳаракатҳои чашм метавонанд тақсимоти диққат, рафтори pupil, gaze ва тағйироти вақтро инъикос кунанд; аммо танҳо онҳо метавонанд барои фарқ кардани эҳсосоти гуногун кофӣ набошанд.
Ҳалли таҳқиқот муттаҳид кардани хусусиятҳои фазоии тасвирҳои чеҳра бо хусусиятҳои замонии ҳаракатҳои чашм мебошад.
Модел аз кадом чор қисми асосӣ иборат аст?
Занҷири шинохти бисёрмодалии эҳсосот дар ронандаи навкор
| Марҳила | Вуруд / раванд | Модели асосӣ | Манбаъ |
|---|---|---|---|
| 1. Тасвири чеҳра | Тасвири чеҳраи 224 × 224 × 3 ба patch-ҳо ҷудо шуда, хусусияти умумии визуалӣ истихроҷ мешавад. | ViT-B/16 | Бахши 3.2 / Шакли 1 |
| 2. Ҳаракати чашм | Дар силсилаи вақти 500 × 17 вобастагиҳои замонии пеш ва қафо коркард мешаванд. | Bi-LSTM | Бахши 3.3 / Шакли 1 |
| 3. Робитаи дурмасофа | Муносибатҳои байни нуқтаҳои вақти аз ҳам дуртар дар силсилаи ҳаракати чашм моделсозӣ мешаванд. | Transformer encoder | Бахши 3.3 |
| 4. Fusion-и мутобиқшаванда | Саҳми хусусиятҳои чеҳра ва ҳаракати чашм бо gating-и омӯзишшаванда вазнгузорӣ мешавад. | GWF | Бахши 3.4 |
| 5. Тасниф | Аз хусусияти муттаҳидшуда эҳтимолияти панҷ синфи эҳсосӣ ҳосил мешавад. | MLP + Softmax | Бахши 3.5 |
Ин намоиши шарҳдиҳандаи раванд дар асоси Шакли 1 ва бахши усули таҳқиқот омода шудааст. Марҳилаи нави модел, ки дар манбаъ нест, илова нашудааст.
ViT-B/16 тасвири чеҳраро чӣ гуна коркард мекунад?
Ба шохаи чеҳраи модел тасвирҳои андозаи 224 × 224 пиксел дода мешаванд. ViT-B/16 тасвирро ба patch-ҳои 16 × 16 пиксел тақсим мекунад. Шумораи patch:
\[ N= \frac{H}{P} \times \frac{W}{P} \]
бо ин формула ҳисоб мешавад. Дар таҳқиқот \(P=16\) аст. Барои тасвири 224 × 224 ин сохтор имкон медиҳад, ки тасвир ба қисмҳои хурд ҷудо шуда, ба Transformer ҳамчун силсилаи token дода шавад.
Ҳар patch бо табдили хаттӣ ба feature space-и 768-андоза гузаронда мешавад:
\[ z_i=W_{\mathrm{patch}}p_i+b_{\mathrm{patch}} \]
Барои аз даст нарафтани ҷойгиршавии patch-ҳо дар тасвир position embedding илова мешавад:
\[ z'_i=z_i+E_{\mathrm{pos},i} \]
Илова бар ин, барои тасниф classification token-и махсус ба оғози силсила илова карда мешавад.
Ядрои self-attention-и ViT:
\[ Attention(Q,K,V) = softmax\left( \frac{QK^T}{\sqrt{d_k}} \right)V \]
ба ин шакл таъриф шудааст. Ҳамин тавр, модел мехоҳад на танҳо минтақаҳои ҳамсояи пиксел, балки робитаҳои байни минтақаҳои аз ҳам дури чеҳраро низ ифода кунад.
Матни усул баромади ниҳоии classification token-ро ҳамчун вектори 768-андозаи \(f_{\mathrm{image}}\) муайян мекунад.
Чаро дар шохаи ҳаракати чашм Bi-LSTM ва Transformer якҷо истифода мешаванд?
Вуруди ҳаракати чашм дар Шакли 1-и манбаъ бо андозаи 500 × 17 нишон дода шудааст. Eye tracker басомади намунагирии 100 Hz дорад ва додаҳо ба равзанаҳои 5-сониягӣ тақсим шудаанд. Аз ин рӯ, дар як равзанаи 5-сониягӣ тақрибан 500 нуқтаи вақт мавҷуд будан бо андозаи вуруди модел мувофиқ аст.
Вазифаи Bi-LSTM коркарди силсила ҳам ба самти пеш ва ҳам қафо мебошад, то заминаи маҳаллӣ ва гузаштаи/ояндаи вақтро ифода кунад. Барои ҳар самт 128 hidden unit истифода шуда, ҳангоми якҷо кардани ду самт баромади 256-андоза ба даст меояд.
Сипас Transformer encoder вобастагиҳои байни нуқтаҳои вақти аз ҳам дуртарро дар силсила бо self-attention моделсозӣ мекунад. Барои қабати Transformer дар манбаъ:
- 8 attention head,
- 256 model dimension,
- 512 feed-forward dimension,
- 0,1 dropout,
- 2 қабати Transformer encoder
нишон дода шудааст.
Gated Weighted Fusion чӣ кор мекунад?
Мувофиқи манбаъ, ҳадафи GWF ин аст, ки ба ҷойи танҳо паҳлуи ҳам гузоштани ду модалият, ба таври омӯзишшаванда муайян кунад, ки дар намунаи ҷорӣ кадом хусусият муфидтар аст.
Ду хусусият:
\[ f_1,f_2\in R^{C\times1} \]
таъриф шуда, аввал:
\[ f_{\mathrm{cat}}=[f_1;f_2] \]
ба ин шакл муттаҳид мешаванд. Сипас gating weight:
\[ g= \sigma(W_gf_{\mathrm{cat}}+b_g) \]
ҳисоб карда мешавад. Қиматҳои \(g\) байни 0 ва 1 мебошанд.
Муодилаи ниҳоии fusion дар манбаъ:
\[ f_{\mathrm{fused}} = g\odot f_1 + (1-g)\odot f_2 \]
ба ин шакл аст. Ин сохтор механизми вазнгузории омӯзишшаванда мебошад, ки метавонад баъзе каналҳои feature-и як модалиятро тақвият дода, модалияти дигарро суст кунад.
Ёддошти андозаи меъморӣ: Дар ин ҷо дар дохили манбаъ фарқи андозае мавҷуд аст, ки шарҳ дода нашудааст. Бахши ViT хусусияти чеҳраро 768-андоза таъриф мекунад, аммо Шакли 1 шохаи чеҳраи воридшаванда ба GWF-ро 256×1 нишон медиҳад. Илова бар ин, формулаи weighted-sum-и боло баромади \(C\)-андоза ҳосил мекунад, дар ҳоле ки Шакли 1 баромади GWF-ро 512×1 нишон медиҳад. Манбаъ қабатҳои фосилавии ин табдилҳоро шарҳ намедиҳад.
Таснифкунанда чӣ истеҳсол мекунад?
Хусусияти аз fusion баромада ба classifier-и бар MLP асосёфта дода мешавад. Дар қабати охир бо Softmax барои панҷ категория эҳтимолият ҳосил мешавад:
\[ \hat{y}_k= \frac{\exp(z_k^{(L)})} {\sum_{i=1}^{C}\exp(z_i^{(L)})} \]
Мутобиқати синфҳо дар Шакли 1-и манбаъ:
| Синф | Эҳсос |
|---|---|
| 0 | Ором |
| 1 | Хушҳол |
| 2 | Ҳайрон |
| 3 | Хашмгин |
| 4 | Дигар |
Ангезандаҳои эҳсосӣ чӣ гуна интихоб шуданд?
Муҳаққиқон ба ҷойи он ки мустақиман ба таҷрибаи лабораторӣ гузаранд, аввал омӯхтанд, ки кадом садоҳои ронандагӣ ва муҳити атроф дар ронандагони навкор бо кадом эҳсосот алоқаманданд. Дар пурсиш дар маҷмӯъ 387 нафар иштирок карданд; 197 нафарашон мард ва 190 нафарашон зан буданд.
Дар пурсиш 17 садо истифода шуд. Ба онҳо занги телефон, борон, сиренаи ёрии таъҷилӣ, бархӯрди автомобил, ҷанҷол, муҳити тарс, мусиқии оромбахш, мусиқии баланд, аккоси саг, суръатгирии автомобил, садои тормоз, сигнал ва садои баланд дохил мешаванд.
Барои муносибати байни садо ва категорияи эҳсос chi-square test истифода шудааст:
\[ \chi^2= \sum_{i,j} \frac{(O_{ij}-E_{ij})^2}{E_{ij}} \]
Дар манбаъ:
\(\chi^2=1310,791\), p<0,001
натиҷа гузориш шудааст. Муҳаққиқон ба хулоса омадаанд, ки байни намудҳои садо ва тақсимоти эҳсосот робитаи маънодор мавҷуд аст.
Дар correspondence analysis гуфта шудааст, ки ҳиссаи ҷамъшавандаи шарҳи ду андоза аз %80 бештар аст. Тибқи тафсири таҳқиқот, сигнали пайваста, ҷанҷол ва аккоси саг ба минтақаи anger; садоҳои монанди бархӯрди ногаҳонӣ ба минтақаи surprise наздиктар гурӯҳбандӣ шудаанд.
Ин натиҷаҳои пурсиш барои интихоби комбинатсияҳои stimulus-и “саҳна + садо” дар симулятсияи баъдинаи ронандагӣ истифода шуданд. Натиҷаи пурсиш далели мустақими тағйири объективии эҳсосот дар ронандагии воқеӣ нест; он марҳилаи пешакии интихоби ангезандаи таҷрибавист.
Таҷрибаҳои статикиву динамикии ронандагӣ чӣ гуна ташкил шуданд?
Дар бахши статикӣ 60 акси ронандагии шаҳрӣ истифода шуд. Пеш аз тасвир prompt-и марбут ба сенарияи ронандагӣ 3 сония ва баъд тасвир 10 сония нишон дода шуд. Манёврҳо гардиш, иваз кардани хат, канорагирӣ аз пиёдагард, бандшавии нақлиёт ва суръатгирӣ барои пешгузариро дар бар мегирифтанд.
Ҳар гурӯҳ аз 12 акс иборат буд ва дар маҷмӯъ панҷ гурӯҳ омода карда шуд. Манбаъ менависад, ки ҳар гурӯҳ тақрибан 2 дақиқа 35 сония давом мекард, аммо таҷрибаи умумии статикӣ тақрибан 30 дақиқа будааст.
Номувофиқии вақт: Панҷ гурӯҳи 2 дақиқа 35 сониягӣ тақрибан 12 дақиқа 55 сонияро ташкил медиҳанд. Ҳисоби 12 × (3+10 сония) низ барои ҳар гурӯҳ тақрибан 2 дақиқа 36 сония медиҳад. Дар манбаъ вақти иловагии интизорӣ ё танаффусе, ки давомнокии умумии 30 дақиқаро шарҳ диҳад, нишон дода нашудааст.
Дар бахши динамикӣ 60 видеои ронандагии шаҳрӣ истифода шуд. Видеоҳо аз маводи таълимии ибтидоии ронандагӣ гирифта шуда, рондани рост, гардиши даврӣ ва интизорӣ дар чорроҳаро дар бар мегирифтанд.
Ҳар видео ду дақиқа давом карда, 10 видео як гурӯҳ ва дар маҷмӯъ шаш гурӯҳ ташкил доданд. Байни гурӯҳҳо панҷ дақиқа танаффус дода шуд ва пеш аз ҳар гурӯҳ calibration-и нӯҳнуқтаи eye-tracker анҷом дода шуд. Давомнокии умумии таҷрибаи динамикӣ тақрибан 2 соат 30 дақиқа нишон дода шудааст.
Дар таҷҳизоти таҷриба кадом дастгоҳҳо ҳастанд?
Дар муҳити лабораторӣ рули симулятсионӣ, сцепление, тормоз, идоракунии сигнали гардиш, eye tracker, таҷҳизоти human-factor, ноутбук, камера ва гӯшмонак мавҷуданд.
Барои ҳаракати чашм aSee Pro F100 истифода шуда, басомади намунагирӣ 100 Hz нишон дода шудааст. Нармафзори aSee Studio барои ҷамъоварии маълумоти иштирокчӣ, pupil data, gaze points, saccade ва blink истифода шудааст.
Манбаъ дар Шакли 5 муҳити таҷрибавиро мустақим нишон медиҳад: ҳангоми намоиши тасвири симулятсияи ронандагӣ дар монитор, камера ва системаи пайгирии чашми aSee Pro дар рӯ ба рӯи иштирокчӣ ва симулятори рул дар назди миз ҷойгир шудааст. Ин муҳит кабинаи воқеии автомобил нест, балки симулятсияи ронандагии лабораторист.
Иштирокчиён киҳо буданд?
Ба таҷриба 34 нафар аз 18 то 25 сола ҷалб шуда, синни миёна 22 гуфта шудааст. Иштирокчиён аз байни номзадҳои гирифтани шаҳодатномаи ронандагӣ ё шахсони дорои камтар аз як сол таҷрибаи ронандагӣ интихоб шуданд.
Иштирокчиёне, ки самаранокии таҷрибаашон аз %90 камтар буд, хориҷ карда шуданд ва дар натиҷа намунаи самараноки 32-нафара боқӣ монд.
Дар таҳқиқот барои ҳолатҳое, ки метавонанд ба ченкунии пайгирии чашм таъсир расонанд, меъёрҳо муайян шудаанд. Манбаъ талаб мекунад, ки контакт-линза истифода нашавад ва барои истифодабарандагони айнак prescription аз “500 diopters” зиёд набошад. Ин рақам айнан ба шакли дар манбаъ омада нигоҳ дошта мешавад; хатои эҳтимолии воҳид ё тарҷума пинҳонӣ ислоҳ намешавад.
Иштирокчиён informed consent додаанд ва таҳқиқот аз ҷониби кумитаи ахлоқии Baoji University of Arts and Sciences тасдиқ шудааст.
Маълумоти ҳаракати чашм чӣ гуна омода шудааст?
Манбаъ мегӯяд, ки маҷмӯаи ибтидоии eye-movement барои ҳар иштирокчӣ 79.070 нуқтаи вақт дошт. Маълумот ба равзанаҳои 5-сониягӣ тақсим карда шудааст.
Бо сабаби басомади намунагирии 100 Hz, як равзанаи 5-сониягӣ тақрибан 500 нуқтаи вақтро дар бар мегирад; таърифи вуруди модел ҳамчун 500×17 бо ин сохтор мувофиқ аст.
Дар матни манбаъ ҳамчунин гуфта мешавад, ки slicing маълумотро аз “79.070 rows то тақрибан 500 rows” кам кардааст. Ҳарчанд аз вуруди модел фаҳмидан мумкин аст, ки ин ба тақрибан 500 сатр дар ҳар равзанаи 5-сониягӣ ишора мекунад, матн нисбат ба ҳаҷми умумии додаҳо равшан нест.
Тасвирҳои чеҳра чӣ гуна омода шудаанд?
Видеоҳои чеҳра ба нармафзори ErgoLAB facial-expression analysis дода шуда, нуқтаҳои facial feature ва emotion label-ҳои мувофиқ гирифта шуданд. Сипас видеоҳо frame-by-frame ба силсилаи тасвир табдил дода шуданд.
Тасвирҳо аз 1920×1080 ба 224×224 пиксел resize шуда, қиматҳои пиксел ба фосилаи [0,1] нормализатсия шудаанд.
Манбаъ мегӯяд, ки пас аз emotion label-ҳои истеҳсолкардаи нармафзор classification-и дастӣ анҷом дода шудааст. Аммо тафсилоти ҳамоҳангсозии ground-truth-и ниҳоии байни равзанаҳои eye-movement ва facial frame-ҳо дар бахши усул маҳдуд шарҳ дода шудааст.
Модел бо кадом додаҳо омӯзонида шуд?
| Навъи дода | Шумораи намуна |
|---|---|
| Намунаҳои ҳаракати чашм | 30.000 |
| Намунаҳои ифодаи чеҳра | 30.000 |
| Ҳар категорияи эҳсосот | 6000 |
Намунаҳо аз рӯйи subject ба панҷ зермаҷмӯа тақсим шуданд. Дар ҳар давр чор зермаҷмӯа барои омӯзиш, зермаҷмӯаи боқимонда барои validation истифода шуд ва пас аз он ки ҳар зермаҷмӯа як бор validation гардид, раванд анҷом ёфт.
Параметрҳои омӯзиш
| Параметр | Қимат |
|---|---|
| Epoch | 30 |
| Batch size | 32 |
| Initial learning rate | 10−3 |
| Optimizer | Adam |
| Loss | Cross-entropy |
| Validation | Subject-level 5-fold cross-validation |
Натиҷаҳои танҳо чеҳра, танҳо чашм ва multimodal чӣ гуна тағйир меёбанд?
| Модалият | Accuracy-и гузоришшуда дар манбаъ |
|---|---|
| Тасвири чеҳра | %71,18 |
| Ҳаракати чашм | %95,10 |
| Multimodal | %98,72 |
Мувофиқи тафсири худи манбаъ, паёми муҳимтарини натиҷаҳо ин аст, ки дар ин гурӯҳи таҷрибавӣ маълумоти ҳаракати чашм нисбат ба ифодаи чеҳра фарқкунандагии хеле баландтар нишон дода, муттаҳид кардани ду модалият accuracy-и баландтари гузоришшударо таъмин кардааст.
Ин натиҷа маънои онро надорад, ки ифодаи чеҳра дар маҷмӯъ барои шинохти эҳсосот заиф аст. Натиҷа танҳо барои ҳамин маҷмӯаи додаҳо, ҳамин гурӯҳи иштирокчиён, ҳамин ангезандаҳо ва ҳамин сохтори модел эътибор дорад.
Оё GWF аз concatenation-и оддӣ беҳтар аст?
| Усули Fusion | Accuracy (%) |
|---|---|
| Feature Concatenation | 95,45 |
| GWF Fusion | 98,72 |
Фарқи мутлақ байни ду қимат 3,27 банди фоизӣ аст. Манбаъ ин натиҷаро ҳамчун “%3,27 improvement дар accuracy” ифода мекунад.
Чаро confusion matrix-ҳо муҳиманд?
Дар confusion matrix-и Шакли 10 барои модели танҳо facial-image, ҷамъбасти диагонали асосӣ 3257 ва шумораи умумии намунаҳо 4576 аст:
\[ Accuracy= \frac{3257}{4576} = 0,71176 \approx71,18\% \]
Ин қимат бо facial-image accuracy-и гузоришшуда дар Шакли 8 пурра мувофиқ аст.
Дар модели facial дида мешавад, ки Class 0, яъне calm, махсусан бо Class 4 “other” ва Class 3 “angry” омехта шудааст. Манбаъ инро бо нозуктар будани тағйироти чеҳра дар эҳсоси ором шарҳ медиҳад.
Аммо вақте Шакли 11-и multimodal дубора ҳисоб карда мешавад:
| Ченак | Қимат |
|---|---|
| Шумораи умумии намунаҳои confusion-matrix | 4576 |
| Диагонали асосӣ / таснифи дуруст | 4304 |
| Accuracy-и аз матритса дубора ҳисобшуда | ≈ %94,06 |
| Multimodal accuracy-и гузоришшуда дар Шакли 8 ва Ҷадвали 3 | %98,72 |
Огоҳии гузоришдиҳии илмӣ: Манбаъ намегӯяд, ки Шакли 11 ба fold, зермаҷмӯа ё қисми дигари таҷриба тааллуқ дорад. Бо ин вуҷуд, %94,06-и аз confusion matrix дубора гирифташуда бо %98,72-и ҷадвали асосӣ мувофиқат намекунад. Verianla интихоб намекунад, ки кадоме аз ин ду натиҷа дуруст аст; номувофиқиро ошкоро нигоҳ медорад.
Саҳми Bi-LSTM ва Transformer дар модели eye-movement чист?
Дар аблятсия бо танҳо маълумоти ҳаракати чашм:
| Модел | Accuracy (%) |
|---|---|
| Bi-LSTM | 87,50 |
| Transformer | 94,23 |
| Bi-LSTM + Transformer | 95,10 |
Дар таҷрибаи multimodal таъсири ҷузъҳои eye branch чунин аст:
| Eye branch | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Манбаъ ин натиҷаҳоро чунин тафсир мекунад, ки Bi-LSTM вобастагиҳои самтноки вақтро ва Transformer муносибатҳои дурмасофатарро ифода намуда, якдигарро пурра мекунанд.
Натиҷаҳо дар се маҷмӯаи умумии додаҳо чиро нишон медиҳанд?
Муҳаққиқон барои он ки модел танҳо ба муваффақият дар додаҳои таҷрибавии худ вобаста набошад, дар AFFEC, SEED-IV ва AffectNet муқоисаҳои иловагӣ анҷом додаанд.
| Маҷмӯаи додаҳо | Модалият | Accuracy-и модели пешниҳодшуда | Macro-F1 |
|---|---|---|---|
| AFFEC | Чашм + чеҳра | 91,95 ± 0,87% | 91,36 ± 0,92% |
| SEED-IV | Танҳо ҳаракати чашм | 90,44 ± 0,75% | 89,81 ± 0,80% |
| AffectNet | Танҳо чеҳра | 89,67 ± 0,69% | 89,02 ± 0,73% |
Манбаъ гузориш мекунад, ки модели пешниҳодшуда дар ҳар се маҷмӯаи додаҳо нисбат ба baseline-ҳои муқоисашуда дар сатҳи p<0,05 бартарии омории маънодор нишон додааст.
Аммо ҳадди тафсири ин бахш махсусан муҳим аст: AFFEC, SEED-IV ва AffectNet маҷмӯаҳои додаҳои ронандагӣ барои ронандагони навкор нестанд. Таҳқиқот инро ошкоро таъкид мекунад. Ин натиҷаҳо қобилияти умумии меъмории моделро дар шинохти эҳсосот дастгирӣ мекунанд; кори онро дар шароити ронандагии воқеӣ тасдиқ намекунанд.
Бо дигар усулҳои шинохти эҳсосот чӣ гуна муқоиса шудааст?
| Сигналҳо | Усул | Accuracy-и дар манбаъ додашуда |
|---|---|---|
| Чашм + садо + тасвир | FE-CNN | 81,90% |
| Чашм + PPG | FECNN + LSTM | 84,68% |
| Чеҳра + rPPG + чашм | Dual-path Transformer | 86,98% |
| EEG + чашм | MFFNN | 87,32% |
| EEG | LSTM | 90,72% |
| EEG + ECG + чашм | 1D-Inception + Self-Attention + LSTM | 91,38% |
| EEG | CNN-LSTM | 93,97% |
| EEG + чеҳра + сигналҳои физиологӣ | GNN | 91,25% |
| Чашм + чеҳра | Ин таҳқиқот | 98,72% |
Азбаски ин ҷадвал таҳқиқотҳои гуногун бо маҷмӯаҳои додаҳо, шумораи синфҳо, намунаҳо ва протоколҳои таҷрибавии гуногунро дар бар мегирад, набояд ҳамчун ҷадвали рақобати мустақим хонда шавад. Манбаъ ин қиматҳоро ҳамчун муқоисаи адабиёт пешниҳод мекунад; онҳо озмоиши назоратшудаи head-to-head дар як benchmark нестанд.
Оё модел real-time аст?
Манбаъ барои модели multimodal қимати миёнаи processing time ба ҳар batch-ро:
29,42 ± 0,08 ms
медиҳад.
Дар hybrid inference mode барои ҳар намуна:
0,9230 ± 0,0014 ms
гузориш шудааст.
Муҳаққиқон ин қиматро аз latency-и истинодии 100–200 ms барои ҳамкории инсон–мошин дар дохили автомобил пасттар дониста, онро барои real-time кофӣ арзёбӣ мекунанд.
Аммо ин вақт end-to-end latency-и ченшуда дар автомобили воқеӣ, embedded ECU-и истеҳсолӣ ё тамоми pipeline-и камера/eye-tracker-и дохили автомобил нест. Таҳқиқот ошкоро мегӯяд, ки deployment дар муҳити ронандагии воқеӣ анҷом дода нашудааст.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Меъмории гибридии шинохти эҳсосот, ки тасвири чеҳра ва eye-tracking data-ро якҷо истифода мебарад, амалӣ шудааст.
- ViT-B/16, Bi-LSTM, Transformer encoder, GWF ва MLP дар як multimodal pipeline истифода шудаанд.
- Дар ҷадвалҳои асосии манбаъ барои модели multimodal accuracy-и %98,72 гузориш шудааст.
- Манбаъ дар аблятсияи модалият нишон медиҳад, ки eye-movement data нисбат ба facial-image data accuracy-и баландтар додааст.
- GWF дар манбаъ бо accuracy-и баландтар аз feature concatenation-и оддӣ гузориш шудааст.
- Eye branch-и Bi-LSTM + Transformer нисбат ба аблятсияҳое, ки танҳо Bi-LSTM ё танҳо Transformer истифода мебаранд, натиҷаи баландтар нишон додааст.
- Модел дар маҷмӯаҳои умумии додаҳои эҳсосии AFFEC, SEED-IV ва AffectNet аз baseline-ҳои муқоисашуда баландтар гузориш шудааст.
- Вақти inference-и модел дар муҳити ҳисоббарории лабораторӣ дар сатҳи миллисония чен шудааст.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад, насанҷидааст ё исбот накардааст
- Модел дар ҳаракати воқеии роҳ ё ронандагии воқеӣ санҷида нашудааст.
- Нишон дода нашудааст, ки accuracy-и %98,72 ба ронандагони навкори Туркия ё гурӯҳҳои синнии дигар интиқол дода мешавад.
- Дар ин таҳқиқот таҷрибавӣ чен карда нашудааст, ки шинохти эҳсосот воқеан садамаҳои роҳро кам мекунад.
- Модел дар камераи дохили автомобил, нури офтоб, ронандагии шабона, пӯшидани чеҳра, ҳаракати зиёди сар ва ларзиши воқеии роҳ тасдиқ нашудааст.
- Дар платформаи воқеии embedded-и автомобил масрафи неру, RAM, андозаи модел ва end-to-end latency чен нашудааст.
- Муваффақият дар се маҷмӯаи додаҳои беруна санҷиши воқеии ронандагии махсус барои ронандаи навкор нест.
- Confusion matrix-и таҳқиқот қимати асосии accuracy-и %98,72-ро мустақилона тасдиқ намекунад.
- Синфҳои эҳсосии моделро набояд ҳамчун ченаки клиникӣ ё қатъии ҳолати воқеии психологии шахс тафсир кард.
Усул ва натиҷаҳои таҳқиқот
Ҷузъҳои асосии тарҳи таҳқиқот
| Ҷузъ | Маълумоти додашуда дар манбаъ |
|---|---|
| Намунаи пурсиш | 387 нафар |
| Мард/зан дар пурсиш | 197 / 190 |
| Ангезандаи садо | 17 навъ |
| Иштирокчии ибтидоии таҷриба | 34 |
| Иштирокчии самаранок | 32 |
| Синну сол | 18–25; миёна 22 |
| Таҷрибаи ронандагӣ | Номзади шаҳодатнома ё <1 сол таҷриба |
| Eye tracker | aSee Pro F100 |
| Eye-tracking sampling rate | 100 Hz |
| Eye window | 5 s / тақрибан 500 нуқтаи вақт |
| Вуруди eye model | 500 × 17 |
| Вуруди facial-image | 224 × 224 × 3 |
| Синфи эҳсос | 5 |
Параметрҳои асосии меъмории модел
| Модул | Сохтори асосӣ |
|---|---|
| Face feature extraction | ViT-B/16; 16×16 patch; classification token-и 768-андоза |
| Bi-LSTM | 128 hidden unit/самт; баромади якҷояи 256-андоза |
| Transformer encoder | 8 head, d-model 256, FFN 512, dropout 0,1, 2 қабат |
| Fusion | Gated Weighted Fusion |
| Classifier | MLP + Softmax |
Натиҷаи асосии таҷрибаи multimodal
| Eye feature model | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Назорати сифати confusion matrix
| Натиҷаи манбаъ | Гузоришшуда / дубора ҳисобшуда | Ҳолат |
|---|---|---|
| Facial-image accuracy | Шакли 8: %71,18 / аз матритсаи Шакли 10: %71,18 | Мувофиқ |
| Multimodal accuracy | Шакли 8 ва Ҷадвали 3: %98,72 / аз матритсаи Шакли 11: ≈%94,06 | Номувофиқ |
Ин назорат аз ҷониби Verianla аз рӯйи ҳуҷайраҳои Шакли 10 ва Шакли 11-и манбаъ дубора ҳисоб шудааст. Он ба ҷойи манбаъ натиҷаи нави таҷриба истеҳсол намекунад; танҳо мувофиқати арифметикии ҳуҷайраҳои нашршударо месанҷад.
Натиҷаҳо дар маҷмӯаҳои умумии додаҳо
| Dataset | Accuracy ± Std-и модели пешниҳодшуда | Macro-F1 ± Std | Ёддошти омории манбаъ |
|---|---|---|---|
| AFFEC | 91,95 ± 0,87% | 91,36 ± 0,92% | p<0,05 vs. ҳамаи baseline-ҳо |
| SEED-IV | 90,44 ± 0,75% | 89,81 ± 0,80% | p<0,05 vs. ҳамаи baseline-ҳо |
| AffectNet | 89,67 ± 0,69% | 89,02 ± 0,73% | p<0,05 vs. ҳамаи baseline-ҳо |
Натиҷаи real-time
| Ченак | Қимат |
|---|---|
| Processing time ба ҳар batch | 29,42 ± 0,08 ms |
| Hybrid inference mode, ба ҳар намуна | 0,9230 ± 0,0014 ms |
Ин қиматҳои иҷроиш ба ҳисоббарории модел дахл доранд. Онҳо ченкунии ҳақиқии end-to-end latency дар дохили автомобил нестанд, ки camera acquisition, eye-tracking acquisition, preprocessing, таъхири системаи оператсионӣ, ҳамоҳангсозии сенсор ва тавлиди огоҳиро пурра дар бар гирад.
Маҳдудиятҳои асосии таҳқиқот
- Намунаи самараноки ронандагон танҳо 32 нафар аст.
- Иштирокчиён танҳо дар гурӯҳи синнии 18–25 ҳастанд.
- Гуногунии фарҳангӣ маҳдуд аст.
- Эҳсосот дар лаборатория бо stimulus-и визуалӣ ва шунавоӣ ба вуҷуд оварда шудаанд.
- Рӯйдодҳои воқеии ғайричашмдошти роҳ санҷида нашудаанд.
- Ронандагии воқеӣ истифода нашудааст.
- Тағйироти табиии рӯшноии дохили автомобил, head movement ва facial occlusion ба таври фарогир тасдиқ нашудаанд.
- Embedded deployment-и воқеӣ анҷом дода нашудааст.
- Байни multimodal confusion matrix ва натиҷаи асосии accuracy номувофиқии ададии шарҳнадода вуҷуд дорад.
- Андозаҳои feature-и GWF байни муодилаҳои усул ва расми меъморӣ пурра шарҳ дода нашудаанд.
Ёддошт оид ба манбаъ ва усул
Номи пурраи аслии таҳқиқот: Hybrid Deep Neural Network-Based Modeling of Multimodal Emotion Recognition for Novice Drivers
Муаллифон ва тартиби онҳо: Jianzhuo Li; Ye Yu; Zhao Dai; Panyu Dai.
Муаллифи масъул: Jianzhuo Li.
Муаллифи аввали муштарак/саҳми баробар: Дар манбаъ нишон дода нашудааст.
Муассиса: School of Computer Science, Baoji University of Arts and Sciences, Baoji 721016, China.
Маҷалла: Future Internet
Ношир: MDPI, Basel, Switzerland
Ҷилд / шумора / мақола: 18 / 4 / 221
Санаи қабул: 27 Феврал 2026
Санаи бознигарӣ: 17 Апрел 2026
Санаи пазируфтан: 18 Апрел 2026
Санаи нашр: 21 Апрел 2026
DOI: 10.3390/fi18040221
Пайванди расмии нашр:https://doi.org/10.3390/fi18040221
Навъи манбаъ: Мақолаи таҳқиқотии тақризшуда; таҷрибаи лаборатории симулятсионии ронандагӣ, таҳлили eye-tracking/facial-image ва моделсозии омӯзиши амиқ.
Ҳолати тақриз: Таҳқиқот дар маҷаллаи илмии тақризшуда нашр шудааст.
Литсензия: Creative Commons Attribution (CC BY).
Версия: Файли баррасишуда v2 номида шудааст. Ёддошти версияи ношир нишон медиҳад, ки барои таҳқиқот version of record-и навшуда мавҷуд аст. Доираи навсозӣ аз доираи мундариҷаи илмии мақолаи баррасишуда берун тахмин карда нашудааст.
Тасдиқи ахлоқӣ: Таҳқиқот гузориш медиҳад, ки мувофиқи Эъломияи Helsinki гузаронида шудааст ва рақами тасдиқи Baoji University of Arts and Sciences Institutional Review Board BJWL-2025-ETH-048, санаи тасдиқ 7 Январ 2025 мебошад.
Розигии огоҳона: Манбаъ мегӯяд, ки ҳамаи иштирокчиён дар бораи ҳадаф ва тартиби таҳқиқот огоҳ карда шуда, informed-consent form-ро барои истифодаи маълумот дар таҳқиқоти илмӣ имзо кардаанд.
Маблағгузорӣ: Таҳқиқот маблағгузории беруна нагирифтааст.
Дастрасии додаҳо: Гуфта шудааст, ки маҷмӯаҳои додаҳои истифодашударо бо дархости оқилона аз муаллифи масъул гирифтан мумкин аст.
Бархӯрди манфиатҳо: Муаллифон изҳор кардаанд, ки бархӯрди манфиатҳо вуҷуд надорад.
Саҳми муаллифон: Тибқи изҳороти манбаъ, консептуализатсия Ye Yu; методология Ye Yu, Zhao Dai ва Panyu Dai; нармафзор Ye Yu ва Panyu Dai; validation, formal analysis, таҳқиқот ва data curation Ye Yu; лоиҳаи аввал Ye Yu; бозбинӣ/таҳрир Jianzhuo Li; визуализатсия Ye Yu; назорат ва идоракунии лоиҳа Jianzhuo Li анҷом додаанд.
Номувофиқии ададии дохили манбаъ 1 — confusion matrix: Accuracy-и аз ҳуҷайраҳои facial-image confusion matrix дубора ҳисобшуда %71,18 аст ва бо Шакли 8 мувофиқат мекунад. Аммо дар multimodal confusion matrix аз 4576 намуна 4304 намуна дар диагонали асосӣ ҳастанд ва accuracy-и дубора ҳисобшуда тақрибан %94,06 мебошад. Ин қимат бо %98,72-и Шакли 8 ва Ҷадвали 3 мувофиқат намекунад. Манбаъ маҷмӯаи дигар ё fold-и дигарро шарҳ намедиҳад.
Номувофиқии меъмории дохили манбаъ 2 — андозаҳои feature: Усули ViT баромади classification-token-ро 768-андоза таъриф мекунад, аммо Шакли 1 вуруди шохаи чеҳра ба GWF-ро 256×1 нишон медиҳад. Муодилаи (19)-и GWF аз ду вуруди C-андоза weighted-sum-и C-андоза месозад, аммо Шакли 1 баромадро 512×1 нишон медиҳад. Табдили фосилавӣ ошкоро таъриф нашудааст.
Номувофиқии вақти дохили манбаъ 3: Панҷ гурӯҳи таҷрибаи статикии ронандагӣ ҳар кадом тақрибан 2 дақиқа 35 сония таъриф шудаанд; ин тақрибан 12 дақиқа 55 сония аст. Сохтори stimulus-и 12 тасвир × 13 сония низ тақрибан ҳамин вақтро медиҳад. Бо вуҷуди ин, манбаъ давомнокии умумии таҷрибаи статикиро тақрибан 30 дақиқа гузориш мекунад ва сабаби фарқ шарҳ дода нашудааст.
Ёддошти воҳиди дохили манбаъ 4: Дар меъёри интихоби иштирокчӣ барои prescription-и айнак ибораи “500 diopters” мавҷуд аст. Хатои эҳтимолии воҳид/тарҷума бо тахмини аз берун гирифташуда ислоҳ карда нашудааст.
Ифодаи иҷроиши GWF: Манбаъ барои feature concatenation accuracy-и %95,45 ва барои GWF %98,72 гузориш мекунад ва афзоишро %3,27 меномад. Фарқи мутлақ байни ду accuracy-и гузоришшуда 3,27 банди фоизӣ аст.
Ёддошти ground-truth/labeling: Видеоҳои facial expression бо нармафзори ErgoLAB таҳлил шуда emotion label тавлид гардидааст ва баъд classification-и дастӣ анҷом дода шудааст. Гуфта мешавад, ки намунаҳои eye-movement бо панҷ категория label шудаанд, аммо тартиби сохт ва ҳамоҳангсозии ground-truth-и ниҳоии муштараки ду модалият дар манбаъ муфассал шарҳ дода нашудааст.
Ҳадди умумисозӣ: Validation-ҳои AFFEC, SEED-IV ва AffectNet вазифаҳои умумии шинохти эҳсосот мебошанд. Манбаъ махсус таъкид мекунад, ки ин маҷмӯаҳо novice-driver ё driving-specific нестанд. Аз ин рӯ, ин натиҷаҳо ҳамчун validation-и мустақим барои шароити воқеии ронандагӣ истифода нашудаанд.
Ҳадди real-time: Қиматҳои 29,42 ms/batch ва 0,9230 ms/sample ченакҳои processing-и модел мебошанд. Дар таҳқиқот deployment-и воқеии embedded system дар дохили автомобил ё ченкунии end-to-end latency дар шароити воқеии ронандагӣ анҷом дода нашудааст.
Усул, маҷмӯаҳои додаҳо, муодилаҳо, натиҷаҳои тасниф, ҷадвалҳо, тафсирҳои шаклҳо ва маҳдудиятҳо дар ин шарҳи Verianla ба таҳқиқоти илмии баррасишуда асос ёфтаанд. Санҷиши библиографии беруна танҳо барои тасдиқи унсурҳои ҳувияти манбаъ, аз қабили DOI, маҷалла, ношир, ҳолати тақриз ва версияи нашр истифода шудааст; аз манбаъҳои беруна натиҷаи нави шинохти эҳсосот ё қимати нави иҷроиш илова нашудааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд