

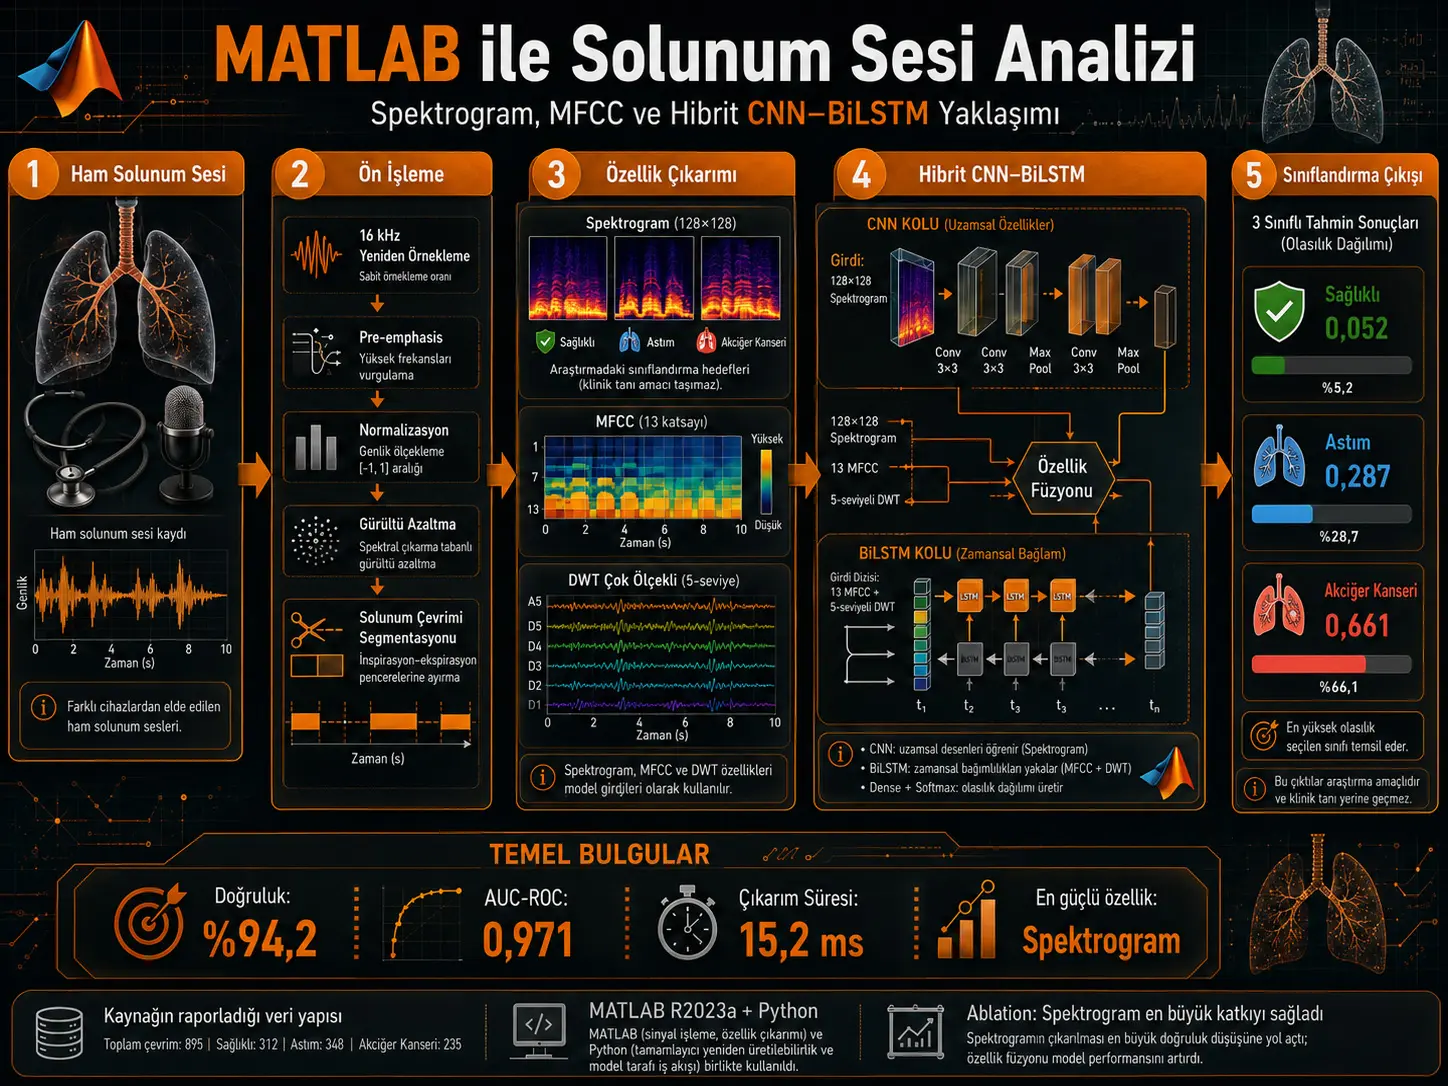
Изилдөө дем алуу үндөрүн убакыт–жыштык көрүнүштөрүнө айландырып, аларды CNN–BiLSTM модели аркылуу үч класска бөлүүнү көздөгөн эки платформалуу биомедициналык сигнал иштетүү иш агымын сүрөттөйт. MATLAB чийки дем алуу үнүн кайра үлгүлөө, чыпкалоо, нормалдаштыруу, спектрограмма/MFCC/DWT негизиндеги белгилерди бөлүп алуу жана натыйжаларды текшерүү үчүн колдонулган эки негизги эсептөө платформасынын бири. Экинчи платформа — Python.
Булак үч максаттуу энбелгини Healthy, Asthma жана Lung Cancer деп аныктайт. Бирок бул үч класстуу классификация, өзгөчө “Lung Cancer” классы жогорудагы маалымат булагын текшерүү көйгөйүнөн улам клиникалык диагноздун ийгилиги катары чечмеленбеши керек. Бул Verianla макаласы изилдөөнү биринчи кезекте MATLAB негизиндеги дем алуу үнүн иштетүү жана CNN–LSTM архитектурасы жагынан карайт.
Кыскача Мазмун
Булак изилдөө ICBHI 2017 Respiratory Sound Database маалымат базасынан тандалган деп билдирген 895 дем алуу циклинде спектрограмма, Mel-Frequency Cepstral Coefficients (MFCC), Discrete Wavelet Transform (DWT) жана убакыт-аймак белгилерин колдонгон гибриддик CNN–BiLSTM классификаторун сунуштайт. Үндөр адегенде 16 kHz жыштыкка кайра үлгүлөнөт, pre-emphasis колдонулат, z-score нормалдаштыруу жана spectral-subtraction аркылуу ызы-чууну азайтуу жүргүзүлөт, андан соң дем алуу циклдери energy-envelope жана zero-crossing-rate босоголору менен сегменттерге бөлүнөт. CNN бутагы 128×128 боз деңгээлдеги спектрограммалардан мейкиндик белгилерин чыгарат, ал эми BiLSTM бутагы MFCC негизиндеги убакыттык ырааттуулукту иштетет. Булакка ылайык, бириктирилген модель тесттик топтомдо %94,2 accuracy, %93,9 precision, %93,5 recall, %93,6 F1-score жана 0,971 AUC-ROC көрсөткөн. Ablation натыйжасында спектрограмманы алып салуу accuracy көрсөткүчүн 8,5 пайыздык пунктка түшүрүп, эң чоң жоготууга алып келген. Модель үчүн билдирилген inference убактысы 15,2 ms/model киргизүүсү деңгээлинде. Бирок изилдөөдөгү өпкө рагы энбелгилери ICBHI 2017нин текшерүүгө боло турган диагноздук түзүлүшүнө дал келбегендиктен, бул көрсөткүчтөр текшерилген клиникалык өпкө-рагы диагнозунун критерийлери катары кабыл алынбашы керек.
Дем алуу үнүнөн ооруну классификациялоо кантип MATLAB маселесине айланат?
Өпкө үнүнүн жазуусу компьютерге киргенде модель али “астма” же башка клиникалык маанини көрбөйт. MATLAB жагынан баштапкы чекит — убакытка жараша өзгөргөн сандык амплитуда үлгүлөрү гана. Ошондуктан изилдөөнүн эсептөө чынжыры алгач чийки үндү стандарттуу үлгүлөө түзүлүшүнө келтирет, андан кийин ызы-чууну азайтып, убакыт–жыштык белгилерин бөлүп чыгарат. Терең үйрөнүү модели ушул этаптардан кийин гана ишке кирет.
Булактын 2-бетиндеги 1-сүрөт бул чынжырды беш негизги блок менен көрсөтөт: Raw Audio Input → Signal Preprocessing → Feature Extraction → CNN-LSTM Model → Classification Output. Маалыматты көбөйтүү training учурунда гана колдонулган кошумча этап катары көрсөтүлгөн.
Маалымат топтому булакка ылайык кантип бөлүнгөн?
Булак ICBHI 2017деги 920 жазуудан сапат чыпкасынан кийин 895 дем алуу циклин колдонгонун билдирет. Булак берген таблица төмөнкүдөй:
| Булактын класс энбелгиси | Дем алуу цикли | Үлүшү (%) | Training | Validation | Test |
|---|---|---|---|---|---|
| Healthy | 312 | 34,8 | 218 | 47 | 47 |
| Asthma | 348 | 38,9 | 244 | 52 | 52 |
| Lung Cancer | 235 | 26,3 | 165 | 35 | 35 |
| Жалпы | 895 | 100 | 627 | 134 | 134 |
Бул таблица булак макаланын өз эксперименттик түзүлүшүн туура чагылдырат. Бирок айрыкча 235 Lung Cancer цикли ICBHI маалымат топтомунан кантип алынганы түшүндүрүлгөн эмес жана тышкы маалымат топтомун текшерүү менен дал келбейт. Ошондуктан кийинки бардык көрсөткүч таблицалары “булак билдирген классификация” катары окулушу керек.
3-беттеги үч спектрограмма эмнени түшүндүрөт?
Булак 2-сүрөттө бирдей STFT көрсөтүү форматында Healthy, Asthma жана Lung Cancer деп энбелгиленген үч мисалды көрсөтөт. Healthy мисалы энергиясы төмөн жана бир калыпта, Asthma мисалы өзгөчө 500–2500 Hz аралыгында горизонталдуу/үзгүлтүксүз жогорку энергия тилкелерине ээ, ал эми Lung Cancer деп энбелгиленген мисал башаламан жогорку жыштыктагы кыска энергия жарылуулары катары чечмеленет.
Бул сүрөттөр CNN бутагы эмне үчүн колдонулганын түшүндүрөт: CNN жалпы энергияга гана карабайт; спектрограммадагы жергиликтүү форма, тилке, чек жана убакыт–жыштык текстураларын үйрөнүүгө аракет кылат. Бирок маалымат энбелгиси көйгөйү чечилмейинче бул визуалдык үлгүлөрдү өпкө рагына мүнөздүү клиникалык биомаркер деп айтууга болбойт.
MATLAB preprocessing чынжыры
Булак preprocessing процессин беш ырааттуу этапка бөлөт. Биринчи этап — бардык жазууларды 16 kHz үлгүлөө жыштыгына келтирүү. Ошентип, ар башка түпкү sampling rate менен жазылган маалыматтар бир убакыт огунда иштетилет. Экинчи этапта коэффициенти \(\alpha=0.97\) деп берилген first-order pre-emphasis колдонулат. Үчүнчү этапта z-score amplitude normalisation, төртүнчү этапта spectral-subtraction noise reduction, ал эми акыркы этапта energy-envelope жана zero-crossing-rate thresholding негизиндеги respiratory-cycle segmentation жүргүзүлөт.
Булак бул операцияларды MATLAB R2023a чөйрөсүндө Audio Toolbox жана Signal Processing Toolbox менен, параллелдүү текшерүү максатында Python чөйрөсүндө да ишке ашырганын билдирет. Маанилүү булак бүтүндүгүнүн көйгөйү — preprocessing теңдемелерине Eq. 1, Eq. 9 жана Eq. 10 деп шилтеме берилгенине карабай, бул теңдемелер жүктөлгөн PDF документинде көрүнбөйт. Ошондуктан Verianla бул жерде жетишпеген формулаларды жалпы билимден толуктабайт.
Спектрограмма эмне үчүн 128×128 пикселге айландырылат?
Булак CNN киргизүүсүн 128×128×1 grayscale spectrogram деп аныктайт. Бул жердеги алгачкы эки сан сүрөттүн убакыт–жыштык тегиздигиндеги өлчөмүн, акыркы сан болсо бир боз деңгээлдеги каналды көрсөтөт.
CNN үчүн туруктуу киргизүү өлчөмү маанилүү. Ар кандай дем алуу циклдеринин узактыгы өзгөрсө да, моделдин convolution катмарларына бирдей геометриялык өлчөмдөгү маалымат берилүүгө тийиш. Булак бул стандартташтыруунун кеңири resize ыкмасын түшүндүрбөйт; акыркы спектрограмма өлчөмүн гана берет.
MFCC деген эмне жана булакта канча коэффициент колдонулган?
Булак feature-extraction сүрөтүндө ар бир дем алуу үлгүсү үчүн 13 MFCC coefficient алынганын көрсөтөт. MFCCлер үндүн спектрдик кабыгын кысылган формада көрсөтүү үчүн колдонулат.
Изилдөөнүн архитектурасы жагынан спектрограмма менен MFCC бир эле маалыматты бирдей түрдө көрсөтпөйт. Спектрограмма CNNге эки өлчөмдүү сүрөт берсе, MFCC ырааттуулугу BiLSTM бутагына убакыттык катар катары берилет. Ошентип, бири мейкиндик убакыт–жыштык түзүлүшүн, экинчиси ырааттуу акустикалык динамиканы үйрөнүүгө аракет кылат.
DWT эмне үчүн өзүнчө колдонулган?
Булак DWT үчүн Daubechies-4 (db4) wavelet жана 5 level decomposition колдонгонун билдирет. Wavelet анализи кыска мөөнөттүү өтмө окуяларды ар кандай масштабда көрсөтүүгө мүмкүндүк берет. Изилдөө өзгөчө crackle сыяктуу кыска мөөнөттүү өтмө маалымат wavelet аркылуу кошумча түрдө кармалышы мүмкүн деп болжолдойт.
Ablation натыйжалары бул белгилер тобун алып салуу accuracy көрсөткүчүн %94,2ден %91,8ге түшүргөнүн, башкача айтканда булак экспериментинде 2,4 пайыздык пункт салым менен байланышканын көрсөтөт.
4-беттеги белгилердин курамы
Булактын 6-сүрөтүндөгү тегерек диаграмма белгилердин курамын визуалдуу түрдө болжол менен төрт топко бөлөт: спектрограмма, MFCC, DWT statistics жана time-domain белгилери. Ошол эле сүрөт оң жагында 36-dimensional numerical feature vector көрсөтөт.
Бирок ошол эле беттеги архитектуралык текст BiLSTM “MFCC sequence” иштетээрин айтат. DWT жана time-domain өзгөрмөлөрү 36 өлчөмдүү вектор аркылуу BiLSTMге берилип-берилбей турганы, өзүнчө dense катмарга кирээри же MFCC sequenceке кандай кошулаары ачык көрсөтүлгөн эмес. Бул жетишпестик изилдөөнү MATLAB чөйрөсүндө так кайра чыгаргысы келген адам үчүн маанилүү.
CNN бутагы кантип түзүлгөн?
CNN бутагы үч convolutional block камтыйт. Булак фильтрлердин санын тиешелүүлүгүнө жараша 32, 64 жана 128 деп берет. Ар бир блокто batch normalisation, 2×2 max-pooling жана \(p=0.25\) dropout колдонулат.
Бул бутактын аягында:
\[ f_{\mathrm{CNN}}\in\mathbb{R}^{128} \]
өлчөмдүү көрсөтмө алынары жана CNN бутагы болжол менен 1,2 миллион параметр камтыары айтылат.
Convolution фильтрлери бүт спектрограмманы бир жолудан жаттап алуунун ордуна кичинекей аймактарда кайра колдонулуучу фильтрлер менен иштейт. Тереңирээк катмарларга өткөн сайын жөнөкөй жергиликтүү энергия үлгүлөрүнөн татаалыраак убакыт–жыштык үлгүлөрүнө карай көрсөтмө түзүү максат кылынат.
BiLSTM бутагы кантип иштейт?
Булакка ылайык BiLSTM бутагында эки bidirectional LSTM layer бар. Биринчиси 128 unit, экинчиси 64 unit камтыйт.
Бутактын аягында:
\[ f_{\mathrm{LSTM}}\in\mathbb{R}^{128} \]
өлчөмдүү көрсөтмө түзүлөт жана бул бутак болжол менен 0,8 миллион параметр камтыары билдирилет.
“Bidirectional” түшүнүгүнүн мааниси — MFCCнин убакыт кадамы өзүнө чейинки үлгүлөр менен гана эмес, training учурунда ырааттуулуктун кийинки бөлүгүндөгү контекст менен да бирге көрсөтүлө алат. Ошентип, дем алуу циклинин убакыттагы өнүгүүсү CNNдин спектрограмма үлгүлөрүн толуктаган экинчи маалымат каналына айланат.
Эки модель кантип бириктирилет?
Булак ачык берген fusion операциясы:
\[ f_{\mathrm{fused}} ================== [f_{\mathrm{CNN}};f_{\mathrm{LSTM}}] \in\mathbb{R}^{256} \]
түрүндө.
128 өлчөмдүү CNN жана 128 өлчөмдүү BiLSTM чыгыштары учма-уч бириктирилип, 256 өлчөмдүү feature-fusion вектору алынат. Андан кийин булак:
Dense(128) → Dropout(0.5) → Dense(3) → Softmax
чынжырын аныктайт.
Акыркы Dense(3) катмарындагы үч чыгыш булак Healthy, Asthma жана Lung Cancer деп аныктаган үч классты билдирет.
Модель эмне үчүн болжол менен 2,1 миллион параметрге ээ?
Булак эсептөө таблицасында бүт CNN–LSTM системасын болжол менен 2,1 миллион trainable parameter менен билдирет. CNN бутагы болжол менен 1,2 миллион, BiLSTM бутагы болжол менен 0,8 миллион деп берилгендиктен, калган параметрлер fusionдан кийинки dense классификация бөлүгүн да камтыйт.
Class imbalance кантип эске алынган?
Булак класстардагы үлгүлөрдүн саны бирдей болбогондуктан multi-class cross-entropy loss ичинде class weights колдонот:
\[ w_c= \frac{N}{C,N_c} \]
Бул жерде \(N\) жалпы үлгүлөрдүн санын, \(C\) класстардын санын, ал эми \(N_c\) тиешелүү класска таандык үлгүлөрдүн санын билдирет. Ошентип, үлгүсү аз класстардагы каталардын loss функциясындагы салмагын көбөйтүү максат кылынат.
Training параметрлери
| Training параметри | Булак мааниси |
|---|---|
| Optimiser | Adam |
| Learning rate | 0,001 |
| \(\beta_1\) | 0,9 |
| \(\beta_2\) | 0,999 |
| Batch size | 32 |
| Максималдуу epoch | 100 |
| Early-stopping patience | 15 |
| Cross-validation | 5-fold stratified |
| Time stretching | ×0,9–1,1 |
| Pitch shifting | ±2 semitone |
| Gaussian noise | \(\sigma=0.005\) |
Data augmentation training тарабында гана колдонулат. Бул айырма маанилүү: test маалыматына augmentation колдонуу көрсөткүчтөрдү өлчөөнүн маанисин өзгөртмөк.
Early stopping эмне үчүн керек?
Булакта максималдуу training 100 epoch деп коюлганына карабай, validation loss эң төмөн маанисине болжол менен 45-epoch чамасында жетип, мыкты модель ошол учурда checkpoint кылынган. Early stopping болжол менен 60-epoch чамасында ишке кирген.
Булак билдирген training loss башында 1,098 болуп, 0,142ге чейин төмөндөгөн; минималдуу validation loss болсо 0,186 болгон. Авторлор train жана validation ийри сызыктарынын ортосундагы чакан айырманы олуттуу overfitting байкалбаганы катары чечмелешет.
Беш башка моделди салыштыруу
Булактын өз эксперименттеринде гибриддик модель бардык бир бутактуу baseline моделдерден жогору натыйжа берет. CNN менен BiLSTMнин бириктирилиши булакта спектрограмманы гана же MFCCни гана колдонууга караганда жогорку көрсөткүч менен байланышкан.
Accuracy эмне үчүн жалгыз өзү жетишсиз?
Accuracy — бардык туура чечимдердин үлүшү; бирок класстар тең салмаксыз болгондо ал жалгыз өзү адаштырышы мүмкүн. Ошондуктан булак precision, recall, F1-score, specificity, ROC-AUC жана confusion matrixти да билдирет.
Бул мамиле MATLAB жана жасалма интеллектти үйрөнүү жагынан абдан маанилүү. Өзгөчө саламаттык сактоо классификацияларында модель “канча үлгүнү туура тапканы” гана эмес, белгилүү класстагы чыныгы учурларды кандай үлүштө аныктай алганы да маанилүү.
Булактын класс боюнча натыйжалары
| Булак энбелгиси | Precision (%) | Recall (%) | F1 (%) | Specificity (%) | Test үлгүсү |
|---|---|---|---|---|---|
| Healthy | 95,7 | 96,2 | 95,9 | 97,8 | 47 |
| Asthma | 92,8 | 94,1 | 93,4 | 96,2 | 52 |
| Lung Cancer | 93,1 | 89,2 | 91,1 | 97,5 | 35 |
| Macro average | 93,9 | 93,2 | 93,5 | 97,2 | 134 |
Булак эң төмөн recall мааниси %89,2 менен Lung Cancer энбелгисинде экенин; муну класс тең салмаксыздыгы жана Asthma менен 500–2500 Hz аймагындагы окшош wheeze акустикасы менен байланыштырат. Бул түшүндүрмө булак авторлорунун чечмелөөсү; маалымат энбелгилеринин клиникалык келип чыгышы текшерилбегендиктен, көз карандысыз клиникалык тыянак катары кабыл алынбашы керек.
Confusion matrixтин чыныгы сандары
6-беттеги 5-сүрөт 134 үлгүлүү test топтомунун чийки сандарын ачык берет:
| Чыныгы \ Божомол | Healthy | Asthma | Lung Cancer |
|---|---|---|---|
| Healthy | 45 | 2 | 0 |
| Asthma | 2 | 48 | 1 |
| Lung Cancer | 0 | 4 | 33 |
Булактын өз түшүндүрмөсүндө эң чоң жалгыз off-diagonal ката — төрт Lung Cancer үлгүсүнүн Asthma деп классификацияланышы.
ROC анализи
| Булак энбелгиси | One-vs-rest AUC |
|---|---|
| Healthy | 0,978 |
| Asthma | 0,969 |
| Lung Cancer | 0,965 |
Булак бардык ROC ийри сызыктары кокустук классификатордун 0,5 AUC сызыгынан жогору жайгашканын билдирет. Беш катмарлуу cross-validation үчүн %95 confidence interval көлөкөлөрү 7-сүрөттө көрсөтүлгөн.
Ablation study деген эмне?
Ablation изилдөөсүндө моделдин бир компоненти же белгилер тобу кезеги менен алынып салынат жана көрсөткүч канчалык төмөндөй турганы байкалат. Ошентип, модель кайсы маалымат каналына көбүрөөк көз каранды экени түшүнүлүүгө аракет кылынат.
Булактын эң так моделдөө натыйжасы ушул: спектрограмма алынганда көрсөткүч эң кескин төмөндөйт. Ошого карабастан, спектрограмма гана колдонулган модель %91,1 деңгээлинде калса, бардык белгилердин бирикмеси %94,2ге жетет. Авторлор муну ар кандай белги модалдуулуктары бири-бирин толуктаган маалымат алып жүрөт деп чечмелешет.
BiLSTMнин салымы кантип өлчөнгөн?
Булак CNN-only baselineдын %88,6 тактыгын гибриддик системанын %94,2 натыйжасы менен салыштырат; ошондой эле frequency-sensitivity бөлүмүндө BiLSTM temporal component CNN-only түзүлүшкө караганда 3,1 пайыздык пункт салым бергенин билдирет. Бул эки билдирүү түз эле бир арифметикалык айырма эмес; булакта ар башка контексттерде берилген жана бул жерде бири-бирине айландырылбайт.
Кайсы жыштык аймагы көбүрөөк айырмалоочу?
Булак frequency-band sensitivity анализинде айырмалоочу маалыматтын:
| Жыштык аралыгы | Булак билдирген салым | Булак түшүндүрмөсү |
|---|---|---|
| 0–500 Hz | %23 | Normal breath |
| 500–2500 Hz | %45 | Wheeze patterns |
| 2500–8000 Hz | %32 | Crackles / high-frequency information |
түрүндө бөлүштүрүлгөнүн билдирет. Бирок бул %23/%45/%32 маанилер кайсы математикалык sensitivity эсептөөнөн алынганы макалада кеңири аныкталган эмес.
Эсептөө көрсөткүчтөрү
| Модель | Параметр (M) | Training (мүн) | Inference (ms) | Эс тутум (MB) |
|---|---|---|---|---|
| SVM + MFCC | — | 12,3 | 2,1 | 45 |
| Random Forest | — | 18,7 | 5,4 | 128 |
| CNN | 1,2 | 142,5 | 8,3 | 156 |
| BiLSTM | 0,8 | 98,4 | 12,7 | 98 |
| CNN–LSTM | 2,1 | 215,8 | 15,2 | 234 |
Бул таблица машиналык үйрөнүүдөгү маанилүү чындыкты көрсөтөт: булакта эң жогорку accuracy көрсөткөн модель ошол эле учурда эң узак training убактысына жана эң көп эс тутум колдонууга ээ. Татаалыраак модель ар бир көрсөткүчтө автоматтык түрдө “жакшыраак” эмес; тактык менен эсептөө чыгымынын ортосунда долбоордук компромисс бар.
15,2 ms эмнени билдирет?
Булак CNN–LSTM үчүн 15,2 ms inference убактысын билдирип, аны 400 ms терезе узундугундагы streaming audio үчүн 25 ms талаптан кыска болгондугу үчүн реалдуу убакытта колдонууга ылайыктуу деп чечмелейт.
Бул жерде көңүл бура турган нерсе — туюнтманын бирдиги. Таблицада “Inference (ms)” деп жазылса, текстте “15.2 ms/sample” деп берилген. Эгер “sample” бул жерде бир гана 16 kHz audio sample деген маанини билдирсе, бул чечмелөө туура болмок эмес. Булактын контекстине ылайык, бир модель үлгүсү / анализ терезеси айтылып жатышы ыктымалыраак; бирок макала муну ачык аныктабайт.
Статистикалык маанилүүлүк тести
Булак беш катмарлуу cross-validation натыйжаларына paired t-test колдонгонун билдирет:
| Салыштыруу | t | p |
|---|---|---|
| CNN–LSTM vs CNN | 3,42 | 0,026 |
| CNN–LSTM vs BiLSTM | 4,18 | 0,013 |
| CNN–LSTM vs Random Forest | 6,73 | 0,002 |
Үч салыштыруунун баарында булак \(p<0.05\) жыйынтыгына келет. Бирок болгону беш fold боюнча t-test колдонуу чакан үлгүдөгү статистикалык салыштыруу болуп саналат; көрсөткүч тууралуу дооматтын маалымат-энбелги жана subject leakage сыяктуу негизги маалымат көйгөйлөрүн өз алдынча чечпейт.
Адабиятта мындан жогорку accuracy бар болсо, булак эмне үчүн %94,2ни маанилүү деп эсептейт?
Макала өз ыкмасы абсолюттук accuracy рекорду экенин айтпайт. Булак 6-таблицада Zhang жана кесиптештеринин 2024-жылдагы dual-channel CNN-LSTM ыкмасы %99,01 accuracy көрсөткөнүн ачык тааныйт.
Авторлордун өз салымы тууралуу дооматы негизинен үч багытта: үч класстуу disease classification, MATLAB/Python эки платформалуу кайра өндүрүлүмдүүлүк жана inference latency / memory footprint сыяктуу эсептөө профилин билдирүү.
Бирок биринчи салымдагы “lung cancer” классынын маалымат булагы текшерилбегендиктен, бул салым Verianla тарабынан далилденген клиникалык жаңылык катары кабыл алынбайт.
MATLAB жагынан бул изилдөөдөн эмнени үйрөнө алабыз?
Изилдөөнүн эң пайдалуу жагы — жалгыз терең үйрөнүү тармагы эмес, баштан аягына чейинки инженердик чынжыр. MATLAB үйрөнгөн адам бул жерде төмөнкү байланышты көрүшү керек: чийки сигнал стандартташтырылмайынча модель окутулбайт; спектрограмма жана MFCC сыяктуу көрсөтмөлөр ар башка маалымат алып жүрөт; CNN жана LSTM ар башка маалымат геометрияларын иштетет; класс тең салмаксыздыгы loss долбооруна таасир берет; augmentation training учурунда гана колдонулушу керек; training accuracy жалгыз өзү жетишсиз; validation, test, confusion matrix, ROC, ablation жана cross-validation ар башка суроолорго жооп берет; мындан тышкары моделдин эс тутуму жана inference убактысы да реалдуу системаны долбоорлоонун бир бөлүгү.
Ошондуктан MATLABдагы биомедициналык жасалма интеллект долбоору “сигналды spectrogramга айландырып neural networkке берүү” менен чектелбейт. Маалыматтын келип чыгышы жана бейтап энбелгилеринин тууралыгы коддун өзүнөн да мурда турат. Бул изилдөө дал ушул жерде абдан сабак болчу каршы мисалды көрсөтөт: эсептөө чынжыры канчалык өнүккөн болбосун, максат энбелгилердин булагы текшерилбесе, модель көрсөткүчтөрүнүн клиникалык мааниси алсырайт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Булактын изилдөө суроолору
Макала төрт изилдөө суроосун аныктайт. Биринчи суроо — спектрограмма белгилери дем алуу үнү класстарын клиникалык маанилүү sensitivity менен ажырата алабы. Экинчи суроо — гибриддик CNN–LSTM архитектурасы бир-модель baselineдардан жогору чыгабы. Үчүнчү суроо — кайсы feature modality accuracyга эң чоң салым берет. Төртүнчү суроо — система реалдуу убакытта колдонууга жетиштүү эсептөө көрсөткүчүнө ээби.
Маалыматты даярдоо
Булак 920 ICBHI жазуусунун ичинен сапат чыпкасынан кийин 895 respiratory cycle колдонгонун билдирет. Алардын %70и training, %15и validation жана %15и test үчүн бөлүнгөн. Сандар тиешелүүлүгүнө жараша 627, 134 жана 134.
Бул жерде кайрадан баса белгилөө керек: split “stratified” деп берилгени менен patient-independent деп аныкталган эмес. Бир бейтапка таандык ар башка циклдер көз карандысыз маалымат үлгүлөрү сыяктуу ар башка бөлүктөргө түшүп-түшпөгөнү белгисиз.
Preprocessing
| Ирет | Булак операциясы | Булак параметри |
|---|---|---|
| 1 | Resampling | 16 kHz |
| 2 | Pre-emphasis | \(\alpha=0.97\) |
| 3 | Amplitude normalisation | z-score |
| 4 | Noise reduction | spectral subtraction |
| 5 | Respiratory cycle segmentation | energy envelope + ZCR thresholding |
Feature extraction
Булакта түз текшериле турган негизги киргизүүлөр — 128×128 спектрограмма, 13 MFCC коэффициенти, db4 wavelet менен беш деңгээлдүү DWT жана time-domain белгилери. 6-сүрөт ошондой эле 36 өлчөмдүү numerical feature vector көрсөтөт.
Модель архитектурасы
| Катмар / бөлүк | Булак түзүлүшү |
|---|---|
| CNN input | 128×128×1 спектрограмма |
| Convolution block 1 | 32 фильтр + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 2 | 64 фильтр + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 3 | 128 фильтр + batch norm + 2×2 max-pool + dropout 0,25 |
| CNN embedding | 128 өлчөм |
| BiLSTM layer 1 | 128 unit |
| BiLSTM layer 2 | 64 unit |
| BiLSTM embedding | 128 өлчөм |
| Fusion | 256 өлчөм |
| Dense | 128 |
| Dropout | 0,5 |
| Output | Dense(3) + softmax |
Негизги көрсөткүч натыйжасы
Булактын акыркы гибриддик модели %94,2 accuracy жана 0,971 AUC-ROC берет. Өзүнчө CNN %88,6, өзүнчө BiLSTM болсо %90,5 accuracy деңгээлинде калат. Демек, булак маалыматтарынын ичинде fusion модели эки бир бутактуу моделге караганда жогорку көрсөткүчкө ээ.
Белгилердин салымы боюнча натыйжа
Ablation изилдөөсүндөгү эң чоң төмөндөө спектрограмма алынганда болот: %94,2 → %85,7. MFCC алынганда %89,3, wavelet алынганда %91,8 жана time-domain алынганда %93,5 алынат.
Бул булактын RQ3 суроосуна берген жообу: өз экспериментинде эң айырмалоочу жалгыз модалдуулук — спектрограмма.
Эсептөө чыгымы боюнча натыйжа
Гибриддик система 2,1 миллион параметр, 215,8 мүнөт training, 15,2 ms inference жана 234 MB memory footprint менен сыналган моделдердин ичинен эң кымбат эсептөөчү модель. Ошол эле учурда эң жогорку accuracyны да ушул система берет.
Булактын өз чектөөлөрү
Авторлор 895 циклден турган маалымат топтому клиникалык масштаб үчүн чакан экенин, Lung Cancer классы %26,3 үлүш менен аз берилгенин, көз карандысыз тышкы когорт validation жүргүзүлбөгөнүн, cancer stage же asthma severity сыяктуу ички класстар каралбаганын, interpretability мамилеси формалдуу SHAP/LIME ордуна frequency-band sensitivity менен чектелгенин жана адабияттагы %99,01 натыйжалуу Zhang изилдөөсү менен салыштыруу ар кандай augmentation стратегияларынан таасирленерин моюнга алышат.
Verianla булакка кошкон негизги текшерүү чеги
Булактын өз limitation бөлүмүнө кошумча, Verianla жагынан эң маанилүү көйгөй — маалымат энбелгилеринин келип чыгышы. Расмий ICBHI жазуусу 920 үн файлы, 126 адам жана 6.898 respiratory cycle бар экенин билдирип, циклдер адистер тарабынан normal, crackle, wheeze же crackle+wheeze деп белгиленгенин ачык көрсөтөт. ICBHIни оорунун деңгээлинде пайдаланууну түшүндүргөн басылмалар маалымат топтомундагы диагноздорду COPD, Healthy, Bronchiectasis, Bronchiolitis, URTI, Pneumonia, Asthma жана LRTI деп көрсөтөт; алардын ичинде lung cancer жок.
Ошондуктан булактагы “235 Lung Cancer respiratory cycles” деген билдирүүнү кайра өндүрүлө турган маалымат дал келүүсүсүз кабыл алуу мүмкүн эмес. Эгер булактын MATLAB коду, бейтап идентификаторлорунун тизмеси же 235 цикл кайсы диагноз metadataсынан алынганы жарыяланса, бул маселе өзүнчө кайра бааланышы мүмкүн.
Жыйынтык
MATLAB жана терең үйрөнүү көз карашынан алганда изилдөө audio preprocessing, спектрограмма, MFCC, wavelet, CNN, BiLSTM, feature fusion, class weighting, augmentation, early stopping, cross-validation, confusion matrix, ROC, ablation жана inference profiling түшүнүктөрүнүн бир изилдөө чынжырында кантип бириктириле турганын көрсөткөн бай мисал.
Илимий диагноз көз карашынан болсо ошол эле изилдөө маанилүү принципти эске салат: моделдин %94,2 тактык көрсөтүшү максат класстар туура аныкталганын далилдебейт. Жасалма интеллект ага берилген энбелгилерди гана үйрөнөт. Энбелгилердин клиникалык булагы текшерилбесе, жакшыраак neural network архитектурасы бул негизги көйгөйдү чече албайт. Ошондуктан Verianla жагынан бул изилдөөнү эң туура пайдалануу — “MATLAB менен дем алуу үнүн классификациялоонун техникалык иш агымын үйрөтүү”; азыркы түрүндө “дем алуу үнүнөн өпкө рагын %94,2 тактык менен диагноздогон текшерилген система” деп көрсөтүү эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Толук түпнуска изилдөө аталышы: Spectrogram-Based Detection of Lung Cancer and Asthma Using Deep Learning and MATLAB: A Hybrid CNN-LSTM Approach
Авторлор: Mridul Vats; Pooja Sabherwal; Monika Agrawal.
Авторлордун ирети: Булактагы ирет өзгөртүлбөй сакталган.
Мекемелер: Булак PDF Mridul Vats жана Pooja Sabherwal үчүн The NorthCap University, Department of Electronics and Communication Engineering; Monika Agrawal үчүн IIT Delhi, Centre for Applied Research in Electronics (CARE) маалыматын берет.
Байланыш автору: SSRN каттоо барагында Mridul Vats Contact Author катары көрсөтүлгөн.
Булак түрү: Терең үйрөнүү жана биомедициналык сигнал иштетүү боюнча preprint.
Максаттуу журнал: Булак PDF документинде Biomedical Signal Processing and Control журналына жөнөтүлгөн manuscript катары көрүнөт. Бул билдирүү жарыялоого кабыл алынды дегенди билдирбейт.
Рецензия абалы: Бул изилдөө рецензиядан өтпөгөн preprint; натыйжалар ушул жарыялоо баскычы эске алынып бааланышы керек.
Платформа: SSRN.
DOI: 10.2139/ssrn.6689273.
SSRN датасы: 1 May 2026.
MATLAB: MATLAB R2023a, Audio Toolbox, Signal Processing Toolbox.
Python тарабы: librosa, scipy, PyWavelets.
Булак кодго жеткиликтүүлүк: Макала MATLAB жана Python implementation scriptтерин corresponding authorдан негиздүү суроо-талап боюнча алууга болорун билдирет; жүктөлгөн версияда ачык туруктуу код репозиторийи берилген эмес.
Каржылоо: No external funding.
Кызыкчылыктардын кагылышы: Булак competing financial or personal interests жок экенин билдирет.
Маалыматка жеткиликтүүлүк: Булак ICBHI 2017 Respiratory Sound Database маалымат базасын колдонот. Расмий ICBHI жазуусу маалымат топтомун 920 жазуу, 126 адам жана 6.898 respiratory cycle деп аныктайт.
Критикалык маалымат-энбелги эскертүүсү: Булак 312 Healthy, 348 Asthma жана 235 Lung Cancer циклин колдонгонун ырастайт. Тышкы библиографиялык текшерүүдө ICBHI диагноз класстарынын арасында өпкө рагы табылган эмес. ICBHIни оору деңгээлинде колдонгон басылмаларда COPD, healthy, bronchiectasis, bronchiolitis, URTI, pneumonia, asthma жана LRTI класстары билдирилет. Булак макала 235 lung-cancer энбелгиси кайдан келгенин түшүндүрбөйт.
Бейтап негизиндеги split эскертүүсү: Булак %70/%15/%15 stratified split жана 5-fold stratified cross-validation билдирет, бирок subject-independent partition ачык көрсөтүлгөн эмес. Ошондуктан бир эле бейтаптын ар башка дем алуу циклдери training жана test топтомдоруна бөлүнүп кеткен-кетпегени текшерилбейт.
Архитектураны кайра өндүрүү боюнча эскертүү: DWT жана time-domain features ablation анализинде модель компоненти катары көрүнгөнү менен, архитектуралык түшүндүрмөдө акыркы fusion ачык түрдө CNN spectrogram embedding менен BiLSTM MFCC embedding ортосунда гана көрсөтүлгөн. Бул белгилердин чыныгы network байланышы толук аныкталган эмес.
Теңдеме жетишпестиги: Булак Eq. 1–15 аралыгындагы ар кандай теңдемелерге шилтеме берет, бирок алардын маанилүү бөлүгү жүктөлгөн PDFде көрүнбөйт. Жетишпеген туюнтмалар Verianla тарабынан тышкы билимден кайра түзүлгөн эмес.
Клиникалык колдонуу чеги: Бул изилдөө клиникалык диагноз тести, перспективдүү бейтап изилдөөсү же көз карандысыз оорукана текшерүүсү эмес. External validation жүргүзүлгөн эмес. Маалыматты энбелгилөө көйгөйү чечилмейинче “lung-cancer detection” көрсөткүчүнүн клиникалык жарактуулугу далилденди деп эсептөөгө болбойт.
Илимий мазмун булагы: MATLAB/Python preprocessing, CNN–BiLSTM архитектурасы, бардык модель параметрлери, dataset таблицасы, модель натыйжалары, confusion matrix, ROC, ablation, training динамикасы, inference/эс тутум маанилери жана булак авторлорунун түшүндүрмөлөрү жүктөлгөн 10 беттик макалага негизделген. Тышкы булак изилдөөсү библиографиялык идентификация жана ICBHI маалымат түзүлүшүн көз карандысыз текшерүү үчүн гана колдонулган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген