

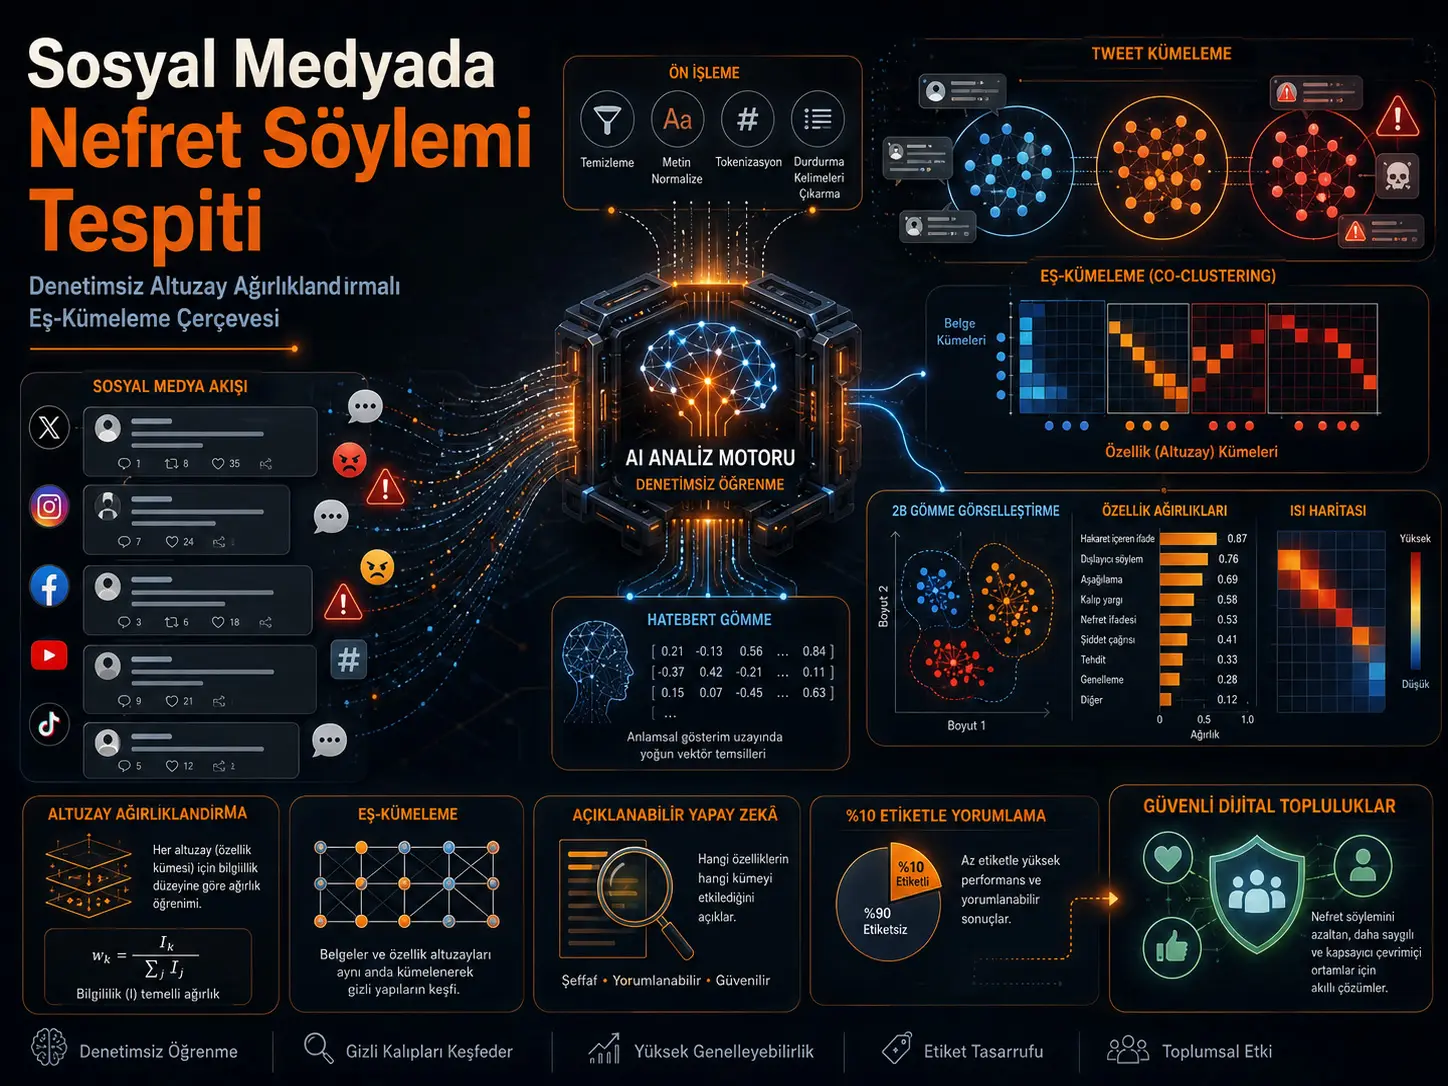
Бул изилдөө социалдык медиадагы англис тилиндеги жек көрүү сөздөрүнүн үлгүлөрүн көп көлөмдөгү белгиленген окутуу маалыматтарын талап кылбастан табуу максатында Subspace Weighting Co-Clustering (SWCC; субмейкиндикти салмактоочу кош кластерлөө) деп аталган ыкманы сунуштайт. Система тексттерди 768 өлчөмдүү контексттик embeddingдерге айландырган BERT-негизиндеги тил моделинен башталат; андан кийин tweetтерди жана ушул embedding мейкиндигиндеги өзгөчөлүк өлчөмдөрүн бир убакта кластерлейт жана ар бир кластер үчүн ар башка субмейкиндик салмактарын үйрөнөт. Авторлордун билдирүүсүнө ылайык, SWCC ички кластерлөө баалоосунда 0,68 Silhouette, 0,85 Davies–Bouldin, 1580,5 Calinski–Harabasz жана 0,43 Dunn көрсөткүчтөрүнө жетет. Waseem маалымат топтомундагы тышкы баалоодо болсо, кластерлер түзүлгөндөн кийин энбелгилердин %10'у категорияларды дал келтирүү үчүн колдонулганда %93,1 тактык жана %93,5 F1 упайы билдирилген. Ошол эле учурда бул изилдөө толугу менен энбелгисиз учтан-учка классификатор эмес; категория аттарын ыйгаруу үчүн белгиленген валидациялык кичи топтом талап кылынат. Мындан тышкары, колдонулган моделдин идентификатору жана маалымат топтомдорунун класс бөлүштүрүлүшү боюнча булак текстте кайра өндүрүлүүгө таасир этиши мүмкүн болгон дал келбестиктер бар.
Изилдөөнүн негизги идеясы — жек көрүү сөздөрүнүн бардык түрлөрү бирдей тилдик өзгөчөлүктөргө бирдей деңгээлде таянбайт деген божомол. Расага негизделген жек көрүү, сексисттик сөз жана жек көрүүнү камтыбаган агрессивдүү тил ар башка семантикалык өлчөмдөрдө топтолушу мүмкүн. Ошондуктан SWCC tweetтерди гана кластерлерге бөлбөстөн, 768 өлчөмдүү embedding мейкиндигин да субмейкиндиктерге бөлөт жана ар бир tweet кластери үчүн бул субмейкиндиктерге ыңгайлашуучу маанилүүлүк салмактарын ыйгарат. Ablation экспериментинде үйрөнүлгөн салмактоо алып салынганда Silhouette упайы 0,68 маанисинен 0,55 маанисине, салмактар туш келди тандалганда 0,47 маанисине жана тең кармалганда 0,51 маанисине төмөндөйт. Бул жыйынтык изилденген маалыматтарда жана эксперименттик түзүлүштө адаптивдүү салмактоо кластерлердин ажырашына салым кошорун колдойт.
Бирок макаланын “жашыруун жек көрүү сөзү” жана “ресурсу аз тилдер” үчүн кеңири колдонуу жөнүндө дооматтары азырынча эксперименттик жактан ырасталган эмес. Эксперименттер англис тилиндеги Twitter маалыматтарында жана авторлордун өз сөзү менен explicit hate маалымат топтомдорунда жүргүзүлгөн. Ошондуктан изилдөө ар башка платформаларга, ар башка тилдерге же түздөн-түз implicit hate маалымат топтомдоруна жалпыланган ийгилик далилин сунуштабайт.
Эмне үчүн классикалык көзөмөлдөнгөн жек көрүү сөзүн аныктоодон башкача ыкма изделүүдө?
Жек көрүү сөзүн аныктоодо кеңири тараган ыкма — алдын ала адамдар тарабынан классификацияланган миңдеген же миллиондогон тексттерди колдонуп классификаторду үйрөтүү. Бул ыкма жогорку натыйжа бере алганы менен, жаңы тилдер, жаңы коомчулуктар, тез өзгөргөн сленг жана жек көрүү сөзүнүн жаңы формалары үчүн үзгүлтүксүз аннотация чыгымын жаратат.
Изилдөө бутага алган боштук дал ушул жерде пайда болот: энбелгилер моделдин кластер түзүү этабында колдонулбаган, бирок семантикалык жактан маанилүү tweet топтору ошого карабастан табыла турган түзүлүштү курууга болобу?
Авторлордун сунушу эки техниканы бириктирет:
- Контексттик тил өкүлчүлүгү: tweetтин маанисин туруктуу сөз тизмелеринин ордуна көп өлчөмдүү embedding мейкиндигине айландыруу.
- Субмейкиндикти салмактоочу кош кластерлөө: документтерди да, embedding өлчөмдөрүн да бирге уюштуруу жана ар бир документ кластеринде кайсы субмейкиндиктер көбүрөөк айырмалоочу экенин үйрөнүү.
Бул жерде “көзөмөлсүз” деген сөз так эмнени билдирет?
Изилдөөдө document cluster'лары түзүлүп жатканда адам тарабынан берилген жек көрүү сөзүнүн класстары колдонулбайт. Бул жагынан SWCCнин негизги кластерлөө этабы көзөмөлсүз.
Бирок алынган Cluster 1, Cluster 2 же Cluster 3 сыяктуу кластерлердин кайсынысы “расисттик”, “сексисттик”, “жек көрүүнү камтыбаган агрессивдүү тил” же маалымат топтомунун башка расмий классына туура келерин аныктоо үчүн энбелгилердин кеминде %10'у колдонулган.
Ошондуктан ыкма үчүн эң так жана этият аныктама төмөнкүдөй:
SWCC кластерлөө этабында көзөмөлсүз, ал эми категорияларды атоодо жана тышкы натыйжалуулукту баалоодо минималдуу энбелги колдонгон алкак.
Бул айырма маанилүү. %93,1 тактык же %93,5 F1 упайы эч бир энбелгини карабастан автоматтык түрдө маанилүү категория аттарын түзгөн толугу менен энбелгисиз системанын натыйжасы эмес.
HateBERT эмне үчүн колдонулат?
Жөнөкөй сөз эсептөөлөрү бир эле сөздүн ар башка контексттеги маанисин ажыратууда кыйналышы мүмкүн. BERT-негизиндеги моделдер болсо сөздүн өкүлчүлүгүн анын айланасындагы сөздөргө жараша өзгөртө алат.
Изилдөөнүн концептуалдык моделинде HateBERT социалдык медиадагы агрессия жана жек көрүү сөзү менен байланышкан тилдик үлгүлөргө ыңгайлаштырылган контексттик өкүлчүлүк өндүрүүчү катары колдонулат.
Ар бир текст жалпысынан:
\[ M=768 \]
өлчөмдүү латенттик семантикалык мейкиндикке айландырылат. Бүт маалымат топтому:
\[ X\in\mathbb{R}^{N\times768} \]
матрицасы менен көрсөтүлөт. Бул жерде \(N\) документ/tweet саны.
Embedding өлчөмдөрү сөздөрбү?
Жок. 768 embedding өлчөмүнүн ар бири түздөн-түз “раса”, “жыныс”, “кемсинтүү” же белгилүү бир сөздүн маанисин билдирбейт. Булар моделдин ичинде бөлүштүрүлгөн түрдө үйрөнүлгөн латенттик сандык өзгөчөлүктөр.
Макала түшүндүрмөлүүлүктү түзүү үчүн кийин жогорку салмактуу embedding өлчөмдөрүнүн маалымат топтомунда эң көп активдешкен token'дарын аныктап, аларды семантикалык категорияларга дал келтирет.
Ошондуктан өзгөчөлүктөрдү чечмелөө эки этаптан турат:
- SWCC кайсы латенттик өлчөм/субмейкиндик маанилүү экенин аныктайт.
- Post hoc талдоо бул латенттик өлчөмдөрдү адам түшүнө турган token же түшүнүктөр менен байланыштырууга аракет кылат.
Демек, таблицада көрүнгөн сөздөр BERTтин 768 мамычасынын табигый аттары эмес; алар изилдөө жүргүзгөн кийинки чечмелөө катмарынын жыйынтыгы.
Кош кластерлөө эмнеси менен айырмаланат?
Классикалык K-means саптарды гана, башкача айтканда бул мисалда tweetтерди кластерлейт. SWCC болсо эки окту бир учурда уюштурат:
- Саптар: tweetтер / документтер.
- Мамычалар: embedding өзгөчөлүк өлчөмдөрү.
Tweet кластери боюнча дайындоо:
\[ U\in\{0,1\}^{N\times K} \]
матрицасы менен; feature-subspace мүчөлүгү болсо:
\[ V\in\{0,1\}^{M\times L} \]
матрицасы менен берилет.
Изилдөөнүн акыркы эксперименттик параметрлеринде:
\[ K=3 \]
tweet кластери жана:
\[ L=32 \]
өзгөчөлүк субмейкиндиги тандалган.
Субмейкиндик салмагы эмне иш кылат?
Жек көрүү сөзүнүн ар бир категориясы бирдей семантикалык өлчөмдөргө бирдей деңгээлде муктаж болот деп болжолдонбойт. Анын ордуна:
\[ C\in\mathbb{R}^{K\times L} \]
түрүндөгү салмак матрицасы аныкталат.
\[ c_{g,h} \]
мааниси \(g\)-tweet кластери үчүн \(h\)-субмейкиндиктин маанилүүлүгүн көрсөтөт.
Мисалы, бир кластерде иденттүүлүк/топту бутага алууга сезгич латенттик өзгөчөлүктөр күчтүү болушу мүмкүн, ал эми башка кластерде жалпы агрессивдүүлүк же басмырлоочу тил үлгүлөрүн алып жүргөн өлчөмдөр жогорку салмак алышы мүмкүн.
Бул ыкманын теориялык артыкчылыгы — бардык 768 өлчөмгө бир эле глобалдык маанилүүлүк маанисин берүүнүн ордуна кластерге көз каранды өзгөчөлүк маанилүүлүгүн үйрөнө алышы.
SWCC максат функциясы кандай иштейт?
Макала берген негизги максат функциясы:
\[ J(U,V,Z,C) = \frac{1}{NM} \sum_{g=1}^{K} \sum_{h=1}^{L} \sum_{i=1}^{N} \sum_{j=1}^{M} u_{i,g}v_{j,h}c_{g,h} (x_{i,j}-z_{g,h})^2 + \eta \sum_{g=1}^{K} \sum_{h=1}^{L} c_{g,h}\log(c_{g,h}) \]
түрүндө.
Биринчи мүчө ар бир tweetтин өзү таандык болгон кластердин тиешелүү субмейкиндик борборуна чейинки салмакталган квадраттык аралыкты азайтууга аракет кылат. Tweet менен centroid бири-бирине канчалык жакын болсо, reconstruction/clustering катасы ошончолук аз болот.
Экинчи мүчө энтропияга негизделген regularization компоненти:
\[ R_{\mathrm{entropy}} = \eta \sum_{g,h} c_{g,h}\log c_{g,h}. \]
Бул жердеги:
\[ \eta>0 \]
параметри салмактардын канчалык топтолгон же тең салмактуу болоруна таасир этет.
Энтропиялык регуляризация эмне үчүн керек?
Эгер салмактар толугу менен эркин калтырылса, модель бардык маанилүүлүктү бир нече featureга топтоп, өтө курч жана туруксуз чечимдерди жаратышы мүмкүн. Энтропия мүчөсү бул жүрүм-турумду көзөмөлдөөгө аракет кылат.
Изилдөөнүн сезимталдык экспериментинде:
| \(\eta\) | Silhouette | Булактын чечмелөөсү |
|---|---|---|
| 0,01 | 0,52 | Салмактар өтө сейрек |
| 0,1 | 0,61 | Жетишсиз регуляризация |
| 0,5 | 0,68 | Эң жакшы тең салмак |
| 1,0 | 0,65 | Ашыкча регуляризация |
| 2,0 | 0,58 | Ашыкча регуляризация |
| 5,0 | 0,49 | Катуу ашыкча регуляризация |
Бул эксперименттин алкагында:
\[ \eta=0{,}5 \]
эң жогорку Silhouette маанисин берген.
Алгоритмдин итеративдик агымы кандай?
Макаладагы SWCC алгоритми alternating minimization ыкмасын колдонот:
- Tweet жана feature кластерлери баштапкы абалда дайындалат.
- Tweetтер салмакталган аралыкка жараша кайра кластерленет.
- Cluster centroid'лери жаңыртылат.
- Feature өлчөмдөрү тиешелүү субмейкиндиктерге кайра дайындалат.
- Ар бир cluster–subspace жубу үчүн бөлүштүрүүгө байланышкан салмактар жаңыртылат.
- Дайындоолор туруктуу болгондо же максималдуу итерация санына жеткенде процесс токтойт.
Ошентип, документ кластерлери, feature субмейкиндиктери, centroid'лер жана субмейкиндик салмактары бири-биринен көз карандысыз бир жолу гана эсептелбейт; алар итеративдүү түрдө бири-бирине таасир этет.
Эсептөө баасы кандай?
Макала бир итерация үчүн болжолдуу татаалдыкты:
\[ O(NKML) \]
деп берет.
\[ K=3,\qquad L=32,\qquad M=768 \]
болгондо бир документке болжол менен:
\[ 7{,}4\times10^4 \]
негизги операция масштабы эсептелет.
Авторлордун масштабдык баалоосуна ылайык \(N=10^6\) жана 50 итерация деңгээлинде жалпы операциялардын саны болжол менен:
\[ 3{,}7\times10^{12} \]
болушу мүмкүн. Ошондуктан изилдөө миллиондогон документ масштабына чыкканда бөлүштүрүлгөн ишке ашыруу талап кылынышы мүмкүн экенин белгилейт.
Чыныгы эксперимент канча убакытка созулган?
Кайра өндүрүлүүчүлук бөлүмүндө Davidson маалымат топтому үчүн embedding чыгаруу:
\[ 2887\ \text{saniye} \]
башкача айтканда болжол менен 48 мүнөткө созулганы билдирилген.
SWCC үчүн 30 итерация колдонулуп, ар бир итерацияга болжол менен 2–3 секунд деп көрсөтүлгөн. Толук pipeline убактысы болжол менен 50–55 мүнөт деп берилген.
Embedding матрицасы:
\[ 24.783\times768 \]
өлчөмүндө жана болжол менен 72,61 MB эс тутум ээлей турганы көрсөтүлгөн.
Кайсы маалымат топтомдору колдонулган?
Изилдөө англис тилиндеги эки Twitter маалымат топтомун колдонот:
| Маалымат топтому | Булакта билдирилген көлөм | Колдонуу максаты |
|---|---|---|
| Davidson ж.б. (2017) | 24.783 tweet | Жек көрүү сөзү / агрессивдүү тил / нейтралдуу мазмун боюнча эксперименттер |
| Waseem (2016) | 16.000 tweet деп билдирилет | Расизм / сексизм / башка класстар боюнча баалоо |
Бул жердеги класс бөлүштүрүүлөрү боюнча булак текстте кайра өндүрүлүүчүлүк жагынан маанилүү дал келбестиктер болгондуктан, катыштар текшерилбестен “туура маалымат топтомунун бөлүштүрүлүшү” катары кайра жарыяланбашы керек. Макаланын методологиялык жыйынтыктарын баалоодо бул жагдай өзүнчө эске алынышы зарыл.
Маалыматтарды алдын ала иштетүү кандай жүргүзүлгөн?
Tweetтердеги URL'дерди, колдонуучу аттарын, hashtag белгилерин, тыныш белгилерин, stop-word'дерди жана социалдык медиадагы ар кандай ызы-чууларды тазалоо көздөлгөн. Slang жана кыскартуулар маани жагынан ылайык сөздөр менен алмаштырылганы, emoticon'дор да түшүндүрмө сөздөргө айландырылганы белгиленет.
Изилдөөнүн алдын ала иштетүү талдоосунда бир tweetтен орточо болжол менен:
\[ 19{,}1 \]
символ алынып салынганы билдирилет.
Бул процесс embedding моделине көбүрөөк стандартташтырылган текст берүүнү көздөйт. Бирок hashtag же социалдык медиа белгилери айрым учурларда жек көрүү сөзүнүн контекстин алып жүрүшү мүмкүн экенин эске алганда, тазалоо чечимдери маалымат жоготууга алып келдиби же жокпу — бул изилдөөнүн ичинде өзүнчө ablation эксперименти менен текшерилген эмес.
\(K=3\) эмне үчүн тандалган?
Tweet cluster саны үчүн:
\[ K=2,\ldots,10 \]
аралыгында Within-Cluster Sum of Squares баалоосу жүргүзүлгөн. Изилдөө \(K=2\)ден \(K=3\)кө өткөндө WCSS %23,7 азайганын билдирип, elbow чекитин \(K=3\) деп тандайт.
7-сүрөт ошондой эле Silhouette, Davies–Bouldin жана Calinski–Harabasz көрсөткүчтөрүн көрсөтөт. Бирок бул көмөкчү индекстердин графиктеги оптимумдары так бир эле чекитте толук дал келбейт. Ошондуктан \(K=3\) тандоосун эң туура түрдө elbow талдоосу артык көргөн үч кластерлүү чечим деп аныктоо керек.
Эмне үчүн \(L=32\)?
Embedding өлчөмдөрүнүн саны:
\[ M=768 \]
болгондуктан, изилдөө feature-subspace санын square-root heuristic менен:
\[ L\approx\sqrt{768}\approx32 \]
деп аныктайт.
Бул тандоо маалыматтан үйрөнүлгөн так оптимум эмес; колдонулган heuristicтен келип чыккан гиперпараметр тандоосу.
Ички кластерлөө сапаты эмнени көрсөттү?
SWCC үчүн изилдөө төрт негизги ички валидация метрикасын билдирет:
| Метрика | SWCC жыйынтыгы | Чечмелөө багыты |
|---|---|---|
| Silhouette | 0,68 | Жогорку маани жакшыраак ажырашууну билдирет |
| Davies–Bouldin | 0,85 | Төмөн маани жакшыраак |
| Calinski–Harabasz | 1580,5 | Жогорку маани жакшыраак |
| Dunn | 0,43 | Жогорку маани жакшыраак ажырашууну билдирет |
Он кайталанган салыштырууда билдирилген Silhouette маанилери төмөнкүдөй:
| Ыкма | Silhouette |
|---|---|
| K-means + BERT | 0,45 ± 0,03 |
| LDA | 0,38 ± 0,04 |
| Spectral Clustering | 0,52 ± 0,02 |
| BERTopic | 0,58 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 |
| SWCC | 0,68 ± 0,01 |
Булакта ошол эле таблица үчүн SWCCнин DB, CH жана Dunn маанилеринде да салыштырылган ыкмалардан жакшыраак жыйынтык бергени билдирилет.
Тышкы баалоодо эмне алынды?
Кластерлер түзүлгөндөн кийин энбелгилердин %10'у cluster-to-category mapping үчүн колдонулуп, Waseem маалымат топтомунда:
\[ \mathrm{Accuracy}=93{,}1\% \]
жана:
\[ F1=93{,}5\% \]
билдирилген.
Изилдөө ошондой эле класс боюнча macro F1 үчүн:
\[ 0{,}89 \]
маанисин жана racism, neither жана sexism үчүн тиешелүүлүгүнө жараша болжол менен:
\[ 0{,}85,\quad0{,}94,\quad0{,}89 \]
F1 маанилерин билдирет.
Бирок булакта толук confusion matrix жарыяланган эмес; “суроо-талап боюнча жеткиликтүү” деп айтылган. Мындан тышкары, маалымат топтомундагы класс катыштарын билдирүүдөгү көйгөйдөн улам класс боюнча жыйынтыктарды кайра өндүрүү өзгөчө маанилүү.
Көзөмөлдөнгөн моделдерден ашып түштү деп айтууга болобу?
Макаланын 7-таблицасында SWCCнин F1 мааниси айрым көзөмөлдөнгөн адабияттык жыйынтыктардан жогору көрүнөт. Мисалы, булакта GLTR+BERT үчүн %93,1 F1, BERTweet-large үчүн %90,9 жана башка айрым ыкмалар үчүн төмөн маанилер берилет.
Бирок ошол эле изилдөө толук көзөмөлдөнгөн ыкмалар менен түз салыштыруу ылайыктуу эмес экенин да белгилейт. Мунун себептери:
- энбелги колдонуу катыштарынын ар башка болушу,
- train/test протоколдорунун бирдей эместиги,
- ар башка макалаларда маалыматты иштетүү чечимдеринин айырмаланышы,
- SWCCде энбелгилер cluster mapping максатында кийинчерээк колдонулушу.
Ошондуктан эң коопсуз жыйынтык:
“SWCC билдирилген упайлар боюнча айрым адабияттык жыйынтыктар менен атаандаша алат көрүнөт.”
түрүндө.
“Бирдей эксперименттик шарттарда бардык көзөмөлдөнгөн моделдерден ийгиликтүүрөөк экени далилденген.”
деген жыйынтыкты бул эксперименттик дизайндан чыгарууга болбойт.
Ablation изилдөөсү негизги механизм тууралуу эмнени көрсөтөт?
Изилдөөдөгү эң таза көзөмөлдөнгөн салыштыруулардын бири — ошол эле SWCC системасынын feature-weighting механизмин өзгөртүү менен жасалган ablation эксперименти.
Толук модель:
\[ S=0{,}68 \]
Silhouette маанисине жеткенде:
\[ S_{\mathrm{no\ weighting}}=0{,}55, \]
\[ S_{\mathrm{random}}=0{,}47, \]
\[ S_{\mathrm{equal}}=0{,}51 \]
билдирилген.
Бул жыйынтык изилденген эксперименттик чөйрөдө co-clustering түзүлүшү гана эмес, үйрөнүлгөн жана clusterга мүнөздүү subspace weighting механизми да натыйжалуулукка салым кошорун колдойт.
Түшүндүрмөлүүлүк чындап камсыздалабы?
SWCCнин артыкчылыктарынын бири — ар бир cluster үчүн кайсы субмейкиндиктер жогорку салмак алганын көрсөтө алышы. Андан кийин булак бул embedding өлчөмдөрүн жогорку активдешүү көрсөткөн token'дар менен байланыштырып, расалык жек көрүү, сексисттик сөз жана жек көрүүгө кирбеген агрессивдүү тил үчүн мүнөздүү сөз топторун чыгарат.
Бирок эки илимий чек сакталууга тийиш.
Биринчиден, embedding dimension менен адам түшүнө турган түшүнүктүн ортосунда түз бирге-бир семантикалык теңдик жок. Картага түшүрүү post hoc болуп саналат.
Экинчиден, авторлор келечекте жогорку салмактуу өзгөчөлүктөр көз карандысыз адам баалоочулары тарабынан каралышы керек экенин өздөрү ачык изилдөө суроосу катары калтырышат.
Демек, изилдөө “толук түшүндүрүлө турган AI” түзүлгөнүн далилдөөдөн көрө, классикалык black-box embeddingге салыштырмалуу өзгөчөлүк салмагы деңгээлинде кошумча чечмелөө каналын сунуштайт.
Implicit жек көрүү сөзү чындап текшерилгенби?
Жок. Изилдөөнүн кириш бөлүмүндө жашыруун жек көрүү сөзү sarcasm, коддолгон тил же түз кемсинтүүнү камтыбаган кыйыр билдирүүлөр аркылуу пайда болушу мүмкүн экени түшүндүрүлөт.
Бирок авторлор ачык түрдө:
эксперименттик баалоо Davidson жана Waseem explicit-hate маалымат топтомдорунда жүргүзүлгөнүн
жана dedicated implicit-hate маалымат топтомдору келечекте колдонула турганын белгилешет.
Ошондуктан изилдөөнүн:
“жашыруун жек көрүү сөзүн ийгиликтүү аныктады”
деген жыйынтыгын учурдагы эксперименттен чыгарууга болбойт.
Ресурсу аз тилдер үчүн жыйынтык барбы?
Изилдөө аннотация муктаждыгын азайтуу ресурсу аз тилдер үчүн пайдалуу болушу мүмкүн деп сунуштайт. Бирок эксперименттердин бардыгы англис тилинде, ал эми колдонулган embedding модели да англис тилине багытталган.
Авторлордун келечектеги иш планында XLM-RoBERTa жана mBERT сыяктуу көп тилдүү моделдер менен тилди таануу + тилге мүнөздүү subspace weighting түзүлүшүн изилдөө сунушталат.
Демек, ресурсу аз тилдер үчүн колдонуу азырынча потенциалдуу колдонмо багыты, ырасталган жыйынтык эмес.
Түркия жана түрк тили үчүн бул эмнени билдирет?
Изилдөөдө түрк тилиндеги маалымат колдонулбагандыктан, Түркиядагы социалдык медиа мазмуну үчүн түз натыйжалуулук жыйынтыгы жок.
Түрк тилине ылайыкташтырылган версияда англис моделин жөн гана түркчө tweetтерге колдонуу жетиштүү болбойт. Түрк тилинин агглютинативдүү түзүлүшү, жергиликтүү сленг, контекстке көз каранды жашыруун дискриминация, код алмаштыруу, жазуу варианттары жана Түркиядагы социалдык медиа тилинин өзгөчөлүктөрү үчүн жаңы embedding жана адамдык валидация изилдөөсү талап кылынат.
Ошондуктан изилдөө Түркия үчүн даяр модерация модели эмес; түрк тили үчүн өзүнчө текшериле турган clustering архитектурасын сунуштайт.
Изилдөө колдогон жыйынтыктар
- Изилденген англис тилиндеги Twitter маалымат топтомдорунда SWCC билдирилген ички кластерлөө метрикаларында салыштырылган көзөмөлсүз ыкмалардан жакшыраак жыйынтык берген.
- Ablation изилдөөсү адаптивдүү subspace weighting алып салынганда же бузулганда clustering сапаты төмөндөөрүн көрсөтөт.
- Кластер түзүү процесси ground-truth label'дар колдонулбастан жүргүзүлгөн.
- %10 энбелги менен жасалган post hoc cluster mappingден кийин Waseem баалоосунда жогорку Accuracy жана F1 маанилери билдирилген.
- Cluster-specific subspace weights ар башка кластерлерде ар башка feature аймактары маанилүү боло аларын көрсөтөт.
- Алкактын эсептөө жана кайра өндүрүлүүчүлүк параметрлеринин маанилүү бөлүгү булакта ачык билдирилген.
Изилдөө колдобогон же далилдебеген жыйынтыктар
- Система учтан-учка толугу менен энбелгисиз эмес; category mapping үчүн %10 label колдонулат.
- Implicit hate speech ийгилиги түз текшерилген эмес.
- Түрк тилинде же башка ресурсу аз тилдерде ийгилик көрсөтүлгөн эмес.
- Facebook, YouTube, TikTok же башка платформаларда cross-platform жалпылануу текшерилген эмес.
- 7-таблица бирдей train/test протоколунда өткөрүлгөн көзөмөлдөнгөн head-to-head supervised benchmark эмес.
- Feature салмактары адам тарабынан түз аныкталган маани өлчөмдөрү эмес.
- Clusterлар адамдын жек көрүү сөзү таксономиясы менен толук дал келери көз карандысыз колдонуучу изилдөөсү аркылуу ырасталган эмес.
- Система реалдуу убакыттагы, миллиондогон колдонуучусу бар социалдык медиа өндүрүш инфраструктурасында талаа сыноосунан өткөн эмес.
- Hard assignment болгондуктан бир tweet бир убакта бир нече жек көрүү категориясына тиешелүү болушу мүмкүн деген ыктымалдык учурдагы версияда моделделбейт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Ыкма агымынын төрт негизги этабы
Булак изилдөөнүн 5-бетиндеги 1-сүрөт жана 2-сүрөт системаны төрт этаптуу pipeline катары көрсөтөт:
- Маалыматтарды алдын ала иштетүү: социалдык медиа текстин тазалоо жана нормалдаштыруу.
- Feature embedding: текстти BERT-негизиндеги модель менен 768 өлчөмдүү семантикалык өкүлчүлүккө айландыруу.
- SWCC: tweet жана feature субмейкиндиктерин чогуу кластерлөө, cluster-specific салмактарды үйрөнүү.
- Баалоо: ички clustering метрикалары жана %10 белгиленген post hoc category mapping менен тышкы баалоо.
Моделдин төрт негизги чыгышы
| Объект | Мааниси | Булакта билдирилген эксперименттик өлчөм |
|---|---|---|
| \(U\) | Tweet → cluster мүчөлүк матрицасы | \((19.971,3)\) деп билдирилет |
| \(V\) | Feature dimension → subspace мүчөлүк матрицасы | \((768,32)\) |
| \(Z\) | Centroid түзүлүшү | Эксперимент бөлүмүндө \((3,768)\) деп билдирилет |
| \(C\) | Cluster → subspace салмактары | \((3,32)\) |
Бул жердеги \(U=(19.971,3)\) менен изилдөөнүн башка бөлүмдөрүндө берилген 24.783 tweetтен турган embedding матрицасынын ортосунда булакта түшүндүрүлбөгөн үлгү санынын айырмасы бар.
Ички метрикаларды салыштыруу
| Ыкма | Silhouette ↑ | DB ↓ | CH ↑ | Dunn ↑ |
|---|---|---|---|---|
| K-means (BERT) | 0,45 ± 0,03 | 1,42 ± 0,15 | 980,2 ± 45,3 | 0,28 ± 0,02 |
| LDA | 0,38 ± 0,04 | 1,65 ± 0,18 | 720,5 ± 38,2 | 0,21 ± 0,03 |
| Spectral Clustering | 0,52 ± 0,02 | 1,18 ± 0,12 | 1205,7 ± 52,1 | 0,35 ± 0,02 |
| BERTopic | 0,58 ± 0,02 | 1,05 ± 0,10 | 1350,8 ± 48,7 | 0,39 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 | 1,55 ± 0,16 | 850,3 ± 42,5 | 0,25 ± 0,02 |
| SWCC | 0,68 ± 0,01 | 0,85 ± 0,08 | 1580,5 ± 35,2 | 0,43 ± 0,01 |
Булак бул маанилер 10 иштетүүнүн орточо ± стандарттык четтөөсү экенин белгилейт.
Verianla Live: Адаптивдүү салмактоонун ablation жыйынтыгына таасири
Ошол эле ablation таблицасында full SWCC үчүн:
\[ DB=0{,}85,\qquad CH=1580{,}5,\qquad Dunn=0{,}43 \]
билдирилген. Салмактоосу жок моделде бул маанилер тиешелүүлүгүнө жараша:
\[ 1{,}10,\qquad1250{,}3,\qquad0{,}36 \]
болгон.
Бул көзөмөлдөнгөн эксперимент изилдөөнүн эң күчтүү механизм далилдеринин бири; анткени салыштырылган нерсе ар башка макалалардан келген системалар эмес, ошол эле архитектуранын weighting компоненти өзгөртүлгөн варианттары.
Waseem тышкы баалоосу
| Модель | Accuracy | F1 |
|---|---|---|
| SWCC | %93,1 | %93,5 |
| GLTR with BERT | %92,7 | %93,1 |
| BERTweet-large | Булакта берилген эмес | %90,90 |
| CAT Boost | %89,03 | %87,74 |
| RoBERTa-based transformer | %86 | %86 |
| AAEBERT | Булакта берилген эмес | %46,2 |
| BERTweet trained on GPT-4 | Булакта берилген эмес | %90,1 |
Бул таблицаны баалоодо ыкмалардын энбелги колдонуу деңгээли жана эксперименттик протоколдору бирдей эмес экенин унутпоо керек. Булактын өз эскертүүсү SWCC label'дардын %10'ун post hoc cluster mapping үчүн колдонорун, ал эми supervised салыштыруулар адатта чоңураак белгиленген train бөлүктөрүн колдонорун баса белгилейт.
Кайра өндүрүлүүчүлүк үчүн берилген программалык чөйрө
| Компонент | Булакта берилген маани |
|---|---|
| Python | 3.9.12 |
| PyTorch | 1.12.1 |
| Transformers | 4.21.1 |
| NumPy | 1.21.5 |
| Scikit-learn | 1.0.2 |
| Random seed | 42 |
| HateBERT максималдуу узундук | 512 token |
| Embedding batch size | 8 |
| \(K\) | 3 |
| \(L\) | 32 |
| \(\eta\) | 0,5 |
| SWCC итерация саны | 30 |
Аппараттык чөйрө
Изилдөө Google Colab чөйрөсүн болжол менен 12–25 GB RAM, 2 vCPU Intel Xeon жана сессия бөлүштүрүлүшүнө жараша NVIDIA Tesla V100 же T4 GPU менен билдирет.
Бул маалыматтар кайра өндүрүлүүчүлүк жагынан пайдалуу. Бирок колдонулган embedding моделинин аты ар башка бөлүмдөрдө ар башка берилгендиктен, бирдей программалык камсыздоону жана seed маанилерин колдонуу өзүнөн өзү так репликацияга кепилдик бербейт.
Булактагы модель идентификаторунун дал келбестиги
Ыкма бөлүмүндө колдонулган модель:
GroNLP/HateBERT
деп көрсөтүлсө, кайра өндүрүлүүчүлүк бөлүмүндө:
Hate-speech-CNERG/bert-base-uncased-hatexplain
деп жазылган.
Булар ар башка модель булактары болгондуктан, төмөнкү суроолорго булак тексттен так жооп берүү мүмкүн эмес:
- Билдирилген 768 өлчөмдүү embeddingдер кайсы checkpointтен алынган?
- Model fallback кайсы шарттарда ишке кирген?
- Акыркы натыйжалуулук таблицалары кайсы checkpointке таандык?
- Ар башка checkpointтердин SWCC жыйынтыктары өзүнчө текшерилгенби?
Ошондуктан Verianla тексти бардык жыйынтыктарды унчукпай “оригинал GroNLP HateBERT жыйынтыгы” деп кайра белгилебейт.
Булактагы маалымат топтомдорунун дал келбестиктери
Waseem маалымат топтому үчүн булакта берилген класс пайыздары өз ичинде жалпысынан %100 көрсөткүчүнөн ашат. Davidson маалымат топтому үчүн билдирилген %22,8 / %51,8 / %25,4 бөлүштүрүүсү да изилдөө шилтеме берген стандарттуу Davidson маалымат топтомунун кеңири белгилүү класс бөлүштүрүүсүнө дал келбейт.
Бул маселе clustering ыкмасынын математикалык аныктамасын түздөн-түз жараксыз кылбайт; бирок Accuracy/F1 жыйынтыктары так кайсы label бөлүштүрүүсүндө жана маалыматтын кайсы версиясында алынганын көз карандысыз кайра өндүрүү үчүн маанилүү.
Centroid жана баштапкы салмак көрсөтүлүшүндөгү дал келбестик
Математикалык notation таблицасы centroidти:
\[ Z\in\mathbb R^{K\times L} \]
деп аныктаса, ишке ашыруу бөлүмүндө:
\[ Z=(3,768) \]
түрүндө \(K\times M\) өлчөмү берилет.
Ошол сыяктуу алгоритм алдындагы түшүндүрмөдө баштапкы салмак \(1/K\) деп көрсөтүлсө, Algorithm 1 ичинде:
\[ C^{(0)}\leftarrow[1/L] \]
деп жазылган.
Бул айырмачылыктар, өзгөчө ыкманы коддон кайра ишке ашырууну каалаган изилдөөчүлөр үчүн такталууга тийиш болгон пункттар.
Моделдин негизги күчтүү жактары
- Кластер түзүүдө ground-truth класстарына муктаж болбойт.
- Tweet жана feature subspace түзүлүштөрүн бир убакта моделдейт.
- Ар бир кластер үчүн өзүнчө feature/subspace маанилүүлүк салмактарын үйрөнөт.
- Салмактоо механизми ablation аркылуу текшерилген.
- Бир нече ички clustering метрикасын билдирет.
- Гиперпараметрлердин сезимталдык талдоосун сунуштайт.
- Программа версиясы, seed, аппараттык камсыздоо жана runtime маалыматтарынын маанилүү бөлүгүн бөлүшөт.
- Кластер жыйынтыгын бир гана Accuracy маанисине кыскартпастан, ички түзүлүш метрикалары менен да баалайт.
Негизги чектөөлөр
- Эксперименттер англис тилиндеги Twitter маалыматтары менен гана жүргүзүлгөн.
- Implicit hate үчүн dedicated тест топтому колдонулган эмес.
- Категорияларды атоо үчүн %10 label талап кылынат.
- Hard cluster assignment колдонулат; көп/кайчылаш категория мүчөлүктөрү моделделбейт.
- Embedding сапаты тандалган тил моделине көз каранды.
- Feature-to-word чечмелөөсү post hoc болуп, көз карандысыз адамдык валидация жүргүзүлгөн эмес.
- Cross-platform тест жок.
- Маалымат топтомдорунун класс катыштарында булак ичиндеги дал келбестиктер бар.
- Колдонулган transformer checkpointинин идентификатору эки түрдүү берилген.
- 24.783 embedding менен 19.971 cluster-assignment саптарынын ортосундагы айырма түшүндүрүлгөн эмес.
- Supervised моделдер менен таблицалык салыштыруулар бирдиктүү жалпы эксперименттик протоколдон алынган эмес.
Келечектеги изилдөөлөр
Авторлор төрт негизги багытты сунуштайт:
- Көп тилдүүлүк: mBERT же XLM-RoBERTa сыяктуу моделдер менен тилге мүнөздүү жана жалпы жек көрүү сөзү субмейкиндиктерин изилдөө.
- Адам тарабынан чечмелене турган валидация: annotator'лор жогорку салмактуу feature'ларды карап, cluster маанисин ырасташы.
- Embedding моделдерин салыштыруу: domain specificity, эсептөө чыгымы жана контексттик түшүнүүнүн ортосунда тең салмак түзгөн альтернативдүү моделдерди сыноо.
- Fuzzy clustering: бир tweet бир нече категорияга жарым-жартылай мүчө боло алышын камсыз кылган probabilistic/fuzzy кеңейтүүлөр.
Булак жана Ыкма Жөнүндө Эскертүү
Толук оригинал изилдөө аталышы: An Unsupervised Subspace Weighting Co-Clustering Framework for Hate Speech Detection Patterns in Social Media
Авторлор: Maya Sultan ALGhafri; Imran Khan; Abdelhamid Abdesselam.
Тең биринчи/тең салым: Булакта тең биринчи же тең салым жөнүндө билдирүү жок.
Жооптуу автор: Maya Sultan ALGhafri.
Мекеме: Department of Computer Science, Sultan Qaboos University, Muscat 123, Oman.
Булак түрү: Рецензияланган оригинал изилдөө макаласы; табигый тилди иштетүү, машиналык үйрөнүү жана кластерлөө изилдөөсү.
Журнал: AI.
Басмакана: MDPI, Basel, Швейцария.
Библиографиялык жазуу: AI, 2026, Том 7, Сан 6, Макала 204.
DOI: 10.3390/ai7060204.
Кабыл алуу / ревизия / кабыл кылуу / жарыялоо: 26 апрель 2026 / 20 май 2026 / 27 май 2026 / 4 июнь 2026.
Рецензия статусу: Рецензияланган журналдык жарыя.
Лицензия: Creative Commons Attribution (CC BY).
Академиялык редакторлор: Michal Ptaszynski; Rafal Rzepka; Hisami Suzuki.
Негизги ыкма: BERT-негизиндеги контексттик embeddingдер менен Subspace Weighting Co-Clustering (SWCC).
SWCC түзүлүшү: Tweet кластерлери \(U\), feature-subspace дайындоолору \(V\), centroid түзүлүшү \(Z\) жана cluster-specific subspace weighting матрицасы \(C\) бирге итеративдүү оптималдаштырылат.
Эксперименттик embedding өлчөмү: 768.
Tweet cluster саны: \(K=3\).
Feature-subspace саны: \(L=32\).
Regularization: \(\eta=0,5\).
Негизги маалымат топтомдору: Davidson et al. (2017) Hate Speech and Offensive Language маалымат топтому жана Waseem/Hovy англис тилиндеги Twitter hate-speech маалымат топтому.
Энбелги колдонуу: Cluster formation учурунда ground-truth label колдонулбаганы билдирилет. Тышкы category mapping жана evaluation үчүн label'дардын кеминде %10'у post hoc колдонулат. Ошондуктан системанын clustering өзөгү көзөмөлсүз болгону менен, учтан-учка категория түзүү толугу менен энбелгисиз эмес.
Эң маанилүү ички clustering жыйынтыгы: SWCC үчүн Silhouette 0,68 ± 0,01; Davies–Bouldin 0,85 ± 0,08; Calinski–Harabasz 1580,5 ± 35,2; Dunn 0,43 ± 0,01.
Waseem боюнча билдирилген тышкы жыйынтык: %93,1 Accuracy жана %93,5 F1; %10 label менен post hoc cluster-to-category mappingден кийин.
Ablation жыйынтыгы: Silhouette толук SWCCде 0,68; weighting жок 0,55; random weighting менен 0,47; equal weighting менен 0,51.
Эсептөө татаалдыгы: Булак бир SWCC итерациясын \(O(NKML)\) деп берет.
Булакта берилген runtime: Embedding өндүрүү болжол менен 2887 секунд; SWCC 30 итерация; ар бир итерация болжол менен 2–3 секунд; толук pipeline болжол менен 50–55 мүнөт.
Эксперименттик чөйрө: Python 3.9.12; PyTorch 1.12.1; Transformers 4.21.1; NumPy 1.21.5; Scikit-learn 1.0.2; Google Colab; seed 42.
Каржылоо: Изилдөө тышкы каржылоо албаганын билдирет.
Этика кеңеши: Колдонулбайт деп көрсөтүлгөн.
Маалымдалган макулдук: Колдонулбайт деп көрсөтүлгөн.
Маалымат жеткиликтүүлүгү: Булак Davidson жана Waseem маалымат топтомдору ачык repositoryлерден алынганын билдирет.
Автордук салымдар: Концептуалдаштыруу M.S.A.; методология M.S.A. жана I.K.; программалык камсыздоо, валидация, формалдык талдоо, изилдөө, ресурстар, маалыматтарды курациялоо, алгачкы долбоор жана визуалдаштыруу M.S.A.; карап чыгуу жана редакциялоо M.S.A.; жетекчилик I.K. жана A.A.; долбоорду башкаруу жана каржылоо алуу M.S.A. деп билдирилген.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышын билдиришкен эмес.
Булакка берилгендик жагынан маанилүү кайра өндүрүлүүчүлүк эскертүүлөрү
Изилдөөнүн ыкма бөлүмүндө embedding модели GroNLP/HateBERT деп аныкталса, кайра өндүрүлүүчүлүк бөлүмүндө Hate-speech-CNERG/bert-base-uncased-hatexplain аты берилет. Бул эки checkpoint бир эле модель эмес. Ошондуктан кайсы checkpoint акыркы натыйжалуулук таблицаларын чыгарганы булак тексттен так аныкталбайт.
Мындан тышкары, колдонулган маалымат топтомдорунун класс бөлүштүрүлүшү боюнча булак ичинде жана оригинал маалымат булактары менен дал келбестиктер бар. Waseem үчүн 4-таблицадагы катыштардын суммасы %100 көрсөткүчүнөн ашат. Davidson үчүн билдирилген класс катыштары да стандарттуу ачык маалымат файлындагы label бөлүштүрүлүшүнө дал келбейт. Ошондуктан, өзгөчө external Accuracy/F1 маанилерин көз карандысыз репликациялоодо чийки маалымат версиясы жана preprocessing чыгышы текшерилиши керек.
Математикалык notationда \(Z\) centroid матрицасынын өлчөмү жана баштапкы subspace салмагы боюнча да ар башка билдирүүлөр бар. Ошондой эле Algorithm 1ден кийин жарыяланган текстте калган “Please remove it from the final published version.” деген сүйлөм редакциялык өндүрүш калдыгы болуп саналат.
Бул дал келбестиктер Verianla текстинде үнсүз түрдө бир “туура” версияга айландырылган эмес. Себеби альтернативалардын кайсынысы авторлордун реалдуу эксперименттик кодун чагылдырары булак изилдөөдө так түшүндүрүлгөн эмес.
Илимий чечмелөө чеги
Бул изилдөөдөгү %93,1 Accuracy жана %93,5 F1 маанилери нөл адам энбелгисин колдонгон толугу менен автономдуу жек көрүү сөзүн категориялаштыруу системасынын жыйынтыгы эмес. Энбелгилердин %10'у post hoc категория дал келтирүү үчүн колдонулат.
Изилдөөнүн implicit hate speech тууралуу мотивациясы маанилүү болсо да, эксперименттик жыйынтыктар explicit-hate багытындагы Davidson жана Waseem маалымат топтомдоруна негизделет. Ошондуктан implicit hate ийгилик көрсөткүчү билдирилген эмес.
Supervised моделдер менен 7-таблицада жасалган салыштыруулар да жалпы train/test split, жалпы preprocessing жана жалпы label бюджети менен өткөрүлгөн бир benchmark эксперименти эмес. Ошондуктан SWCCнин айрым жарыяланган упайлардан жогору болушу бардык ушул моделдерге карата көзөмөлдөнгөн статистикалык үстөмдүктүн далили катары чечмеленбеши керек.
Акырында, модель англис тилиндеги Twitter маалыматтарында гана бааланган. Башка тилдер, башка социалдык медиа платформалары жана реалдуу убакыттагы өндүрүш модерация системалары үчүн өзүнчө валидация талап кылынат.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген