

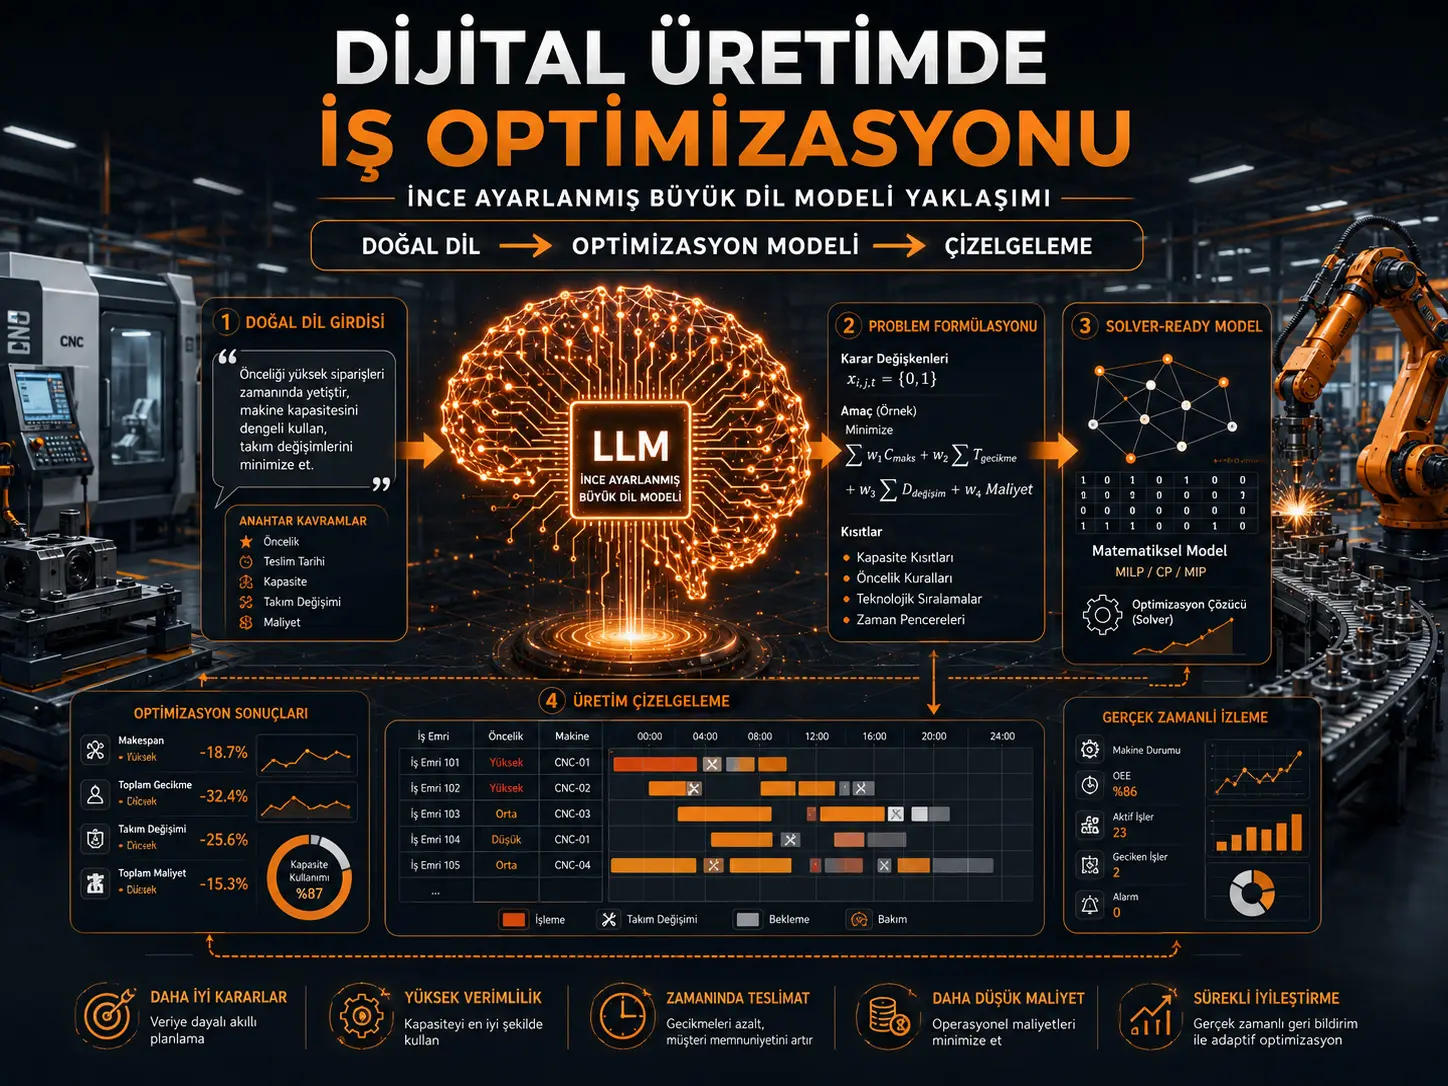
Өндүрүш жетекчисинин “бул буйрутмаларды ушул машиналарда, ушул жеткирүү мөөнөттөрүнө ылайык жана эң кыска жалпы убакытта чыгар” деп айтышы оңой; бирок бул талапты оптималдаштыруу чечүүчүсү түшүнө турган чечим өзгөрмөлөрүнө, максат функцияларына жана математикалык чектөөлөргө айландыруу көбүнчө операциялык изилдөө боюнча адистикти талап кылат. Бул изилдөө санарип өндүрүштөгү ушул адистик тартыштыгын азайтуу үчүн табигый тилде жазылган өндүрүш көйгөйлөрүн автоматтык түрдө чечүүчүгө даяр оптималдаштыруу моделдерине айландырган так жөнгө салынган чоң тил модели алкагын иштеп чыгат.
Ыкманын борборунда жалпы максаттагы өтө чоң жана кымбат коммерциялык моделди колдонуунун ордуна, код өндүрүү жөндөмү бар салыштырмалуу кичине алдын ала үйрөтүлгөн моделди тармакка тиешелүү маалыматтар менен fine-tune кылуу турат. Моделдин чектелген чыгаруу узундугу көйгөйдүн формулировкасын бир жолуда өндүрүүнүн ордуна өзгөрмөлөр, чектөөлөр, максат функциясы, чечим жана визуалдаштыруу сыяктуу көз карандысыз код модулдарына бөлүү аркылуу жеңилдетилет. Ошентип табигый тилдеги көйгөй ар түрдүү көрсөтмөлөр менен бөлүктөргө бөлүнүп моделденет, андан соң түзүлгөн модулдар бириктирилип иштетилүүчү оптималдаштыруу модели алынат.
Изилдөөчүлөр системаны үч деңгээлде сынашкан: классикалык job-shop scheduling көйгөйү, Австралиядагы реалдуу сайма фабрикасынын түзүмүнө жана иштөө эрежелерине негизделген татаалыраак flexible job-shop scheduling көйгөйү жана 288 оптималдаштыруу көйгөйүн камтыган LPWP сызыктуу программалоо benchmark'ы. Ылайыктуу окутуу конфигурацияларында эки өндүрүш пландоо кырдаалында %95 деңгээлинен жогору аткаруу ийгилиги билдирилген, ал эми LPWP тестинде сунушталган fine-tuned ыкма %72 ийгиликке жеткен. Standard GPT жана Chain-of-Experts (CoE) ыкмалары ошол эле салыштырууда %43 ийгилик көрсөткөн. Бул айырма 29 пайыздык пункт.
Натыйжалардын маанилүү чеги мындай: изилдөө жасалма интеллект фабриканын бардык операцияларын өз алдынча башкара аларын көрсөтпөйт. Моделдин милдети — адам табигый тилде сүрөттөгөн оптималдаштыруу көйгөйүн математикалык/коддолгон формага айландыруу; чыныгы оптималдуу чечимди эсептеген компонент дагы эле OR-Tools сыяктуу оптималдаштыруу чечүүчүсү. Мындан тышкары, реалдуу фабрика кейсинде айрым өндүрүш эрежелери чыныгы ишканадан алынганы менен, ERP маалыматтарына жетүү болбогондуктан жеткирүү мөөнөттөрү жана айрым көлөмдөр синтетикалык түрдө түзүлгөн.
Өндүрүштөгү негизги көйгөй жасалма интеллекттин көйгөйдү чечишиби же көйгөйдү туура аныктообу?
Изилдөөнүн баштапкы чекити ушул айырма. Оптималдаштыруу чечүүчүсү математикалык түрдө аныкталган көйгөйдү чече алат; бирок реалдуу ишканадагы көйгөйдү математикалык моделге айландыруу өзүнчө адистик тармагы.
Өндүрүш пландоо көйгөйү адатта жок дегенде үч негизги компонентти камтыйт:
- Чечим өзгөрмөлөрү: Кайсы жумуш кайсы машинага берилет? Жумуш качан башталат?
- Максат функциясы: Жалпы өндүрүш убактысыбы, кечигүүбү, энергия чыгымыбы же башка көрсөткүчпү минималдаштырылат?
- Чектөөлөр: Бир машинада эки жумуш бир убакта аткарыла алабы? Операциялар кайсы тартипте өтүшү керек? Кайсы машина кайсы операцияны аткара алат?
Андан кийин бул модель MiniZinc, GAMS, AMPL же изилдөөдө колдонулган CPMpy сыяктуу моделдөө чөйрөсүндө коддолуп, Gurobi, CPLEX, SCIP же OR-Tools сыяктуу чечүүчүгө өткөрүлөт.
Изилдөөчүлөр “problem formulation” деп атаган процесс — реалдуу ишкана талабын ушул математикалык жана иштетилүүчү түзүмгө айландыруу.
LLM бул жерде так эмне кылат?
LLM түздөн-түз оптималдуу өндүрүш графигин божомолдоого мажбурланбайт. Анын ордуна табигый тилдеги көйгөй сүрөттөмөсүн оптималдаштыруу моделине айлантат.
Изилдөөнүн 2-сүрөтүндөгү процесс чынжыры жөнөкөйлөштүрүлсө:
Табигый тилдеги көйгөй → Fine-tuned LLM → Чечим өзгөрмөлөрү + чектөөлөр + максат функциясы → Solver → Оптималдуу/ылайыктуу чечим
түрүндө.
Бул айырма маанилүү. LLM математикалык оптималдаштыруу чечүүчүсүнүн ордун баспайт; чечүүчүгө керектүү моделди түзүүнү автоматташтырат.
Эмне үчүн жалпы максаттагы LLMдин ордуна fine-tuning?
Авторлор учурдагы иштердин маанилүү бөлүгү prompt engineering же in-context learning колдонорун, бирок татаал өндүрүш оптималдаштыруу көйгөйлөрүндө бул жетиштүү тактык бербеши мүмкүн экенин айтышат.
Fine-tuning ыкмасында моделге жөн гана “оптималдаштыруу адиси сыяктуу иште” деп айтылбайт. Модель табигый тилдеги өндүрүш көйгөйү туура көйгөй формулировкасы менен жупташкан атайын мисалдарда кайра үйрөтүлөт.
Fine-tuning учурунда түзүлгөн модель менен максат коддун айырмасы cross-entropy loss аркылуу азайтылат. Булакта жоготуу функциясы жалпы түрдө:
\[ l(x,y)=\frac{1}{N}\sum_{n=1}^{N}l_n \]
жана token деңгээлиндеги мүчө:
\[ l_n= -\log \frac{\exp(x_{n,y_n})} {\sum_{q=1}^{Q}\exp(x_{n,q})} \]
түрүндө берилет.
Бирок изилдөөчүлөр төмөн cross-entropy loss өзү эле туура оптималдаштыруу модели өндүрүлгөнүн далилдебей турганын атайын белгилешет. Ошондуктан түзүлгөн код чындыгында иштетилет.
“Иштетип текшерүү” эмне үчүн маанилүү?
LLM синтаксистик жактан таасирдүү көрүнгөн, бирок математикалык жактан туура эмес код өндүрө алат. Изилдөөчүлөр муну алдын алуу үчүн түзүлгөн формулировканы OR-Tools менен иштетишет.
Үч мүмкүн натыйжа аныкталган:
- Success: Формулировка иштейт жана туура чечим берет.
- Failure: Формулировка иштейт, бирок туура эмес чечим берет.
- Exception: Формулировка иштетилбейт же аткаруу катасын берет.
Ийгилик көрсөткүчү:
\[ Success=\frac{CR}{I}\times100 \]
ийгиликсиздик көрсөткүчү:
\[ Failure=\frac{RE}{I}\times100 \]
жана истисна көрсөткүчү:
\[ Exception=\frac{CE}{I}\times100 \]
деп аныкталган.
Бул жерде I жалпы формулировка саны, CR туура чечим бергендер, RE туура эмес чечим бергендер жана CE иштетилбеген моделдер.
Биринчи тест: классикалык Job-Shop Scheduling
Биринчи кейс өндүрүш пландоонун классикалык көйгөйлөрүнүн бири — Job-Shop Scheduling. Көп сандагы жумуштар белгилүү машиналардан белгилүү тартипте өтүшү керек жана бир машина бир убакта бир гана операцияны аткара алат.
Изилдөө үч башка максат функциясын карайт:
- makespan, башкача айтканда акыркы жумуш бүткөнгө чейинки жалпы убакыт,
- максималдуу кечигүү,
- приоритет менен салмакталган жалпы кечигүү.
Мисалы makespan:
\[ \min C_{max} \]
деп минималдаштырылат жана ар бир жумуштун акыркы операциясынын бүтүү убактысы үчүн:
\[ C_{max}\geq e_{j,n_j} \]
чектөөсү колдонулат.
Мындан тышкары, бир машинадагы эки операция дал келбеши жана бир жумуштун ичиндеги операциялар туура тартипте жүрүшү керек.
Биринчи маалымат топтому кандай түзүлгөн?
Изилдөөчүлөр классикалык JSS үчүн алгач 100 көйгөй сүрөттөмөсүн жана аларга туура келген көйгөй формулировкаларын кол менен түзүшкөн.
Көйгөй формулировкаларынын узундугу болжол менен 1200–1800 token арасында өзгөрөт. Көйгөй сүрөттөмөлөрү 600 tokenden кыска.
Моделдин бир жолу чыгара алган жообу бул көйгөй формулировкаларынан кыскараак болгондуктан код тогуз башка функционалдык бөлүккө бөлүнгөн. Тогуз өзүнчө көрсөтмө колдонулгандыктан 100 негизги көйгөйдөн:
100 × 9 = 900 окутуу мисалы
алынган.
Token чеги эмне үчүн маанилүү болгон?
Изилдөө тексти колдонулган кичине код өндүрүү моделинин болжол менен 600 token чыгыш чеги бар экенин билдирет. Толук өндүрүш пландоо модели мындан бир нече эсе узун.
Изилдөөчүлөр чоңураак жана кымбатыраак моделди колдонгондун ордуна кодду модулдаштырышат.
Мисалы өзүнчө көрсөтмөлөр:
- керектүү китепканаларды түз,
- чечим өзгөрмөлөрүн түз,
- кагылышпоо чектөөлөрүн жаз,
- приоритет чектөөлөрүн кош,
- максат функциясын аныкта,
- моделди чеч,
- натыйжаларды визуалдаштыр
сыяктуу чакан тапшырмаларга туура келиши мүмкүн.
Ар бир чакан көйгөй моделдин token чегинде калат; акыркы этапта модулдар бириктирилет.
Классикалык JSS экспериментинде натыйжа кандай болгон?
Натыйжалар окутуу убактысы жана ийгилик batch size менен epoch санына күчтүү көз каранды экенин көрсөтөт.
Мисалы:
| Batch | Epoch | Loss | Окутуу убактысы (s) | Ийгилик | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0056 | 1083,78 | %16 | %23 | %61 |
| 1 | 8 | 0,0008 | 8561,05 | %96 | %0 | %4 |
| 2 | 4 | 0,0014 | 2554,93 | %100 | %0 | %0 |
| 4 | 4 | 0,0017 | 1733,71 | %97 | %0 | %3 |
Демек, “модель %95 деңгээлинен жогору ийгиликке жетти” деген билдирүү ар бир окутуу этабы үчүн туура эмес. Жетиштүү fine-tuning болгондо ылайыктуу конфигурацияларда ушул деңгээлге жеткен.
Реалдуу фабрика кейси кандай болгон?
Экинчи кейс Мельбурнда иштеген жана макалада купуялуулук үчүн XYZ деп аталган сайма өндүрүүчү.
1-сүрөт фабриканын чыныгы өндүрүш түзүмүн көрсөтөт. Ишканада жети машина тобу бар:
- Flat,
- Hanging,
- Cap Front,
- Patch,
- Little Fang,
- Packaging,
- 7-Head.
Сүрөттө берилген чыныгы мисал иш агымы:
Cap Machine → Flat Machine → Flat Machine → Hanging Machine
түрүндө.
Эмне үчүн бул көйгөй классикалык JSSтен татаалыраак?
Стандарттуу JSSте операция аткарыла турган машина көбүнчө алдын ала белгилүү. XYZ фабрикасында болсо айрым операциялар бир нече ылайыктуу машинада аткарылышы мүмкүн.
Ошондуктан жасалма интеллект түзө турган формулировка эки чечимди бир убакта моделдеши керек:
- операция кайсы машинага берилет,
- ал машинада кайсы тартипте аткарылат?
Бул түзүм Flexible Job-Shop Scheduling Problem (FJSS) деп классификацияланат.
Реалдуу ишкана эрежелери математикалык чектөөгө кантип айланат?
Фабрикада, мисалы, төрт даанадан аз буйрутмалар Little Fang машиналарына, төрттөн жети даанага чейинкилер 7-Head машиналарына жөнөтүлөт.
7-Head кезегинде күтүү эки иш күнүнөн ашса, жумуш башка ылайыктуу машинага өткөрүлүшү мүмкүн.
LLMдин милдети мындай табигый тил эрежелерин:
- машина ылайыктуулук өзгөрмөлөрүнө,
- дайындоо өзгөрмөлөрүнө,
- башталыш убакыттарына,
- операция приоритеттерине,
- makespan максат функциясына
айландыруу.
“Реалдуу дүйнө” деген сөздүн чеги кандай?
Фабрика, машина топтору жана иштөө эрежелери реалдуу өндүрүш чөйрөсүнө негизделген. Бирок изилдөөчүлөр ERP маалыматтарына жете албагандыктан жеткирүү мөөнөттөрүн uniform бөлүштүрүүдөн кокус түзүшкөн. Айрым иш көлөмдөрү да ар кандай машина сценарийлерин симуляциялоо үчүн кокус түзүлгөн.
Мындан тышкары, машиналардын ортосундагы ташуу убакыттары моделге киргизилген эмес.
Ошондуктан кейс реалдуу фабрика түзүмүнөн алынган, жарым-жартылай синтетикалык эксперимент сценарийи катары бааланууга тийиш.
Реалдуу дүйнө кейсинде маалымат топтому кантип кеңейтилди?
Изилдөөчүлөр алгач 50 негизги өндүрүш пландоо көйгөйүн жана алардын туура формулировкаларын түзүшкөн.
Бул жолу татаалдык жогору болгондуктан 16 башка модулдук көрсөтмө колдонулган:
50 × 16 = 800 мисал.
Мындан тышкары, көйгөй сүрөттөмөлөрүнүн тилдик ар түрдүүлүгүн жогорулатуу үчүн ChatGPT синтетикалык маалымат генератору катары колдонулган.
Мисалы бир эле көйгөй:
- өндүрүш жетекчисинин көз карашынан,
- фабрика операторунун көз карашынан,
- машина колдонууга басым жасаган жетекчинин тили менен
кайра жазылып, мааниси окшош, бирок тили ар башка окутуу мисалдары түзүлгөн.
Бул маалыматты көбөйтүү эмне үчүн маанилүү?
Реалдуу кызматкерлер бир эле өндүрүш көйгөйүн бирдей сөздөр менен айтып берет деп күтүүгө болбойт. Өндүрүш жетекчиси “машина колдонуу деңгээлин жогорулат” десе, оператор “7-Head кезегинде иш калбасын” деп айтышы мүмкүн.
Эгер модель бир эле сүйлөм калыбын жаттап алса, реалдуу чөйрөдө ийгиликсиз болушу мүмкүн. Синтетикалык кайра жазуу ар кандай кызыкдар тараптардын бир операциялык көйгөйдү ар башка тил менен айтуусун туураганга багытталган.
Бирок бул ар түрдүүлүк ChatGPT тарабынан синтезделген; ар башка кызматтарда иштеген реалдуу фабрика кызматкерлеринен чогултулган кең табигый тил корпусу эмес.
Реалдуу дүйнө сценарийинде ийгилик кандай болгон?
4-таблицадагы айрым окутуу конфигурациялары мындай:
| Batch | Epoch | Loss | Убакыт (s) | Ийгилик | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0029 | 864,64 | %6 | %0 | %94 |
| 1 | 4 | 0,0003 | 3454,53 | %100 | %0 | %0 |
| 2 | 4 | 0,0004 | 2141,21 | %100 | %0 | %0 |
| 4 | 4 | 0,0013 | 1445,31 | %23 | %20 | %57 |
| 4 | 8 | 0,0003 | 2902,65 | %100 | %0 | %0 |
Бул таблица fine-tuning жөн гана “бир нече мисал көрсөтүү” эмес экенин ачык көрсөтөт. Мисалы batch 4 менен төрт epoch аягында ийгилик болгону %23 болсо, сегиз epoch аягында %100 деңгээлине өсөт.
Модель жаттап алган болушу мүмкүнбү?
Изилдөөчүлөр бул тобокелдикти окутуу жана validation loss ийри сызыктарын салыштыруу аркылуу баалашкан.
4-сүрөт классикалык JSS, 8-сүрөт болсо реалдуу дүйнө FJSS үчүн окутуу жана validation loss ийри сызыктарын көрсөтөт. Авторлор окутуу алга жылган сайын ийри сызыктардын бири-бирине жакындашын жана чоң туруктуу ажырым көрсөтпөшүн overfitting жоктугу катары чечмелешет.
Бирок бул жыйынтык ошол эле бөлүштүрүүдөн бөлүнгөн validation/test маалыматтары үчүн жалпылоо далили; таптакыр башка фабрика түрлөрү же көрүлбөгөн оптималдаштыруу түзүмдөрү үчүн универсалдуу жалпылоо далили эмес.
PCA embedding анализдери эмнени көрсөтөт?
Изилдөөчүлөр fine-tuned моделдин encoder жана decoder embeddingдерин PCA менен эки өлчөмгө түшүрүшкөн.
Классикалык JSSте көйгөй сүрөттөмөлөрү ар башка көрсөтмөлөргө жараша айкыныраак кластерлерди түзгөнү көрүнөт. Реалдуу дүйнө кейсинде болсо чекиттер көбүрөөк чачыраган; бул тилдик жана түзүмдүк ар түрдүүлүктүн көбөйүшү деп чечмеленет.
Decoder embeddingдеринде ар башка код модулдары да өзүнчө кластерлерди түзөт. Мисалы:
- imports,
- configurations,
- constraints,
- objective,
- visualisation,
- solution
сыяктуу бөлүктөрдүн ар башка өкүлчүлүк аймактарына бөлүнүшү модель бардык кодду бир эле калып катары көчүрбөгөнүн колдогон кошумча анализ катары берилет.
LPWP benchmark эмне үчүн колдонулган?
Алгачкы эки эксперимент түздөн-түз өндүрүш пландоого багытталган. Изилдөөчүлөр ыкма өздөрү түзгөн маалымат топтомдорунда гана ийгиликтүү эмес экенин текшерүү үчүн LPWP деп аталган стандарттуу сызыктуу программалоо маалымат топтомуна да өтүшкөн.
LPWP жалпы 288 көйгөй сүрөттөмөсүн камтыйт.
Салыштырылган ыкмалар:
- Standard GPT,
- Chain-of-Thought (CoT),
- Progressive-Hint Prompting (PHP),
- Chain-of-Experts (CoE),
- сунушталган fine-tuned framework.
LPWPде натыйжа кандай болду?
| Ыкма | Ийгилик | Failure | Exception |
|---|---|---|---|
| Standard | %43 | %24 | %33 |
| CoT | %7 | %7 | %86 |
| PHP | %2 | %3 | %95 |
| CoE | %43 | %31 | %26 |
| Fine-tuned framework | %72 | %26 | %2 |
“Болжол менен %30 жакшыраак” деген эмне?
Макала бул таблицаны “approximately 30% performance improvement” деп сүрөттөйт.
Бирок чийки маанилер:
\[ 72\%-43\%=29 \text{ yüzde puanı} \]
айырма көрсөтөт.
Ошондуктан эң ачык билдирүү — ийгилик көрсөткүчүндө 29 пайыздык пункт өсүш.
Салыштырмалуу өсүш эсептелсе:
\[ \frac{72-43}{43}\times100 \approx 67,4\% \]
алынат. Бул Verianla макаласында булак дооматын күчтүүрөөк же алсызыраак кылып көрсөтпөш үчүн “болжол менен %30 салыштырмалуу жакшыртуу” дегендин ордуна чийки ийгилик көрсөткүчтөрү жана пайыздык пункт айырмасы колдонулат.
LPWP маалыматтарын даярдоодогу маанилүү деталь
LPWP көйгөй сүрөттөмөлөрүн жана күтүлгөн натыйжаларды камтыган, бирок керектүү көйгөй формулировкаларын камтыган эмес.
Изилдөөчүлөр баштапкы формулировкаларды GPT-3.5 менен түзүп, андан кийин күтүлгөн натыйжаларга туура келбеген мисалдарды кол менен текшеришкен.
Макала айрым дал келбестиктерде LPWPнин күтүлгөн маанилери туура эмес болгонун жана айрым GPT-3.5 формулировкаларында да көйгөй болгонун билдирет. Түзөтүлгөн LPWP версиясы өзүнчө жарыяланган.
Демек benchmark даярдоодо автоматтык өндүрүү гана эмес, адам текшерүүсү да колдонулган.
Эмне үчүн кичине модель тандалган?
Изилдөөнүн негизги дизайн максаттарынын бири эсептөө чыгымын азайтуу. Авторлор чоң коммерциялык моделдердин ордуна ачык булактуу жана кичине код өндүрүү моделин fine-tune кылып, тармак билимин моделге киргизүүнү максат кылышат.
2-таблицада окутуу системасы:
- GPU: NVIDIA Tesla V100 SXM2 32 GB,
- модель аныктамасы: Salesforce/codet5-large-ntp-py,
- tokenizer: Salesforce/codet5-large-ntp-py,
- learning rate: 5×10⁻⁵,
- gradient checkpointing: ачык,
- evaluation steps: 10
деп берилет.
Текст болсо ыкманы CodeRL аркылуу түшүндүрөт. CodeRL CodeT5 негизиндеги архитектура экенин айтса да, колдонулган так checkpoint CodeRL аталышы мененби же түздөн-түз CodeT5 checkpoint мененби башталганын булак жетиштүү так айырмалабайт.
SME/KOBИлер бул системаны дароо колдоно алабы?
Изилдөө кичине моделдер эсептөө жана лицензия чыгымдарын азайта аларын, компания ичинде же edge колдонууда маалымат купуялыгы артыкчылыгын бере аларын жана оптималдаштыруу адистиги чектелүү KOBИлердин өнүккөн оптималдаштыруу куралдарына жетүүсүн жеңилдете аларын айтат.
Бирок изилдөөдө:
- бир KOBИде толук өндүрүшкө киргизүү,
- инвестициянын кайтарымынын эсеби,
- булут менен компания ичиндеги сервер чыгымдарын салыштыруу,
- оператор окутуу чыгымы,
- тейлөө жана моделди жаңыртуу чыгымы
өлчөнгөн эмес.
Ошондуктан “чыгым-натыйжалуу” деген жыйынтык архитектуралык жана эсептөө талаптары чоң коммерциялык моделдерге салыштырмалуу азайганына негизделген техникалык доомат; текшерилген коммерциялык ROI жыйынтыгы эмес.
Бул ыкманын өндүрүштөгү эң маанилүү потенциалы эмне?
Эң маанилүү идея — өндүрүш кызматкери математикалык оптималдаштыруу моделин нөлдөн баштап жазууга мажбур болбойт.
Мисалы жетекчи:
“Шашылыш буйрутма келди, жети баштуу машина эки күн бош эмес, бул жумушту башка ылайыктуу машинага өткөрүп, жалпы өндүрүш убактысын минимумга түшүр.”
сыяктуу табигый тилдеги ишкана талабын бере алат.
Идеалдуу учурда fine-tuned модель муну жаңы чечим өзгөрмөсү же чектөө катары формулировкалап, solver жаңыртылган графикти эсептейт.
Бирок булак изилдөө бул түрдөгү бардык күтүлбөгөн кырдаалдарды реалдуу фабрика операциясында узак мөөнөт бою эксперименталдык текшерген эмес. Ошондуктан бул колдонуу сценарийи изилдөө колдогон архитектуралык потенциал катары бааланууга тийиш.
Изилдөө эмнени колдойт?
- Табигый тилдеги оптималдаштыруу көйгөйлөрү тармакка тиешелүү fine-tuning аркылуу solver-ready формулировкаларга айландырылышы мүмкүн.
- Модулдаштыруу token сыйымдуулугу чектелген кичине моделдер менен узун оптималдаштыруу коддорун түзүүгө жардам бере алат.
- Execution-based баалоо тилдик окшоштуктан да түз формулировканын тууралыгын текшерет.
- Ылайыктуу fine-tuning конфигурацияларында классикалык жана татаалыраак өндүрүш пландоо кейстеринде %95 деңгээлинен жогору ийгиликке жетишилген.
- LPWP тестинде fine-tuned ыкма %72 ийгиликке жетип, ошол эле таблицадагы Standard/CoEнин %43 натыйжаларынан ашкан.
- Синтетикалык көйгөй сүрөттөмөлөрү тармак маалыматы жетишсиз болгондо окутуу маалымат топтомун кеңейтүү үчүн колдонулушу мүмкүн.
- Реалдуу өндүрүш ишканасынын эрежелери табигый тилден формалдуу оптималдаштыруу чектөөлөрүнө айландырылышы мүмкүн.
Изилдөө эмнени далилдебейт?
- LLM бардык өндүрүш көйгөйлөрүн адам көзөмөлүсүз туура моделдештире алат деп далилдебейт.
- Fine-tuned модель бардык фабрика түрлөрүндө %95 деңгээлинен жогору ийгиликке кепилдик бербейт.
- LLM оптималдаштыруу чечүүчүсүнүн ордун баспайт.
- Реалдуу дүйнө кейсинин бардык маалыматтары реалдуу ERP өндүрүш тарыхынан алынган эмес.
- Табигый тил интерфейси реалдуу операторлордун иш убактысын канча азайтканын өлчөбөйт.
- KOBИлерде экономикалык инвестиция кайтарымы эсептелген эмес.
- Энергия колдонуу, калдыктар же көмүртек эмиссиясы түз өлчөнгөн эмес.
- Өтө чоң өндүрүш тармактарында же таптакыр башка оптималдаштыруу класстарында ошол эле ийгилик сакталары көрсөтүлгөн эмес.
- Модель чыгыштарына эксперттик көзөмөл толугу менен керексиз болуп калганы көрсөтүлгөн эмес.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Изилдөө дизайнынын кыскача мазмуну
| Компонент | Колдонуу |
|---|---|
| Негизги тапшырма | Табигый тилден оптималдаштыруу көйгөй формулировкасын өндүрүү |
| Негизги ыкма | Тармакка тиешелүү LLM fine-tuning + prompt engineering + код модулдаштыруу |
| Модель үй-бүлөсү | Текстте CodeRL/CodeT5 негизиндеги ыкма |
| Модель идентификациясы, Таблица 2 | Salesforce/codet5-large-ntp-py |
| Көйгөй моделдөө китепканасы | CPMpy |
| Чечүүчү | OR-Tools |
| Fine-tuning | HuggingFace trainer |
| Окутуу / validation / test | %70 / %10 / %20 |
| GPU | NVIDIA Tesla V100 SXM2 32 GB |
| Learning rate | 5 × 10⁻⁵ |
| Негизги баалоо | Success / Failure / Exception |
Кейс 1: Классикалык Job-Shop Scheduling
| Өзгөчөлүк | Маани |
|---|---|
| Кол менен түзүлгөн негизги көйгөй | 100 |
| Модулдук көрсөтмө | 9 |
| Жалпы мисал | 900 |
| Көйгөй сүрөттөмөсү | <600 token |
| Толук көйгөй формулировкасы | 1200–1800 token |
| Өзгөчө конфигурация | Batch 2, epoch 4 |
| Окутуу ийгилик көрсөткүчү | %100 |
| Failure | %0 |
| Exception | %0 |
Кейс 2: Реалдуу фабрика түзүмүнө негизделген FJSS
| Өзгөчөлүк | Маани |
|---|---|
| Негизги көйгөй | 50 |
| Модулдук көрсөтмө | 16 |
| Жалпы мисал | 800 |
| Көйгөй сүрөттөмөсү | <600 token |
| Формулировка узундугу | 1800–3400 token |
| Машина тобу | 7 |
| ERP жеткирүү мөөнөттөрү | Жок; синтетикалык түрдө түзүлгөн |
| Ташуу убактысы | Моделге киргизилген эмес |
Эмне үчүн flexible job-shop күчтүүрөөк тест?
Классикалык JSSте негизги көйгөй операцияларды иреттөө. Flexible JSSте ага машина тандоо да кошулат.
Ар бир операция үчүн:
\[ y_{i,j,h}\in\{0,1\} \]
өзгөрмөсү операциянын машина iге дайындалган же дайындалбаганын көрсөтөт.
Ар бир операциянын бир гана машинага дайындалышы:
\[ \sum_i y_{i,j,h}=1 \]
менен камсыздалат.
Мындан тышкары, операция ылайыктуу болгон машинага гана дайындалышы мүмкүн:
\[ y_{i,j,h}\leq a_{i,j,h} \]
Бул түзүм табигый тилде айтылган фабрика эрежелерин бинардык чечим өзгөрмөлөрүнө айландырууну талап кылат.
LPWP салыштыруусунун илимий мааниси
LPWP экспериментинин мааниси — изилдөө тобунун өз өндүрүш маалымат топтомдорунан сыртка чыгышы.
Сунушталган ыкма %72 ийгиликке жеткенде:
- Standard: %43,
- CoE: %43,
- CoT: %7,
- PHP: %2
деп билдирилген.
Ошол эле учурда сунушталган ыкманын Exception көрсөткүчү болгону %2. Бул түзүлгөн коддун чоң бөлүгү жок дегенде иштетиле турганын камсыздоочу маанилүү натыйжа.
Бирок benchmark протоколунда fine-tuned ыкма окутуу маалыматын талап кыларын, prompt негизиндеги ыкмалар ошол эле түрдө fine-tune кылынбаганын унутпоо керек. Салыштыруу бул эки башка өнүктүрүү парадигмасынын изилдөөдө колдонулган формаларын салыштырат.
Ийгилик метрикасынын чеги
Execution-based баалоо маанилүү күчтүү жак болгону менен, ийгилик критерийи формулировканын туура чечим беришине негизделген.
Ошондуктан натыйжа түзүлгөн моделдин берилген тест мисалында туура жыйынтык чыгарганын тастыктайт. Бул өзүнчө эки математикалык формулировка бардык мүмкүн болгон маалымат мисалдарында толук семантикалык эквивалент экенин далилдеген формалдуу текшерүү эмес.
Бул айырма өзгөчө коопсуздук-критикалык же жогорку чыгымдуу өндүрүш колдонмолорунда адамдык же автоматтык модель текшерүү катмарлары эмне үчүн дагы эле маанилүү экенин көрсөтөт.
Изилдөөнүн күчтүү жактары
- LLM чыгышынын тексттик окшоштугун гана эмес, чыныгы solver иштетилишин өлчөшү.
- Классикалык benchmark менен реалдуу өндүрүш чөйрөсүнөн алынган кейсти бирге карашы.
- Fine-tuning маалымат топтомдорун даярдоо процессин түшүндүрүшү.
- %70/%10/%20 маалымат бөлүнүшүн ачык билдириши.
- Token чегин модулдаштыруу менен системалуу түрдө чечиши.
- Синтетикалык маалымат көбөйтүү процессин ачык көрсөтүшү.
- Маалымат топтомдорунун жана түзүлгөн artefaktтардын маанилүү бөлүгүн ачык репозиторийлерде бөлүшүшү.
- Embedding анализи менен акыркы тактыкты гана эмес, ички өкүлчүлүк жүрүм-турумун да изилдеши.
Изилдөөнүн негизги чектөөлөрү
Авторлор өз жыйынтык бөлүмүндө айткан биринчи чектөө — натыйжалуулук окутуу маалыматтарынын сапаты жана ар түрдүүлүгүнө көз каранды. Окутуу бөлүштүрүүсүнөн олуттуу айырмаланган жаңы көйгөйлөр кошумча fine-tuning же адам текшерүүсүн талап кылышы мүмкүн.
Экинчи чектөө — token көйгөйү. Модулдаштыруу учурдагы көйгөйдү азайтат, бирок өтө чоң же өтө татаал оптималдаштыруу көйгөйлөрүндө азыркы кичине LLM архитектуралары дагы эле жетишсиз болушу мүмкүн.
Үчүнчү чектөө — кейс камтуусу. Эксперименттер негизинен өндүрүш график түзүү көйгөйлөрүнө багытталган. Тармак дизайны, портфель оптималдаштыруу же башка оптималдаштыруу класстарына жалпылоо өзүнчө текшерилиши керек.
Төртүнчү чектөө — узак мөөнөттүү талаа текшерүүсү. Фабрика шарттары убакыт өткөн сайын өзгөрүшү мүмкүн; жаңы машиналар, жаңы өнүмдөр, жаңы иш эрежелери жана персоналдын ар башка сүйлөө формалары модель бөлүштүрүүсүн өзгөртө алат. Ошондуктан авторлор узак мөөнөттүү талаа изилдөөлөрүн келечектеги изилдөө багыты катары сунушташат.
Түркиядагы өндүрүш ишканалары үчүн эмнени билдирет?
Изилдөөдө Түркиядагы фабрикадан маалымат жок. Ошондуктан билдирилген %95 же %72 ийгилик көрсөткүчтөрүн Түркиядагы өндүрүш чөйрөлөрүнө түздөн-түз өткөрүү илимий жактан туура эмес.
Ошентсе да ыкма Түркияда ERP/MES колдонгон өндүрүш ишканалары үчүн сынап көрүүгө боло турган архитектураны сунуштайт. Жергиликтүү колдонуу үчүн компаниянын реалдуу:
- машина топтору,
- операция тартиптери,
- жумуш буйруктары,
- кубаттуулук чектери,
- смена эрежелери,
- жеткирүү мөөнөттөрү,
- тейлөө терезелери,
- приоритеттүү кардар эрежелери
колдонулуп, тармакка тиешелүү маалымат топтому даярдалып, модель көз карандысыз тест маалыматында кайра текшерилиши керек.
Өзгөчө өндүрүш пландоо кызматкерлери эрежелерди табигый түркчө айткан система курулса, түркчө өндүрүш терминологиясы да fine-tuning маалымат топтомунда жетиштүү ар түрдүүлүк менен көрсөтүлүшү керек. Булак изилдөө англисче көйгөйлөрдө жүргүзүлгөндүктөн, түркчө натыйжалуулук боюнча түз жыйынтык бербейт.
Булак жана Ыкма Жөнүндө Эскертүү
Толук түпнуска изилдөө аталышы: Business optimization for digital manufacturing: A fine-tuned large language model approach
Авторлор: Pivithuru Thejan Amarasinghe, Su Nguyen, Yuan Sun, Sobhan (Sean) Arisian, Damminda Alahakoon.
Авторлордун ирети: Булак изилдөөдөгү ирет өзгөртүүсүз сакталган.
Тең салым/тең биринчи автор: Булакта тең салым же тең биринчи автор белгиси жок.
Жооптуу автор: Sobhan (Sean) Arisian.
Мекеме 1: Research Center for Data Analytics and Cognition, La Trobe University, Melbourne, Victoria 3086, Australia.
Мекеме 2: College of Business and Law, RMIT University, Melbourne, Victoria 3000, Australia.
Мекеме 3: ARC Training Centre in Optimization Technologies, Integrated Methodologies, and Applications, University of Melbourne, Melbourne, Victoria 3053, Australia.
Журнал: International Journal of Production Economics.
Басма: Elsevier B.V.
Том: 295.
Макала номери: 109934.
DOI: 10.1016/j.ijpe.2026.109934
Жөнөтүү: 23 июнь 2025.
Ревизия: 12 январь 2026.
Кабыл алуу: 19 январь 2026.
Онлайн жарыя: 29 январь 2026.
Булак түрү: Рецензияланган, ачык жеткиликтүү изилдөө макаласы; эсептөө/жасалма интеллект жана өндүрүш оптималдаштыруу изилдөөсү.
Атайын чыгарылыш: Enhancing digital manufacturing via AI-LLM.
Расмий жарыя шилтемеси: https://doi.org/10.1016/j.ijpe.2026.109934
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint абалы: Каралган документ акыркы International Journal of Production Economics журнал макаласы; preprint катары берилген эмес.
Каржылоо: Каралган PDFде өзүнчө Funding Statement жок. CRediT бөлүмүндө Pivithuru Thejan Amarasinghe үчүн “Funding acquisition” салымы көрсөтүлгөн.
Маалымат жеткиликтүүлүгү: Өзүнчө Data Availability Statement болбосо да, изилдөө маалымат топтомдорун жана түзүлгөн көйгөй формулировкаларын ачык GitHub репозиторийлеринде бөлүшөт. Булакта көрсөтүлгөн репозиторийлер арасында AI-Copilot-Data, AI-Copilot-Artifacts, AI-Copilot-Data-Real-World-Scenario, AI-Copilot-Artifacts-Real-World-Scenario жана оңдолгон LPWP маалымат репозиторийи бар.
Кызыкчылыктардын кагылышы: Каралган PDFде өзүнчө Declaration of Competing Interest билдирүүсү көрүнбөйт.
CRediT салымдары: Pivithuru Thejan Amarasinghe: биринчи долбоор, ыкма, изилдөө, каржылоону алуу, маалымат курациясы жана концептуалдаштыруу. Su Nguyen: биринчи долбоор, валидация, кеңеш/көзөмөл, ыкма, изилдөө жана концептуалдаштыруу. Yuan Sun: биринчи долбоор, валидация, кеңеш/көзөмөл, ресурстар, ыкма жана концептуалдаштыруу. Sobhan (Sean) Arisian: кароо/редакциялоо, валидация, кеңеш/көзөмөл, ресурстар жана долбоор башкаруу. Damminda Alahakoon: кароо/редакциялоо, валидация, кеңеш/көзөмөл, ресурстар жана концептуалдаштыруу.
Генеративдик жасалма интеллект билдирүүсү: ChatGPT изилдөөнүн маалымат түзүү этабында реалдуу дүйнө өндүрүш пландоо көйгөй сүрөттөмөлөрүнүн ар кандай кызыкдар тараптардын көз карашындагы синтетикалык варианттарын түзүү үчүн колдонулган. Авторлор ошондой эле макаланын айрым бөлүктөрүндө тилди жана окумдуулукту жакшыртуу үчүн ChatGPT колдонушканын, андан кийин чыгыштарды өздөрү карап чыгып редакциялашканын жана мазмун үчүн жоопкерчиликти алышканын билдиришет. LPWP көйгөй формулировкаларын алгач түзүүдө GPT-3.5 колдонулуп, дал келбестиктер кол менен текшерилген.
Модель идентификациясы боюнча эскертүү: Булак тексти эксперименттерде CodeRL алдын ала үйрөтүлгөн модель катары колдонулганын айтат, ал эми 2-таблица модель жана tokenizer идентификациясын Salesforce/codet5-large-ntp-py деп берет. CodeRL CodeT5 үстүнө курулганы түшүндүрүлгөнү менен, колдонулган так checkpoint CodeRL аталышы мененби же түз CodeT5 checkpoint мененби башталганы текстте толук такталган эмес; ошондуктан эки билдирүү бул жерде өз-өзүнчө сакталган.
Реалдуу дүйнө маалыматтарынын чеги: Мельбурндагы сайма фабрикасынын физикалык/машина түзүмү жана операциялык эрежелери реалдуу ишканадан алынган. Бирок ERP маалыматтарына жетүү болбогондуктан жеткирүү мөөнөттөрү кокус дайындалып, айрым өндүрүш көлөмдөрү симуляцияланган жана машиналар ортосундагы ташуу убакыттары эсепке алынган эмес. Натыйжаларды толук тарыхый ERP replay изилдөөсү катары чечмелөөгө болбойт.
“%30 жакшыртуу” эскертүүсү: LPWP 5-таблицада сунушталган framework %72, эң жакшы Standard жана CoE натыйжалары %43 ийгилик көрсөтөт. Чийки айырма 29 пайыздык пункт. Булактын “approximately 30% performance improvement” билдирүүсү бул абсолюттук пайыздык-пункт айырмасы менен шайкеш; салыштырмалуу өсүш болжол менен %67.
Чыгым чеги: Булак кичине/fine-tuned модель ыкмасын чыгым-натыйжалуу деп сүрөттөйт; бирок түз акчалай TCO, ROI же реалдуу KOBИ операциялык чыгым салыштыруусун бербейт.
Туруктуулук чеги: Макаланын жыйынтык бөлүмүндө жакшыраак өндүрүш эффективдүүлүгүнүн калдыктарды, энергия керектөөнү жана көмүртек изин азайтуу потенциалы талкууланат. Булар бул изилдөөдө түз өлчөнгөн экологиялык натыйжалар эмес.
Илимий мазмун чеги: Бул Verianla мазмунундагы ыкма, модель, формулалар, маалымат топтомдору, окутуу параметрлери, фабрика кейси, ийгилик көрсөткүчтөрү жана чектөөлөр түпнуска изилдөөгө негизделген. Тышкы булактар библиографиялык идентификацияны, жарыя жазуусун, рецензия жана басма маалыматын текшерүү үчүн гана колдонулган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген