

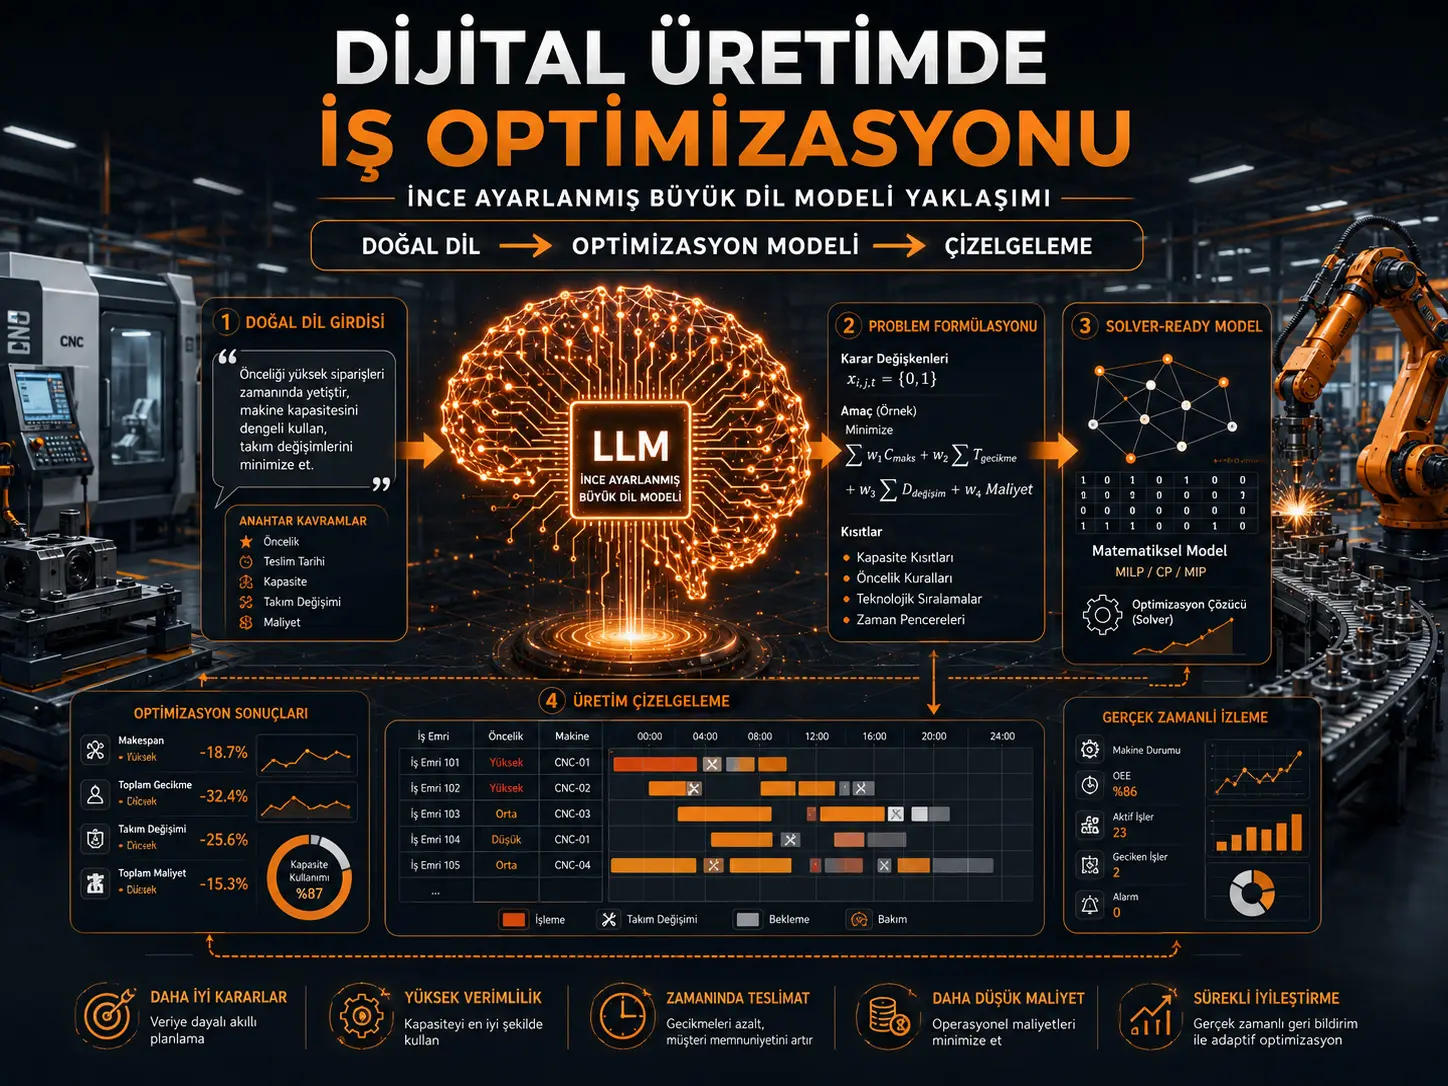
İstehsal menecerinin “bu sifarişləri bu maşınlarda, bu çatdırılma tarixlərinə uyğun və ən qısa ümumi müddətdə istehsal et” deməsi asandır; bu tələbi optimallaşdırma həlledicisinin başa düşəcəyi qərar dəyişənlərinə, məqsəd funksiyalarına və riyazi məhdudiyyətlərə çevirmək isə çox vaxt əməliyyat tədqiqatı üzrə ixtisas tələb edir. Bu iş rəqəmsal istehsaldakı həmin ixtisas darboğazını azaltmaq üçün təbii dildə yazılmış istehsal problemlərini avtomatik olaraq həllediciyə hazır optimallaşdırma modellərinə çevirən incə tənzimlənmiş böyük dil modeli çərçivəsi hazırlayır.
Yanaşmanın mərkəzində ümumi təyinatlı çox böyük və bahalı kommersiya modelindən istifadə etmək əvəzinə, kod yaratmaq qabiliyyətinə malik nisbətən kiçik əvvəlcədən öyrədilmiş modeli sahəyə məxsus məlumatlarla fine-tune etmək dayanır. Modelin məhdud çıxış uzunluğu problem formulyasiyasının bir dəfəyə yaradılması əvəzinə dəyişənlər, məhdudiyyətlər, məqsəd funksiyası, həll və vizuallaşdırma kimi müstəqil kod modullarına bölünməsi ilə aradan qaldırılmağa çalışılır. Beləliklə, təbii dildə problem müxtəlif təlimatlarla hissə-hissə modelləşdirilir və alınan modullar sonradan birləşdirilərək icra edilə bilən optimallaşdırma modeli əldə olunur.
Tədqiqatçılar sistemi üç səviyyədə sınaqdan keçirmişlər: klassik job-shop scheduling problemi, Avstraliyadakı real bir naxış fabrikinin quruluşu və əməliyyat qaydalarına əsaslanan daha mürəkkəb flexible job-shop scheduling problemi və 288 optimallaşdırma problemindən ibarət LPWP xətti proqramlaşdırma benchmarkı. Uyğun təlim konfiqurasiyalarında iki istehsal planlaşdırma halında %95-dən yuxarı icra uğuru bildirilərkən, LPWP testində təklif olunan fine-tuned yanaşma %72 uğura çatmışdır. Standard GPT və Chain-of-Experts (CoE) üsulları eyni müqayisədə %43 uğur göstərmişdir. Bu fərq 29 faiz bəndidir.
Nəticələrin mühüm məhdudiyyəti budur: iş süni intellektin fabrikin bütün əməliyyatlarını özbaşına idarə edə bildiyini göstərmir. Modelin vəzifəsi insan tərəfindən təbii dildə təsvir olunan optimallaşdırma problemini riyazi/kodlaşdırılmış formaya çevirməkdir; həqiqi optimal həlli hesablayan komponent hələ də OR-Tools kimi optimallaşdırma həlledicisidir. Bundan əlavə, real fabrika halında bəzi istehsal qaydaları real müəssisədən götürülsə də, ERP məlumatlarına çıxış olmadığı üçün çatdırılma tarixləri və bəzi miqdarlar sintetik şəkildə yaradılmışdır.
İstehsaldakı əsas problem süni intellektin problemi həll etməsidir, yoxsa problemi düzgün müəyyənləşdirməsidir?
İşin çıxış nöqtəsi bu fərqdir. Optimallaşdırma həlledicisi riyazi olaraq müəyyənləşdirilmiş problemi həll edə bilər; lakin real müəssisədəki problemi riyazi modelə çevirmək ayrıca ixtisas sahəsidir.
İstehsal planlaşdırma problemi adətən ən azı üç əsas komponentdən ibarətdir:
- Qərar dəyişənləri: Hansı iş hansı maşına təyin ediləcək? İş nə vaxt başlayacaq?
- Məqsəd funksiyası: Ümumi istehsal müddəti, gecikmə, enerji xərci və ya başqa ölçü minimallaşdırılacaq?
- Məhdudiyyətlər: Eyni maşında iki iş eyni vaxtda işləyə bilərmi? Əməliyyatlar hansı ardıcıllıqla baş verməlidir? Hansı maşın hansı əməliyyatı yerinə yetirə bilər?
Bu model daha sonra MiniZinc, GAMS, AMPL və ya işdə istifadə olunan CPMpy kimi modelləşdirmə mühitində kodlaşdırılır və Gurobi, CPLEX, SCIP və ya OR-Tools kimi həllediciyə ötürülür.
Tədqiqatçıların “problem formulation” adlandırdıqları proses real müəssisə tələbinin bu riyazi və icra edilə bilən quruluşa çevrilməsidir.
LLM burada dəqiq olaraq nə edir?
LLM birbaşa optimal istehsal cədvəlini təxmin etməyə məcbur edilmir. Bunun əvəzinə təbii dildəki problem təsvirini optimallaşdırma modelinə çevirir.
İşin Şəkil 2-dəki proses zənciri sadələşdirildikdə:
Təbii dildə problem → Fine-tuned LLM → Qərar dəyişənləri + məhdudiyyətlər + məqsəd funksiyası → Solver → Optimal/uyğun həll
şəklindədir.
Bu fərq vacibdir. LLM riyazi optimallaşdırma həlledicisinin yerini tutmur; həlledici üçün zəruri modelin yaradılmasını avtomatlaşdırır.
Niyə ümumi təyinatlı LLM əvəzinə fine-tuning?
Müəlliflər mövcud işlərin mühüm hissəsinin prompt engineering və ya in-context learning istifadə etdiyini, lakin mürəkkəb istehsal optimallaşdırma problemlərində bunun kifayət qədər dəqiqlik verməyə biləcəyini müdafiə edirlər.
Fine-tuning yanaşmasında modelə sadəcə “optimallaşdırma mütəxəssisi kimi davran” deyilmir. Model təbii dildəki istehsal problemi ilə düzgün problem formulyasiyasının uyğunlaşdırıldığı xüsusi nümunələr üzərində yenidən öyrədilir.
Fine-tuning zamanı yaradılan model ilə hədəf kod arasındakı fərq cross-entropy loss istifadə edilərək azaldılır. Mənbədə itki funksiyası ümumilikdə:
\[ l(x,y)=\frac{1}{N}\sum_{n=1}^{N}l_n \]
və token səviyyəsindəki termin:
\[ l_n= -\log \frac{\exp(x_{n,y_n})} {\sum_{q=1}^{Q}\exp(x_{n,q})} \]
şəklində verilir.
Lakin tədqiqatçılar yalnız aşağı cross-entropy loss dəyərinin düzgün optimallaşdırma modeli yaradıldığını sübut etmədiyini xüsusi olaraq qəbul edirlər. Buna görə yaradılan kod həqiqətən icra edilir.
“İcra edərək doğrulama” niyə vacibdir?
LLM sintaksis baxımından təsirli görünən, lakin riyazi olaraq səhv kod yarada bilər. Tədqiqatçılar bunun qarşısını almaq üçün yaradılan formulyasiyanı OR-Tools ilə işlədirlər.
Üç mümkün nəticə müəyyənləşdirilib:
- Success: Formulyasiya işləyir və düzgün həll verir.
- Failure: Formulyasiya işləyir, lakin səhv həll verir.
- Exception: Formulyasiya işə salına bilmir və ya icra xətası verir.
Uğur nisbəti:
\[ Success=\frac{CR}{I}\times100 \]
uğursuzluq nisbəti:
\[ Failure=\frac{RE}{I}\times100 \]
və istisna nisbəti:
\[ Exception=\frac{CE}{I}\times100 \]
kimi müəyyənləşdirilib.
Burada I ümumi formulyasiya sayı, CR düzgün həll yaradanlar, RE səhv həll yaradanlar və CE icra olunmayan modellərdir.
İlk sınaq: klassik Job-Shop Scheduling
İlk hal istehsal planlaşdırmasının klassik problemlərindən olan Job-Shop Scheduling-dir. Çoxsaylı işlər müəyyən maşınlardan müəyyən ardıcıllıqla keçməlidir və eyni maşın eyni anda yalnız bir əməliyyatı işləyə bilər.
İş üç fərqli məqsəd funksiyasını nəzərdən keçirir:
- makespan, yəni son iş tamamlanana qədər keçən ümumi müddət,
- maksimum gecikmə,
- prioritetlə çəkilən ümumi gecikmə.
Məsələn makespan:
\[ \min C_{max} \]
kimi minimallaşdırılır və hər işin son əməliyyatının bitmə vaxtı üçün:
\[ C_{max}\geq e_{j,n_j} \]
məhdudiyyəti tətbiq olunur.
Bundan əlavə eyni maşındakı iki əməliyyat üst-üstə düşməməli və bir iş daxilində əməliyyatlar düzgün ardıcıllıqla getməlidir.
İlk məlumat dəsti necə yaradıldı?
Tədqiqatçılar klassik JSS üçün əvvəlcə 100 problem təsvirini və onlara uyğun problem formulyasiyalarını əl ilə hazırlayıblar.
Problem formulyasiyalarının uzunluğu təxminən 1200–1800 token arasında dəyişir. Problem təsvirləri isə 600 tokendən azdır.
Modelin bir dəfəyə yarada bildiyi çıxış bu problem formulyasiyalarından daha qısa olduğu üçün kod doqquz fərqli funksional hissəyə bölünüb. Doqquz ayrıca təlimat istifadə edildiyinə görə 100 baza problemindən:
100 × 9 = 900 təlim nümunəsi
əldə edilib.
Token limiti niyə vacib idi?
İşin mətni istifadə olunan kiçik kod yaratma modelinin təxminən 600 tokenlik çıxış məhdudiyyətinə malik olduğunu bildirir. Tam istehsal planlaşdırma modeli bundan bir neçə dəfə uzundur.
Tədqiqatçılar daha böyük və bahalı modeldən istifadə etmək əvəzinə kodu modullaşdırırlar.
Məsələn ayrıca təlimatlar:
- lazımi kitabxanaları yarat,
- qərar dəyişənlərini yarat,
- toqquşmama məhdudiyyətlərini yaz,
- prioritet məhdudiyyətlərini əlavə et,
- məqsəd funksiyasını müəyyənləşdir,
- modeli həll et,
- nəticələri vizuallaşdır
kimi alt tapşırıqlara uyğun gələ bilər.
Hər alt problem modelin token limiti daxilində qalır; son mərhələdə modullar birləşdirilir.
Klassik JSS təcrübəsində nəticə nə oldu?
Nəticələr təlim müddətinin və uğurun batch size və epoch sayından güclü şəkildə asılı olduğunu göstərir.
Məsələn:
| Batch | Epoch | Loss | Təlim müddəti (s) | Uğur | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0056 | 1083,78 | %16 | %23 | %61 |
| 1 | 8 | 0,0008 | 8561,05 | %96 | %0 | %4 |
| 2 | 4 | 0,0014 | 2554,93 | %100 | %0 | %0 |
| 4 | 4 | 0,0017 | 1733,71 | %97 | %0 | %3 |
Beləliklə, “model %95-dən yüksək uğur əldə etdi” ifadəsi hər təlim mərhələsi üçün keçərli deyil. Kifayət qədər fine-tuning edildikdə uyğun konfiqurasiyalarda bu səviyyəyə çatılıb.
Real fabrika halı nə idi?
İkinci hal Melburnda fəaliyyət göstərən və məqalədə məxfilik səbəbilə XYZ adlandırılan naxış istehsalçısıdır.
Şəkil 1 fabrikin real istehsal quruluşunu göstərir. Müəssisədə yeddi maşın qrupu var:
- Flat,
- Hanging,
- Cap Front,
- Patch,
- Little Fang,
- Packaging,
- 7-Head.
Şəkildə verilən real nümunə iş axını:
Cap Machine → Flat Machine → Flat Machine → Hanging Machine
şəklindədir.
Niyə bu problem klassik JSS-dən çətindir?
Standart JSS-də əməliyyatın işləyəcəyi maşın çox vaxt əvvəlcədən məlumdur. XYZ fabrikində isə bəzi əməliyyatlar birdən çox uyğun maşında yerinə yetirilə bilər.
Buna görə süni intellektin yaradacağı formulyasiya iki qərarı eyni vaxtda modelləşdirməlidir:
- əməliyyat hansı maşına təyin ediləcək,
- həmin maşında hansı ardıcıllıqla işləyəcək?
Bu struktur Flexible Job-Shop Scheduling Problem (FJSS) kimi təsnif edilir.
Real müəssisə qaydaları riyazi məhdudiyyətə necə çevrilir?
Fabrikdə, məsələn, dörd ədəddən az sifarişlər Little Fang maşınlarına, dörd ilə yeddi ədəd arasındakılar 7-Head maşınlarına yönləndirilir.
7-Head növbəsində gözləmə iki iş gününü keçərsə, iş başqa uyğun maşına ötürülə bilər.
LLM-in vəzifəsi bu cür təbii dil qaydalarını:
- maşın uyğunluğu dəyişənlərinə,
- təyinat dəyişənlərinə,
- başlanğıc vaxtlarına,
- əməliyyat prioritetlərinə,
- makespan məqsəd funksiyasına
çevirməkdir.
“Real dünya” ifadəsinin sərhədi nədir?
Fabrika, maşın qrupları və əməliyyat qaydaları real istehsal mühitinə əsaslanır. Lakin tədqiqatçıların ERP məlumatlarına çıxışı olmadığı üçün çatdırılma tarixləri uniform paylanmadan təsadüfi yaradılıb. Bəzi iş miqdarları da müxtəlif maşın ssenarilərini simulyasiya etmək üçün təsadüfi yaradılıb.
Bundan əlavə maşınlar arasındakı daşınma müddətləri modelə daxil edilməyib.
Buna görə hal real fabrika quruluşundan törədilmiş, qismən sintetik təcrübə ssenarisi kimi qiymətləndirilməlidir.
Real-dünya halında məlumat dəsti necə böyüdüldü?
Tədqiqatçılar əvvəlcə 50 baza istehsal planlaşdırma problemi və düzgün formulyasiyalarını hazırlayıblar.
Bu dəfə mürəkkəblik daha yüksək olduğuna görə 16 fərqli modulyar təlimat istifadə edilib:
50 × 16 = 800 nümunə.
Bundan əlavə problem təsvirlərinin dil müxtəlifliyini artırmaq üçün ChatGPT sintetik məlumat generatoru kimi istifadə edilib.
Məsələn eyni problem:
- istehsal menecerinin baxışından,
- fabrika operatorunun baxışından,
- maşın istifadəsinə fokuslanan menecerin dili ilə
yenidən yazdırılaraq semantik baxımdan oxşar, lakin dil baxımından fərqli təlim nümunələri yaradılıb.
Bu məlumat artırma niyə vacibdir?
Real əməkdaşların eyni istehsal problemini eyni sözlərlə təsvir etməsi gözlənilmir. İstehsal meneceri “maşın istifadə nisbətini artır” deyə bilər, operator isə “7-Head növbəsində iş qalmasın” deyə bilər.
Model yalnız müəyyən cümlə qəlibini əzbərləsə, real mühitdə uğursuz ola bilər. Sintetik yenidən yazma müxtəlif maraqlı tərəflərin eyni əməliyyat problemini fərqli dillə ifadə etməsini təqlid etməyi hədəfləyir.
Lakin bu müxtəliflik ChatGPT tərəfindən sintez edilib; müxtəlif vəzifələrdə çalışan real fabrika əməkdaşlarından toplanmış geniş təbii dil korpusu deyil.
Real-dünya ssenarisində uğur nə idi?
Cədvəl 4-də bəzi təlim konfiqurasiyaları belədir:
| Batch | Epoch | Loss | Müddət (s) | Uğur | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0029 | 864,64 | %6 | %0 | %94 |
| 1 | 4 | 0,0003 | 3454,53 | %100 | %0 | %0 |
| 2 | 4 | 0,0004 | 2141,21 | %100 | %0 | %0 |
| 4 | 4 | 0,0013 | 1445,31 | %23 | %20 | %57 |
| 4 | 8 | 0,0003 | 2902,65 | %100 | %0 | %0 |
Bu cədvəl fine-tuning-in sadəcə “bir neçə nümunə göstərməkdən” ibarət olmadığını açıq göstərir. Məsələn batch 4 ilə dörd epoch sonunda uğur yalnız %23 olduğu halda səkkiz epoch sonunda %100-ə yüksəlir.
Model əzbərləmiş ola bilərmi?
Tədqiqatçılar bu riski təlim və validation loss əyrilərini müqayisə edərək qiymətləndiriblər.
Şəkil 4 klassik JSS, Şəkil 8 isə real-dünya FJSS üçün təlim və validation loss əyrilərini göstərir. Müəlliflər əyrilərin təlim irəlilədikcə bir-birinə yaxınlaşmasını və böyük davamlı ayrılmalar göstərməməsini overfitting olmadığına işarə kimi şərh edirlər.
Bununla belə bu nəticə eyni paylanmadan ayrılmış validation/test məlumatları üçün ümumiləşmə sübutudur; tamamilə fərqli fabrika növləri və ya görülməmiş optimallaşdırma strukturları üçün universal ümumiləşmə sübutu deyil.
PCA embedding analizləri nə göstərir?
Tədqiqatçılar fine-tuned modelin encoder və decoder embedding-lərini PCA ilə iki ölçüyə endiriblər.
Klassik JSS-də problem təsvirlərinin müxtəlif təlimatlara görə daha aydın klasterlər yaratdığı görünür. Real-dünya halında isə nöqtələr daha səpələnmişdir; bu, dil və struktur müxtəlifliyinin artması kimi şərh edilir.
Decoder embedding-lərində müxtəlif kod modulları da ayrı klasterlər yaradır. Məsələn:
- imports,
- configurations,
- constraints,
- objective,
- visualisation,
- solution
kimi hissələrin fərqli təmsil sahələrinə ayrılması modelin yalnız bütün kodu vahid qəlib kimi kopyalamadığını dəstəkləyən köməkçi analiz kimi təqdim olunur.
LPWP benchmark niyə istifadə edildi?
İlk iki təcrübə birbaşa istehsal planlaşdırmaya yönəlib. Tədqiqatçılar üsulun yalnız özlərinin hazırladığı məlumat dəstlərində uğurlu olmadığını sınamaq üçün LPWP adlı standart xətti proqramlaşdırma məlumat dəstinə də keçiblər.
LPWP ümumilikdə 288 problem təsviri ehtiva edir.
Müqayisə olunan üsullar:
- Standard GPT,
- Chain-of-Thought (CoT),
- Progressive-Hint Prompting (PHP),
- Chain-of-Experts (CoE),
- təklif olunan fine-tuned framework.
LPWP-də nəticə nə oldu?
| Üsul | Uğur | Failure | Exception |
|---|---|---|---|
| Standard | %43 | %24 | %33 |
| CoT | %7 | %7 | %86 |
| PHP | %2 | %3 | %95 |
| CoE | %43 | %31 | %26 |
| Fine-tuned framework | %72 | %26 | %2 |
“Təxminən %30 daha yaxşı” nə deməkdir?
Məqalə bu cədvəli “approximately 30% performance improvement” kimi təsvir edir.
Lakin xam dəyərlər:
\[ 72\%-43\%=29 \text{ yüzde puanı} \]
fərq göstərir.
Buna görə ən aydın ifadə uğur nisbətində 29 faiz bəndlik artımdır.
Nisbi artım hesablanarsa:
\[ \frac{72-43}{43}\times100 \approx 67,4\% \]
alınır. Bu Verianla məqaləsində mənbə iddiasını olduğundan güclü və ya zəif göstərməmək üçün “təxminən %30 nisbi yaxşılaşma” əvəzinə xam uğur nisbətləri və faiz bəndi fərqi istifadə olunur.
LPWP məlumatının hazırlanmasında mühüm bir detal
LPWP problem təsvirlərini və gözlənilən nəticələri ehtiva etdiyi halda zəruri problem formulyasiyalarını ehtiva etmirdi.
Tədqiqatçılar ilkin formulyasiyaları GPT-3.5 istifadə edərək yaratmış, sonra gözlənilən nəticələrlə uyğun gəlməyən nümunələri əl ilə nəzərdən keçirmişlər.
Məqalə bəzi uyğunsuzluqlarda LPWP-nin gözlənilən dəyərlərinin səhv olduğunu və bəzi GPT-3.5 formulyasiyalarında da problem olduğunu bildirir. Düzəldilmiş LPWP versiyası ayrıca yayımlanıb.
Beləliklə benchmark hazırlanmasında yalnız avtomatik yaratma deyil, insan doğrulaması da istifadə edilib.
Niyə kiçik model seçildi?
Tədqiqatın əsas dizayn hədəflərindən biri hesablama xərclərini azaltmaqdır. Müəlliflər böyük kommersiya modelləri əvəzinə açıq mənbəli və daha kiçik kod yaratma modelini fine-tune edərək sahə biliyini modelə yerləşdirməyi məqsəd qoyurlar.
Cədvəl 2-də təlim sistemi:
- GPU: NVIDIA Tesla V100 SXM2 32 GB,
- model təsviri: Salesforce/codet5-large-ntp-py,
- tokenizer: Salesforce/codet5-large-ntp-py,
- learning rate: 5×10⁻⁵,
- gradient checkpointing: açıq,
- evaluation steps: 10
kimi verilir.
Mətn isə yanaşmanı CodeRL üzərindən izah edir. CodeRL-nin CodeT5 əsaslı arxitektura olduğunu qeyd etsə də istifadə olunan dəqiq checkpoint-in CodeRL adı iləmi, yoxsa birbaşa CodeT5 checkpoint-i iləmi başladıldığı mənbədə kifayət qədər ayrılmır.
SME/KOBİ-lər həqiqətən bu sistemi dərhal istifadə edə bilərmi?
İş kiçik modellərin hesablama və lisenziya xərclərini azalda biləcəyini, şirkət daxilində və ya edge istifadə üçün məlumat məxfiliyi üstünlüyü təmin edə biləcəyini və optimallaşdırma ixtisası məhdud olan KOBİ-lərin qabaqcıl optimallaşdırma alətlərinə çıxışını asanlaşdıra biləcəyini müdafiə edir.
Bununla belə işdə:
- bir KOBİ-də tam istehsal yerləşdirməsi,
- investisiya gəliri hesablaması,
- bulud ilə şirkətdaxili server xərc müqayisəsi,
- operator təlim xərci,
- xidmət və model yeniləmə xərci
ölçülməyib.
Beləliklə “xərc-effektiv” nəticəsi arxitektura və hesablama tələblərinin böyük kommersiya modelləri ilə müqayisədə azaldılmasına əsaslanan texniki iddiadır; doğrulanmış kommersiya ROI nəticəsi deyil.
Bu yanaşmanın istehsalda ən mühüm potensialı nədir?
Ən mühüm fikir istehsal əməkdaşının riyazi optimallaşdırma modelini sıfırdan yazmaq məcburiyyətində qalmamasıdır.
Məsələn menecer:
“Təcili sifariş gəldi, yeddi başlı maşın iki gün doludur, bu işi başqa uyğun maşına keçir və ümumi istehsal müddətini minimuma endir.”
kimi təbii dildə əməliyyat tələbi verə bilər.
İdeal halda fine-tuned model bunu yeni qərar dəyişəni və ya məhdudiyyət kimi formulyasiya edir və solver yenilənmiş cədvəli hesablayır.
Lakin mənbə işi bu tip bütün gözlənilməz vəziyyətləri real fabrika əməliyyatında uzun müddət ərzində eksperimental olaraq sınamayıb. Buna görə bu istifadə ssenarisi işin dəstəklədiyi arxitektur potensial kimi qiymətləndirilməlidir.
İş nəyi dəstəkləyir?
- Təbii dildəki optimallaşdırma problemləri sahəyə məxsus fine-tuning ilə solver-ready formulyasiyalara çevrilə bilər.
- Modullaşdırma məhdud token tutumuna malik daha kiçik modellərlə uzun optimallaşdırma kodlarının yaradılmasına kömək edə bilər.
- Execution-based qiymətləndirmə yalnız dil oxşarlığından daha birbaşa formulyasiya dəqiqliyi nəzarəti verir.
- Uyğun fine-tuning konfiqurasiyalarında klassik və daha mürəkkəb istehsal planlaşdırma hallarının %95-dən çoxunda uğur əldə edilib.
- LPWP testində fine-tuned yanaşma %72 uğura çatıb və eyni cədvəldə Standard/CoE-nin %43 nəticələrini keçib.
- Sintetik problem təsvirləri sahə məlumatı kifayət etmədikdə təlim məlumat dəstini genişləndirmək üçün istifadə edilə bilər.
- Real istehsal müəssisəsinin qaydaları təbii dildən formal optimallaşdırma məhdudiyyətlərinə çevrilə bilər.
İş nəyi sübut etmir?
- LLM-in bütün istehsal problemlərini insan nəzarəti olmadan düzgün modelləşdirə biləcəyini sübut etmir.
- Fine-tuned model bütün fabrika növlərində %95-dən yuxarı uğura zəmanət vermir.
- LLM optimallaşdırma həlledicisinin yerini tutmur.
- Real-dünya hal məlumatlarının hamısı real ERP istehsal tarixçəsindən gəlmir.
- Təbii dil interfeysinin real operatorların iş müddətini nə qədər azaltdığı ölçülməyib.
- KOBİ-lərdə iqtisadi investisiya gəliri hesablanmayıb.
- Enerji istifadəsi, tullantı və ya karbon emissiyası birbaşa ölçülməyib.
- Çox böyük istehsal şəbəkələrində və ya tamamilə fərqli optimallaşdırma siniflərində eyni uğurun qorunacağı göstərilməyib.
- Model çıxışlarında mütəxəssis nəzarətinin tamamilə lazımsız olduğu göstərilməyib.
İşin Metodu və Nəticələri
Tədqiqat dizaynının xülasəsi
| Komponent | Tətbiq |
|---|---|
| Əsas tapşırıq | Təbii dildən optimallaşdırma problem formulyasiyası yaratmaq |
| Əsas yanaşma | Sahəyə məxsus LLM fine-tuning + prompt engineering + kod modullaşdırma |
| Model ailəsi | Mətndə CodeRL/CodeT5 əsaslı yanaşma |
| Model kimliyi, Cədvəl 2 | Salesforce/codet5-large-ntp-py |
| Problem modelləşdirmə kitabxanası | CPMpy |
| Həlledici | OR-Tools |
| Fine-tuning | HuggingFace trainer |
| Təlim / validation / test | %70 / %10 / %20 |
| GPU | NVIDIA Tesla V100 SXM2 32 GB |
| Learning rate | 5 × 10⁻⁵ |
| Əsas qiymətləndirmə | Success / Failure / Exception |
Hal 1: Klassik Job-Shop Scheduling
| Xüsusiyyət | Dəyər |
|---|---|
| Əl ilə hazırlanmış baza problem | 100 |
| Modulyar təlimat | 9 |
| Ümumi nümunə | 900 |
| Problem təsviri | <600 token |
| Tam problem formulyasiyası | 1200–1800 token |
| Seçilən konfiqurasiya | Batch 2, epoch 4 |
| Təlim uğur nisbəti | %100 |
| Failure | %0 |
| Exception | %0 |
Hal 2: Real fabrika quruluşuna əsaslanan FJSS
| Xüsusiyyət | Dəyər |
|---|---|
| Baza problem | 50 |
| Modulyar təlimat | 16 |
| Ümumi nümunə | 800 |
| Problem təsviri | <600 token |
| Formulyasiya uzunluğu | 1800–3400 token |
| Maşın qrupu | 7 |
| ERP çatdırılma tarixləri | Mövcud deyil; sintetik yaradılıb |
| Daşınma müddəti | Modelə daxil edilməyib |
Niyə flexible job-shop daha güclü sınaqdır?
Klassik JSS-də əsas problem əməliyyatların sıralanmasıdır. Flexible JSS-də buna maşın seçimi də əlavə olunur.
Hər əməliyyat üçün:
\[ y_{i,j,h}\in\{0,1\} \]
dəyişəni əməliyyatın maşın i-yə təyin edilib-edilmədiyini göstərir.
Hər əməliyyatın yalnız bir maşına təyin edilməsi:
\[ \sum_i y_{i,j,h}=1 \]
ilə təmin olunur.
Bundan əlavə əməliyyat yalnız uyğun olduğu maşına təyin edilə bilər:
\[ y_{i,j,h}\leq a_{i,j,h} \]
Bu struktur təbii dildə ifadə olunan fabrika qaydalarının ikili qərar dəyişənlərinə çevrilməsini tələb edir.
LPWP müqayisəsinin elmi mənası
LPWP təcrübəsinin əhəmiyyəti iş komandasının öz istehsal məlumat dəstlərindən kənara çıxılmasıdır.
Təklif olunan üsul %72 uğura çatarkən:
- Standard: %43,
- CoE: %43,
- CoT: %7,
- PHP: %2
kimi bildirilmişdir.
Eyni zamanda təklif olunan üsulun Exception nisbəti yalnız %2-dir. Bu yaradılan kodun böyük hissəsinin ən azından icra edilə bilən olması baxımından mühüm nəticədir.
Lakin benchmark protokolunda fine-tuned yanaşmanın təlim məlumatına ehtiyacı olduğu, prompt əsaslı üsulların isə eyni şəkildə fine-tune edilmədiyi unudulmamalıdır. Müqayisə bu iki fərqli inkişaf paradiqmasının iş tərəfindən tətbiq edilən formalarını müqayisə edir.
Uğur metrikasının sərhədi
Execution-based qiymətləndirmə mühüm güclü tərəf olsa da uğur meyarı formulyasiyanın düzgün həll verməsinə əsaslanır.
Buna görə nəticə yaradılan modelin verilən test nümunəsində düzgün nəticə verdiyini doğrulayır. Bu, özlüyündə iki riyazi formulyasiyanın bütün mümkün məlumat nümunələrində tam semantik ekvivalent olduğunu sübut edən formal yoxlama deyil.
Bu fərq xüsusilə təhlükəsizlik-kritik və ya yüksək xərcli istehsal tətbiqlərində insan və ya avtomatlaşdırılmış model doğrulama qatlarının niyə hələ də vacib ola biləcəyini göstərir.
İşin güclü tərəfləri
- Yalnız LLM çıxışının mətn oxşarlığını deyil, real solver icrasını ölçməsi.
- Klassik benchmark ilə real istehsal mühitindən törədilən halı birlikdə araşdırması.
- Fine-tuning məlumat dəstlərinin hazırlanma prosesini izah etməsi.
- %70/%10/%20 məlumat bölünməsini açıq bildirməsi.
- Token limitini modullaşdırma ilə sistemli şəkildə həll etməsi.
- Sintetik məlumat artırma prosesini açıq bildirməsi.
- Məlumat dəstləri və yaradılan artefaktların mühüm hissəsini açıq depolarda paylaşması.
- Embedding analizi ilə yalnız son dəqiqliyi deyil, daxili təmsil davranışını da araşdırması.
İşin əsas məhdudiyyətləri
Müəlliflərin öz nəticə bölməsində qeyd etdiyi ilk məhdudiyyət performansın təlim məlumatının keyfiyyət və müxtəlifliyindən asılı olmasıdır. Təlim paylanmasından əhəmiyyətli dərəcədə fərqli yeni problemlər əlavə fine-tuning və ya insan doğrulaması tələb edə bilər.
İkinci məhdudiyyət token problemidir. Modullaşdırma mövcud problemi azaldır, lakin çox böyük və çox mürəkkəb optimallaşdırma problemlərində mövcud kiçik LLM arxitekturaları yenə kifayət etməyə bilər.
Üçüncü məhdudiyyət hal əhatəsidir. Təcrübələr əsasən istehsal cədvəlləmə problemlərinə fokuslanıb. Şəbəkə dizaynı, portfel optimallaşdırması və ya başqa optimallaşdırma siniflərinə ümumiləşdirmə ayrıca doğrulanmalıdır.
Dördüncü məhdudiyyət uzunmüddətli sahə doğrulamasıdır. Fabrika şəraiti zamanla dəyişə bilər; yeni maşınlar, yeni məhsullar, yeni iş qaydaları və fərqli personal ifadə formaları model paylanmasını dəyişə bilər. Müəlliflər buna görə uzunmüddətli sahə işlərini gələcək tədqiqat istiqaməti kimi təklif edirlər.
Türkiyədəki istehsal müəssisələri üçün nə deməkdir?
İşdə Türkiyədəki fabrikdən məlumat yoxdur. Buna görə bildirilən %95 və ya %72 uğur nisbətlərini Türkiyə istehsal mühitlərinə birbaşa tətbiq etmək elmi baxımdan düzgün olmaz.
Bununla belə üsul Türkiyədə ERP/MES istifadə edən istehsal müəssisələri üçün sınaqdan keçirilə bilən arxitektura təqdim edir. Yerli tətbiq üçün şirkətin real:
- maşın qrupları,
- əməliyyat ardıcıllıqları,
- iş əmrləri,
- tutum sərhədləri,
- növbə qaydaları,
- çatdırılma tarixləri,
- texniki xidmət pəncərələri,
- prioritet müştəri qaydaları
istifadə edilərək sahəyə məxsus məlumat dəsti hazırlanmalı və model müstəqil test məlumatında yenidən doğrulanmalıdır.
Xüsusilə istehsal planlaşdırma işçilərinin qaydaları təbii türkcə ifadə etdiyi sistem qurulmaq istənərsə, türkcə istehsal terminologiyası da fine-tuning məlumat dəstində kifayət qədər müxtəlifliklə təmsil edilməlidir. Mənbə iş ingilis dilində problemlər üzərində aparıldığı üçün türkcə performans barədə birbaşa nəticə vermir.
Mənbə və Metod Qeydi
Tam özgün iş adı: Business optimization for digital manufacturing: A fine-tuned large language model approach
Müəlliflər: Pivithuru Thejan Amarasinghe, Su Nguyen, Yuan Sun, Sobhan (Sean) Arisian, Damminda Alahakoon.
Müəllif sırası: Mənbə işdəki sıra olduğu kimi qorunub.
Bərabər töhfə/bərabər birinci müəllif: Mənbədə bərabər töhfə və ya bərabər birinci müəllif işarəsi yoxdur.
Məsul müəllif: Sobhan (Sean) Arisian.
Qurum 1: Research Center for Data Analytics and Cognition, La Trobe University, Melbourne, Victoria 3086, Australia.
Qurum 2: College of Business and Law, RMIT University, Melbourne, Victoria 3000, Australia.
Qurum 3: ARC Training Centre in Optimization Technologies, Integrated Methodologies, and Applications, University of Melbourne, Melbourne, Victoria 3053, Australia.
Jurnal: International Journal of Production Economics.
Nəşriyyat: Elsevier B.V.
Cild: 295.
Məqalə nömrəsi: 109934.
DOI: 10.1016/j.ijpe.2026.109934
Göndərilmə: 23 iyun 2025.
Reviziya: 12 yanvar 2026.
Qəbul: 19 yanvar 2026.
Onlayn nəşr: 29 yanvar 2026.
Mənbə növü: Resenziyalı, açıq çıxışlı tədqiqat məqaləsi; hesablama/süni intellekt və istehsal optimallaşdırması işi.
Xüsusi buraxılış: Enhancing digital manufacturing via AI-LLM.
Rəsmi nəşr keçidi: https://doi.org/10.1016/j.ijpe.2026.109934
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint statusu: Araşdırılan sənəd yekun International Journal of Production Economics jurnal məqaləsidir; preprint kimi təqdim edilməyib.
Maliyyələşdirmə: Araşdırılan PDF-də ayrıca Funding Statement yoxdur. CRediT bölməsində Pivithuru Thejan Amarasinghe üçün “Funding acquisition” töhfəsi qeyd olunub.
Məlumatların əlçatanlığı: Ayrı Data Availability Statement olmasa da iş məlumat dəstlərini və yaradılan problem formulyasiyalarını açıq GitHub depolarında paylaşır. Mənbədə verilən depolar arasında AI-Copilot-Data, AI-Copilot-Artifacts, AI-Copilot-Data-Real-World-Scenario, AI-Copilot-Artifacts-Real-World-Scenario və düzəldilmiş LPWP məlumat deposu var.
Maraqlar toqquşması: Araşdırılan PDF-də ayrıca Declaration of Competing Interest bəyanı görünmür.
CRediT töhfələri: Pivithuru Thejan Amarasinghe: ilkin mətn, metod, araşdırma, maliyyələşdirmənin əldə edilməsi, məlumat kurasiyası və konseptuallaşdırma. Su Nguyen: ilkin mətn, doğrulama, məsləhət/gözetim, metod, araşdırma və konseptuallaşdırma. Yuan Sun: ilkin mətn, doğrulama, məsləhət/gözetim, resurslar, metod və konseptuallaşdırma. Sobhan (Sean) Arisian: baxış/redaktə, doğrulama, məsləhət/gözetim, resurslar və layihə idarəetməsi. Damminda Alahakoon: baxış/redaktə, doğrulama, məsləhət/gözetim, resurslar və konseptuallaşdırma.
Generativ süni intellekt bəyanatı: ChatGPT işin məlumat yaratma mərhələsində real-dünya istehsal planlaşdırma problem təsvirlərinin müxtəlif maraqlı tərəf perspektivlərindən sintetik variantlarını yaratmaq üçün istifadə olunub. Müəlliflər həmçinin məqalənin bəzi hissələrində dili və oxunaqlılığı yaxşılaşdırmaq üçün ChatGPT istifadə etdiklərini, daha sonra çıxışları özlərinin nəzərdən keçirib redaktə etdiklərini və məzmun üçün məsuliyyəti üzərlərinə götürdüklərini bildiriblər. LPWP problem formulyasiyalarının ilkin yaradılmasında GPT-3.5 istifadə olunub və uyğunsuzluqlar əl ilə nəzərdən keçirilib.
Model kimliyi qeydi: Mənbə mətn təcrübələrdə CodeRL-nin əvvəlcədən öyrədilmiş model kimi istifadə edildiyini bildirsə də, Cədvəl 2 model və tokenizer kimliyini Salesforce/codet5-large-ntp-py kimi verir. CodeRL-nin CodeT5 üzərində qurulduğu izah olunsa da istifadə olunan dəqiq checkpoint fərqi mətndə tam aydınlaşdırılmır; buna görə iki ifadə burada ayrıca saxlanılıb.
Real-dünya məlumat sərhədi: Melburndakı naxış fabrikinin fiziki/maşın quruluşu və əməliyyat qaydaları real müəssisədən götürülüb. Bununla belə ERP məlumatlarına çıxış olmadığı üçün çatdırılma tarixləri təsadüfi təyin olunub, bəzi istehsal miqdarları simulyasiya olunub və maşınlararası daşınma vaxtları nəzərə alınmayıb. Nəticələr tam tarixi ERP replay işi kimi şərh edilməməlidir.
“%30 yaxşılaşma” qeydi: LPWP Cədvəl 5-də təklif olunan framework %72, ən yaxşı Standard və CoE nəticələri isə %43 uğur göstərir. Xam fərq 29 faiz bəndidir. Mənbənin “approximately 30% performance improvement” ifadəsi bu mütləq faiz-bənd fərqi ilə uyğun gəlir; nisbi artım təxminən %67-dir.
Xərc sərhədi: Mənbə kiçik/fine-tuned model yanaşmasını xərc-effektiv kimi təsvir edir; lakin birbaşa pul TCO, ROI və ya real KOBİ əməliyyat xərc müqayisəsi təqdim etmir.
Davamlılıq sərhədi: Məqalənin nəticə bölməsində daha yaxşı istehsal səmərəliliyinin tullantı, enerji istifadəsi və karbon izini azaltma potensialı müzakirə olunur. Bunlar bu işdə birbaşa ölçülmüş ekoloji nəticələr deyil.
Elmi məzmun sərhədi: Bu Verianla məzmunundakı metod, model, formullar, məlumat dəstləri, təlim parametrləri, fabrika halı, uğur nisbətləri və məhdudiyyətlər özgün işə əsaslanır. Xarici mənbələr yalnız biblioqrafik kimlik, nəşr qeydi, resenziya və nəşriyyat məlumatının doğrulanmasında istifadə olunub.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib