

Ön Değerlendirme
Bu yazı, finansal haber başlıklarından piyasa duyarlılığı üretmeye çalışan hibrit bir sistem üzerine hazırlanmıştır. İncelenen çalışma, Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs başlığını taşımaktadır ve arXiv üzerinde ön baskı olarak yayımlanmıştır.
Çalışmanın temel iddiası şudur: Finansal haber duyarlılığı analizi yalnızca “olumlu” veya “olumsuz” kelime saymakla sınırlı kalmamalıdır. Bir haber başlığı gerçekten piyasa üzerinde etki oluşturdu mu, oluşturmadı mı? Sistem bu soruya cevap verebilmek için haber başlıklarını aynı andaki fiyat görüntüleriyle eşleştirir ve daha sonra tahmin sinyallerini gerçekleşen fiyat hareketleriyle karşılaştırarak kendini günceller.
Bu çalışma özellikle ilgi çekicidir çünkü büyük dil modeli veya GPU zorunluluğu olmadan, CPU üzerinde çalışan daha hafif bir piyasa duyarlılığı motoru önerir. Ancak sonuçlar doğrudan al-sat sinyali veya yatırım tavsiyesi olarak okunmamalıdır. Sistem, haber ve fiyat hareketi arasında korelasyon yakalamaya çalışır; fakat haberin fiyat hareketine gerçekten neden olduğunu kesin olarak kanıtlamaz.
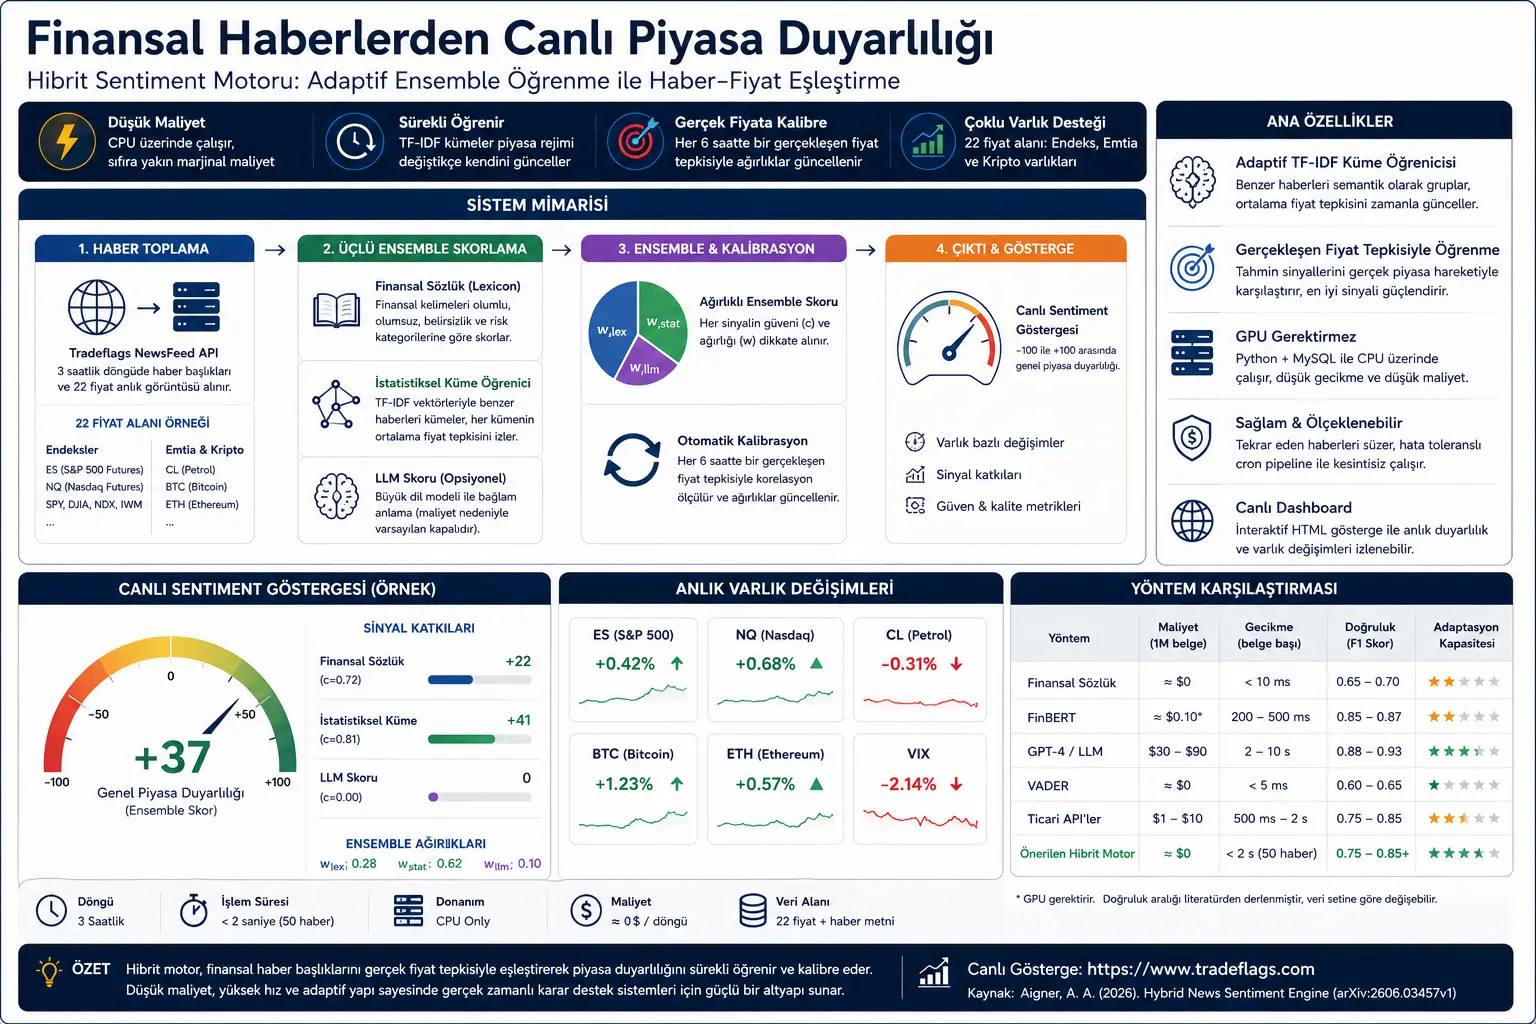
Yeni bir akademik çalışma, finansal haber başlıklarını gerçek zamanlı fiyat hareketleriyle eşleştirerek çalışan hibrit bir piyasa duyarlılığı motoru öneriyor. Sistem; finansal kelime sözlüğü, TF-IDF tabanlı adaptif haber kümeleme ve gerçekleşen fiyat tepkisine göre ağırlık güncelleyen ensemble yapısını birleştiriyor. En dikkat çekici tarafı, GPU veya pahalı büyük dil modeli çağrısı gerektirmeden CPU üzerinde çalışabilmesi ve piyasa rejimi değiştikçe kendini yeniden kalibre edebilmesi.
Problem Ne?
Finansal piyasalar her gün haber başlıkları, şirket açıklamaları, merkez bankası mesajları, ekonomik veriler ve sosyal medya akışlarıyla beslenir. Piyasa katılımcıları bu haberleri yorumlar ve fiyatlar çoğu zaman bu yorumlara göre hareket eder. Ancak bir haberin gerçekten piyasada nasıl karşılık bulduğunu ölçmek kolay değildir.
Klasik duyarlılık analizleri genellikle metni olumlu, olumsuz veya nötr olarak sınıflandırır. Örneğin “büyüme”, “ralli”, “kâr” gibi kelimeler olumlu; “düşüş”, “iflas”, “resesyon” gibi kelimeler olumsuz kabul edilir. Fakat finansal piyasalarda bağlam çok önemlidir. Bir “faiz artışı” bazı dönemlerde olumsuz algılanabilirken, başka bir dönemde ekonominin güçlü olduğuna dair işaret olarak yorumlanabilir.
Büyük dil modelleri bu bağlamı daha iyi yakalayabilir. Ancak GPT sınıfı modellerin maliyeti, gecikmesi ve üretim ortamındaki API bağımlılığı ciddi bir sorun oluşturur. Ayrıca önceden eğitilmiş modeller, piyasa anlatıları değiştiğinde eski kalabilir. Bu çalışmanın çıkış noktası da burasıdır: Daha ucuz, daha hızlı, kendini fiyat tepkisine göre güncelleyebilen bir haber duyarlılığı sistemi kurulabilir mi?
Yöntem Ne Öneriyor?
Çalışmada önerilen sistem üç ana sinyali bir araya getirir.
İlk sinyal, finansal alan için hazırlanmış kelime sözlüğüne dayanır. Bu bölüm, haber başlığındaki olumlu, olumsuz, belirsizlik ve hukuki risk çağrıştıran kelimeleri sayar. Klasik kelime tabanlı yöntemlere benzer; fakat finansal metne özel terimlerle genişletilmiştir.
İkinci sinyal, çalışmanın en özgün tarafıdır. Sistem haber başlıklarını TF-IDF yöntemiyle vektörlere dönüştürür ve benzer başlıkları kümeler. Daha sonra her haber kümesinin geçmişte ortalama nasıl bir fiyat tepkisiyle eşleştiğini takip eder. Örneğin “faiz indirimi beklentisi”, “petrol arz riski” veya “teknoloji hisselerinde yükseliş” gibi benzer başlıklar zamanla aynı semantik mahallede toplanabilir. Bu kümenin fiyat tepkisi değişirse, sistemin duyarlılık yorumu da değişir.
Üçüncü sinyal, isteğe bağlı büyük dil modeli skorudur. Çalışmada LLM sinyali mimaride desteklenir; ancak maliyet nedeniyle varsayılan olarak kapalıdır. Asıl yapı, finansal sözlük ve istatistiksel küme öğrenicisiyle CPU üzerinde çalışabilecek biçimde tasarlanmıştır.
Son aşamada bu sinyaller ensemble yani birleşik skor haline getirilir. Sistem belirli aralıklarla, daha önce üretilen duyarlılık skorlarını gerçekleşen fiyat hareketleriyle karşılaştırır. Hangi sinyal son dönemde daha iyi çalıştıysa, onun ağırlığı artırılır. Böylece sistem, yalnızca metnin dilsel anlamına değil, piyasanın o metne verdiği gerçek tepkiye de uyum sağlamaya çalışır.
Formüller Ne Anlatıyor?
Çalışmadaki formüller, haber başlığından duyarlılık skoru üretme sürecinin nasıl kurulduğunu gösteriyor. Formüller üç ana gruba ayrılabilir: kelime tabanlı skor, TF-IDF kümeleme ve fiyat tepkisine göre ensemble kalibrasyonu.
1. Finansal kelime skoru
İlk formül, haber başlığındaki olumlu ve olumsuz finansal kelimeleri sayarak bir sözlük skoru üretir:
Burada \(P\), olumlu kelime sayısını; \(N\), olumsuz kelime sayısını; \(U\), belirsizlik ifade eden kelime sayısını; \(C\), hukuki veya dava riski çağrıştıran kelime sayısını gösterir. \(|T|\), başlıktaki toplam token yani kelime/parça sayısıdır.
Formülde olumsuz kelimeler \(1.2\) katsayısıyla daha ağır cezalandırılır. Bunun nedeni, finansal piyasalarda kötü haberlerin çoğu zaman eşdeğer iyi haberlere göre daha güçlü fiyat etkisi oluşturabilmesidir. Sonuç \(-1\) ile \(+1\) arasına sıkıştırılır. Böylece skor çok kısa veya aşırı uç haberlerde kontrolsüz büyümez.
2. Sözlük skorunun güveni
Sistemin yalnızca skor üretmesi yeterli değildir; bu skora ne kadar güvenileceği de hesaplanır:
Bu formül, başlıkta finansal sözlükle eşleşen kelime sayısı arttıkça güvenin yükselmesini sağlar. Eğer haber başlığı finansal terim bakımından zayıfsa, sözlük skoru da düşük güvenle ensemble içine girer.
3. TF-IDF: Başlıkları sayısal vektöre çevirme
Sistem, haber başlıklarını yalnızca kelime listesi olarak değil, sayısal vektörler olarak da ele alır. Bunun için TF-IDF kullanılır:
Burada \(TF_i(t)\), \(t\) teriminin ilgili başlıkta ne kadar sık geçtiğini gösterir. \(IDF(t)\) ise o kelimenin tüm başlıklar içinde ne kadar ayırt edici olduğunu ölçer. Çok sık geçen genel kelimeler düşük ağırlık alırken, daha özel ve ayırt edici kelimeler daha yüksek ağırlık alır.
Başlığın vektör gösterimi şu şekilde oluşturulur:
Burada \(V\), sistemin seçtiği kelime dağarcığını ifade eder. Çalışmada en ayırt edici ilk 2000 terimden oluşan bir sözlük kullanıldığı belirtilir.
4. Benzer haberleri kümeye yerleştirme
Sistem, yeni bir haber başlığını daha önce oluşmuş haber kümeleriyle karşılaştırmak için kosinüs benzerliği kullanır:
Burada \(v_i\), yeni haber başlığının TF-IDF vektörüdür. \(\mu_j\), \(C_j\) kümesinin merkez vektörüdür. Benzerlik değeri belirli bir eşik değerini geçerse, haber en yakın kümeye eklenir. Çalışmada bu eşik \(\theta=0.35\) olarak verilmiştir.
Küme merkezi ise o kümeye ait vektörlerin ortalamasıyla temsil edilir:
Bu yapı sayesinde sistem, tüm veriyi baştan eğitmeden yeni haberleri mevcut kümelere ekleyebilir. Eğer haber mevcut kümelere yeterince benzemiyorsa, yeni bir küme oluşturulur.
5. Kümelerin fiyat tepkisini öğrenmesi
Her haber kümesi, geçmişte o kümeye giren haberlerin ortalama fiyat tepkisini tutar:
Burada \(ES_j\), ilgili haber kümesinin S&P 500 vadeli işlem tarafındaki ortalama fiyat tepkisini; \(NQ_j\) ise Nasdaq vadeli işlem tarafındaki ortalama fiyat tepkisini ifade eder. Çalışmada sistemin farklı varlık sınıfları için çoklu fiyat alanlarını takip edebildiği belirtilir.
6. İstatistiksel duyarlılık skoru
Yeni bir haber başlığı bir kümeyle eşleşirse, o kümenin geçmiş fiyat tepkisi istatistiksel duyarlılık skoru olarak kullanılır:
Bu formül, haberin en iyi eşleştiği kümenin geçmişteki ortalama ES tepkisini \(-1\) ile \(+1\) aralığına dönüştürür. Eğer haber hiçbir kümeye yeterince benzemiyorsa, istatistiksel skor nötr kabul edilir.
7. Küme kalitesi: Sharpe benzeri ölçü
Çalışmada her kümenin güvenilirliğini ölçmek için Sharpe benzeri bir kalite metriği de kullanılır:
Bu formül, bir kümenin ortalama fiyat tepkisini o tepkilerin oynaklığına böler. Eğer bir küme tutarlı şekilde aynı yönde fiyat tepkisi üretiyorsa, değeri daha anlamlı hale gelir. Gürültülü kümeler ise ensemble içinde daha az önem kazanır veya budanır.
8. Ensemble skoru: Üç sinyali birleştirme
Sistemin nihai duyarlılık skoru, farklı sinyallerin ağırlıklı birleşimidir:
Burada \(s_{lex}\), kelime tabanlı skoru; \(s_{stat}\), istatistiksel küme skorunu; \(s_{llm}\), isteğe bağlı büyük dil modeli skorunu ifade eder. \(w\) değerleri sinyal ağırlıklarıdır, \(c\) değerleri ise her sinyalin güven katsayısıdır.
Bu yapı sayesinde sistem yalnızca bir yönteme bağlı kalmaz. Kimi dönemde sözlük sinyali daha iyi çalışabilir, kimi dönemde istatistiksel küme sinyali daha anlamlı hale gelebilir.
9. Gerçekleşen fiyat tepkisiyle kalibrasyon
Sistem, haber geldikten sonra gerçekleşen fiyat hareketini hesaplayarak sinyalleri kontrol eder:
Burada \(ES_{snapshot}\), haber geldiği andaki ES fiyatını; \(ES_{current}\), kalibrasyon anındaki ES fiyatını ifade eder. Bu değer, haberden sonra piyasanın hangi yönde hareket ettiğine dair yaklaşık bir gözlem sağlar.
10. Ağırlıkların kendini güncellemesi
Her sinyalin son dönemde gerçekleşen fiyat hareketiyle ne kadar uyumlu olduğu Spearman korelasyonu ile ölçülür. Ardından ağırlıklar güncellenir:
Burada \(\rho_k\), ilgili sinyalin gerçekleşen fiyat hareketiyle olan korelasyonunu ifade eder. Formülde \(0.05\) taban değeri kullanılması, hiçbir sinyalin tamamen sistem dışına atılmamasını sağlar. Böylece model çeşitlilik payını korur.
11. Sinyal-gürültü oranı
Çalışmada ensemble skorunun gerçekleşen hareketleri ne kadar açıkladığını özetleyen basit bir sinyal-gürültü ölçüsü de verilir:
Bu değer, ensemble skorunun gerçekleşen fiyat hareketindeki varyansın ne kadarını açıklayabildiğine dair yaklaşık bir fikir verir.
Grafik, Tablo ve Şema Ana Mesajı
Çalışmadaki mimari şema, sistemi üç aşamalı bir veri hattı olarak anlatır: haberleri içeri al, skorla, sonra gerçekleşen fiyat tepkisine göre kalibre et. Bu yapı, klasik duyarlılık analizinden farklıdır. Çünkü sistem yalnızca haberin “dilsel tonunu” değil, haberden sonra piyasanın ne yaptığını da izler.
Canlı gösterge şeması ise kullanıcının göreceği çıktıyı basitleştirir. Ana göstergede genel piyasa duyarlılığı \(-100\) ile \(+100\) arasında gösterilir. Ayrıca kelime tabanlı skor, istatistiksel küme skoru ve LLM skoru ayrı ayrı sunulur. ES, Nasdaq, petrol ve Bitcoin gibi varlıkların anlık yüzdesel değişimleri de göstergeye eklenir.
Karşılaştırma tablosunun ana mesajı ise maliyet, gecikme ve uyum yeteneği arasındaki farktır. Çalışmaya göre FinBERT ve LLM tabanlı yaklaşımlar daha güçlü dil anlama kapasitesine sahip olabilir; fakat GPU, API maliyeti veya daha yüksek gecikme gerektirebilir. Önerilen sistem ise daha hafif, daha ucuz ve piyasa tepkisine göre kendini güncelleyebilen bir alternatif olarak konumlandırılır.
Deneyler Nasıl Yapılmış?
Sistem, Tradeflags NewsFeed API üzerinden gelen haber başlıklarını ve aynı anda kaydedilen fiyat anlık görüntülerini kullanır. Her haber öğesinde başlık, kaynak, açıklama, bağlantı ve yayın zamanı gibi metinsel alanların yanında; ES, NQ, SPY, DJIA, IWM, petrol, Bitcoin ve Ethereum gibi varlıklara ait fiyat ve yüzde değişim alanları yer alır.
Veri hattı üç saatlik döngülerle çalışacak şekilde tasarlanmıştır. İlk adımda haberler alınır ve tekrar eden başlıklar ayıklanır. İkinci adımda haberler kelime sözlüğü, istatistiksel küme ve isteğe bağlı LLM yöntemiyle skorlanır. Üçüncü adımda sistem belirli aralıklarla geçmiş skorları gerçekleşen fiyat hareketleriyle karşılaştırır ve ensemble ağırlıklarını günceller.
Çalışmada kullanılan yazılım yığını oldukça hafiftir. Python, MySQL ve birkaç temel paketle çalışır. Derin öğrenme kütüphanesi, GPU veya büyük model indirme zorunluluğu yoktur. Bu da sistemi küçük sunucularda çalıştırılabilir hale getirir.
Sonuçlar Ne Gösteriyor?
Çalışmanın sonuçları, önerilen sistemin üç temel avantajını öne çıkarır: düşük maliyet, hızlı çalışma ve adaptasyon kabiliyeti.
Sistem, 50 haberlik bir toplu işlemde iki saniyenin altında çalışacak şekilde tasarlanmıştır. Kelime tabanlı skorlayıcı başlık başına milisaniyenin altında çalışır. TF-IDF vektörleştirme ve küme araması da CPU üzerinde düşük gecikmeyle tamamlanır.
Çalışma, GPT-4 gibi büyük dil modeli tabanlı yöntemlerin daha yüksek doğruluk potansiyeline sahip olabileceğini kabul eder. Fakat bu yöntemlerin maliyet ve gecikme açısından üretim ortamında her zaman uygun olmayabileceğini vurgular. Önerilen sistemin amacı, en güçlü dil modelini yenmekten çok, gerçek zamanlı ve düşük maliyetli bir piyasa duyarlılığı altyapısı kurmaktır.
En önemli katkı, adaptif TF-IDF küme öğrenicisidir. Sistem, benzer haber başlıklarını aynı semantik mahallede toplar ve bu mahallelerin ortalama fiyat tepkisini zaman içinde günceller. Piyasa rejimi değiştikçe, örneğin “faiz artışı” gibi bir ifadenin fiyat etkisi farklılaşırsa, kümenin ortalama fiyat tepkisi de kademeli olarak değişir.
Bu Neden Önemli?
Finansal haber analizi, yalnızca metin sınıflandırma problemi değildir. Piyasa açısından asıl önemli soru şudur: Bu haber gerçekten fiyatlarda bir hareketle ilişkili mi?
Bu çalışma, finansal duyarlılık analizini piyasa gerçekleşmeleriyle bağlamaya çalıştığı için önemlidir. Bir başlık dilsel olarak olumlu görünse bile piyasa tepki vermediyse, bu sinyal işlem açısından zayıf olabilir. Tersine, dilsel olarak nötr görünen bazı başlıklar belirli piyasa koşullarında güçlü fiyat tepkisi doğurabilir.
Bu yaklaşım özellikle haber tabanlı karar destek sistemleri, piyasa panelleri, finansal veri platformları ve düşük maliyetli analiz araçları için değerlidir. Büyük modellerin pahalı olduğu ortamlarda, hafif ama kendini kalibre edebilen istatistiksel sistemler pratik bir alternatif sunabilir.
Dikkat Noktaları
Çalışma ön baskı niteliğindedir. Bu nedenle sonuçların bağımsız doğrulama ve daha geniş veri setleriyle desteklenmesi gerekir.
Sistem, haber ile fiyat hareketi arasında korelasyon yakalar; fakat nedensellik kanıtlamaz. Bir fiyat hareketi haberden dolayı olmuş olabilir, ancak aynı zaman aralığında başka bir piyasa olayı da etkili olmuş olabilir.
Gerçekleşen fiyat hareketi ölçümü yaklaşık bir yöntemle yapılmıştır. Çalışmada bu durum açıkça sınırlılık olarak belirtilir. Daha kesin sonuçlar için 1 dakika, 5 dakika veya 15 dakika ileriye dönük hassas tick verisi gerekir.
İstatistiksel küme öğrenicisi soğuk başlangıç problemi yaşar. Yeterli sayıda haber birikmeden küme merkezleri ve ortalama fiyat tepkileri güvenilir hale gelmeyebilir.
Sistem şu haliyle İngilizce finansal haberler için tasarlanmıştır. Türkçe haberlerde benzer performans beklemek için Türkçe finansal sözlük, Türkçe tokenizasyon ve ayrı kalibrasyon gerekir.
Bu yazı yatırım tavsiyesi değildir. Haber duyarlılığı skorları tek başına işlem kararı vermek için yeterli değildir.
Sonuç
Bu çalışma, finansal haber duyarlılığı analizinde pahalı ve ağır modeller dışında da uygulanabilir yollar olduğunu gösteriyor. Önerilen sistem; finansal kelime sözlüğünü, adaptif TF-IDF küme öğrenmesini ve gerçekleşen fiyat tepkisine göre ensemble kalibrasyonunu birleştiriyor.
En dikkat çekici fikir, duyarlılık analizinin yalnızca metnin dilsel anlamıyla sınırlı kalmaması. Sistem, haber başlıklarını piyasanın gerçek tepkisiyle eşleştirerek “bu tür haberler geçmişte nasıl fiyatlanmıştı?” sorusuna cevap arıyor.
Verianla açısından bu çalışmanın ana mesajı şudur: Finansal yapay zekâ her zaman devasa modeller ve yüksek maliyetli altyapılar gerektirmek zorunda değildir. Doğru tasarlanmış hafif istatistiksel yöntemler, özellikle canlı veri akışında ve düşük maliyetli sistemlerde güçlü bir karar destek katmanı oluşturabilir.
Kaynak ve Yöntem Notu
Bu içerik, Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs başlıklı akademik PDF incelenerek hazırlanmıştır. Metin birebir çeviri değildir. Çalışmanın amacı, yöntemi, temel formülleri, sistem mimarisi, bulguları ve sınırlılıkları Verianla okurları için sadeleştirilmiş, özgün ve editoryal Türkçe ile yeniden anlatılmıştır.
Formüller, çalışmadaki temel matematiksel yapıya sadık kalınarak MathJax uyumlu LaTeX formatında verilmiştir. Yazı yatırım tavsiyesi, al-sat önerisi veya canlı işlem sistemi önerisi değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir