

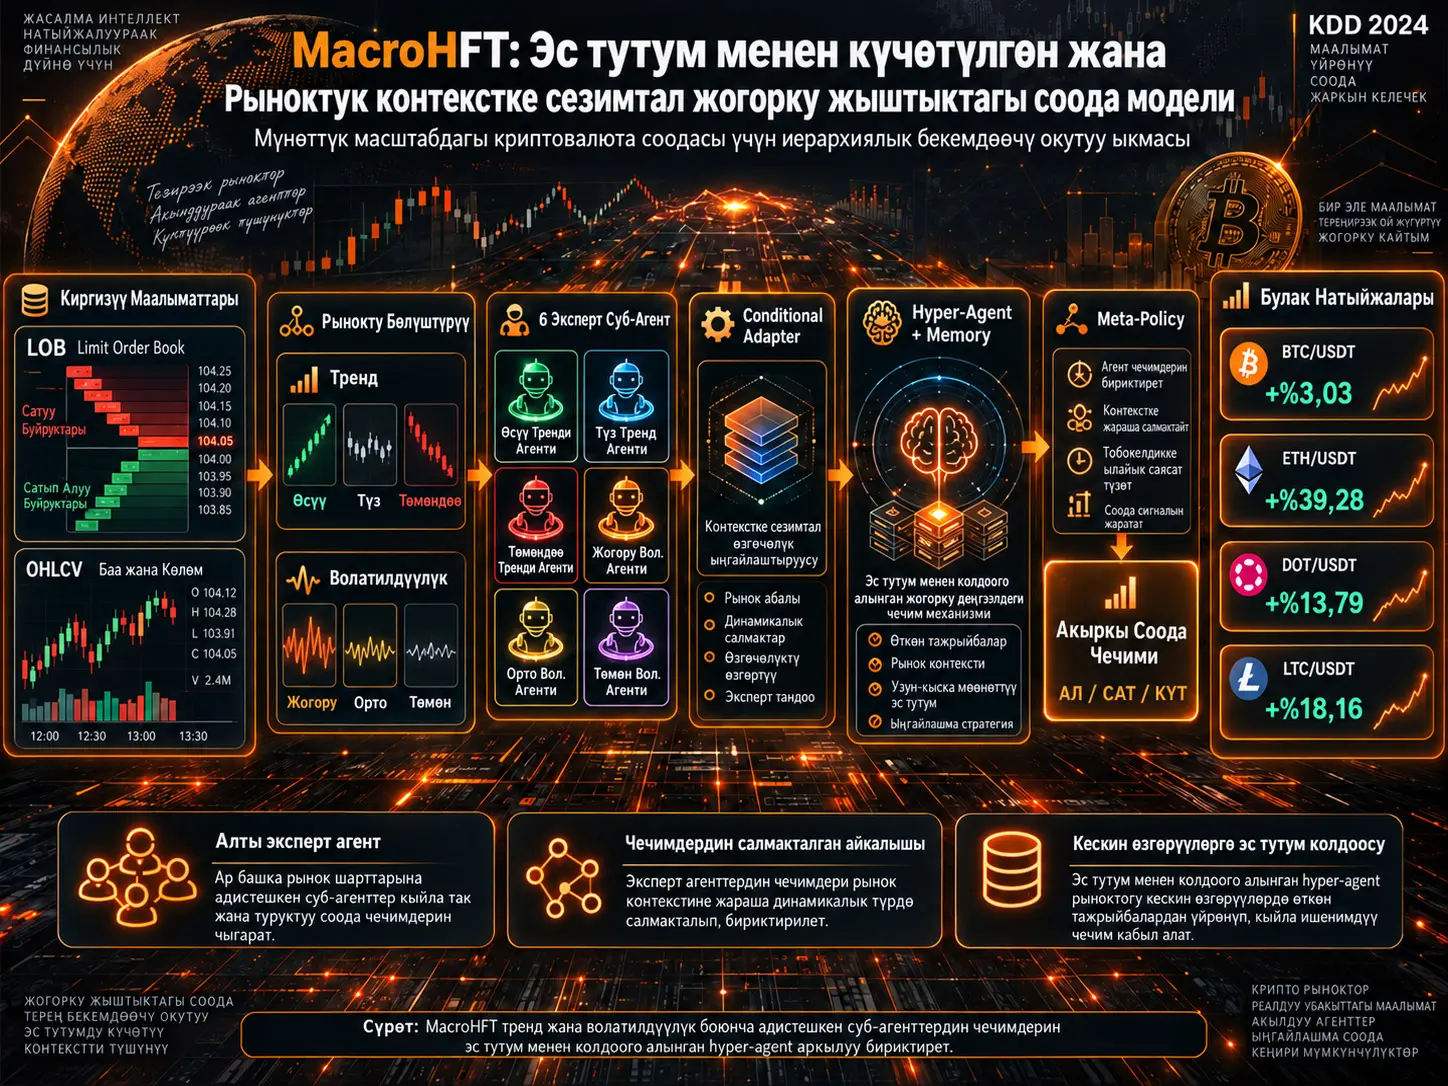
MacroHFT — мүнөттүк масштабдагы криптовалюта соодасында өзгөрүп турган рынок шарттарына ыңгайлашуу үчүн иштелип чыккан, эс тутум менен колдоого алынган жана контекстке сезгич иерархиялык бекемдөө аркылуу үйрөнүү системасы. Chuqiao Zong, Chaojie Wang, Molei Qin, Lei Feng, Xinrun Wang жана Bo An тарабынан иштелип чыккан ыкма бир trading агент бардык рынок режимдерин үйрөнүшүн күтүүнүн ордуна ар кандай тренд жана волатилдүүлүк шарттарына адистешкен sub-agentтерди түзүп, алардын чечимдерин hyper-agent аркылуу бириктирет.
Изилдөөнүн негизги көйгөйү — крипто рыногунун стационардуу эместиги. Бир эле trading policy өсүп жаткан, төмөндөп жаткан, каптал багыттагы, жогорку волатилдүү же төмөн волатилдүү рыноктордо бирдей натыйжа бербеши мүмкүн. Стандарттуу RL агенттери айрым көрсөткүчтөргө ашыкча ылайыкташып, жакынкы рынок контекстин жетиштүү пайдалана албай калышы да мүмкүн. MacroHFT бул көйгөйлөрдү market decomposition, conditional adaptation, policy mixture жана episodic memory деген төрт бири-бирин толуктоочу механизм аркылуу чечет.
Биринчи этапта мүнөттүк маалыматтар тренд жана волатилдүүлүк көрсөткүчтөрүнө жараша алты башка топко бөлүнөт: Bull, Medium Trend, Bear, Volatile, Medium Volatility жана Stable. Ар бир маалымат тобунда өзүнчө DDQN негизиндеги sub-agent үйрөтүлөт. Ар бир sub-agent учурдагы рынок контекстин жана учурдагы позиция тууралуу маалыматты conditional adapter аркылуу колдонуп, өзүнүн ички абалдык өкүлчүлүгүн масштабдап жана жылдыра алат.
Экинчи этапта hyper-agent бул алты эксперт агенттин бирөөсүн гана тандабайт. Ар бир sub-agentтин Q-маанилерине softmax салмагын берип, аларды бириктирип бирдиктүү meta-policy түзөт. Ошентип система ар түрдүү эксперттердин баалоолорун бир убакта пайдалана алат. Hyper-agent ошондой эле акыркы рыноктук тажрыйбаларды сактаган memory module колдонуп, жакынкы өткөндөгү окшош рынок абалдарынан пайдаланууну көздөйт.
BTC/USDT, ETH/USDT, DOT/USDT жана LTC/USDT боюнча жүргүзүлгөн тарыхый симуляцияларда MacroHFT тиешелүүлүгүнө жараша %3,03, %39,28, %13,79 жана %18,16 Total Return билдирген. Изилдөөнүн 1-таблицасында система төрт маалымат топтомунун баарында салыштырылган ыкмаларга караганда жогорку Total Return көрсөткөн; тобокелдикке ылайыкташтырылган метрикалардын көпчүлүгүндө да күчтүү натыйжаларды берген.
Бирок бул натыйжалар жандуу exchange deployment эмес. Система мүнөт деңгээлинде чечим кабыл алат, транзакция чыгымы туруктуу %0,02 катары моделденет, ал эми чыныгы network latency, exchange queue priority, market impact жана операциялык HFT инфраструктурасы эксперименттик түрдө өлчөнбөйт.
MacroHFT Эмне Үчүн Бир RL Агенттин Ордуна Бир Нече Экспертти Колдонот?
Криптовалюта рыноктору баа багыты жана волатилдүүлүк жагынан тез өзгөрүшү мүмкүн. Узун убакыт катарында өсүү, төмөндөө, каптал кыймыл, жогорку волатилдүүлүк жана төмөн волатилдүүлүк мезгилдери кезектешип болушу мүмкүн. Бир RL агенттин бул жүрүм-турумдардын баарын бир policy ичинде үйрөнүшү overfitting жана policy bias көйгөйлөрүнө алып келиши мүмкүн.
Ошондуктан MacroHFT алгач рынокту ар түрдүү динамикаларга бөлөт. Булак эки негизги критерийди колдонот:
- Тренд: баанын убакыт катарысына low-pass filter колдонулгандан кийинки сызыктуу регрессиянын эңкейиши.
- Волатилдүүлүк: тиешелүү маалымат бөлүгүндөгү баанын орточо өзгөрмөлүүлүгү.
Ар бир убакыт катарынын бөлүгү адегенде туруктуу узундуктагы chunk'тарга бөлүнөт. Тренд маанилеринин quantile бөлүштүрүлүшү аркылуу үч топ түзүлөт:
- Bull — оң тренд,
- Medium — болжол менен каптал тренд,
- Bear — терс тренд.
Өзүнчө волатилдүүлүктүн quantile маанилери боюнча:
- Volatile — жогорку волатилдүүлүк,
- Medium — орточо волатилдүүлүк,
- Stable — төмөн волатилдүүлүк
топтору түзүлөт.
Бул жерде маанилүү жагдай — изилдөө тренд жана волатилдүүлүк белгилеринин кайчылаш айкалыштарынан тогуз агент түзбөйт. Үч тренд жана үч волатилдүүлүк тобу өзүнчө маалыматтык ички топтомдор катары колдонулуп, жалпы алты sub-agent үйрөтүлөт.
Conditional Adapter Эмне Кылат?
Conditional adapter — sub-agentтин trading policy'син учурдагы баа жана order-book абалына гана эмес, жакынкы мезгилдеги рынок контекстине жана учурдагы позицияга жараша өзгөрткөн механизм.
Low-level state үч компоненттен турат:
Бул жерде:
- \(s_{lt}^{1}\): учурдагы LOB жана OHLCV snapshot'ынан алынган single-state белгилери,
- \(s_{lt}^{2}\): акыркы 60 убакыт кадамындагы рынок маалыматынан алынган context белгилери,
- \(P_t\): трейдердин учурдагы позициясы.
Single-state жана context маалыматы өзүнчө neural layer'ларда берилет. Учурдагы позиция да embedding'ге айландырылат:
Бул жердеги \(c\) — рынок контексти менен учурдагы holding абалынын бириктирилген conditional representation'ы.
Conditional representation эки вектор түзөт:
жана state representation масштабдалып, жылдырылат:
Булак бул дизайн Diffusion Transformer'деги Adaptive Layer Norm идеясынан шыктанганын белгилейт.
Негизги максат — мисалы, бир эле баа кыймылы трейдердин позицияда бар же жок болушуна же жакынкы тренд/волатилдүүлүк режимине жараша башка Q-маани жаратышын жеңилдетүү.
Low-Level DDQN Агенттери Кантип Үйрөтүлөт?
Ар бир sub-agentтин негизи Double Deep Q-Network (DDQN) жана dueling-network архитектурасы болуп саналат.
Dueling түзүмү Q-маанини state value жана action advantage болуп бөлөт:
Training loss стандарттуу TD error менен гана чектелбейт. EarnHFT изилдөөсүндө колдонулган Optimal Value Supervisor да кошулган:
Бул жердеги \(Q^*\) — берилген абалда динамикалык программалоо аркылуу эсептелген оптималдуу Q-маани. Ошентип sub-agent өзүнүн изилдөө тажрыйбасынан гана эмес, эсептелген оптималдуу action-value маалыматынан да багыт алат.
MacroHFT менен EarnHFT Ортосундагы Негизги Айырма Эмне?
EarnHFT ар башка рынок тренддеринде үйрөтүлгөн agent pool түзөт жана router учурдагы рынок шартына жараша алардын ичинен бир агентти тандайт. MacroHFT болсо эки маанилүү өзгөртүү киргизет.
Биринчиден, рынок тренд боюнча гана эмес, тренд + волатилдүүлүк боюнча бөлүнөт.
Экинчиден жана андан да маанилүүсү, hyper-agent sub-agentтердин бирин тандоонун ордуна бардык sub-agentтердин Q-маанилерине салмак берет:
MacroHFT'де \(N=6\).
Final action:
аркылуу аныкталат.
Ошондуктан MacroHFT'деги meta-policy “agent selector” эмес, policy mixture түзүмү.
Эмне Үчүн Hyper-Agentке Эс Тутум Кошулат?
Крипто рыногунда окшош көрүнгөн эки абалдын кыска мөөнөттүү натыйжасы абдан айырмаланышы мүмкүн. Мындан тышкары, crash, тез rebound же breakout сыяктуу сейрек кыймылдар стандарттуу replay buffer ичинде аз чагылдырылышы мүмкүн.
MacroHFT бул үчүн сыйымдуулугу чектелген таблицага негизделген episodic memory аныктайт:
Бул жерде:
- \(K\): state encoder түзгөн key векторлору,
- \(E\): state-action experience жуптары,
- \(V\): тажрыйбалардын эсептелген маанилери.
Жаңы тажрыйба келгенде:
түзүлүп, \((k,(s,a),v)\) memory'ге жазылат.
Эс тутум максималдуу сыйымдуулукка жеткенде FIFO ыкмасы колдонулат; эң эски жазуу өчүрүлөт. Бул дизайн рыноктун жакынкы өткөнү учурдагы чечим үчүн баалуураак деген божомолго негизделет.
Hyper-agent учурдагы state'ке эң жакын \(m\) тажрыйбаны L2 аралыгы аркылуу издейт:
жана алардан memory Q-target түзөт:
Бул маани hyper-agentтин стандарттуу RL target'ына кошумча supervision катары кирет:
Булактын тексти жакын жана окшош тажрыйбалар натыйжалуураак пайдаланыларын билдирет. Бирок басылган Теңдеме (7)де attention салмагы L2 аралыгына түз пропорционалдай көрүнүшү математикалык белгилөөдөгү бүдөмүктүктү жаратат; булак бул жагдайды өзүнчө түшүндүрбөйт.
Limit Order Book жана Техникалык Кириштер Кантип Колдонулат?
Булак беш деңгээлдүү Limit Order Book колдонот:
Ар бир деңгээлде bid/ask баасы жана жеткиликтүү көлөм бар.
Мындан тышкары OHLCV маалыматы:
колдонулат.
Кошумча 4-таблицада көптөгөн техникалык белгилер аныкталат. Алардын арасында:
- candle body жана wick өлчөмдөрү,
- беш bid/ask деңгээлинин нормалдаштырылган көлөмдөрү,
- weighted average prices,
- buy/sell spreads,
- buy/sell volume,
- volume imbalance,
- price spread,
- VWAP өлчөмдөрү,
- bid/ask log returns,
- WAP log returns,
- 60 убакыт кадамдуу rolling trend features
камтылган.
Мисалы, volume imbalance:
жана price spread:
түрүндө аныкталат.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Маалымат топтомдору
| Рынок | Training | Validation | Test |
|---|---|---|---|
| BTC/USDT | 05.03.2022 – 22.02.2023 | 18.03.2023 – 15.06.2023 | 22.06.2023 – 15.10.2023 |
| ETH/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
| DOT/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
| LTC/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
BTC маалыматтарын бөлүүдө training, validation жана test мезгилдеринин ортосунда булак таблицасында бош убакыт аралыктары бар; Verianla аларды автоматтык түрдө толтурган эмес.
Trading setup
Эксперименттер 4 даана NVIDIA RTX 4090 GPUда жүргүзүлгөн.
Transaction commission:
деп белгиленип, булак мунун Binance саясатына шайкеш экенин көрсөткөн.
Training chunk узундуктары:
- BTC/USDT: 360 мүнөт = 6 саат,
- ETH/USDT, DOT/USDT жана LTC/USDT: 4320 мүнөт = 3 күн.
Ар бир sub-agent 15 epoch; hyper-agent да 15 epoch үйрөтүлгөн.
Бардык neural-network параметрлеринде Adam optimizer жана:
колдонулган.
Sub-agent optimal supervisor коэффициенти:
боюнча validation натыйжалуулугуна карап тандалган.
Hyper-agent үчүн:
жана memory-loss коэффициенти:
катары сыналган. DOT/USDT үчүн \(\beta=1\), калган үч рынок үчүн \(\beta=5\) тандалган.
Салыштырылган ыкмалар
MacroHFT сегиз baseline менен салыштырылган:
- DQN,
- DDQN,
- PPO,
- CDQNRP,
- CLSTM-PPO,
- EarnHFT,
- Imbalance Volume (IV),
- MACD.
Баалоо көрсөткүчтөрү
Алты финансылык метрика колдонулган:
- Total Return (TR),
- Annual Sharpe Ratio (ASR),
- Annual Calmar Ratio (ACR),
- Annual Sortino Ratio (ASoR),
- Annual Volatility (AVOL),
- Maximum Drawdown (MDD).
Total Return:
Annual Volatility мүнөттүк return'дарды жылына 525.600 мүнөт деген божомол менен annualize кылууга негизделет:
Annual Sharpe Ratio:
Негизги натыйжалуулук жыйынтыктары
| Рынок | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) | Trading Number |
|---|---|---|---|---|---|---|---|
| BTC/USDT | 3,03 | 0,61 | 2,06 | 0,34 | 18,19 | 5,41 | 19 |
| ETH/USDT | 39,28 | 3,89 | 8,41 | 2,49 | 20,93 | 9,67 | 20 |
| DOT/USDT | 13,79 | 0,97 | 2,45 | 0,68 | 40,31 | 15,89 | 38 |
| LTC/USDT | 18,16 | 1,50 | 3,11 | 0,66 | 29,59 | 14,24 | 138 |
Булактын 1-таблицасы жана 3-сүрөтүнө ылайык, MacroHFT төрт рыноктун баарында эң жогорку Total Return маанисин көрсөткөн.
BTC/USDT
MacroHFT %3,03 киреше бергенде, булакта салыштырылган бардык baseline'дардын BTC жыйынтыктары терс болгон. Мисалы, CDQNRP −%1,51, PPO −%9,15, EarnHFT −%11,16 жана MACD −%18,99 киреше билдирген.
Ошол эле учурда айрым терс-return моделдер төмөнүрөөк AVOL же MDD көрсөткөн. Демек, MacroHFT'нин жогорку киреше натыйжасы “бардык тобокелдик өлчөмдөрүндө эң төмөн тобокелдик” дегенди билдирбейт.
ETH/USDT
MacroHFT:
деп билдирген.
Ошол эле тестте EarnHFT %18,02, IV %0,56 жана PPO −%2,12 киреше берген.
MacroHFT ошондой эле:
маанилерин билдирет.
DOT/USDT
MacroHFT %13,79 Total Return берген. IV %10,58 менен оң киреше түзгөн дагы бир күчтүү ыкма; EarnHFT −%2,67 жана MACD −%20,29.
LTC/USDT
MacroHFT %18,16 киреше берген. IV %7,75, EarnHFT %0,54; MACD болсо −%13,16.
Hyper-Agent Чындап Ар Түрдүү Эксперттерди Аралаштырабы?
Булактын 5-сүрөтү BTC/USDT тестинде hyper-agent убакыт ичинде алты башка sub-agentке берген салмактарды көрсөтөт. Салмактар туруктуу эмес; рынок контексти өзгөргөн сайын үстөм эксперт да өзгөрөт.
Бул сүрөт MacroHFT training учурунда гана ар башка агенттерди түзбөстөн, inference учурунда да рынок шартына жараша эксперттердин contribution'ын тынымсыз өзгөртөрүн көрсөтөт.
Conditional Adapter жана Memory Чындап Керекпи?
Ablation тесттери эки негизги компоненттин таасирин өз-өзүнчө баалайт:
- w/o-CA: conditional adapter алынып салынган MacroHFT,
- w/o-MEM: memory механизми алынып салынган MacroHFT.
| Рынок | Модель | TR (%) | ASR | MDD (%) |
|---|---|---|---|---|
| BTC | w/o-CA | 1,69 | 0,36 | 7,24 |
| BTC | w/o-MEM | 2,03 | 0,49 | 6,49 |
| BTC | MacroHFT | 3,03 | 0,61 | 5,41 |
| ETH | w/o-CA | 14,27 | 2,42 | 7,57 |
| ETH | w/o-MEM | 12,73 | 1,26 | 20,87 |
| ETH | MacroHFT | 39,28 | 3,89 | 9,67 |
| DOT | w/o-CA | -16,79 | -1,18 | 31,66 |
| DOT | w/o-MEM | 2,41 | 0,34 | 27,23 |
| DOT | MacroHFT | 13,79 | 0,97 | 15,89 |
| LTC | w/o-CA | -6,71 | -0,36 | 18,83 |
| LTC | w/o-MEM | -8,66 | -0,58 | 22,03 |
| LTC | MacroHFT | 18,16 | 1,50 | 14,24 |
Эң чоң айырмалар DOT жана LTC рынокторунда байкалат. Булак бул тест мезгилдеринде рынок баасы DOT үчүн болжол менен %14,85 жана LTC үчүн болжол менен %24,94 төмөндөгөнүн билдирет.
LTC'де толук MacroHFT %18,16 киреше бергенде conditional adapter алынып салынганда −%6,71, memory алынып салынганда −%8,66 киреше алынган.
ETH'те MacroHFT %39,28 киреше бергенде w/o-CA %14,27 жана w/o-MEM %12,73 болгон. Бирок MDD жагынан w/o-CA %7,57 болуп, толук MacroHFT'нин %9,67 маанисинен төмөн. Демек, ablation жыйынтыгы да бардык тобокелдик көрсөткүчтөрүндө толук артыкчылыкты көрсөтпөйт.
Memory Механизми Күтүүсүз Рынок Кыймылдарында Эмне Берет?
Булактын 6-сүрөтүндө ETH рыногунда memory алынып салынганда модель баанын күтүүсүз түшүшүнө жетиштүү тез жооп бере албай, олуттуу жоготуу пайда болот. Conditional adapter алынып салынганда болсо модель рынок flat/bear шартынан bull шартына өткөндө trading policy'син жетиштүү өзгөртө албай, өсүү мүмкүнчүлүгүн колдон чыгарат.
Авторлор бул байкоолорду memory күтүүсүз жана сейрек баа кыймылдарында, ал эми conditional adapter режим өзгөрүүлөрүндө маанилүү экенин көрсөткөн жүрүм-турумдук далил катары чечмелешет.
Булакта Көрсөтүлгөн Trading Мисалдары Эмнени Түшүндүрөт?
Булактын 4-сүрөтүндө төрт мисал көрсөтүлгөн.
ETH
Авторлор моделди кыска мөөнөттүү өсүүдө “breakout” мүмкүнчүлүгүн кармаган стратегия катары чечмелешет. Позиция кыска кыймылдын ичинде ачылып-жабылат.
DOT
MacroHFT узакка созулган өсүү бөлүгүндө позициясын сактап, trend-following жүрүм-турумун көрсөтөт жана андан кийин позициядан чыгат.
LTC
Баанын кулашында stop-loss сыяктуу чыгуу жүрүм-туруму, андан кийин rebound учурунда жаңы кирешелүү позициянын мисалы көрсөтүлөт.
BTC
Жалпы төмөндөө багытындагы рыноктун ичинде майда өсүүлөрдү пайдаланууга аракет кылган операциялар көрсөтүлөт.
Бул төрт мисал ыкманын formal trading rules'у эмес. Алар авторлордун модель жараткан trading жүрүм-турумуна берген ex-post түшүндүрмөлөрү.
Изилдөө Колдогон Жыйынтыктар
- Тренд менен волатилдүүлүктү өзүнчө критерий катары колдонуп эксперт sub-agentтерди үйрөтүү сыналган крипто рынокторунда иштеген иерархиялык RL түзүмүн жараткан.
- Conditional adapter учурдагы рынок контексти менен позициянын low-level Q-policy'ге түз таасирин күчөтөт.
- Бир экспертти тандоонун ордуна алты sub-agentтин Q-маанилерин аралаштырган hyper-agent сыналган маалымат топтомдорунда күчтүү натыйжаларды берген.
- Memory механизмин алып салуу, айрыкча күтүүсүз рынок кыймылдары болгон айрым тесттерде, натыйжалуулукту байкаларлык төмөндөткөн.
- Conditional adapter'ди алып салуу режим өзгөрүүлөрүнө ыңгайлашууну алсыраткан.
- MacroHFT төрт тест маалымат топтомунун баарында оң Total Return берип, булактын 1-таблицасындагы бардык baseline'дардан жогорку Total Return билдирген.
- DOT жана LTC сыяктуу тест мезгилинде жалпы рынок баасы кескин түшкөн маалымат топтомдорунда да модель оң киреше берген.
- EarnHFT'деги single-agent routing ордуна policy mixture колдонуу бул изилдөөнүн борбордук архитектуралык айырмачылыктарынын бири.
Изилдөө Колдобогон Жалпылоолор
- MacroHFT жандуу Binance же башка exchange'де ушундай эле кирешелерди берери көрсөтүлгөн эмес.
- %39,28 ETH же %18,16 LTC кирешеси келечекте кайталанары көрсөтүлгөн эмес.
- Модель классикалык ultra-low-latency HFT системаларынын microsecond же nanosecond execution убактысын өлчөбөйт.
- Чыныгы exchange queue priority, network jitter, packet loss, API throttling же co-location артыкчылыгы эксперименттик түрдө моделденген эмес.
- Market impact чоң позицияларда жыйынтыктарды кандай өзгөртөрү кеңири сыналган эмес.
- Жалаң long-position түзүмү чыныгы HFT стратегияларынын баарын билдирбейт.
- Төрт криптовалютада алынган натыйжаларды бардык token, exchange же рынок мезгилдерине жалпылоого болбойт.
- Conditional adapter же memory компоненттери өз алдынча ар бир trading алгоритмде бирдей өлчөмдө натыйжалуулук өсүшүн берери көрсөтүлгөн эмес.
Негизги Методологиялык Чектөөлөр
Биринчиден, модель \(P_t\geq0\) позицияларга гана уруксат берет; башкача айтканда, short-selling түзүмү жок. Бул чыныгы крипто HFT системаларынын стратегия мейкиндигине салыштырмалуу маанилүү жөнөкөйлөтүү.
Экинчиден, транзакция чыгымы төрт рыноктун баарында туруктуу %0,02 деп кабыл алынат. Чыныгы trading fee, spread жана execution cost trader tier, exchange, order түрү жана рынок шартына жараша өзгөрүшү мүмкүн.
Үчүнчүдөн, trading interval бир мүнөт. Бул чечим кабыл алуунун жогорку жыштыгын бере алат, бирок классикалык market-microstructure HFT'деги microsecond/nanosecond latency жарышынан абдан башка убакыт масштабы.
Төртүнчүдөн, система төрт крипто trading pair боюнча сыналган. Рыноктордун саны кеңири универсалдуу жалпылоо үчүн чектелүү.
Бешинчиден, model-selection жана hyperparameter тандоолору validation мезгилдериндеги кирешелерге негизделген. Бул ыкма test топтомун сактоого жардам бергени менен, model-development процессинин белгилүү тарыхый режимдерге көз карандылыгын толук жойбойт.
Алтынчыдан, булак эс тутум механизминде жакын тажрыйбаларды салмактоо үчүн колдонулган Теңдеме (7)нин басылган формасы менен “окшоштукка жараша жакыныраак тажрыйбаларды колдонуу” деген тексттик түшүндүрмөнүн ортосунда так эмес математикалык жагдай калтырат.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: MacroHFT: Memory Augmented Context-aware Reinforcement Learning On High Frequency Trading.
Авторлор: Chuqiao Zong, Chaojie Wang, Molei Qin, Lei Feng, Xinrun Wang жана Bo An.
Жооптуу автор: Chaojie Wang.
Мекемелер: Nanyang Technological University; Skywork AI; Singapore University of Technology and Design.
Жарыя: Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, KDD ’24.
Конференция: 25–29 Август 2024, Barcelona, Spain.
Басма: Association for Computing Machinery.
ACM ISBN: 979-8-4007-0490-1/24/08.
DOI: 10.1145/3637528.3672064.
arXiv: 2406.14537v1 [cs.LG], 20 Июнь 2024.
Негизги ыкма: Memory-Augmented Context-aware Hierarchical Reinforcement Learning.
Low-level RL: Dueling DDQN + Optimal Value Supervisor + conditional adaptation.
High-level RL: Бардык sub-agent Q-policies'тин softmax салмактуу mixture'ы + episodic memory supervision.
Sub-agent саны: 6.
Market decomposition: Bull, Medium Trend, Bear, Volatile, Medium Volatility жана Stable.
LOB тереңдиги: 5 деңгээл.
Low-level context window: 60 мүнөт.
Trading убакыт чечилиши: 1 мүнөт.
Action space: \(\{0,1\}\) максаттуу позиция.
Позиция чектөөсү: Жалаң non-negative / long position.
Commission: %0,02.
Тест рыноктору: BTC/USDT, ETH/USDT, DOT/USDT жана LTC/USDT.
Baseline саны: 8.
Baselines: DQN, DDQN, PPO, CDQNRP, CLSTM-PPO, EarnHFT, Imbalance Volume жана MACD.
Финансылык көрсөткүчтөр: TR, ASR, ACR, ASoR, AVOL жана MDD.
GPU: 4 × NVIDIA RTX 4090.
Optimizer: Adam.
Learning rate: \(1\times10^{-4}\).
Training: Sub-agentтер 15 epoch; hyper-agent 15 epoch.
Негизги тест кирешелери: BTC %3,03; ETH %39,28; DOT %13,79; LTC %18,16.
Ablation жыйынтыгы: Conditional adapter жана memory'ни алып салуу төрт рыноктун баарында Total Return'дү төмөндөткөн; DOT жана LTC'де варианттар терс кирешеге чейин түшкөн.
Funding: National Research Foundation, Singapore — Industry Alignment Fund – Pre-positioning (IAF-PP) Funding Initiative.
Код: Булак ишке ашырууну ZONG0004/MacroHFT GitHub репозиторийинде жарыялаганын билдирет.
Булак ичиндеги техникалык эскертүү 1: Low-level target-position түшүндүрмөсүндөгү bid/ask order терминологиясы ошол эле бөлүмдө берилген bid/ask аныктамалары менен багыт жагынан толук шайкеш көрүнбөйт.
Булак ичиндеги техникалык эскертүү 2: Memory lookup түшүндүрмөсү эң жакын тажрыйбаларды баса белгилегени менен, басылган attention формуласы L2 аралыгын түздөн-түз салмактайт; булак бул белгилөө айырмасын түшүндүрбөйт.
Негизги илимий чек: Натыйжалар тарыхый рынок маалыматтарындагы trading simulation'га таандык; жандуу exchange execution эксперименти же ultra-low-latency өндүрүштүк HFT системасын баалоо эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген