

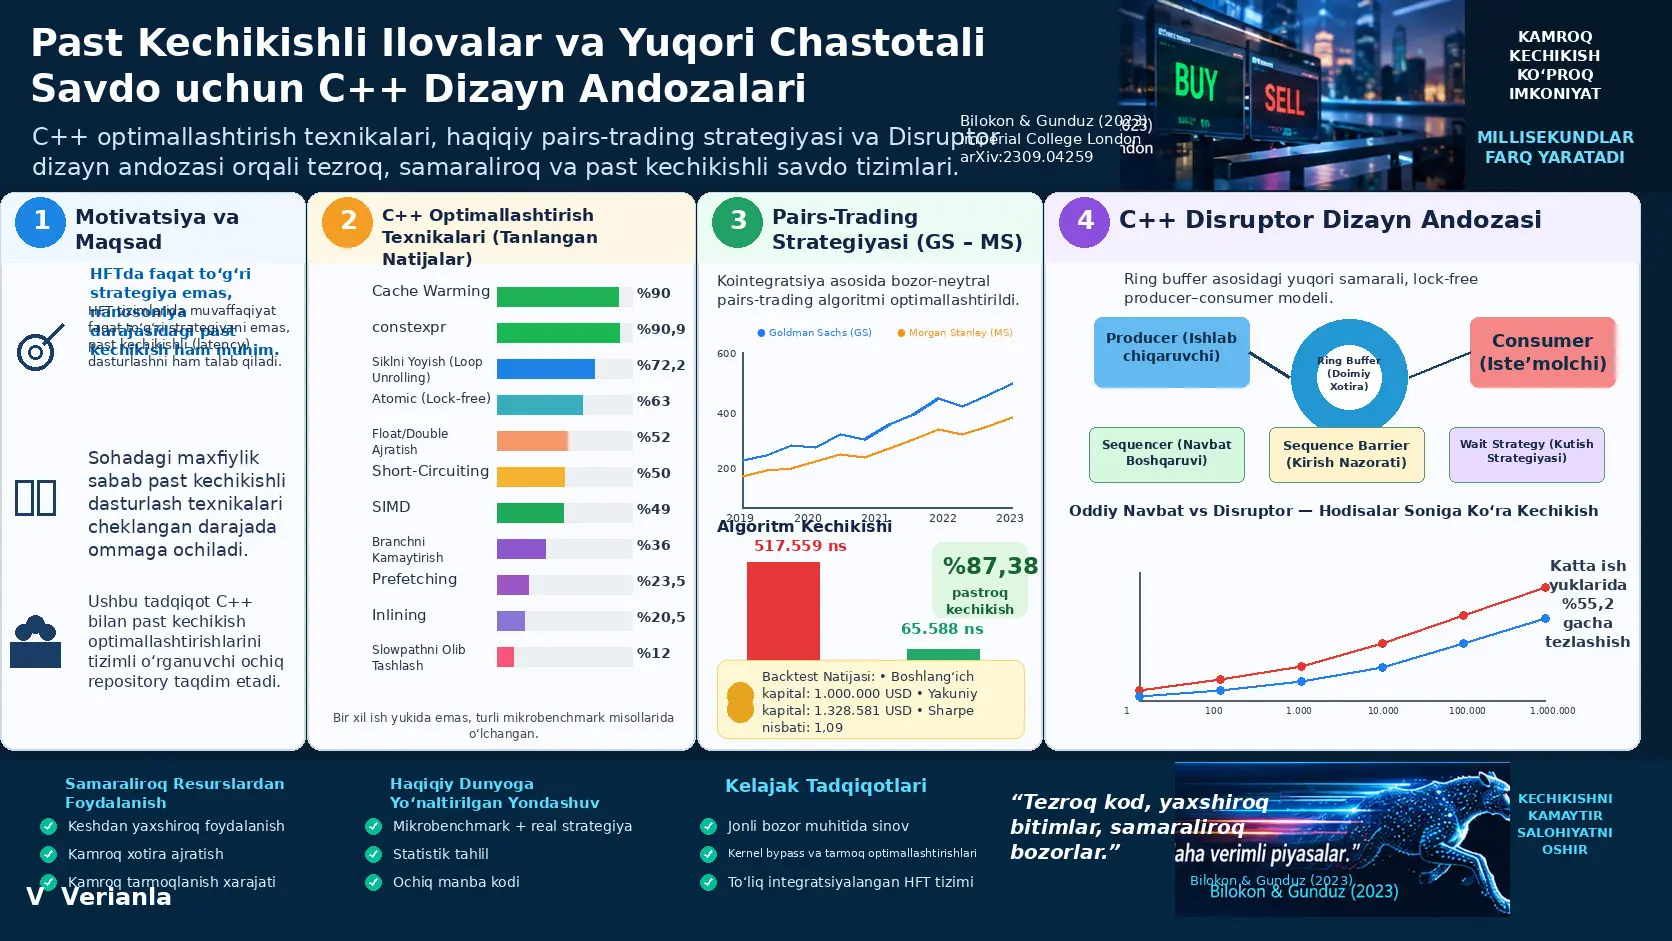
Past kechikishli C++ optimallashtirish — dastur faqat o‘rtacha ishlash vaqtini emas, balki kechikishning o‘zgaruvchanligini ham kamaytirish maqsadida xotiraga murojaat, keshdan foydalanish, kompilyatsiya vaqtidagi hisoblashlar, tarmoqlanish, ma’lumotlarni joylashtirish, parallel bajarish va threadlararo aloqa kabi CPU darajasidagi xarajatlarni tizimli ravishda tartibga soladigan ishlash samaradorligi muhandisligi yondashuvidir. Paul Bilokon va Burak Gunduzning tadqiqoti bu yondashuvni uch qatlamda o‘rganadi: ko‘plab C++ optimallashtirish texnikalarini alohida benchmark qiladigan Low-Latency Programming Repository, ushbu texnikalar qo‘llanilgan bozor-neytral pairs-trading backtest algoritmi va producer–consumer aloqasi uchun C++ da amalga oshirilgan LMAX Disruptor tuzilmasi.
Manbada ajratilgan mikrobenchmarklarda eng yuqori qayd etilgan tezlik oshishlari cache warming va constexpr uchun taxminan %90, loop unrolling uchun %72,24, atomic asosidagi lock-free hisoblagich uchun taxminan %63, float/double turlarini aralashtirmaslik sinov qilingan misolda manba mualliflarining ifodasiga ko‘ra taxminan %52, short-circuiting uchun taxminan %50 va SIMD massiv qo‘shish uchun taxminan %49 ni tashkil etadi. Bunga qarshi ravishda inlining %20,5, prefetching %23,5, compile-time dispatch taxminan %26, branch reduction %36, slowpath removal %12 va tegishli signed/unsigned taqqoslash taxminan %12,15 yaxshilanish ko‘rsatgan. Bu foizlar turli mikrobenchmarklarga tegishli; ularni bitta ilovada qo‘shib, umumiy tezlashish foizi sifatida talqin qilib bo‘lmaydi.
Pairs-trading ilovasida SIMD/AVX2, loop unrolling, qat’iy o‘lchamli massivdan foydalanish va inlining birlashtirilganda, 10 benchmark ishga tushirishiga asoslangan baholashda o‘rtacha kechikish taxminan 517.559 ns dan 65.588 ns gacha tushgan va manba buni %87,38 kechikish yaxshilanishi sifatida qayd etgan. Standart og‘ish ham 4.233 ns dan 400 ns gacha kamaygan. Biroq bu test tarixiy ma’lumotlar bilan ishlaydigan backtest kodi ustida o‘tkazilgan; jonli bozor ma’lumotlari oqimi, network latency, birja ulanishi va haqiqiy Order Management System xatti-harakati bu natijaga kiritilmagan.
Tadqiqotning uchinchi qatlamida C++ Disruptor mutex va condition variable ishlatadigan standart queue bilan taqqoslangan. Event soni oshgani sari Disruptorning o‘lchangan ustunligi umuman olganda ortgan; manba 4-jadvalda 10 event uchun %11,9, 1.000 event uchun %48,8, 10.000 event uchun %55,2 va 1.000.000 event uchun %38,7 tezlashishni qayd etgan. Alohida 20-ishga tushirishli 1.000-event tajribasida Simple Queue uchun 931.255 ns, Disruptor uchun 74.908 ns o‘rtacha kechikish berilgan va farqning t-statistikasi 22,596, p-qiymati esa \(1.243\times10^{-23}\) sifatida qayd etilgan. Mutlaq vaqtlar avvalgi benchmark seriyasidan farq qilgani sababli bu ikki ma’lumot to‘plami bitta o‘lchov ketma-ketligi sifatida birlashtirilmasligi kerak.
Tadqiqot qaysi muammoni hal qilishga urinmoqda?
Yuqori chastotali savdo tizimlarida dasturiy ta’minotning faqat to‘g‘ri qaror qabul qilishi yetarli emas; qaror qanday kechikish bilan qabul qilinishi va bu kechikish ishga tushirishdan ishga tushirishga qanchalik o‘zgarishi ham muhim. Shu sababli tadqiqot C++ kodidagi kichik ko‘rinadigan optimallashtirishlarni CPU darajasida haqiqiy o‘lchovlar bilan sinashga qaratilgan.
Mualliflarning asosiy motivatsiyasi HFT sanoatidagi past kechikish muhandisligining muhim qismi raqobat va maxfiylik sababli ochiq akademik adabiyotda batafsil mavjud emasligidir. Ushbu bo‘shliqni kamaytirish maqsadida yaratilgan Low-Latency Programming Repository texnikalarni shunchaki nomlaydigan ro‘yxat emas, balki benchmark kodi va o‘lchovlari mavjud amaliy arxiv sifatida loyihalashtirilgan.
Cache Warming Past Kechikishli C++ da Nega Muhim?
Cache warming — ishlash samaradorligi uchun muhim bo‘lgan ma’lumot yoki ko‘rsatmalar haqiqatan kerak bo‘lishidan oldin CPU keshiga murojaat qilib, ularni tayyor holatda saqlashdir. HFT dagi “hot path” kamdan-kam ishlasa ham ishga tushganda juda tez bo‘lishi kerakligi sababli, tadqiqot bajarish mexanizmining tegishli ma’lumot va kodini oldindan ishga tushirish yoki o‘qish orqali cache ichida saqlash xotiraga murojaat kechikishini kamaytirishi mumkinligini ko‘rsatadi.
Manba ikki xil Google Benchmark ssenariysini yaratgan. BM_CacheCold katta ma’lumotlar to‘plamiga tasodifiy murojaat qilib, zaif spatial locality hosil qiladi, BM_CacheWarm esa ma’lumotga oldindan va benchmark davomida ketma-ket murojaat qiladi.
| Metrik | BM_CacheCold | BM_CacheWarm |
|---|---|---|
| Vaqt | 267.685.006 ns | 25.635.035 ns |
| Instruction | 4.931.929.489 | 12.013.354.366 |
| Cache reference | 146.264.562 | 61.306.992 |
| Cache miss / cache reference | %73,964 | %71,559 |
Mualliflar vaqt farqini taxminan %90 tezlik yaxshilanishi sifatida talqin qiladilar. Qiziq tomoni shundaki, cache-miss nisbati %73,964 dan faqat %71,559 gacha tushgan bo‘lsa ham umumiy cache reference soni ancha kamaygan. Bu natija cache optimallashtirishni faqat “miss foizi”ga qarab talqin qilib bo‘lmasligini ko‘rsatadi; murojaat tartibi, umumiy memory traffic va bir xil vaqt ichida bajarilgan ish miqdori ham muhim.
Compile-time dispatch
Runtime dispatch ishlaydigan funksiyani dastur bajarilish vaqtida tanlashga asoslansa, compile-time dispatch bu qarorni kompilyatsiya bosqichida beradi. Manba benchmarkida ikki runtime-dispatch misoli 2,60 ns va 2,15 ns o‘lchangan, compile-time muqobillari esa ikkala holatda ham 1,92 ns bo‘lgan. Tadqiqotning umumiy baholashi ushbu texnikaga taxminan %26 tezlik yaxshilanishini nisbat beradi.
Constexpr
constexpr mos ifodalarni runtime o‘rniga kompilyatsiya vaqtida baholashga imkon beradi. Tadqiqotda faktorial 10 hisobining constexpr versiyasi taxminan 0,245 ns, runtime recursive versiyasi esa 2,69 ns o‘lchangan va manba taxminan %90,88 tezlik farqini qayd etgan.
Mualliflar bu natijani umumiy “constexpr har doim %90 tezlashtiradi” qoidasi sifatida taqdim etmaydi. Zamonaviy compilerlar constexpr bo‘lmagan kodni ham optimallashtirishi mumkin. Tajribadagi farq ushbu maxsus kod va compiler xatti-harakati ostida yuzaga kelgan.
Inlining
Inlining funksiya chaqirig‘i o‘rniga funksiya tanasini chaqirish joyiga joylashtirishni maqsad qiladi. always_inline ishlatilgan test taxminan 1,90 ns, oddiy funksiya taxminan 2,39 ns davom etgan va manba taxminan %20,5 yaxshilanishni qayd etgan. Biroq haddan tashqari inlining executable hajmini oshirishi va instruction cache xatti-harakatini yomonlashtirishi mumkin.
Loop unrolling
Loop unrolling sikl boshqaruvining takrorlanish sonini kamaytirish uchun bir iteratsiyada bir nechta amalni ochiq bajaradi. Manbadagi testda standart sikl 4.539 ns, to‘rt qadamli unrolled sikl 1.260 ns davom etgan va %72,24 yaxshilanish qayd etilgan.
Bu texnika ham cheksiz miqyoslanmaydi. Kattaroq binary, instruction cache bosimi va memory-bound ish yuklari foydani kamaytirishi mumkin.
Short-circuiting
Short-circuiting Boolean ifodaning natijasi aniq bo‘lishi bilan qolgan keraksiz hisoblashlarni bajarmaslikdir. Manbada 8 dan 8.192 iteratsiyagacha bo‘lgan turli testlarda short-circuit versiya taxminan oddiy versiyaning yarmi vaqtida ishlagan; yaxshilanishlar %49,53 dan %52,83 gacha qayd etilgan.
Slowpath removal
Slowpath removal xatolikni qayta ishlash, loglash yoki kam uchraydigan holat kodlarini doimiy ishlaydigan hot path tashqarisiga chiqaradi. Manbada hot path %90, slow path %10 ishlaydigan benchmarkda to‘g‘ridan-to‘g‘ri joylashtirilgan slowpath kodi 28.074 ns, alohida HandleError funksiyasiga ko‘chirilgan versiya 24.755 ns davom etgan va taxminan %12 yaxshilanish kuzatilgan.
Branch reduction
Branch reduction bir xil hot path ichida ketma-ket ko‘plab xatolik tekshiruvlarini bajarish o‘rniga xatolik holatlarini, masalan, bit maskasi ichida birlashtirib branch sonini kamaytirishni maqsad qiladi. Manba tajribasida klassik tuzilma 7,35 ns, kamaytirilgan branch tuzilmasi 4,68 ns davom etgan va taxminan %36 yaxshilanish qayd etilgan.
Prefetching
__builtin_prefetch ishlatilgan katta vektor qo‘shish testida prefetch ishlatilmagan versiya 8.235.924 ns, prefetch ishlatilgan versiya 6.301.400 ns davom etgan. Manba buni taxminan %23,5 ishlash samaradorligi yutug‘i sifatida qayd etadi. Yutuq ma’lumotga murojaatning oldindan aytilishi, ma’lumot hajmi va protsessor arxitekturasiga bog‘liq.
Signed va unsigned integer taqqoslanishi
Manbaning maxsus testida signed integer ishlatilgan funksiya 0,282 ns, unsigned versiya 0,321 ns o‘lchangan va signed versiya uchun taxminan %12,15 tezlik ustunligi hisoblangan. Buning sababi misolda compiler unsigned overflow holatini saqlash uchun qo‘shimcha assembly ko‘rsatmalarini ishlab chiqarganidir.
Bu natijani “signed har doim unsigneddan tezroq” deb umumlashtirib bo‘lmaydi. Manbaning o‘zi ma’lum sikl va overflow semantikasiga ega mikrobenchmarkni o‘lchaydi.
Float va double turlarini aralashtirish
float qiymatini 1.23 kabi odatda double bo‘lgan literal bilan ishlash float → double → float aylantirishlarini keltirib chiqarishi mumkin. Manbada mixed versiya 21,6 ns, faqat float ishlatadigan 1.23f versiyasi 14,2 ns o‘lchangan va mualliflar unmixed versiyani taxminan %52 tezroq deb ifodalagan.
SIMD
Single Instruction, Multiple Data (SIMD) bitta CPU ko‘rsatmasi bilan bir nechta ma’lumot elementi ustida parallel amal bajarishga imkon beradi. SSE2 ishlatilgan array-addition testida klassik versiya 21.447 ns, SIMD versiya 10.929 ns davom etgan; amal vaqtida taxminan %49 kamayish qayd etilgan.
Lock-free dasturlash
Tadqiqot atomik amallarni mutex asosidagi sinxronlashtirish bilan taqqoslagan. 10.000 increment uchun atomic versiya taxminan 65.369 ns, mutex versiyasi 175.904 ns davom etgan va manba atomik yondashuv uchun taxminan %63 ishlash samaradorligi yaxshilanishini qayd etgan.
Lock-free dasturlash qulf ishlatmasa ham “bepul” emas. Atomics, CAS, memory ordering va cache-coherence xarajatlari saqlanib qoladi; shuningdek, to‘g‘ri lock-free dizaynni amalga oshirish mutex asosidagi koddan murakkabroq bo‘lishi mumkin.
Kernel bypass
Kernel bypass tadqiqot doirasida benchmark qilinmagan. Texnika tarmoq paketlarini kernel networking stack orqali o‘tkazish o‘rniga foydalanuvchi makonining NIC bilan to‘g‘ridan-to‘g‘riroq aloqa qilishini maqsad qiladi. Manba OpenOnload, VMA va DPDK kabi texnologiyalarni misol sifatida keltiradi, ammo ularning ishlashini tadqiqotning o‘z tajribasi sifatida ko‘rsatmaydi.
LMAX Disruptor Nega An’anaviy Navbatdan Farq Qiladi?
LMAX Disruptor producer va consumerlar o‘rtasida oldindan ajratilgan ring buffer, doimiy ortib boradigan sequence raqamlari va tanlanadigan wait strategy yordamida ma’lumot uzatishni boshqaradigan past kechikishli xabar almashish arxitekturasidir. An’anaviy mutex/condition-variable queue yondashuvidan asosiy farqi runtime memory allocation va lock contention xarajatlarini imkon qadar kamaytirib, producer va consumerga umumiy ma’lumotga oldindan aytish mumkin bo‘lgan xotira joylashuvi orqali murojaat qilish imkonini berishidir.
Ring buffer
Ring buffer qat’iy o‘lchamli, aylana shaklida qayta ishlatiladigan ma’lumot tuzilmasidir. Xotira boshida ajratilgani uchun har eventda yangi allocation/deallocation qilish talab etilmaydi. Bu xotiradan foydalanishni yanada oldindan aytish mumkin qiladi va cache locality nuqtai nazaridan ham ustunlik berishi mumkin.
Sequencer
Sequencer qaysi ring-buffer slotlariga producer yozishi va consumer o‘qishi mumkinligini sequence raqamlari orqali kuzatadi. Producer eventni yozgach tegishli sequenceni e’lon qiladi; consumer o‘z siljish nuqtasini sequence orqali kuzatadi.
Sequence Barrier va Wait Strategy
Sequence Barrier consumerga eventni xavfsiz o‘qish mumkinligini aniqlash imkonini beradi. Ma’lumot hali mavjud bo‘lmasa Wait Strategy ishga tushadi. Busy-spin eng past latencyni maqsad qilishi mumkin, ammo ko‘p CPU sarflaydi; sleeping kamroq CPU ishlatgan holda yuqoriroq latency keltirib chiqarishi mumkin.
Tadqiqot benchmarklarida ishlatilgan wait strategy yield waitdir. Busy-spin, sleeping yoki boshqa strategiyalar bilan tizimli taqqoslash o‘tkazilmagan. Shu sababli Disruptor latency qiymatlari barcha mumkin bo‘lgan konfiguratsiyalar uchun umumiy natija emas.
Tadqiqot Usuli va Natijalari
Birinchi tajriba qatlami: Low-Latency Programming Repository
Mualliflar optimallashtirishlarni compile-time features, optimisation techniques, data handling, concurrency va system programming sarlavhalari ostida jamlagan. Google Benchmark asosiy vaqt o‘lchash vositasi; Linux perf esa ayniqsa cache-reference va cache-miss tahlili uchun ishlatilgan.
| Texnika | Manbada qayd etilgan taxminiy yaxshilanish | Asosiy mexanizm |
|---|---|---|
| Cache warming | %90 | Ma’lumot/ko‘rsatmani oldindan cachega olib kelish |
| Constexpr | %90,88 | Hisobni runtimedan compile-timega ko‘chirish |
| Loop unrolling | %72,24 | Sikl boshqaruvi yukini kamaytirish |
| Atomic / lock-free hisoblagich | %63 | Mutex va context-switch xarajatini kamaytirish |
| Float/double aralashtirmaslik | Manba ifodasiga ko‘ra %52 | Implicit conversionlarni olib tashlash |
| Short-circuiting | Taxminan %50 | Keraksiz Boolean hisoblarini bajarmaslik |
| SIMD array addition | Taxminan %49 | Bitta ko‘rsatma bilan bir nechta ma’lumot elementini ishlash |
| Branch reduction | %36 | Hot path ichidagi branch sonini kamaytirish |
| Compile-time dispatch | Taxminan %26 | Runtime dispatch qarorini olib tashlash |
| Prefetching | %23,5 | Ma’lumot ishlatilishidan oldin cachega so‘rash |
| Inlining | %20,5 | Funksiya chaqirig‘i yukini kamaytirish |
| Signed vs unsigned misoli | %12,15 | Maxsus benchmarkda kamroq assembly ko‘rsatmasi |
| Slowpath removal | %12 | Kam uchraydigan kodni instruction hot pathdan ajratish |
Bu jadval “qaysi optimallashtirish eng yaxshi?” reytingi sifatida talqin qilinmasligi kerak. Har bir qator boshqa amal, ma’lumot hajmi, compiler xatti-harakati va benchmark tuzilmasiga ega. Masalan, 90% cache-warming natijasi katta memory-access benchmarkidan, 90,88% constexpr natijasi esa faktorial 10 misolidan keladi.
Ikkinchi tajriba qatlami: pairs trading
Tadqiqot optimallashtirishlarni realroq ilovada ko‘rish uchun Goldman Sachs Group Inc. (GS) va Morgan Stanley (MS) aksiyalarining besh yillik kundalik adjusted-close ma’lumotlari ustida statistical-arbitrage pairs-trading backtestidan foydalangan.
Cointegration Pairs Trading Strategiyasida Nimani Anglatadi?
Cointegration alohida-alohida non-stationary bo‘lgan ikki vaqt qatorining ma’lum chiziqli kombinatsiyasi stationary bo‘lishi holatidir. Ushbu tadqiqotda GS va MS adjusted-close qatorlarini Engle–Granger ikki bosqichli usuli bilan sinash, narx qatorlari o‘rtasida o‘rganilgan besh yillik davrda uzoq muddatli muvozanat munosabati borligiga statistik dalil hosil qilish uchun ishlatilgan.
Manbaning konseptual ko‘rinishida ikki qator:
shaklida qaraladi. Agar:
kombinatsiyasi stationary bo‘lsa, \(Y_t\) va \(X_t\) cointegrated deb baholanadi. Bu yerda \(\gamma\) ikki qator o‘rtasidagi uzoq muddatli chiziqli munosabatni ifodalaydi.
GS–MS uchun Engle–Granger testida manba p≈0,0149 va t≈−3,7684 ni qayd etadi. \(0,05\) significance darajasida no-cointegration null gipotezasi rad etilgan. Bu natija cointegration uchun statistik dalil beradi; munosabat kelajakda o‘zgarmasligini yoki trading strategiyasi kafolatli foydali bo‘lishini isbotlamaydi.
Z-score bilan signal yaratish
Algoritm spreadning rolling mean va standard deviation qiymatlaridan foydalanib, joriy spreadni standartlashtiradi:
Bu yerda \(Z\) z-score, \(X\) joriy spread, \(\mu\) rolling spread o‘rtachasi va \(\sigma\) rolling spread standard deviation qiymatidir.
Manba strategiyasida:
- \(Z>1.0\): GS nisbatan qimmat deb qabul qilinadi; GS short, MS long signali yaratiladi.
- \(Z<-1.0\): GS nisbatan arzon deb qabul qilinadi; GS long, MS short signali yaratiladi.
- \(|Z|<0.8\): spread o‘rtachaga qaytadi degan taxmin bilan ochiq pozitsiya yopiladi.
- Boshqa hududlarda yangi savdo signali yaratilmaydi.
Backtest moliyaviy natijasi
Manba backtestida portfel 1.000.000 AQSh dollari bilan boshlanib, 1.328.581 AQSh dollari bilan yakunlanadi. Qayd etilgan Sharpe ratio 1,09.
\(R_p\) portfel daromadi, \(R_f\) xavfsiz daromad va \(\sigma_p\) portfel excess-return standard deviation qiymatidir.
Tadqiqotning o‘z ifodasiga ko‘ra trading algoritmining moliyaviy muvaffaqiyatini keng qamrovli baholash tadqiqotning asosiy maqsadi emas. Bu natija tarixiy ma’lumotlar backtestiga tegishli va transaction cost, haqiqiy execution quality, order-book dynamics, slippage, network delay hamda jonli bozor anomaliyalarining barchasini ifodalamaydi.
Pairs-trading algoritmidagi CPU optimallashtirishlari
Algoritmning rolling spread mean va standard-deviation hisobida AVX2 ishlatilgan. 256-bit __m256d register ichida to‘rtta double bir vaqtning o‘zida ishlanib, spread yig‘indisi va kvadratlar yig‘indisi parallel hisoblangan. Bu tuzilma ayni vaqtda to‘rt elementli qadamlar bilan loop unrollingni amalga oshiradi.
Manbaning ushbu ilova uchun qayd etgan muhim cheklovi window size to‘rtning karrasi bo‘lishi talabidir. Bu ishlatilgan AVX2 dizaynidan kelib chiqadi.
Ikkinchi muhim o‘zgarish dynamic container o‘rniga qat’iy o‘lchamli array va rolling index ishlatilishidir. Yangi spread kelganda eng eski element shu array ichidagi joyda almashtiriladi; shu tariqa takroriy dynamic memory allocation ehtiyoji kamaytiriladi.
Mean va standard-deviation hisoblash funksiyalariga inlining ham qo‘llangan.
| Tuzilma | Latency | Manbada qayd etilgan yaxshilanish |
|---|---|---|
| Inlining | 406.709 ns | %21,41 |
| SIMD + loop unrolling | 355.618 ns | %31,28 |
| Fixed array | 266.146 ns | %48,58 |
| Combined | 65.580 ns | %87,33 |
Keyingi 10-ishga tushirishli evaluation bo‘limida manba optimallashtirilmagan algoritm uchun o‘rtacha 517.559 ns va standard deviation 4.233 ns; optimallashtirilgan algoritm uchun o‘rtacha 65.588 ns va standard deviation 400 ns beradi. Shunga ko‘ra qayd etilgan latency kamayishi %87,38 ni tashkil etadi.
Avvalgi usul bo‘limida baseline uchun 519.772 ns ifodasi ham mavjud. Manba ikki baseline soni o‘rtasidagi kichik farqni ochiq tushuntirmagani sababli qiymatlar bitta songa majburan birlashtirilmagan.
Instruction soni va cache-miss xatti-harakati
| Texnika | Instruction | Cache misses / cache references |
|---|---|---|
| Optimallashtirishsiz | 6,01 milliard | %16,001 |
| Combined | 3,27 milliard | %33,879 |
| Fixed array | 8,27 milliard | %19,089 |
| Inlining | 9,07 milliard | %19,151 |
| SIMD + loop unrolling | 8,35 milliard | %16,829 |
Bu jadval muhim natijani ko‘rsatadi: pastroq cache-miss foizi yoki kamroq instruction soni o‘z-o‘zidan tezroq dastur degani emas. Combined versiya eng yuqori cache-miss foiziga ega bo‘lsa ham eng past latencyni hosil qilgan. CPU ishlashi instruction-level parallelism, memory layout, branch behavior, compiler optimallashtirishlari va ma’lumotga murojaat tartibining birgalikdagi natijasidir.
Statistik test
Pairs-trading benchmarklarida har bir tuzilma 10 marta ishlatilgan va optimallashtirilgan/optimallashtirilmagan latency o‘lchovlariga paired t-test qo‘llangan. Manba juda katta t-statistikalar va juda kichik p-qiymatlarni qayd etib, o‘lchangan latency farqini faqat tasodifiy variatsiya bilan tushuntirish ehtimoli past ekanini bildiradi.
Shu bilan birga, manba faqat 10 ma’lumot nuqtasidan foydalanilganini cheklov sifatida ochiq tan oladi va ko‘proq o‘lchov aniqlikni oshirishini bildiradi.
Foydalilik talqini qaysi chegarada qolishi kerak?
Manba pastroq latencyning qisqa muddatli bozor imkoniyatlariga tezroq javob berish salohiyati tufayli moliyaviy jihatdan foydali bo‘lishi mumkinligini adabiyot bilan bog‘laydi. Shuningdek, boshqa tadqiqotda qayd etilgan latency bilan salbiy order-book o‘zgarishiga duchor bo‘lish munosabatidan foydalanib, %87,32 tezlik oshishini taxminan %78,59 pastroq exposure bilan bog‘lovchi hisobni keltiradi.
Bu %78,59 qiymati tadqiqotning jonli bozorda bevosita o‘lchagan natijasi emas. Bu boshqa tadqiqotdagi regressiya munosabati bilan ushbu tadqiqot backtest latency yutug‘ining chiziqli tarzda birlashtirilgan manbadan kelib chiqqan proyeksiyasidir. Haqiqiy HFT tizimida ayni exposure kamayishi yuz berishi ko‘rsatilmagan.
Uchinchi tajriba qatlami: C++ Disruptor
C++ Disruptor implementatsiyasi producer, ring buffer, sequencer, event processor, sequence barrier, event va wait strategy komponentlaridan tuzilgan. HFT kontekstida event order obyekti bo‘lishi mumkin; manba benchmarkida oddiy string event ishlatilgan.
Taqqoslash modeli ikki threaddan iborat. Disruptor versiyasida producer ma’lumotni ring bufferga e’lon qiladi va consumer alohida threadda sequence raqamlari bo‘yicha qayta ishlaydi. Simple Queue versiyasida esa std::queue<std::string>, std::mutex va std::condition_variable ishlatiladi.
| Event | Simple Queue | Disruptor | Manbada qayd etilgan tezlashish |
|---|---|---|---|
| 10 | 20.646 ns | 18.182 ns | %11,9 |
| 100 | 99.458 ns | 64.686 ns | %35,0 |
| 1.000 | 881.092 ns | 451.251 ns | %48,8 |
| 10.000 | 9.735.102 ns | 4.361.096 ns | %55,2 |
| 100.000 | 90.088.609 ns | 52.562.872 ns | %41,7 |
| 1.000.000 | 884.871.405 ns | 543.171.556 ns | %38,7 |
Manba event soni oshgani sari ikki tuzilma o‘rtasidagi mutlaq vaqt farqi kattalashishini bildiradi. 10 eventda o‘rtacha farq 2.464 ns, 1.000.000 eventda 341.699.849 ns deb qayd etilgan.
Disruptorning cache xatti-harakati
10 va 100 event kabi kichik ish yuklarida Disruptorning cache-miss nisbati Simple Queuedan biroz yuqori bo‘lgan. 1.000–1.000.000 event oralig‘ida esa munosabat teskari bo‘lgan va Disruptor pastroq cache-miss nisbatlarini ko‘rsatgan. Bu holat ring buffer katta event oqimlarida samaraliroq memory-access xatti-harakatini ta’minlashi mumkinligiga ishora qiladi.
10-event testida Disruptor taxminan 586.000 kamroq instruction bajargan. Manba buni lock contentionning kamayishi, oldindan ajratilgan ring-buffer xotirasi va yanada oldindan aytiladigan producer–consumer aloqasi bilan bog‘laydi.
Disruptorning Statistik Ishlash Testi Nimani Ko‘rsatadi?
Manbaning alohida 20-ishga tushirishli va 1.000-event testida Simple Queue uchun o‘rtacha latency 931.255 ns, standard deviation 453.766 ns; Disruptor uchun o‘rtacha latency 74.908 ns va standard deviation 53.600 ns o‘lchangan. T-test natijasi \(t=22.596\) va \(p=1.243\times10^{-23}\) deb qayd etilgani sababli ushbu tajriba to‘plamida ikki tuzilmaning o‘lchangan o‘rtacha latency farqi statistik jihatdan kuchli.
Bu natija 4-jadvaldagi 1.000-event qiymatlaridan farqli mutlaq vaqtlarni o‘z ichiga oladi. Manba ularni turli benchmark baholashlari sifatida beradi, ammo farqning konfiguratsiya yoki o‘lchov manbasini batafsil tushuntirmaydi. Shu sababli 451.251 ns bilan 74.908 ns ni bitta “to‘g‘ri” Disruptor latency qiymatiga tushirish kerak emas.
Disruptor baholashining cheklovlari
Benchmark asosan inter-thread communication tezligiga qaratilgan. Memory consumption va CPU load keng qamrovli taqqoslanmagan. Shuningdek, faqat yield wait strategy ishlatilgan; busy-spin, sleep va boshqa wait strategylar tizimli sinovdan o‘tkazilmagan. Shu sababli o‘lchangan natijalar Disruptorning barcha konfiguratsiyalarini ifodalamaydi.
Low-Latency Repository foydalanuvchi baholashi
Repository to‘rtta universitetdan jami 17 ishtirokchi tomonidan ko‘rib chiqilgan: Imperial College London, University College London, King's College London va University of Oxford. Ishtirokchilarning 11 nafari kompyuter fanlari; oltitasi matematika, fizika yoki muhandislik sohalaridan.
| Kategoriya | O‘rtacha | Eng past | Eng yuqori |
|---|---|---|---|
| Comprehensiveness | 8,3 | 6,5 | 9,1 |
| Clarity | 8,7 | 7,8 | 8,9 |
Bu baholash dasturiy ta’minot ishlashining dalili emas, balki repositoryning ta’limiy foydalanish qulayligiga oid kichik foydalanuvchi namunasidir.
Tadqiqot qo‘llab-quvvatlaydigan topilmalar
Manba o‘rganilgan benchmark muhitlarida C++ darajasidagi ma’lumot joylashuvi, cache ishlatish, compile-time hisoblash, branch kamaytirish, SIMD, atomics va allocation strategiyalari latencyga o‘lchash mumkin bo‘lgan ta’sir ko‘rsatishi mumkinligini ko‘rsatadi. Bir nechta optimallashtirish birga qo‘llangan pairs-trading benchmarki alohida optimallashtirishlardan kattaroq umumiy latency kamayishini bergan. C++ Disruptor implementatsiyasi esa sinovdan o‘tkazilgan producer–consumer ish yuklarida mutex/condition-variable queuedan tezroq o‘lchangan.
Tadqiqot qo‘llab-quvvatlamaydigan umumlashtirishlar
Tadqiqot benchmarkdagi foiz yutuqlar boshqa CPU, compiler, operatsion tizim yoki ma’lumot tuzilmasida aynan takrorlanishini ko‘rsatmaydi. Cache warming har bir ish yukida %90, constexpr har bir hisoblashda %90 yoki SIMD har bir algoritmda %49 tezlik berishi haqida xulosa chiqarib bo‘lmaydi. Xuddi shuningdek backtest latency kamayishini jonli trading foydasiga bevosita tenglashtirib bo‘lmaydi va Disruptor benchmarki to‘liq haqiqiy OMSning end-to-end latencysini o‘lchamaydi.
Kelajakdagi ish takliflari
Manba uchta asosiy yo‘nalishni taklif qiladi. Birinchisi repositoryni variadic templates, kernel bypass va networking optimallashtirishlari kabi yangi texnikalar bilan kengaytirishdir. Ikkinchisi pairs-trading algoritmini jonli market-data feed ustida sinashdir. Uchinchisi esa Disruptor bilan trading algoritmini birlashtirib, order obyektlari ring buffer orqali uzatiladigan kengroq trading-system benchmarkini yaratishdir.
Manba va Usul Haqida Izoh
To‘liq original sarlavha: C++ design patterns for low-latency applications including high-frequency trading
Mualliflar: Paul Bilokon; Burak Gunduz.
Affiliatsiyalar: Paul Bilokon — Departments of Computing and Mathematics, Imperial College London; Burak Gunduz — Department of Computing, Imperial College London.
Manba turi: Preprint.
Manuscriptda ko‘rsatilgan sana: 11 sentyabr 2023.
arXiv birinchi versiya sanasi: 8 sentyabr 2023.
arXiv: 2309.04259v1 [cs.PF].
DOI: 10.48550/arXiv.2309.04259.
Platforma: arXiv / CoRR.
Taqriz holati: Tasdiqlangan bibliografik qaydlarda tadqiqot preprint / informal publication sifatida ko‘rinadi; taqrizdan o‘tgan jurnal versiyasi tasdiqlanmagan.
Dasturiy artefakt: Manba Low-Latency Programming Repository, pairs-trading kodi va Disruptor implementatsiyasini 0burak/imperial_hft repositoriyasida taqdim etganini bildiradi.
Litsenziya: Yuklangan PDF ichida ochiq kontent litsenziyasi aniqlanmagani sababli ma’lum bir Creative Commons yoki o‘xshash litsenziya biriktirilmagan.
Moliyalashtirish: Yuklangan preprintda alohida moliyalashtirish bayonoti aniqlanmagan.
Manfaatlar to‘qnashuvi: Yuklangan preprintda alohida manfaatlar to‘qnashuvi bayonoti aniqlanmagan.
CRediT / muallif hissalari: Alohida CRediT bayonoti qayd etilmagan.
Asosiy usul vositalari: Google Benchmark bilan vaqt o‘lchash; Linux perf bilan cache xatti-harakati; C++ past kechikish mikrobenchmarklari; GS–MS adjusted-close ma’lumotlari bilan Engle–Granger cointegration testi va pairs-trading backtesti; AVX2/SIMD optimallashtirish; C++ ring-buffer/Disruptor taqqoslanishi; paired t-test.
Asosiy cheklovlar: Benchmarklarning muhim qismi CPU va dasturiy ta’minot darajasidadir. To‘liq ishlab chiqarish HFT tarmog‘i, co-location, exchange order flow, hardware timestamping va jonli market-data sharoitlari birgalikda o‘lchanmagan. Pairs-trading algoritmi tarixiy ma’lumot backtestidir. AVX2 optimallashtirishi uni qo‘llab-quvvatlaydigan apparatni va tadqiqot implementatsiyasida to‘rtning karrasi bo‘lgan window sizeni talab qiladi. Disruptor tajribasida memory consumption va CPU load keng qamrovli baholanmagan; muqobil wait strategylar taqqoslanmagan.
Manba ichidagi sonlar yaxlitligi izohi: Pairs-trading baseline vaqti usul bo‘limida 519.772 ns, keyingi evaluation bo‘limida 517.559,10 ns sifatida ko‘rsatiladi. Shuningdek 1.000-event Disruptor qiymatlari 4-jadval bilan keyingi 20-ishga tushirishli statistik test orasida farq qiladi. Verianla bu qiymatlardan birini yashirincha tuzatmagan yoki boshqasining o‘rniga qo‘ymagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan