

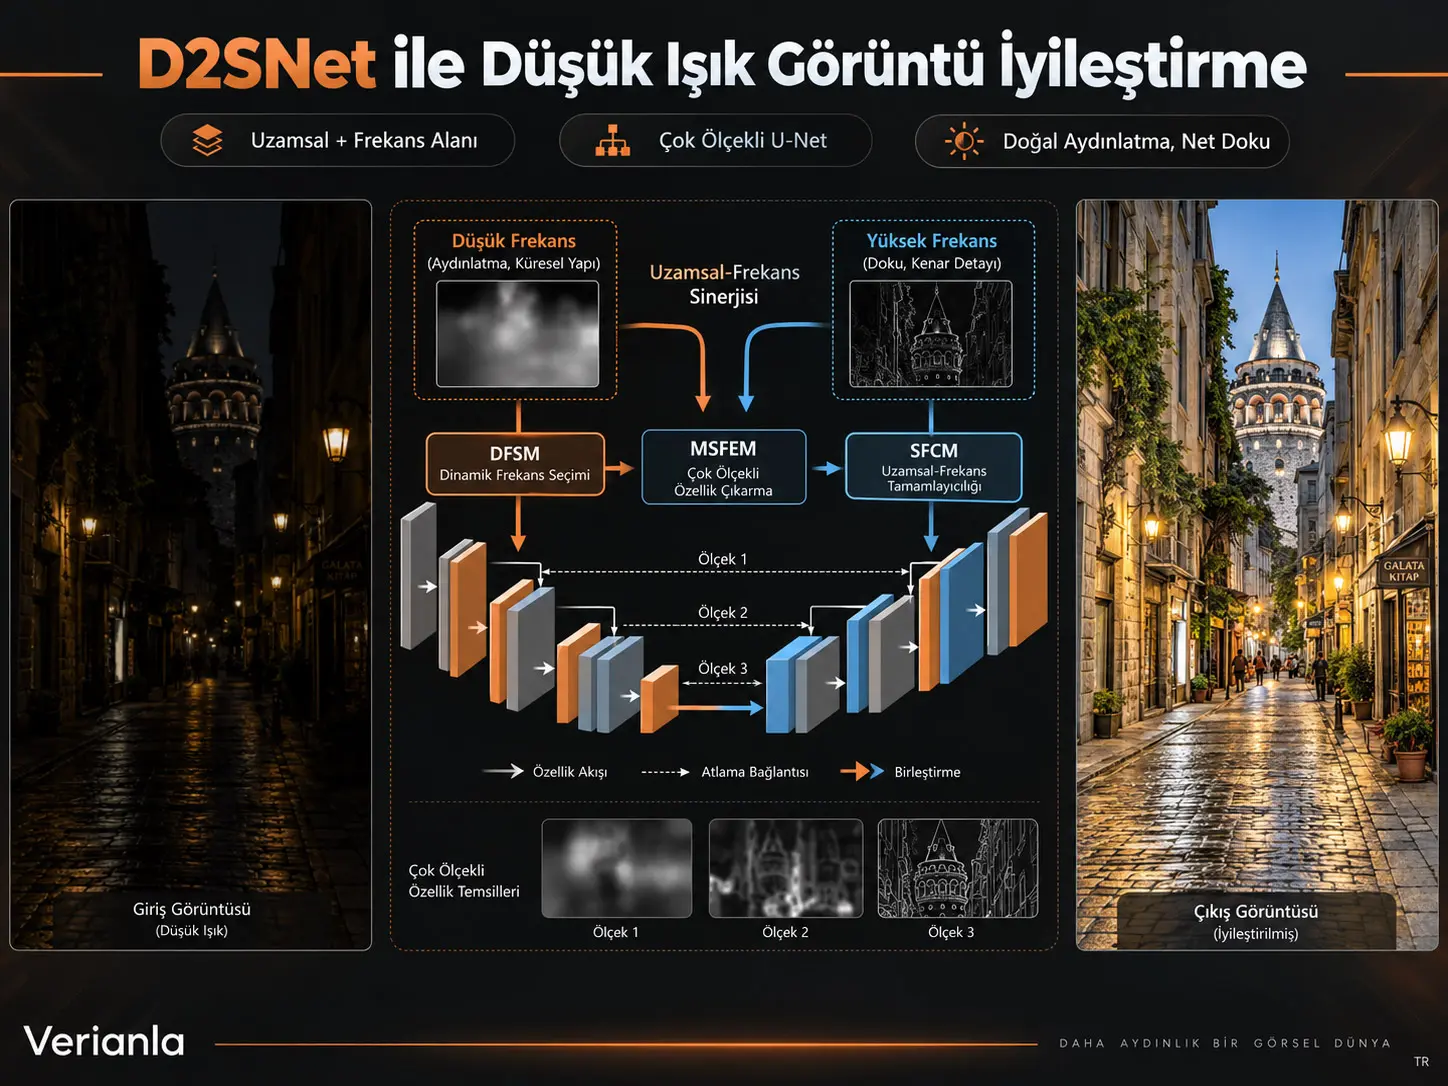
Dual-Domain Synergy Network (D2SNet), düşük ışıklı görüntü iyileştirme probleminde görüntünün uzamsal yapısı ile frekans bileşenlerini çok ölçekli bir U-Net içinde birlikte işleyen bir derin öğrenme mimarisidir. Modelin temel amacı yalnız görüntüyü aydınlatmak değil; aydınlatma düzeltilirken gürültünün gereksiz biçimde büyütülmesini sınırlamak, renkleri korumak ve ince dokuları yeniden oluşturabilmektir. D2SNet bunu Dinamik Frekans Seçim Modülü (Dynamic Frequency Selection Module, DFSM), Çok Ölçekli Özellik Çıkarım Modülü (Multi-Scale Feature Extraction Module, MSFEM) ve Uzamsal-Frekans Tamamlayıcılık Modülü (Spatial-Frequency Complementarity Module, SFCM) aracılığıyla gerçekleştirir.
DFSM, sabit Fourier, kosinüs veya dalgacık tabanlarıyla doğrudan ayrıştırma yapmak yerine giriş özelliklerinden öğrenilen düşük geçiren filtre grupları üretir. Bu filtreler düşük frekanslı ve yüksek frekanslı özellikleri ayırır; kanal ve uzamsal dikkat mekanizmaları daha sonra hangi frekans bileşenlerinin iyileştirme için daha yararlı olduğuna ağırlık verir. MSFEM ise 3 × 3, 5 × 5 ve 7 × 7 genişletilmiş derinlik-ayrımlı evrişimler ile 1 × 1 yerel dalı birleştirerek hem geniş bağlamı hem de yerel ayrıntıyı yakalamaya çalışır. SFCM, bu iki yaklaşımı küçük bir SU-Net yapısı üzerinden ana U-Net'in yüksek çözünürlüklü seviyesine bağlar.
Kaynak çalışmada D2SNet; LOLv1, LOLv2-Real, LOLv2-Synthetic, LOL-Blur, Sony-Total-Dark, beş eşleştirilmemiş düşük ışık veri kümesi ve ExDark nesne algılama deneyleri dahil geniş bir benchmark seti üzerinde değerlendirilmiştir. Örneğin LOLv1'de 25.09 dB PSNR ve 0.874 SSIM, LOLv2-Synthetic'te 26.60 dB PSNR ve 0.947 SSIM, LOL-Blur'da 27.78 dB PSNR ve 0.906 SSIM raporlanmıştır. Model 5.62 milyon parametre ve 256 × 256 giriş yaması için 36.82 G FLOPs ile çalışmaktadır.
Bu sonuçlar, D2SNet'in çalışmada kullanılan veri kümeleri ve eğitim protokolü altında güçlü bir düşük ışık restorasyon modeli olduğunu göstermektedir. Bununla birlikte sonuçlar hakem değerlendirmesinden geçmemiş bir preprintten gelmektedir ve belirli benchmark sonuçları gerçek dünyadaki bütün kamera, sensör, ışık seviyesi veya bozulma türleri için evrensel üstünlük anlamına gelmez.
Araştırma problemi: yalnız parlaklığı artırmak neden yeterli değildir?
Düşük ışıkta çekilen bir görüntüde sorun yalnız ortalama piksel yoğunluğunun düşük olması değildir. Sensör gürültüsü belirginleşebilir, renkler bozulabilir, yerel kontrast azalabilir, ince dokular kaybolabilir ve uzun pozlama kullanılmışsa hareket veya kamera kaynaklı bulanıklık ortaya çıkabilir. Bu nedenle iyi bir düşük ışık görüntü iyileştirme sistemi bir taraftan küresel aydınlatmayı düzeltirken diğer taraftan ayrıntıları korumalı, gürültüyü büyütmemeli ve doğal olmayan aşırı pozlanmış bölgeler oluşturmamalıdır.
Kaynak çalışma mevcut yaklaşımları iki temel açıdan tartışmaktadır. CNN ve Transformer tabanlı yöntemlerin büyük bölümü ağırlıklı olarak uzamsal alanda çalışır. Frekans alanından yararlanan yöntemler ise çoğu zaman FFT, DCT veya DWT gibi önceden belirlenmiş dönüşümler kullanır. Bu sabit dönüşümlerin düşük ışık bozulmasının görüntüden görüntüye değişen yapısına doğrudan uyum sağlayamaması, D2SNet'in çıkış noktasıdır.
D2SNet Nedir ve Neden İki Farklı Alanı Birlikte Kullanır?
D2SNet, düşük ışıklı görüntünün uzamsal yapısını ve düşük-yüksek frekans özelliklerini aynı çok ölçekli restorasyon ağı içinde karşılıklı olarak kullanan bir U-Net tabanlı görüntü iyileştirme modelidir. Uzamsal alan nesnelerin, bölgelerin ve yerel bağlamın nerede bulunduğunu taşırken frekans ayrımı daha yavaş değişen aydınlatma bileşenleri ile kenar, doku ve gürültü gibi daha hızlı değişen bileşenlerin farklı biçimde işlenmesine olanak verir.
Ağın genel veri akışı
Giriş, \(3 \times H \times W\) boyutunda düşük ışıklı RGB görüntüdür. İlk 3 × 3 evrişim görüntüyü \(C \times H \times W\) boyutunda sığ bir özellik gösterimine dönüştürür. Ardından üç ölçekli ana U-Net kodlayıcısı çözünürlüğü aşamalı olarak azaltırken kanal sayısını artırır. Kod çözücü ters yönde çalışır ve kodlayıcıdan gelen özelliklerle atlama bağlantıları üzerinden birleşir.
Her çözünürlük seviyesinin son ResBlock işleminden sonra DFSM uygulanır. MSFEM ise sürekli olarak her seviyeye yerleştirilmez; SU-Net ve ana U-Net darboğazlarında kullanılır. Kaynağa göre bu seçim, çok sayıda genişletilmiş evrişimin art arda uygulanması halinde oluşabilecek düzenli örnekleme boşluklarını ve uzamsal bilgi kaybını azaltmayı amaçlamaktadır.
Son aşamada 3 × 3 evrişim uygulanır ve ağ çıktısı orijinal düşük ışıklı görüntüyle artık bağlantısı üzerinden birleştirilerek nihai iyileştirilmiş görüntü elde edilir.
Üç temel modül
| Modül | Tam adı | Temel görev | Bilimsel rolü |
|---|---|---|---|
| DFSM | Dynamic Frequency Selection Module | Öğrenilebilir filtrelerle frekans ayrıştırma ve ağırlıklandırma | Görüntü içeriğine göre yararlı düşük/yüksek frekans bileşenlerini seçmek |
| MSFEM | Multi-Scale Feature Extraction Module | Birden fazla alıcı alan büyüklüğünden uzamsal özellik çıkarmak | Frekans seçimine globalden yerele uzanan semantik bağlam sağlamak |
| SFCM | Spatial-Frequency Complementarity Module | SU-Net, MSFEM ve DFSM'yi ortak işlem hattında birleştirmek | Yüksek çözünürlük seviyesinde uzamsal-frekans tamamlayıcılığı kurmak |
DFSM Öğrenilebilir Frekans Seçimini Nasıl Yapar?
DFSM, giriş özelliklerini kanal gruplarına ayırır, girişin kendisinden öğrenilen düşük geçiren filtre çekirdekleri üretir, düşük frekans bileşenini filtreleme yoluyla çıkarır ve yüksek frekans bileşenini giriş ile düşük frekans bileşeni arasındaki artık olarak oluşturur; daha sonra kanal ve uzamsal dikkat ağırlıkları düşük ve yüksek frekansların çıktıdaki katkısını dinamik biçimde belirler.
FFE: frekans bileşenlerinin dinamik ayrıştırılması
Giriş özellik haritası \(X \in \mathbb{R}^{C \times H \times W}\), kanal ekseninde \(g\) gruba ayrılır:
Denklem (1)
\[ X=[X^{1},X^{2},\ldots,X^{g}] \]
Her grubun kanal sayısı \(C_i=C/g\) olarak tanımlanır. Filtre üretim yolu global ortalama havuzlama, 1 × 1 evrişim, batch normalization ve Softmax kullanır:
Denklem (2)
\[ LPF=\operatorname{Softmax}\left(BN\left(Conv_{1\times1}(GAP(X))\right)\right) \]
Üretilen düşük geçiren filtrelerin boyutu \(k^{2}\times g\)'dir. \(k\) filtre çekirdek boyutunu, \(g\) kanal grubu sayısını gösterir. Softmax işlemi \(k^{2}\) çekirdek elemanı üzerinde normalize edilmiş ağırlıklar üretir.
Denklem (3), kaynakta basıldığı biçimde
\[ X^{i}_{low}= \sum_{p,q\in\mathcal{N}_{k}} \left( X^{i}(h+p,w+q)\cdot LPS^{i} \right) \]
Burada \(h,w\) mevcut uzamsal konumu; \(\mathcal{N}_{k}\) ise \(k\times k\) yerel komşuluğu gösterir. Kaynak metnin açıklamasında ilgili filtre LPF olarak adlandırıldığı halde Denklem (3) görselinde LPS sembolü basılmıştır. Kaynak bunun bir yazım hatası olduğunu açıkça belirtmediğinden iki gösterim arasındaki tutarsızlık burada değiştirilmeden kaydedilmektedir.
Yüksek frekans bileşeni, orijinal özellikten tüm düşük frekans gruplarının birleştirilmiş gösteriminin çıkarılmasıyla elde edilir:
Denklem (4)
\[ X_{high}=X-[X^{1}_{low},X^{2}_{low},\ldots,X^{g}_{low}] \]
Bu matematiksel yapı önemlidir: yüksek frekans bileşeni ayrı bir sabit yüksek geçiren filtreyle hesaplanmak yerine öğrenilebilir düşük frekans tahmininin artığı olarak tanımlanmaktadır.
DAGG ve çift dikkat mekanizması
Düşük ve yüksek frekans özellikleri önce ayrı 3 × 3 depth-wise evrişimlerden geçirilir. Ardından iki farklı füzyon yolu oluşturulur: eleman bazlı toplama ile \(X_{add}\), kanal yönünde birleştirme ile \(X_{con}\). \(X_{add}\), paralel kanal ve uzamsal dikkat yollarından oluşan Dual Attention Module'a gönderilir.
Denklem (5)
\[ W_{ca}=Conv_{1\times1}\left( ReLU\left( Conv_{1\times1}(GAP(X_{add})) \right) \right) \]
\(W_{ca}\in\mathbb{R}^{C\times1\times1}\), hangi özellik kanallarının iyileştirme açısından daha önemli olduğunu ağırlıklandıran kanal dikkat terimidir.
Denklem (6)
\[ W_{sa}=Conv_{7\times7}\left( [GAP(X_{add}),GMP(X_{add})] \right) \]
\(W_{sa}\in\mathbb{R}^{1\times H\times W}\), uzamsal bölgeler arasında ağırlık dağılımı üretir. Kaynak açıklamasına göre amaç daha ağır bozulmuş bölgelerin daha fazla dikkate alınmasıdır.
Kanal ve uzamsal ağırlıklar bir araya getirilerek Sigmoid ile \(W_{casa}\) oluşturulur. İki füzyon yolunun birleşimi şu biçimdedir:
Denklem (7)
\[ X_{fuse}= W_{casa}\cdot X_{add} + (1-W_{casa})\cdot Conv_{1\times1}(X_{con}) \]
Ardından düşük ve yüksek frekans bileşenlerine özgü normalize edilmiş ağırlıklar elde edilir:
Denklem (8)
\[ W_{low},W_{high} = Split\left( Softmax(GAP(X_{fuse})) \right) \]
DFSM çıkışı:
Denklem (9)
\[ X_{out} = W_{low}\cdot X_{low} + W_{high}\cdot X_{high} \]
Bu son ifade DFSM'nin ana işlevini özetler. Model düşük ve yüksek frekans özelliklerini sabit oranlarda toplamaz; her giriş için öğrenilen ağırlıklarla yeniden birleştirir.
MSFEM: global bağlam ile yerel ayrıntının aynı modülde tutulması
MSFEM giriş özelliklerini önce batch normalization, 1 × 1 point-wise evrişim ve GELU aktivasyonundan geçirir:
Denklem (10)
\[ \hat{X} = GELU\left( Conv_{1\times1}(BN(X)) \right) \]
Büyük dalda üç paralel depth-wise dilated convolution kullanılır:
Denklem (11)
\[ X_{k} = DWDConv_{k\times k,d=3}(\hat{X}), \qquad k\in\{3,5,7\} \]
Dilation oranı \(d=3\)'tür. Kaynağın verdiği etkin alıcı alan bağıntısı:
\[ k_{eff}=k+(k-1)(d-1) \]
Buna göre 3 × 3, 5 × 5 ve 7 × 7 çekirdekler sırasıyla 7 × 7, 13 × 13 ve 19 × 19 etkin alıcı alanlara ulaşır. Böylece tek bir çekirdek ölçeğine bağlı kalmadan kısa, orta ve daha uzun menzilli uzamsal bağlam yakalanmaya çalışılır.
Büyük dalın çıktısı:
Denklem (12)
\[ X_{large} = Conv_{1\times1} \left( GELU \left( Conv_{1\times1} ([X_{3},X_{5},X_{7}]) \right) \right) \]
Küçük dal yalnız 1 × 1 depth-wise evrişim kullanarak yerel bilgiyi tamamlar:
Denklem (13)
\[ X_{small} = Conv_{1\times1} \left( GELU \left( DWConv_{1\times1}(\hat{X}) \right) \right) \]
MSFEM'in dikkat çekici tasarım tercihi, modülün tüm seviyelerde art arda kullanılmamasıdır. Kaynak, genişletilmiş evrişimlerin çok sayıda ardışık ölçekte kullanılmasının düzenli biçimde örneklenmeyen pikseller ve uzamsal bilgi kaybı oluşturabileceğini belirterek MSFEM'i yalnız SU-Net ve ana U-Net darboğazlarına yerleştirir.
SFCM ve küçük U-Net'in konumu
SFCM \(C\times H\times W\) girişini önce iki adet 3 × 3 evrişim ve ReLU içeren ResBlock ile işler. Daha sonra özellikler kernel=2 ve stride=2 depth-wise evrişimle \(C\times H/2\times W/2\) boyutuna indirilir ve MSFEM'e gönderilir. Bilinear interpolation ile yeniden özgün çözünürlüğe çıkıldıktan sonra DFSM uygulanır ve sığ özelliklerle atlama bağlantısı kurulur.
Bu yapı ana U-Net'in yalnız en yüksek çözünürlüklü birinci ölçeğinde kullanılmıştır. Ablasyon sonuçları, SU-Net'in ikinci ve üçüncü ölçeklere de eklenmesinin FLOPs'u düşürmesine rağmen PSNR'ı azalttığını göstermektedir. Bu bulgu, düşük çözünürlük seviyelerinde yeni bir downsampling işleminin yararlı uzamsal ayrıntıları kaybettirebildiği yorumuyla ilişkilendirilmiştir.
Kayıp fonksiyonu
D2SNet eğitiminde hem uzamsal alan hem de frekans alanı için \(L_{1}\) kaybı kullanılmaktadır.
Denklem (14)
\[ L_{spatial} = \|Pred-GT\|_{1} \]
Burada \(Pred\) ağın ürettiği görüntüyü, \(GT\) ise referans normal-ışık görüntüsünü gösterir.
Denklem (15)
\[ L_{frequency} = \|F(Pred)-F(GT)\|_{1} \]
\(F\), hızlı Fourier dönüşümünü (FFT) ifade eder. Bu frekans kaybı, tahmin edilen görüntü ile referans görüntünün frekans temsillerini birbirine yaklaştırmayı amaçlar.
Denklem (16)
\[ L = L_{spatial} + \lambda L_{frequency} \]
Çalışmada \(\lambda=0.2\) seçilmiştir. Dolayısıyla toplam optimizasyon uzamsal yeniden yapılandırma hatasını temel bileşen olarak tutarken frekans alanı uyumuna da ek ağırlık verir.
Değerlendirme metrikleri neyi ölçüyor?
PSNR, piksel seviyesindeki yeniden yapılandırma hatasıyla ilişkili bir kalite ölçütüdür ve bu çalışmada yüksek değer tercih edilir. SSIM, yapısal benzerliği ölçer ve yine yüksek değer daha iyidir. LPIPS, derin özellik uzayındaki algısal farklılığı değerlendirir; düşük değer daha iyidir. Referans görüntüsü bulunmayan veri kümelerinde BRISQUE ve NIQE kullanılmıştır ve her ikisinde de düşük değer tercih edilmektedir.
Çalışmanın Yöntemi ve Bulguları
Veri kümeleri
Temel eşleştirilmiş değerlendirmelerde LOLv1 ile LOLv2-Real ve LOLv2-Synthetic kullanılmıştır. LOLv1'de 485 düşük/normal ışık görüntü çifti eğitim, 15 çift test için ayrılmıştır. LOLv2-Real eğitim:test oranı 689:100, LOLv2-Synthetic oranı 900:100'dür.
LOL-Blur veri kümesi 200 sahne üzerinden oluşturulmuş 12.000 düşük-ışık/bulanık ve yüksek-keskinlik görüntü çiftinden oluşur; 10.200 çift eğitim, 1.800 çift test için kullanılmıştır. Sony-Total-Dark bölümünde 2.697 kısa ve uzun pozlama RAW görüntü çifti bulunur; 2.099 çift eğitim, 598 çift test için kullanılmıştır.
Referans görüntüsü bulunmayan genelleme deneyleri DICM, LIME, MEF, NPE ve VV üzerinde yapılmıştır. Ayrıca düşük ışık iyileştirmenin üst seviye bir bilgisayarlı görü görevine etkisini değerlendirmek için ExDark nesne algılama veri kümesi kullanılmıştır.
Eğitim ve uygulama ayrıntıları
| Parametre | Kaynakta kullanılan değer |
|---|---|
| Çerçeve | PyTorch |
| Donanım | Tek NVIDIA A100 GPU |
| Optimizer | Adam |
| \(\beta_1\) | 0.9 |
| \(\beta_2\) | 0.999 |
| \(\epsilon\) | \(1\times10^{-8}\) |
| Başlangıç öğrenme oranı | \(1\times10^{-3}\) veya \(1.2\times10^{-3}\) |
| Son öğrenme oranı | \(5\times10^{-7}\) |
| Öğrenme oranı zamanlaması | Cosine annealing |
| Batch size | 32 |
| Patch size | 256 × 256 |
| DFSM filtre çekirdekleri | 3 × 3 ve 5 × 5 |
| FFE grup sayısı | 8 |
| LOLv1 / LOLv2 eğitim süresi | 2.500 epoch |
| LOL-Blur eğitim süresi | 1.500 epoch |
| Sony-Total-Dark | LOL-Blur ile aynı temel parametre ayarları |
Temel eşleştirilmiş benchmark sonuçları
| Veri kümesi | PSNR | SSIM | LPIPS |
|---|---|---|---|
| LOLv1 | 25.09 dB | 0.874 | 0.082 |
| LOLv2-Real | 23.80 dB | 0.877 | 0.076 |
| LOLv2-Synthetic | 26.60 dB | 0.947 | 0.027 |
| LOL-Blur | 27.78 dB | 0.906 | 0.075 |
| Sony-Total-Dark | 21.70 dB | 0.676 | 0.387 |
D2SNet'in hesaplama büyüklüğü kaynak tablolarında 5.62 milyon parametre ve 36.82 G FLOPs olarak verilmektedir. LOLv1'de model 25.09 dB PSNR ile Diff-Retinex++'ın 24.67 dB değerini 0.42 dB aşmıştır. LOLv2-Synthetic'te D2SNet 26.60 dB PSNR, 0.947 SSIM ve 0.027 LPIPS elde etmiştir.
LOLv2-Real için D2SNet'in 23.80 dB PSNR ve 0.877 SSIM değerleri kaynak Tablo 1'de en yüksek değerlerdir. Buna karşılık LPIPS değeri 0.076'dır ve aynı tabloda CWNet için 0.063 raporlanmıştır. Bu nedenle kaynak metnin “PSNR, SSIM ve LPIPS'in tamamında en iyi” ifadesi tablonun LPIPS sütunuyla uyuşmamaktadır.
LOL-Blur: iyileştirme ve bulanıklık giderme birlikte
LOL-Blur deneyinde D2SNet 27.78 dB PSNR, 0.906 SSIM ve 0.075 LPIPS üretmiştir. Kaynak Tablo 2'de bu üç değer de listelenen diğer uçtan uca ve ardışık yöntemlerden daha iyi görünmektedir. Modelin 36.82 G FLOPs'luk hesaplama maliyeti, bazı daha ağır yöntemlerden belirgin şekilde düşük olmakla birlikte en hafif karşılaştırılan model değildir.
Kaynağın nitel karşılaştırmalarında D2SNet çıktılarında renk geri kazanımı, ayrıntı korunumu ve bulanıklığın azaltılması vurgulanmaktadır. Bunlar görsel örneklerle desteklenmektedir; ancak nitel örneklerin seçimi tüm olası sahneleri temsil eden bağımsız bir kullanıcı çalışması değildir.
Sony-Total-Dark: çok karanlık RAW görüntüler
Sony-Total-Dark üzerinde D2SNet 21.70 dB PSNR, 0.676 SSIM ve 0.387 LPIPS elde etmiştir. Kaynak karşılaştırmasında LEDNet sırasıyla 20.83 dB, 0.648 ve 0.471 değerlerindedir. Bu deney, mimarinin yalnız standart LOL görüntülerinde değil çok düşük pozlamalı RAW veri üzerinde de değerlendirildiğini gösterir.
Referans görüntüsü olmayan veri kümeleri
| Veri kümesi | BRISQUE | NIQE |
|---|---|---|
| DICM | 18.16 | 3.77 |
| LIME | 14.63 | 3.66 |
| MEF | 13.22 | 3.38 |
| NPE | 13.21 | 4.01 |
| VV | 18.54 | 2.80 |
LIME, MEF ve VV üzerinde D2SNet güçlü değerler verir. DICM'de BRISQUE 18.16 ile kaynak tablodaki en düşük değerdir; NIQE 3.77 ise DarkIR'ın 3.76 değerinden çok az yüksektir. NPE'de D2SNet'in 13.21 BRISQUE değeri DarkIR'ın 12.88 değerinden, 4.01 NIQE değeri ise CIDNet'in 3.74 değerinden daha yüksektir. Bu nedenle sonuçlar “bütün eşleştirilmemiş veri kümelerinde ve bütün metriklerde en iyi” biçiminde yorumlanmamalıdır.
Ablasyon Deneyleri D2SNet'in Hangi Bileşenlerinin Katkısını Gösteriyor?
Kaynak ablasyonları en büyük tek modül katkısının DFSM'den geldiğini, MSFEM'in ek kazanç sağladığını ve SU-Net'in yalnız en yüksek çözünürlüklü ölçekte kullanılmasının performans-hesaplama dengesi açısından daha uygun olduğunu göstermektedir; tam yapı LOLv1 üzerinde 25.09 dB PSNR ve 0.874 SSIM'e ulaşmıştır.
Ana modüllerin katkısı
Temel ağ 20.19 dB PSNR ve 0.815 SSIM üretmiştir. Ana U-Net darboğazına MSFEM eklenmesi PSNR'ı 21.06 dB'ye taşırken DFSM'nin ilgili ölçeklerde kullanılması 23.68 dB'ye ulaşmıştır. Kaynak yazarları bunu DFSM için tabana göre 3.49 dB PSNR artışı olarak raporlamaktadır.
SU-Net'in birinci ölçeğe eklenmesiyle PSNR 23.74 dB olurken FLOPs 38.13 G'den 35.01 G'ye düşmüştür. Daha sonraki MSFEM yerleşimleriyle tam ağ 25.09 dB PSNR, 0.874 SSIM, 5.62 M parametre ve 36.82 G FLOPs değerine ulaşmıştır.
Neden yalnız bir SU-Net?
| SU-Net sayısı | PSNR | SSIM | FLOPs |
|---|---|---|---|
| 0 | 23.68 | 0.858 | 38.13 G |
| 1 | 23.74 | 0.858 | 35.01 G |
| 2 | 23.42 | 0.850 | 31.89 G |
| 3 | 23.27 | 0.850 | 28.77 G |
SU-Net sayısı arttıkça hesaplama azalmasına karşın görüntü kalitesi düşmektedir. Kaynağın yorumu, daha düşük çözünürlüklü katmanlarda ek downsampling yapılmasının geri döndürülemeyen uzamsal ayrıntı kaybına yol açabilmesidir.
FFE grup sayısı
FFE için \(g=2\) ve \(g=4\) durumlarında PSNR 23.57 dB, \(g=8\) durumunda 23.68 dB, \(g=16\) durumunda 23.48 dB'dir. Bu nedenle nihai modelde 8 grup seçilmiştir. Kaynak, 16 gruptaki düşüşü olası aşırı uyumla ilişkilendirmektedir; bu açıklama doğrudan kanıtlanmış bir mekanizma değil, yazar yorumudur.
Öğrenilebilir filtre ve dikkat tasarımı
FFE karşılaştırmasında Gaussian filtre 23.22 dB, Wavelet filtre 23.21 dB ve öğrenilebilir düşük geçiren filtre 23.68 dB PSNR üretmiştir. DAGG tarafında CBAM ile 23.19 dB, çalışmanın DAM yapısıyla 23.68 dB elde edilmiştir. Böylece kaynak deneyleri hem içerik uyarlamalı frekans ayrıştırmasının hem de kullanılan paralel çift dikkat mekanizmasının seçilen benchmark üzerinde katkı verdiğini göstermektedir.
MSFEM ölçeklerinin katkısı
Üç paralel 3 × 3 DWDConv 20.34 dB, üç paralel 5 × 5 yapı 20.56 dB, üç paralel 7 × 7 yapı 20.64 dB PSNR üretmiştir. Çok ölçekli Large Branch 20.81 dB'ye, Large Branch ile Small Branch'in birlikte kullanımı ise 21.06 dB'ye çıkmıştır. Küçük dalın eklenmesi 0.19 dB PSNR kazancı sağlarken kaynak tabloya göre yalnız 0.07 G ek FLOPs getirmiştir.
ExDark nesne algılama uygulaması
Çalışma, görüntü iyileştirmenin yalnız görsel kalite metriğine değil sonraki bilgisayarlı görü görevine etkisini de sınamıştır. ExDark veri kümesindeki 7.363 görüntü 5.890 eğitim, 737 doğrulama ve 736 test görüntüsü olarak ayrılmıştır. Görüntüler LOLv2-Synthetic üzerinde eğitilmiş D2SNet modeliyle iyileştirildikten sonra YOLO-V5 nesne algılayıcısı kullanılmıştır.
D2SNet ön işleme ile kaynak Tablo 10'da toplam mAP 73.6 olarak raporlanmıştır. İkinci en yüksek ortalama değer SRENet için 67.9'dur; fark 5.7 puandır. “Dog” kategorisinde D2SNet 80.0, Diff-Retinex++ 72.8 değerine ulaşmış ve fark 7.2 puan olmuştur. Kaynak Şekil 9'daki örneklerden birinde düşük ışık görüntüsünde tespit edilemeyen tekne, D2SNet iyileştirmesinden sonra YOLO-V5 tarafından 0.82 güven skoruyla algılanmıştır.
D2SNet Sonuçları Nasıl Yorumlanmalıdır?
D2SNet'in sonuçları, çalışmada kullanılan benchmark veri kümeleri ve eğitim ayarları altında uzamsal-frekans sinerjisinin güçlü bir restorasyon yaklaşımı olabildiğini desteklemektedir; ancak preprint statüsü, veri kümelerinin sınırlı kapsamı ve bazı metin-tablo tutarsızlıkları nedeniyle sonuçlar bütün gerçek kamera sistemleri veya bütün düşük ışık koşulları için kesin ve evrensel üstünlük iddiasına dönüştürülmemelidir.
Çalışmanın desteklediği sonuçlar
Kaynak deneyleri DFSM'nin güçlü bir ablasyon katkısı sağladığını, MSFEM'in farklı alıcı alan ölçeklerini birleştirmesinin tek ölçekli sürümlerden daha yüksek PSNR verdiğini ve en yüksek çözünürlük seviyesine yerleştirilen tek SU-Net'in hesaplama maliyeti ile kalite arasında daha uygun denge kurduğunu göstermektedir. D2SNet ayrıca eşleştirilmiş, eşleştirilmemiş, bulanık ve aşırı karanlık veri kümelerinde sınanmış; ExDark deneyiyle nesne algılama ön işleme etkisi de değerlendirilmiştir.
Çalışmanın desteklemediği genellemeler
Çalışma D2SNet'in bütün kamera sensörlerinde, bütün gürültü modellerinde, bütün aydınlatma seviyelerinde veya gerçek zamanlı gömülü cihazlarda aynı performansı vereceğini kanıtlamaz. Kaynak belirli bir mobil cihaz, edge accelerator veya gerçek zamanlı endüstriyel sistem üzerinde gecikme ölçümü raporlamamaktadır. Ayrıca benchmark görüntü metriklerindeki iyileşme, her görsel algı veya güvenlik-kritik bilgisayarlı görü görevinde aynı büyüklükte kazanç oluşacağı anlamına gelmez.
Kaynak ve Yöntem Notu
Özgün başlık: D2SNet: Dual-domain Synergy Network for Low-Light Image Enhancement
Yazarlar: Feng Huang; Jing Guo; Jing Wu; Jiong Huang.
Yazar sırası: Feng Huang → Jing Guo → Jing Wu → Jiong Huang.
Kurum: SSRN resmî kaydına göre dört yazar da Fuzhou University bağlantılıdır.
İletişim yazarı: SSRN kaydında Jing Guo “Contact Author” olarak belirtilmektedir. PDF'nin görünen sürümü ayrıca bir corresponding-author işareti sunmamaktadır.
DOI: 10.2139/ssrn.7003581
Platform: SSRN.
Resmî kayıt:SSRN Abstract 7003581
Gönderim/kayıt tarihi: 26 Haziran 2026.
Kaynak türü: Preprint araştırma makalesi.
Hakemlik durumu: Kaynak PDF açık biçimde çalışmanın hakem değerlendirmesinden geçmediğini belirtmektedir.
Dergi/cilt/sayı: Kaynakta hakemli bir dergi yayını, cilt veya sayı bilgisi verilmemektedir.
Lisans/telif: SSRN kayıt sayfasında hakların saklı olduğu ve izin olmadan yeniden kullanıma izin verilmediği belirtilmektedir. Bu nedenle Verianla metni kaynak şekil ve tablo tasarımını kopyalamaz; yalnız doğrulanabilir bilimsel bilgi, yöntem, denklem ve sonuçları bağımsız öğretici yapıda açıklar.
Çıkar çatışması: Yazarlar, çalışmayı etkileyebilecek bilinen mali çıkar veya kişisel ilişki bulunmadığını beyan etmektedir.
Veri erişilebilirliği: Kaynak, çalışmada kullanılan verilerin talep üzerine erişilebilir olduğunu belirtmektedir.
Finansman: İncelenen PDF'de ayrı bir finansman beyanı raporlanmamaktadır.
CRediT/yazar katkıları: İncelenen PDF'de yazar bazında CRediT katkı beyanı verilmemektedir.
Kaynak içi gösterim tutarsızlığı: Denklem (3) görselinde \(LPS^{i}\), ilgili açıklama metninde ise düşük geçiren filtre için \(LPF^{i}\) yazımı kullanılmaktadır. Kaynak bu farklılığın nedenini açıklamamaktadır.
Kaynak içi sonuç tutarsızlığı: Metin LOLv2-Real üzerinde D2SNet'in PSNR, SSIM ve LPIPS'in üçünde de en iyi olduğunu söylerken Tablo 1'de CWNet'in LPIPS değeri 0.063, D2SNet'in değeri 0.076'dır. LPIPS için daha düşük değer tercih edildiğinden Verianla değerlendirmesinde tablo değerleri esas alınmıştır.
Yöntemsel sınır: Sonuçlar öğrenilmiş bir görüntü restorasyon modelinin seçilmiş benchmark veri kümelerindeki performansına dayanır. Hakem değerlendirmesi, bağımsız yeniden üretim, farklı donanım gecikme ölçümleri ve geniş saha doğrulaması bu kaynak tarafından gösterilmemektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir