

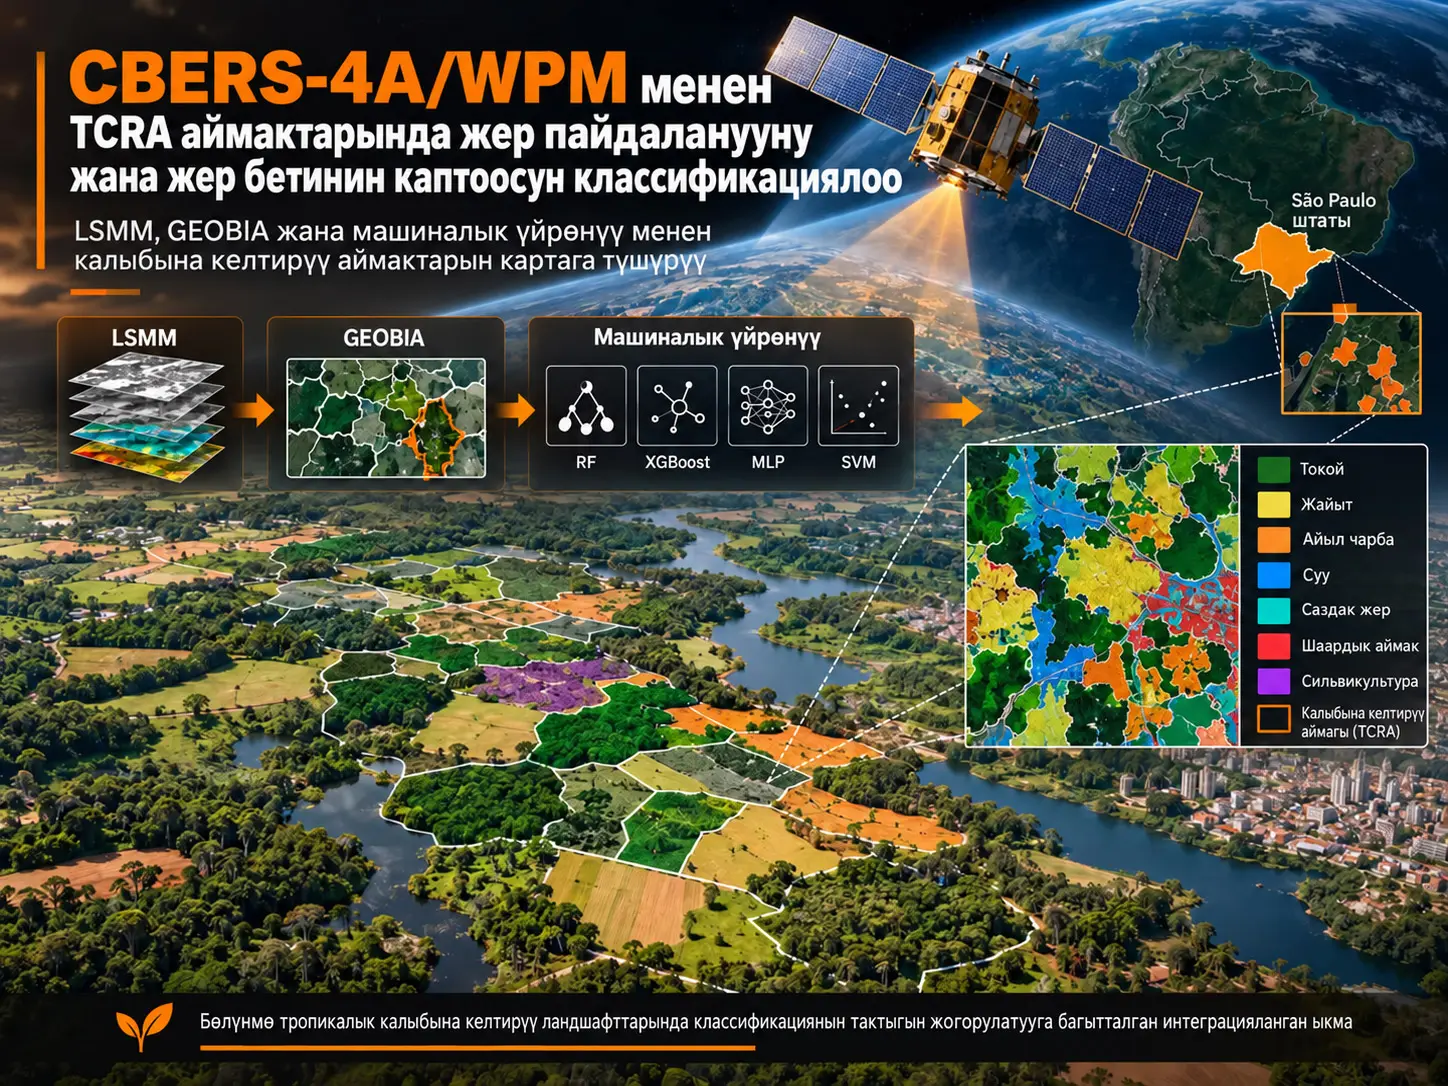
Экологиялык калыбына келтирүү аймактарын спутникттик сүрөттөр аркылуу көзөмөлдөө бир бүтүн жана бир тектүү токойлорду картага түшүрүүгө караганда кыйыныраак болушу мүмкүн. Айрыкча тропикалык аймактарда чакан токой тилкелери, жайыт, айыл чарба жерлери, жылаңач топурак, суу, саздак жерлер жана шаардык беттер кыска аралыкта жанаша жайгашышы мүмкүн. Бир спутникттик пиксел бул беттердин бир нечесин бир убакта камтыганда пайда болгон спектралдык аралашуу жер пайдалануу жана жер бетинин каптоосун классикалык классификациялоону бүдөмүк кылышы мүмкүн.
Бул изилдөө Бразилиянын São Paulo штатындагы Environmental Restoration Commitment Agreement (TCRA) аймактарын картага түшүрүү үчүн CBERS-4A/WPM спутникттик сүрөттөрүн, Linear Spectral Mixture Model (LSMM), Geographic Object-Based Image Analysis (GEOBIA) жана төрт түрдүү көзөмөлдөнүүчү машиналык үйрөнүү алгоритмин бир эле талдоо чынжырында бириктирет.
Изилденген аймак 47 муниципалитетти жана 902 TCRA полигонун камтыйт. CBERS-4A/WPMдин 8 m ажыратуу жөндөмүндөгү мультиспектралдык тилкелери 2 m панхроматикалык тилке менен pan-sharpening аркылуу иштетилип, 2 m көп тилкелүү жумушчу сүрөттөр алынган. Андан кийин ар бир сүрөт объектиси үчүн чийки спектралдык тилкелерге кошумча LSMM аркылуу өсүмдүк, топурак жана көлөкө фракциялары эсептелип, жалпысынан 63 белги түзүлгөн.
Random Forest, XGBoost, Multilayer Perceptron жана Support Vector Machine моделдери бир эле маалымат түзүмүндө салыштырылган. Random Forest Top-k белгилерди тандоо тажрыйбасында болжол менен 0,66 менен эң жогорку overall accuracy көрсөткүчүнө жеткен. Бирок макаланын кийинки жыйынтыктоочу көп метрикалуу баалоосунда XGBoost болжол менен 0,41 F1 жана 0,41 Kappa менен тең салмактуураак натыйжа көрсөткөн; RF болсо болжол менен 0,58 менен эң жогорку precision көрсөткүчүн берген. Булактын Abstract жана Conclusion бөлүмдөрүндөгү RF=0,66 натыйжасы менен final comparative evaluation бөлүмүндөгү RF≈0,62 / XGB≈0,63 айырмасы толук дал келбегендиктен, бул эки баалоо контексти өз-өзүнчө каралышы керек.
SHAP түшүндүрмөлүүлүк талдоосу өзгөчө LSMMден алынган өсүмдүк жана көлөкө фракциялары класстарды ажыратууга олуттуу салым кошконун көрсөткөн. Натыйжада изилдөө татаал калыбына келтирүү ландшафттарында жалаң чийки спутникттик тилкелерди колдонбой, субпикселдик курамды, объекттик түзүлүштү жана машиналык үйрөнүүнү бирге баалоо жер бетин кеңири чагылдырууга мүмкүнчүлүк берерин көрсөтөт.
Тропикалык калыбына келтирүү аймактарын спутник аркылуу классификациялоо эмне үчүн кыйын?
Жерди аралыктан зонддоо классификациясында идеалдуу шарт — ар бир пикселдин жер бетинин бир гана каптоо классын көрсөтүшү. Реалдуу тропикалык калыбына келтирүү ландшафттарында бул божомол көп учурда аткарылбайт.
Чакан калыбына келтирүү полигонунун ичинде же айланасында жаш өсүмдүк, жетилген токой, жайыт, айыл чарба жерлери, ачык топурак жана жолдор жанаша жайгашышы мүмкүн. Сенсор өлчөгөн электромагниттик сигнал бул беттердин геометриялык чектерин так кайталабайт; айрыкча өтмө зоналарда бир пиксел бир нече беттик компоненттин жалпы спектралдык сигналын камтышы мүмкүн.
Бул көйгөй mixed pixel — аралаш пиксел деп аталат. Аралаш пиксел — бир эле санарип сүрөт уячасы бир нече физикалык жер бетинин каптоо компонентин көрсөтүшү.
Ошондуктан изилдөөнүн чечүү ыкмасы бир гана метод менен чектелбейт:
CBERS-4A/WPM → Pan-sharpening → LSMM → GEOBIA → Белгилерди интеграциялоо → RF / XGBoost / MLP / SVM → Accuracy + F1 + Confusion Matrix + SHAP
TCRA деген эмне?
TCRA макалада Environmental Restoration Commitment Agreement термининин кыскартылышы катары колдонулат. Анын португал тилиндеги түп нуска аталышы Termos de Compromisso de Recuperação Ambiental.
Булар Бразилияда экологиялык мыйзамдардын алкагында бузулган аймактарды калыбына келтирүүгө байланыштуу милдеттенмелерди, мөөнөттөрдү жана мониторинг талаптарын аныктаган укуктук инструменттер. Изилдөөнүн максаты бул келишимдердин укуктук жарактуулугун баалоо эмес; калыбына келтирүү аймактарында кандай жер бетинин каптоо түрлөрү бар экенин спутникттик сүрөттөр аркылуу системалуу картага түшүрүү.
Изилдөө аймагы
Изилдөө São Paulo штатында TCRA тыгыздыгы жогору жана ландшафт түзүлүшү татаал болгон 47 муниципалитетти камтыйт. Аймактын олуттуу бөлүгү Атлантика токой биомунун ичинде жайгашкан; жергиликтүү токой, жайыт, айыл чарба аянттары, шаардык беттер жана калыбына келтирүүнүн ар кандай баскычтары бир эле ландшафтта кездешет.
| TCRA аймагынын өзгөчөлүгү | Булактагы мааниси |
|---|---|
| Изилденген TCRA полигону | 902 |
| Минималдуу аянт | 0,27 ha |
| Максималдуу аянт | 8,76 ha |
| Орточо аянт | 6,02 ha |
| Аянттын стандарттык четтөөсү | 1,86 ha |
| Аянттын дисперсиясы | 3,40 ha |
Бул чакан жана бөлүкчөлөнгөн аймак түзүлүшү классификациянын эмне үчүн кыйын экенине түз таасир этет. Чакан полигондордо чек ара пикселдеринин үлүшү көбөйөт жана айланадагы айыл чарба же жайыт сыяктуу класстардын сигналдары калыбына келтирүү аймагынын ичиндеги спутникттик өлчөөгө таасир этиши мүмкүн.
CBERS-4A/WPM сүрөтү кантип 2 метр ажыратуу жөндөмүнө жеткирилди?
CBERS-4A/WPM сенсору төрт мультиспектралдык канал берет: Blue, Green, Red жана Near Infrared (NIR). Алардын баштапкы мейкиндиктик ажыратуу жөндөмү 8 m. Сенсордо ошондой эле 2 m ажыратуу жөндөмүндөгү панхроматикалык тилке бар.
Изилдөөдө радиометриялык жана геометриялык оңдоолордон кийин pan-sharpening колдонулган. Бул процесс мультиспектралдык тилкелердин түс/спектралдык маалыматын панхроматикалык тилкенин жогорку мейкиндиктик деталдуулугу менен бириктирип, талдоо үчүн 2 m ажыратуу жөндөмүндөгү мультиспектралдык сүрөттөрдү түзгөн.
Бул жерде маанилүү техникалык айырма — pan-sharpening процесси сенсордун баштапкы мультиспектралдык өлчөөсүн физикалык жактан жаңы 2 m мультиспектралдык сенсор өлчөөсүнө айландырбайт. Алынган сүрөт 8 m спектралдык маалымат менен 2 m панхроматикалык деталдын биригүүсү.
LSMM пикселдин ичинде эмне бар экенин кантип көрсөтөт?
Linear Spectral Mixture Model бир пикселдин өлчөнгөн спектралдык сигналын негизги беттик компоненттердин салмакталган аралашмасы катары көрсөтөт. Жөнөкөйлөштүрүлгөн түрдө:
\[ R_{\lambda} = \sum_{i=1}^{n} f_i r_{i,\lambda} + \varepsilon_{\lambda} \]
Бул жерде \(R_{\lambda}\) белгилүү толкун узундугунда байкалган пикселдин чагылуусун; \(r_{i,\lambda}\) негизги беттик компоненттин спектралдык кол тамгасын; \(f_i\) ошол компоненттин пиксел ичиндеги үлүшүн; \(\varepsilon_{\lambda}\) болсо моделдин калдык катасын көрсөтөт.
Бул изилдөөдө LSMM үч негизги фракцияны түзгөн:
| LSMM компоненти | Көрсөткөн маалыматы |
|---|---|
| Vegetation fraction | Пиксел ичиндеги жашыл өсүмдүктүн үлүшү |
| Soil fraction | Ачык/топурак бетинин үлүшү |
| Shadow fraction | Көлөкө жана төмөн жарыктануу компоненти |
Ошентип модель классификаторго “бул пиксел жашыл көрүнөт” деген маалыматты гана эмес, ошол эле пикселдеги ар кандай беттик компоненттердин болжолдуу үлүштөрүн да бере алат.
GEOBIA пикселдик классификациядан эмнеси менен айырмаланат?
GEOBIA — Geographic Object-Based Image Analysis — ар бир пикселди толугу менен өз алдынча баалоонун ордуна кошуна жана окшош пикселдерди мейкиндиктик объекттер түрүндө топтойт.
Мунун аркасында классификацияга пикселдин түсү же чагылуусу гана эмес, объекттин текстурасы, формасы, кошуналаштыгы, таралышы жана контексттик маалыматы да кошулат.
Изилдөөдө Orfeo Toolbox 9.1.1 QGIS чөйрөсүндө колдонулуп, сегментация үчүн:
| GEOBIA параметри | Маани |
|---|---|
| Scale | 10 |
| Shape | 0,05 |
| Compactness | 0,5 |
маанилери колдонулган. Төмөн shape салмагы геометриялык формадан көрө спектралдык окшоштукка артыкчылык берүү үчүн тандалган.
63 белги кантип түзүлдү?
Төрт баштапкы спектралдык топ жана үч LSMM фракция тобу биригип жети негизги өзгөрмө тобун түзгөн:
Blue + Green + Red + NIR + Soil + Vegetation + Shadow
Ар бир топ үчүн тогуз статистикалык сүрөттөгүч эсептелген:
минимум, максимум, орточо, стандарттык четтөө, p05, p25, p50, p75 жана p95.
Ошентип:
\[ 7 \times 9 = 63 \]
белги түзүлгөн.
Белгилерди тандоо классификацияга чейин кайталанма же аз маалымат алып жүргөн өзгөрмөлөрдүн таасирин азайтуу үчүн колдонулган.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Жер бетинин кайсы каптоо класстары колдонулган?
Классификация схемасы MapBiomas маалымдама системасына шайкеш түзүлүп, изилдөө аймагында сегиз негизги категория бааланган:
| Класс | Негизги мааниси |
|---|---|
| Forest Formation | Жергиликтүү/токой формациялары |
| Pasture | Жайыт жана чөптүү аянттар |
| Agriculture / Crops | Айыл чарба өндүрүш аянттары |
| Land Use Mosaic | Бир нече жер пайдалануу түрү аралашкан мозаикалар |
| Urban Area | Калктуу жана курулган чөйрө |
| Wetlands | Саздак жерлер |
| Water | Дарыя, көл, суу сактагыч жана башка суу беттери |
| Silviculture | Плантация / токой чарба өндүрүш аянттары |
Окутуу жана текшерүү кантип жүргүзүлдү?
Маалыматтар болжол менен %70 окутуу жана %30 текшерүү болуп бөлүнгөн. Forest Formation жана Pasture класстарында үлгүлөрдүн саны азчылык класстарга караганда кыйла көп болгондуктан, окутуу топтомуна balancing колдонулган.
Majority класстардан үлгүлөр азайтылып, азчылык класстардагы бар үлгүлөр сакталган. Класстар аралык үлгү көлөмүнүн вариация коэффициенти баштапкы 1,79 дан тең салмакталган окутуу топтомунда 0,49 га чейин төмөндөтүлгөн.
Текшерүү топтому болсо баштапкы класс бөлүштүрүүсү менен калтырылган. Бул тандоо моделдин табигый тең эмес класс түзүмүндө кандай иштей турганын өлчөөгө багытталган.
Төрт машиналык үйрөнүү модели
| Модель | Булакта колдонулган негизги түзүм |
|---|---|
| Random Forest | 500 чечим дарагы; максималдуу тереңдик окутуу маалында оптималдаштырылган. |
| XGBoost | Learning rate = 0,1; maximum depth = 6. |
| SVM | Radial Basis Function (RBF) kernel. |
| MLP | Бир жашыруун катмар; 100 нейрон. |
Random Forest чындап эле изилдөөнүн эң жакшы модели беле?
Булактын ар башка бөлүмдөрүндө эки башка баалоо контексти бар болгондуктан, бир сөз менен жооп берүү туура эмес.
Top-k белгилерди тандоо тажрыйбасында Random Forest тактыгы бир гана белги колдонулганда болжол менен 0,40 тан башталып, болжол менен 10 белги чамасында 0,60 тан ашып, болжол менен 30 белги чамасында болжол менен 0,66 менен максимумга жеткен. Көбүрөөк белги кошуу олуттуу кошумча пайда берген эмес, көрсөткүч бир аз төмөндөгөн.
Бул жыйынтык бардык 63 белги бирдей пайдалуу эмес экенин; маалымат алып жүргөн салыштырмалуу чакан белги топчосу көрсөткүчтүн негизги бөлүгүн камсыздай аларын көрсөтөт.
Ошол эле учурда макаланын final comparative evaluation бөлүмүндө төмөнкү көрүнүш берилген:
| Модель | Final бөлүмдө көрсөтүлгөн маанилүү метрикалар |
|---|---|
| RF | Precision ≈ 0,58; Recall ≈ 0,33; F1 ≈ 0,38; final OA текстинде ≈ 0,62 |
| XGBoost | F1 ≈ 0,41; Kappa ≈ 0,41; Recall ≈ 0,40; OA ≈ 0,63 |
| MLP | F1 ≈ 0,40; Kappa ≈ 0,39; OA ≈ 0,63/0,62 контекстке жараша |
| SVM | Precision ≈ 0,24; Recall ≈ 0,43; F1 ≈ 0,14; Kappa ≈ 0,06; OA ≈ 0,10 |
Булактын Abstract жана Conclusion бөлүмдөрүндө болсо RF=0,66, XGB=0,63, MLP=0,62 жана SVM=0,10 түрүндө жалпы тактык ирети берилет.
Ошондуктан Verianla үчүн эң ишенимдүү чечмелөө RF Top-k белгилерди тандоодо эң жогорку чоку тактыкты, ал эми XGBoost жыйынтыктоочу көп метрикалуу баалоодо тең салмактуураак натыйжаларды берген деген формада. Булактын ар кайсы бөлүктөрүндөгү сандар толугу менен бирдей эмес жана жаңы бир “туура” маанини түзүү үчүн аларды унчукпай бириктирүүгө болбойт.
Эмне үчүн overall accuracy гана жетишсиз?
Класстар тең көлөмдө болбогондо overall accuracy чоң класстардын ийгилигинен көбүрөөк таасир алышы мүмкүн. Мисалы, Forest Formation жана Pasture маалымат топтомунда кыйла көп көрсөтүлгөн.
Модель көпчүлүк класстарда ийгиликтүү, чакан класстарда начар болсо да жалпы accuracy салыштырмалуу жогору көрүнүшү мүмкүн. Ошондуктан изилдөө precision, recall, F1, Kappa, confusion matrix жана класс негизиндеги ROC/AUC өлчөмдөрүн бирге баалаган.
SVM бул айырманын жакшы мисалы. Recall болжол менен 0,43 болуп, башка моделдерден төмөн эмес; бирок precision болжол менен 0,24 жана F1 болжол менен 0,14. Демек, ал көптөгөн чыныгы класс үлгүлөрүн таба алганы менен, көп сандагы туура эмес класс дайындоолорун жасайт.
Кайсы класстар оңойураак ажыратылды?
XGBoostтун one-vs-rest ROC талдоосунда:
| Класс | AUC |
|---|---|
| Water | 0,99 |
| Silviculture | 0,93 |
| Crops | 0,90 |
| Urban Area | 0,81 |
| Forest Formation | 0,79 |
| Pasture | 0,77 |
| Land Use Mosaic | 0,67 |
| Wetland | 0,67 |
Суу классынын жакшы ажыратылышы физикалык жактан түшүнүктүү; суу NIR аймагында кургактык беттеринен байкаларлык айырмаланган чагылуу жүрүм-турумун көрсөтөт.
Land Use Mosaic жана Wetland класстарында болсо бир объекттин ичинде бир нече беттик түр, өзгөрмө топурак нымдуулугу, өсүмдүк каптоосу жана мезгилдик шарттар кездешкендиктен, класс чек аралары бүдөмүгүрөөк.
SHAP талдоосу машиналык үйрөнүү эмнеге көңүл бурарын көрсөттүбү?
Машиналык үйрөнүү моделинин жөн гана туура же туура эмес натыйжа бериши экологиялык мониторинг үчүн жетишсиз. Колдонулган өзгөрмөлөр эмне үчүн моделге салым кошорун түшүнүү да маанилүү.
Изилдөө бул максатта SHAP — SHapley Additive exPlanations — ыкмасын колдонгон.
Глобалдык SHAP талдоосунда LSMMден алынган өзгөрмөлөр эң маанилүү белгилердин катарына кирген. Айрыкча:
LSMM_vegetation_min
өзгөрмөсү күчтүү класс ажыраткыч катары бөлүнүп чыккан.
Forest Formation үчүн vegetation жана shadow фракциялары маанилүү болсо, Water классында NIR белгилери айкын болгон. Pasture классында топурак жана өсүмдүк фракцияларынын айкалышы; Urban жана Wetland сыяктуу гетерогендүү класстарда болсо белгилердин салымы көбүрөөк чачыранды болгон.
Көлөкө эмне үчүн токой көрсөткүчү болушу мүмкүн?
Көлөкө алгач сүрөт классификациясын бузган керексиз элемент катары кабылданышы мүмкүн. Бирок токойлордо көлөкө дарактын таажы түзүлүшү, тик катмарлануу, дарактын бийиктиги жана жарыктануу геометриясы жөнүндө кыйыр маалымат бере алат.
Ошондуктан LSMM shadow fraction айрым учурларда токойду өсүмдүк каптоосу бир калыпта жана жапыз болгон жайыт сыяктуу класстардан ажыратууга жардам бере алат.
Белгилердин саны эмне үчүн чексиз көбөйтүлбөшү керек?
Top-k тажрыйбасы көрсөткүч алгачкы белгилер менен тез өскөнүн, болжол менен 30 белги чамасында чокусуна жеткенин жана андан кийин жаңы өзгөрмөлөрдү кошуу өтө аз пайда бергенин көрсөткөн.
Мындан тышкары, корреляция талдоосу бир эле спектралдык тилкенин ар кандай процентилдеринен жана статистикаларынан алынган көптөгөн белгилер бири-бири менен жогорку деңгээлде байланышта болушу мүмкүн экенин көрсөтөт.
Бул көрүнүш белгилердин көп болушу автоматтык түрдө маалыматтын көп болушун билдирбей турганын көрсөтөт. Керексиз же бири-бирин кайталаган өзгөрмөлөр эсептөө чыгымын көбөйтүп, моделге ызы-чуу кошушу мүмкүн.
Бул система калыбына келтирүүнүн ийгилигин автоматтык түрдө далилдейби?
Жок. Модель LULC классификация системасы. TCRA полигону белгилүү бир учурда “Forest Formation”, “Pasture” же башка класс катары көрүнүшү калыбына келтирүүнүн бардык экологиялык максаттары ийгиликтүү аткарылганын өзүнөн-өзү далилдебейт.
Экологиялык калыбына келтирүүнүн ийгилиги түр курамы, табигый регенерация, жашоо чөйрөсүнүн сапаты, экосистемалык функциялар, топурак шарттары жана убакыт ичиндеги өнүгүү сыяктуу кеңири критерийлерди талап кылышы мүмкүн.
Бул ыкманын негизги мүмкүнчүлүгү — көп сандагы калыбына келтирүү аймактарын аймактык масштабда тезирээк жана төмөн чыгым менен алдын ала скринингден өткөрүү жана талаа текшерүүлөрүн багыттоо.
Изилдөөнүн эң маанилүү чектөөсү
Моделдин көрсөткүчү бир гана train-validation бөлүнүшү боюнча берилген. Бул ыкма көз карандысыз текшерүү топчосун бергени менен, маалымат башкача бөлүнгөндө натыйжа канчалык өзгөрөрүн көрсөтпөйт.
Авторлор келечекте:
- k-fold cross-validation,
- spatially stratified validation,
- убакыт катарындагы спутникттик сүрөттөр,
- жогорку мейкиндиктик ажыратуу жөндөмү,
- кеңири жана тең салмакталган маалымдама маалыматтары,
- альтернативдүү машиналык жана терең үйрөнүү ыкмалары
колдонулушун сунушташат.
Демек, бул изилдөөдөгү accuracy жана AUC маанилери башка жылдар, башка CBERS сахналары же башка тропикалык өлкөлөр үчүн күтүлүүчү көрсөткүч катары түздөн-түз колдонулбашы керек.
Булак жана Ыкма Жөнүндө Эскертүү
Түп нуска аталышы: CBERS 4A/WPM Image Classification for Mapping Land Use and Land Cover in TCRAs
Авторлор: Carla Rodrigues Santos; Francisco Salazar; Fernanda Beatriz Jordan Rojas Dallaqua; Bruno Schultz.
Corresponding authors: Carla Rodrigues Santos жана Francisco Salazar.
Мекемелер: Grupo de Pesquisa DEGET da Unemat, Sinop, Mato Grosso, Brazil; Visiona Tecnologia Espacial S.A., São José dos Campos, São Paulo, Brazil.
Журнал: Geographies.
Басмакана: MDPI.
Библиографиялык жазуу: Geographies 2026, 6, 84.
DOI:10.3390/geographies6030084
Күндөр: Жөнөтүлгөн 3 июнь 2026; оңдолгон 16 август 2026; кабыл алынган 19 август 2026; жарыяланган 1 сентябрь 2026.
Булактын түрү: Жерди аралыктан зонддоого жана көзөмөлдөнүүчү машиналык үйрөнүүгө негизделген жер пайдалануу/жер бетинин каптоосун классификациялоо изилдөөсү.
Лицензия: Creative Commons Attribution (CC BY).
Изилдөө аймагы: São Paulo штатындагы 47 муниципалитет жана 902 TCRA полигону; негизинен Атлантика токой биому.
Спутникттик маалымат: CBERS-4A/WPM; төрт 8 m мультиспектралдык тилке + 2 m панхроматикалык тилке; pan-sharpeningден кийин 2 m талдоо сүрөтү.
Белгилер архитектурасы: Blue, Green, Red, NIR + LSMM soil, vegetation жана shadow фракциялары; тогуз статистикалык сүрөттөгүч менен жалпысынан 63 белги.
Машиналык үйрөнүү: Random Forest, XGBoost, Multilayer Perceptron жана Support Vector Machine.
Текшерүү: Болжол менен %70 окутуу / %30 көз карандысыз validation; окутуу топтомунда majority-class азайтууга негизделген balancing; validation бөлүштүрүүсү сакталган.
Түшүндүрмөлүүлүк: SHAP менен глобалдык жана класс негизиндеги белгилердин салымы каралган.
Негизги методологиялык чектөө: Бир гана train-validation split колдонулушу жана мейкиндиктик cross-validation болбошу көрсөткүч бааларынын жалпылануусун чектейт.
Булак ичиндеги натыйжа эскертүүсү: Abstract жана Conclusion RFти OA≈0,66 менен эң жогорку модель деп көрсөткөнү менен, кеңири final comparison бөлүмүндө RFтин Top-k тажрыйбасындагы 0,66 чоку маанисинен өзүнчө final OA≈0,62; XGBoost жана MLP үчүн ≈0,63 маанилери берилет. Ошол эле бөлүм XGBoostту F1/Kappa боюнча тең салмактуураак деп чечмелейт. Бул Verianla тексти эки контекстти аралаштырбайт.
Каржылоо: FAPESP — São Paulo Research Foundation, grant 2024/19134-1, Innovative Research in Small Business.
Маалыматтын жеткиликтүүлүгү: Изилдөөнүн түп нуска салымдары макаланын ичинде берилгени, кошумча маалымат суроолору corresponding authors дарегине жөнөтүлүшү мүмкүн экени көрсөтүлгөн.
Кызыкчылыктардын кагылышы / мекеме байланышы: Francisco Salazar Visiona Tecnologia Espacial S.A. кызматкери экени жарыяланган; башка авторлор коммерциялык же каржылык кызыкчылыктардын кагылышын билдиришкен эмес.
Техникалык колдоо: Visiona Tecnologia Espacial S.A. техникалык колдоо көрсөткөн; CETESB техникалык сунуштарды берген.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген