

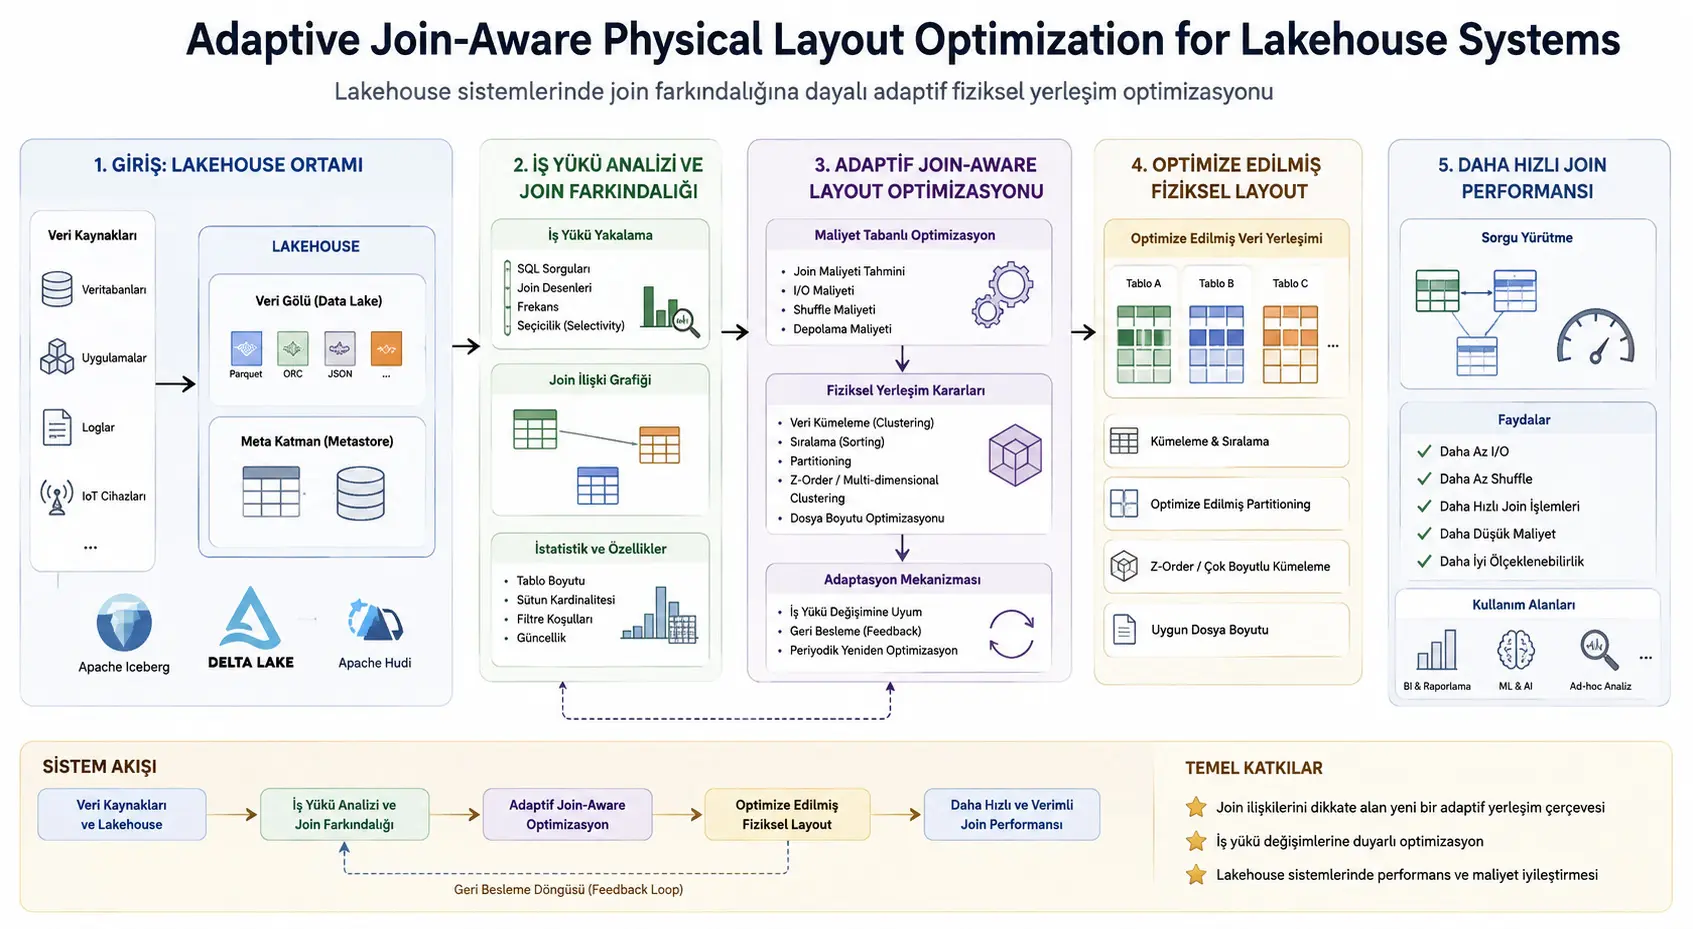
Ushbu tadqiqot ochiq manbali Delta Lake ustida jadvallarni qaysi ustunlar bo‘yicha jismonan klasterlash kerakligini so‘rovlar tarixidan avtomatik tanlaydigan AJLO nomli tizimni taklif qiladi. AJLO ma’lum vaqt oralig‘ida bajarilgan so‘rovlarni tahlil qilib, jadvallar o‘rtasidagi join munosabatlaridan vaznli grafik tuzadi; har bir munosabatni so‘rov chastotasi, ma’lumot hajmi va bajarish xarajatini birgalikda hisobga oladigan Join Importance Score bilan tartiblaydi. So‘ng cheklangan qayta yozish byudjeti ostida tez-tez birgalikda ishlatiladigan jadvallar uchun mos Liquid Clustering kalitlarini tanlaydi.
TPC-H Scale Factor 1 ustida o‘tkazilgan tajribalarda AJLO barcha so‘rovlar bo‘yicha o‘rtacha hisobda har bir so‘rov uchun skanerlangan ma’lumot miqdorini 46 MB darajasiga tushirgan. Hech qanday ishlov berilmagan Delta Lake joylashuvida bu qiymat 51 MB, sana kabi jadvalga xos filtr ustunlari bo‘yicha statik klasterlangan joylashuvda esa 117 MB deb bildirilgan. Join og‘ir Q01–Q07 so‘rovlarida AJLO statik filtr ustuni klasterlashiga nisbatan skanerlangan baytlarni %86,7 ga kamaytirgan. O‘rtacha so‘rov kechikishi AJLO’da 0,6 soniya, statik klasterlashda 1,0 soniya va tartiblanmagan boshlang‘ich tuzilmada 1,2 soniya bo‘lgan.
AJLO’ning asosiy afzalligi har bir jadvalni mustaqil tartibga solish o‘rniga bir xil join kalitidan foydalanadigan jadvallarni birgalikda baholashidir. Biroq tizim Spark almashinuvi yoki shuffle jarayonini yo‘q qilmaydi. Yutuq join boshlanishidan oldin min–maks fayl statistikasi yordamida ko‘proq faylni o‘tkazib yuborish va almashinuv bosqichiga kamroq ma’lumot yetib borishidan kelib chiqadi. Yondashuv ayniqsa ikkita katta jadval Sort-Merge Join bilan birlashtiriladigan so‘rovlarga qaratilgan; kichik jadval to‘liq tarqatiladigan Broadcast Hash Join operatsiyalarida xuddi shunday joylashuv foydasi kutilmaydi.
Turkiya nuqtai nazaridan: AJLO yondashuvi ochiq manbali Apache Spark va Delta Lake’dan foydalanadigan Turkiyadagi bank, telekommunikatsiya, elektron tijorat, logistika, davlat analitikasi va katta ma’lumot platformalarida jismoniy jadval joylashuvini avtomatik baholash uchun tadqiq qilinishi mumkin. Biroq tadqiqot taxminan 1 GB hajmdagi TPC-H ma’lumotlarini bitta noutbukda o‘rgangan. Turkiyadagi ishlab chiqarish muhitlariga ko‘chirishdan oldin uni terabayt yoki petabayt miqyosidagi taqsimlangan klasterlarda, tashkilotning haqiqiy so‘rovlar tarixi bilan, qayta yozish xarajatlari va bir vaqtda bajariladigan ma’lumot yuklash jarayonlarini ham qo‘shgan holda tekshirish kerak. Tadqiqotdan ma’lum bir turk tashkiloti %86,7 kamroq ma’lumot skanerlaydi yoki so‘rovlari %40 tezlashadi degan xulosa bevosita chiqarib bo‘lmaydi.
Lakehouse tizimlaridagi jismoniy joylashuv muammosi nima?
Lakehouse arxitekturasi ma’lumot ko‘llarining arzon va ochiq fayl tuzilmasini ma’lumot omborlarining tranzaksiya ishonchliligi va so‘rov imkoniyatlari bilan birlashtirishni maqsad qiladi. Delta Lake bu tuzilmada odatda Parquet fayllaridan foydalanadi va har bir fayl uchun ustunlarning eng kichik va eng katta qiymatlari kabi statistikalarni saqlaydi. So‘rov sharti ma’lum faylning qiymat oralig‘i bilan kesishmasa, Spark bu faylni o‘qimasdan tashlab ketishi mumkin. Ushbu mexanizm file skipping, ya’ni faylni o‘tkazib yuborish deb ataladi.
Liquid Clustering o‘xshash kalit qiymatlariga ega satrlarni Hilbert egri chizig‘i lokalitetidan foydalanib yaqin fayllarga jamlashga harakat qiladi. Masalan, buyurtmalar jadvali buyurtma sanasi bo‘yicha klasterlansa, ma’lum sana oralig‘ini so‘raydigan so‘rovlar ko‘p faylni o‘tkazib yuborishi mumkin. Ammo shu jadval buyurtma raqami bo‘yicha filtrlanib boshqa jadval bilan buyurtma raqami orqali join qilinsa, sana bo‘yicha joylashuv foyda bermasligi mumkin; bir xil buyurtma kaliti oralig‘i deyarli barcha sana fayllariga tarqalgan bo‘lishi mumkin.
Shu sababli “eng ko‘p filtrlanadigan ustunni tanla” yondashuvi join og‘ir analitik ish yuklarida noto‘g‘ri jismoniy joylashuv yaratishi mumkin. Bundan tashqari, to‘g‘ri ustun vaqt o‘tishi bilan o‘zgarishi mumkin. Bugun buyurtma sanasi so‘rovlari ustun bo‘lsa, keyingi davrda buyurtma–pozitsiya yoki mijoz–buyurtma joinlari ustun bo‘lishi mumkin.
Tadqiqot baholagan ochiq manbali Delta Lake tartibida o‘zgaruvchan so‘rov naqshlariga ko‘ra Liquid Clustering kalitlarini avtomatik va jadvallararo muvofiqlashtirilgan tarzda tanlaydigan mexanizm yo‘q deb qabul qilinadi. AJLO ushbu bo‘shliqni so‘rovlar tarixidan o‘rganilgan join grafigi bilan to‘ldirishni maqsad qiladi.
Join kaliti bo‘yicha birgalikda klasterlash nega muhim?
Agar so‘rov orders va lineitem jadvallarini orderkey orqali birlashtirib, shu kalit bo‘yicha tanlovchi interval shartini qo‘llasa, ikkala jadvalni ham shu kalit bo‘yicha klasterlash har ikki tomonda faylni o‘tkazib yuborishga imkon berishi mumkin. Faqat bitta jadvalni yoki ikkala jadvalni ham aloqasiz sana ustunlari bo‘yicha klasterlash xuddi shu foydani bermaydi.
Tadqiqot bir munosabatni “skanerlash nuqtai nazaridan moslashtirilgan” deb atash uchun ikki jadvalning jismoniy joylashuvi bir xil join ustunini qo‘llab-quvvatlashini talab qiladi. Har bir jadvalning joylashuvi quyidagi strategiya vektori bilan ko‘rsatiladi:
\[ \lambda(t)=\langle P_t,C_t\rangle \]
- \(P_t\), jadvalning katalogga asoslangan partition ustuni yoki bo‘sh qiymatdir.
- \(C_t\), Liquid Clustering ustunlari to‘plami yoki bo‘sh qiymatdir.
Delta Lake’da PARTITIONED BY va CLUSTER BY bitta jadvalda bir vaqtning o‘zida ishlatiladigan ikkita mustaqil joylashuv turi emas. Shu sababli rejalashtiruvchi mavjud joylashuvni o‘zgartirish xarajatini ham hisobga olishi kerak.
AJLO arxitekturasi qaysi tarkibiy qismlardan iborat?
Tadqiqotning 6. sahifasidagi 1-rasm tizimni uzluksiz qayta aloqa siklida ishlaydigan oltita asosiy komponent bilan ko‘rsatadi:
- Query Log Collector – QLC: SparkListener orqali tugallangan so‘rovlarning SQL matni, mantiqiy rejasi, bajarilish statistikasi va vaqt tamg‘asini to‘playdi. Standart sirg‘aluvchi oyna yetti kun.
- Join Graph Builder – JGB: So‘rov matnini to‘g‘ridan-to‘g‘ri parslash o‘rniga Spark’ning resolve qilingan mantiqiy rejasidan tenglikka asoslangan join munosabatlarini chiqarib oladi.
- Relationship Importance Estimator – RIE: Har bir join qirrasi uchun chastota, ma’lumot hajmi va xarajat o‘lchovlarini normallashtirib Join Importance Score’ni hisoblaydi.
- Multi-Table Layout Planner – MTLP: Byudjet ostida eng yuqori kutilayotgan sof foydani beradigan umumiy klasterlash yoki partitionlash nomzodlarini tanlaydi.
- Adaptive Reorganization Engine – ARE: Tanlangan rejani Delta Lake DDL buyruqlari va
OPTIMIZEoperatsiyalariga aylantiradi. - Cost-Based Optimization Layer – CBOL: Qayta tartibga solishdan so‘ng
ANALYZE TABLEishga tushirib fayl statistikalarini yangilaydi va natijalarni qayta aloqa sikliga uzatadi.
Bu komponentlardan tashqari Workload Drift Detector join munosabatlarining nisbiy ahamiyatida yetarli o‘zgarish yuz berganda rejalashtiruvchini qayta ishga tushiradi. Drift chegara qiymatidan past bo‘lsa, mavjud reja saqlanadi.
Join grafigi qanday tuziladi?
Har bir jadval grafikda tugun, ikki jadval orasidagi join munosabati esa qirra sifatida ko‘rsatiladi. Har bir qirra uchun uchta asosiy qiymat hisoblanadi:
- F(i,j): Sirg‘aluvchi vaqt oynasida ushbu joinni o‘z ichiga olgan so‘rovlar soni.
- D(i,j): Tegishli so‘rovlarda ikki jadval satrlar soni ko‘paytmasining o‘rtachasi.
- C(i,j): Ushbu joinni o‘z ichiga olgan so‘rovlarning o‘rtacha bajarilish xarajati.
So‘rov rejalaridan ustun kelib chiqishini aniqlash faqat SQL ichidagi nomlarni qidirishdan murakkabroq. Spark’ning resolve qilingan rejasida ustunlar ko‘pincha customer_id kabi nomlardan ko‘ra exprId identifikatorlari bilan ifodalanadi. Ushbu identifikatorlarni asl jadval va ustunlarga bog‘lash uchun Project, Alias, Filter va Subquery tugunlari bo‘ylab lineage kuzatiladi.
Join Importance Score qanday hisoblanadi?
AJLO normallashtirilgan chastota, ma’lumot hajmi va bajarish xarajatini ko‘paytiradi:
\[ JIS(i,j)=\widehat{F}(i,j)\times\widehat{D}(i,j)\times\widehat{C}(i,j) \]
Ma’lumot hajmi qiymatlari keng diapazonga tarqalishi mumkinligi sababli \(D\) normallashtirishdan oldin logarifmik masshtablanadi:
\[ \widehat{D}(i,j)= \frac{\log_{10}(D(i,j)+1)-\log_{10}(D_{\min}+1)} {\log_{10}(D_{\max}+1)-\log_{10}(D_{\min}+1)+\varepsilon} \]
Chastota va xarajat uchun standart minimum–maksimum normallashtirish qo‘llanadi:
\[ \widehat{X}(i,j)= \frac{X(i,j)-X_{\min}} {X_{\max}-X_{\min}+\varepsilon}, \qquad X\in\{F,C\} \]
Ko‘paytmali tuzilma uch o‘lchovdan istalgan biri nolga yaqinlashganda umumiy ball ham nolga yaqinlashishini ta’minlaydi. Shunday qilib, juda tez-tez bajariladigan, biroq kichik va arzon dimension jadval joini faqat yuqori chastotasi sabab qayta yozish byudjetining katta qismini olmaydi.
Tadqiqotdagi misol taqqoslashda chastotasi yuqori, biroq jadvallari kichik va tez bo‘lgan munosabatning ko‘paytmali balli 0,002, barcha o‘lchovlarda muvozanatli munosabatning balli esa 0,125 bo‘lgan. Qo‘shilmali formula xuddi shu misollarga mos ravishda 0,333 va 0,500 berib, arzon munosabat ahamiyatini nisbatan oshirib yuboradi.
JIS bevosita bayt tejami emas. U o‘lchovsiz ustuvorlik tartiblash signali. Iqtisodiy optimallashtirish maqsadi alohida ravishda taxminiy skanerlash kamayishi, qayta yozish xarajati va saqlash xarajati orqali hisoblanadi.
Multi-Table Layout Coordination muammosi qanday ta’riflanadi?
Tadqiqot jismoniy joylashuv qarorini Multi-Table Layout Coordination deb ataladigan byudjet bilan cheklangan sof joriy qiymat muammosi sifatida formulalaydi:
\[ \operatorname{NPV}(L)= \sum_{(i,j)\in E} \operatorname{ScanReduction}(i,j,L) \left( \frac{1-(1+r)^{-H}}{r} \right) -\operatorname{RewriteCost}(L) -\operatorname{StorageCost}(L) \]
Cheklovlar:
\[ \operatorname{RewriteCost}(L)\leq B \]
\[ \operatorname{StorageCost}(L)\leq S \]
- \(L\), tanlangan ko‘p jadvalli jismoniy joylashuv rejasidir.
- \(H\), rejalashtirish ufqidir.
- \(r\), har bir oyna uchun diskont stavkasidir.
- \(B\), qayta yozish byudjetidir.
- \(S\), saqlash byudjetidir.
Tadqiqotda xarajat va foyda atamalari baytlarda ifodalanadi. Tadqiqotchi muammo Maximum Weighted Coverage muammosidan reduksiya orqali NP-hard ekanini ta’kidlaydi. Shu sababli barcha mumkin bo‘lgan jadval va kalit kombinatsiyalarini ishlab chiqarish miqyosida to‘liq ko‘rib chiqish o‘rniga greedy yondashuv qo‘llanadi.
Dinamik greedy rejalashtiruvchi qanday ishlaydi?
Rejalashtiruvchi har bir join qirrasi uchun mavjud reja ostida eng yuqori sof joriy qiymatni beradigan nomzodni priority queue’ga joylaydi. Eng yuqori nomzod tanlangach, qayta yozish xarajati qolgan byudjetga mos bo‘lsa, reja qo‘llanadi.
Bir jadval uchun qaror qabul qilinganda shu jadvalga ulangan boshqa qirralarning ustuvorliklari qayta hisoblanadi. Bu muhim. Masalan, A jadvali B bilan order_id bo‘yicha klasterlangach, A–C munosabatining customer_id taklifi endi A jadvalini yana boshidan yozishni talab qilishi mumkin. Eski xarajat bilan hisoblangan ustuvorlik saqlansa, rejalashtiruvchi bir jadvalni ketma-ket qarama-qarshi kalitlarga ko‘chirishi mumkin.
Tadqiqotda zich star schema uchun eng yomon holat murakkabligi taxminan:
\[ O(|E|^2\cdot|C|\cdot\log|E|) \]
deb berilgan. Tugun darajasi past bo‘lgan odatiy siyrak sxemalarda esa:
\[ O(|E|\cdot|C|\cdot\log|E|) \]
darajasiga yaqinlashadi.
Qayta tartibga solish qanday amalga oshiriladi?
Liquid Clustering kaliti o‘zgartirilganda tavsiya etilgan operatsiya ketma-ketligi quyidagicha:
ALTER TABLE tablo CLUSTER BY (sutun);
OPTIMIZE tablo;
ANALYZE TABLE tablo;
Liquid Clustering bilan katalogga asoslangan partitionlash orasida o‘tish qilinsa, avval mavjud klasterlash olib tashlanishi, keyin yangi jismoniy joylashuv aniqlanishi va jadval qayta yozilishi kerak.
Tadqiqot OPTIMIZE operatsiyalari bir vaqtda ishlayotgan ETL writerlar bilan to‘qnashishi mumkinligini ta’kidlaydi. Delta transaction log’dagi optimistic concurrency control ConcurrentAppendException yoki ConcurrentDeleteReadException chiqarishi mumkin. AJLO bunday holatda ortib boruvchi kutish bilan qayta urinish, eng yangi jadval snapshotini o‘qish va rejani qayta baholash yondashuvini taklif qiladi.
Qayta klasterlashdan keyin statistikalarni yangilamaslik yangi fayllarning eski ustun statistikasi bilan baholanishiga olib kelishi mumkin. Shu sababli ANALYZE TABLE faylni o‘tkazib yuborish mexanizmi yangi kalitdan foydalana olishi uchun tizim siklining majburiy qismi sifatida qaraladi.
AJLO qaysi so‘rov turlarida samarali bo‘lishni maqsad qiladi?
Tizim ikkita katta jadval Sort-Merge Join bilan birlashtiriladigan so‘rovlarga qaratilgan. Bunday so‘rovlarda ikkala jadvaldan o‘qilgan satrlar almashinuv bosqichiga kirishdan oldin jismoniy fayllardan skanerlanadi. Mos kalit bo‘yicha klasterlash kamroq fayl o‘qilishini ta’minlashi mumkin.
AJLO Spark’ning ClusteredDistribution talabini qondirmagani uchun shuffle jarayonini yo‘q qilmaydi. Catalyst baribir Exchange tugunini qo‘shadi. Yaxshilanish Exchange’ga kiradigan ma’lumot miqdorining kamayishidir.
Adaptive Query Execution almashinuv bosqichlaridan keyin real statistikaga ko‘ra bajarish rejasini o‘zgartirishi mumkin. Ammo AQE ishga tushganda manba fayllari allaqachon o‘qilgan bo‘ladi. Shu sababli AJLO va AQE bir xil xarajatni nishonga olmaydi:
- AJLO saqlash qatlamidan manba o‘qish xarajatini kamaytirishni maqsad qiladi.
- AQE bajarish vaqtida reja va almashinuv bosqichlarini moslashtirishni maqsad qiladi.
Agar so‘rov bajarish vaqtida Broadcast Hash Join’ga aylantirilsa, kichik tomon to‘liq tarqatiladi va birgalikdagi klasterlash xuddi shu fayl skanerlash foydasini bermasligi mumkin. Shu sababli tadqiqot optimallashtirish doirasini Sort-Merge Join hududida qoladigan munosabatlar bilan cheklagan.
Workload drift qanday aniqlanadi?
Ketma-ket ikki vaqt oynasidagi join grafiklari orasidagi o‘zgarish qirralarning JIS qiymatlari normallashtirilgan farqlarining o‘rtachasi bilan o‘lchanadi:
\[ \operatorname{Drift}(G_k,G_{k+1})= \frac{1}{|E_k\cup E_{k+1}|} \sum_{(i,j)\in E_k\cup E_{k+1}} \frac{ |JIS_k(i,j)-JIS_{k+1}(i,j)| }{ \max(JIS_k(i,j),JIS_{k+1}(i,j),\varepsilon) } \]
Standart chegara \(\delta=0{,}10\). Chegara oshsa, reja qayta baholanadi. Yangi davrda ilk bor paydo bo‘lgan join munosabatlariga bevosita yuqori qayta baholash ustuvorligi beriladi.
Tajriba muhiti qanday tayyorlangan?
Barcha tajribalar Apple M1 protsessorli va 8 GB unified memory’ga ega bitta noutbukda o‘tkazilgan. Asosiy konfiguratsiya quyidagicha:
- Apache Spark 4.0.0, mahalliy
local[8]rejimi - Delta Lake 3.2.0
- PySpark 4.0.0
- 6 GB driver xotirasi
- 50 shuffle partition
- Adaptive Query Execution yoqilgan
- Broadcast threshold 10 MB
- Maqsadli Delta fayl hajmi 2 MB
TPC-H Scale Factor 1 ma’lumotlari maxsus Python generatori bilan tayyorlangan. Orders, lineitem, customer, supplier, part, partsupp, nation va region kabi sakkizta jadval ishlatilgan. Har bir konfiguratsiya besh marta ishga tushirilgan va median qiymatlar hisobot qilingan.
Maqsadli fayl hajmining 2 MB tanlanishi tajriba dizaynidagi muhim tafsilot. Standart 128 MB ishlatilganda Scale Factor 1 jadvallarida faqat bir yoki ikki fayl hosil bo‘ladi va file skipping darajasini mazmunli o‘lchab bo‘lmaydi. Ikki megabaytlik fayllar ancha ko‘p fayl hosil qilib, kalit tanlovining ta’sirini ko‘rinadigan qilgan. Biroq bu tanlov tajriba muhitini ishlab chiqarish tizimlaridagi odatiy fayl hajmlaridan uzoqlashtiradi.
Qaysi asosiy joylashuvlar taqqoslangan?
| Joylashuv | Izoh |
|---|---|
| B0 | Hech qanday jismoniy joylashuv optimallashtirilmagan xom Delta Lake jadvallari |
| B2 | Har bir jadval uchun sana kabi tez-tez filtrlanadigan ustunlarda bir marta o‘rnatilgan va o‘zgartirilmaydigan statik Liquid Clustering |
| AJLO | So‘rovlar tarixidagi ustun join munosabatlariga ko‘ra jadvallararo muvofiqlashtirilgan kalit tanlovi |
Hive uslubidagi katalog partitionlash taqqoslashdan chiqarilgan. Tadqiqotning maqsadi Liquid Clustering bilan an’anaviy Hive partitionlashni qayta taqqoslash emas, balki xuddi shu Liquid Clustering infratuzilmasida tanlangan ustunning ta’sirini o‘lchashdir.
Skanerlangan ma’lumot miqdorida nima topildi?
2-rasmda barcha so‘rovlar bo‘yicha o‘rtacha skanerlash miqdorlari quyidagicha:
| Jismoniy joylashuv | Har bir so‘rov uchun o‘rtacha skanerlangan ma’lumot |
|---|---|
| B0 – optimallashtirish yo‘q | 51 MB |
| B2 – filtr ustunlarida statik klasterlash | 117 MB |
| AJLO – joinga sezgir klasterlash | 46 MB |
B2’ning tartiblanmagan B0’dan ko‘proq ma’lumot skanerlashi diqqatga sazovor. orders jadvalining o_orderdate, lineitem jadvalining esa l_shipdate bo‘yicha klasterlanishi sana shartlariga yordam beradi; biroq orderkey intervalini ishlatadigan join so‘rovlarida kalit qiymatlari sana fayllariga tarqalganligi uchun deyarli barcha fayllar mos ko‘rinadi. Statik joylashuv boshlang‘ich ma’lumotdagi tabiiy lokalitetni ham buzib, ayrim so‘rovlarda skanerlashni oshirgan.
AJLO’ning JIS tartibida lineitem ↔ orders munosabati 1,000 ball bilan birinchi, customer ↔ orders munosabati 0,404 ball bilan ikkinchi. Tizim ushbu ustun munosabatlarni umumiy kalitlarda klasterlagan.
%86,7 kamayish barcha so‘rovlarning o‘rtachasi emas. Bu qiymat join og‘ir Q01–Q07 so‘rovlarida AJLO B2 ga nisbatan skanerlagan baytlarning kamayishini anglatadi. Faqat sana filtri ishlatadigan Q08–Q10 so‘rovlarida esa B2 ustun. AJLO ushbu kirish naqshlarini maxsus optimallashtirmagan.
So‘rov kechikishi qanday o‘zgargan?
5-rasmdagi batafsil natijalarga ko‘ra:
| Joylashuv | O‘rtacha so‘rov kechikishi |
|---|---|
| B0 | 1,2 soniya |
| B2 | 1,0 soniya |
| AJLO | 0,6 soniya |
AJLO statik filtr ustuni klasterlashiga nisbatan o‘rtacha kechikishni %40 kamaytirgan. Tadqiqotchi bu yutuqni boshqa so‘rov bajarish algoritmiga emas, balki almashinuvdan oldin kamroq fayl va satr o‘qilishiga bog‘laydi.
Tadqiqotning kirish qismidagi bir jumlada 0,5 va 0,6 soniyalik turli qiymatlar mavjud. Biroq annotatsiya, natijalar matni va 5-rasm AJLO uchun izchil ravishda 0,6, B2 uchun 1,0 soniyani bildirgani sababli shu qiymatlar asos qilib olinishi kerak.
Faylni o‘tkazib yuborish darajasida nima topildi?
RQ2 doirasida hisobot qilingan o‘rtacha file skipping darajalari quyidagicha:
| Joylashuv | O‘rtacha file skipping darajasi |
|---|---|
| B0 | %14,9 |
| B2 | %14,5 |
| AJLO | %54,4 |
Statik sana ustuni klasterlashining %14,5 bilan tartiblanmagan jadvaldagi %14,9 ga yaqin qolishi join og‘ir so‘rovlar uchun noto‘g‘ri kalit tanlovi file skipping’ga deyarli hissa qo‘shmaganini ko‘rsatadi.
AJLO rejalashtirish modelida umumiy Liquid Clustering uchun %30 skanerlash kamayishi koeffitsiyenti ishlatilgan. Tajribada Q01–Q07 so‘rovlarining o‘lchangan file skipping darajalari %76–79 orasida bo‘lgan. Model ushbu kichik ma’lumot tartibida taxminan 2,5 baravar konservativ qolgan. Xuddi shu farq katta fayl va ma’lumot miqyoslarida davom etadimi, noma’lum.
Workload drift tajribasi nimani ko‘rsatdi?
Uch xil ish yuki rejimida so‘rov shablonlarining chastotalari o‘zgartirilgan, biroq ishlatilgan join ustunlari o‘zgartirilmagan. W3 oynasidagi drift balli 0,249, W4 dagi ball 0,107 bo‘lib, ikkalasi ham 0,10 chegaradan oshgan. Tizim shu nuqtalarda qayta baholashni to‘g‘ri ishga tushirgan.
W5 da 0,069 va W6 da 0,091 qiymatlar chegaradan past qolib, qayta optimallashtirish ishga tushirilmagan. Biroq barcha oynalarda haqiqiy qayta yozish xarajati nol bo‘lgan. Buning sababi o‘zgargan narsa join ustunlari emas, mavjud munosabatlarning chastotalari bo‘lganidir. Qayta baholash mavjud jismoniy joylashuv hanuz yetarli deb qaror qilgan.
Shu sababli tajriba drift detektorining chegaraviy xatti-harakatini ko‘rsatadi; yangi join ustuni paydo bo‘lganda jadvalning haqiqatan qayta klasterlanishini va buning xarajatini baholamaydi. Tadqiqotchi buni kelajak ishlari uchun asosiy kamchiliklardan biri sifatida tan oladi.
Greedy rejalashtiruvchi optimumga qanchalik yaqinlashgan?
Beshdan sakkiztagacha jadval, oltidan o‘n ikkigacha qirra va umumiy qayta yozish xarajatining %20–50 oralig‘idagi byudjetni o‘z ichiga olgan to‘qqizta sintetik grafik konfiguratsiyasi yaratilgan. Greedy yechimning aniq brute-force optimumga nisbati hisoblangan.
- To‘qqiz konfiguratsiyaning oltitasida greedy yechim optimum bilan bir xil natija bergan.
- To‘qqiz konfiguratsiyaning sakkiztasi \(1-1/e\approx0{,}632\) chegarasini qondirgan yoki oshirgan.
- Barcha konfiguratsiyalar bo‘yicha o‘rtacha yaqinlashish nisbati 0,913 bo‘lgan.
- C6 konfiguratsiyasi 0,570 nisbatda qolgan.
C6 da qat’iy byudjet algoritmning dastlabki bosqichda mahalliy jihatdan jozibali qirrani tanlashiga va keyinroq yuqoriroq umumiy foyda beradigan kombinatsiyaga yeta olmasligiga sabab bo‘lgan. Bu natija nazariy \(1-1/e\) chegarasi faqat submodullik va kamayuvchi marjinal foyda shartlari bajarilganda amal qilishini eslatadi. Tadqiqotdagi to‘liq joylashuv muammosida bu shartlar har bir konfiguratsiyada kafolatlanmagan.
Tadqiqotning kuchli tomonlari nimalar?
- Ochiq manbali lakehouse stekiga xos va aniq belgilangan jismoniy dizayn muammosi ko‘rib chiqilgan.
- Jadvallar mustaqil emas, join grafigi orqali muvofiqlashtirilgan holda baholangan.
- Matematik maqsad funksiyasi, byudjet cheklovlari va algoritmlar ochiq tarzda berilgan.
- Fayl skanerlash hajmi, so‘rov kechikishi, file skipping darajasi, drift aniqlash va yaqinlashish sifati alohida tajribalar bilan o‘rganilgan.
- Tizim Spark shuffle jarayonini yo‘q qilmasligi ochiq aytilgan.
- Tajriba konfiguratsiyalari, kod, ma’lumot generatori va natija skriptlari uchun qayta ishlab chiqarish ma’lumotlari berilgan.
- Salbiy natija sifatidagi C6 muvaffaqiyatsizligi va ishlab chiqarish miqyosiga oid noaniqlik yashirilmagan.
Tadqiqotning asosiy cheklovlari nimalar?
- Tajribalar bitta Apple M1 noutbukida va mahalliy Spark rejimida o‘tkazilgan.
- TPC-H Scale Factor 1 taxminan 1 GB bo‘lib, ma’lumotlar xotiraga sig‘adi.
- Ishlab chiqarish muhitidagi tarmoq, taqsimlangan saqlash, executorlararo ma’lumot uzatish va tugun nosozliklari o‘rganilmagan.
- Ikki megabaytlik maqsadli fayl hajmi file skipping ta’sirini ko‘rinadigan qilish uchun tajriba maqsadida kichraytirilgan.
- Maxsus Python TPC-H generatori rasmiy
dbgentaqsimotidan kichik farqlarni o‘z ichiga olishi mumkin. - %86,7 skanerlash kamayishi faqat join og‘ir yettita so‘rov va B2 taqqoslashiga tegishli.
- Filtr og‘ir so‘rovlarda statik sana klasterlashi AJLO’dan yaxshiroq natija bergan.
- Drift tajribasida yangi join ustunlari bo‘lmagani uchun haqiqiy jismoniy qayta klasterlash yuz bermagan.
- OPTIMIZE operatsiyalarining terabayt yoki petabayt miqyosidagi haqiqiy xarajati o‘lchanmagan.
- Saqlash va qayta yozish xarajatlarining baytga asoslangan taxminlari ishlab chiqarish hisob-kitoblari yoki operatsion uzilish xavfi bilan tekshirilmagan.
- Greedy rejalashtiruvchi bir konfiguratsiyada nazariy chegaradan past qolgan.
- Tadqiqot peer review’dan o‘tmagan.
Tadqiqot qaysi natijalarni qo‘llab-quvvatlaydi?
- Xuddi shu kichik TPC-H muhitida Liquid Clustering kalitini tanlash file skipping va skanerlangan ma’lumotda katta farq yaratgan.
- Join kaliti bo‘yicha muvofiqlashtirilgan klasterlash Q01–Q07 so‘rovlarida sana ustuni bo‘yicha statik klasterlashdan kamroq ma’lumot skanerlagan.
- Noto‘g‘ri ustun bo‘yicha klasterlangan jismoniy joylashuv ayrim ish yuklarida tartiblanmagan jadvaldan ham yomon natija bergan.
- Ko‘paytmali JIS tadqiqotdagi misollarda yuqori chastotali, ammo past xarajatli munosabatlarni orqaga sura olgan.
- Drift o‘lchovi sinov qilingan so‘rov chastotasi o‘tishlarida chegaraning oshishini aniqlay olgan.
- Greedy rejalashtiruvchi to‘qqizta kichik sintetik grafikda o‘rtacha 0,913 optimum nisbatini ta’minlagan.
Tadqiqot qaysi natijalarni isbotlamaydi?
- AJLO barcha ochiq manbali Delta Lake o‘rnatmalarida tezroq bo‘lishini isbotlamaydi.
- %86,7 skanerlash kamayishi terabayt yoki petabayt miqyosida saqlanishini ko‘rsatmaydi.
- AJLO shuffle jarayonini yoki Sort-Merge Join almashinuvini yo‘q qilganini ko‘rsatmaydi.
- Broadcast Hash Join ishlatadigan so‘rovlar xuddi shunday foyda ko‘rishini ko‘rsatmaydi.
- Filtr og‘ir va join og‘ir so‘rovlarni bir vaqtning o‘zida eng yaxshi tarzda optimallashtirishini ko‘rsatmaydi.
- Ish yukiga yangi join ustunlari qo‘shilganda qayta klasterlash muvaffaqiyatli va arzon yakunlanishini ko‘rsatmaydi.
- Greedy rejalashtiruvchi barcha grafik va byudjet sharoitlarida \(1-1/e\) chegarasini ta’minlashini isbotlamaydi.
- Ishlab chiqarish tizimida olinadigan pul tejamini yoki xizmat darajasi yaxshilanishini o‘lchamaydi.
Tadqiqot usuli va topilmalari
Usul xulosasi
| Usul komponenti | Tadqiqotda qo‘llangan yondashuv |
|---|---|
| Tadqiqot turi | Algoritmik tizim dizayni, kichik miqyosli TPC-H tajribasi va sintetik grafik baholashi |
| Tizim nomi | AJLO – Adaptive Join-aware Layout Optimizer |
| Maqsad platforma | Ochiq manbali Apache Spark va Delta Lake |
| Asosiy ma’lumot tuzilmasi | So‘rovlar tarixidan tuzilgan vaznli jadval join grafigi |
| Ahamiyat balli | Normallashtirilgan so‘rov chastotasi × log masshtablangan ma’lumot hajmi × bajarish xarajati |
| Optimallashtirish maqsadi | Qayta yozish va saqlash byudjeti ostida kutilayotgan skanerlash kamayishining sof joriy qiymatini oshirish |
| Rejalashtiruvchi | Har bir qarordan keyin ustuvorliklarni yangilaydigan dinamik greedy algoritm |
| Moslashuv | JIS taqsimotidagi o‘zgarish uchun drift o‘lchovi; standart chegara 0,10 |
| Tajriba ma’lumotlari | TPC-H Scale Factor 1; sakkizta jadval; maxsus Python ma’lumot generatori |
| Tajriba so‘rovlari | O‘nta so‘rov; besh takror; median natijalar |
| Uskuna | Apple M1 noutbuki, 8 GB unified memory |
| Dasturiy ta’minot | Spark 4.0.0, Delta Lake 3.2.0, PySpark 4.0.0 |
Asosiy ishlash topilmalari
| Ko‘rsatkich | B0 | B2 | AJLO |
|---|---|---|---|
| O‘rtacha skanerlangan ma’lumot | 51 MB | 117 MB | 46 MB |
| O‘rtacha so‘rov kechikishi | 1,2 soniya | 1,0 soniya | 0,6 soniya |
| O‘rtacha file skipping darajasi | %14,9 | %14,5 | %54,4 |
So‘rov turiga ko‘ra natijalar farqi
| So‘rov guruhi | Afzal joylashuv | Tadqiqotdagi kuzatuv |
|---|---|---|
| Q01–Q07, join og‘ir | AJLO | B2 ga nisbatan skanerlangan baytlarda %86,7 kamayish; file skipping taxminan %76–79 |
| Q08–Q10, filtr og‘ir | B2 | Sana ustuni so‘rov sharti bilan bevosita mos kelgani uchun statik filtr klasterlashi kamroq ma’lumot skanerlagan |
Drift aniqlash topilmalari
| Oyna | Drift balli | Chegara holati | Jismoniy qayta yozish |
|---|---|---|---|
| W3 | 0,249 | 0,10 dan yuqori; qayta baholash | Yo‘q |
| W4 | 0,107 | 0,10 dan yuqori; qayta baholash | Yo‘q |
| W5 | 0,069 | Chegaradan past | Yo‘q |
| W6 | 0,091 | Chegaradan past | Yo‘q |
Greedy rejalashtiruvchi topilmalari
| O‘lchov | Natija |
|---|---|
| Sintetik konfiguratsiyalar soni | 9 |
| Optimum bilan to‘liq teng konfiguratsiya | 6 |
| 0,632 nazariy chegarasini qondirgan yoki oshirgan | 8 |
| O‘rtacha yaqinlashish nisbati | 0,913 |
| Eng past nisbat | C6 konfiguratsiyasida 0,570 |
Rasmlarning asosiy xabarlari
- 1-rasm: So‘rov jurnalidan boshlab rejalashtirish, qo‘llash, statistikani yangilash va drift aniqlash sikligacha boradigan oltita komponentli AJLO arxitekturasini ko‘rsatadi.
- 2-rasm: Statik filtr ustuni klasterlashi o‘rtacha 117 MB bilan B0 va AJLO’dan ko‘proq ma’lumot skanerlaganini ko‘rsatadi.
- 3-rasm:
lineitem–ordersmunosabati 1,000 JIS bilan ish yukida ustun ekanini ko‘rsatadi. - 4-rasm: Join og‘ir so‘rovlar AJLO tomonida, filtr og‘ir so‘rovlar esa B2 tomonida afzallik olishini ajratib ko‘rsatadi.
- 5-rasm: Batafsil kechikishlarni B0 uchun 1,2, B2 uchun 1,0 va AJLO uchun 0,6 soniya deb ko‘rsatadi.
- 6-rasm: AJLO’ning %54,4 file skipping darajasini B0 va B2 ning taxminan %14–15 qiymatlari bilan taqqoslaydi.
- 7-rasm: %30 rejalashtirish taxmini Q01–Q07 dagi o‘lchangan %76–79 darajalarga nisbatan konservativ qolganini ko‘rsatadi.
- 8-rasm: W3 va W4 oynalarida drift chegarasi oshganini ko‘rsatadi.
- 9-rasm: Qayta baholashlarga qaramay sinov qilingan rejimlarda jismoniy qayta yozish xarajati nol bo‘lib qolganini ko‘rsatadi.
- 10-rasm: To‘qqiz konfiguratsiyadan faqat C6 0,632 chegaradan past qolganini ko‘rsatadi.
- 11-rasm: Greedy va aniq optimum sof joriy qiymatlarni taqqoslab, eng katta mutlaq farqni C6 da ko‘rsatadi.
Manba va usul eslatmasi
Tadqiqotning to‘liq asl nomi: Adaptive Join-Aware Physical Layout Optimization for Lakehouse Systems
Muallif: Nishank Mahore.
Muallif tartibi: Tadqiqot bitta muallif tomonidan yozilgan.
Teng hissa ma’lumoti: Boshqa muallif yoki teng hissa bildirishi mavjud emas.
Mas’ul muallif: Nishank Mahore.
Aloqa manzili: nishankmahore@gmail.com
Institutsional aloqa: Independent Researcher, Pune, India. Tadqiqotda universitet, tadqiqot markazi yoki kompaniya aloqasi ko‘rsatilmagan.
Nashr platformasi: SSRN.
Rasmiy manba havolasi:SSRN tadqiqot yozuvi
Nashr yili: 2026.
Jurnal: Peer review’dan o‘tgan jurnal nomi yoki jurnal qabul ma’lumoti mavjud emas.
Nashriyot: Yakuniy peer-reviewed nashr uchun nashriyot ma’lumoti mavjud emas.
Manba turi: Algoritmik tizim dizayni va eksperimental kompyuter tizimlari baholashi; preprint.
Peer review holati: Tadqiqot peer review’dan o‘tmagan.
Amalga oshirish va tajriba kodlari:AJLO GitHub repozitoriysi
Ma’lumotlarga kirish: Xom TPC-H ma’lumotlari alohida saqlanmagan. Tadqiqotda ma’lumotlarni tpch_generator.py nomli maxsus generator bilan deterministik tarzda qayta yaratish mumkinligi aytilgan.
Muallif hissasi: Nishank Mahore; konseptualizatsiya, usul, dasturiy ta’minot, validatsiya, formal tahlil, tadqiqot, ma’lumotlarni tartibga solish, vizualizatsiya, dastlabki draft, ko‘rib chiqish va tahrirlash rollarining barchasini bajargan.
Moliyalashtirish: Tadqiqot uchun davlat, tijorat yoki notijorat tashkilotidan maxsus moliyalashtirish olinmagani bildirilgan.
Manfaatlar to‘qnashuvi: Muallif moliyaviy yoki shaxsiy manfaatlar to‘qnashuvini bildirmagan.
Generativ sun’iy intellekt bayonoti: Generativ sun’iy intellekt vositalari faqat muallifning original matnini tahrirlash, qisqartirish va aniqroq qilish uchun ishlatilgani; tadqiqot dizayni, amalga oshirish, eksperimental ma’lumotlar va texnik natijalar sun’iy intellekt tomonidan yaratilmagani bildirilgan.
Ushbu o‘zbekcha izoh faqat yuklangan tadqiqot matni, matematik ifodalar, algoritmlar, jadvallar, tajriba natijalari va 1–11-rasmlardagi vizual topilmalar asosida tayyorlangan. Tashqi manbalar ilmiy natija qo‘shish uchun ishlatilmagan; faqat tadqiqotning bibliografik shaxsi va rasmiy yozuvlarini tekshirishda baholangan.
Tadqiqotdagi 0,6 soniyalik kechikish, %54,4 file skipping va %86,7 skanerlash kamayishi natijalari taxminan 1 GB hajmdagi TPC-H Scale Factor 1 ma’lumotlari, ikki megabaytlik eksperimental maqsadli fayl hajmi va bitta kompyuterdagi mahalliy Spark muhitiga tegishli. Bu qiymatlar ishlab chiqarish miqyosi uchun ishlash kafolati sifatida talqin qilinmasligi kerak.
Muallifning “ilgari nashr etilgan hech bir tizim ochiq manbali Delta Lake uchun joinga sezgir Liquid Clustering kalit tanlovini avtomatlashtirmagan” degan yangilik da’vosi tadqiqotning o‘z adabiyot sharhiga asoslanadi. Ushbu maqolada mustaqil va to‘liq prior-art qidiruvi bajarilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan