

Табигый тилди иштетүү (NLP) долбоорлорунда көңүл көбүнчө моделдин архитектурасына, чоң тил моделдерине же жаңы алгоритмдерге бурулат. Чынында, ийгиликтүү жасалма интеллект системасынын негизинде көбүнчө кызыксыз көрүнгөнү менен чечүүчү ролду ойногон бир иш жатат: сапаттуу этикеткаланган маалыматтарды өндүрүү. Named Entity Recognition, башкача айтканда аталган объектилерди таануу, тексттин ичиндеги адамды, мекемени, жерди, дарыны, техникалык бөлүктү, укуктук түшүнүктү же тармакка тиешелүү маанилүү сөз айкаштарын (туюнтуларды) таап, аларды классификациялоону максат кылат.
Бул изилдөө NER маалымат топтомун даярдоонун практикалык кыйынчылыктарына басым жасайт. Изилдөөчү же тармактык эксперт тексттеги ар бир токенди (сөздү же бөлүктү) этикеткалашы керек. Бир объект текстте жүздөгөн жолу кайталанышы мүмкүн. Чычкан (mouse) менен тандалган сөз айкашы модел колдонгон токен чектери менен так дал келбеши мүмкүн. Объект болбогон ар бир токенге да “O”, башкача айтканда Outside (Сыртта) этикеткасы берилиши керек. Бул кичинекей көрүнгөн иштер чоң маалымат топтомдорунда жумаларга же айларга созулган чарчатуучу жумуш агымына айланышы мүмкүн.
AutoLabel-NER бул көйгөйгө жеңил, оффлайн жана ачык булактуу (open source) рабочий (desktop) чечимди сунуштайт. Курал маалыматтарды колдонуучунун компьютеринен сыртка чыгарбайт; сервер, булут (cloud) аккаунту же акы төлөнүүчү лицензия талап кылбайт. Этикеткалоо учурунда ал ошол эле объектти документтин бүтүндөй текстине автоматтык түрдө тарата алат, тандалган текстти токен чектерине тегиздей алат, калган бардык токендерди бир басуу (tık) менен Outside этикеткасы менен толуктай алат жана жыйынтыкты BIO, JSON, XLSX жана CSV formatтарында экспорттой алат.
Көйгөй эмнеде?
Заманбап табигый тилди иштетүү (NLP) негизинен көзөмөлдөнгөн үйрөнүүгө (supervised learning) таянат. Көзөмөлдөнгөн үйрөнүү болсо туура жана ырааттуу (tutarlı) этикеткаланган маалыматтарга муктаж. Модель кайсы объекттерди тааный турганын, кайсы түшүнүктөрдү ажырата турганын жана кайсы мисалдардан жалпылоо (genelleme) жасай турганын көп учурда маалымат топтомунун сапаты аныктайт. Ошондуктан маалыматтарды даярдоо моделди окутуудан (treningden) мурун келген критикалык кадам болуп саналат.
NER тапшырмасында этикеткалоо андан да түйшүктүү (zahmetlidir). Анткени сүйлөмгө жалпы этикетка берүү жетишсиз; тексттеги ар бир токендин ролу аныкталышы керек. Объект сөз айкашынын биринчи токени “B”, уланган токендери “I”, ал эми объектке кирбеген токендер “O” этикеткасын алат. Бул түзүм BIO tagging деп аталат.
Мисалы, техникалык тексттеги “double-acting cylinder” сөз айкашы бир кыймылдаткыч (actuator) болушу мүмкүн. Бул учурда “double-acting” B-ACTUATOR, “cylinder” I-ACTUATOR катары белгиленет. Ошол эле тексттеги “5/2-way solenoid valve” бир пре-актуатор (pre-actuator), ал эми “FL limit switch” сенсор болушу мүмкүн. Калган сөздөрдүн бардыгы O этикеткасын алышы керек. Бул процесс кол менен жасалганда, ал жайлайт жана ката кетирүүгө жакын болуп калат.
Изилдөө белгилеген үч негизги көйгөй бар. Биринчиси - кайталоо (tekrar) көйгөйү. Ошол эле объект бир эле документте көп жолу кездешиши мүмкүн жана ар бир жолу бирдей этикетка берилиши керек. Экинчиси - тегиздөө (hizalama) көйгөйү. Эгерде колдонуучу чычкан (mouse) менен тандаган текст бөлүгү модел колдонгон токен чектери менен так дал келбесе, жараксыз же бузулган BIO тизмектери (dizileri) пайда болушу мүмкүн. Үчүнчүсү - Outside этикеткасы көйгөйү. Объект эмес токендер да этикеткаланышы керек; бирок бул процесс көптөгөн куралдарда автоматтык жана коопсуз түрдө аткарылбайт.
Учурдагы куралдар (Mevcut araçlar) бул көйгөйлөрдүн бардыгын бир эле учурда чече албашы мүмкүн. Булутка негизделген куралдар заманбап интерфейсти сунуштаса да, купуя маалыматтарды (gizli verinin) тышкы кызматка (dış servise) жүктөөнү талап кылышы мүмкүн. Желеге негизделген (Web tabanlı) күчтүү куралдар орнотууну (kurulum) жана серверди башкарууну талап кылышы мүмкүн. Коммерциялык куралдар акы төлөнүүчү лицензия менен чектелиши мүмкүн. Жөнөкөй spreadsheet (электрондук жадыбал) же ноутбук чечимдери визуалдаштыруу, ырааттуулук жана BIO шайкештиги жагынан кооптуу болушу мүмкүн.
Метод эмнени сунуштайт?
AutoLabel-NER, NER маалымат топтомун өндүрүүнү бир компьютерде иштеген, орнотууга (kurulumu) жеңил жана купуялыкты сактаган (gizlilik dostu) рабочий (masaüstü) тиркемеси менен чечүүнү сунуштайт. Курал төрт катмарлуу (katmanlı) архитектуранын үстүнө курулган: презентация (sunum) катмары, лингвистикалык (dilsel) иштетүү катмары, этикеткалоо кыймылдаткычы (etiketleme motoru) жана туруктуулук/экспорттоо (kalıcılık/dışa aktarma) катмары.
Презентация катмары колдонуучу этикеткалаган графикалык интерфейс болуп саналат. Ал CustomTkinter менен даярдалган. Интерфейсте текст аймагы, этикетка баскычтары, объект тизмеси, абал тилкеси (durum çubuğu), прогресс көрсөткүчү, тема жана масштаб (zoom) опциялары бар. Колдонуучу этикеткаларды өзүнүн тармагына жараша аныктай алат; мисалы, укук тармагында "СОТ", "МЫЙЗАМ", "ТАРАПТАР"; саламаттыкты сактоодо "ДАРЫ", "ООРУ", "ДАРЫЛОО"; өнөр жайда "СЕНСОР", "АКТУАТОР", "КОМПОНЕНТ" сыяктуу атайын этикеткаларды түзө алат.
Лингвистикалык иштетүү катмары NLTK негизиндеги сүйлөм жана сөз токенизациясын колдонот. Эң критикалык функциялардын бири - экранда тандалган текст диапазонун баштапкы тексттеги токен чектерине (sınırlarına) туташтыруу. Эгерде бул тегиздөө (hizalama) болбосо, колдонуучу туура сөздү тандадым деп ойлосо дагы, экспорттолгон (dışa aktarılan) BIO файлы моделди окутуу үчүн каталуу (hatalı) болуп калышы мүмкүн.
Этикеткалоо кыймылдаткычы (Etiketleme motoru) - бул куралдын өндүрүмдүүлүк (üretkenlik) борбору. Ал тандалган объекттердин бири-бирине дал келүүсүн (çakışmasını) алдын алат, кокустан тандалган боштуктарды тазалайт, документ боюнча бирдей объект кайталоолорун автоматтык түрдө этикеткалайт, калган токендерди бир операция менен Outside (Сыртта) катары толтурат жана жокко чыгаруу/кайра жасоо (geri al/yeniden yap) тарыхын башкарат. Бул структура ылдамдыкты да, ырааттуулукту да камсыз кылууну көздөйт.
Туруктуулук (Kalıcılık) жана экспорттоо катмары долбоордун бардык абалын локалдык (yerel) JSON файлында сактайт. Булак тексти, этикетка схемасы, түстөр жана белгиленген аралыктар (işaretlenmiş spanlar) бир эле долбоор файлында сакталат. Этикеткалоо аяктаганда курал BIO, JSON, XLSX жана CSV форматтарында жыйынтык чыгарат. BIO натыйжасы (çıktısı) Hugging Face Transformers, spaCy жана Flair сыяктуу кеңири таралган NER окутуу китепканалары (kütüphaneleri) менен түздөн-түз шайкеш келет.
Формулалар эмнени түшүндүрөт?
Изилдөөдө классикалык мааниде математикалык модель формуласы жок. Бул макала программалык камсыздоо (yazılım) куралы жана иш агымы (iş akışı) боюнча изилдөө болуп саналат. Бирок NER этикеткалоо логикасын, BIO схемасын жана маалымат топтомун (veri seti) өндүрүү процессин жөнөкөй көрсөтмөлөр менен түшүндүрүүгө болот.
NER тапшырмасын жалпысынан төмөнкүчө элестетүүгө болот:
BIO этикеткалоо схемасы үч негизги абалдан турат:
Бул жерде \(B\), объекттин (varlık) башталышын; \(I\), ошол эле объекттин уландысын; \(O\) болсо эч кандай объектке таандык болбогон токенди билдирет.
Көп сөздүү объект сөз айкашы (ifadesi) үчүн түзүм төмөнкүдөй көрсөтүлүшү мүмкүн:
Бул жерде \(X\), этикетка классын билдирет. Мисалы \(X=\text{ACTUATOR}\) болсо, биринчи токен \(B\text{-ACTUATOR}\), андан кийинки токендер \(I\text{-ACTUATOR}\) этикеткасын алат.
AutoLabel-NERдин автоматтык кайталоо (tekrar) жайылтуу логикасын төмөнкүдөй кыскача жалпылоого болот:
Калган токендерди толуктоо (tamamlama) болсо төмөнкүдөй элестетилиши мүмкүн:
Бул туюнтмалар изилдөөдө түзмө-түз математикалык формула катары берилген эмес; AutoLabel-NERдин маалыматтарды этикеткалоо логикасын Verianla окурманы үчүн жөнөкөйлөткөн редактордук көрсөтмөлөр болуп саналат.
График, Таблица жана Схеманын Негизги Билдирүүсү
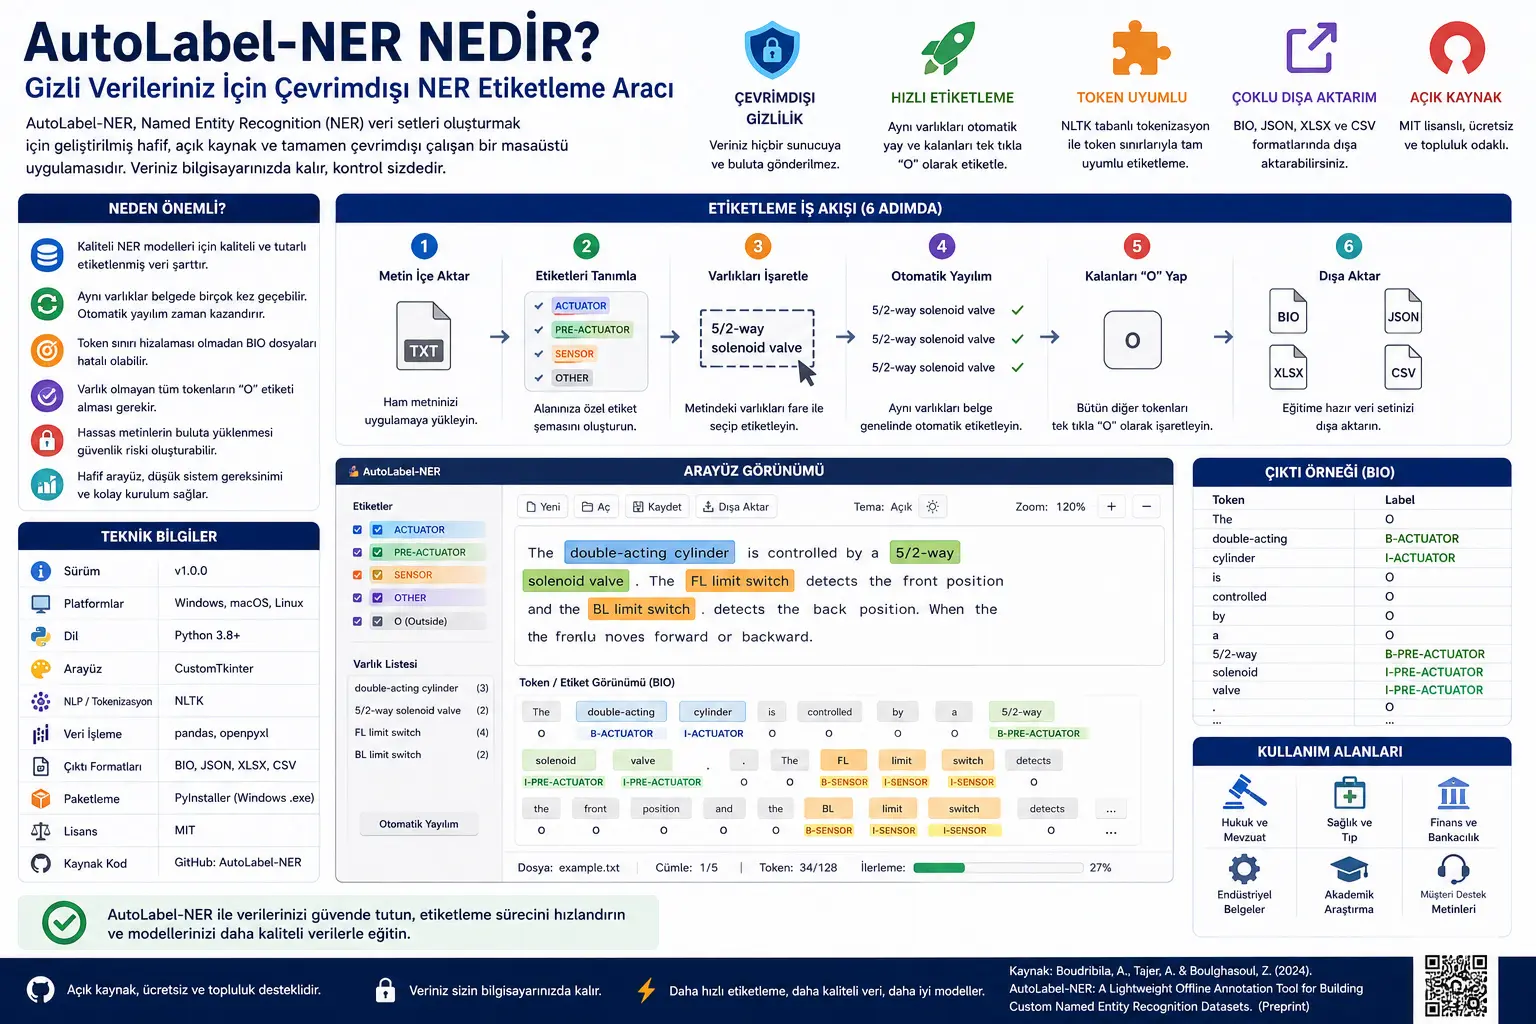
Код метадата (metadata) таблицасы AutoLabel-NERдин практикалык изилдөө программасы (araştırma yazılımı) катары позицияланганын көрсөтөт. Курал v1.0.0 версиясында сунушталган; GitHub аркылуу бөлүшүлөт, MIT лицензиясына ээ, Python 3.8 жана андан жогорку версиялар менен иштейт, CustomTkinter, NLTK, pandas, openpyxl жана PyInstaller колдонот. Windows үчүн көз карандысыз (bağımsız) аткарылуучу (çalıştırılabilir) файлдын берилиши, техникалык эмес колдонуучулардын да куралды ачып колдонуусун жеңилдетет.
Салыштыруу (Karşılaştırma) таблицасынын негизги билдирүүсү - AutoLabel-NER учурдагы куралдардын ортосундагы боштукту максат кылат. Doccano жана Label Studio сыяктуу куралдар күчтүү интерфейсти сунушташы мүмкүн; BRAT жана INCEpTION сыяктуу куралдар академиялык этикеткалоо үчүн натыйжалуу; Prodigy сыяктуу коммерциялык куралдар жакшы иштелип чыккан. Бирок AutoLabel-NERдин дооматы (iddiası) - толугу менен оффлайн иштөө, серверди талап кылбоо, жергиликтүү (yerel) маалыматтарды сактоо, NLTK негизиндеги токенизация, автоматтык этикетканы жайылтуу, боштуктарды (boşlukları) тазалоо, бир басуу менен Outside этикеткасын толуктоо жана native BIO экспорттоо өзгөчөлүктөрүн бир жеңил рабочий (masaüstü) куралда бириктирүүсүндө.
Төрт катмарлуу архитектура схемасы куралдын иш агымын так (net) көрсөтүп турат. Чийки текст алгач колдонуучу интерфейсине келет. Андан кийин NLTK негизиндеги лингвистикалык (dilsel) иштетүү катмары сүйлөм, сөз жана символдор аралыгын (karakter aralığı) дал келтирүүнү (eşlemesini) аткарат. Этикеткалоо кыймылдаткычы (Etiketleme motoru) auto-tagging (авто-этикеткалоо), Outside толуктоо, кайталанууну (çakışma) текшерүү жана жокко чыгаруу/кайра жасоо (geri al/yeniden yap) операцияларын жүргүзөт. Акыркы катмар болсо маалыматтарды JSON, XLSX, CSV жана BIO форматтарында экспорттойт.
Алты кадамдуу иш агымы (iş akışı) схемасы колдонуучунун чийки тексттен окутуу маалыматына (eğitim verisine) кантип өткөнүн көрсөтөт: текст импорттолот (içe aktarılır), этикеткалар аныкталат, объекттер кол менен белгиленет, ошол эле этикеткалар окшош мисалдарга (örneklere) жайылат, калган токендер O катары белгиленет жана маалымат топтому экспорттолот. Бул агымдын маанилүү тарабы - кол менен чечим кабыл алууну талап кылган этаптар менен автоматтык өндүрүмдүүлүк этаптарын бирге колдонуусунда.
Интерфейс визуалы тиркеменин (uygulamanın) бир гана техникалык backend'ден турбагандыгын; этикетка баскычтары, түстүү белгилөөлөр (vurgular), объект тизмеси жана прогресс көрсөткүчү менен чыныгы колдонуучунун иш агымын максат кылганын көрсөтөт. BIO жыйынтык (çıktı) визуалы болсо куралдын визуалдык гана этикеткалоо жасабаганын, моделди окутууга түздөн-түз кире ала турган токен деңгээлиндеги (düzeyinde) жыйынтык чыгарганын көрсөтөт.
Эксперименттер кандайча жасалган?
Изилдөө классикалык машиналык үйрөнүү экспериментин сунуштабайт; ал көбүрөөк программалык куралды (yazılım aracını) таанытууну, иш агымын (iş akışını) көрсөтүүнү жана колдонуу таасирин (kullanım etkisi) баалоону камтыйт. Ошондуктан моделдин тактыгын (doğruluğunu) салыштырууга караганда, куралдын NER маалымат топтомун өндүрүү процессиндеги практикалык салымы (katkısı) айтылат.
Алгач кыска техникалык спецификация (şartname) сүйлөмү аркылуу үлгү (örnek) этикеткалоо жасалат. Сүйлөмдөгү “double-acting cylinder”, “5/2-way solenoid valve”, “FL limit switch” жана “BL limit switch” сыяктуу тармакка тиешелүү (alan özelindeki) сөз айкаштары этикеткаланат. Максат - актуатор, пре-актуатор жана сенсор сыяктуу техникалык объекттердин кантип белгиленээрин көрсөтүү.
Колдонуучу текстти импорттойт, этикеткаларды аныктайт, алгачкы объект мисалдарын тандап, ылайыктуу этикеткаларды ыйгарат (atar). Auto-tagging (Авто-этикеткалоо) өзгөчөлүгү күйгүзүлгөндө, ошол эле объекттин кайталоолору документтин ичинде автоматтык түрдө этикеткаланат. Андан кийин “Label Rest as O” (Калганын O катары белгилөө) операциясы этикеткаланбаган бардык токендерди Outside этикеткасы менен толуктайт. Акыркы этапта курал BIO, JSON, XLSX жана CSV натыйжаларын чыгарат.
Изилдөө ошондой эле масштабдуураак (büyük ölçekli) колдонуу мисалы жөнүндө сөз кылат. AutoLabel-NER өнөр жай (endüstriyel) талаптарынын спецификацияларынан (şartnamelerinden) турган тармакка тиешелүү (alan özelinde) NER корпусун түзүү үчүн колдонулган. Бул корпус бир нече миң спецификацияны, он миңдеген сүйлөмдөрдү жана жүз миңдеген токендерди камтыйт. Бөлүшүлгөн (Paylaşılan) тастыктоо бөлүгүндө (doğrulama alt kümesinde) күчтүү inter-annotator agreement (этикеткалоочулар аралык макулдашуу) бар экендиги, башкача айтканда, ар кандай этикеткалоочулардын чоң өлчөмдө ырааттуу (tutarlı) этикеткаларды чыгара алаары белгиленген.
Бул маалымат топтомунан (veri setinden) өндүрүлгөн BIO натыйжасы орто аралык конвертацияны (dönüştürme) талап кылбастан трансформер негизиндеги NER моделдерин fine-tune (кылдат жөнгө салуу) үчүн колдонулганы жана эң мыкты модель сакталып калган (elde tutulan) тесттик топтомдо 0.9721 F1 скоруна жеткени кабарланат. Бул натыйжа куралдын жөн гана интерфейс ыңгайлуулугун камсыз кылбаганын; моделди окутууга ылайыктуу, ырааттуу жана колдонууга боло турган маалыматтарды (датаны) өндүрүүгө салым кошконун көрсөтүп турат.
Натыйжалар эмнени көрсөтүп турат?
Биринчи жыйынтык, NER долбоорлорунда маалыматтарды этикеткалоо (veri etiketleme) моделдин архитектурасынан кем эмес маанилүү экендигинде. Туура токен чектери (sınırları), ырааттуу BIO тизмектери (dizileri) жана толук O этикеткалары болбосо, эң күчтүү трансформер модели да ката же ыраатсыз маалыматтар менен окутулушу (eğitilebilir) мүмкүн.
Экинчи жыйынтык, оффлайн режиминде иштөө кээ бир тармактарда критикалык мааниге ээ экендигинде. Клиникалык жазуулар (notlar), юридикалык (hukuki) документтер, ички корпоративдик отчеттор, финансылык документтер же өнөр жай (endüstriyel) спецификациялары сыяктуу тексттер жалпыга ачык булутка (kamu bulutuna) жүктөлбөшү мүмкүн. AutoLabel-NER мындай учурларда маалыматтарды жергиликтүү (yerel) компьютерде сактоо менен изилдөө жүргүзүүнү жеңилдетет.
Үчүнчү жыйынтык, автоматтык этикетканы жайылтуунун кайталоо жүгүн (tekrar yükünü) олуттуу (ciddi) түрдө азайта ала тургандыгында. Эгерде бир эле объект документтин көп жерлеринде кездешсе, аны бир-бирден кол менен белгилөө (işaretlemek) убакытты текке кетирет жана ыраатсыздык (tutarsızlık) коркунучун жаратат. Exact-string label propagation бул кайталоолорду кыйла азайтат.
Төртүнчү жыйынтык, токендерди тегиздөө (hizalamasının) көрүнбөгөн, бирок критикалык сапат (kalite) маселеси экендигинде. Эгерде колдонуучу интерфейсинде туура көрүнгөн тандоо моделдин токенизациясы менен шайкеш (uyumlu) келбесе, BIO файлы бузулушу мүмкүн. AutoLabel-NERдин NLTK токенизациясы жана символдор аралыгын (karakter aralığı) тегиздөөсү бул тобокелдикти азайтууга багытталган.
Бешинчи жыйынтык, стандарттык экспорттоонун (dışa aktarımın) изилдөө агымын (araştırma akışını) тездеткенинде. BIO, JSON, XLSX жана CSV жыйынтыктарын (çıktılarının) бир куралдан алуусу; Hugging Face Transformers, spaCy жана Flair сыяктуу китепканаларга (kütüphanelere) өтүүнү жеңилдетет. Ушундай жол менен, изилдөөчүлөрдүн маалыматтарды конвертациялоо (dönüştürme) скрипттерин жазууда кетириши мүмкүн болгон үнсүз (sessiz) каталары азайышы мүмкүн.
Бул эмне үчүн маанилүү?
Бул изилдөө жасалма интеллект долбоорлорунда көп унутулуп калган бир жагдайды көрүнүктүү (görünür) кылат: Эгерде маалыматтарды этикеткалоо инфраструктурасы (altyapısı) күчтүү болбосо, моделдин ийгилиги да морт (kırılgan) болуп калат. Өзгөчө атайын (özel) тармактарда даяр маалымат топтому көбүнчө жок болот. Медициналык, укуктук, каржылык же өнөр жай тексттеринде моделди окутууну каалаган изилдөөчүлөр, көбүнчө өздөрүнүн маалымат топтомун түзүүгө мажбур болушат.
AutoLabel-NER сыяктуу куралдардын маанилүүлүгү ушул жерден келип чыгат. Курал чоң моделди сунуштабайт; бирок моделдин үйрөнө ала турган таза маалыматтарды (temiz veriyi) өндүрүүнү жеңилдетет. Бул маалыматка багытталган (veri merkezli) жасалма интеллект ыкмасы (yaklaşımı) жагынан маанилүү. Анткени моделдин өндүрүмдүүлүгүн (performansını) архитектура менен гана эмес, маалыматтын сапаты менен да жакшыртуу керек.
Купуялык (Gizlilik) өлчөмү да критикалык. Саламаттыкты сактоо мекемеси бейтаптардын (hasta) жазууларын, компания техникалык документтерин, юридикалык топ сот (dava) файлдарын же финансылык мекеме отчетторун тышкы булут кызматына (dış bulut servisine) жүктөй албашы мүмкүн. Оффлайн жана локалдык (yerel) иштеген этикеткалоо куралы, бул тармактарда изилдөө жана моделдерди иштеп чыгуу үчүн практикалык эшик ачат.
Изилдөөнүн инженердик баалуулугун да баалабай коюуга болбойт (küçümsenmemelidir). Жакшы изилдөө программасы (araştırma yazılımı) жөн гана татаал алгоритм чыгаруу эмес; кээде туура жерде туура кичинекей автоматташтырууларды (otomasyonları) сунуштоо. Бир басуу менен (Tek tıkla) O этикеткасын толуктоо, боштуктарды (boşlukları) тазалоо, токен чектерин тегиздөө (hizalama) жана ошол эле объектти жайылтуу сыяктуу өзгөчөлүктөр чоң маалыматтарды этикеткалоо долбоорлорунда олуттуу убакыт жана сапат айырмасын (farkı) жаратышы мүмкүн.
Көңүл буруу пункттары
Биринчи көңүл бура турган жагдай (dikkat noktası), изилдөөнүн preprint (алдын ала басып чыгаруу) экендигинде. Ал рецензиядан (hakem değerlendirmesi) өтпөгөндүктөн, программалык камсыздоонун (yazılımın) дооматтары (iddiaları), чөйрөсү жана баалоо натыйжалары келечекте өзгөрүшү мүмкүн. Ошондуктан изилдөө, үмүт берүүчү (umut verici) изилдөө программасын (araştırma yazılımı) таанытуу катары окулушу керек.
Экинчи көңүл бура турган жагдай, куралдын автоматтык этикеткалоо стратегиясынын exact-string (так сап/текст) дал келүүсүнө (eşleşmeye) негизделгендигинде. Бирдей сөздөрдүн тизмегин (dizisini) кармоо кайталоолорду тездетет; бирок контекстке (bağlama) жараша ар кандай маанини алып жүргөн дал келүүлөрдө колдонуучунун көзөмөлү (kullanıcı kontrolü) талап кылынат. Ар бир автоматтык жайылтууну (otomatik yayılım) туура деп кабыл албоо керек.
Үчүнчү көңүл бура турган жагдай, NER этикеткалоонун сапаты курал менен гана аныкталбайт. Этикеткалоо боюнча колдонмо (Etiket yönergesi), этикеткалоочуларды окутуу, тармактык (alan) экспертиза, келишпестиктерди (uyuşmazlık) чечүү жана сапатты көзөмөлдөө протоколу дагы деле зарыл. Курал жакшы болушу мүмкүн; бирок начар аныкталган этикетка схемасы баары бир ыраатсыз (tutarsız) маалыматтарды (veri) өндүрүшү мүмкүн.
Төртүнчү көңүл бура турган жагдай, NLTK токенизациясынын ар бир тил жана тармак үчүн идеалдуу боло бербеши мүмкүн экендигинде. Англис тилиндеги техникалык тексттерде жакшы жыйынтык (sonuç) бериши мүмкүн; бирок кыргызча, түркчө, аралаш коддуу (karma kodlu) тексттер, медициналык кыскартуулар же атайын символдорду камтыган аймактарда токенизация өзүнчө сыналууга тийиш (test edilmelidir).
Бешинчи көңүл бура турган жагдай, оффлайн иштөө купуялык (gizlilik) жагынан баалуу болгону менен, жалгыз өзү толук коопсуздукту (tam güvenlik) билдирбейт. Жергиликтүү компьютердеги (Yerel bilgisayardaki) файлдарга уруксаттар (dosya izinleri), дискти шифрлөө (disk şifreleme), резервдик көчүрүү (yedekleme), кирүү мүмкүнчүлүгүн көзөмөлдөө (erişim kontrolü) жана долбоор файлдарын коопсуз бөлүшүү (güvenli paylaşımı) дагы өзүнчө ойлонулушу керек.
Жыйынтык
Бул изилдөө табигый тилди иштетүү (NLP) долбоорлорунда маалыматтарды даярдоонун (veri hazırlamanın) канчалык борбордук (merkezi) мааниге ээ экенин эске салат. AutoLabel-NER атайын тармактарда (özel alanlarda) NER маалымат топтомун (veri seti) түзгүсү келген изилдөөчүлөр үчүн оффлайн, ачык булактуу (açık kaynak) жана жеңил рабочий куралды (masaüstü araç) сунуштайт.
Куралдын күчтүү тарабы - бул бир эле иш агымынын (iş akışı) ичинде үч практикалык көйгөйдү чечүүгө аракет кылуусу: кайталанган объекттерди кайра-кайра этикеткалоо, колдонуучунун тандоосу менен токен чектеринин (sınırları) ортосундагы дал келбестик (uyumsuzluk) жана объект болбогон токендерди O этикеткасы менен толуктоо (tamamlanması). Буларга BIO, JSON, XLSX жана CSV экспорттоо колдоосу (dışa aktarma desteği) кошулганда, чийки тексттен моделди окутууга өтүү (eğitimine geçiş) иреттүүрөөк (daha düzenli) болот.
Verianla жагынан алганда изилдөөнүн негизги билдирүүсү төмөнкүдөй: Жасалма интеллектте ийгилик чоң моделдерден гана келбейт. Өзгөчө атайын тармактарда (özel alanlarda) ишенимдүү маалымат топтомун өндүрүү, моделди иштеп чыгуу сыяктуу эле стратегиялык иш болуп саналат. AutoLabel-NER бул "маалымат ишин" (veri işini) тезирээк, коопсузураак жана кайталануучу (tekrarlanabilir) кылууну көздөгөн практикалык изилдөө куралы (araştırma aracı) болуп саналат.
Булак жана Метод Эскертүүсү
Бул мазмун Абдеррахман Будрибила (Abderrahmane Boudribila), Абделуахед Тажер (Abdelouahed Tajer) жана Закария Булгасул (Zakaria Boulghasoul) тарабынан даярдалган “AutoLabel-NER: A Lightweight Offline Annotation Tool for Building Custom Named Entity Recognition Datasets” аттуу preprint (алдын ала басып чыгаруу) изилдөөсүнүн негизинде даярдалган. Изилдөө; оффлайн NER маалыматтарын этикеткалоо (veri etiketleme), BIO tagging, NLTK негизиндеги токендерди тегиздөө (hizalama), автоматтык этикетканы жайылтуу, Outside этикеткасын толуктоо, жергиликтүү долбоорду сактоо (yerel proje saklama) жана стандарттуу маалыматтарды экспорттоо (veri dışa aktarma) өзгөчөлүктөрүнө ээ болгон AutoLabel-NER куралын таанытат.
Бул мазмун сөзмө-сөз котормо эмес; изилдөөнүн негизги идеясы Verianla басып чыгаруу багытына ылайык жөнөкөйлөштүрүлүп, оригиналдуу кыргызча редактордук макалага айландырылган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген