

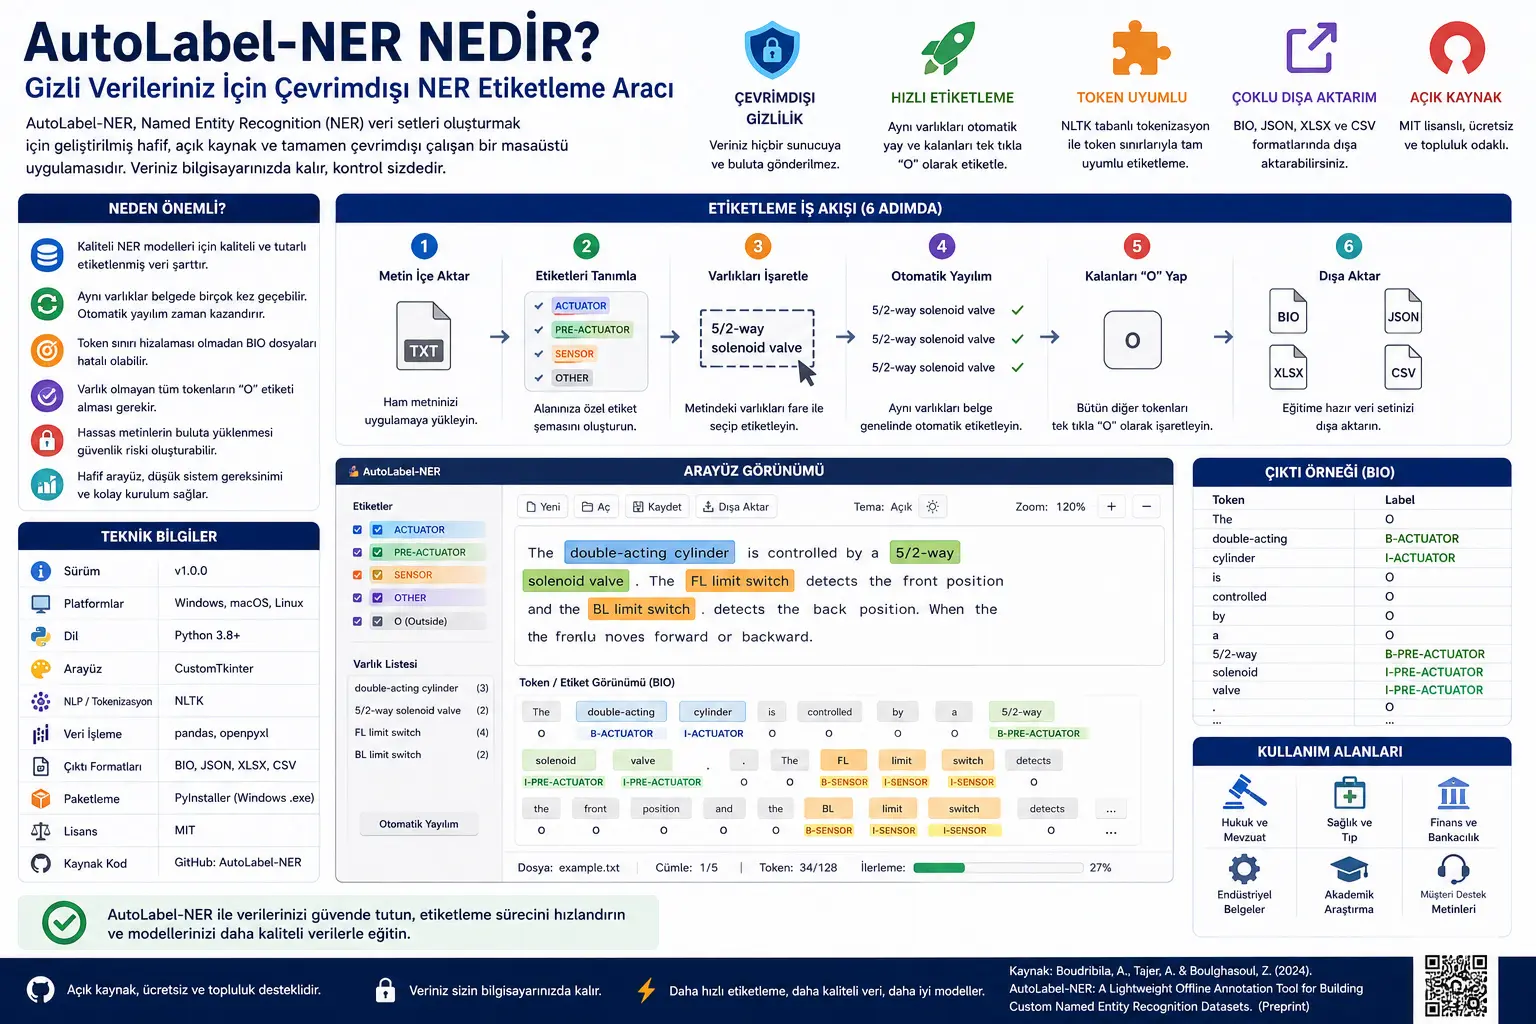
Təbii dil emalı layihələrində diqqət çox vaxt model arxitekturasına, böyük dil modellərinə və ya yeni alqoritmlərə yönəlir. Halbuki uğurlu süni intellekt sisteminin təməlində çox vaxt daha darıxdırıcı görünən, amma daha həlledici bir iş dayanır: keyfiyyətli etiketlənmiş verilənlər yaratmaq. Named Entity Recognition, yəni adlandırılmış varlığın tanınması, mətn daxilindəki şəxs, qurum, yer, dərman, texniki hissə, hüquqi anlayış və ya sahəyə xas vacib ifadələri tapıb təsnif etməyi hədəfləyir.
Bu tədqiqat NER verilənlər dəsti hazırlamağın praktik çətinliklərinə fokuslanır. Tədqiqatçı və ya sahə mütəxəssisi mətndəki hər tokeni etiketləməlidir. Bir varlıq mətndə yüzlərlə dəfə təkrarlana bilər. Siçanla seçilən ifadə modelin istifadə etdiyi token sərhədləri ilə tam üst-üstə düşməyə bilər. Varlıq olmayan hər token də “O”, yəni Outside etiketi almalıdır. Kiçik görünən bu işlər böyük verilənlər dəstlərində həftələr və ya aylar davam edən yorucu iş axınına çevrilə bilər.
AutoLabel-NER bu problemə yüngül, oflayn və açıq mənbəli masaüstü həll təklif edir. Alət verilənləri istifadəçinin kompüterindən kənara çıxarmır; server, bulud hesabı və ya ödənişli lisenziya tələb etmir. Etiketləmə zamanı eyni varlığı bütün sənəd üzrə avtomatik yaya, seçilmiş mətni token sərhədlərinə uyğunlaşdıra, qalan bütün tokenləri bir kliklə Outside etiketi ilə tamamlaya və nəticəni BIO, JSON, XLSX və CSV formatlarında ixrac edə bilir.
Problem Nədir?
Müasir təbii dil emalı böyük ölçüdə nəzarətli öyrənməyə əsaslanır. Nəzarətli öyrənmə isə düzgün və ardıcıl etiketlənmiş verilənlər tələb edir. Modelin hansı varlıqları tanıyacağını, hansı anlayışları ayıracağını və hansı nümunələrdən ümumiləşdirmə aparacağını çox vaxt verilənlər dəstinin keyfiyyəti müəyyən edir. Buna görə verilənlərin hazırlanması model təlimindən əvvəl gələn kritik mərhələdir.
NER tapşırığında etiketləmə daha da zəhmətlidir. Çünki yalnız cümləyə ümumi etiket vermək kifayət etmir; mətndəki hər tokenin rolu müəyyən edilməlidir. Varlıq ifadəsinin ilk tokeni “B”, davam edən tokenləri “I”, varlıqdan kənar tokenlər isə “O” etiketi alır. Bu quruluş BIO tagging kimi tanınır.
Məsələn, texniki mətndə “double-acting cylinder” ifadəsi aktüator ola bilər. Bu halda “double-acting” B-ACTUATOR, “cylinder” I-ACTUATOR kimi işarələnir. Eyni mətndə “5/2-way solenoid valve” pre-actuator, “FL limit switch” isə sensor ola bilər. Qalan sözlərin hamısı da O etiketi almalıdır. Bu əməliyyat əl ilə aparıldıqda həm yavaşıyır, həm də səhvə açıq olur.
Tədqiqatın vurğuladığı üç əsas problem var. Birincisi təkrar problemidir. Eyni varlıq eyni sənəddə dəfələrlə keçə bilər və hər dəfə eyni etiket verilməlidir. İkincisi uyğunlaşdırma problemidir. İstifadəçinin siçanla seçdiyi mətn hissəsi modelin istifadə etdiyi token sərhədləri ilə tam üst-üstə düşməzsə, etibarsız və ya pozulmuş BIO ardıcıllıqları yarana bilər. Üçüncüsü Outside etiketi problemidir. Varlıq olmayan tokenlər də etiketlənməlidir; lakin bu əməliyyat bir çox alətdə avtomatik və təhlükəsiz şəkildə tamamlanmır.
Mövcud alətlər bu problemlərin hamısını eyni vaxtda həll etməyə bilər. Bulud əsaslı alətlər müasir interfeys təqdim etsə də, məxfi verilənlərin xarici xidmətə yüklənməsini tələb edə bilər. Güclü veb əsaslı alətlər quraşdırma və server idarəetməsi istəyə bilər. Kommersiya alətləri ödənişli lisenziya ilə məhdudlaşa bilər. Sadə spreadsheet və ya notebook həlləri isə vizuallaşdırma, ardıcıllıq və BIO uyğunluğu baxımından riskli ola bilər.
Metod Nə Təklif Edir?
AutoLabel-NER NER verilənlər dəstinin hazırlanmasını bir kompüterdə işləyən, yüngül quraşdırılan və məxfiliyə uyğun masaüstü tətbiqlə həll etməyi təklif edir. Alət dördqatlı arxitektura üzərində qurulub: təqdimat qatı, linqvistik emal qatı, etiketləmə mühərriki və davamlılıq/ixrac qatı.
Təqdimat qatı istifadəçinin etiketləmə apardığı qrafik interfeysdir. CustomTkinter ilə hazırlanıb. İnterfeysdə mətn sahəsi, etiket düymələri, varlıq siyahısı, status sətri, irəliləyiş göstəricisi, tema və zoom seçimləri var. İstifadəçi etiketləri öz sahəsinə uyğun müəyyən edə bilər; məsələn hüquqda “MƏHKƏMƏ”, “QANUN”, “TƏRƏFLƏR”; səhiyyədə “DƏRMAN”, “XƏSTƏLİK”, “MÜALİCƏ”; sənayedə “SENSOR”, “AKTÜATOR”, “KOMPONENT” kimi xüsusi etiketlər yarada bilər.
Linqvistik emal qatı NLTK əsaslı cümlə və söz tokenizasiyasından istifadə edir. Ən kritik funksiyalardan biri ekranda seçilən mətn intervalını mənbə mətndəki token sərhədlərinə bağlamaqdır. Bu uyğunlaşdırma olmazsa, istifadəçi düzgün sözü seçdiyini düşünsə belə, ixrac olunan BIO faylı model təlimi üçün səhv ola bilər.
Etiketləmə mühərriki alətin məhsuldarlıq mərkəzidir. Seçilən varlıqların toqquşmasının qarşısını alır, səhvən seçilmiş boşluqları təmizləyir, eyni varlığın təkrarlarını bütün sənəd üzrə avtomatik etiketləyir, qalan tokenləri bir əməliyyatla Outside kimi tamamlayır və geri al/yenidən et tarixçəsini idarə edir. Bu quruluş həm sürət, həm də ardıcıllıq təmin etməyi hədəfləyir.
Davamlılıq və ixrac qatı layihənin bütün vəziyyətini lokal JSON faylında saxlayır. Mənbə mətn, etiket sxemi, rənglər və işarələnmiş spanlar eyni layihə faylında saxlanılır. Etiketləmə başa çatdıqda alət BIO, JSON, XLSX və CSV formatlarında çıxış yaradır. BIO çıxışı Hugging Face Transformers, spaCy və Flair kimi geniş istifadə olunan NER təlim kitabxanaları ilə birbaşa uyğundur.
Formullar Nəyi İzah Edir?
Tədqiqatda klassik mənada riyazi model formulu yoxdur. Bu məqalə proqram təminatı aləti və iş axını tədqiqatıdır. Lakin NER etiketləmə məntiqi, BIO sxemi və verilənlər dəstinin hazırlanması prosesi sadə göstərimlərlə izah oluna bilər.
NER tapşırığını ümumilikdə belə düşünmək olar:
BIO etiketləmə sxemi üç əsas vəziyyətdən ibarətdir:
Burada \(B\) varlıq ifadəsinin başlanğıcını; \(I\) eyni varlığın davamını; \(O\) isə heç bir varlığa aid olmayan tokeni təmsil edir.
Çoxsözlü varlıq ifadəsi üçün quruluş belə göstərilə bilər:
Burada \(X\) etiket sinfini təmsil edir. Məsələn, \(X=\text{ACTUATOR}\) olarsa, ilk token \(B\text{-ACTUATOR}\), sonrakı tokenlər isə \(I\text{-ACTUATOR}\) etiketi alır.
AutoLabel-NER-in avtomatik təkrar yayılma məntiqini sadə şəkildə belə ümumiləşdirmək olar:
Qalan tokenlərin tamamlanmasını isə belə düşünmək olar:
Bu ifadələr tədqiqatda sözbəsöz riyazi formul kimi təqdim olunmur; AutoLabel-NER-in verilən etiketləmə məntiqini Verianla oxucusu üçün sadələşdirən redaksiya göstərimləridir.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
Kod metadatası cədvəli AutoLabel-NER-in praktik tədqiqat proqramı kimi mövqeləndiyini göstərir. Alət v1.0.0 versiyasında təqdim olunub; GitHub vasitəsilə paylaşılır, MIT lisenziyasına malikdir, Python 3.8 və daha yuxarı versiyalarla işləyir, CustomTkinter, NLTK, pandas, openpyxl və PyInstaller-dən istifadə edir. Windows üçün müstəqil icra olunan faylın təqdim edilməsi texniki olmayan istifadəçilərin də aləti açıb işlətməsini asanlaşdırır.
Müqayisə cədvəlinin əsas mesajı AutoLabel-NER-in mövcud alətlər arasındakı boşluğu hədəfləməsidir. Doccano və Label Studio kimi alətlər güclü interfeys verə bilər; BRAT və INCEpTION kimi alətlər akademik etiketləmə üçün səmərəlidir; Prodigy kimi kommersiya alətləri yaxşı dizayn olunub. Lakin AutoLabel-NER-in iddiası tam oflayn işləmə, server tələb etməmə, lokal verilən saxlanması, NLTK əsaslı tokenizasiya, avtomatik etiket yayılması, boşluqların təmizlənməsi, bir kliklə Outside etiketi tamamlama və native BIO ixrac xüsusiyyətlərini bir yüngül masaüstü alətdə birləşdirməkdir.
Dördqatlı arxitektura sxemi alətin iş axınını aydın göstərir. Xam mətn əvvəlcə istifadəçi interfeysinə daxil olur. Sonra NLTK əsaslı linqvistik emal qatı cümlə, söz və simvol intervalı uyğunlaşdırmasını aparır. Etiketləmə mühərriki auto-tagging, Outside tamamlama, toqquşma nəzarəti və geri al/yenidən et əməliyyatlarını həyata keçirir. Son qat isə verilənləri JSON, XLSX, CSV və BIO formatlarında ixrac edir.
Altı mərhələli iş axını sxemi istifadəçinin xam mətndən təlim veriləninə necə keçdiyini göstərir: mətn idxal edilir, etiketlər müəyyənləşdirilir, varlıqlar əl ilə işarələnir, eyni etiketlər oxşar nümunələrə yayılır, qalan tokenlər O kimi işarələnir və verilənlər dəsti ixrac olunur. Bu axının mühüm tərəfi əl ilə qərar tələb edən mərhələlərlə avtomatik məhsuldarlıq mərhələlərini birlikdə işlətməsidir.
İnterfeys görüntüsü tətbiqin yalnız texniki backend-dən ibarət olmadığını; etiket düymələri, rəngli vurğular, varlıq siyahısı və irəliləyiş göstəricisi ilə real istifadəçi iş axınını hədəflədiyini göstərir. BIO çıxış görüntüsü isə alətin yalnız vizual etiketləmə aparmadığını, model təliminə birbaşa daxil edilə biləcək token səviyyəli çıxış yaratdığını göstərir.
Təcrübələr Necə Aparılıb?
Tədqiqat klassik maşın öyrənməsi təcrübəsi təqdim etmir; daha çox proqram təminatı alətinin təqdimatı, iş axınının göstərilməsi və istifadə təsirinin qiymətləndirilməsini verir. Buna görə model dəqiqliyinin müqayisəsindən daha çox alətin NER verilənlər dəstinin hazırlanması prosesinə praktik töhfəsi izah olunur.
Əvvəlcə qısa texniki spesifikasiya cümləsi üzərində nümunə etiketləmə aparılır. Cümlədə “double-acting cylinder”, “5/2-way solenoid valve”, “FL limit switch” və “BL limit switch” kimi sahəyə xas ifadələr etiketlənir. Məqsəd aktüator, pre-actuator və sensor kimi texniki varlıqların necə işarələndiyini göstərməkdir.
İstifadəçi mətni idxal edir, etiketləri müəyyənləşdirir, ilk varlıq nümunələrini seçir və uyğun etiketləri təyin edir. Auto-tagging funksiyası açıldıqda eyni varlığın təkrarları sənəd daxilində avtomatik etiketlənir. Sonra “Label Rest as O” əməliyyatı etiketlənməmiş bütün tokenləri Outside etiketi ilə tamamlayır. Son mərhələdə alət BIO, JSON, XLSX və CSV çıxışları yaradır.
Tədqiqat daha böyük miqyaslı istifadə nümunəsindən də bəhs edir. AutoLabel-NER sənaye tələbləri spesifikasiyalarından ibarət sahəyə xas NER korpusu yaratmaq üçün istifadə olunub. Bu korpus bir neçə min spesifikasiya, on minlərlə cümlə və yüz minlərlə token ehtiva edir. Paylaşılmış doğrulama alt dəstində güclü inter-annotator agreement bildirildiyi, yəni fərqli etiketləyicilərin böyük ölçüdə ardıcıl etiketlər yarada bildiyi qeyd olunur.
Bu verilənlər dəstindən yaradılan BIO çıxışının aralıq çevrilməyə ehtiyac olmadan transformer əsaslı NER modellərini fine-tune etmək üçün istifadə edildiyi və ən yaxşı modelin ayrıca saxlanmış test dəstində 0.9721 F1 balına çatdığı bildirilir. Bu nəticə alətin yalnız interfeys rahatlığı vermədiyini; model təliminə uyğun, ardıcıl və istifadə oluna bilən verilən istehsalına töhfə verdiyini göstərir.
Nəticələr Nəyi Göstərir?
Birinci nəticə NER layihələrində verilən etiketləməsinin model arxitekturasından daha az vacib olmamasıdır. Düzgün token sərhədləri, ardıcıl BIO sıraları və tam O etiketləri olmadan ən güclü transformer modeli belə səhv və ya ziddiyyətli verilənlərlə öyrədilə bilər.
İkinci nəticə oflayn işləmənin bəzi sahələrdə kritik dəyərə malik olmasıdır. Klinik qeydlər, hüquqi sənədlər, şirkətdaxili hesabatlar, maliyyə sənədləri və ya sənaye spesifikasiyaları kimi mətnlər ictimai buluda yüklənə bilməz. AutoLabel-NER belə hallarda verilənləri lokal kompüterdə saxlayaraq tədqiqat aparmağı asanlaşdırır.
Üçüncü nəticə avtomatik etiket yayılmasının təkrar yükünü ciddi şəkildə azalda bilməsidir. Eyni varlıq sənədin bir çox yerində keçirsə, onu bir-bir əl ilə işarələmək həm vaxt itkisi, həm də ardıcıllıq riski yaradır. Exact-string label propagation bu təkrarları böyük ölçüdə azaldır.
Dördüncü nəticə token uyğunlaşdırmasının görünməyən, lakin kritik keyfiyyət məsələsi olmasıdır. İstifadəçi interfeysində düzgün görünən seçim modelin tokenizasiyası ilə uyğun deyilsə, BIO faylı pozula bilər. AutoLabel-NER-in NLTK tokenizasiyası və simvol intervalı uyğunlaşdırması bu riski azaltmağı hədəfləyir.
Beşinci nəticə standart ixracın tədqiqat axınını sürətləndirməsidir. BIO, JSON, XLSX və CSV çıxışlarının bir alətdən alınması Hugging Face Transformers, spaCy və Flair kimi kitabxanalara keçidi asanlaşdırır. Beləliklə, tədqiqatçıların verilən çevirmə skriptləri yazarkən edə biləcəyi səssiz xətalar azala bilər.
Bu Niyə Vacibdir?
Bu tədqiqat süni intellekt layihələrində tez-tez unudulan məqamı görünən edir: Verilən etiketləmə infrastrukturu güclü deyilsə, model uğuru da kövrək olur. Xüsusilə xüsusi sahələrdə hazır verilənlər dəsti çox vaxt mövcud deyil. Tibbi, hüquqi, maliyyə və ya sənaye mətnlərində model öyrətmək istəyən tədqiqatçılar çox vaxt öz verilənlər dəstlərini yaratmalıdırlar.
AutoLabel-NER kimi alətlərin əhəmiyyəti burada ortaya çıxır. Alət böyük model təklif etmir; lakin modelin öyrənə biləcəyi təmiz verilənlərin hazırlanmasını asanlaşdırır. Bu, verilən-mərkəzli süni intellekt yanaşması baxımından vacibdir. Çünki model performansını yalnız arxitektura ilə deyil, verilənlərin keyfiyyəti ilə də yaxşılaşdırmaq lazımdır.
Məxfilik ölçüsü də kritikdir. Səhiyyə qurumu xəstə qeydlərini, şirkət texniki sənədlərini, hüquq komandası məhkəmə iş materiallarını və ya maliyyə qurumu hesabatlarını xarici bulud xidmətinə yükləyə bilməz. Oflayn və lokal işləyən etiketləmə aləti bu sahələrdə tədqiqat və model inkişafı üçün praktik imkan yaradır.
Tədqiqatın mühəndislik dəyəri də kiçildilməməlidir. Yaxşı tədqiqat proqramı yalnız mürəkkəb alqoritm yaratmaq demək deyil; bəzən doğru yerdə doğru kiçik avtomatlaşdırmaları təqdim etməkdir. Bir kliklə O etiketini tamamlama, boşluqları təmizləmə, token sərhədini uyğunlaşdırma və eyni varlığı yayma kimi xüsusiyyətlər böyük verilən etiketləmə layihələrində ciddi vaxt və keyfiyyət fərqi yarada bilər.
Diqqət Edilməli Məqamlar
Birinci diqqət məqamı tədqiqatın preprint olmasıdır. Rəyçi qiymətləndirməsindən keçmədiyi üçün proqramın iddiaları, əhatə dairəsi və qiymətləndirmə nəticələri gələcəkdə dəyişə bilər. Buna görə tədqiqat ümidverici tədqiqat proqramının təqdimatı kimi oxunmalıdır.
İkinci diqqət məqamı alətin avtomatik etiketləmə strategiyasının exact-string uyğunluğuna əsaslanmasıdır. Eyni söz ardıcıllığını tutmaq təkrarları sürətləndirir; lakin kontekstə görə fərqli məna daşıyan uyğunluqlarda istifadəçi nəzarəti tələb olunur. Hər avtomatik yayılma doğru hesab edilməməlidir.
Üçüncü diqqət məqamı NER etiketləmə keyfiyyətinin yalnız alətlə müəyyən edilməməsidir. Etiket təlimatı, etiketləyici təlimi, sahə ekspertizası, uyğunsuzluqların həlli və keyfiyyətə nəzarət protokolu hələ də tələb olunur. Alət yaxşı ola bilər; lakin pis müəyyən edilmiş etiket sxemi yenə də ziddiyyətli verilənlər yarada bilər.
Dördüncü diqqət məqamı NLTK tokenizasiyasının hər dil və sahə üçün ideal olmaya bilməsidir. İngilis dili texniki mətnlərində yaxşı nəticə verə bilər; lakin türk, ərəb, qarışıq-kodlu mətnlərdə, tibbi qısaltmalarda və ya xüsusi simvollar olan sahələrdə tokenizasiya ayrıca sınaqdan keçirilməlidir.
Beşinci diqqət məqamı oflayn işləmənin məxfilik baxımından dəyərli olsa da, təkbaşına tam təhlükəsizlik demək olmamasıdır. Lokal kompüterdə fayl icazələri, disk şifrələnməsi, ehtiyat nüsxələmə, giriş nəzarəti və layihə fayllarının təhlükəsiz paylaşılması ayrıca nəzərə alınmalıdır.
Nəticə
Bu tədqiqat təbii dil emalı layihələrində verilən hazırlığının nə qədər mərkəzi olduğunu xatırladır. AutoLabel-NER xüsusi sahələrdə NER verilənlər dəsti yaratmaq istəyən tədqiqatçılar üçün oflayn, açıq mənbəli və yüngül masaüstü alət təklif edir.
Alətin güclü tərəfi üç praktik problemi eyni iş axınında həll etməyə çalışmasıdır: təkrarlanan varlıqların dəfələrlə etiketlənməsi, istifadəçi seçimi ilə token sərhədləri arasındakı uyğunsuzluq və varlıqdan kənar tokenlərin O etiketi ilə tamamlanması. Bunlara BIO, JSON, XLSX və CSV ixrac dəstəyi əlavə olunduqda xam mətndən model təliminə keçid daha nizamlı olur.
Verianla baxımından tədqiqatın əsas mesajı budur: Süni intellektdə uğur yalnız böyük modellərdən gəlmir. Xüsusilə xüsusi sahələrdə etibarlı verilənlər dəsti yaratmaq model inkişafı qədər strateji işdir. AutoLabel-NER bu “verilən işi”ni daha sürətli, daha təhlükəsiz və daha təkrarlana bilən etməyi hədəfləyən praktik tədqiqat alətidir.
Mənbə və Metod Qeydi
Bu məzmun Abderrahmane Boudribila, Abdelouahed Tajer və Zakaria Boulghasoul tərəfindən hazırlanmış “AutoLabel-NER: A Lightweight Offline Annotation Tool for Building Custom Named Entity Recognition Datasets” adlı preprint tədqiqata əsasən hazırlanıb. Tədqiqat oflayn NER verilən etiketləməsi, BIO tagging, NLTK əsaslı token uyğunlaşdırması, avtomatik etiket yayılması, Outside etiketinin tamamlanması, lokal layihə saxlanması və standart verilən ixracı xüsusiyyətlərinə malik AutoLabel-NER alətini təqdim edir.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla-nın nəşr xəttinə uyğun şəkildə sadələşdirilib və orijinal türkcə redaksiya məqaləsinə çevrilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib