

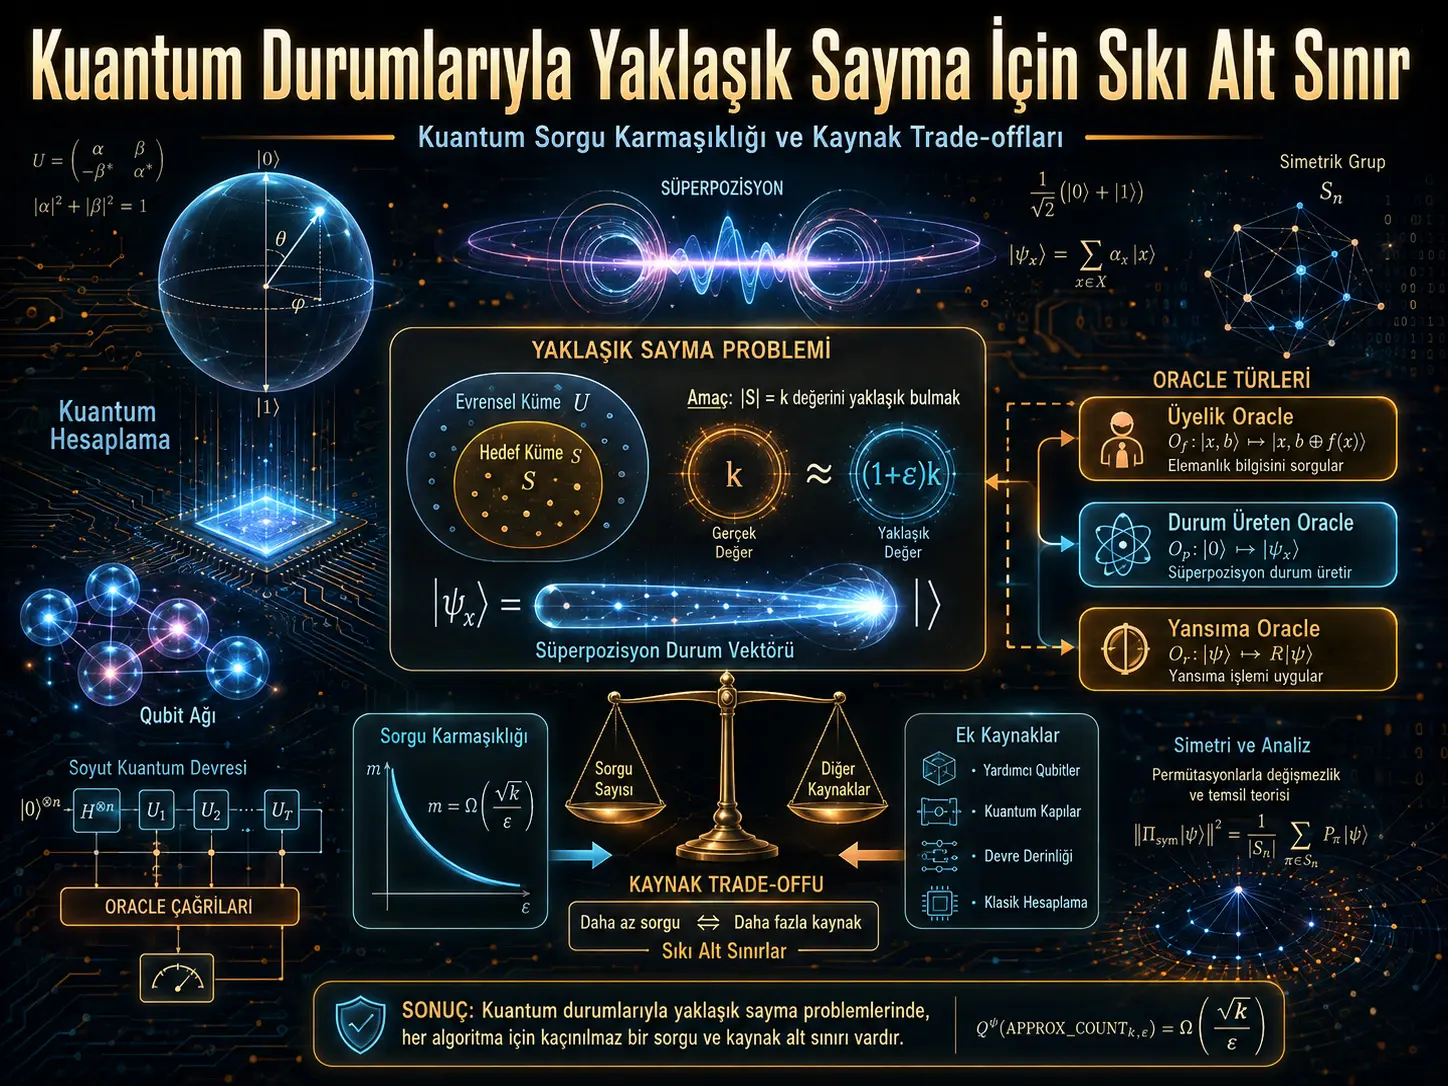
Bu çalışma, bir kümenin eleman sayısını kuantum kaynakları kullanarak yaklaşık olarak belirleme probleminin temel maliyet sınırlarını ortaya koyuyor. Araştırmacılar, giriş kümesinin büyüklüğünün ya k ya da k′ = (1+ε)k olduğu iki durumu ayırt eden kuantum algoritmalarını inceliyor. Algoritmaya klasik üyelik sorgusunun kuantum karşılığı olan membership oracle yanında, kümenin elemanlarının düzgün kuantum süperpozisyonu olan \(|\psi_x\rangle\) durumuna üç farklı erişim biçimi sağlanıyor: bu durumun kopyaları, durum etrafında yansıma yapan oracle ve durumu üreten oracle. Çalışmanın temel sonucu, \(n\geq5k\) ve \(1/k\leq\varepsilon\leq1\) bölgesinde bu kaynakların her biri ve kombinasyonları için sıkı alt sınırlar elde edilmesi ve eşleşen algoritmalarla bu sınırların büyük ölçüde optimal olduğunun gösterilmesidir.
Sonuç yalnızca “kaç kuantum sorgusu gerekir?” sorusunu cevaplamıyor. Asıl önemli nokta, dört farklı kaynağın birbirinin yerine ne ölçüde geçebildiğini matematiksel olarak belirleyen kaynak trade-off'larını ortaya çıkarmasıdır. Örneğin yalnız membership oracle kullanıldığında gerekli sorgu sayısı \(\Omega((1/\varepsilon)\sqrt{n/k})\) iken, yalnız state-generating oracle kullanıldığında problem bazı parametre bölgelerinde \(k^{1/3}/\varepsilon^{2/3}\) ölçeğinde çözülebilmektedir. Buna karşılık farklı kaynakları bir araya getirmek sınırsız bir avantaj sağlamaz; ana teorem, herhangi bir başarılı algoritmanın makalede verilen sekiz kaynak koşulundan en az birini karşılamak zorunda olduğunu gösterir.
Bu sonuçlar gerçek bir kuantum bilgisayar üzerinde işlem süresi veya saniye cinsinden performans ölçümü değildir. Çalışma, kuantum sorgu karmaşıklığı modelinde teorik alt ve üst sınırlar kanıtlamaktadır. Dolayısıyla sonuçlardan belirli bir kuantum donanımının gerçek çalışma süresi, hata oranı veya pratik üstünlüğü doğrudan çıkarılamaz.
Yaklaşık sayma problemi nedir?
Araştırmacıların ele aldığı problem, bilinmeyen bir \(x\subseteq[n]\) kümesinin büyüklüğünü tam olarak bulmak yerine iki olasılığı ayırt etmektir:
\[ |x|=k \]
veya
\[ |x|=k'=(1+\varepsilon)k. \]
Burada \(n\), olası tüm elemanların sayısını; \(k\), küçük küme büyüklüğünü; \(\varepsilon\) ise iki olasılık arasındaki göreli farkı belirleyen hassasiyet parametresini temsil eder. \(\varepsilon\) küçüldükçe iki durum birbirine yaklaşır ve ayırt etme problemi zorlaşır.
Bu karar problemi, daha genel olan “kümenin büyüklüğünü çarpımsal hata payıyla tahmin etme” probleminin alt sınırlarını incelemek için kullanılır. Eğer bir algoritma \(k\) ile \((1+\varepsilon)k\) durumlarını bile ayırt etmek için belirli miktarda kaynak kullanmak zorundaysa, genel yaklaşık sayma problemi bundan daha ucuz olamaz.
Membership oracle ne sağlar?
Bir küme klasik olarak karakteristik bit dizisiyle gösterilebilir. Her \(i\in[n]\) için \(x_i=1\) ise \(i\in x\), \(x_i=0\) ise \(i\notin x\) kabul edilir. Kuantum membership oracle bu üyelik bilgisini kuantum sorgusu biçiminde erişilebilir kılar.
Çalışmada kullanılan standart biçim şu dönüşümdür:
\[ O_x:|i\rangle|b\rangle\mapsto|i\rangle|b\oplus x_i\rangle. \]
Yalnız bu oracle mevcut olduğunda yaklaşık saymanın sorgu karmaşıklığı daha önce bilinen sonuçlarla
\[ \Theta\!\left(\frac{1}{\varepsilon}\sqrt{\frac{n}{k}}\right) \]
ölçeğindedir. Bu çalışma, bunun ötesine geçerek algoritmanın küme hakkında doğrudan kuantum durumuna erişebildiği modelleri inceliyor.
Kümenin kuantum durumu nasıl tanımlanıyor?
Kümenin elemanları üzerinde düzgün süperpozisyon
\[ |\psi_x\rangle= \frac{1}{\sqrt{|x|}} \sum_{i\in x}|i\rangle \]
şeklinde tanımlanıyor. Bu kuantum durumu, kümedeki her elemana eşit genlik verir. Araştırmanın kritik sorusu, algoritmaya membership oracle yanında bu durum hakkında ek kuantum kaynakları verilmesinin yaklaşık saymanın maliyetini ne kadar azaltabileceğidir.
Kuantum durumuna üç farklı erişim neden ayrılıyor?
Makale üç farklı erişim biçimini birbirinden bağımsız kaynak olarak sayıyor.
- Durum kopyaları: Algoritmaya doğrudan \(|\psi_x\rangle\) durumunun belirli sayıda kopyası verilir.
- Reflecting oracle: Algoritma \(|\psi_x\rangle\) durumu etrafında yansıma gerçekleştiren bir oracle kullanabilir.
- State-generating oracle: Bir başlangıç durumunu \(|0\rangle\mapsto|\psi_x\rangle\) biçiminde dönüştüren ve ters yönde de çalıştırılabilen oracle sağlanır.
State-generating oracle bu üçü arasında özellikle güçlüdür. Kaynağa göre bir çağrı bir \(|\psi_x\rangle\) kopyası üretmek için yeterlidir; iki çağrı — biri doğrudan, biri ters — \(|\psi_x\rangle\) etrafındaki yansımayı gerçekleştirebilir. Bunun tersine, yalnız kopyalar ve yansımalar kullanılarak genel state-generating oracle'nın kolay biçimde simüle edildiği gösterilmemektedir.
Ana teorem ne söylüyor?
Ana sonuç \(n\geq5k\) ve \(1/k\leq\varepsilon\leq1\) için veriliyor. Algoritmanın elinde \(\ell\) adet \(|\psi_x\rangle\) kopyası bulunduğunu ve membership, state-generating ve reflecting oracle'ları sırasıyla \(q_M\), \(q_G\) ve \(q_R\) kez kullandığını düşünelim. Başarılı bir algoritmanın, aşağıdaki kaynak koşullarından en az birinin belirlediği ölçeğe ulaşması gerekiyor.
| Kaynak veya kaynak bileşimi | Kanıtlanan alt sınır / trade-off | Bilimsel anlamı |
|---|---|---|
| Yalnız durum kopyaları | \(\ell=\Omega\!\left(\min\left\{k,\frac{\sqrt{k}}{\varepsilon},\frac{n}{k\varepsilon^2}\right\}\right)\) | Kuantum durumunu yalnız örnek olarak almak da sınırsız bilgi sağlamaz. |
| Yalnız membership oracle | \(q_M=\Omega\!\left(\frac{1}{\varepsilon}\sqrt{\frac{n}{k}}\right)\) | Standart kuantum yaklaşık sayma sınırı korunur. |
| Yalnız state-generating oracle | \(q_G=\Omega\!\left(\min\left\{\frac{1}{\varepsilon}\sqrt{\frac{n}{k}},\frac{k^{1/3}}{\varepsilon^{2/3}}\right\}\right)\) | Durumu aktif biçimde hazırlamak bazı parametre bölgelerinde membership sorgularından daha güçlü olabilir. |
| State-generating oracle + durum kopyaları | \(q_G\sqrt{\ell}=\Omega\!\left(\frac{\sqrt{k}}{\varepsilon}\right)\) | Daha fazla hazır kopya, gereken state-generating sorgularını azaltabilir; ancak ürün trade-off'u korunur. |
| Yalnız reflecting oracle | \(q_R=\Omega\!\left(\min\left\{\frac{1}{\varepsilon}\sqrt{\frac{n}{k}},\sqrt{\frac{k}{\varepsilon}}+\sqrt{\frac{n}{k}}\right\}\right)\) | Yansıma oracle'sı da belirli bir asimptotik maliyetin altına inemez. |
| Reflecting oracle + kopya/state-generating kaynağı | \(q_R\sqrt{\ell+q_G}=\Omega\!\left(\frac{\sqrt{k}}{\varepsilon}\right)\) | Yansıma erişimi ile durum hazırlama kaynakları arasında sıkı bir değiş-tokuş vardır. |
| Reflecting oracle + en az bir durum kaynağı | \(q_R=\Omega\!\left(\sqrt{\frac{k}{\varepsilon}}\right)\), ayrıca \(\ell+q_G\geq1\) | Tek bir ek durum kaynağı bile reflecting oracle gereksinimini tamamen ortadan kaldırmaz. |
| Reflecting oracle + membership oracle | \(q_R=\Omega\!\left(\sqrt{\frac{k}{\varepsilon}}\right)\) ve \(q_M=\Omega\!\left(\sqrt{\frac{n}{k}}\right)\) | İki oracle'nın birlikte kullanılması her ikisinin de temel maliyetini sıfırlayamaz. |
Burada \(\Omega(\cdot)\), kaynak miktarının sabit çarpanlar göz ardı edildiğinde verilen fonksiyondan asimptotik olarak daha küçük olamayacağını ifade eder. Tablo gerçek bir algoritmanın duvar saati süresini değil, oracle çağrıları ve durum kopyaları açısından kaynak karmaşıklığını gösterir.
Neden dört kaynağı birden kullanmak ayrı bir avantaj yaratmıyor?
Çalışmanın dikkat çekici sonuçlarından biri, üç veya dört kaynağın aynı algoritmada birlikte kullanılmasının yeni ve bağımsız bir “dokuzuncu rejim” yaratmamasıdır. Yazarların teoremine göre başarılı bir algoritmanın kaynak tüketiminde, yukarıdaki sekiz koşuldan birini sağlayan tek bir kaynak veya kaynak çifti mutlaka bulunur.
Bu sonuç, farklı kuantum erişim biçimlerinin birbirine yardımcı olabildiğini ancak toplam kaynak maliyetinin matematiksel alt sınırlarını keyfi biçimde aşamadığını gösterir.
Alt sınır neden “sıkı” olarak adlandırılıyor?
Bir karmaşıklık alt sınırına “sıkı” denebilmesi için yalnızca algoritmanın daha az kaynakla çalışamayacağını kanıtlamak yetmez; aynı ölçeğe ulaşan bir üst sınır algoritmasının da bulunması gerekir. Makalenin Ek A bölümü bu amaçla eşleşen algoritmalar veriyor.
Yazarlar, Tablo 1'deki alt sınırların tamamının sabit çarpanlara kadar eşleştiğini bildiriyor. Tek ayrıntı, yalnız kopyalar için ilk \(k\) teriminde verilen üst sınırın çalışmada \(O(k\log k)\) olmasıdır. Makale bu noktada alt sınır ile verilen algoritma arasında logaritmik bir fark bulunduğunu açıkça belirtmektedir.
Kopyalarla yaklaşık sayma nasıl yapılabiliyor?
Ek A'da birden fazla yaklaşım veriliyor. Bunlardan biri klasik coupon collector mantığına benzer: \(|\psi_x\rangle\) durumları ölçülerek kümeden düzgün rastgele örnekler elde edilir ve kaç farklı elemanın görüldüğü takip edilir.
Başka bir yaklaşımda alınan \(\ell\) örnek arasında eşleşen çiftlerin sayısı kullanılır. İki bağımsız düzgün örneğin eşit olma olasılığı yaklaşık olarak \(1/|x|\) olduğundan, çakışma sayısı küme büyüklüğü hakkında bilgi verir. Makale bu yöntemle
\[ O\!\left(\frac{\sqrt{k}}{\varepsilon}\right) \]
örneğin yeterli olduğunu gösterir.
Bir başka kopya-temelli algoritmada ise \(|\psi_x\rangle\), tüm \([n]\) elemanlarının düzgün süperpozisyonuna karşı ölçülür. İlgili ölçüm olayının olasılığı \(|x|/n\) olduğundan, Bernoulli örneklemesiyle \(k/n\) ile \((1+\varepsilon)k/n\) ayrılabilir. Bunun kaynak maliyeti
\[ O\!\left(\frac{n}{k\varepsilon^2}\right) \]
kopyadır.
State-generating oracle için \(k^{1/3}\) ölçeği nereden geliyor?
Ek A'daki algoritma önce kümeden \(t\) farklı eleman elde ediyor, ardından bilinen bu alt kümeden yararlanarak amplitude estimation uyguluyor. Kaynak maliyeti kabaca
\[ O\!\left( t+\frac{1}{\varepsilon}\sqrt{\frac{k}{t}} \right) \]
biçiminde yazılıyor. Birinci terim örnek toplamanın, ikinci terim ise kalan sayma probleminin maliyetidir.
Bu iki maliyet dengelendiğinde
\[ t\sim\frac{k^{1/3}}{\varepsilon^{2/3}} \]
ölçeği ortaya çıkar ve toplam state-generating oracle karmaşıklığı da aynı asimptotik düzeye iner. Bu sonuç, makaledeki \(k^{1/3}/\varepsilon^{2/3}\) teriminin algoritmik kökenini açıklar.
Reflecting oracle neden amplitude amplification açısından önemli?
Bir kuantum durumu etrafında yansıma, amplitude amplification ve amplitude estimation işlemlerinin temel bileşenlerinden biridir. Makale, önceden \(x\) kümesine ait olduğu bilinen bir eleman mevcutsa reflecting oracle ile yeni elemanların bulunabileceğini ve ardından küme büyüklüğünün tahmin edilebileceğini gösteriyor.
Bu senaryoda uygun parametre seçimiyle yaklaşık sayma için
\[ O\!\left(\sqrt{\frac{k}{\varepsilon}}\right) \]
reflecting-oracle sorgusu yeterlidir. Ancak başlangıçta \(x\)'ten bilinen bir eleman yoksa bunu bulmak için ayrıca yaklaşık \(\sqrt{n/k}\) ölçeğinde Grover tipi arama gerekir.
Çalışmanın ispat mimarisi nasıl ilerliyor?
Verianla Live: Sıkı kuantum alt sınırının ispat zinciri
Bu süreç, çalışmanın bölümlerinde izlenen matematiksel stratejiyi özetler. Aşamalar kaynakta kullanılan gerçek ispat yapısını temsil eder; yeni bir algoritma veya ara sonuç eklenmemiştir.
| Aşama | Açıklama | Kaynak |
|---|---|---|
| 1. Yaklaşık sayma probleminin tanımlanması | \(|x|=k\) ile \(|x|=(1+\varepsilon)k\) durumları ve dört kaynak türü tanımlanır. | Bölüm 1–2 |
| 2. Çoklu oracle adversary çerçevesi | Genel adversary yöntemi, bir algoritmanın birden fazla giriş oracle'sını bağımsız kaynaklar olarak kullanabileceği biçimde formüle edilir. | Bölüm 3 |
| 3. Simetri kullanılarak adversary matrisinin sadeleştirilmesi | Problemin permütasyon simetrisi kullanılarak adversary matrisi simetrik grubun indirgenemez temsilleri üzerinden ayrıştırılır. | Bölüm 4–5 |
| 4. Oracle türleri için norm tahminleri | Membership, state-generating ve reflecting oracle'ların adversary matrisi üzerindeki etkilerini sınırlayan temel lemmalar kanıtlanır. | Bölüm 4, 6 ve 7 |
| 5. Simetrik grup temsil teorisi | \(\mathbb{C}^{\binom{[n]}k}\) ve \(\mathbb{C}^{\binom{[n]}k}\otimes\mathbb{C}^n\) modülleri analiz edilerek gerekli isotypical altuzaylar belirlenir. | Bölüm 5–8 |
| 6. Parametrik adversary matrisi | \(\gamma_j=\max\{1-j/t,0\}\) seçimiyle kaynak trade-off eğrisinde hareket etmeyi sağlayan tek parametreli yapı oluşturulur. | Bölüm 4.2 |
| 7. Ana alt sınır teoremi | Elde edilen norm tahminleri birleştirilerek başarılı algoritmanın sekiz kaynak koşulundan en az birini sağlaması gerektiği gösterilir. | Theorem 1.1 / Bölüm 4.3 |
| 8. Eşleşen üst sınırlar | Örnekleme, coupon collector, amplitude amplification ve amplitude estimation tabanlı algoritmalarla alt sınırların sıkılığı gösterilir. | Ek A |
Adversary yöntemi burada neden merkezi?
Kuantum sorgu karmaşıklığında alt sınır ispatlamak için kullanılan temel araçlardan biri adversary method yöntemidir. Kabaca amaç, farklı doğru çıktılar gerektiren girişleri birbirinden ayırmanın her oracle sorgusunda ne kadar ilerleme sağlayabileceğini sınırlamaktır.
Bu çalışmanın teknik yeniliği, yalnız standart membership oracle'ya göre tasarlanmış bir adversary yöntemini kullanmak yerine, genel üniter giriş oracle'larını ve birden fazla oracle kaynağını aynı çerçevede ele alan varyantı uygulamasıdır.
Çoklu oracle durumunda makalede verilen temel eşitsizlik şu biçimdedir:
\[ \sum_{i=1}^{r} \left\|\Gamma\circ\Delta^{(i)}\right\| \max_{x\in D} L_x^{(i)} \geq \|\Gamma\circ E\|. \]
Burada \(\Gamma\) adversary matrisi; \(\Delta^{(i)}\), \(i\). oracle'nın farklı girdiler arasında ne kadar değiştiğini; \(L_x^{(i)}\), algoritmanın ilgili oracle'ya yaptığı kaynak kullanımını; \(E\) ise başlangıç ve hedef durumların Gram-matrisleri arasındaki farkı temsil eder.
Bu formülün işlevi, “algoritmanın bütün kaynakları aynı anda az kullanması” ihtimalini sınırlandırmaktır. Uygun bir \(\Gamma\) seçildiğinde en az bir kaynağın yeterince büyük olması gerektiği gösterilebilir.
Simetri problemi nasıl basitleştiriyor?
Yaklaşık sayma probleminde hangi elemanların \(x\)'te olduğu değil, toplam kaç elemanın bulunduğu önemlidir. Dolayısıyla eleman etiketlerinin permütasyonu problemi değiştirmez. Araştırmacılar bu simetriyi kullanarak adversary matrisini simetrik grubun temsilleri cinsinden yazıyor:
\[ \Gamma=\sum_{j=0}^{k}\gamma_j\Phi_j. \]
\(\Phi_j\) operatörleri, ilgili \(S_n\) indirgenemez temsil kopyaları arasındaki izometrik izomorfizmleri temsil eder. Farklı bileşenlerin görüntü ve ortak görüntü uzayları birbirine ortogonal olduğundan karmaşık bir yüksek boyutlu matris problemi, \(\gamma_j\) katsayılarının kontrol edildiği çok daha düzenli bir probleme dönüşür.
Neden \(\gamma_j=\max\{1-j/t,0\}\) seçiliyor?
Ana ispatta adversary matrisinin katsayıları için
\[ \gamma_j=\max\left\{1-\frac{j}{t},0\right\} \]
seçiliyor. \(t\), 1 ile yaklaşık \(k/5\) arasında alınan bir parametredir.
Bu seçim \(j=0\)'da yüksek değerle başlayıp \(j=t\)'de sıfıra inen doğrusal bir gradyan oluşturur. Yazarlar \(t\)'yi değiştirerek farklı kaynak kombinasyonları arasındaki trade-off eğrisinin farklı bölgelerine ulaşabilmektedir. Böylece her kaynak çifti için baştan tamamen farklı adversary matrisi kurmak yerine, tek bir parametrik aile kullanılmaktadır.
Temsil teorisi neden gerekli?
Çalışmanın ikinci büyük matematiksel bileşeni simetrik grup \(S_n\)'nin temsil teorisidir. Araştırmacılar özellikle
\[ \mathbb{C}^{\binom{[n]}k} \]
modülünün indirgenemez bileşenlere
\[ S^{(n)} \oplus S^{(n-1,1)} \oplus S^{(n-2,2)} \oplus\cdots\oplus S^{(n-k,k)} \]
biçiminde ayrıldığını kullanıyor. Her indirgenemez bileşenin burada multiplicity 1 ile bulunduğu gösteriliyor.
Durum oracle'larının analizi için daha karmaşık
\[ \mathbb{C}^{\binom{[n]}k}\otimes\mathbb{C}^{n} \]
modülü gerekiyor. Makalenin uzun temsil-teorisi bölümü, adversary matrisinin bu uzaylarda nasıl davrandığını belirlemek için gerekli ortonormal bazları ve izotipik bileşenleri inşa ediyor.
Şekil 1 neyi gösteriyor?
Çalışmanın 33. sayfasındaki tek şekil, farklı
\[ \mathbb{C}^{\binom{[n]}\ell}\otimes\mathbb{C}^{n} \]
modülleri içinde \(D_j\) operatörünün görüntüsünün yapısını şematik olarak gösteriyor. Sütunlar \(\ell=j-1,j,j+1,\ldots,k\) değerleriyle değişen modüllere karşılık geliyor. Sarı bölgeler, altı boyutlu genel görüntünün araştırmanın ihtiyaç duyduğu dört boyutluk \(A^\ell_j\) kısmını temsil ediyor.
Şekilde çerçevelenen ilk vektörler her temsil dizisinin başlangıç noktasını, oklar ise \(W_{\ell\rightarrow k}\) morfizmasıyla aynı temsil bileşeninin daha büyük \(k\) değerlerine taşınmasını gösteriyor. Bu görsel deneysel bir sonuç değildir; uzun cebirsel yapının ispat organizasyonunu anlatan temsil-teorik bir şemadır.
Çalışmanın desteklediği sonuçlar
- \(n\geq5k\) ve \(1/k\leq\varepsilon\leq1\) rejiminde incelenen yaklaşık sayma problemi için membership, state-generating ve reflecting oracle'lar ile kuantum durum kopyaları arasında sıkı kaynak alt sınırları kurulabilir.
- Membership oracle tek başına kullanıldığında sorgu alt sınırı \(\Omega((1/\varepsilon)\sqrt{n/k})\)'dir.
- State-generating oracle bazı parametre bölgelerinde \(k^{1/3}/\varepsilon^{2/3}\) sorgu ölçeğine kadar avantaj sağlayabilir.
- Kuantum durum kopyaları ile oracle sorgularının birlikte kullanılması kaynak trade-off'ları oluşturur; bir kaynağın artırılması diğerini azaltabilir fakat bütün alt sınırları ortadan kaldırmaz.
- Genel adversary yöntemi, standart membership oracle dışındaki üniter giriş oracle'larını ve birden fazla oracle kaynağını analiz etmek için kullanılabilir.
- Simetrik grup temsil teorisi, yaklaşık sayma probleminin simetrisini kullanarak adversary optimizasyonunu ciddi biçimde sadeleştirir.
- Çalışmadaki alt sınırlar, belirtilen tek istisna dışında, Ek A'daki algoritmalarla sabit çarpanlara kadar eşleşmektedir.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Çalışma gerçek kuantum donanımında deney gerçekleştirmemektedir.
- Belirli bir kuantum işlemcinin saniye cinsinden çalışma süresini ölçmemektedir.
- Oracle çağrılarının fiziksel kapı sayısı, hata düzeltme maliyeti veya enerji tüketimiyle birebir eşdeğer olduğunu göstermemektedir.
- Sonuçlar bütün olası \(n,k,\varepsilon\) değerleri için tek bir biçimde kanıtlanmamıştır; ana teorem açıkça \(n\geq5k\) ve \(1/k\leq\varepsilon\leq1\) varsayımlarını kullanmaktadır.
- Teorik sorgu avantajı, uygulama düzeyinde otomatik bir kuantum hızlanması veya ticari üstünlük anlamına gelmez.
- Çalışma yaklaşık saymanın bütün kuantum hesaplama modellerindeki zaman ve uzay karmaşıklığını çözmemektedir; ele alınan ana ölçüt sorgu kaynaklarının karmaşıklığıdır.
Gelecek araştırmalar için hangi problem açık kalıyor?
Yazarlar özellikle k-fold search problemindeki kaynak trade-off'larını açık bir yön olarak işaret ediyor. Bu problemde \(x\) kümesinin büyüklüğü \(k\) olarak biliniyor ve görev yalnız büyüklüğü tahmin etmek değil, kümenin tamamını üretmektir.
Çalışmada kullanılan additive adversary tekniğinin küçük başarı olasılıklarında daha iyi-than-linear bağımlılıklar üretmeye uygun olmadığı belirtiliyor. Bu nedenle multiplicative adversary fikirleriyle genel oracle yaklaşımının nasıl birleştirilebileceği açık bir teknik soru olarak kalıyor.
Türkiye açısından bilimsel önemi nedir?
Çalışma Türkiye'ye özgü veri, kurum, kuantum donanımı veya uygulama sonucu içermemektedir. Türkiye açısından anlamı doğrudan bir yerel performans tahmini değil; kuantum algoritmaları, hesaplama karmaşıklığı ve matematiksel kuantum bilgi araştırmaları için kullanılabilecek temel teorik bir çerçeve sunmasıdır. Üniversitelerde ve araştırma gruplarında kuantum sorgu karmaşıklığı, oracle modelleri veya adversary yöntemleri üzerine yapılacak teorik çalışmalar için kaynak niteliğindedir.
Çalışmanın Yöntemi ve Bulguları
Araştırma tasarımı
Bu çalışma deneysel değil, matematiksel-teorik bir kuantum hesaplama çalışmasıdır. Ana hedef, belirlenmiş bir karar problemi için farklı kuantum erişim kaynaklarının zorunlu asimptotik maliyetini kanıtlamaktır.
Girdi alanı iki sınıfa ayrılır:
- \(X\): Hamming ağırlığı \(k\) olan bütün bit dizileri/kümeler,
- \(Y\): Hamming ağırlığı \(k'=(1+\varepsilon)k\) olan bütün bit dizileri/kümeler.
Algoritmanın görevi girişin \(X\)'te mi yoksa \(Y\)'de mi olduğunu sınırlı hata olasılığıyla belirlemektir.
Kaynak değişkenleri
| Sembol | Kaynak | Anlam |
|---|---|---|
| \(\ell\) | \(|\psi_x\rangle\) kopyaları | Algoritmaya başlangıçta verilen kuantum durum kopyalarının sayısı |
| \(q_M\) | Membership oracle | Üyelik oracle'sına yapılan sorgu miktarı |
| \(q_G\) | State-generating oracle | \(|0\rangle\leftrightarrow|\psi_x\rangle\) dönüşüm kaynağının kullanım miktarı |
| \(q_R\) | Reflecting oracle | \(|\psi_x\rangle\) etrafındaki yansımayı gerçekleştiren oracle'nın kullanım miktarı |
Çoklu oracle sorgu karmaşıklığı nasıl tanımlanıyor?
Araştırmacılar bütün oracle'ları tek bir doğrudan toplam oracle'sı içinde matematiksel olarak birleştiriyor. Ancak toplam sorgu sayısını doğrudan saymak yerine, algoritmanın her oracle bileşeninde ne kadar kuantum genliği taşıdığı ayrı ayrı izleniyor.
\(i\). oracle için \(x\) girdisindeki sorgu karmaşıklığı
\[ L_x^{(i)} = \sum_t \left\| \psi^{(i)}_{t,x} \right\|^2 \]
olarak tanımlanıyor. Böylece bir kuantum algoritmasının oracle seçimini ara ölçümlerle veya süperpozisyon halinde yaptığı daha esnek modeller de alt sınır analizine dahil edilebiliyor.
Adversary matrisinin özel biçimi
Permütasyon simetrisi kullanıldıktan sonra adversary matrisi
\[ \Gamma= \sum_{j=0}^{k}\gamma_j\Phi_j \]
şeklinde yazılıyor ve ana alt sınır ispatı için
\[ \gamma_j= \max\left\{ 1-\frac{j}{t},0 \right\} \]
seçiliyor. Bu seçimle \(\|\Gamma\|=1\) olur ve \(j\geq t\) için katsayılar sıfırlanır.
Başlangıç durumunun etkisi nasıl hesaba katılıyor?
Algoritmaya \(\ell\) adet \(|\psi_x\rangle\) kopyası verilmesi durumunda farklı girdilerin başlangıç durumları aynı değildir. Bu nedenle klasik adversary probleminden farklı olarak başlangıç Gram matrisi de analize girer.
Makale
\[ \Psi[[x,y]] = \langle\psi_x|\psi_y\rangle \]
matrisini tanımlıyor. \(\ell\) kopya olduğunda başlangıç durumlarının Gram matrisi
\[ \Xi=\Psi^{\circ\ell} \]
olur; burada \(\circ\), Hadamard yani eleman-eleman çarpımı temsil eder.
Bu nokta önemlidir: ücretsiz kuantum durum kopyaları algoritmaya daha sorgu yapmadan giriş hakkında bilgi verir. Alt sınır ispatının bu başlangıç bilgisini açıkça hesaba katması gerekir.
State-generating oracle için elde edilen norm tahmini
Belirli adversary matrisi seçimi altında yazarlar state-generating oracle ile ilişkili matris normlarını
\[ O\!\left( \varepsilon\sqrt{\frac{k}{n}} + \varepsilon\sqrt{\frac{t}{k}} + \frac{1}{t} \right) \]
ölçeğinde sınırlar. Bu üç terim sırasıyla problem hassasiyeti ile \(n/k\) oranının, adversary kesim parametresi \(t\)'nin ve gradyanın sonlu eğiminin etkilerini bir arada taşır.
Reflecting oracle için elde edilen norm tahmini
Reflecting oracle için ilgili adversary normu
\[ O\!\left( \frac{1}{t}+\varepsilon \right) \left( \sqrt{\frac{k}{n}} + \sqrt{\frac{t}{k}} \right) \]
ile sınırlandırılır. Bu tahmin, farklı \(t\) seçimlerinin reflecting-oracle alt sınırının farklı rejimlerini üretmesini sağlar.
Membership oracle tahmini
Membership oracle için yazarların elde ettiği temel norm tahmini
\[ \|\Gamma\circ\Delta_i\| = O\!\left( \frac{1}{t}+\varepsilon \right) \sqrt{\frac{k}{n}} \]
biçimindedir. Bu ifade genel adversary alt sınırına yerleştirildiğinde standart \((1/\varepsilon)\sqrt{n/k}\) ölçeğinin geri elde edilmesine katkıda bulunur.
Ana teoremdeki parametre koşulları
Yazarlar ana sonuç için açıkça
\[ n\geq5k \]
ve
\[ \frac{1}{k}\leq\varepsilon\leq1 \]
varsayımlarını kullanıyor. Ayrıca adversary parametresi \(t\) için belirli ispat aşamalarında
\[ 2\ell\leq t\leq\frac{k}{5} \]
koşulu uygulanıyor.
Dolayısıyla kaynak tablolarındaki sonuçları bu varsayımlardan bağımsız evrensel eşitlikler olarak okumak doğru değildir.
Üst sınır algoritmalarının teknik özeti
| Algoritmik araç | Kullanıldığı amaç | Kaynakta elde edilen ölçek |
|---|---|---|
| Coupon collector | Kümeden yeterli sayıda farklı eleman görme | \(O(k\log k)\) örnek ile tam farklı-eleman eşiği |
| Örnek çakışmalarını sayma | \(k\) ile \((1+\varepsilon)k\) durumlarını ayırma | \(O(\sqrt{k}/\varepsilon)\) örnek |
| Uniform durum üzerine projeksiyon | \(|x|/n\) olasılığını tahmin etme | \(O(n/(k\varepsilon^2))\) kopya |
| Amplitude estimation | Küme büyüklüğünü çarpımsal hassasiyetle tahmin etme | Problemin ilgili rejimine göre değişir |
| Amplitude amplification / Grover araması | Kümeden eleman bulma | \(O(\sqrt{n/k})\) oracle çağrısı |
| Önceden bilinen alt kümeden arama | State-generating veya reflecting kaynaklarını daha verimli kullanma | Kaynak trade-off'larının üst sınır algoritmalarını üretir |
Bu algoritmaların amacı gerçek donanım uygulaması sunmak değil, ana teoremdeki alt sınırların erişilebilir olduğunu ve dolayısıyla asimptotik olarak sıkı olduklarını göstermektir.
Çalışmanın güçlü yönleri
- Birden fazla farklı kuantum erişim kaynağını aynı alt sınır çerçevesi içinde ayrı ayrı ölçmesi.
- Önceki yaklaşık sayma problemlerinde açık kalan küçük-\(\varepsilon\) rejimini kapsaması.
- Durum kopyaları, reflecting oracle ve state-generating oracle arasında ayrım yapabilmesi.
- Simetriyi temsil teorisiyle kullanarak genel adversary problemini sistematik biçimde sadeleştirmesi.
- Alt sınırlarla yetinmeyip eşleşen üst sınır algoritmalarını da vermesi.
- Genel üniter input oracle'ları için adversary yönteminin gerçek bir probleme uygulanabilirliğini göstermesi.
Çalışmanın sınırlılıkları
- Ana teorem \(n\geq5k\) ve \(1/k\leq\varepsilon\leq1\) bölgesi için formüle edilmiştir.
- Analiz kuantum sorgu karmaşıklığına odaklanır; toplam kapı karmaşıklığı ve fiziksel çalışma süresi aynı şey değildir.
- Küçük başarı olasılıkları için kullanılan additive adversary yaklaşımının sınırlı olduğu yazarlar tarafından belirtilmiştir.
- Yalnız durum kopyalarına ilişkin ilk \(k\) teriminde verilen üst sınır \(O(k\log k)\) olduğundan burada logaritmik bir boşluk kalmaktadır.
- Makale deneysel bir kuantum uygulaması veya donanım doğrulaması gerçekleştirmemektedir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Tight Quantum Lower Bound for Approximate Counting with Quantum States
Yazarlar: Aleksandrs Belovs; Ansis Rosmanis.
Yazar sırası: Kaynakta verilen sıra aynen korunmuştur.
Eş katkı/eş birinci yazar: Kaynakta belirtilmemiştir.
Sorumlu yazar: Yüklenen belgede açık bir corresponding-author işareti bulunmamaktadır.
Kaynak belge afiliyasyonları: Aleksandrs Belovs — Faculty of Computing, University of Latvia. Ansis Rosmanis — Graduate School of Mathematics, Nagoya University, Japan.
Yüklenen kaynak türü: arXiv preprint sürümü.
Yüklenen sürüm: arXiv:2002.06879v2 [quant-ph].
Preprint ilk gönderim tarihi: 17 Şubat 2020.
Yüklenen v2 revizyon tarihi: 7 Mayıs 2024.
arXiv/DataCite DOI: 10.48550/arXiv.2002.06879.
Preprint resmî bağlantısı: https://arxiv.org/abs/2002.06879
Preprint lisansı: Resmî arXiv kayıt sayfası bu sürüm için Creative Commons Attribution 4.0 International (CC BY 4.0) lisansına bağlantı vermektedir.
Hakemlik ve yayımlanmış sürüm notu: Yüklenen 2002.06879v2 dosyası bir preprint belgesidir ve bu belge kendi başına hakemli dergi sürümü değildir. Bibliyografik doğrulamada aynı başlık ve aynı yazarlarla çalışmanın daha sonra hakemli Computational Complexity dergisinde yayımlandığı doğrulanmıştır.
Hakemli dergi sürümü: Belovs, A.; Rosmanis, A. Tight Quantum Lower Bound for Approximate Counting with Quantum States. Computational Complexity, 35, Article 2 (2026).
Hakemli sürüm DOI: 10.1007/s00037-025-00282-7.
Hakemli sürüm yayınevi: Springer Nature / Springer International Publishing.
Hakemli sürüm resmî bağlantısı: https://doi.org/10.1007/s00037-025-00282-7
Bilimsel içerik kaynağı: Bu Verianla makalesindeki problem tanımı, teoremler, formüller, algoritmalar, temsil-teorisi açıklamaları, alt ve üst sınırlar ile yöntemsel sınırlılıklar yüklenen arXiv:2002.06879v2 belgesine dayanmaktadır. 2026 tarihli dergi kaydı yalnız bibliyografik durumun doğrulanması amacıyla kullanılmış; dış kaynaktan yeni bilimsel sonuç ana metne eklenmemiştir.
Finansman: Kaynağın teşekkür bölümünde A.B.'nin Latvian Quantum Initiative kapsamında Avrupa Birliği Recovery and Resilience Facility projesi no. 2.3.1.1.i.0/1/22/I/CFLA/001 tarafından desteklendiği; çalışmanın bir bölümünün ERDF proje no. 1.1.1.2/I/16/113 ile desteklendiği belirtilmektedir. A.R. için JSPS KAKENHI JP20H05966, MEXT Q-LEAP JPMXS0120319794 ve daha önceki çalışma dönemleri için JP19F19079 ile Centre for Quantum Technologies/National University of Singapore desteği bildirilmektedir.
Veri erişilebilirliği: Kaynakta ayrı bir veri erişilebilirliği beyanı bulunmamaktadır. Çalışma deneysel veri setine dayanan bir araştırma değil, matematiksel-teorik bir sorgu karmaşıklığı çalışmasıdır.
Çıkar çatışması: Yüklenen kaynakta ayrı bir çıkar çatışması beyanı tespit edilmemiştir.
Yazar katkıları: Yüklenen kaynakta CRediT veya ayrıntılı yazar katkı beyanı verilmemiştir.
Temel yöntem: Çoklu üniter giriş oracle'larına genişletilmiş genel adversary yöntemi, \(S_n\) simetrik grubunun temsil teorisi ve matching upper-bound kuantum algoritmaları.
Temel yöntemsel sınır: Sonuçlar sorgu karmaşıklığına ilişkindir. Oracle çağrılarının gerçek kuantum donanımında fiziksel işlem zamanı, hata düzeltme yükü, qubit sayısı veya toplam devre karmaşıklığıyla birebir özdeş olduğu sonucuna varılamaz.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir