

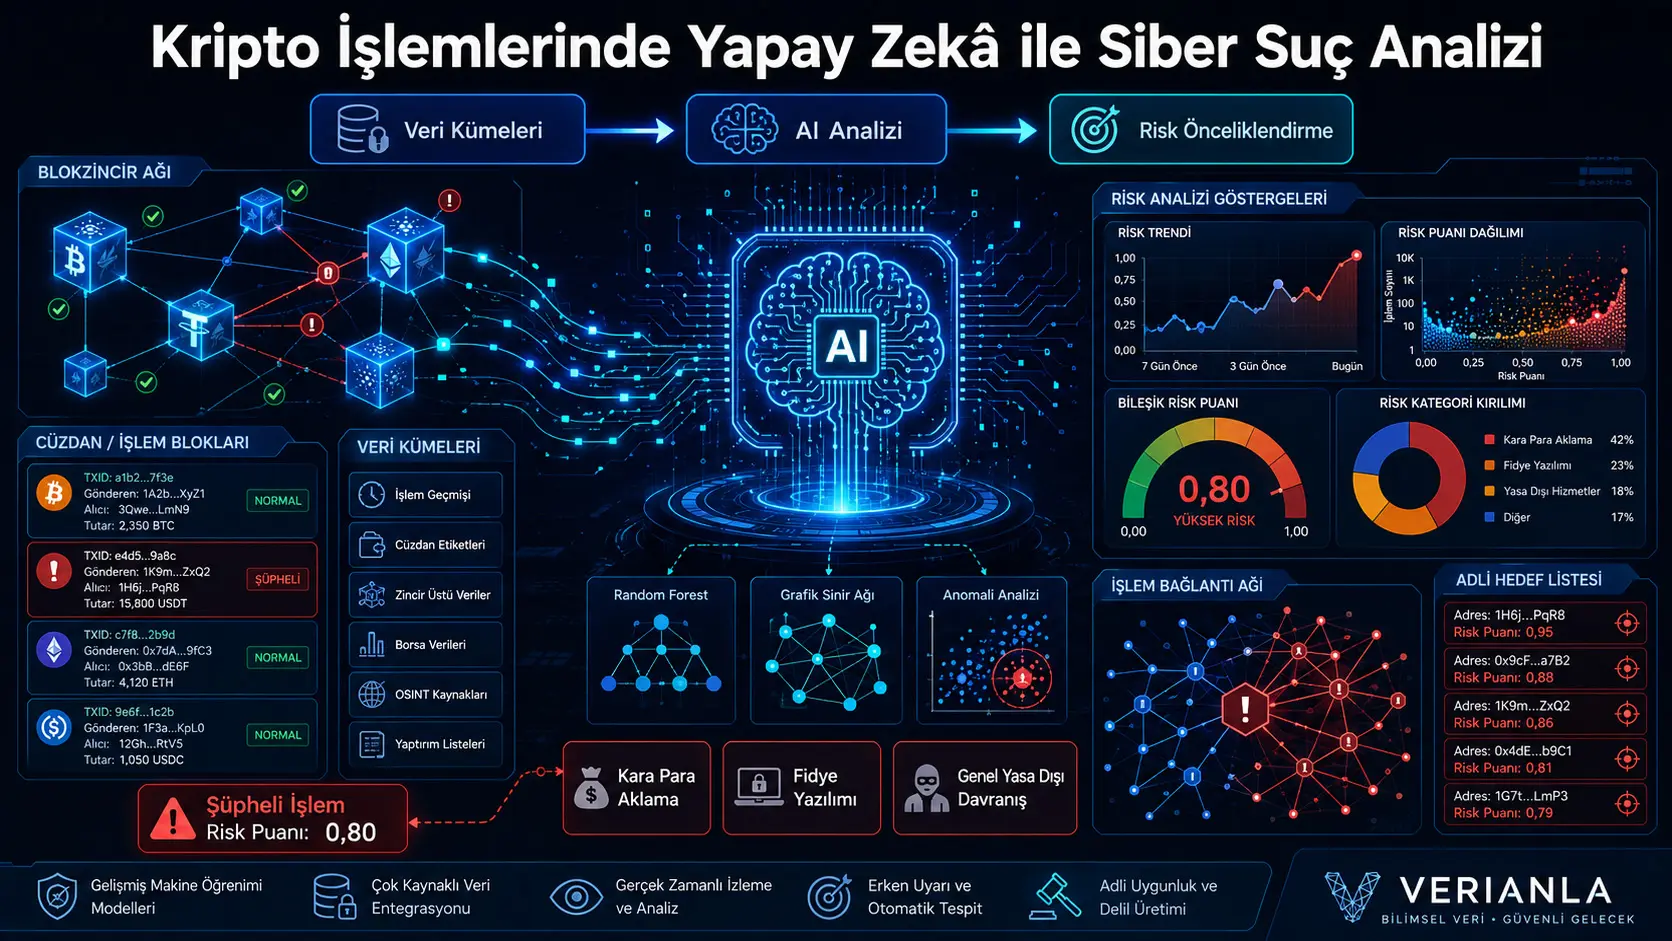
Bu çalışma, Bitcoin işlem verilerindeki şüpheli örüntüleri belirlemek ve dijital adli incelemelerde kullanılabilecek önceliklendirilmiş bir işlem listesi oluşturmak amacıyla farklı yapay zekâ yöntemlerini tek bir analiz hattında birleştirmektedir. Önerilen sistem; denetimli ikili sınıflandırma, yarı denetimli grafik derin öğrenmesi, davranışsal anomali analizi ve işlem bağlantılarının ağ tabanlı incelenmesinden oluşmaktadır.
Ana veri kaynağı olarak 203.769 işlemi, 234.355 yönlü bağlantıyı ve işlem başına 166 özelliği kapsayan Elliptic Bitcoin Veri Kümesi kullanılmıştır. Bu işlemlerin 42.019’u meşru, 4.545’i yasa dışı ve 157.205’i bilinmeyen olarak etiketlenmiştir. BitcoinHeist Ransomware Veri Kümesi fidye yazılımı davranışlarının, IBM AMLSim veri kümesi ise para dağıtma ve katmanlama örüntülerinin temsil edilmesi amacıyla destekleyici kaynak olarak kullanılmıştır.
İkili sınıflandırmada 100 karar ağacından oluşan Random Forest modeli ve K-En Yakın Komşu modeli karşılaştırılmıştır. Araştırmacılar Random Forest için yüzde 98,92 doğruluk, 0,9962 ROC-AUC ve 0,9817 PR-AUC bildirmiştir. Bununla birlikte çalışmanın karışıklık matrisindeki 8.401 doğru meşru, 796 doğru yasa dışı, 3 yanlış pozitif ve 113 yanlış negatif değerleri kullanıldığında toplam doğruluk yaklaşık yüzde 98,75 olarak hesaplanmaktadır. Metinde bildirilen yüzde 98,92 ile görseldeki matris arasında küçük ancak açıklanmamış bir uyuşmazlık bulunmaktadır.
Grafik Evrişim Ağı, etiketli işlemlerden öğrenilen bilgiyi işlem bağlantıları üzerinden bilinmeyen işlemlere aktarmak ve işlemleri meşru, fidye yazılımı benzeri, kara para aklama benzeri veya genel yasa dışı davranış olarak sınıflandırmak için kullanılmıştır. Araştırmacılar dört sınıflı model için yüzde 96 genel doğruluk bildirmiştir. Ancak fidye yazılımı ve kara para aklama sınıfları doğrulanmış adli vaka etiketlerinden oluşturulmamıştır. Fidye yazılımı etiketi belirli bir işlem ağırlığının ortancanın üzerinde bulunmasına, kara para aklama etiketi ise fan-out değerinin ortancanın üzerinde olmasına dayanmaktadır. Dolayısıyla modelin bu sınıflardaki başarısı, büyük ölçüde araştırmacıların oluşturduğu sezgisel etiketleri yeniden öğrenme başarısını göstermektedir.
Random Forest olasılığı, grafik ağının yasa dışı işlem olasılığı ve Isolation Forest anomali puanı birleştirilerek 0 ile 1 arasında Bileşik Risk Puanı oluşturulmuştur. Araştırmacılar 10.188 işlemi yüksek riskli olarak işaretlemiş; bunları 4.893 fidye yazılımı benzeri, 3.627 kara para aklama benzeri ve 1.668 genel yasa dışı işlem adayı olarak sınıflandırmıştır. Bu sayılar doğrulanmış suç işlemlerini değil, model tarafından soruşturma adayı olarak önceliklendirilen kayıtları temsil etmektedir.
Türkiye açısından değerlendirme: Çalışmadaki mimari, Türkiye’de kripto varlık hizmet sağlayıcılarının işlem izleme sistemleri, finansal suç araştırmaları, siber olay incelemeleri ve dijital delil önceliklendirmesi için araştırma prototipi olarak değerlendirilebilir. Ancak uygulama öncesinde Türkiye’deki işlem yapısını ve güncel suç tiplerini temsil eden, hukuken doğrulanmış yerel verilerle yeniden eğitim ve bağımsız test yapılmalıdır. Risk puanlarının yanlış pozitif oranları, zaman içindeki kararlılığı, açıklanabilirliği ve delil zinciriyle uyumu değerlendirilmelidir. Fransızca veya İngilizce metin sınıflandırmasından farklı olarak bu sistem doğrudan zincir üstü sayısal verilere dayansa da, Elliptic veri kümesindeki tarihsel Bitcoin örüntülerinden Türkiye’deki güncel işlemler, diğer blokzincirler veya belirli kişiler hakkında doğrudan sonuç çıkarılamaz. Model çıktıları tek başına hesap dondurma, suç isnadı veya kişisel kimlik atfı için kullanılmamalıdır.
Araştırmanın temel amacı nedir?
Çalışma, herkese açık blokzincir kayıtlarını soruşturmacıların kullanabileceği yapılandırılmış risk bilgisine dönüştürmeyi hedeflemektedir. Blokzincir üzerinde işlemler görünür olsa da cüzdan ve işlem kimlikleri doğrudan gerçek kişileri göstermemektedir. Milyonlarca düğüm ve bağlantı içeren işlem ağlarının manuel olarak incelenmesi de uygulamada mümkün değildir.
Araştırmacılar, geleneksel sabit kuralların yeni para gizleme, adres değiştirme ve işlem katmanlama davranışlarına uyum sağlamakta yetersiz kalabildiğini savunmaktadır. Önerilen çerçeve bu sorunu dört farklı analitik bakışı birleştirerek ele almaktadır:
- Etiketli işlemler üzerinden meşru veya yasa dışı ayrımı yapan denetimli sınıflandırma,
- İşlemler arasındaki bağlantılardan yararlanan yarı denetimli grafik öğrenmesi,
- Önceden verilmiş etikete ihtiyaç duymadan olağandışı davranışları arayan anomali analizi,
- Şüpheli işlem çevresindeki doğrudan ve dolaylı bağlantıları gösteren ağ incelemesi.
Çalışmanın önerdiği uçtan uca işlem hattı
Çalışmanın 7. sayfasındaki Şekil 2, sistemin bütün bileşenlerini aynı akış içinde göstermektedir. Üç veri kümesi önce veri ön işleme ve özellik mühendisliği aşamasına girmektedir. İşlenmiş veriler daha sonra üç paralel kola ayrılmaktadır:
- Random Forest ve KNN ile denetimli sınıflandırma,
- İki katmanlı Grafik Evrişim Ağı ile grafik tabanlı sınıflandırma,
- t-SNE, anomali puanlama ve k-hop bağlantı analiziyle denetimsiz inceleme.
Bu üç koldaki sonuçlar adli benzerlik veya risk puanında birleştirilmekte, işlemler risklerine göre sıralanmakta ve her işlem için olası davranış tipi ile otomatik açıklama üretilmektedir. En son aşamada sistemin çıktısı, kolluk veya finansal suç araştırmacılarının değerlendirebileceği bir inceleme listesi olarak gösterilmektedir.
Bu şema kavramsal olarak bütünleşik bir mimari sunmaktadır. Ancak farklı bileşenlerin aynı veri üzerinde birbirinden tamamen bağımsız kanıt ürettiği varsayılmamalıdır. Random Forest ve grafik ağı aynı Elliptic özelliklerinden yararlanmakta, bazı suç tipi etiketleri de bu özelliklere uygulanan eşiklerden oluşturulmaktadır. Bu nedenle bileşenler arasındaki yüksek uyum kısmen ortak veri ve ortak etiket üretim sürecinden kaynaklanabilir.
Kullanılan veri kümeleri nelerdir?
| Veri kümesi | Çalışmadaki kapsamı | Çalışmadaki görevi |
|---|---|---|
| Elliptic Bitcoin Veri Kümesi | 203.769 işlem, 234.355 yönlü bağlantı, 166 özellik ve 49 zaman adımı | İkili sınıflandırma ve grafik ağı için ana veri kaynağı |
| BitcoinHeist Ransomware Veri Kümesi | Fidye yazılımıyla ilişkilendirilmiş Bitcoin adresleri | Fidye yazılımına benzetilen davranış özelliklerini destekleme |
| IBM AMLSim | Sentetik kara para aklama işlemleri | Para dağıtma ve fan-out temelli davranış özelliklerini destekleme |
Elliptic veri kümesinde işlemler yönlü bir grafik olarak temsil edilmektedir. Her düğüm bir Bitcoin işlemini, her kenar ise işlemler arasındaki para akışını göstermektedir. Çalışmanın bazı bölümlerinde düğümler “cüzdan adresleri” olarak tanımlanırken yöntem ve veri açıklamasında düğümler işlemlerdir. İşlem düğümü ile cüzdan adresi kavramlarının yer yer birbirinin yerine kullanılması, sistemin hangi varlık düzeyinde sonuç ürettiğini belirsizleştirmektedir.
Veri sınıfları ne kadar dengesizdir?
| Sınıf | İşlem sayısı | Toplam içindeki yaklaşık payı |
|---|---|---|
| Bilinmeyen | 157.205 | %77,15 |
| Meşru | 42.019 | %20,62 |
| Yasa dışı | 4.545 | %2,23 |
Çalışmanın 5. sayfasındaki Şekil 1 bu ciddi dengesizliği açık biçimde göstermektedir. Bilinmeyen işlemler en büyük grubu, yasa dışı işlemler ise çok küçük bir azınlığı oluşturmaktadır. Denetimli modeller eğitilirken bilinmeyen sınıf çıkarılmış ve geriye kalan 46.564 etiketli işlem kullanılmıştır.
Meşru işlemlerin yasa dışı işlemlerden yaklaşık dokuz kat fazla olması nedeniyle yalnızca genel doğruluğa bakmak yanıltıcı olabilir. Araştırmacılar bu sorunu eğitim ve test kümelerinde tabakalı örnekleme kullanarak ve Random Forest modelinde sınıf ağırlığını “balanced” olarak ayarlayarak azaltmaya çalışmıştır.
Ön işleme ve özellik mühendisliği nasıl yapılmıştır?
Elliptic verisi özellik tablosu, sınıf tablosu ve yönlü bağlantı listesi olmak üzere üç dosyadan yüklenmiştir. Denetimli sınıflandırma için bilinmeyen işlemler çıkarılmış, sayısal özellikler StandardScaler kullanılarak ortalaması sıfır ve standart sapması bir olacak biçimde ölçeklenmiştir.
Araştırmacılar “Behavioral Bridge” olarak adlandırdıkları ağ tabanlı özellikler oluşturmuştur. Bunların başlıcası Bitcoin fan-out değeridir. Fan-out, bir kaynak işlemin kaç farklı hedef işlemle bağlantı kurduğunu göstermektedir. Çok sayıda hedefe dağılan fonların kara para aklamadaki katmanlama davranışına benzeyebileceği varsayılmıştır.
Ancak yüksek fan-out yalnızca yasa dışı davranışlarda görülmez. Çalışmanın kendisi, yoğun çalışan meşru borsa işlemlerinin de yüksek fan-out oluşturabileceğini kabul etmektedir. Bu nedenle fan-out tek başına kara para aklama kanıtı veya güvenilir suç tipi etiketi değildir.
Random Forest ve KNN modelleri nasıl kurulmuştur?
Random Forest modeli 100 karar ağacından oluşturulmuştur. Modelin seçilme gerekçeleri; çok boyutlu verilerle çalışabilmesi, doğrusal olmayan örüntüleri öğrenmesi, aşırı öğrenmeye karşı tek karar ağacından daha dayanıklı olması ve özellik önem değerleri üretebilmesidir.
K-En Yakın Komşu yöntemi karşılaştırma modeli olarak uygulanmıştır. Veriler yüzde 80 eğitim ve yüzde 20 test olmak üzere tabakalı biçimde bölünmüştür. Çalışma, bu bölmenin zaman adımlarına göre değil sınıf oranlarına göre yapıldığını belirtmektedir.
Elliptic veri kümesi 49 zaman adımından oluştuğu için rastgele ve tabakalı bir bölme, aynı dönemlere ait benzer işlemlerin hem eğitim hem test kümelerine dağılmasına izin verebilir. Çalışma, geçmiş zaman adımlarında eğitilip sonraki zaman adımlarında sınanan ayrı bir ileri-zaman testi sunmamaktadır. Bu nedenle modelin gelecekte ortaya çıkacak yeni işlem davranışlarına ne ölçüde genelleneceği gösterilmemiştir.
Grafik Evrişim Ağı nasıl çalışmaktadır?
Random Forest her işlem kaydını büyük ölçüde bağımsız özellikler üzerinden değerlendirirken Grafik Evrişim Ağı, işlemin bağlı bulunduğu komşuların bilgisini de kullanmaktadır. İlk grafik katmanı 166 boyutlu işlem özelliklerini 64 boyutlu gizli gösterime dönüştürmektedir:
\[ 166 \longrightarrow 64 \]
Bu dönüşümden sonra ReLU doğrusal olmayanlık fonksiyonu uygulanmaktadır. İkinci katman, 64 boyutlu temsili çıktı sınıflarına dönüştürmektedir:
\[ 64 \longrightarrow C \]
Burada ikili model için \(C=2\), çok sınıflı model için \(C=4\)’tür. Çıkışta log-softmax kullanılmıştır. Model yalnızca etiketli eğitim düğümleri üzerinden kayıp hesaplamakta, ancak grafik bağlantıları aracılığıyla bilinmeyen düğümlerin komşuluk yapısından da yararlanmaktadır.
İkili GCN 100 dönem, çok sınıflı GCN 50 dönem eğitilmiştir. Adam iyileştiricisi ve 0,01 öğrenme oranı kullanılmış; kayıp fonksiyonu olarak negatif log-olabilirlik uygulanmıştır.
Dört suç tipi etiketi nasıl oluşturulmuştur?
Dört sınıf şunlardır:
- Meşru işlem,
- Fidye yazılımı benzeri işlem,
- Kara para aklama benzeri işlem,
- Genel yasa dışı işlem.
Meşru ve yasa dışı ana ayrımı Elliptic veri kümesindeki etiketlere dayanmaktadır. Ancak yasa dışı sınıfın alt türleri doğrulanmış olay kayıtlarından alınmamıştır. Araştırmacılar alt sınıfları şu kurallarla üretmiştir:
- Fidye yazılımı benzeri: Elliptic veri kümesindeki feat_0 olarak adlandırılan normalize işlem ağırlığı, yasa dışı işlemler içindeki ortanca değerin üzerindeyse,
- Kara para aklama benzeri: Fan-out değeri yasa dışı işlemler içindeki ortancanın üzerindeyse,
- Genel yasa dışı: Önceki iki kurala girmeyen diğer yasa dışı işlemler.
Bu yaklaşım, modelin gerçek ve bağımsız suç tipi etiketlerini öğrenmediği anlamına gelmektedir. GCN önce araştırmacıların tanımladığı eşik kurallarından türetilen etiketlerle eğitilmiş, ardından aynı tür özellikler üzerinden bu etiketleri tahmin etmiştir. Çalışmanın 15. sayfasındaki eleştirel değerlendirme bölümü de bu döngüselliği açıkça kabul etmektedir.
Denetimsiz davranış analizi nasıl yapılmıştır?
Yüksek boyutlu işlem özellikleri t-SNE ile iki boyutlu düzleme indirgenmiştir. t-SNE, birbirine benzeyen kayıtların iki boyutlu görselde yakın görünmesini sağlayabilen bir boyut indirgeme yöntemidir. Çalışma bunu “davranışsal kümeleme” olarak adlandırmaktadır; ancak ayrı bir kümeleme algoritması, küme sayısı seçimi veya silhouette skoru gibi nicel küme geçerlilik ölçütleri bildirilmemiştir.
Dolayısıyla t-SNE görsellerindeki ayrışmalar, bağımsız biçimde doğrulanmış doğal suç kümeleri olarak yorumlanmamalıdır. t-SNE’nin ayarları, rastgele başlangıcı ve yerel komşuluk yapısı görsel biçimi etkileyebilir.
Isolation Forest anomali puanı nedir?
Isolation Forest, etikete bağlı olmadan diğerlerinden farklı görünen işlemleri belirlemek için uygulanmıştır. Model 100 ağaçla kurulmuş ve contamination değeri yüzde 5 olarak ayarlanmıştır. Çalışmada 0,413 eşik değeri, skor dağılımının yüzde 95’lik dilimine karşılık gelecek biçimde seçilmiştir.
Contamination değerinin yüzde 5 olarak ayarlanması, verilerin yaklaşık yüzde 5’inin anomali olarak kabul edileceğinin yöntem tasarımında önceden belirlendiği anlamına gelmektedir. Bu oran, gerçek işlemlerin yüzde 5’inin suçla bağlantılı olduğunu göstermez.
Bileşik Risk Puanı nasıl hesaplanmaktadır?
Çalışma üç model çıktısını aşağıdaki ağırlıklı formülle birleştirmektedir:
\[ CRS(v) = 0{,}4\,RF_{\mathrm{prob}}(v) + 0{,}4\,GCN_{\mathrm{illicit}}(v) + 0{,}2\,BEH_{\mathrm{score}}(v) \]
Burada:
- \(RF_{\mathrm{prob}}\), Random Forest modelinin yasa dışı sınıf olasılığını,
- \(GCN_{\mathrm{illicit}}\), grafik ağının yasa dışı sınıf olasılığını,
- \(BEH_{\mathrm{score}}\), Isolation Forest tabanlı davranışsal anomali puanını göstermektedir.
Risk düzeyleri şu eşiklerle tanımlanmıştır:
| Risk düzeyi | Çalışmada kullanılan eşik |
|---|---|
| Düşük risk | CRS < 0,30 |
| Yükselmiş risk | 0,30 ≤ CRS < 0,65 |
| Yüksek risk | CRS ≥ 0,65 |
Yüzde 40, yüzde 40 ve yüzde 20 ağırlıkları araştırmacıların tasarım tercihidir. Çalışma, bu ağırlıkların bağımsız doğrulama kümesinde optimize edildiğini, farklı ağırlıklarla karşılaştırıldığını veya olasılık kalibrasyonu yapıldığını göstermemektedir. Aynı durum 0,30 ve 0,65 risk eşikleri için de geçerlidir.
Gizli bağlantı analizi nasıl yapılmaktadır?
Şüpheli kabul edilen bir işlemin çevresindeki düğümler, PyTorch Geometric k-hop alt grafik çıkarma işleviyle belirlenmiştir. Alt grafik NetworkX yapısına dönüştürülerek düğüm derecesi, aradalık merkeziliği ve PageRank gibi ağ ölçütlerinin hesaplanması amaçlanmıştır.
Çalışmanın 14. sayfasındaki Şekil 9, altı etiketli yasa dışı düğümün çevresindeki işlem ağını göstermektedir. Kırmızı düğümler yasa dışı, yeşil düğümler meşru ve gri düğümler bilinmeyen olarak gösterilmiştir. Görselde şüpheli düğümlerin yalnızca başka şüpheli düğümlerle değil meşru ve bilinmeyen düğümlerle de bağlantılı olduğu görülmektedir.
Bir meşru düğümün yasa dışı etiketli düğümle bağlantılı olması, o düğümün veya bağlı kişinin suç işlediği anlamına gelmez. Borsalar, ödeme hizmetleri, aracı adresler veya sıradan karşı taraflar aynı ağ içinde görünebilir.
“Canlı çıkarım” ne anlama gelmektedir?
Çalışmadaki canlı çıkarım işlevi, bir işlem kimliği ile 166 boyutlu özellik vektörünü eğitilmiş modele vererek sınıf, risk puanı, olası tipoloji ve açıklama üretmektedir. Bu, tek bir yazılım işlevi içinde anlık tahmin yapılabildiğini göstermektedir.
Ancak çalışma gerçek blokzincir akışına bağlı sürekli bir izleme hizmeti, saniyede işlenen işlem sayısı, uçtan uca gecikme, ağ kesintisi davranışı veya üretim ortamı testi sunmamaktadır. Bu nedenle “gerçek zamanlı” ifadesi, çalışan bir fonksiyon prototipi anlamında kullanılmalı; operasyonel sistem performansı olarak değerlendirilmemelidir.
Çalışmanın güçlü yönleri nelerdir?
- Üç farklı analitik yaklaşımı tek bir işlem hattında birleştirmektedir.
- İşlem özellikleriyle birlikte ağ bağlantılarını kullanmaktadır.
- Büyük ve kamuya açık bir Bitcoin veri kümesi üzerinde sayısal test sunmaktadır.
- Genel doğruluğun yanında kesinlik, duyarlılık, F1, ROC-AUC ve PR-AUC raporlamaktadır.
- Karışıklık matrisi ve özellik önem grafiğiyle model davranışını kısmen görünür hâle getirmektedir.
- Etiketlenmemiş işlemlerin grafik bağlantıları üzerinden değerlendirilmesini amaçlamaktadır.
- Kaynak kodu ve kullanılan veri kümelerinin bağlantılarını paylaşmaktadır.
- Kendi suç tipi etiketlerinin doğrulanmış gerçek referans olmadığını sınırlılıklar bölümünde açıkça kabul etmektedir.
Çalışma neyi kanıtlamamaktadır?
- Modelin yüksek riskli olarak işaretlediği işlemlerin gerçekten suç işlemi olduğunu kanıtlamamaktadır.
- Bir işlemi belirli gerçek kişi veya kuruma bağlamamaktadır.
- Fidye yazılımı ve kara para aklama tipolojilerinin bağımsız, doğrulanmış adli etiketlerle tanındığını göstermemektedir.
- Modelin güncel Bitcoin işlemlerinde veya başka blokzincirlerde aynı doğruluğa ulaşacağını göstermemektedir.
- Yüzde 96 çok sınıflı başarının gerçek suç tiplerinin ayırt edilmesini temsil ettiğini kanıtlamamaktadır.
- Risk puanlarının hukuki delil standardını karşıladığını göstermemektedir.
- Canlı blokzincir izleme sisteminde ölçülmüş gerçek zamanlı performans sunmamaktadır.
- Yanlış pozitiflerin gerçek kişiler veya kurumlar üzerindeki sonuçlarını değerlendirmemektedir.
- Modelin kasıtlı olarak değiştirilmiş veya gizlenmiş işlem örüntülerine dayanıklı olduğunu göstermemektedir.
Çalışmanın Yöntemi ve Bulguları
Veri ve deney yapılandırması
| Yöntem bileşeni | Çalışmada bildirilen yapılandırma |
|---|---|
| Ana veri kümesi | Elliptic Bitcoin Veri Kümesi |
| İşlem sayısı | 203.769 |
| Grafik bağlantısı | 234.355 yönlü kenar |
| Özellik sayısı | 166 |
| Zaman adımı | 49 |
| Etiketli işlem | 46.564 |
| Bilinmeyen işlem | 157.205 |
| Eğitim-test ayrımı | %80 / %20, tabakalı |
| Ölçekleme | StandardScaler |
| Çalışma ortamı | Google Colaboratory ve GPU hızlandırması |
Random Forest ve KNN sonuçları
| Ölçüt | Random Forest | KNN |
|---|---|---|
| Metinde bildirilen genel doğruluk | %98,92 | %97,75 |
| Yasa dışı sınıf kesinliği | 1,000 | 0,890 |
| Yasa dışı sınıf duyarlılığı | 0,876 | 0,878 |
| Yasa dışı sınıf F1 skoru | 0,934 | 0,884 |
| Micro-F1 | 0,989 | 0,978 |
| ROC-AUC | 0,996 | 0,964 |
| PR-AUC | 0,9817 | Çalışmada bildirilmemiştir. |
Random Forest, çalışmadaki bütün karşılaştırma ölçütlerinde KNN’den daha yüksek sonuç vermiştir. Özellikle yasa dışı sınıf kesinliğinin 1,000 olarak raporlanması, test kümesindeki yanlış pozitif sayısının çok düşük olmasıyla ilişkilidir. Bununla birlikte duyarlılık 0,876’dır; yani yasa dışı olarak etiketlenmiş işlemlerin bir bölümü meşru olarak sınıflandırılmıştır.
Karışıklık matrisi ne göstermektedir?
| Gerçek sınıf | Meşru tahmini | Yasa dışı tahmini |
|---|---|---|
| Meşru | 8.401 | 3 |
| Yasa dışı | 113 | 796 |
Bu matrise göre toplam 9.313 test örneğinin 9.197’si doğru sınıflandırılmıştır:
\[ \mathrm{Doğruluk} = \frac{8401+796}{8401+3+113+796} \approx 0{,}9875 \]
Bu değer yaklaşık yüzde 98,75’tir. Çalışma metninde belirtilen yüzde 98,92 ile matriste hesaplanan değer aynı değildir. Farkın ayrı bir deney çalıştırmasından, yuvarlamadan veya görselin farklı bir sonuç kümesine ait olmasından kaynaklanıp kaynaklanmadığı açıklanmamıştır.
Yasa dışı sınıf için matristen hesaplanan yaklaşık değerler şöyledir:
\[ \mathrm{Kesinlik} = \frac{796}{796+3} \approx 0{,}996 \]
\[ \mathrm{Duyarlılık} = \frac{796}{796+113} \approx 0{,}876 \]
\[ F1 \approx 0{,}932 \]
Bunlar çalışmanın tabloda verdiği 1,000 kesinlik, 0,876 duyarlılık ve 0,934 F1 değerlerine yakındır; küçük farklılıklar yuvarlama veya ayrı çalıştırmalardan kaynaklanabilir.
ROC ve kesinlik-duyarlılık grafikleri
Çalışmanın 9. sayfasındaki Şekil 3’te ROC eğrisi sol üst köşeye yakın ilerlemekte ve 0,9962 AUC değeri göstermektedir. Kesinlik-duyarlılık eğrisi de geniş bir duyarlılık aralığında yüksek kesinlik sergilemekte ve 0,9817 alan değeri bildirmektedir.
Bu sonuçlar, kullanılan test bölmesinde modelin meşru ve yasa dışı Elliptic etiketlerini güçlü biçimde ayırdığını göstermektedir. Ancak aynı dönemlerden rastgele ayrılmış kayıtlar üzerinde elde edilen yüksek performans, gelecekteki zaman adımlarında veya yeni suç yöntemlerinde aynı başarıyı garanti etmez.
Özellik önem grafiği
11. sayfadaki Şekil 5, Random Forest modelinin en etkili 15 özelliğini göstermektedir. En yüksek önem değerleri feat_52 ve feat_89 özelliklerine aittir; bunları feat_42 ve feat_40 izlemektedir.
Ancak Elliptic veri kümesindeki bazı özellikler anonimleştirilmiş adlarla sunulduğu için bu özelliklerin gerçek dünyadaki doğrudan anlamı çalışmada ayrıntılı olarak açıklanmamaktadır. Bir özellik önem değerinin yüksek olması, tek başına nedensel ilişki veya adli açıklama sağlamaz.
Dört sınıflı GCN sonuçları
| Sınıf | Çalışmada bildirilen F1 skoru |
|---|---|
| Meşru | %97,2 |
| Fidye yazılımı benzeri | %93,4 |
| Kara para aklama benzeri | %91,8 |
| Genel yasa dışı | %94,2 |
| Genel doğruluk | %96 |
Bu oranlar, grafik ağının oluşturulan dört etiketi birbirinden ayırabildiğini göstermektedir. Fakat üç yasa dışı alt sınıfın doğrulanmış gerçek referans yerine özellik eşiklerinden türetilmesi nedeniyle sonuçlar gerçek suç tipi tanıma başarısı olarak sunulmamalıdır.
Adli istihbarat haritası
12. sayfadaki Şekil 6, t-SNE benzeri iki boyutlu davranış alanında fidye yazılımı ve kara para aklama bölgelerini renkli sınırlarla göstermektedir. Yüzde 70’in üzerinde güven puanı alan işlemler daha büyük işaretlerle sunulmuştur.
Harita görsel önceliklendirme sağlayabilir; ancak çizilen bölge sınırları bağımsız adli doğrulamaya dayanmamaktadır. Görselde birbirinden ayrılmış görünen noktalar, iki boyuta indirgeme yönteminin oluşturduğu yerleşimden etkilenmektedir.
Zamansal analizdeki tutarsızlık
13. sayfadaki Şekil 8, 49 zaman adımında şüpheli olarak işaretlenen bilinmeyen işlem sayısını göstermektedir. Şeklin başlığı ve metin, 19–21. zaman adımlarında yaklaşık 1.750 ve 33. zaman adımında yaklaşık 1.470 işlemlik zirveler bulunduğunu belirtmektedir.
Buna karşılık grafiğin dikey ekseni ve çizilen noktalar, 20–22. zaman adımlarında yaklaşık 2.300–2.800 ve 33. zaman adımında yaklaşık 3.200 düzeyinde değerler göstermektedir. Grafik ile şekil açıklamasındaki sayılar belirgin biçimde uyuşmamaktadır.
Ayrıca araştırmacılar bu dönemlerin “yüksek suç etkinliği veya eş güdümlü saldırı kampanyaları” olabileceğini ifade etmektedir. Ancak zaman adımları gerçek olay kayıtlarıyla eşleştirilmemiştir. Bu nedenle grafikteki artışların belirli suç kampanyalarına karşılık geldiği çalışmanın verileriyle doğrulanmamaktadır.
Bağlantı ağı sonuçları
| Ağ bulgusu | Çalışmada bildirilen değer |
|---|---|
| Yasa dışı düğümlerden bilinmeyen düğümlere bağlantılar | 1.458 |
| Yasa dışı düğümlerden meşru düğümlere bağlantılar | 915 |
| En yüksek riskli işlem merkezinin doğrudan bağlantıları | 672 |
Araştırmacılar bu ağ yapısını çok adımlı fon aktarımı ve aracı adres kullanımıyla ilişkilendirmektedir. Bununla birlikte bağlantı sayısı tek başına para aklama davranışını kanıtlamaz. Özellikle yüksek hacimli hizmetler ve borsalar doğal olarak çok sayıda meşru bağlantı oluşturabilir.
Yüksek riskli işlem listesi
| Model tarafından atanan kategori | İşlem sayısı |
|---|---|
| Fidye yazılımı benzeri | 4.893 |
| Kara para aklama benzeri | 3.627 |
| Genel yasa dışı | 1.668 |
| Toplam yüksek risk | 10.188 |
Çalışmanın 15. sayfasındaki Şekil 10, en yüksek puanlı işlemlerin örnek listesini göstermektedir. Her satırda işlem kimliği, risk puanı, şüpheli durumu, olası tipoloji ve kısa otomatik gerekçe bulunmaktadır.
Yüksek riskli işlem sayısı, veri kümesindeki doğrulanmış 4.545 yasa dışı etiketten daha fazladır. Bunun nedeni modelin bilinmeyen işlemleri de riskli olarak işaretlemesidir. Ancak bilinmeyen bir işlemin model tarafından yüksek riskli bulunması, gerçek referans etiketi elde edildiği anlamına gelmez.
Yeniden üretilebilirlik ve eksik bilgiler
Çalışma; kod deposunu, ana veri kümelerini ve uygulama defterini paylaşmaktadır. Bu durum yöntemin incelenmesini ve tekrar çalıştırılmasını kolaylaştırmaktadır.
Bununla birlikte ana metinde aşağıdaki ayrıntılar tam olarak raporlanmamıştır:
- KNN için kullanılan komşu sayısı ve uzaklık ölçütü,
- Random Forest için azami derinlik ve diğer ağaç parametreleri,
- Rastgelelik tohumları,
- Birden fazla çalıştırmadaki ortalama ve standart sapmalar,
- GCN için düzenlileştirme, dropout ve ağırlık kaybı ayrıntıları,
- t-SNE perplexity, öğrenme oranı ve rastgele başlangıç ayarları,
- Model olasılıklarının kalibrasyon yöntemi,
- Bileşik puan ağırlıklarının duyarlılık analizi,
- Canlı çıkarımın gecikme ve işlem kapasitesi,
- Başka veri kümesinde bağımsız dış doğrulama.
Genel bilimsel değerlendirme
Çalışmanın en güçlü sonucu, Random Forest modelinin Elliptic veri kümesinin etiketli test bölümünde yüksek ikili sınıflandırma performansı göstermesidir. Grafik yapı, anomali puanı ve ağ görselleştirmesinin aynı analiz hattına eklenmesi de soruşturma önceliklendirmesi için uygulanabilir bir prototip yaklaşımı sunmaktadır.
En ciddi sınırlılık ise suç tiplerinin doğrulanmış gerçek referans yerine araştırmacıların özellik eşiklerinden oluşturulmasıdır. Bu durum dört sınıflı GCN’nin yüzde 96’lık sonucunun gerçek fidye yazılımı, para aklama ve diğer yasa dışı işlemleri bağımsız biçimde ayırma başarısı olarak yorumlanmasını engellemektedir.
İkinci önemli sınırlılık, zaman serisi niteliğindeki veri için rastgele ve tabakalı eğitim-test ayrımı kullanılmasıdır. Gelecekteki dönemlere genelleme, geçmiş zaman adımlarıyla eğitim ve sonraki adımlarla test edilen zaman temelli değerlendirmeyle gösterilmelidir.
Üçüncü olarak, bileşik risk puanındaki ağırlıklar ve eşikler doğrulanmış operasyonel maliyetlere göre belirlenmemiştir. Yanlış pozitif bir işaretlemenin soruşturma kaynakları, müşteri hesapları ve gerçek kişiler üzerindeki olası etkisi değerlendirilmemiştir.
Bu nedenle sistem, otomatik suç belirleme aracı değil; insan uzman tarafından incelenecek işlemleri sıralayan deneysel bir karar destek prototipi olarak değerlendirilmelidir.
Kaynak ve Yöntem Notu
| Kaynak kimliği alanı | Doğrulanan bilgi |
|---|---|
| Çalışmanın tam özgün adı | AI-Driven Cryptocurrency Transaction Analysis for Cybercrime Intelligence |
| Yazarlar ve sıraları | 1. Norah Rashed Alshamri; 2. Seokhee Lee |
| Eş birinci yazar | Eş katkı veya eş birinci yazarlık beyanı yer almamaktadır. |
| Sorumlu yazar | Seokhee Lee |
| Kurum | Department of Cybersecurity and Digital Forensics, Center for Cybercrime and Economic Crime, Naif Arab University for Security Sciences, Riyadh, Suudi Arabistan |
| Norah Rashed Alshamri ORCID | 0009-0004-5967-4015 |
| Seokhee Lee ORCID | 0009-0007-6142-7891 |
| DOI | 10.2139/ssrn.7004983 |
| Dergi | Belirli bir hakemli dergide yayımlandığına ilişkin bilgi bulunmamaktadır. |
| Yayınevi | Hakemli dergi yayınevi bilgisi bulunmamaktadır. Dosyada “Preprint submitted to Elsevier” ibaresi yer almaktadır. |
| Yayın platformu | SSRN |
| Yayın yılı | 2026 |
| SSRN’ye yüklenme tarihi | 26 Haziran 2026 |
| Sayfa sayısı | 17 |
| Kaynak türü | Makine öğrenmesi, grafik sinir ağı ve davranış analizi içeren deneysel araştırma preprinti |
| Hakemlik durumu | Hakem değerlendirmesinden geçmemiştir. |
| Resmî çalışma bağlantısı | SSRN resmî çalışma sayfası |
| Uygulama kodu | GitHub kaynak kodu deposu |
| Çıkar çatışması | Yazarlar bilinen mali çıkar çatışması veya kişisel ilişki bulunmadığını beyan etmiştir. |
| Kurumsal destek | Yazarlar NAUSS’a kurumsal desteği için teşekkür etmiştir; ayrı bir finansman kaynağı belirtilmemiştir. |
Bu çalışma hakem değerlendirmesinden geçmemiş bir preprinttir. DOI, SSRN çalışma kaydını tanımlamakta olup hakemli bir dergi makalesine ait DOI olarak sunulmamalıdır. Çalışmanın Elsevier biçiminde hazırlanması veya Elsevier’e gönderilmiş olması, kabul veya hakemli yayın anlamına gelmemektedir.
Bu Verianla makalesinin bilimsel içeriği yalnızca yüklenen çalışmaya dayanarak hazırlanmıştır. Dış kaynaklar yalnızca yazar sırası, sorumlu yazar, kurum, DOI, SSRN yüklenme tarihi, resmî çalışma sayfası ve kod deposu gibi bibliyografik kimlik bilgilerinin doğrulanması amacıyla kullanılmıştır. Çalışmada bulunmayan ek deney sonucu veya dış performans bulgusu eklenmemiştir.
Araştırmanın sonuçları, yüksek risk puanı alan işlemlerin suç faaliyeti olduğunu veya herhangi bir gerçek kişinin suç işlediğini göstermemektedir. Model çıktıları olasılıksal ve deneysel inceleme öncelikleridir. Bir işlem hakkındaki hukuki değerlendirme; bağımsız kaynaklar, doğrulanmış cüzdan atıfları, borsa kayıtları, delil bütünlüğü ve yetkili insan incelemesi gerektirir.
Çalışmanın başlıca yöntemsel sınırlılıkları; suç tipi etiketlerinin doğrulanmış gerçek referans yerine sezgisel eşiklerden üretilmesi, rastgele eğitim-test ayrımının zaman içindeki genellemeyi göstermemesi, risk ağırlıkları ve eşiklerinin doğrulanmaması, t-SNE görsellerinin nicel küme doğrulaması içermemesi, canlı sistem gecikmesinin ölçülmemesi ve sonuçların tek bir tarihsel Bitcoin veri kümesine dayanmasıdır.
Random Forest için bildirilen yüzde 98,92 genel doğruluk ile sunulan karışıklık matrisinden hesaplanan yaklaşık yüzde 98,75 doğruluk arasında açıklanmamış fark bulunmaktadır. Zamansal şüpheli işlem grafiğindeki değerler de şekil açıklamasında belirtilen zirve sayılarıyla uyuşmamaktadır. Bu tutarsızlıklar sonuçların yorumunda dikkate alınmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir