

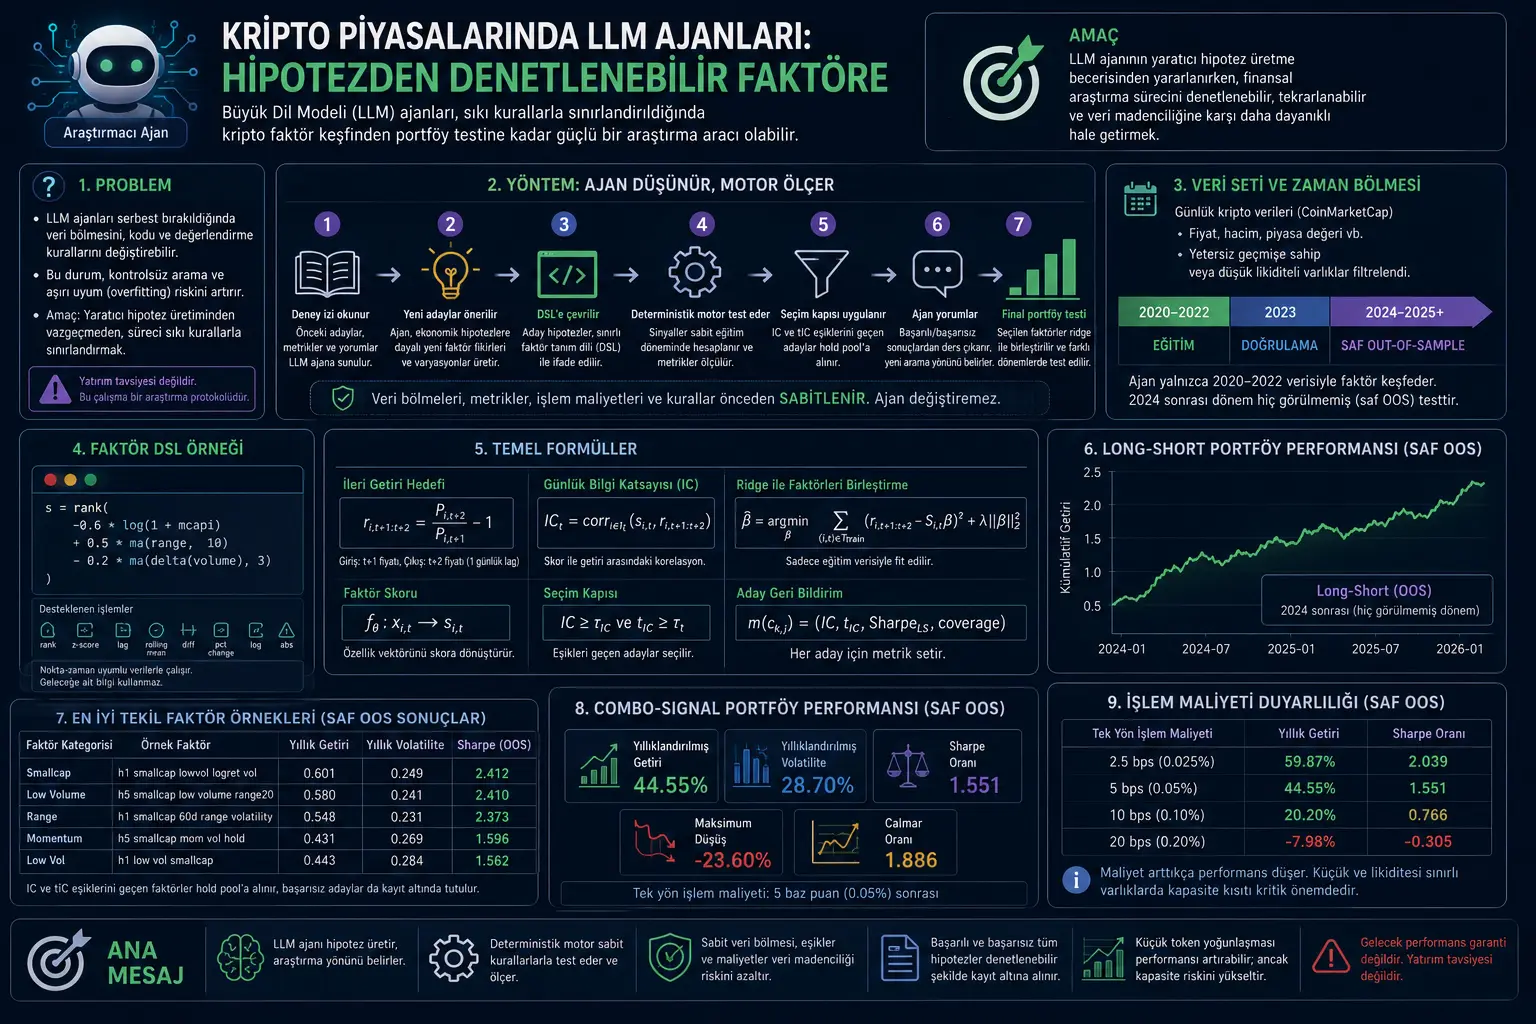
Bu çalışma, LLM ajanlarının kripto piyasalarında faktör keşfi için nasıl kullanılabileceğini araştırıyor. Araştırmacılar, ajanın sınırsız şekilde kod, veri bölmesi veya değerlendirme kuralı değiştirmesine izin vermek yerine, onu sıkı bir protokol içine yerleştiriyor. Böylece ajan hipotez kuruyor, sinyal tarifi öneriyor ve önceki sonuçlardan öğreniyor; fakat testi yürüten motor sabit kurallara göre çalışıyor.
Çalışmada faktör keşfi, tek seferlik tahmin problemi olarak değil, sıralı hipotez arama problemi olarak tanımlanıyor. Ajan daha önce denenmiş adayları, ölçülen metrikleri ve yorumları okuyor; sonra yeni, yanlışlanabilir faktör hipotezleri öneriyor. Bu hipotezler, serbest Python kodu olarak değil, sınırlı bir faktör DSL’iyle yazılıyor. Böylece başarılı ve başarısız tüm denemeler denetlenebilir hâle geliyor.
Makalenin raporladığı ana sonuçlardan biri, yalnızca 2020–2022 eğitim verisiyle seçilen faktörlerin 2024–2026 saf out-of-sample döneminde, 5 baz puan tek yön işlem maliyeti sonrası yıllıklandırılmış %44,55 getiri ve 1,55 Sharpe oranı üretmesidir. Fakat sonuçlar özellikle küçük ve likiditesi sınırlı tokenlarda yoğunlaştığı için kapasite sınırı önemli bir dikkat noktasıdır.
Problem Ne?
LLM ajanları finansal araştırmada güçlü araçlar olabilir. Önceki sonuçları okuyabilir, yeni hipotezler önerebilir, sinyal formülleri yazabilir ve geri bildirime göre yön değiştirebilirler. Fakat bu esneklik ciddi bir metodolojik risk taşır: Eğer ajan aynı anda veri bölmesini, özellikleri, kodu ve değerlendirme kuralını değiştirebiliyorsa, iyi görünen sonuçlar gerçek keşiften çok kontrolsüz aramanın ürünü olabilir.
Finansal faktör araştırmasında bu risk daha da büyür. Çünkü binlerce olası sinyal denenebilir. Birçok sinyal geçmiş veride tesadüfen başarılı görünebilir. Eğer başarısız denemeler kayıt altına alınmazsa veya out-of-sample dönem gerçekten ayrı tutulmazsa, araştırma süreci “güzel görünen sonucu bulana kadar arama” problemine dönüşebilir.
Makalenin çözmeye çalıştığı temel sorun şudur: LLM ajanının yaratıcı hipotez üretme kapasitesinden yararlanırken, araştırma sürecini nasıl denetlenebilir, tekrarlanabilir ve veri madenciliğine karşı daha dayanıklı hâle getirebiliriz?
Yöntem Ne Öneriyor?
Çalışma, LLM ajanını otonom bir nicel araştırmacı gibi kurguluyor; fakat bu araştırmacı sıkı kurallar altında çalışıyor. Ajanın görevi hipotez üretmek ve aramanın yönünü belirlemek. Deney motorunun görevi ise sinyalleri hesaplamak, metrikleri ölçmek, seçim kapılarını uygulamak, işlem maliyetlerini hesaba katmak ve sonuçları kayıt altına almak.
Bu ayrım makalenin merkezinde yer alıyor: Ajan düşünür, motor ölçer. Ajan değerlendirme kuralını değiştiremez. Veri bölmeleri, işlem maliyetleri, portföy ayarları ve seçim eşikleri önceden sabitlenmiştir.
Yöntem şu şekilde işler:
1. Deney izi okunur: Ajan daha önce denenmiş aday faktörleri, metrikleri, kabul-ret kararlarını ve yorumları okur.
2. Yeni adaylar önerilir: Ajan hem mekanik varyasyonlar hem de yeni ekonomik hipotezlere dayalı faktör adayları üretir.
3. Adaylar DSL’e çevrilir: Her hipotez, nokta-zaman uyumlu piyasa değişkenleriyle çalışan sınırlı bir faktör tarifine dönüştürülür.
4. Deterministik motor test eder: Faktörler sabit eğitim döneminde değerlendirilir. IC, tIC, long-short Sharpe ve coverage gibi metrikler hesaplanır.
5. Seçim kapısı uygulanır: Sadece önceden belirlenen IC ve tIC eşiklerini geçen adaylar hold pool’a alınır.
6. Ajan yorumlar: Başarılı ve başarısız hipotezlerden ders çıkarılır. Ajan yeni arama yönünü belirler.
7. Final portföy testi yapılır: Seçilen iyi faktörler ridge regression ile birleştirilir ve eğitim, doğrulama ve saf out-of-sample dönemlerde ayrıca test edilir.
Formüller Ne Anlatıyor?
PDF’teki formüller, faktör keşfinin nasıl nokta-zaman uyumlu, denetlenebilir ve out-of-sample test edilebilir bir problem olarak kurulduğunu gösteriyor.
1. Her varlık için nokta-zaman özellik vektörü
Burada \(x_{i,t}\), \(t\) tarihinde \(i\) varlığı için gözlenen özellik vektörüdür. Bu vektör yalnızca \(t\) veya öncesinde bilinen fiyat, hacim, piyasa değeri ve türetilmiş geçmiş değişkenlerden oluşur. Bu nokta önemlidir; çünkü geleceğe ait bilgi kullanılmamalıdır.
2. İleri getiri hedefi
Bu formül, sinyalin \(t\) tarihinde üretildiğini, giriş fiyatının \(t+1\), çıkış fiyatının ise \(t+2\) olduğunu gösterir. Bir günlük execution lag eklenmesi, aynı gün kapanış fiyatından gerçekçi olmayan işlem varsayımını azaltmak için kullanılır.
3. Faktörün skor fonksiyonu olarak tanımı
Bir faktör, varlığın özellik vektörünü bir skora dönüştürür. \(s_{i,t}\), aynı tarihteki varlıkları sıralamak için kullanılan cross-sectional skordur. Buradaki \(\theta\), klasik bir sinir ağı parametresi değil; sembolik faktör tarifidir.
4. Ajanın araştırma durumu
\(h_k\), \(k\). iterasyonda ajanın gördüğü araştırma durumunu temsil eder. \(C\) önceki adayları, \(M\) bu adayların metriklerini, \(E\) ise doğal dilde yorumları ve kararları gösterir. Bu yapı, ajanın geçmiş başarı ve başarısızlıklardan öğrenmesini sağlar.
5. Ajanın yeni aday önerileri
Bu formül, ajanın her turda birden fazla aday faktör önerdiğini gösterir. Her aday; hipotez, ekonomik gerekçe, aday tipi ve çalıştırılabilir faktör tarifinden oluşur.
6. Bir adayın ölçülen geri bildirimi
Bu metrik seti, bir aday faktörün nasıl değerlendirildiğini gösterir. \(IC\), faktör skoruyla sonraki getiri arasındaki ortalama bilgi katsayısıdır. \(t_{IC}\), bunun istatistiksel anlamlılığını; \(Sharpe_{LS}\), long-short portföy performansını; \(coverage\) ise faktörün kaç varlık-tarih gözleminde skor üretebildiğini ifade eder.
7. Seçim kapısı
Bir faktörün seçilebilmesi için önceden belirlenmiş \(IC\) ve \(t_{IC}\) eşiklerini geçmesi gerekir. Bu eşikler arama sırasında ajanın isteğine göre değiştirilmez. Bu, veri madenciliği riskini azaltan temel kontrol noktalarından biridir.
8. Seçilmiş faktör kümesi
Aramanın sonunda amaç, yalnızca tek bir sinyal değil, denetlenebilir ve farklı mekanizmaları temsil eden bir faktör kümesi üretmektir.
9. Ridge ile faktörleri birleştirme
Seçilen faktörler final aşamada düzenlileştirilmiş doğrusal modelle birleştirilir. Bu model yalnızca eğitim döneminde fit edilir. Amaç, farklı faktörlerin sinyallerini tek bir bileşik skora dönüştürürken aşırı uyumu sınırlamaktır.
10. Örnek faktör tarifi
PDF’teki bu formül metin çıkarımında kısmen bozuk görünmektedir; bağlamdan okunarak yukarıdaki gibi düzenlenmiştir. Formül, küçük piyasa değerli, yüksek aralık davranışı gösteren fakat son hacim şoku sınırlı varlıkları daha yüksek sıralamaya çalışan örnek bir faktör tarifidir. Burada \(rank_t\), aynı tarihteki varlıklar arasında cross-sectional sıralama yapar.
11. Günlük bilgi katsayısı
Bu formül, belirli bir tarihte faktör skorları ile sonraki getiri arasındaki Pearson korelasyonunu gösterir. Faktör skorları daha yüksek olan varlıklar gerçekten daha yüksek getiri üretiyorsa \(IC_t\) pozitif olur.
Grafik, Tablo ve Şema Ana Mesajı
Agentic AI karşılaştırma şeması: Makalenin ilk bölümündeki şema, geleneksel AI ile agentic AI arasındaki farkı özetliyor. Geleneksel sistemler daha sabit kurallarla çalışırken, ajan tabanlı sistemler hedefe dönük akıl yürütme, geri bildirimden öğrenme ve iteratif karar alma döngüsüyle çalışıyor. Bu çalışmada bu esneklik, sabit bir değerlendirme protokolüyle sınırlandırılıyor.
Faktör DSL yapısı: Makaledeki yöntem bölümü, aday faktörlerin serbest kodla değil, sınırlı bir DSL ile yazıldığını anlatıyor. Bu DSL; cross-sectional rank, z-score, lag, rolling mean, rolling standard deviation, fark alma, yüzde değişim, logaritma, mutlak değer ve lineer kombinasyon gibi denetlenebilir işlemleri destekliyor.
Sayfa 6’daki portföy grafikleri: Quintile portföy görseli, combo-signal ile sıralanan portföylerde üst grupların alt gruplara göre daha iyi performans gösterdiğini anlatıyor. Aynı sayfadaki long-short eğrisi, yüksek skorlu varlıkları uzun, düşük skorlu varlıkları kısa tutan yapının dönem içinde pozitif ayrıştığını gösteriyor.
Tek faktör tablosu: En iyi tekil faktörler arasında smallcap, low volume, high range, low volatility ve momentum bileşenleri öne çıkıyor. Bu, ajanın arama sürecinde küçük, likiditesi sınırlı ve belirli trend/aralık davranışı gösteren tokenlara yöneldiğini gösteriyor.
Fee sensitivity tablosu: İşlem maliyeti arttıkça performans azalıyor; ancak tabloda bazı maliyet varsayımlarında stratejinin pozitif kalabildiği raporlanıyor. Bu bölüm, yalnızca brüt getiriye bakmanın yanıltıcı olabileceğini hatırlatıyor.
Deneyler Nasıl Yapılmış?
Çalışmada CoinMarketCap kaynaklı günlük kripto verileri kullanılıyor. Veri seti Ocak 2020’den Aralık 2025’e kadar uzanıyor. Fiyat, hacim ve piyasa değeri gibi temel değişkenler kullanılıyor. Yetersiz işlem geçmişine sahip veya düşük likiditeli varlıklar filtreleniyor.
Deney tasarımında zaman bölmesi önemlidir. 2020–2022 dönemi eğitim, 2023 doğrulama, 2024 sonrası ise saf out-of-sample dönem olarak ayrılıyor. Bu yapı, ajanın geçmişte iyi görünen sinyalleri doğrudan gelecek performansla karıştırmasını engellemeyi amaçlıyor.
Ajan beş arama turunda faktör adayları öneriyor. Bu adaylar büyüklük, volatilite, işlem aralığı, likidite, hacim değişimi ve momentum gibi piyasa mekanizmalarını test ediyor. Başarılı faktörler hold pool’a alınıyor; başarısız faktörler de kayıt dışı bırakılmıyor, aksine sonraki arama kararları için negatif kanıt olarak kullanılıyor.
Final aşamada seçilen faktörler ridge regression ile birleştiriliyor. Portföyler quintile mantığıyla kuruluyor: En yüksek skorlu varlıklar üst gruba, en düşük skorlu varlıklar alt gruba ayrılıyor. Long-short portföy ise üst grubu uzun, alt grubu kısa pozisyon gibi ele alıyor. Çalışmada eşit ağırlıklı ve piyasa değeri ağırlıklı yapıların farklı davrandığı da vurgulanıyor.
Sonuçlar Ne Gösteriyor?
Makalenin raporladığı sonuçlara göre, ajan arama süreci küçük piyasa değerli, likiditesi sınırlı, belirli aralık davranışı ve pozitif trend özelliği taşıyan tokenlarda yoğunlaşan bir faktör ailesi buluyor. En iyi tekil faktörler arasında “smallcap”, “low volume”, “high range”, “low volatility” ve momentum bileşenleri öne çıkıyor.
Tek faktör tablosunda en yüksek Pure OOS Sharpe oranları +2 civarında raporlanıyor. Örneğin “h1 smallcap lowvol logret vol” faktörü +2.412 Pure OOS Sharpe, “h5 smallcap low volume range20” faktörü +2.410 Pure OOS Sharpe değeriyle listeleniyor.
Combo-signal portföy performansında long-short strateji için yıllıklandırılmış getiri 0.445, yıllık volatilite 0.287, Sharpe oranı 1.551, maksimum düşüş -0.236 ve Calmar 1.886 olarak raporlanıyor. Bu, eğitim dönemi dışında da belirli bir risk-ayarlı performans gözlendiğini gösteriyor.
Ancak makalenin önemli bir uyarısı var: Piyasa değeri ağırlıklı sonuçlar zayıf kalıyor. Bu, bulunan alfa kaynağının daha çok küçük tokenlarda yoğunlaştığını ve kapasite sınırlı olabileceğini düşündürüyor. Yani sonuçlar büyük ölçekli, sürtünmesiz ve kolay uygulanabilir bir kurumsal strateji olarak yorumlanmamalıdır.
Bu Neden Önemli?
Bu çalışma, finansal yapay zekâda LLM ajanlarının nasıl daha güvenli ve denetlenebilir kullanılabileceğine dair önemli bir örnek sunuyor. Ajanın güçlü tarafı hipotez üretme ve araştırma yönünü değiştirme becerisidir. Zayıf tarafı ise serbest bırakıldığında kuralları esnetme, istemeden veri sızıntısı üretme veya geçmiş veriye aşırı uyum sağlama riskidir.
Makale bu ikisini ayırıyor: Ajan araştırma fikrini üretir, fakat protokolü değiştiremez. Böylece başarılı faktörler kadar başarısız hipotezler de kayıt altına alınır. Bu yaklaşım, finansal araştırmada “sadece iyi sonucu gösterme” riskini azaltabilecek pratik bir çerçeve sunar.
Kripto piyasaları bu tür bir çalışma için uygun bir test alanıdır. Çünkü varlıkların listelenme geçmişleri farklıdır, likidite dağılımı keskindir, spekülatif ilgi hızlı değişir ve standart temel analiz verileri sınırlıdır. Bu nedenle fiyat, hacim, piyasa değeri, volatilite ve momentum gibi mikro yapı sinyallerinin kombinasyonu araştırma açısından önem kazanır.
Dikkat Noktaları
1. Bu çalışma yatırım tavsiyesi değildir. Raporlanan getiriler ve Sharpe oranları, deneysel bir araştırma protokolünün sonucudur. Gerçek piyasa uygulamasında likidite, emir defteri derinliği, spread, kayma, vergi, regülasyon ve operasyonel riskler farklı sonuçlar doğurabilir.
2. Küçük token etkisi kapasite sorunu yaratabilir. Makalede alfa kaynağının küçük varlıklarda yoğunlaştığı belirtiliyor. Küçük ve likiditesi sınırlı tokenlarda işlem maliyeti ve piyasa etkisi hızla artabilir.
3. LLM ajanı doğru protokol olmadan risklidir. Ajan veri bölmesini, eşikleri veya kodu serbestçe değiştirebilirse, sonuçlar kontrolsüz arama ve overfitting ürünü olabilir.
4. Başarısız hipotezlerin kaydı önemlidir. Yalnızca başarılı sonuçları raporlamak yanıltıcıdır. Bu çalışmanın güçlü taraflarından biri, başarısız adayları da append-only trace içinde denetlenebilir bırakmasıdır.
5. Geçmiş performans gelecek performans garantisi değildir. Kripto piyasalarında rejimler hızla değişebilir. Bir dönemde çalışan faktörler sonraki dönemde zayıflayabilir veya tamamen kaybolabilir.
6. Etik ifade yetersiz kalabilir. Makalede etik sorun olmadığı belirtilmiş olsa da finansal ajanların gerçek piyasalarda kullanımı, yatırımcı davranışı ve piyasa etkisi bakımından daha geniş etik tartışmalar gerektirebilir.
Riskli alan notu: Konu kripto piyasalarında faktör keşfi ve portföy performansı ile ilgilidir. Bu yazı yatırım tavsiyesi değildir. Burada anlatılan sonuçlar; herhangi bir kripto varlığı alma, satma, tutma veya otomatik strateji kurma önerisi olarak değerlendirilmemelidir.
Genel değerlendirme: Çalışma, büyük dil modeli ajanlarının finansal araştırmada nasıl kullanılabileceğini inceliyor. Ancak makalenin ana fikri “LLM serbestçe strateji yazsın” değildir. Tam tersine, LLM ajanının hipotez üretmesine izin verilirken, veriyi bölme, faktörleri test etme, seçim eşiği uygulama, işlem maliyetini hesaba katma ve out-of-sample değerlendirme gibi kritik adımlar deterministik bir motor tarafından kontrol ediliyor.
Sonuç
Bu çalışma, LLM ajanlarının finansal araştırmada tamamen serbest bırakılmaması gerektiğini; bunun yerine sıkı bir deney protokolüne bağlı hipotez arama sistemi olarak kullanılabileceğini gösteriyor. Ajan, yaratıcı ve iteratif araştırma tarafını üstlenirken, deterministik motor veri bölmesi, metrik, seçim kapısı ve portföy testini kontrol ediyor.
Kripto piyasaları üzerinde yapılan deneylerde ajan, küçük piyasa değerli, likiditesi sınırlı, yüksek aralık davranışı ve pozitif trend özellikleri taşıyan tokenlara odaklanan bir faktör ailesi keşfediyor. Eşit ağırlıklı long-short portföyde out-of-sample dönemde anlamlı performans raporlanıyor. Fakat kapasite sınırlılığı ve küçük token yoğunlaşması, sonuçların dikkatli okunmasını gerektiriyor.
Verianla okuru için ana mesaj şudur: Finansal yapay zekâda değerli olan yalnızca iyi tahmin sonucu değildir. Daha önemlisi; hipotezin nasıl üretildiği, nasıl test edildiği, başarısız denemelerin kaydedilip kaydedilmediği ve sonuçların gerçekten görülmemiş dönemde sınanıp sınanmadığıdır.
Kaynak ve Yöntem Notu
Bu yazı, “From Hypotheses to Factors: Constrained LLM Agents in Cryptocurrency Markets” başlıklı akademik PDF temel alınarak hazırlanmış özgün Türkçe editoryal içeriktir. Metin birebir çeviri değildir; çalışmadaki problem, yöntem, formüller, deney tasarımı, bulgular ve sınırlılıklar sadeleştirilerek anlatılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir