

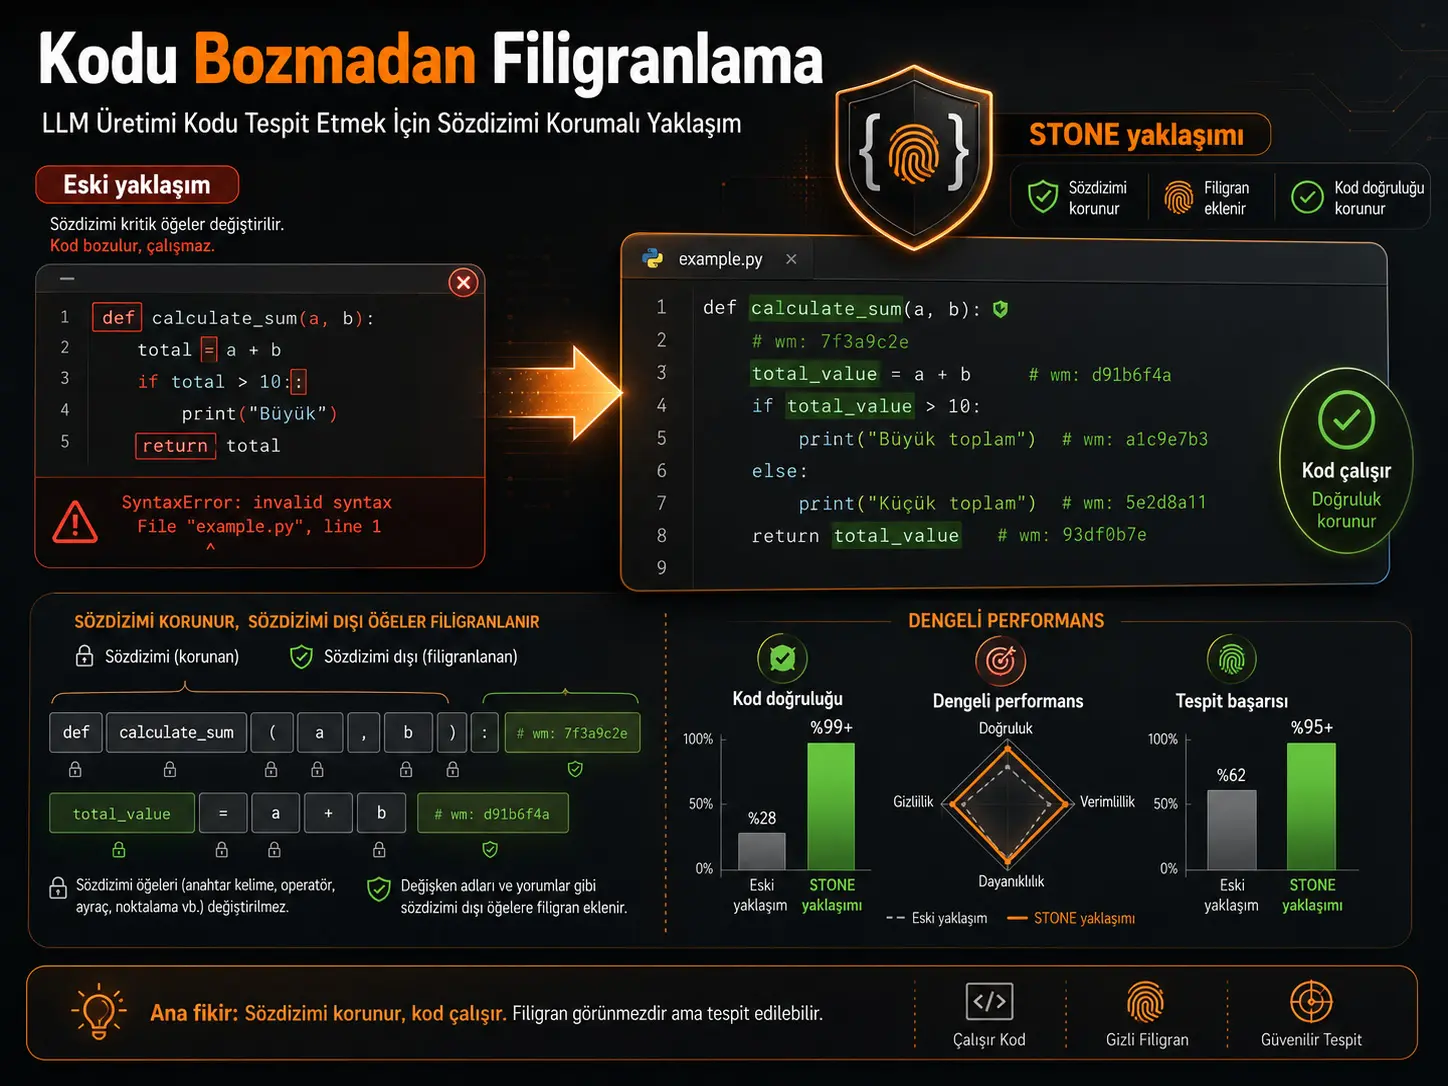
Watafiti walitengeneza mbinu iitwayo STONE inayolenga kupunguza hatari ya kuharibu sintaksia au mantiki ya utekelezaji wa msimbo wakati wa kuweka watermark inayoweza kutambuliwa baadaye kwenye msimbo wa programu unaozalishwa na miundo mikubwa ya lugha. Mbinu kuu ya STONE ni kulinda token za kisintaksia zinazochukuliwa kuwa muhimu kwa uendeshaji wa programu badala ya kutumia watermark kwa token zote au kwa token zenye entropy ya juu pekee.
Hoja ya kuanzia ya utafiti ni uchunguzi muhimu: dhana kwamba “kubadilisha token zenye entropy ya juu ni salama zaidi” si sahihi kila wakati katika msimbo wa programu. Katika uchambuzi wa awali uliofanywa kwenye Python, keywords, yaani maneno muhimu, yalipatikana kuwa kategoria yenye wastani wa juu zaidi wa token entropy. Katika MBPP+, wastani wa entropy wa keywords ulikuwa 2,81, huku katika kategoria ya “etc” inayolengwa kwa watermarking ukiwa 1,98. Katika HumanEval+ pia keywords ndiyo kategoria ya juu zaidi kwa 1,58; kategoria ya “etc” ni 1,11.
Matokeo haya ni muhimu kwa sababu kubadilisha token zenye entropy ya juu kama def, return, True, False, if au for kunaweza kubadilisha si mtindo wa maandishi tu bali pia sintaksia au mantiki ya programu. Kwa kuwa mbinu ya awali ya SWEET ililenga token zenye entropy ya juu, watafiti walionyesha kwamba sehemu ya token zilizochaguliwa ilikuwa vipengele vya kisintaksia. Kwa HumanEval+, katika mpangilio bora wa SWEET, takriban %12,6 ya token zilizochaguliwa ni token zinazohusiana na sintaksia.
Badala yake, STONE inalenga kuacha nje ya lengo la watermarking makundi matano ya sintaksia: keywords, whitespace, types, delimiters na operators. Ishara ya watermark huundwa katika eneo la token zisizoingia katika makundi haya. Wakati wa uzalishaji, token candidate hugawanywa katika orodha za kijani na nyekundu; thamani za logit za token zilizo katika orodha ya kijani huongezwa ili kuacha muundo unaoweza kutambuliwa kwa takwimu katika msimbo unaozalishwa. Katika hatua ya detection, uwiano wa token za kijani na z-score huhesabiwa kwa kutumia token zisizo za kisintaksia pekee.
Katika majaribio makuu ya Qwen2.5-Coder-7B ya utafiti, STONE ilitoa alama ya juu zaidi ya pamoja ya STEM katika seti zote nne za tathmini. Thamani za STEM zenye uzito sawa ziliripotiwa kuwa 0,848 kwa MBPP+, 0,781 kwa HumanEval+, 0,780 kwa HumanEvalPack-C++ na 0,715 kwa HumanEvalPack-Java.
Kwa upande wa usahihi wa kifunksional, thamani za correctness za STONE ni 0,571, 0,587, 0,622 na 0,445 kwa mpangilio huo. Watafiti walihesabu kuwa thamani hizi zilitoa kwa wastani %7,57 ya usahihi wa juu zaidi kuliko SWEET katika benchmark zote nne. Kwa MBPP+, thamani ya pass@1 ya msimbo usio na watermark ilikuwa 0,571 na thamani ya STONE pia ilikuwa 0,571. Katika HumanEval+, matokeo yasiyo na watermark yalikuwa 0,595, huku STONE ikiwa 0,587.
Katika mafanikio ya detection pia STONE ilipata AUROC ya 0,982, 0,777, 0,729 na 0,721 mtawalia katika seti nne kuu za data. Hata hivyo, mbinu hiyo si ya juu zaidi katika kila benchmark kwa kipimo cha kutokuonekana. Kwa mfano, katika MBPP+, imperceptibility ni 0,994 kwa KGW na EWD, huku STONE ikiwa 0,990. Kwa hiyo, hitimisho lenye nguvu la utafiti si kwamba “STONE ni bora katika kila kipimo”, bali kwamba inatoa utendaji wa jumla ulio na uwiano zaidi kati ya malengo hayo matatu.
Faida nyingine ya STONE ni muda wa detection. Ingawa muda wa kuongeza watermark uko katika kiwango sawa na mbinu zinazolinganishwa, watafiti wanaripoti kuwa detection ya watermark ya STONE katika kiwango cha dataset ni kwa wastani takriban %86 haraka zaidi kuliko SWEET na EWD. Sababu kuu ni kwamba detection ya STONE hutumia utaratibu wa orodha ya kijani uliowekwa mapema badala ya kuhesabu tena token entropy.
Mbinu hiyo si sugu kabisa dhidi ya mashambulizi. Katika HumanEval+, thamani ya detection ya STONE ilishuka kutoka 0,777 bila shambulio hadi 0,664 baada ya code refactoring na 0,600 baada ya code paraphrasing. Katika MBPP+, thamani zinazolingana ni 0,982, 0,907 na 0,824. Hata hivyo, katika majaribio hayo hayo STONE ilionyesha utendaji wa detection ulio juu kuliko SWEET.
Tathmini kwa mtazamo wa Uturuki: Utafiti huu haujajaribiwa katika mazingira maalum ya maendeleo ya programu, mfumo wa kazi za chuo kikuu au huduma ya kibiashara ya kutengeneza msimbo nchini Uturuki. Hata hivyo, unaweza kuchunguzwa na timu za utafiti na programu nchini Uturuki kwa ajili ya kufuatilia chanzo cha msimbo uliotengenezwa na akili bandia, mnyororo wa ugavi wa programu, uzalishaji wa msimbo katika elimu, sera za msimbo za mashirika na kuweka alama kwenye maudhui yanayotengenezwa na watoa huduma za modeli. Lakini STONE haitambui kwa njia ya nyuma na kwa uhakika kipande chochote cha msimbo kama “AI code detector”; watermark lazima iwe imewekwa kwa makusudi wakati wa kutengeneza msimbo kwa mbinu husika. Kwa hiyo, matumizi ya mbinu hii hayapaswi kutafsiriwa kama ushahidi wa jumla wa kiuchunguzi wa aina ya “msimbo huu kwa hakika uliandikwa na AI”.
Kwa nini tatizo la code watermarking ni tofauti na lugha ya asili?
Katika watermarking ya lugha ya asili, mabadiliko madogo katika uchaguzi wa maneno mara nyingi hayaharibu maana ya msingi au uhalali wa maandishi. Katika uzalishaji wa msimbo, hata herufi moja au token inaweza kubadilisha kabisa kama programu inakompaili au inafanya kazi.
Kwa mfano:
- kuondoa alama ya koloni kunaweza kusababisha kosa la sintaksia ya Python,
- kutumia
-badala ya+kunaweza kubadilisha hesabu ya programu, - kutumia
Falsebadala yaTruekunaweza kugeuza control flow, - kubadilisha mabano au square bracket kunaweza kusababisha parsing error.
Kielelezo 1 katika ukurasa wa 1 wa utafiti kinaonyesha tatizo hili kupitia function rahisi ya is_even: watafiti wanaonyesha kwamba wakati mbinu ya awali ya watermarking inaweza kubadilisha syntax token na kuleta hatari ya “syntax error”, STONE inalenga kulinda token za kisintaksia.
Kwa nini entropy ya juu haimaanishi token salama?
Mbinu ya awali ya SWEET inategemea wazo kwamba kuweka watermark katika sehemu ambako language model haina uhakika mkubwa kuhusu token itakayochagua, yaani entropy iko juu, kutaharibu ubora wa output kwa kiwango kidogo zaidi.
Token entropy imefafanuliwa katika chanzo kwa Shannon entropy:
\[ H_t = -\sum_{i=1}^{|V|} P(y_t=v_i\mid y_{
kama ifuatavyo.
Hapa \(V\) modelin kelime dağarcığını, \(y_{
Uchambuzi wa awali wa watafiti kwa Qwen2.5-Coder-7B ulionyesha kuwa baadhi ya kategoria muhimu kisintaksia katika Python zinaweza pia kuwa na entropy ya juu.
| Kategoria ya token | Wastani wa entropy wa MBPP+ | Wastani wa entropy wa HumanEval+ |
|---|---|---|
| Keywords | 2,81 | 1,58 |
| Etc | 1,98 | 1,11 |
| Types | 1,83 | 1,09 |
| Delimiters | 1,06 | 0,78 |
| Whitespace | 0,93 | 0,46 |
| Operators | 0,93 | 0,63 |
Kwa hiyo, ikiwa kigezo pekee ni “token yenye entropy ya juu”, token muhimu kwa muundo wa programu inaweza pia kuwa lengo la watermark.
STONE inachukulia token zipi kuwa za kisintaksia?
STONE inafafanua makundi matano ya msingi ya sintaksia kwa lugha tatu za programu:
- Keywords: maneno muhimu yaliyohifadhiwa na lugha,
- Whitespace: nafasi, mwisho wa mstari na tab,
- Types: viashiria vya aina za msingi,
- Delimiters: mabano, vitenganishi, alama za uandishi na herufi nyingine za kimuundo,
- Operators: operators za hesabu, mantiki, ulinganisho na assignment.
Token zisizoingia katika makundi haya matano zinatathminiwa katika utafiti kama kategoria ya “etc” na ndizo zinazounda eneo kuu la lengo la watermark la STONE.
STONE inaongezaje watermark?
Katika hatua ya \(t\) ya uzalishaji, language model kwanza huhesabu vector ya kawaida ya logit:
\[ l_t=f_{LM}(x,y_{
na kutoka katika thamani hizi hupatikana initial probability distribution:
\[ p_{t,i} = \frac{e^{l_t[i]}} {\sum_{j=1}^{|V|}e^{l_t[j]}} \]
STONE kwanza huchukua candidate token kutoka katika distribution hii. Ikiwa candidate si ya syntax set, hash value ya token iliyotangulia hutumiwa kama seed na vocabulary hugawanywa katika orodha ya kijani \(G_t\) na nyekundu \(R_t\).
Constant \(\delta\) huongezwa kwenye logit za token zilizo katika green list:
\[ l_t[i]\leftarrow l_t[i]+\delta, \qquad i\in G_t \]
Mabadiliko haya huongeza uwezekano wa token za kijani kuzalishwa. Kisha final token huchukuliwa kutoka katika distribution iliyorekebishwa.
Verianla Live: Mlolongo wa kuweka watermark wa STONE
Mchakato huu ni muhtasari wa kisayansi uliorahisishwa wa mantiki ya generation na detection iliyoelezwa na utafiti katika Algorithm 1 na Algorithm 2.
| Hatua | Kitendo | Lengo |
|---|---|---|
| 1. Uzalishaji wa kawaida | Language model huhesabu token logits na probabilities kulingana na context iliyopo. | Kupata distribution ya kawaida ya uzalishaji wa msimbo. |
| 2. Ukaguzi wa sintaksia | Candidate token iliyochukuliwa hukaguliwa dhidi ya syntax element set. | Kuzuia kuingilia kwa watermark katika maeneo muhimu kisintaksia. |
| 3. Orodha ya kijani/nyekundu | Vocabulary hugawanywa katika green na red list kwa kutumia hash value ya token iliyotangulia. | Kuunda muundo wa siri wa watermark unaoweza kurudiwa. |
| 4. Kuhamisha logit | δ huongezwa kwenye logits za token zilizo katika green list. | Kuongeza uwezekano wa kuzalishwa kwa green tokens. |
| 5. Uzalishaji wa msimbo | Final token huchukuliwa kutoka katika distribution iliyorekebishwa. | Kuingiza signal ya watermark katika code generation. |
| 6. Detection ya watermark | Idadi ya green tokens na z-score katika non-syntax tokens huhesabiwa. | Kutafuta ushahidi wa kitakwimu wa watermark ya STONE katika msimbo. |
Verianla Live: Uonyeshaji huundwa kutoka katika jedwali linaloonekana la mchakato wa kisayansi hapo juu. Jedwali huhifadhiwa kama scientific source-of-truth.
Z-score ya detection inahesabiwaje?
STONE wakati wa detection huhesabu token zisizo za kisintaksia pekee zinazochukuliwa kama “etc”. Jumla yake hufafanuliwa kama \(N^E\), na idadi ya zilizo katika green list kama \(N_G^E\).
Z-score ni:
\[ z= \frac{ N_G^E-\gamma N^E }{ \sqrt{\gamma(1-\gamma)N^E} } \]
.
Thamani iliyohesabiwa ikizidi threshold iliyowekwa mapema ya \(z_{threshold}\), sequence huainishwa kuwa ina watermark.
Utaratibu huu hufanya kazi tu kwa msimbo ambao rule ya listing iliyotumiwa kuunda watermark inajulikana au inaweza kuzalishwa tena. Si mbinu ya jumla ya “kutambua msimbo wa LLM”.
Kwa nini STEM ilitengenezwa?
Watafiti wanaeleza kwamba tafiti zilizopo za code watermarking huzingatia vipimo tofauti na hali hii hufanya kulinganisha mbinu kwa uwiano kuwa vigumu. Mfumo mmoja unaweza kufanya watermark itambulike kwa urahisi sana lakini uzalishe programu nyingi zenye makosa; mfumo mwingine unaweza kulinda msimbo lakini signal ya watermark ikawa dhaifu sana.
Kipimo cha STEM kilichopendekezwa pamoja na STONE kinaunganisha vipimo vitatu katika score moja yenye uzito:
\[ STEM= \alpha\cdot Correctness+ \beta\cdot Detectability+ \zeta\cdot Imperceptibility \]
na:
\[ \alpha+\beta+\zeta=1 \]
hutumiwa.
Correctness inapimwaje?
Kwa functional correctness, kipimo cha pass@k kinachotumiwa katika tafiti za code generation kinatumika. Kipimo hiki hukadiria uwezekano kwamba angalau suluhisho moja kati ya \(k\) zilizozalishwa litapita test zote.
Safu za correctness zilizoripotiwa katika majaribio makuu zinawakilisha tathmini ya pass@1.
Detectability inapimwaje?
Uwezo wa z-score inayotokana na green-token ratio kutenganisha msimbo ulioandikwa na binadamu na msimbo wenye watermark katika thresholds tofauti ulitathminiwa kwa ROC curve; matokeo yakaripotiwa kwa AUROC.
AUROC inapoongezeka, kutenganisha makundi mawili ya msimbo kwa watermark statistic huwa rahisi zaidi.
Imperceptibility inapima nini?
Watafiti hutathmini kupitia perplexity kiwango ambacho watermark hubadilisha natural token-probability distribution ya msimbo.
Imperceptibility imefafanuliwa kama:
\[ 1- \frac{ |PPL(C_{wm})-PPL(C)| }{ PPL(C) } \]
.
Hapa \(C_{wm}\) ni msimbo wenye watermark, huku \(C\) ni seti ya msimbo usio na watermark. Kadiri score inavyokaribia 1, watermark huchukuliwa kuwa imesababisha mabadiliko madogo zaidi ya uwiano katika token distribution. Ikiwa mabadiliko ya distribution ni makubwa sana, kipimo kinaweza pia kutoa thamani hasi; kuna mifano ya hili katika jaribio la kurudia CodeIP la utafiti.
Ni dataset zipi zilizotumiwa?
| Dataset | Lugha | Idadi ya matatizo | Wastani wa urefu wa suluhisho (token) |
|---|---|---|---|
| MBPP+ | Python | 399 | 40,25 |
| HumanEval+ | Python | 164 | 188,28 |
| HumanEvalPack-C++ | C++ | 164 | 223,10 |
| HumanEvalPack-Java | Java | 164 | 237,36 |
Ililinganishwa na mbinu zipi?
Katika ulinganisho mkuu, mbinu tatu za training-free zilitumiwa:
- KGW: mbinu msingi inayogawanya vocabulary katika green na red list katika kila generation step na kupendelea green tokens,
- EWD: mbinu inayoweka uzito kwenye token entropy wakati wa detection,
- SWEET: mbinu ya code watermarking inayolenga kuweka watermark kwenye high-entropy tokens pekee.
CodeIP haikujumuishwa katika main baseline group kwa sababu inahitaji kufundisha type-prediction model ya ziada, huku STONE na comparisons kuu zikiwa training-free. Watafiti waliitekeleza tena CodeIP kando katika Appendix A na kuripoti matokeo yake.
Modeli kuu na mipangilio ya uzalishaji ni ipi?
Katika majaribio makuu, Qwen2.5-Coder-7B ilitumika. Katika Appendix B, jaribio pia lilifanywa na Llama-3.1-8B.
Mipangilio kuu ya uzalishaji:
- top-k = 50,
- temperature = 1,0,
- \(\gamma=0,5\),
- kwa MBPP+ \(\delta=1,0\),
- kwa HumanEval+, C++ na Java \(\delta=0,5\).
Katika tathmini ya imperceptibility, StarCoder2-7B ilitumika kukokotoa perplexity. Inaelezwa kwamba majaribio yalifanywa kwenye NVIDIA A6000 GPU.
Matokeo makuu ya STONE ni yapi?
Matokeo ya correctness pekee yakoje?
| Mbinu | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,499 | 0,573 | 0,576 | 0,387 |
| EWD | 0,499 | 0,573 | 0,576 | 0,387 |
| SWEET | 0,502 | 0,574 | 0,584 | 0,413 |
| STONE | 0,571 | 0,587 | 0,622 | 0,445 |
STONE ilifikia thamani ya juu zaidi ya correctness katika benchmark zote nne kuu. Watafiti wanaripoti tofauti ya wastani ya uwiano ya %7,57 dhidi ya SWEET.
Nini hutokea ikilinganishwa na msimbo usio na watermark?
Appendix F pia inatoa majaribio ya msimbo usio na watermark:
| Mbinu | MBPP+ pass@1 | HumanEval+ pass@1 |
|---|---|---|
| Hakuna watermark | 0,571 | 0,595 |
| STONE | 0,571 | 0,587 |
| SWEET | 0,502 | 0,574 |
| KGW | 0,499 | 0,573 |
| EWD | 0,499 | 0,573 |
Katika MBPP+, thamani ya pass@1 ya STONE yenye watermark na uzalishaji usio na watermark ni sawa. Katika HumanEval+ kuna kushuka kidogo kutoka 0,595 hadi 0,587. Kwa hiyo, kusema “STONE haipunguzi correctness katika hali yoyote” kunazidi matokeo ya chanzo; kauli sahihi zaidi ni kwamba katika test zilizochunguzwa, upungufu wa correctness ulikuwa mdogo kuliko kwa mbinu nyingine za watermark.
Mafanikio ya detection yakoje?
| Mbinu | MBPP+ AUROC | HumanEval+ AUROC | C++ AUROC | Java AUROC |
|---|---|---|---|---|
| KGW | 0,831 | 0,523 | 0,621 | 0,546 |
| EWD | 0,965 | 0,730 | 0,681 | 0,646 |
| SWEET | 0,867 | 0,710 | 0,641 | 0,580 |
| STONE | 0,982 | 0,777 | 0,729 | 0,721 |
Katika jaribio kuu la Qwen2.5-Coder-7B, STONE ilitoa thamani ya juu zaidi ya detectability katika dataset zote nne.
Je, ni bora pia katika kutokuonekana?
Hapana. Matokeo ya imperceptibility:
| Mbinu | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,994 | 0,986 | 0,993 | 0,993 |
| EWD | 0,994 | 0,986 | 0,993 | 0,993 |
| SWEET | 0,992 | 0,978 | 0,979 | 0,901 |
| STONE | 0,990 | 0,978 | 0,990 | 0,979 |
KGW na EWD zina thamani zilizo juu kidogo katika kipimo hiki. Faida inayodaiwa ya STONE si ushindi wa kabisa katika kutokuonekana; ni kuimarisha correctness na detectability pamoja huku imperceptibility ikiendelea kuwa katika kiwango cha juu.
Je, matokeo hubadilika katika uzito 66 tofauti wa STEM?
Watafiti walibadilisha thamani za \(\alpha\), \(\beta\) na \(\zeta\) kati ya 0,0–1,0 kwa hatua za 0,1 na kutathmini mchanganyiko 66 tofauti wa uzito wenye jumla ya 1.
Asilimia ya michanganyiko ambayo STONE ilipata STEM score ya juu zaidi:
- MBPP+: %97,0,
- HumanEval+: %90,9,
- HumanEvalPack-C++: %98,5,
- HumanEvalPack-Java: %95,5.
Uchambuzi huu unaonyesha kwamba matokeo makuu si matokeo ya uchaguzi wa uzito sawa pekee. Hata hivyo, haimaanishi kwamba kila mchanganyiko endelevu wa uzito unaoweza kuchaguliwa na mtumiaji umejaribiwa; utafiti ulitathmini michanganyiko 66 iliyobainishwa kwa vipindi vya 0,1.
STONE ni ya haraka kiasi gani?
Muda wa jumla wa detection katika kiwango cha dataset:
| Mbinu | MBPP+ (sek) | HumanEval+ (sek) | C++ (sek) | Java (sek) |
|---|---|---|---|---|
| KGW | 12,90 | 4,19 | 8,01 | 8,95 |
| EWD | 100,43 | 34,51 | 56,85 | 59,84 |
| SWEET | 100,94 | 34,68 | 58,08 | 59,22 |
| STONE | 13,27 | 4,62 | 8,48 | 9,24 |
Muda wa detection wa STONE uko karibu sana na KGW na ni wa chini kwa kiasi kikubwa kuliko EWD na SWEET. Watafiti wanaeleza kwamba sababu ni EWD na SWEET kufanya hesabu ya token probability distribution/entropy wakati wa detection, huku STONE ikifanya green-list check.
Muda wa kuongeza watermark uko katika kiwango sawa katika mbinu zote; faida kubwa ya kasi ya STONE iko hasa katika hatua ya detection.
Ina ustahimilivu kiasi gani dhidi ya shambulio la refactoring?
Katika HumanEval+:
| Hali | SWEET | STONE |
|---|---|---|
| Hakuna shambulio | 0,710 | 0,777 |
| Code refactoring | 0,539 | 0,664 |
| Code paraphrasing | 0,563 | 0,600 |
Katika MBPP+:
| Hali | SWEET | STONE |
|---|---|---|
| Hakuna shambulio | 0,679 | 0,982 |
| Code refactoring | 0,359 | 0,907 |
| Code paraphrasing | 0,385 | 0,824 |
STONE inaonyesha detection performance ya juu kuliko SWEET katika aina zote mbili za shambulio. Lakini kushuka kwa thamani ukilinganisha na hali isiyo na shambulio kunaonyesha wazi kwamba watermark inaweza kuathiriwa na mabadiliko.
Kwa nini paraphrasing inaathiri STONE?
Watafiti wanaeleza kwamba refactoring huhifadhi mipaka mingi ya sintaksia na kwa hiyo sehemu muhimu ya watermark katika eneo la non-syntax token inaweza kubaki.
Paraphrasing inaweza kubadilisha maeneo nje ya sintaksia kama variable names na expressions. Kwa kuwa haya yanaingiliana moja kwa moja na malengo ya watermark ya STONE, detection signal inaweza kupungua.
STONE ilijaribiwa dhidi ya mshambuliaji anayejua algorithm?
Hapana. Hili limeelezwa wazi katika sehemu ya limitations ya utafiti wenyewe.
Mshambuliaji anayejua algorithm ya STONE, hasa akilenga non-syntax tokens, anaweza:
- kubadilisha majina ya variables zote kwa utaratibu,
- kuondoa comments,
- kutumia transformations zinazolengwa kupunguza watermark density ya STONE.
Watafiti wanataja ulinzi mpya dhidi ya mashambulizi kama haya ya algorithm-aware kama eneo la kazi ya baadaye.
Kwa nini code golf na obfuscated code zinaweza kuwa tatizo?
Kiasi cha watermark ambacho STONE inaweza kubeba kinategemea msongamano wa non-syntax tokens. Katika benchmark code za kawaida kuna idadi ya kutosha ya target token.
Lakini katika suluhisho fupi sana na zilizobanwa za “code golf” au code iliyofanywa obfuscate kwa makusudi, idadi ya token hizi inaweza kupungua. Katika hali hizo, watermark inaweza kuwa sparse sana na kutotosha kwa detection ya kuaminika.
Je, matokeo ya Llama-3.1-8B yanaonyesha mwelekeo huo huo?
Katika majaribio ya ziada, Llama-3.1-8B ilitumika kwenye MBPP+ na HumanEval+. STONE tena ilitoa score za juu zaidi za STEM yenye uzito sawa:
- MBPP+: STONE 0,782,
- HumanEval+: STONE 0,699.
Hata hivyo, katika detectability ya HumanEval+, EWD kwa 0,755 ilikuwa juu kidogo kuliko 0,741 ya STONE. Pamoja na hayo, STONE iliendelea kuongoza katika combined STEM score kutokana na correctness ya juu.
Matokeo haya pia yanaunga mkono kwamba dai la mbinu si “kushinda kila submetrik kwa kila model”, bali kudumisha uwiano wa jumla.
Matokeo yanayoungwa mkono na utafiti
- High token entropy haimaanishi mabadiliko salama kisintaksia katika program code.
- Katika uchambuzi wa awali wa Python, kategoria ya keywords ina wastani wa juu zaidi wa entropy katika benchmark mbili zilizochunguzwa.
- Katika mpangilio bora wa SWEET wa HumanEval+, takriban %12,6 ya token zilizochaguliwa ni syntax tokens.
- STONE inapendekeza generation na detection approach inayotenganisha syntax tokens na watermark target.
- Katika jaribio kuu la Qwen2.5-Coder-7B, STONE ilitoa correctness, detectability na equal-weight STEM za juu zaidi katika benchmark nne.
- Imperceptibility ya STONE ilibaki juu lakini absolute best value ya submetrik hii haikuwa ya STONE kila wakati.
- STONE ilitoa kwa wastani %7,57 ya correctness ya juu zaidi kuliko SWEET.
- Detection ya STONE iliripotiwa kuwa kwa wastani takriban %86 haraka zaidi kuliko entropy-based detection ya EWD na SWEET.
- STONE ilibaki nafasi ya kwanza katika sehemu kubwa ya 66 STEM weightings.
- Ingawa detectability ilishuka baada ya refactoring na paraphrasing attacks, STONE ilibaki resistant zaidi kuliko SWEET katika majaribio yaliyofanywa.
Matokeo ambayo utafiti hauungi mkono au bado haujaonyesha
- STONE si general-purpose detector inayotambua bila watermark kwamba unknown code yoyote imeandikwa na LLM.
- Haijaonyeshwa kwamba watermark haiwezi kuondolewa dhidi ya code transformations zote.
- Resistance dhidi ya targeted attackers wanaojua algorithm ya STONE haijaonyeshwa kwa majaribio.
- Reliable detection haijahakikishwa katika obfuscated au code-golf code.
- Si lugha zote za programu zimetathminiwa; main experiments zimewekewa mipaka kwenye Python, C++ na Java.
- Hakuna field evaluation iliyofanywa kwenye real enterprise software repositories au production code yenye mamilioni ya mistari.
- STONE haitoi result ya juu zaidi kila wakati katika submetrik zote.
- Detection ya code yenye watermark pekee si ushahidi wa author identity, malicious intent, academic misconduct au legal liability.
Mbinu na Matokeo ya Utafiti
Maswali ya utafiti
Utafiti unalenga maswali matatu makuu:
- Je, STONE inaweza kuhifadhi functional correctness?
- Je, inaweza kutoa balanced performance inayopimwa kwa STEM kati ya correctness, detectability na imperceptibility?
- Computational cost yake ni ipi kwa upande wa watermark insertion na detection?
Matokeo yote makuu ya Qwen2.5-Coder-7B
| Dataset | Mbinu | Correctness | Detectability | Imperceptibility | STEM |
|---|---|---|---|---|---|
| MBPP+ | KGW | 0,499 | 0,831 | 0,994 | 0,775 |
| MBPP+ | EWD | 0,499 | 0,965 | 0,994 | 0,819 |
| MBPP+ | SWEET | 0,502 | 0,867 | 0,992 | 0,787 |
| MBPP+ | STONE | 0,571 | 0,982 | 0,990 | 0,848 |
| HumanEval+ | KGW | 0,573 | 0,523 | 0,986 | 0,694 |
| HumanEval+ | EWD | 0,573 | 0,730 | 0,986 | 0,763 |
| HumanEval+ | SWEET | 0,574 | 0,710 | 0,978 | 0,754 |
| HumanEval+ | STONE | 0,587 | 0,777 | 0,978 | 0,781 |
| HEP-C++ | KGW | 0,576 | 0,621 | 0,993 | 0,730 |
| HEP-C++ | EWD | 0,576 | 0,681 | 0,993 | 0,750 |
| HEP-C++ | SWEET | 0,584 | 0,641 | 0,979 | 0,735 |
| HEP-C++ | STONE | 0,622 | 0,729 | 0,990 | 0,780 |
| HEP-Java | KGW | 0,387 | 0,546 | 0,993 | 0,642 |
| HEP-Java | EWD | 0,387 | 0,646 | 0,993 | 0,675 |
| HEP-Java | SWEET | 0,413 | 0,580 | 0,901 | 0,631 |
| HEP-Java | STONE | 0,445 | 0,721 | 0,979 | 0,715 |
Muda wa uchakataji
| Dataset | Mbinu | Insertion (sek) | Detection (sek) |
|---|---|---|---|
| MBPP+ | KGW | 3320 | 12,90 |
| MBPP+ | EWD | 3320 | 100,43 |
| MBPP+ | SWEET | 3300 | 100,94 |
| MBPP+ | STONE | 3266 | 13,27 |
| HumanEval+ | KGW | 1268 | 4,19 |
| HumanEval+ | EWD | 1268 | 34,51 |
| HumanEval+ | SWEET | 1270 | 34,68 |
| HumanEval+ | STONE | 1277 | 4,62 |
| HEP-C++ | KGW | 1308 | 8,01 |
| HEP-C++ | EWD | 1308 | 56,85 |
| HEP-C++ | SWEET | 1454 | 58,08 |
| HEP-C++ | STONE | 1300 | 8,48 |
| HEP-Java | KGW | 1506 | 8,95 |
| HEP-Java | EWD | 1506 | 59,84 |
| HEP-Java | SWEET | 1480 | 59,22 |
| HEP-Java | STONE | 1459 | 9,24 |
Coverage ya syntax-token ya SWEET
Katika Appendix E, ilichunguzwa SWEET huchagua token ngapi na ni kiasi gani cha zilizochaguliwa ni syntax token wakati entropy threshold inabadilika.
Kwa HumanEval+, wakati optimum entropy threshold ni 0,9:
- %28,98 ya token zote zilizozalishwa zilichaguliwa,
- %12,60 ya zilizochaguliwa ni syntax token.
Mgawanyo uliotolewa katika chanzo ndani ya syntax token hizi ni:
- delimiters: %49,29,
- whitespace: %38,17,
- keywords: %9,44,
- types: %3,17,
- operators: %2,78.
Asilimia hizi zimehamishwa kama zilivyoripotiwa kwa subcategories katika chanzo; kutokana na rounding na category-reporting format, jumla haitarajiwi kuwa sawa kabisa na %100.
Matokeo ya comparison ya ziada ya CodeIP
Watafiti hawakujumuisha CodeIP katika main baseline group kwa sababu inahitaji training, lakini waliendesha tena official implementation yake katika Appendix A.
Thamani za detectability za CodeIP zilibaki juu kati ya 0,945–0,994, huku correctness results zikiwa 0,093 kwa MBPP+, 0,018 kwa HumanEval+, 0,000 kwa C++ na 0,073 kwa Java.
Jaribio hili lilitumiwa kuonyesha kwamba detection performance ya juu pekee haitoshi kwa balanced code-watermarking method. Hata hivyo, matokeo haya ni ya reproduction setup ya waandishi wenyewe na hayapaswi kutafsiriwa kama hukumu ya jumla kwa possible settings zote au versions za baadaye za CodeIP.
Mapungufu makuu ya mbinu
- Watermark capacity inategemea density ya non-syntax tokens.
- Katika code-golf au obfuscated code, sufficient watermark signal inaweza isizalishwe.
- Comprehensive defense dhidi ya targeted token renaming ya mshambuliaji anayejua algorithm haijaonyeshwa.
- Robustness experiments zimewekewa mipaka kwenye aina mbili za mashambulizi ya jumla.
- Main evaluation imewekewa mipaka kwenye lugha tatu za programu na benchmark nne.
- Main model ni Qwen2.5-Coder-7B; second-model analysis ilifanywa tu katika appendix kwenye Python benchmark mbili.
- Long-term watermark persistence chini ya human-developer edits katika real large-scale software projects haijajaribiwa.
Maelezo muhimu katika ufafanuzi wa algorithm
Maelezo ya utafiti yanafafanua STONE kama mbinu “inayoweka watermark kwenye non-syntax tokens pekee”. Katika printed pseudocode ya Algorithm 1, hata hivyo, kama watermark process itawezeshwa au la huamuliwa kulingana na ikiwa candidate token ya kwanza iliyochukuliwa iko katika syntax set, na kisha final token huchukuliwa tena kutoka katika adjusted distribution.
Pseudocode haionyeshi independent line inayokataza final token kuchaguliwa kutoka syntax set katika sampling ya pili. Chanzo pia hakielezi kando katika maandishi jinsi jambo hili linavyoshughulikiwa katika implementation code. Kwa hiyo, hapa ufafanuzi wa “syntax-aware/non-syntax targeting” uliotolewa na waandishi umehifadhiwa; algorithm tofauti haijadhaniwa kutokana na maelezo ya pseudocode.
Maelezo ya Chanzo na Mbinu
Jina kamili asilia la utafiti: Marking Code Without Breaking It: Code Watermarking for Detecting LLM-Generated Code
Waandishi na mpangilio asilia: Jungin Kim; Shinwoo Park; Yo-Sub Han.
Equal contribution: Jungin Kim na Shinwoo Park wameonyeshwa katika chanzo kama waandishi wenye mchango sawa.
Corresponding author: Yo-Sub Han.
Taasisi: Yonsei University, Seoul, Republic of Korea.
Aina ya chanzo na peer review: Peer-reviewed conference publication; Findings of the Association for Computational Linguistics: EACL 2026.
Publication: Findings of the Association for Computational Linguistics: EACL 2026.
Mchapishaji: Association for Computational Linguistics.
Kurasa: 3990–4002.
Conference: 19th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2026), Rabat, Morocco, 24–29 March 2026.
ACL Anthology ID: 2026.findings-eacl.207
DOI: 10.18653/v1/2026.findings-eacl.207
Official publication link: https://aclanthology.org/2026.findings-eacl.207/
DOI link: https://doi.org/10.18653/v1/2026.findings-eacl.207
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0) license inayotumiwa na ACL Anthology kwa ACL materials zilizochapishwa 2016 na baadaye.
Ufadhili: Utafiti unaripoti msaada wa NRF grant RS-2025-00562134 na AI Graduate School Program RS-2020-II201361 inayofadhiliwa na serikali ya Korea.
Implementation code: Source study inaeleza kwamba STONE implementation inapatikana katika https://github.com/inistory/STONE-watermarking.
Main model: Qwen2.5-Coder-7B.
Additional model: Llama-3.1-8B.
Perplexity evaluation model: StarCoder2-7B.
Programming languages: Python, C++ na Java.
Benchmarks: MBPP+, HumanEval+, HumanEvalPack-C++ na HumanEvalPack-Java.
Main comparisons: KGW, EWD na SWEET. CodeIP haikujumuishwa katika main training-free baseline group kwa sababu inahitaji training na ilitathminiwa tena kando katika Appendix A.
Main evaluation metrics: pass@k kwa correctness; z-score-based AUROC kwa detectability; perplexity change kwa imperceptibility; STEM kwa combined evaluation.
Computing infrastructure: NVIDIA A6000 GPU.
Robustness analysis: Code refactoring na code paraphrasing attacks kwa GPT-4o zilitumiwa kwenye HumanEval+ na MBPP+.
Kikomo kikuu cha kimetodolojia: STONE ni provenance mechanism inayoweza kutumiwa tu kwenye outputs ambako watermark iliwekwa kwa makusudi wakati wa generation. Si general detector inayotambua kwa uaminifu, kwa mtindo pekee, code yoyote isiyo na watermark, iliyotengenezwa na provider mwingine au iliyoandikwa na binadamu kama “LLM-generated”.
Kikomo cha mashambulizi: Baada ya refactoring na paraphrasing, detectability ya STONE hushuka. Comprehensive robustness dhidi ya attackers wanaojua algorithm na wanaolenga hasa non-syntax tokens haijaonyeshwa.
Kikomo cha generalization: Matokeo yanategemea benchmark-based code generation tasks. Performance rates sawa hazijahakikishwa kwa large real-world repositories, long-term human edits, different programming languages na broad model families.
Kikomo cha comparison: STONE si absolute best katika kila individual submetrik. Hasa kwa imperceptibility, KGW na EWD zilitoa score za juu katika baadhi ya main experiments. Matokeo makuu ya utafiti ni kwamba STONE huzalisha STEM results za juu na thabiti wakati correctness, detectability na imperceptibility zinatathminiwa pamoja.
Algorithm note ndani ya chanzo: Katika pseudocode ya Algorithm 1, kuwezesha watermarking huamuliwa kulingana na ikiwa candidate token iko katika syntax set, huku final token ikichukuliwa baadaye tena kutoka adjusted distribution. Ingawa maandishi yanafafanua mbinu kama non-syntax-only watermarking, pseudocode haionyeshi wazi hatua ya pili ya syntax blocking kwa final token. Kwa kuwa jambo hili halijapatanishwa kando katika chanzo, hakuna correction ya kubashiri iliyofanywa katika maelezo ya Verianla.
Upeo wa maudhui ya kisayansi: Algorithms, formulas, benchmark values, attack results, processing times, STEM comparisons na limitations katika maelezo haya ya Verianla yanategemea source study. External source ilitumika tu kuthibitisha official bibliographic identity, EACL/ACL publication status na license information.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *