

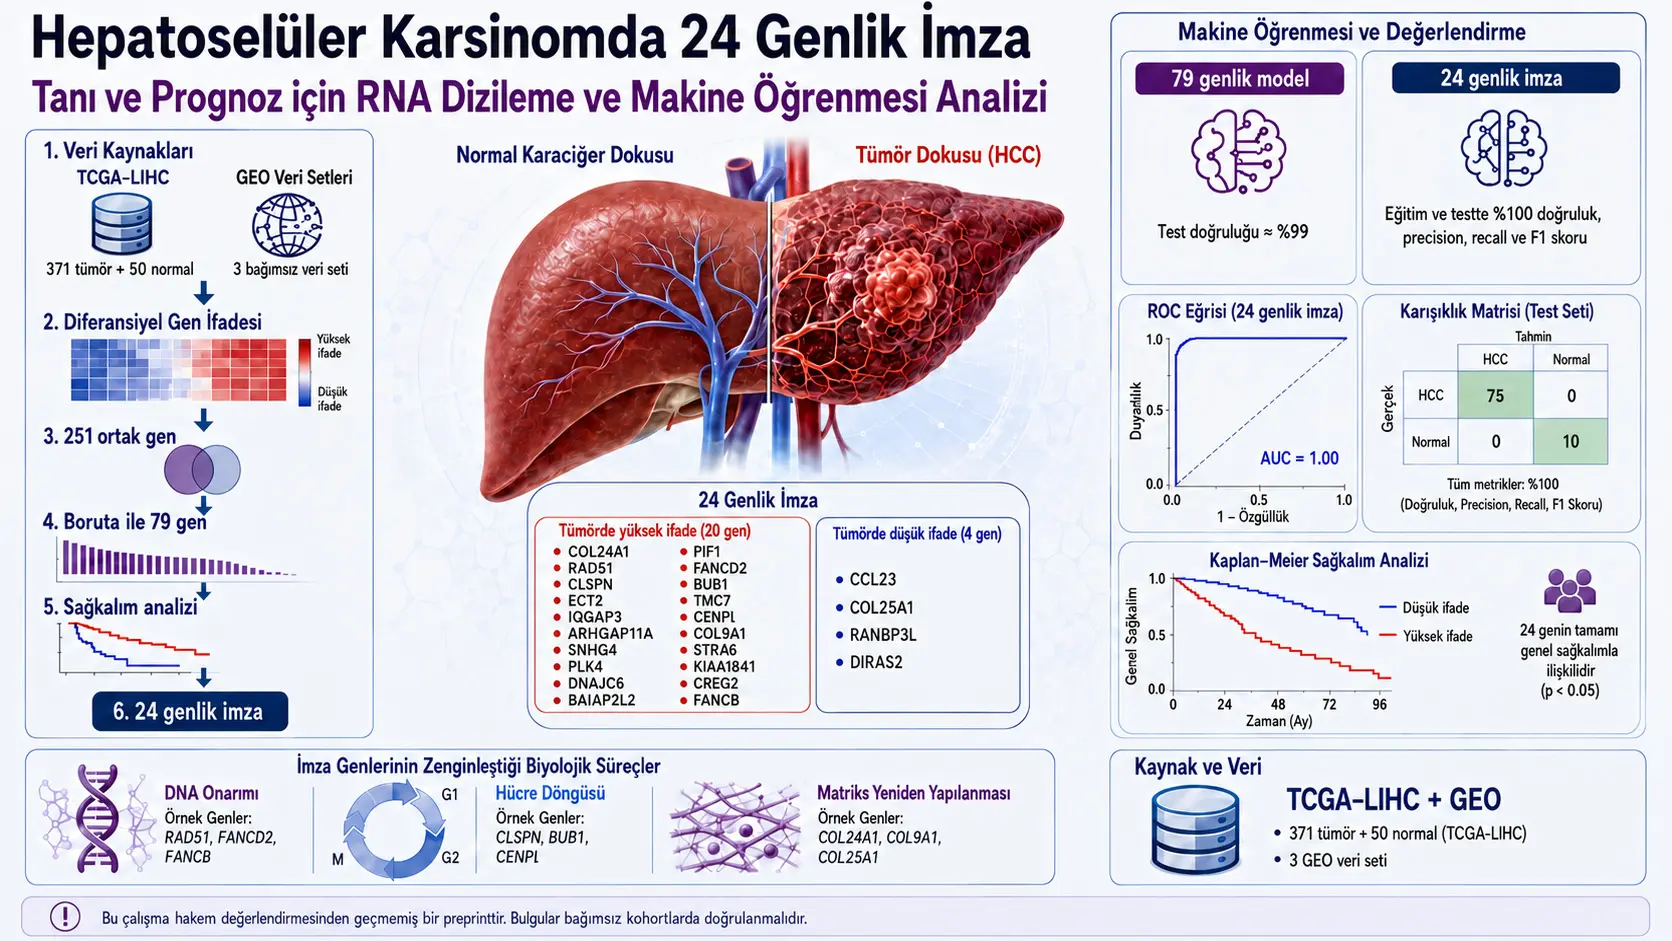
Hepatoselüler karsinom, karaciğerde gelişen birincil kanserlerin büyük bölümünü oluşturan ve çoğu hastada ileri evrede saptanması nedeniyle ciddi ölüm yükü taşıyan bir hastalıktır. Klinik uygulamada kullanılan alfa-fetoprotein gibi biyobelirteçler, özellikle erken evre hastalıkta yeterli duyarlılık ve özgüllüğe sahip olmayabilir. Bu nedenle tümör dokusunu normal karaciğer dokusundan ayırabilecek ve aynı zamanda hastaların genel sağkalımıyla ilişkili olabilecek moleküler imzalar araştırılmaktadır.
Bu çalışmada The Cancer Genome Atlas’ın TCGA-LIHC kohortundaki 371 tümör ve 50 normal karaciğer örneği ile üç GEO veri setindeki toplam 367 örnek incelenmiştir. Dört veri kaynağında ortak biçimde farklı ifade edilen 251 gen belirlenmiş, Boruta algoritmasıyla bunların 79’u önemli özellik olarak seçilmiş ve sağkalım analizi sonucunda 24 genlik son imza oluşturulmuştur.
Son imzada yer alan genlerin 20’si tümör dokusunda daha yüksek, dördü daha düşük düzeyde ifade edilmiştir. Genler DNA onarımı, hücre döngüsü kontrolü, kromozom ayrılması, hücre dışı matriksin yeniden yapılanması, sitoskeleton düzenlenmesi ve epitelyal-mezenkimal geçiş gibi kanser biyolojisiyle ilişkili süreçlerde kümelenmiştir.
TCGA-LIHC verisinin %80’lik eğitim ve %20’lik test bölümlerinde çalıştırılan rastgele orman modeli, 24 genlik imzayla tümör ve normal dokuyu %100 doğrulukla ayırmıştır. Bununla birlikte test kümesinde yalnızca 10 normal ve 75 tümör örneği bulunmaktadır. Model bağımsız bir dış kohortta doğrulanmamış, başka karaciğer hastalıklarıyla karşılaştırılmamış ve gen seçim sürecinin eğitim-test ayrımından tamamen bağımsız yürütülüp yürütülmediği açıklanmamıştır. Bu nedenle kusursuz performans, klinik kullanıma hazır bir testten çok, aşırı uyum ve veri sızıntısı olasılığı açısından araştırılması gereken bir bulgudur.
Çalışma ayrıca 24 genin her birinin genel sağkalımla istatistiksel ilişki gösterdiğini bildirmektedir. Ancak analizler tek değişkenli Kaplan-Meier ve log-rank karşılaştırmalarına dayanmaktadır. Tümör evresi, tedavi, karaciğer fonksiyonu, siroz, viral hepatit durumu ve diğer klinik değişkenlere göre düzeltilmiş çok değişkenli sağkalım modeli sunulmamıştır. Bu nedenle genlerin bağımsız prognostik belirteçler olduğu henüz gösterilmiş değildir.
En kritik nokta, bu 24 genlik imzanın mevcut haliyle bir kan testi olmamasıdır. Model, doku örneklerinden elde edilen RNA ifade profillerinde tümör dokusunu normal karaciğer dokusundan ayırmaktadır. Erken tanı, kan dolaşımından ölçüm, biyopsiden kaçınma veya klinik tarama amacıyla kullanılabilmesi için bağımsız hasta gruplarında, sirotik ve benign karaciğer dokularında ve mümkünse prospektif çalışmalarda doğrulanması gerekir.
Çalışmanın ele aldığı temel klinik problem
Hepatoselüler karsinom, İngilizce adıyla hepatocellular carcinoma ve kısaltmasıyla HCC, birincil karaciğer kanserlerinin yaklaşık %90’ını oluşturan malign tümördür. Hastalık sıklıkla kronik hepatit B veya C enfeksiyonu, alkole bağlı siroz, metabolik işlev bozukluğuyla ilişkili yağlı karaciğer hastalığı, hemokromatoz ve alfa-1 antitripsin eksikliği gibi kronik karaciğer hastalıklarının zemininde gelişebilir.
HCC’de tedavi başarısını sınırlayan önemli sorunlardan biri, tümörün çoğu hastada ileri evrede fark edilmesidir. Küçük ve karaciğer içinde sınırlı tümörlerde cerrahi rezeksiyon, karaciğer nakli veya lokal ablasyon gibi küratif amaçlı seçenekler değerlendirilebilirken; ileri evrede hastalık, damar invazyonu, karaciğer rezervinin azalması ve uzak yayılım nedeniyle daha zor yönetilir.
Bu nedenle araştırmacılar iki farklı klinik ihtiyacı aynı moleküler panelle karşılamaya çalışmıştır:
- Tanısal değer: Gen ifade örüntüsünün tümör dokusuyla normal karaciğer dokusunu ayırabilmesi.
- Prognostik değer: Genlerin yüksek veya düşük ifade düzeylerinin hastaların genel sağkalımıyla ilişkili olması.
Tanısal ve prognostik kavramlar birbirinden farklıdır. Bir belirteç tümör dokusunu normal dokudan çok iyi ayırabilir fakat hastanın ne kadar yaşayacağını göstermeyebilir. Benzer şekilde sağkalımla ilişkili bir gen, erken tanı açısından yeterli ayırt ediciliğe sahip olmayabilir. Çalışmanın amacı, iki özelliği aynı gen kümesinde birleştirmektir.
AFP neden tek başına yeterli görülmemektedir?
Alfa-fetoprotein, HCC’de en yaygın kullanılan serum biyobelirteçlerinden biridir. Bununla birlikte çalışma, AFP’nin erken evre hastalıkta sınırlı duyarlılık ve özgüllük gösterebildiğini vurgulamaktadır. İleri HCC hastalarının bir bölümünde dahi AFP normal kalabilir; benign karaciğer hastalıkları da AFP yüksekliğine yol açabilir.
Bu nedenle AFP yüksekliği her zaman kanser anlamına gelmez, normal AFP düzeyi de HCC’yi kesin olarak dışlamaz. Çalışmanın araştırdığı gen imzası, teorik olarak tek bir proteine dayalı göstergeden daha geniş bir tümör biyolojisi örüntüsünü yakalamayı amaçlamaktadır.
Ancak araştırma 24 genlik paneli AFP ile doğrudan karşılaştırmamıştır. AFP ile birlikte kullanıldığında ek yarar sağlayıp sağlamadığı da test edilmemiştir. Dolayısıyla çalışma, 24 genlik panelin AFP’den üstün olduğunu göstermemektedir.
Kullanılan veri kaynakları
Araştırmada bir TCGA kohortu ve üç GEO veri seti kullanılmıştır:
| Veri seti | Normal örnek | Tümör örneği | Toplam | Çalışmadaki rolü |
|---|---|---|---|---|
| TCGA-LIHC | 50 | 371 | 421 | Diferansiyel ifade, özellik seçimi, sınıflandırma, ekspresyon ve sağkalım analizleri |
| GSE57957 | 39 | 39 | 78 | Diferansiyel ifade ve ortak genlerin belirlenmesi |
| GSE62232 | 10 | 81 | 91 | Diferansiyel ifade ve ortak genlerin belirlenmesi |
| GSE112790 | 15 | 183 | 198 | Diferansiyel ifade ve ortak genlerin belirlenmesi |
Dört veri setinde toplam 738 örnek bulunmaktadır. Bununla birlikte bu örneklerin tamamı birleştirilerek tek bir makine öğrenmesi modeli oluşturulmamıştır. GEO kohortları ortak diferansiyel genleri belirlemek için kullanılmış; sınıflandırma modeli ise TCGA-LIHC kohortunda geliştirilip aynı kohortun içinden ayrılan test setinde değerlendirilmiştir.
Bu ayrım son derece önemlidir. GEO verilerinin gen seçiminde kullanılması, 24 genlik sınıflandırıcının GEO kohortlarında dış doğrulamadan geçtiği anlamına gelmemektedir.
Çalışmanın analiz akışı
Araştırma şemasında süreç şu sırayla ilerlemektedir:
- TCGA-LIHC ve GEO gen ifade verilerinin alınması,
- Her veri setinde tümör-normal diferansiyel gen ifade analizi,
- Dört veri setinde ortak bulunan 251 genin belirlenmesi,
- Boruta algoritmasıyla 251 genden önemli özelliklerin seçilmesi,
- 79 doğrulanmış genle rastgele orman sınıflandırıcısının kurulması,
- 79 genin genel sağkalımla ilişkisinin GEPIA2 üzerinden incelenmesi,
- P<0,05 bulunan 24 genin son imzaya alınması,
- 24 genin tümör-normal ekspresyon farklarının değerlendirilmesi,
- 24 genlik imzayla ikinci rastgele orman modelinin kurulması,
- Genlerin biyolojik işlevlerinin mevcut literatür üzerinden yorumlanması.
Diferansiyel gen ifadesi ne anlama gelir?
Bir genin “diferansiyel ifade edildiğinin” söylenmesi, o gene ait RNA miktarının karşılaştırılan iki grup arasında istatistiksel ve biyolojik açıdan anlamlı farklılık göstermesi demektir. Bu çalışmada tümör dokusu ile normal karaciğer dokusu karşılaştırılmıştır.
Gen ifade değişiminin temel göstergelerinden biri kat değişimidir. Açıklama amacıyla kullanılan temel ilişki şöyledir:
\[ \log_2FC = \log_2 \left(\frac{\text{Tümör grubundaki ifade}}{\text{Normal gruptaki ifade}}\right) \]
Burada log₂FC, iki tabanında logaritmik kat değişimidir.
- log₂FC=1, tümör grubundaki ifadenin yaklaşık iki kat yüksek olduğunu gösterir.
- log₂FC=-1, tümör grubundaki ifadenin normal grubun yaklaşık yarısı olduğunu gösterir.
- Pozitif değerler yukarı düzenlenmeyi, negatif değerler aşağı düzenlenmeyi ifade eder.
TCGA-LIHC analizinde genlerin anlamlı kabul edilmesi için yanlış keşif oranının FDR<0,01 ve mutlak log kat değişiminin |logFC|>1,5 olması şartı uygulanmıştır.
FDR, binlerce gen aynı anda test edildiğinde ortaya çıkabilecek yalancı pozitif sonuçları kontrol etmeyi amaçlar. Bir genin ham P değeri düşük olsa bile, çok sayıda test yapıldığında bazı sonuçlar yalnızca şans nedeniyle anlamlı görünebilir.
TCGA-LIHC verisi nasıl işlendi?
TCGA-LIHC verisi TCGAbiolinks R paketiyle işlenmiştir. Araştırmada bildirilen adımlar şunlardır:
- Korelasyon eşiği 0,6 kullanılarak düşük kaliteli örneklerin filtrelenmesi,
- Genlerin GC içeriğinden kaynaklanabilecek teknik farklılıkların normalizasyonu,
- 0,25 kuantil eşiğiyle düşük değişkenlik gösteren genlerin çıkarılması,
- Normal ve tümör dokularının karşılaştırılması,
- FDR<0,01 ve |logFC|>1,5 eşiklerinin uygulanması.
Bu analiz sonucunda TCGA-LIHC kohortunda 4.412 diferansiyel gen belirlenmiştir. Bunların 3.687’si tümör dokusunda daha yüksek, 725’i daha düşük ifade edilmiştir.
GEO veri setleri nasıl analiz edildi?
Üç GEO veri setinde DESeq2 kullanılmıştır. Önce bütün örneklerde toplam okuma sayısı 100’ün altında olan düşük sayımlı genler çıkarılmış, ardından negatif binom dağılımına dayalı genelleştirilmiş doğrusal model uygulanmıştır.
DESeq2’de kullanılan temel sayım modeli açıklama amacıyla şu biçimde gösterilebilir:
\[ K_{ij} \sim NB(\mu_{ij}, \alpha_i) \]
Burada:
- Kij, i geninin j örneğindeki RNA okuma sayısıdır.
- NB, negatif binom dağılımını ifade eder.
- μij, beklenen ortalama sayımdır.
- αi, gene özgü dağılım veya saçılma parametresidir.
GEO analizlerinde düzeltilmiş P<0,05 eşiği kullanılmıştır. Ayrıca sıralanmış gen listesi ve güvenli etki büyüklüğü tahminleri için deseq2 confects işlevi 0,5 adım değeriyle uygulanmıştır.
Dört veri setindeki diferansiyel gen sayıları
| Veri seti | Yukarı düzenlenen | Aşağı düzenlenen | Toplam diferansiyel gen |
|---|---|---|---|
| TCGA-LIHC | 3.687 | 725 | 4.412 |
| GSE57957 | 8.594 | 5.527 | 14.121 |
| GSE62232 | 11.273 | 5.017 | 16.290 |
| GSE112790 | 45 | 86 | 131 |
Veri setleri arasında diferansiyel gen sayılarının son derece farklı olması dikkat çekmektedir. GSE62232’de 16.290 gen anlamlı bulunurken GSE112790’da yalnızca 131 gen bulunmuştur. Bu fark; örnek büyüklüğü, ölçüm platformu, veri kalitesi, hasta özellikleri, normalizasyon, tümör heterojenliği ve kullanılan eşiklerle ilişkili olabilir.
Çalışma farklı veri setlerinde farklı anlamlılık koşulları uygulamıştır. TCGA’da hem FDR hem de belirgin kat değişimi eşiği bulunurken GEO bölümünde düzeltilmiş P değeri temel alınmıştır. Bu farklılık, veri setleri arasındaki gen sayılarını ve ortak gen kümesini etkileyebilir.
Volkan grafikleri neyi gösterdi?
Volkan grafikleri her genin ifade değişimini ve istatistiksel anlamlılığını aynı düzlemde göstermektedir. Yatay eksen log kat değişimini, dikey eksen ise genellikle P değerinin negatif logaritmasını temsil eder.
Grafiklerde:
- Yeşil noktalar tümör dokusunda yukarı düzenlenen genleri,
- Kırmızı noktalar aşağı düzenlenen genleri,
- Siyah noktalar anlamlı kabul edilmeyen genleri göstermektedir.
Grafiğin sağ üst bölgesindeki genler tümörde daha yüksek ve istatistiksel olarak güçlü farklılık gösterirken, sol üst bölgedekiler tümörde daha düşük ifade edilen güçlü adaylardır.
251 ortak gen nasıl belirlendi?
TCGA-LIHC, GSE57957, GSE62232 ve GSE112790’da diferansiyel ifade gösteren genler Venny aracıyla kesiştirilmiştir. Dört veri setinin ortak bölgesinde 251 gen bulunmuştur.
Bir genin dört bağımsız veri kaynağında da diferansiyel ifade göstermesi, tek veri setine özgü teknik veya örneklem kaynaklı sonuçları azaltma amacı taşır. Bununla birlikte ortaklık tek başına genin HCC’ye özgü olduğu anlamına gelmez. Aynı gen başka kanserlerde, inflamasyonda, fibroziste veya hızlı hücre çoğalmasında da değişebilir.
Boruta algoritmasıyla özellik seçimi
251 ortak genin tümünü modele almak, örnek sayısına kıyasla çok sayıda değişken kullanılması nedeniyle aşırı uyum riskini artırabilir. Araştırmacılar bu nedenle Boruta algoritmasını rastgele orman modeliyle birlikte kullanmıştır.
Boruta, her gerçek değişkenin rastgele karıştırılmış “gölge” kopyalarını oluşturur. Gerçek bir genin modeldeki önemi, rastgele gölge özelliklerden sürekli olarak yüksekse gen doğrulanmış özellik olarak kabul edilir.
251 genin Boruta sonucu şöyledir:
- 79 gen: Doğrulanmış özellik
- 13 gen: Kararsız veya geçici özellik
- 159 gen: Reddedilmiş özellik
Boruta’nın temel amacı en küçük gen kümesini bulmak değil, sonuçla ilgili olabilecek bütün anlamlı özellikleri korumaktır. Bu nedenle 79 genlik küme hâlâ geniştir.
Rastgele orman modeli nasıl çalışır?
Rastgele orman, çok sayıda karar ağacının oluşturduğu topluluk modelidir. Her ağaç veri örneklerinin ve genlerin rastgele alt kümeleriyle eğitilir. Son sınıf, ağaçların çoğunluk oyu üzerinden belirlenir.
Açıklama amacıyla sınıflandırma kararı şu temel ilişkiyle gösterilebilir:
\[ \hat{y} = \operatorname{mode}\{T_1(x), T_2(x), \ldots, T_B(x)\} \]
Burada:
- x, bir doku örneğinin gen ifade profilidir.
- Tb, her karar ağacının normal veya tümör tahminidir.
- B, toplam ağaç sayısıdır.
- ŷ, çoğunluk oyuyla belirlenen nihai sınıftır.
Çalışma kullanılan ağaç sayısını, ağaç derinliğini, her bölünmede değerlendirilen gen sayısını, sınıf ağırlıklarını ve rastgele başlangıç değerini ayrıntılı biçimde vermemektedir. Bu eksiklik modelin birebir yeniden üretilmesini zorlaştırmaktadır.
79 genlik ilk modelin performansı
TCGA-LIHC verisi rastgele biçimde %80 eğitim ve %20 test setine ayrılmıştır:
| Veri bölümü | Normal | Tümör | Toplam |
|---|---|---|---|
| Eğitim seti | 40 | 296 | 336 |
| Test seti | 10 | 75 | 85 |
79 genlik model eğitim setindeki bütün örnekleri doğru sınıflandırmıştır. Test setinde ise 85 örnekten 84’ü doğru, biri yanlış sınıflandırılmıştır. Bildirilen genel doğruluk %98,8’dir.
Karışıklık matrisinde 10 normal örneğin tamamı normal, 75 tümör örneğinin 74’ü tümör ve biri normal olarak gösterilmiştir. Bu durumda tek yanlış sınıflandırılan örnek bir tümör örneğidir.
Tablodaki sınıf bazlı precision ve recall değerleriyle karışıklık matrisindeki hücreler arasında yönsel bir yorum belirsizliği bulunmaktadır. Matrisin satır ve sütunlarının gerçek ve tahmin edilen sınıflar olarak nasıl tanımlandığına bağlı olarak precision ile recall değerleri yer değiştirmiş görünmektedir. Bu raporlama noktası nihai yorumları değiştirmese de metriklerin yeniden doğrulanmasını gerektirir.
Doğruluk, kesinlik, duyarlılık ve F1 skoru
Aşağıdaki formüller çalışmada açıkça yazılmamış, bildirilen performans ölçülerinin ne anlama geldiğini açıklamak amacıyla eklenmiştir:
\[ \mathrm{Accuracy} = \frac{TP+TN}{TP+TN+FP+FN} \]
\[ \mathrm{Precision} = \frac{TP}{TP+FP} \]
\[ \mathrm{Recall} = \frac{TP}{TP+FN} \]
\[ F1 = 2 \times \frac{\mathrm{Precision}\times\mathrm{Recall}}{\mathrm{Precision}+\mathrm{Recall}} \]
Burada:
- TP: Doğru biçimde tümör olarak sınıflandırılan tümör örnekleri,
- TN: Doğru biçimde normal olarak sınıflandırılan normal örnekler,
- FP: Yanlışlıkla tümör denilen normal örnekler,
- FN: Yanlışlıkla normal denilen tümör örnekleridir.
Kanser tanısında yalnızca genel doğruluk yeterli değildir. Normal örnek sayısı azsa model bütün örnekleri tümör olarak sınıflandırarak bile yüksek doğruluk elde edebilir. Bu nedenle sınıf dağılımı, duyarlılık, özgüllük, pozitif kestirim değeri ve bağımsız doğrulama birlikte değerlendirilmelidir.
Genel sağkalımla ilişkili 24 gen
Boruta tarafından seçilen 79 gen GEPIA2 aracılığıyla sağkalım analizine alınmıştır. Her gen için hastalar medyan ifade düzeyine göre yüksek ve düşük ifade gruplarına ayrılmış, Kaplan-Meier eğrileri oluşturulmuş ve log-rank testi uygulanmıştır.
P<0,05 bulunan 24 gen son imzaya dahil edilmiştir:
COL24A1, RAD51, CLSPN, ECT2, IQGAP3, ARHGAP11A, CCL23, SNHG4, PLK4, DNAJC6, BAIAP2L2, PIF1, FANCD2, BUB1, TMC7, CENPI, COL9A1, COL25A1, STRA6, KIAA1841, RANBP3L, DIRAS2, CREG2 ve FANCB.
Kaplan-Meier analizi neyi ölçmektedir?
Kaplan-Meier yöntemi, belirli bir zamana kadar hayatta kalma olasılığını tahmin eder. Temel ilişki açıklama amacıyla şöyledir:
\[ \hat{S}(t) = \prod_{t_i \leq t}\left(1-\frac{d_i}{n_i}\right) \]
Burada:
- S(t), t zamanına kadar sağkalma olasılığıdır.
- di, ilgili zamanda gerçekleşen ölüm sayısıdır.
- ni, o anda risk altında bulunan hasta sayısıdır.
Log-rank testi, yüksek ve düşük gen ifadesine sahip grupların sağkalım eğrileri arasında istatistiksel fark olup olmadığını değerlendirir.
Bununla birlikte P<0,05 bulunması, genin sağkalımı doğrudan etkilediğini veya bağımsız prognostik faktör olduğunu göstermez. Gen ifadesi tümör evresi, histolojik derece, damar invazyonu veya başka agresif biyolojik özelliklerle birlikte değişiyor olabilir.
Çoklu sağkalım testlerinin önemi
Toplam 79 gen için ayrı sağkalım testi yapılmıştır. Metinde bu testler için FDR veya başka bir çoklu karşılaştırma düzeltmesi uygulandığı belirtilmemektedir.
Çok sayıda hipotez aynı anda test edildiğinde yalnızca P<0,05 eşiğinin kullanılması, bazı genlerin tesadüfen anlamlı görünme ihtimalini artırır. Bu nedenle 24 genlik prognostik kümenin bağımsız kohortlarda ve düzeltilmiş çok değişkenli Cox modellerinde yeniden doğrulanması gerekir.
24 genin tümör ve normal dokudaki ifade yönleri
Son imzadaki 24 genin 20’si tümör dokusunda daha yüksek, dördü daha düşük ifade edilmiştir.
| Ekspresyon yönü | Genler |
|---|---|
| Tümörde yukarı düzenlenen 20 gen | COL24A1, RAD51, CLSPN, ECT2, IQGAP3, ARHGAP11A, SNHG4, PLK4, DNAJC6, BAIAP2L2, PIF1, FANCD2, BUB1, TMC7, CENPI, COL9A1, STRA6, KIAA1841, CREG2, FANCB |
| Tümörde aşağı düzenlenen 4 gen | CCL23, COL25A1, RANBP3L, DIRAS2 |
Kutu grafiklerinde birçok yukarı düzenlenen gen için normal ve tümör örneklerinin ifade dağılımları belirgin biçimde ayrılmaktadır. CCL23, COL25A1 ve RANBP3L’de normal dokudaki ifade daha yüksek görünmektedir. DIRAS2 de aşağı düzenlenen gen olarak sınıflandırılmıştır; ancak dağılımında örnekler arası değişkenlik bulunmaktadır.
24 genlik modelin bildirilen tanısal performansı
24 genlik imzayla oluşturulan ikinci rastgele orman modeli hem eğitim hem test setindeki bütün örnekleri doğru sınıflandırmıştır:
| Veri bölümü | Normal örnek | Tümör örneği | Doğruluk | Precision | Recall | F1 |
|---|---|---|---|---|---|---|
| Eğitim seti | 40 | 296 | %100 | %100 | %100 | %100 |
| Test seti | 10 | 75 | %100 | %100 | %100 | %100 |
ROC grafiğinde eğri altında kalan alan AUC=1,00 olarak gösterilmiştir. AUC’nin temel yorumu, rastgele seçilen bir tümör örneğinin rastgele seçilen bir normal örnekten daha yüksek model skoru alma olasılığıdır.
AUC=1,00 incelenen test kümesinde kusursuz ayrım anlamına gelir. Ancak bu değer modelin yeni hastalarda da kusursuz çalışacağını göstermez.
Kusursuz performans neden dikkatle yorumlanmalıdır?
Makalenin kendisi de kusursuz performansın aşırı uyum kaygısı doğurduğunu kabul etmektedir. Bu kaygının birkaç teknik nedeni vardır.
Test kümesi küçüktür
Test setinde yalnızca 85 örnek ve bunların içinde yalnızca 10 normal karaciğer örneği bulunmaktadır. Tek bir normal örneğin yanlış sınıflandırılması normal sınıf performansını önemli ölçüde değiştirecektir.
Sınıflar dengesizdir
TCGA-LIHC kohortunda 371 tümör örneğine karşı yalnızca 50 normal örnek vardır. Bu dengesizlik, model eğitimi ve performans ölçüleri üzerinde etkili olabilir. Çalışmada sınıf ağırlığı, dengeleme veya tabakalı örnekleme ayrıntıları verilmemiştir.
Dış doğrulama yapılmamıştır
GEO kohortları ortak genleri bulmak için kullanılmış, fakat 24 genlik rastgele orman sınıflandırıcısı bu bağımsız kohortlarda test edilmemiştir. Modelin yalnızca TCGA içinde ayrılan test parçasında değerlendirilmesi iç doğrulamadır.
Olası veri sızıntısı yeterince açıklanmamıştır
Metin, 251 ortak genin ve Boruta özelliklerinin bütün TCGA-LIHC verisi kullanılarak seçildiğini, daha sonra veri setinin %80-%20 ayrıldığını düşündüren bir iş akışı sunmaktadır. Özellik seçimi test örneklerini de gördükten sonra yapıldıysa test kümesine ait bilgi dolaylı biçimde modele sızmış olabilir.
Güvenilir değerlendirmede veri önce eğitim ve test olarak ayrılır; normalizasyon, özellik seçimi, Boruta ve hiperparametre ayarı yalnızca eğitim setinde yapılır. Test seti son aşamaya kadar tamamen dokunulmadan tutulur. Çalışma bu işlemlerin iç içe veya bağımsız biçimde yürütülüp yürütülmediğini açıkça belirtmemektedir.
Tek bir rastgele bölme kullanılmıştır
Model performansı tek bir %80-%20 ayrımına dayanıyor görünmektedir. Farklı rastgele bölmelerde, tekrarlı çapraz doğrulamada veya bootstrap örneklemlerinde performansın nasıl değiştiği raporlanmamıştır.
Normal karşılaştırma klinik olarak sınırlıdır
Model tümör dokusunu normal karaciğer dokusundan ayırmıştır. Klinik uygulamada daha zor soru, küçük HCC odağının siroz, displastik nodül, rejeneratif nodül, hepatit veya benign karaciğer tümörlerinden ayrılmasıdır. Bu gruplar modelde test edilmemiştir.
Bu panel bir kan testi midir?
Hayır. Çalışmada kullanılan veriler karaciğer dokularındaki RNA ifade düzeylerinden elde edilmiştir. Dolayısıyla 24 genlik imza mevcut biçimiyle serum, plazma veya başka bir sıvı biyopsi testi değildir.
Bir doku temelli panelin klinik tanıda kullanılabilmesi için genellikle biyopsi veya cerrahi materyal gerekir. Erken HCC taramasındaki temel ihtiyaç ise çoğu zaman tümör dokusuna ulaşmadan hastalığı saptayabilmektir.
Bu panelin kan testine dönüştürülebilmesi için ilgili RNA’ların dolaşımdaki hücresiz RNA, tümör kaynaklı eksozom veya dolaşan tümör hücrelerinde güvenilir biçimde ölçülebildiğinin gösterilmesi gerekir. Bu araştırmada böyle bir analiz yapılmamıştır.
Gen imzasının biyolojik temaları
Araştırmacılar 24 geni üç geniş kanser biyolojisi başlığında yorumlamıştır:
- Genomik kararsızlık ve DNA hasar yanıtı,
- Hücre döngüsü ve kromozom ayrılmasının bozulması,
- Tümör mikroçevresi ve hücre dışı matriksin yeniden yapılanması.
DNA onarımı ve genomik kararsızlık
| Gen | Çalışmada ilişkilendirilen temel işlev |
|---|---|
| RAD51 | Homolog rekombinasyon yoluyla çift zincirli DNA kırıklarının onarımı |
| FANCD2 | Fanconi anemisi DNA onarım yolu ve replikasyon stresi yanıtı |
| FANCB | Fanconi anemisi çekirdek kompleksi; HCC’de işlevi yeterince tanımlanmamış |
| PIF1 | DNA helikaz etkinliği ve replikasyon çatalının kararlılığı |
DNA onarım genlerinin yüksek ifadesi ilk bakışta tümörü baskılayan bir durum gibi düşünülebilir. Normal hücrelerde DNA onarımı genom bütünlüğünü korur. Ancak kanser hücrelerinde güçlü DNA onarımı, hücrelerin yüksek replikasyon stresine ve DNA hasarına rağmen hayatta kalmasına yardım edebilir.
Bu nedenle aynı yol normal dokuda koruyucu, gelişmiş tümörde ise tedavi direncini veya hasar toleransını destekleyici rol oynayabilir. Çalışma bu genlerin işlevlerini deneysel olarak değiştirmediği için bu mekanizma doğrudan kanıtlanmamıştır.
Hücre döngüsü ve kromozom ayrılması
| Gen | Çalışmada ilişkilendirilen süreç |
|---|---|
| CLSPN | Replikasyon kontrol noktası ve S fazı yanıtı |
| BUB1 | Mitotik iğ kontrol noktası ve kromozom ayrılması |
| CENPI | Kinetokor yapısı ve kromozomların mitoz sırasında doğru ayrılması |
| PLK4 | Sentrozom çoğalması ve hücre bölünmesi düzenlenmesi |
Hücre döngüsü kontrol noktaları, hasarlı veya hatalı DNA’ya sahip hücrenin bölünmesini durdurmayı amaçlar. Bu sistemlerdeki bozulma, kromozomların yanlış sayıda veya hatalı biçimde yavru hücrelere dağılmasına yol açabilir.
Kromozomal kararsızlık, tümör içi heterojenliği artırabilir. Aynı tümör içinde farklı genetik özelliklere sahip alt hücre grupları oluştuğunda hastalık ilerlemesi, metastaz ve tedavi direnci karmaşıklaşabilir.
Hücre dışı matriks ve kollajen genleri
| Gen | Ekspresyon yönü | Çalışmadaki biyolojik yorum |
|---|---|---|
| COL24A1 | Yukarı | İnvaziv fenotip ve matriks yeniden yapılanmasıyla ilişkilendirilmiş kollajen |
| COL9A1 | Yukarı | Fokal adezyon ve hücre göçüyle ilişkili olabilecek matriks bileşeni |
| COL25A1 | Aşağı | HCC’de yeterince karakterize edilmemiş kollajen geni |
| STRA6 | Yukarı | Retinol taşınması, hepatik lipogenez ve fibrotik mikroçevreyle bağlantı |
Hücre dışı matriks, tümör hücrelerini çevreleyen kollajen, glikoprotein ve diğer yapısal moleküllerin oluşturduğu ağdır. Bu ağ yalnızca fiziksel destek sağlamaz; hücre hareketi, büyüme sinyalleri, damar oluşumu ve bağışıklık hücresi erişimi üzerinde de etkili olabilir.
Sirotik karaciğerde zaten yoğun fibrozis ve matriks değişikliği bulunmaktadır. HCC hücreleri bu ortamın mekanik ve biyokimyasal özelliklerinden yararlanarak invazyon ve yayılım kapasitesini artırabilir.
Hücre hareketi, sitoskeleton ve epitelyal-mezenkimal geçiş
| Gen | Çalışmada ilişkilendirilen süreç |
|---|---|
| ECT2 | Sitokinez, Rho/ERK sinyali ve erken nüksle ilişkili hücresel davranışlar |
| IQGAP3 | Metastaz ve epitelyal-mezenkimal geçiş |
| DNAJC6 | Epitelyal-mezenkimal geçiş ve HCC ilerlemesi |
| ARHGAP11A | Rho ailesi GTPazları, hücre iskeleti ve malign ilerleme |
Epitelyal-mezenkimal geçiş, epitel özellikleri taşıyan tümör hücrelerinin hücreler arası bağlantılarını azaltarak daha hareketli ve invaziv özellikler kazanmasını anlatan biyolojik programdır. Bu süreç metastazla ilişkilendirilebilir; ancak tek bir genin yüksek ifadesi tek başına hastanın metastaz geliştireceğini göstermez.
Diğer genler ve bilgisi sınırlı adaylar
SNHG4 uzun kodlamayan RNA olarak ileri hastalık ve kötü sağkalımla ilişkilendirilmiştir. TMC7, KIAA1841, CREG2 ve PLK4 daha önce çeşitli prognostik imzalarda yer almış olsa da bazı genlerin HCC’deki doğrudan işlevi yeterince karakterize edilmemiştir.
BAIAP2L2 de son imzada yer almakla birlikte çalışmada HCC’ye özgü işlevsel rolü ayrıntılı deneylerle gösterilmemiştir.
Aşağı düzenlenen genlerden CCL23’ün kaybı, çalışmanın literatür yorumuna göre CCR1/AKT/ESR1 sinyalinin tümör baskılayıcı etkisini azaltabilir. RANBP3L ve DIRAS2 ise olası tümör baskılayıcı adaylar olarak değerlendirilmiştir; ancak karaciğer kanserindeki işlevleri doğrudan doğrulanmamıştır.
24 genlik panel gerçekten prognostik midir?
Çalışma, her gen için yüksek ve düşük ifade grupları arasında genel sağkalım farkı bulunduğunu bildirmektedir. Bu, genlerin prognostik aday olduğunu gösterir. Ancak klinik prognostik belirteç olarak kabul edilmeleri için daha fazla kanıt gerekir.
Çalışmada şu analizler sunulmamıştır:
- Tümör evresine göre düzeltilmiş Cox regresyonu,
- Karaciğer fonksiyon sınıfı veya siroz durumuna göre düzeltme,
- Viral hepatit durumuna göre alt grup analizi,
- Damar invazyonu, tümör sayısı veya boyutuna göre düzeltme,
- Tedavi türünün modele eklenmesi,
- 24 geni tek bir risk skorunda birleştiren açık matematiksel formül,
- Risk skoruna göre düşük ve yüksek risk gruplarının bağımsız doğrulanması,
- C-indeksi, zaman bağımlı ROC veya kalibrasyon analizi.
Dolayısıyla “24 genlik prognostik imza” ifadesi, bu aşamada her genin sağkalımla tek tek ilişkili bulunmasına dayanmaktadır. Klinik kullanım için tanımlanmış, ağırlıkları belirlenmiş ve dış kohortta doğrulanmış bir prognostik puan henüz sunulmamıştır.
Gündelik yaşam ve klinik uygulama açısından olası anlamı
Bu tür çalışmaların uzun vadeli amacı, karaciğer kanserinin moleküler çeşitliliğini ölçülebilir bir imzaya dönüştürmektir. Gelecekte doğrulanmış bir gen paneli şu alanlarda değerlendirilebilir:
- Şüpheli karaciğer dokusunun tümör olup olmadığının desteklenmesi,
- Agresif biyolojik özellik taşıyan tümörlerin ayrılması,
- Nüks veya ölüm riski yüksek hastaların izlem yoğunluğunun belirlenmesi,
- Belirli DNA onarım veya hücre döngüsü yollarına yönelik araştırmaların yönlendirilmesi,
- AFP ve görüntüleme gibi mevcut yöntemlere ek moleküler bilgi sağlanması.
Ancak bu olasılıkların hiçbiri mevcut çalışmada klinik olarak test edilmemiştir. Çalışma hasta yönetimini değiştiren bir prospektif uygulama deneyi değildir.
Çalışmanın güçlü yönleri
- Bir TCGA ve üç GEO veri setindeki ortak diferansiyel genlere odaklanılmıştır.
- Tek veri setine özgü adayları azaltmak için dört veri kaynağının kesişimi kullanılmıştır.
- İstatistiksel diferansiyel ifade, makine öğrenmesi ve sağkalım analizi aynı akışta birleştirilmiştir.
- Boruta yöntemiyle rastgele gölge özelliklere karşı değişken önemi değerlendirilmiştir.
- 79 genlik geniş küme, sağkalım ilişkisi üzerinden 24 gene daraltılmıştır.
- Son genlerin tümör ve normal dokudaki ifade yönleri ayrı ayrı gösterilmiştir.
- Genler DNA onarımı, hücre döngüsü ve matriks biyolojisi gibi anlamlı işlevsel gruplarda yorumlanmıştır.
- Kullanılan veri kaynakları halka açıktır.
- Çalışma kendi metninde aşırı uyum ve dış doğrulama gereksinimini kabul etmektedir.
Çalışmanın sınırlılıkları
- Hakem değerlendirmesi yoktur: Çalışma preprinttir.
- Retrospektif tasarım: Halka açık veri tabanlarında daha önce toplanmış örneklere dayanmaktadır.
- Dış model doğrulaması yoktur: 24 genlik sınıflandırıcı bağımsız GEO kohortlarında test edilmemiştir.
- Küçük test seti: Test kümesinde yalnızca 10 normal ve 75 tümör örneği bulunmaktadır.
- Sınıf dengesizliği: TCGA kohortunda normal doku sayısı tümör sayısından çok daha azdır.
- Kusursuz performans: %100 test başarısı aşırı uyum veya veri sızıntısı olasılığını gündeme getirmektedir.
- Analiz sırası belirsizliği: Özellik seçimi ve sağkalım filtresinin eğitim seti içinde mi, bütün veri üzerinde mi yürütüldüğü yeterince açıklanmamıştır.
- Tek veri bölmesi: Tekrarlı çapraz doğrulama veya bağımsız doğrulama raporlanmamıştır.
- Hiperparametre ayrıntıları sınırlıdır: Rastgele orman modelinin tam ayarları verilmemiştir.
- Normal doku karşılaştırması: Siroz, hepatit, displastik nodül ve benign tümörlerden ayırt etme performansı test edilmemiştir.
- Doku temelli veri: Çalışma bir kan veya sıvı biyopsi testi geliştirmemiştir.
- Sağkalım analizleri tek değişkenlidir: Evre ve diğer klinik faktörlere göre düzeltilmiş sonuçlar yoktur.
- Çoklu test düzeltmesi belirtilmemiştir: 79 sağkalım testi için yalnızca P<0,05 eşiği kullanılmıştır.
- Risk skoru formülü yoktur: 24 geni birleştiren ağırlıklı prognostik puan sunulmamıştır.
- AFP karşılaştırması yoktur: Panel AFP’den üstün veya AFP’ye ek yararlı olarak test edilmemiştir.
- Klinik heterojenlik sınırlı ele alınmıştır: Hepatit durumu, siroz nedeni, tümör evresi ve moleküler alt tipler değerlendirilmemiştir.
- Deneysel doğrulama yoktur: Genlerin işlevleri hücre, organoid veya hayvan modellerinde test edilmemiştir.
- Bazı genler yetersiz karakterize edilmiştir: COL25A1, TMC7, KIAA1841 ve BAIAP2L2 gibi adayların HCC’deki rolü belirsizdir.
Çalışma ne söylüyor?
- Dört veri setinde ortak biçimde farklı ifade edilen 251 gen bulunmuştur.
- Boruta analizi bu genlerin 79’unu önemli özellik olarak seçmiştir.
- TCGA-LIHC içindeki rastgele orman modeli 79 genle çok yüksek iç test performansı göstermiştir.
- Yetmiş dokuz genin 24’ü tek değişkenli sağkalım analizinde P<0,05 ile genel sağkalımla ilişkili bulunmuştur.
- Son imzada 20 yukarı ve dört aşağı düzenlenen gen bulunmaktadır.
- 24 genlik model TCGA iç test setindeki tüm örnekleri doğru sınıflandırmıştır.
- Genler DNA onarımı, hücre döngüsü, kromozomal kararsızlık, matriks yeniden yapılanması ve hücresel sinyal süreçlerinde kümelenmektedir.
- İmza, bağımsız doğrulama gerektiren bir tanısal ve prognostik adaydır.
Çalışma ne söylemiyor?
- Panelin klinik kullanıma hazır olduğunu göstermemektedir.
- Panelin kan örneğinden ölçülebildiğini göstermemektedir.
- Erken evre HCC’yi siroz veya benign karaciğer hastalığından ayırdığını kanıtlamamaktadır.
- %100 performansın yeni hastalarda tekrarlanacağını kanıtlamamaktadır.
- 24 genin HCC’ye neden olduğunu göstermemektedir.
- Genlerin tümör evresinden bağımsız prognostik değer taşıdığını kanıtlamamaktadır.
- Panelin AFP’den üstün olduğunu veya AFP’nin yerini alabileceğini göstermemektedir.
- Herhangi bir genin doğrulanmış tedavi hedefi olduğunu göstermemektedir.
- Bu genlere yönelik tedavilerin hasta sağkalımını artırdığını test etmemektedir.
- Klinik karar, tedavi seçimi veya güvenlik garantisi sağlamamaktadır.
Çalışmanın Yöntemi ve Bulguları
Teknik yöntem özeti
| Aşama | Veri/Yöntem | Uygulanan ölçüt | Çıktı |
|---|---|---|---|
| TCGA veri işleme | TCGAbiolinks | Korelasyon 0,6; GC içeriği normalizasyonu; kuantil filtresi 0,25 | İşlenmiş TCGA-LIHC ifade matrisi |
| TCGA diferansiyel ifade | TCGAanalyze DEA | FDR<0,01 ve |logFC|>1,5 | 4.412 diferansiyel gen |
| GEO diferansiyel ifade | DESeq2 | Toplam sayım ≥100; düzeltilmiş P<0,05 | Üç GEO veri setine ait diferansiyel gen listeleri |
| Ortak gen analizi | Venny | Dört veri setinin kesişimi | 251 ortak gen |
| Özellik seçimi | Boruta ve rastgele orman | Gölge değişkenlere göre önem karşılaştırması | 79 doğrulanmış, 13 kararsız, 159 reddedilmiş gen |
| İlk sınıflandırıcı | 79 genlik rastgele orman | %80 eğitim, %20 test | Test doğruluğu %98,8 |
| Sağkalım filtresi | GEPIA2, Kaplan-Meier ve log-rank | Medyan bölme; P<0,05 | 24 sağkalım ilişkili gen |
| Ekspresyon analizi | TCGA-LIHC tümör-normal karşılaştırması | Gen bazlı dağılımlar | 20 yukarı, 4 aşağı düzenlenen gen |
| Son sınıflandırıcı | 24 genlik rastgele orman | %80 eğitim, %20 test | Eğitim ve iç testte %100 performans |
| Biyolojik yorum | Literatür analizi | Genlerin yayımlanmış işlevleri | DNA onarımı, hücre döngüsü, matriks ve sinyal yolları |
24 genlik imzanın teknik özeti
| Gen | Tümörde ifade | Çalışmada öne çıkan işlev veya yorum |
|---|---|---|
| COL24A1 | Yüksek | Hücre dışı matriks ve invaziv fenotip |
| RAD51 | Yüksek | Homolog rekombinasyon ve DNA onarımı |
| CLSPN | Yüksek | Replikasyon kontrol noktası |
| ECT2 | Yüksek | Sitokinez ve Rho/ERK sinyali |
| IQGAP3 | Yüksek | Metastaz ve epitelyal-mezenkimal geçiş |
| ARHGAP11A | Yüksek | Sitoskeleton ve malign ilerleme |
| CCL23 | Düşük | Olası tümör baskılayıcı sinyalleme |
| SNHG4 | Yüksek | Uzun kodlamayan RNA; ileri hastalık ve sağkalım ilişkisi |
| PLK4 | Yüksek | Sentrozom ve hücre bölünmesi |
| DNAJC6 | Yüksek | Epitelyal-mezenkimal geçiş |
| BAIAP2L2 | Yüksek | HCC’de işlevsel rolü sınırlı tanımlanmış |
| PIF1 | Yüksek | DNA helikazı ve replikasyon çatalı kararlılığı |
| FANCD2 | Yüksek | Fanconi DNA onarım yolu |
| BUB1 | Yüksek | Mitotik kontrol noktası |
| TMC7 | Yüksek | HCC’de işlevsel rolü yeterince bilinmiyor |
| CENPI | Yüksek | Kinetokor ve kromozom ayrılması |
| COL9A1 | Yüksek | Matriks ve fokal adezyon |
| COL25A1 | Düşük | HCC’de yeterince karakterize edilmemiş kollajen |
| STRA6 | Yüksek | Retinol taşınması, lipogenez ve fibrozis |
| KIAA1841 | Yüksek | İşlevsel HCC kanıtı sınırlı |
| RANBP3L | Düşük | Olası tümör baskılayıcı aday |
| DIRAS2 | Düşük | Olası tümör baskılayıcı aday |
| CREG2 | Yüksek | Kanser biyolojisindeki rolü sınırlı tanımlanmış |
| FANCB | Yüksek | Fanconi anemisi DNA onarım kompleksi |
Ana bulguların düzenli özeti
| Bulgular | Sonuç | Doğru yorum |
|---|---|---|
| Toplam veri kaynağı | TCGA-LIHC ve üç GEO kohortu | Farklı veri kaynaklarından gen listeleri karşılaştırılmıştır. |
| Toplam örnek | 738 | Bütün örnekler aynı sınıflandırıcıda kullanılmamıştır. |
| Ortak diferansiyel gen | 251 | Dört veri setinin ortak kesişimidir. |
| Boruta ile doğrulanan gen | 79 | TCGA’da tümör-normal sınıflandırmasına katkı veren adaylardır. |
| 79 genlik test doğruluğu | %98,8 | TCGA iç test setine aittir. |
| Sağkalımla ilişkili gen | 24 | Tek değişkenli log-rank P<0,05 sonucudur. |
| Yukarı düzenlenen gen | 20 | Tümör dokusunda normal dokuya göre daha yüksek ifade edilmiştir. |
| Aşağı düzenlenen gen | 4 | Tümör dokusunda daha düşük ifade edilmiştir. |
| 24 genlik test doğruluğu | %100 | Yalnızca 85 örnekli TCGA iç test kümesine aittir. |
| 24 genlik ROC-AUC | 1,00 | Dış doğrulama olmadan klinik genellenebilirliği göstermez. |
| Deneysel doğrulama | Yok | Genlerin nedensel işlevi hücre veya hayvan modelinde test edilmemiştir. |
| AFP karşılaştırması | Yok | Panelin mevcut biyobelirteçten üstünlüğü gösterilmemiştir. |
| Bağımsız dış doğrulama | Yok | Klinik kullanımdan önce zorunlu bir sonraki aşamadır. |
Kaynak ve Yöntem Notu
Bu içerik, Oluwafemi Ogundare tarafından hazırlanan “A 24-Gene Signature with Diagnostic and Prognostic Value in Hepatocellular Carcinoma: An Integrative RNA-seq and Machine Learning Analysis” başlıklı çalışmaya dayanmaktadır.
Çalışma SSRN üzerinde yayımlanmış bir preprinttir. Metinde açıkça “This preprint research paper has not been peer reviewed” ifadesi yer almaktadır. Dolayısıyla çalışma bağımsız hakem değerlendirmesinden geçmemiştir ve sonraki sürümlerde yöntem, sonuç veya yorumlar değişebilir.
Araştırma yeni hasta alımı yapılan klinik çalışma, in vitro deney, hayvan çalışması veya prospektif tanı testi değildir. TCGA-LIHC ve GEO veri tabanlarında bulunan geçmiş gen ifade verilerinin hesaplamalı analizidir. Kullanılan veriler halka açık olduğundan ayrı etik kurul onayı ve katılımcı onamının uygulanabilir olmadığı belirtilmiştir.
Çalışmanın tek yazarı Oluwafemi Ogundare’dir. Yazar, çalışma tasarımı, analiz, yorum ve makale hazırlığının tamamından sorumlu olduğunu bildirmiştir. Belirli bir finansman desteği bulunmadığı belirtilmiştir. Yazar, bu çalışmayla ilgisiz bir patente sahip olduğunu ve bunun araştırmayı etkilemediğini beyan etmiştir.
24 genlik modelin %100 iç test performansı, bağımsız klinik doğrulama olarak yorumlanmamalıdır. Test setinin küçük olması, normal-tümör dengesizliği, dış doğrulamanın bulunmaması ve analiz akışındaki olası veri sızıntısının yeterince açıklanmaması nedeniyle sonuçlar keşif niteliğindedir.
Panel doku RNA ifade verilerine dayanmaktadır; mevcut haliyle kan testi değildir. Erken tanı, klinik tarama, tedavi seçimi veya sağkalım tahmini amacıyla kullanılabilmesi için bağımsız kohortlarda, farklı hastalık evrelerinde, sirotik ve benign karaciğer dokularında, AFP ve klinik değişkenlerle karşılaştırılarak doğrulanması gerekir.
Bu içerik yalnızca yüklenen PDF’deki yöntem, şekil, tablo, gen listesi, sayısal sonuç, literatür yorumu ve sınırlılıklara dayanarak hazırlanmıştır. Çalışmada bulunmayan klinik başarı, kesin tanı, tedavi hedefi, kan testi, sağkalım garantisi veya nedensel biyolojik mekanizma iddiası eklenmemiştir. :contentReference[oaicite:1]{index=1}
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir