

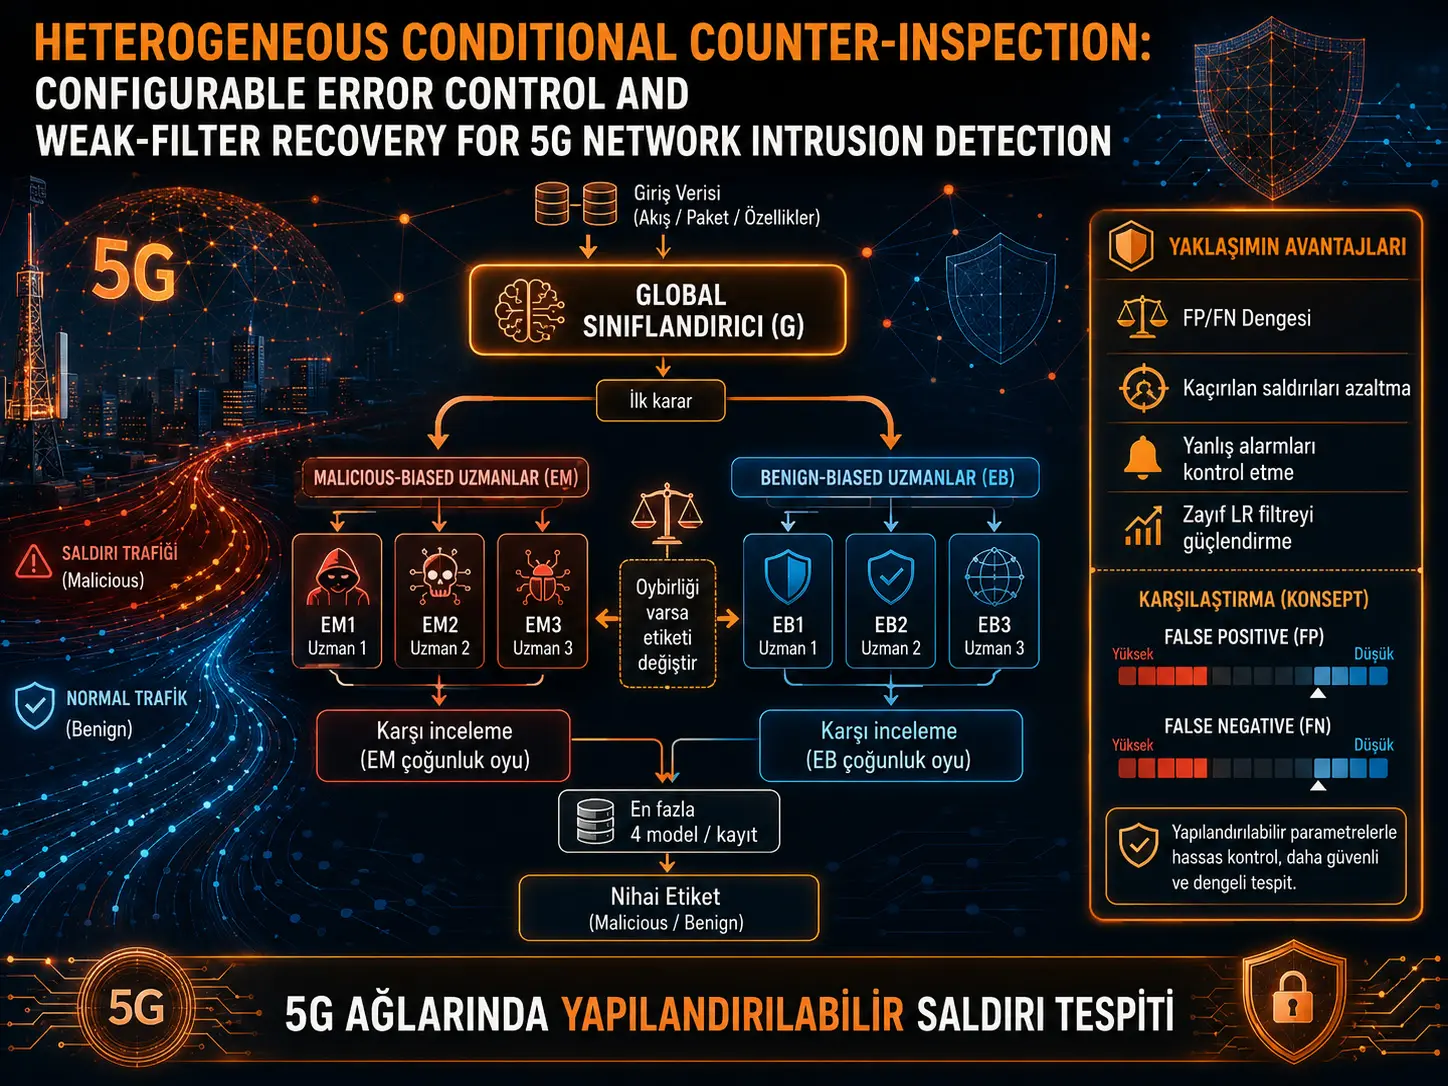
5G ağlarında kullanılan saldırı tespit sistemlerinin başarısını yalnız tek bir doğruluk veya F1 değeriyle değerlendirmek önemli bir sorunu gizleyebilir: kaç saldırının gözden kaçtığı ile kaç normal ağ akışının yanlış alarm ürettiği aynı şey değildir. Bu araştırma, birinci aşamadaki sınıflandırıcının kararını yalnız gerektiğinde uzman modellerle yeniden kontrol eden “conditional counter-inspection” mimarisini heterojen hâle getirerek bu iki hata türü arasındaki dengeyi yapılandırmayı inceliyor.
Sistem bir global sınıflandırıcı (G), üç malicious-biased uzmandan oluşan EM kolu ve üç benign-biased uzmandan oluşan EB kolu içeriyor. Global model bir ağ akışını önce benign veya malicious olarak sınıflandırıyor. Ardından yalnız global kararın karşı sınıfında uzmanlaşmış üç model devreye giriyor. İlk karar ancak bu üç uzmanın tamamı global sınıflandırıcıya karşı çıkarsa değiştiriliyor. Böylece sistem yedi model saklamasına rağmen tek bir kayıt için global modelle birlikte yalnız üç uzmanı çalıştırıyor; yani kayıt başına en fazla dört model değerlendiriliyor.
Araştırmacılar karar ağacı (DT), Random Forest (RF), Extremely Randomized Trees (ET) ve Histogram-based Gradient Boosting (HGB) algoritmalarını G, EM ve EB rollerine farklı kombinasyonlarla yerleştirdi. Logistic Regression (LR) ise özellikle zayıf bir global ilk aşama oluşturmak amacıyla ayrıca kullanıldı. Deneyler 5G-NIDD ve UNSW-NB15 veri kümelerinde gerçekleştirildi.
Çalışmanın temel bulgusu, gözden kaçan saldırıların azaltılmasının yalnız CART karar ağacına özgü olmadığıdır. İncelenen ağaç tabanlı dataset–konfigürasyon çiftlerinin tamamında false negative sayısı global sınıflandırıcıya göre azaldı. 5G-NIDD'de bu azalma konfigürasyona bağlı olarak %36,5 ile %79,6 arasında değişti. Bununla birlikte bazı konfigürasyonlarda false negative azalırken false positive sayısı yükseldi; dolayısıyla mimari her hata türünü aynı anda ve koşulsuz biçimde azaltmıyor.
Zayıf Logistic Regression global sınıflandırıcısı üzerinde sonuç daha çarpıcıdır. 5G-NIDD'de bağımsız LR 795 false positive ve 571 false negative üretirken LR–RF–RF kombinasyonu bunları sırasıyla 57 ve 24'e indirdi. UNSW-NB15'te LR–RF–DT konfigürasyonu F1 değerini 0,902575'ten 0,934041'e yükseltirken kaçırılan saldırı sayısını 19.629'dan 12.653'e düşürdü; ancak false positive sayısını 1.897'den 2.415'e çıkardı.
Türkiye açısından: Bu yaklaşım Türkiye'deki mobil operatörler, 5G/özel 5G altyapıları, MEC sistemleri, veri merkezleri ve güvenlik operasyon merkezleri açısından araştırmaya değer bir IDS mimarisi sunabilir. Özellikle yanlış alarm maliyeti ile kaçırılan saldırının güvenlik maliyetinin farklı olduğu ortamlarda aynı karar mimarisinin farklı uzman kombinasyonlarıyla yapılandırılabilmesi önemlidir. Ancak çalışma Türkiye'deki gerçek bir 5G operatör ağı üzerinde gerçekleştirilmemiştir. Yerel uygulama için gerçek trafik dağılımları, saldırı profilleri, özellik çıkarma maliyeti, UPF/NWDAF/MEC entegrasyonu, gecikme ve alarm yönetimi ayrıca ölçülmelidir.
Tek bir F1 değeri neden yeterli olmayabilir?
Bir saldırı tespit sisteminde malicious trafik pozitif sınıf olarak kabul edildiğinde iki kritik hata oluşabilir. False positive (FP), normal bir ağ akışının saldırı olarak işaretlenmesidir. False negative (FN) ise gerçek bir saldırının normal trafik olarak değerlendirilmesidir.
Bu iki hatanın operasyonel maliyeti eşit değildir. Çok fazla FP oluşursa güvenlik analistleri yanlış alarmlarla uğraşır ve alarm yorgunluğu oluşabilir. Buna karşılık FN'nin yüksek olması gerçek saldırıların tespit katmanını geçmesi anlamına gelir. Dolayısıyla iki IDS'nin F1 değerleri birbirine çok yakın olsa dahi güvenlik davranışları önemli ölçüde farklı olabilir.
Araştırmanın amacı yalnız daha yüksek F1 elde etmek değil, aynı karar mimarisi içinde hangi hata türünün daha agresif biçimde kontrol edileceğini uzman model yerleşimi üzerinden değiştirebilmektir.
Koşullu karşı-inceleme nasıl çalışıyor?
Çalışmanın 5. sayfasındaki Şekil 1, mimarinin karar mekanizmasını açık biçimde gösteriyor. Bir ağ akışı önce global sınıflandırıcıya gönderiliyor. Global model benign kararı verirse yalnız malicious-biased uzmanlar, malicious kararı verirse yalnız benign-biased uzmanlar çalıştırılıyor.
Verianla Live: Koşullu karşı-inceleme karar akışı
Aşağıdaki tablo çalışmanın Şekil 1'de tanımladığı karar mekanizmasını özetlemektedir. Sistem yedi model saklasa da bir akış üzerinde en fazla dört model çalışır.
| Aşama | Koşul | Çalıştırılan bileşen | Sonuç |
|---|---|---|---|
| 1. İlk sınıflandırma | Her ağ akışı | Global sınıflandırıcı G | Benign veya malicious ilk karar üretilir. |
| 2A. Karşı inceleme | G benign diyorsa | 3 malicious-biased uzman, EM | Üç uzmanın tamamı malicious derse karar malicious olarak değiştirilir. |
| 2B. Karşı inceleme | G malicious diyorsa | 3 benign-biased uzman, EB | Üç uzmanın tamamı benign derse karar benign olarak değiştirilir. |
| 3. Oybirliği sağlanmazsa | En az bir uzman global kararla aynı fikirdeyse | Ek model çalıştırılmaz | Global sınıflandırıcının ilk kararı korunur. |
Verianla Live: Süreç görünümü yukarıdaki görünür veri tablosundan oluşturulur. Tablo bilimsel kaynak-of-truth olarak korunur.
Neden “oybirliğiyle karşı çıkma” kullanılıyor?
Uzmanlardan yalnız birinin global karara karşı çıkması etiketi değiştirmek için yeterli değildir. Örneğin global model bir akışı benign olarak değerlendirdiyse malicious-biased üç uzmanın da malicious demesi gerekir.
Malicious-biased uzmanların oybirliği göstergesi çalışmada:
\[ u_M(x)=\prod_{\rho\in R}E_M^{(\rho)}(x) \]
ve benign-biased uzmanlar için:
\[ u_B(x)=\prod_{\rho\in R}\left[1-E_B^{(\rho)}(x)\right] \]
olarak tanımlanmıştır.
Nihai karar ise:
\[ \hat{y}(x)=[1-g(x)]u_M(x)+g(x)[1-u_B(x)] \]
şeklinde ifade edilir. Burada \(g(x)\) global sınıflandırıcının ilk kararını temsil eder. Bu formül, ilk benign kararın yalnız bütün EM uzmanları karşı çıkarsa malicious'a; ilk malicious kararın da yalnız bütün EB uzmanları karşı çıkarsa benign'e çevrilmesini tanımlar.
Uzmanlar neden aynı veride eğitilmiyor?
Her uzman kolunda üç model bulunur ve bunlar karşı sınıfa farklı oranlarda maruz bırakılır. Çalışmada kullanılan oranlar:
\[ R=\{0{,}10,\;0{,}20,\;0{,}30\} \]
şeklindedir.
Malicious-biased uzman her malicious eğitim örneğini görürken benign sınıfın yalnız belirli bir bölümünü görür. Benign-biased uzmanlarda bunun simetriği uygulanır. Böylece modeller aynı temel sınıflandırma problemini çözerken farklı hata bölgelerine duyarlı hâle getirilir.
Araştırmacılar bu eğitim yapısını değiştirmemiş; yalnız G, EM ve EB rollerinde kullanılan öğrenme algoritmalarını değiştirmiştir. Bu deney tasarımı, sonuç farklarının routing veya oybirliği kuralından değil, öğrenici yerleşiminden kaynaklanmasını incelemek için seçilmiştir.
G–EM–EB gösterimi ne anlama geliyor?
Her konfigürasyon üçlü biçimde yazılır:
G – EM – EB
- G: Global ilk aşama sınıflandırıcısı.
- EM: İlk karar benign olduğunda devreye giren malicious-biased uzman ailesi.
- EB: İlk karar malicious olduğunda devreye giren benign-biased uzman ailesi.
Örneğin DT–RF–HGB, global sınıflandırıcının Decision Tree, malicious-biased uzmanların Random Forest ve benign-biased uzmanların Histogram-based Gradient Boosting olduğu anlamına gelir.
İncelenen temel algoritmalar DT, RF, ET ve HGB'dir. Logistic Regression ise ağacın yerine genel alternatif olarak taranmamış, özellikle “zayıf global filtre” stres deneyi için kullanılmıştır.
Deney ailesi neden bütün 64 kombinasyonu taramıyor?
Dört ağaç tabanlı algoritmanın üç role yerleştirilmesi teorik olarak \(4^3=64\) farklı kombinasyon oluşturabilir. Araştırmacılar bunların tümünü taramamıştır.
Bunun yerine dört kontrollü deney ailesi oluşturulmuştur:
| Deney ailesi | Konfigürasyon yaklaşımı | Araştırılan soru |
|---|---|---|
| Global model değişimi | X–DT–DT | İlk aşama modeli değiştiğinde kaçırılan saldırıların kurtarılması devam ediyor mu? |
| Uzman değişimi | DT–X–X | Uzman modeli FP/FN dengesini değiştirebiliyor mu? |
| Her iki tarafın değişimi | X–X–X veya X–Y–Z | Farklı operasyon profilleri oluşturulabiliyor mu? |
| Zayıf global filtre | LR–Y–Z | Uzman katmanı zayıf bir ilk sınıflandırıcıyı kurtarabiliyor mu? |
Dolayısıyla çalışma bütün olası konfigürasyonlar arasındaki mutlak optimumu bulduğunu iddia etmemektedir.
5G-NIDD ve UNSW-NB15 neden birlikte kullanıldı?
İki veri kümesi farklı zorluk rejimlerini temsil etmek için seçilmiştir. 5G-NIDD, gerçek işlevsel 5G test ağında oluşturulan benign ve saldırı trafiğini içerir ve kullanılan ağaç tabanlı modeller bu veri kümesinde zaten son derece yüksek performans göstermektedir.
5G-NIDD'de eğitim/test bölünmesi stratified %80/%20 olarak gerçekleştirilmiş; 972.712 kayıt eğitim ve 243.178 kayıt test için kullanılmıştır. Malicious oranı her iki bölümde de yaklaşık 0,607'dir.
UNSW-NB15'te veri kümesinin önceden tanımlanmış bölümleri korunmuştur: 82.332 eğitim ve 175.341 test kaydı. One-hot encoding sonrasında 190 özellik elde edilmiş; malicious oranı eğitimde 0,5506 ve testte 0,6806 olarak verilmiştir.
Bütün veri dönüşümleri yalnız eğitim bölümünde fit edilmiş ve test bölümüne değiştirilmeden uygulanmıştır. 5G-NIDD'deki Attack Type ve Attack Tool sütunları label leakage riskini önlemek amacıyla eğitimden çıkarılmıştır.
Kaçırılan saldırılar gerçekten azalıyor mu?
Araştırmanın en tutarlı sonucu false negative sayısındaki azalmadır. Global-only ve homogeneous tree-based substitution deneylerinde her iki veri kümesinde de incelenen bütün dataset–konfigürasyon çiftleri ilk aşamadaki global modele göre daha az FN üretmiştir.
5G-NIDD'de göreli FN azalmaları %36,5 ile %79,6 arasında değişmiştir. En yüksek oran HGB–HGB–HGB konfigürasyonunda görülmüş; HGB global modelinin 54 false negative değeri pipeline sonrasında 11'e düşmüştür.
UNSW-NB15'te etki daha küçüktür. FN azalmaları yaklaşık %0,9 ile %5,8 arasında değişmiş; HGB–HGB–HGB konfigürasyonunda 16.657 FN değeri 15.697'ye düşmüştür.
Bu sonuç çalışma kapsamında counter-inspection'ın saldırı kurtarma etkisinin yalnız Decision Tree davranışından kaynaklanmadığını desteklemektedir. Ancak sonuç, mimarinin tüm olası veri kümelerinde veya bütün model ailelerinde aynı davranışı göstereceğini kanıtlamaz.
Daha az FN her zaman daha iyi F1 anlamına geliyor mu?
Hayır. HGB–HGB–HGB bunun belirgin örneğidir. 5G-NIDD'de HGB global modeli yalnız üç false positive üretirken pipeline sonunda FP sayısı 109'a çıkmıştır. Aynı anda FN 54'ten 11'e düşmüştür.
Böylece sistem çok daha fazla saldırıyı yakalamış fakat daha fazla benign trafiği saldırı olarak işaretlemiştir. F1 değeri 0,999807'den 0,999594'e hafifçe gerilemiştir.
Bu sonuç araştırmanın temel savını destekler: uzman katmanı yalnız “performans yükselticisi” değildir; hata profilinin yönünü değiştirebilir.
Uzman modelinin değiştirilmesi FP/FN dengesini nasıl etkiliyor?
Global model DT olarak sabit tutulduğunda 5G-NIDD'de RF uzmanları en dengeli profillerden birini oluşturmuştur. Standalone DT'deki 48 FP ve 51 FN, DT–RF–RF ile 28 FP ve 26 FN'ye gerilemiştir. Bu, FP'de %41,7 ve FN'de %49,0 azalma anlamına gelir.
HGB uzmanları daha agresif bir güvenlik profili oluşturmuştur: FN 51'den 14'e inerken FP 48'den 64'e çıkmıştır. Böylece missed-attack recovery güçlenmiş ancak yanlış alarm maliyeti yükselmiştir.
UNSW-NB15'te aynı algoritmaların hata profilleri farklı davranmıştır. HGB uzmanları bu kez FP'yi %25,0 ve FN'yi %5,2 azaltmıştır. Bu durum, belirli bir uzman algoritmasının her veri kümesinde sabit bir FP/FN davranışı göstermediğini ortaya koymaktadır.
Tek bir “en iyi konfigürasyon” var mı?
Çalışmanın yaklaşımı buna özellikle karşı çıkıyor. Farklı konfigürasyonlar farklı operasyonel hedeflere hizmet ediyor.
| Veri kümesi | Profil | Konfigürasyon | FP | FN | F1 |
|---|---|---|---|---|---|
| 5G-NIDD | Homogeneous referans | DT–DT–DT | 30 | 27 | 0,999807 |
| 5G-NIDD | En yüksek değerlendirilen F1 | DT–RF–HGB | 13 | 30 | 0,999854 |
| 5G-NIDD | DT uyumlu saldırı kurtarma | DT–HGB–RF | 79 | 10 | 0,999699 |
| UNSW-NB15 | Homogeneous referans | DT–DT–DT | 1515 | 16.688 | 0,918558 |
| UNSW-NB15 | En yüksek ağaç tabanlı F1 | HGB–RF–RF | 2356 | 13.893 | 0,928464 |
Örneğin UNSW-NB15'te HGB–RF–RF F1'i yükseltip FN'yi azaltırken FP sayısını 1.515'ten 2.356'ya çıkarmıştır. Bu konfigürasyon yüksek saldırı yakalama önceliği olan bir ortam için anlamlı olabilir; ancak alarm hacminin kritik olduğu başka bir operasyon için aynı tercih uygun olmayabilir.
Zayıf bir ilk aşama gerçekten kurtarılabiliyor mu?
Araştırmanın önemli deneylerinden biri Logistic Regression modelini kasıtlı olarak zayıf global sınıflandırıcı olarak kullanmıştır.
5G-NIDD'de standalone LR:
- 795 false positive,
- 571 false negative,
- 0,994410 F1
üretmiştir.
LR–RF–RF kullanıldığında:
- FP 57'ye,
- FN 24'e,
- F1 0,999726'ya
ulaşmıştır.
Verianla Live: Zayıf LR filtresinin 5G-NIDD üzerindeki kurtarılması
Ham hata sayıları aynı test kümesinde standalone Logistic Regression ile LR–RF–RF pipeline'ı arasındaki karşılaştırmadır.
| Hata türü | LR standalone | LR–RF–RF | Göreli değişim |
|---|---|---|---|
| False Positive | 795 | 57 | −%92,8 |
| False Negative | 571 | 24 | −%95,8 |
Verianla Live: Sayılar çalışmanın aynı veri kümesi ve aynı test bölümü için verdiği ham FP/FN sonuçlarıdır.
UNSW-NB15'te ise LR–RF–DT konfigürasyonu özellikle recall yönelimli sonuç üretmiştir. F1 0,902575'ten 0,934041'e yükselmiş; FN 19.629'dan 12.653'e gerilemiştir. Buna karşılık FP 1.897'den 2.415'e yükselmiştir.
Bu nedenle çalışma, zayıf bir ilk filtrenin her hata türünde koşulsuz olarak iyileştirileceğini değil, uzman katmanıyla önemli ölçüde yeniden şekillendirilebileceğini göstermektedir.
Pipeline gerçekten “hafif” mi?
Mimari yedi ayrı model içerir: bir global model, üç EM uzmanı ve üç EB uzmanı. Fakat yönlendirme nedeniyle aynı akış üzerinde yalnız bir uzman kolu çalışır. Böylece:
1 global model + 3 uzman = en fazla 4 model değerlendirmesi
yapılır.
Çalışmanın tek iş parçacıklı ölçümlerinde tam pipeline sınıflandırıcı gecikmesi bütün test edilen backbone'larda kayıt başına 0,1 ms'nin altında kalmıştır.
| Veri kümesi | Backbone | Pipeline gecikmesi (ms/kayıt) | Throughput (kayıt/s) | 7 model boyutu (MB) |
|---|---|---|---|---|
| 5G-NIDD | DT | 0,0024 | 425.393 | 0,20 |
| 5G-NIDD | RF | 0,0340 | 29.377 | 50,14 |
| 5G-NIDD | ET | 0,0554 | 18.062 | 435,63 |
| 5G-NIDD | HGB | 0,0395 | 25.311 | 2,83 |
| UNSW-NB15 | DT | 0,0057 | 174.853 | 1,19 |
| UNSW-NB15 | RF | 0,0733 | 13.635 | 383,01 |
| UNSW-NB15 | ET | 0,0978 | 10.228 | 1102,31 |
| UNSW-NB15 | HGB | 0,0497 | 20.127 | 2,77 |
Bu tablo önemli bir ayrımı ortaya çıkarır. Yönlendirme açısından pipeline düşük ve sınırlandırılmış çıkarım maliyetine sahiptir; fakat bütün model aileleri düşük bellek tüketimine sahip değildir. Özellikle ET ve RF modelleri yüzlerce megabayt hatta yaklaşık 1,1 GB toplam model alanına ulaşabilir.
Dolayısıyla “lightweight” ifadesi burada bütün konfigürasyonların küçük olduğu anlamına gelmemelidir. DT ve HGB modelleri bellek açısından çok daha kompakt görünürken RF ve ET'nin belirli hata profilleri daha yüksek bellek maliyetiyle elde edilmektedir.
0,1 ms sonucu gerçek 5G gecikmesi mi?
Hayır. Bu araştırmanın yanlış yorumlanmaması gereken en önemli noktalarından biri budur.
Ölçülen süreler yalnız sınıflandırıcı inference süresidir. Test verileri önceden hazırlanmıştır ve tahminler çevrimdışı batch koşullarında tek iş parçacığı kullanılarak ölçülmüştür.
Gerçek bir 5G IDS sisteminde bunlara ek olarak:
- ağ paketlerinin veya akışlarının yakalanması,
- flow feature çıkarılması,
- verinin modele taşınması,
- ön işleme,
- alert oluşturma,
- SIEM/SOC entegrasyonu,
- network function içindeki diğer işlem maliyetleri
bulunacaktır.
Bu nedenle “EPoLBFT...” değil, bu çalışmadaki conditional counter-inspection IDS için verilen 0,1 ms altı değerler gerçek uçtan uca 5G saldırı tespit gecikmesi olarak yorumlanamaz.
MEC, UPF ve NWDAF açısından uygulanabilirlik nasıl değerlendiriliyor?
Araştırmacılar mimarinin 5G network edge, Multi-access Edge Computing (MEC), User Plane Function (UPF) yakınındaki monitoring noktaları veya Network Data Analytics Function (NWDAF) çevresindeki sistemlerde kullanılabileceğini tartışmaktadır.
Heterojen mimarinin önemli bir özelliği, farklı uzman modeller eklenmesine rağmen yeni ağ tarafı ölçümü istememesidir. Global model ve bütün uzmanlar aynı flow-level feature vector üzerinde çalışmaktadır.
Dolayısıyla mevcut homogeneous CART sisteminin ihtiyaç duyduğu özellikler belirli bir network monitoring noktasında zaten üretilebiliyorsa heterojen sürüm aynı özellikleri kullanabilir. Ancak araştırmada gerçek MEC/UPF/NWDAF entegrasyonu gerçekleştirilmemiştir.
Çalışmanın desteklediği sonuçlar
- Conditional counter-inspection mimarisinde G, EM ve EB rollerinin farklı öğrenme algoritmalarıyla doldurulabileceği gösterilmiştir.
- İncelenen ağaç tabanlı konfigürasyonların tamamı iki veri kümesinde de kendi standalone global sınıflandırıcısına göre belirli miktarda FN azaltmıştır.
- Uzman backbone seçiminin false positive ve false negative dengesi üzerinde yönlü etki oluşturabildiği gösterilmiştir.
- Farklı G–EM–EB kombinasyonları farklı güvenlik operasyon profilleri üretmiştir.
- Zayıf Logistic Regression ilk aşamasının ağaç tabanlı uzmanlarla önemli ölçüde iyileştirilebildiği gösterilmiştir.
- Conditional routing nedeniyle kayıt başına en fazla dört model değerlendirilmiştir.
- Çalışmada ölçülen classifier-only inference süreleri test edilen bütün backbone'larda kayıt başına 0,1 ms'nin altında kalmıştır.
Çalışmanın desteklemediği veya henüz test etmediği sonuçlar
- Mimarinin gerçek üretim 5G ağında aynı gecikmeyle çalıştığı gösterilmemiştir.
- 0,1 ms altı ölçüm uçtan uca packet capture–feature extraction–alert latency değildir.
- Bütün 64 ağaç tabanlı G–EM–EB kombinasyonu taranmamıştır.
- Çalışmada seçilen operasyon profilleri bağımsız validation seti üzerinden deployment optimumu olarak belirlenmemiştir.
- Model yalnız benign–malicious ikili sınıflandırma kapsamında değerlendirilmiştir; saldırı ailesi sınıflandırması test edilmemiştir.
- 5G-NIDD üzerinde elde edilen near-ceiling sonuçların farklı gerçek ağ trafiğine aynı biçimde genellenebileceği gösterilmemiştir.
- Random Forest ve Extra Trees kullanan bütün konfigürasyonların düşük bellekli edge cihazlara uygun olduğu gösterilmemiştir.
- Türkiye'deki gerçek 5G veya özel 5G ağları üzerinde doğrulama yapılmamıştır.
Çalışmanın Yöntemi ve Bulguları
Veri ve ön işleme
| Özellik | 5G-NIDD | UNSW-NB15 |
|---|---|---|
| Görev | Benign / malicious ikili sınıflandırma | Benign / malicious ikili sınıflandırma |
| Eğitim kaydı | 972.712 | 82.332 |
| Test kaydı | 243.178 | 175.341 |
| Split | Stratified %80 / %20 | Veri kümesinin önceden tanımlanmış partition'ları |
| Malicious prevalence | 0,607 eğitim ve test | 0,5506 eğitim; 0,6806 test |
| Kategorik özellikler | One-hot encoding | One-hot encoding |
| Özel leakage önlemi | Attack Type ve Attack Tool çıkarıldı | Kaynakta buna karşılık gelen ek sütun çıkarımı belirtilmiyor |
Kullanılan modeller ve yazılım ortamı
| Bileşen | Ayar |
|---|---|
| Decision Tree | DecisionTreeClassifier, random_state=42 |
| Random Forest | 200 ağaç, random_state=42 |
| Extra Trees | 200 ağaç, random_state=42 |
| HGB | HistGradientBoostingClassifier, random_state=42 |
| Logistic Regression | Median imputation → StandardScaler → LogisticRegression; max_iter=3000, solver=lbfgs |
| Curriculum oranları | 0,10; 0,20; 0,30 |
| Uzman sayısı | 3 EM + 3 EB |
| Random seed | 42 |
| Python | 3.12.13 |
| scikit-learn | 1.6.1 |
| NumPy | 2.0.2 |
| pandas | 2.2.2 |
| SciPy | 1.16.3 |
Araştırmacılar her konfigürasyon için ayrı hyperparameter optimizasyonu yapmamıştır. Sabit algoritma ayarlarının amacı, performans farkının unequal tuning yerine modelin hangi role yerleştirildiğini yansıtmasını sağlamaktır.
Değerlendirme ölçütleri
Malicious sınıf pozitif kabul edilerek accuracy, precision, recall ve F1 aşağıdaki standart biçimde hesaplanmıştır:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1=\frac{2\cdot Precision\cdot Recall}{Precision+Recall} \]
Araştırma özellikle FP ve FN'nin ham sayılarını da korumuştur. Bu yaklaşım önemlidir; çünkü çok yüksek F1 değerleri altında birkaç düzine hata arasındaki operasyonel fark normalize edilmiş skorlarda neredeyse görünmez olabilir.
5G-NIDD: uzman backbone karşılaştırması
| DT global + uzman backbone | FP değişimi | FN değişimi | F1 | Kaynakta tanımlanan profil |
|---|---|---|---|---|
| DT | −%37,5 | −%47,1 | 0,999807 | Homogeneous CART referansı |
| RF | −%41,7 | −%49,0 | 0,999817 | Dengeli hata azaltımı |
| ET | −%2,1 | −%37,3 | 0,999732 | Recall yönelimli düzeltme |
| HGB | +%33,3 | −%72,5 | 0,999736 | Agresif FN azaltımı |
UNSW-NB15: uzman backbone karşılaştırması
| DT global + uzman backbone | FP değişimi | FN değişimi | F1 | Kaynakta tanımlanan profil |
|---|---|---|---|---|
| DT | −%27,0 | −%1,3 | 0,918558 | Ağırlıklı olarak FP azaltımı |
| RF | +%1,2 | −%14,8 | 0,927151 | DT-global varyantlar içinde en yüksek F1 |
| ET | +%2,2 | −%6,2 | 0,920116 | Orta düzey FN azaltımı |
| HGB | −%25,0 | −%5,2 | 0,921549 | Birlikte azalma; FP ağırlıklı |
Zayıf LR filtresi sonuçları
| Veri kümesi | Konfigürasyon | FP | FN | F1 |
|---|---|---|---|---|
| 5G-NIDD | LR standalone | 795 | 571 | 0,994410 |
| 5G-NIDD | LR–DT–DT | 59 | 25 | 0,999716 |
| 5G-NIDD | LR–RF–RF | 57 | 24 | 0,999726 |
| 5G-NIDD | LR–HGB–HGB | 106 | 10 | 0,999607 |
| UNSW-NB15 | LR standalone | 1897 | 19.629 | 0,902575 |
| UNSW-NB15 | LR–DT–DT | 1530 | 16.761 | 0,918143 |
| UNSW-NB15 | LR–RF–DT | 2415 | 12.653 | 0,934041 |
UNSW-NB15'te LR–RF–DT, araştırmanın raporladığı konfigürasyonlar içinde en büyük mutlak F1 artışını sağlamıştır: +0,031466. Ancak aynı konfigürasyon standalone LR'ye göre FP'yi %27,3 artırmıştır. Bu nedenle sonuç “zayıf sınıflandırıcı her açıdan düzeldi” biçiminde değil, recall ve aggregate F1 lehine yeni bir hata profiline taşındı biçiminde yorumlanmalıdır.
Çıkarım maliyetinin ölçülmesi
Gecikme deneyleri 5G-NIDD'nin 243.178 ve UNSW-NB15'in 175.341 held-out test kaydı üzerinde yapılmıştır. Tahminler single-threaded çalıştırılmış, warm-up sonrasında beş zamanlama koşusunun en iyi sonucu kullanılmıştır.
Pipeline/global gecikme oranı yaklaşık 3,3× ile 5,8× arasında değişmiştir. Bu artış yedi modelin tamamının çalıştırılması anlamına gelmez; conditional routing nedeniyle yalnız global + aktif üç uzman değerlendirilir.
Çalışmadaki en düşük tam-pipeline değer 5G-NIDD DT için 0,0024 ms/kayıt, en yüksek değer ise UNSW-NB15 ET için 0,0978 ms/kayıttır.
Bu süreler yalnız classifier inference süresidir; feature extraction, data movement ve alert handling kapsam dışıdır.
Çalışmanın ana sınırlılıkları
- 64 olası ağaç tabanlı heterojen üçlünün tamamı taranmamıştır.
- Deployment-oriented profiller held-out test sonuçlarından tanımlanmıştır; bağımsız validation partition ile seçilmemiştir.
- Yalnız iki veri kümesi kullanılmış ve feature uzayları farklı olduğu için cross-dataset transfer yapılmamıştır.
- Gecikme ölçümleri offline, batch ve single-threaded classifier inference koşullarındadır.
- Canlı bir 5G network function içinde uçtan uca çalışma ölçülmemiştir.
- Problem binary benign/malicious sınıflandırmasıyla sınırlıdır.
- RF ve ET tabanlı uzman profilleri önemli bellek gereksinimi oluşturabilir.
Gelecek araştırma yönleri
Yazarlar gelecek çalışma olarak saldırı türlerini ayrı sınıflar hâlinde ele alan multi-class uzantıları, özel validation verisi üzerinde maliyet fonksiyonuyla profil seçimini, daha fazla IDS veri kümesinde doğrulamayı, heterojen kombinasyon uzayının daha sistematik araştırılmasını ve gerçek 5G edge/network-function ortamında runtime değerlendirmesini önermektedir.
Multi-class genişletme için tek multi-class global sınıflandırıcıya bağlı saldırı ailesi uzmanları, one-vs-rest correction uzmanları, benzer saldırıları kapsayan grup uzmanları veya önce benign/malicious ayrımı ardından saldırı türü sınıflandırması yapan hiyerarşik yapı seçenekleri tartışılmaktadır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Heterogeneous Conditional Counter-Inspection: Configurable Error Control and Weak-Filter Recovery for 5G Network Intrusion Detection
Yazarlar: Khaoula Tahori; Imade Fahd Eddine Fatani; Mohamed Moughit; Hicham Magri.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Eş birinci yazar/eş katkı: Kaynakta eş birinci yazarlık işareti belirtilmemektedir.
Sorumlu yazarlar: Imade Fahd Eddine Fatani ve Mohamed Moughit.
Kurumlar: Sciences and Techniques for the Engineer Laboratory (LASTI), National School of Applied Science, University Sultan Moulay Slimane, Khouribga, Fas; Artificial Intelligence, Modeling & Computational Engineering Laboratory (AIMCE), The National Higher School of Arts and Crafts (ENSAM), Hassan II University of Casablanca, Kazablanka, Fas; Center for Studies and Research in Engineering and Organization Management, Higher School of Multimedia, Computer Science & Networks–Supemir, Hassan II University of Casablanca, Kazablanka, Fas.
Dergi: Future Internet.
Yayınevi: MDPI, Basel, Switzerland.
Cilt / sayı / makale numarası: 18 / 7 / 381.
DOI: 10.3390/fi18070381
Alınma tarihi: 16 Haziran 2026.
Revizyon tarihi: 15 Temmuz 2026.
Kabul tarihi: 17 Temmuz 2026.
Yayın tarihi: 22 Temmuz 2026.
Kaynak türü: Hakemli araştırma makalesi; makine öğrenmesi tabanlı ağ saldırı tespit mimarisi ve karşılaştırmalı veri kümesi değerlendirmesi.
Hakemlik durumu: Hakemli bilimsel yayın.
Lisans: Creative Commons Attribution (CC BY).
Resmî yayın bağlantısı:https://doi.org/10.3390/fi18070381
Veri kaynakları: Deneyler kamuya açık 5G-NIDD ve UNSW-NB15 veri kümeleriyle gerçekleştirilmiştir. 5G-NIDD'nin IEEE Dataport üzerinden, UNSW-NB15'in ise özgün dağıtıcılarından erişilebilir olduğu kaynakta belirtilmektedir.
Kod erişilebilirliği: Eğitimli modellerin, türetilmiş sonuç tablolarının ve tam implementasyonun sorumlu yazardan makul talep üzerine sağlanabileceği bildirilmektedir. Kaynak, açık ve doğrudan indirilebilir bir kod deposu vermemektedir.
Finansman: Araştırma dış finansman almamıştır.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma, veri kürasyonu, yöntem, yazılım, proje yönetimi ve ilk taslak Khaoula Tahori; biçimsel analiz Khaoula Tahori, Imade Fahd Eddine Fatani, Mohamed Moughit ve Hicham Magri; danışmanlık Imade Fahd Eddine Fatani ve Mohamed Moughit; inceleme ve düzenleme Khaoula Tahori, Imade Fahd Eddine Fatani ve Mohamed Moughit tarafından gerçekleştirilmiştir. Kaynakta bütün yazarların yayımlanan sürümü okuyup onayladığı belirtilmektedir.
Önceki çalışma ilişkisi: Araştırma, aynı grubun daha önce yayımladığı homogeneous CART tabanlı conditional counter-inspection mimarisini genişletmektedir. Yeni çalışmanın katkısı aynı pipeline'ı yalnız yeniden ayarlamak değil; G, EM ve EB rollerini birbirinden ayırarak farklı öğrenme algoritmalarının farklı operasyon profilleri oluşturup oluşturmadığını test etmektir.
Konfigürasyon seçimi sınırı: Heterojen çalışma uzayı eksiksiz brute-force biçimde taranmamıştır. Özellikle deployment-oriented profiller ayrı bir validation partition üzerinden seçilen kesin deployment optimumları değildir; held-out test sonuçlarında gözlenen açıklayıcı profillerdir.
Performans ölçümü sınırı: 0,1 ms altındaki süreler gerçek ağın uçtan uca IDS gecikmesi değil, çevrimdışı single-threaded classifier inference ölçümleridir. Feature extraction, packet/flow acquisition, data movement ve alert handling dahil değildir.
“Lightweight” terimi hakkında not: Çalışma lightweight niteliğini primarily conditional routing'in kayıt başına en fazla dört model değerlendirmesiyle sınırlandırılmış hesaplama yapısına bağlamaktadır. Random Forest ve Especially Extra Trees konfigürasyonlarında toplam model ayak izi yüzlerce megabayta veya yaklaşık 1,1 GB'a ulaşabildiği için bütün backbone'ların düşük bellekli olduğu sonucu çıkarılmamalıdır.
Bilimsel kapsam sınırı: Sonuçlar 5G-NIDD ve UNSW-NB15 üzerinde binary benign/malicious sınıflandırmasına aittir. Multi-class attack identification, gerçek network-function entegrasyonu, canlı MEC/UPF/NWDAF dağıtımı ve Türkiye'deki 5G trafik ortamları bu araştırmada test edilmemiştir.
Verianla Live notu: Süreç görselleştirmesi çalışmanın Şekil 1'deki conditional routing ve unanimous dissent mekanizmasına dayanır. LR–RF–RF karşılaştırmasında yalnız aynı 5G-NIDD test kümesinden raporlanan standalone LR ve pipeline ham FP/FN değerleri kullanılmıştır. Farklı veri kümelerinin ham hata sayıları aynı grafikte karşılaştırılmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir