

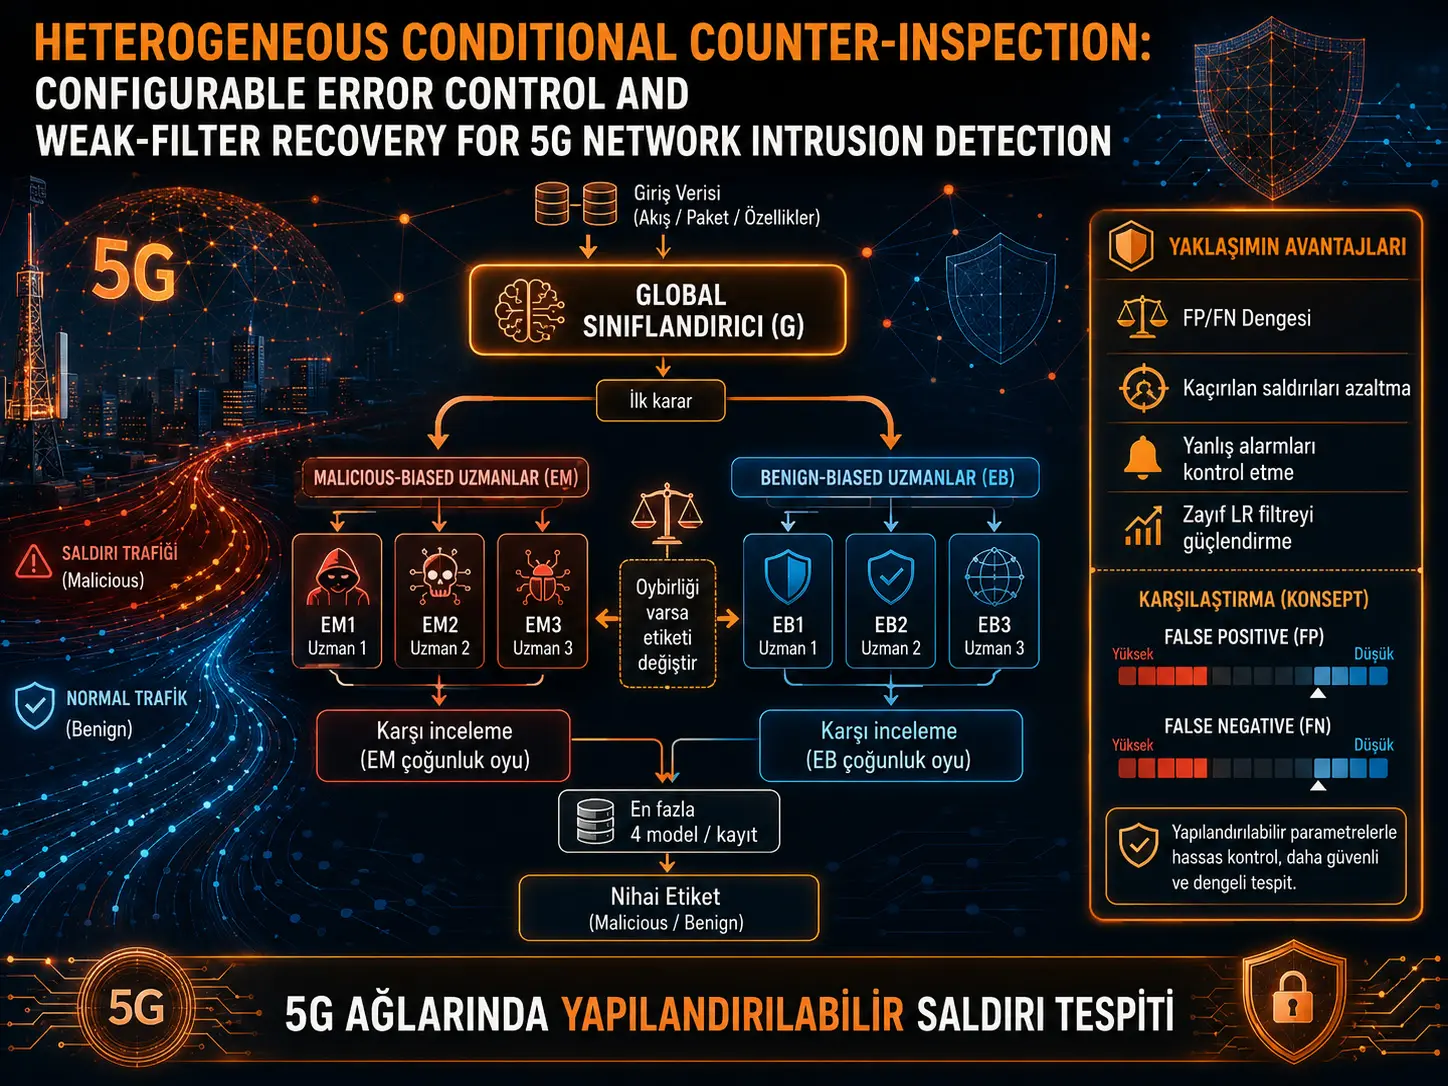
Kutathmini mafanikio ya mifumo ya kugundua uvamizi inayotumiwa katika mitandao ya 5G kwa thamani moja tu ya usahihi au F1 kunaweza kuficha tatizo muhimu: idadi ya mashambulizi yanayokosekana na idadi ya mitiririko ya kawaida ya mtandao inayozalisha tahadhari za uongo si jambo lilelile. Utafiti huu unachunguza jinsi ya kusanidi uwiano kati ya aina hizi mbili za makosa kwa kufanya usanifu wa “conditional counter-inspection”, ambao hukagua upya uamuzi wa classifier wa hatua ya kwanza kwa kutumia modeli za wataalamu pale tu inapohitajika, kuwa wa aina tofauti.
Mfumo una global classifier (G), tawi la EM lenye wataalamu watatu wa malicious-biased, na tawi la EB lenye wataalamu watatu wa benign-biased. Modeli ya global kwanza huainisha mtiririko wa mtandao kama benign au malicious. Kisha modeli tatu tu zilizobobea katika darasa lililo kinyume na uamuzi wa global huanzishwa. Uamuzi wa awali hubadilishwa tu ikiwa wataalamu wote watatu wanapinga global classifier. Hivyo, ingawa mfumo huhifadhi modeli saba, kwa rekodi moja huendesha wataalamu watatu pekee pamoja na modeli ya global; yaani, modeli zisizozidi nne hutathminiwa kwa kila rekodi.
Watafiti waliweka algoriti za decision tree (DT), Random Forest (RF), Extremely Randomized Trees (ET) na Histogram-based Gradient Boosting (HGB) katika majukumu ya G, EM na EB kwa mchanganyiko tofauti. Logistic Regression (LR) ilitumiwa pia kando kwa madhumuni ya kuunda hatua ya kwanza ya global iliyo dhaifu kimakusudi. Majaribio yalifanywa kwenye hifadhidata za 5G-NIDD na UNSW-NB15.
Ugunduzi mkuu wa utafiti ni kwamba kupunguza mashambulizi yanayokosekana si jambo la kipekee kwa decision tree ya CART. Katika jozi zote za dataset–configuration za modeli zinazotegemea miti zilizochunguzwa, idadi ya false negative ilipungua ikilinganishwa na global classifier. Katika 5G-NIDD, upungufu huu ulitofautiana kati ya %36,5 na %79,6 kulingana na configuration. Hata hivyo, katika baadhi ya configuration, false negative zilipungua huku idadi ya false positive ikiongezeka; kwa hiyo usanifu huu haupunguzi aina zote za makosa kwa wakati mmoja na bila masharti.
Matokeo kwa global classifier dhaifu ya Logistic Regression ni ya kushangaza zaidi. Katika 5G-NIDD, LR inayojitegemea ilizalisha 795 false positive na 571 false negative, huku mchanganyiko wa LR–RF–RF ukizipunguza hadi 57 na 24 mtawalia. Katika UNSW-NB15, configuration ya LR–RF–DT iliongeza thamani ya F1 kutoka 0,902575 hadi 0,934041 na kupunguza idadi ya mashambulizi yaliyokosekana kutoka 19.629 hadi 12.653; hata hivyo, iliongeza idadi ya false positive kutoka 1.897 hadi 2.415.
Kwa mtazamo wa Uturuki: Mbinu hii inaweza kutoa usanifu wa IDS unaostahili kuchunguzwa kwa waendeshaji wa simu, miundombinu ya 5G/5G binafsi, mifumo ya MEC, vituo vya data na vituo vya operesheni za usalama nchini Uturuki. Hasa katika mazingira ambako gharama ya tahadhari ya uongo ni tofauti na gharama ya kiusalama ya shambulio lililokosekana, uwezo wa kusanidi usanifu uleule wa uamuzi kwa mchanganyiko tofauti wa wataalamu ni muhimu. Hata hivyo, utafiti haukufanywa kwenye mtandao halisi wa mwendeshaji wa 5G nchini Uturuki. Kwa matumizi ya ndani, mgawanyo halisi wa trafiki, wasifu wa mashambulizi, gharama ya uchimbaji wa vipengele, ujumuishaji wa UPF/NWDAF/MEC, latency na usimamizi wa tahadhari vinapaswa kupimwa kando.
Kwa nini thamani moja ya F1 inaweza kutotosha?
Katika mfumo wa kugundua uvamizi, trafiki ya malicious inapochukuliwa kuwa darasa chanya, makosa mawili muhimu yanaweza kutokea. False positive (FP) ni pale mtiririko wa kawaida wa mtandao unapowekwa alama kama shambulio. False negative (FN) ni pale shambulio halisi linapotathminiwa kama trafiki ya kawaida.
Gharama za kiutendaji za makosa haya mawili si sawa. Ikiwa FP ni nyingi sana, wachambuzi wa usalama hushughulika na tahadhari za uongo na uchovu wa tahadhari unaweza kutokea. Kinyume chake, FN nyingi humaanisha kuwa mashambulizi halisi yanapita kwenye safu ya ugunduzi. Kwa hiyo, hata kama thamani za F1 za IDS mbili ziko karibu sana, tabia zao za usalama zinaweza kutofautiana kwa kiasi kikubwa.
Lengo la utafiti si kupata F1 ya juu pekee, bali kuweza kubadilisha aina gani ya kosa inadhibitiwa kwa ukali zaidi ndani ya usanifu uleule wa uamuzi kupitia mpangilio wa modeli za wataalamu.
Conditional counter-inspection inafanyaje kazi?
Kielelezo 1 kwenye ukurasa wa 5 wa utafiti kinaonyesha wazi utaratibu wa uamuzi wa usanifu. Mtiririko wa mtandao hutumwa kwanza kwa global classifier. Ikiwa modeli ya global inatoa uamuzi wa benign, wataalamu wa malicious-biased pekee huendeshwa; ikiwa inatoa uamuzi wa malicious, wataalamu wa benign-biased pekee huendeshwa.
Verianla Live: Mtiririko wa uamuzi wa conditional counter-inspection
Jedwali lifuatalo linafupisha utaratibu wa uamuzi uliofafanuliwa katika Kielelezo 1 cha utafiti. Ingawa mfumo huhifadhi modeli saba, modeli zisizozidi nne huendeshwa kwenye mtiririko mmoja.
| Hatua | Sharti | Kipengele kinachoendeshwa | Matokeo |
|---|---|---|---|
| 1. Uainishaji wa kwanza | Kila mtiririko wa mtandao | Global classifier G | Uamuzi wa kwanza wa benign au malicious huzalishwa. |
| 2A. Ukaguzi wa kupinga | Ikiwa G inasema benign | Wataalamu 3 wa malicious-biased, EM | Ikiwa wataalamu wote watatu wanasema malicious, uamuzi hubadilishwa kuwa malicious. |
| 2B. Ukaguzi wa kupinga | Ikiwa G inasema malicious | Wataalamu 3 wa benign-biased, EB | Ikiwa wataalamu wote watatu wanasema benign, uamuzi hubadilishwa kuwa benign. |
| 3. Ikiwa hakuna kauli moja | Ikiwa angalau mtaalamu mmoja anakubaliana na uamuzi wa global | Hakuna modeli ya ziada inayoendeshwa | Uamuzi wa kwanza wa global classifier huhifadhiwa. |
Verianla Live: Mwonekano wa mchakato huundwa kutoka kwenye jedwali la data linaloonekana hapo juu. Jedwali huhifadhiwa kama source-of-truth ya kisayansi.
Kwa nini “upinzani wa kauli moja” unatumika?
Upinzani wa mtaalamu mmoja tu dhidi ya uamuzi wa global hautoshi kubadilisha lebo. Kwa mfano, ikiwa modeli ya global imetathmini mtiririko kama benign, wataalamu wote watatu wa malicious-biased lazima waseme malicious.
Kiashirio cha kauli moja cha wataalamu wa malicious-biased kinafafanuliwa katika utafiti kama:
\[ u_M(x)=\prod_{\rho\in R}E_M^{(\rho)}(x) \]
na kwa wataalamu wa benign-biased:
\[ u_B(x)=\prod_{\rho\in R}\left[1-E_B^{(\rho)}(x)\right] \]
kimefafanuliwa hivyo.
Uamuzi wa mwisho ni:
\[ \hat{y}(x)=[1-g(x)]u_M(x)+g(x)[1-u_B(x)] \]
kwa namna hiyo. Hapa \(g(x)\) inawakilisha uamuzi wa kwanza wa global classifier. Fomula hii inaeleza kwamba uamuzi wa kwanza wa benign hubadilishwa kuwa malicious tu ikiwa wataalamu wote wa EM wanapinga, na uamuzi wa kwanza wa malicious hubadilishwa kuwa benign tu ikiwa wataalamu wote wa EB wanapinga.
Kwa nini wataalamu hawafundishwi kwenye data ileile?
Kila tawi la wataalamu lina modeli tatu na modeli hizi huonyeshwa darasa la kinyume kwa viwango tofauti. Viwango vilivyotumiwa katika utafiti ni:
\[ R=\{0{,}10,\;0{,}20,\;0{,}30\} \]
kwa namna hiyo.
Mtaalamu wa malicious-biased huona kila mfano wa mafunzo wa malicious, huku akiona sehemu maalumu tu ya darasa la benign. Kwa wataalamu wa benign-biased, mpangilio wa kinyume kwa ulinganifu hutumiwa. Hivyo, modeli zinapozingatia tatizo lilelile la msingi la uainishaji, huwa nyeti kwa maeneo tofauti ya makosa.
Watafiti hawakubadilisha muundo huu wa mafunzo; walibadilisha tu algoriti za kujifunza zinazotumiwa katika majukumu ya G, EM na EB. Muundo huu wa jaribio ulichaguliwa ili kuchunguza kama tofauti za matokeo zinatokana si na routing au kanuni ya kauli moja, bali na mpangilio wa learner.
Uandishi wa G–EM–EB unamaanisha nini?
Kila configuration huandikwa kama seti ya vipengele vitatu:
G – EM – EB
- G: Global classifier ya hatua ya kwanza.
- EM: Familia ya wataalamu wa malicious-biased inayowashwa wakati uamuzi wa kwanza ni benign.
- EB: Familia ya wataalamu wa benign-biased inayowashwa wakati uamuzi wa kwanza ni malicious.
Kwa mfano, DT–RF–HGB inamaanisha global classifier ni Decision Tree, wataalamu wa malicious-biased ni Random Forest na wataalamu wa benign-biased ni Histogram-based Gradient Boosting.
Algoriti kuu zilizochunguzwa ni DT, RF, ET na HGB. Logistic Regression haikuchunguzwa kwa upana kama mbadala wa jumla wa modeli za miti, bali ilitumiwa hasa kwa jaribio la msongo la “weak global filter”.
Kwa nini familia ya majaribio haichunguzi mchanganyiko wote 64?
Kuweka algoriti nne za modeli za miti katika majukumu matatu kunaweza kinadharia kuunda mchanganyiko tofauti \(4^3=64\). Watafiti hawakuchunguza yote.
Badala yake, familia nne za majaribio yaliyodhibitiwa ziliundwa:
| Familia ya jaribio | Mbinu ya configuration | Swali lililochunguzwa |
|---|---|---|
| Mabadiliko ya global model | X–DT–DT | Je, urejeshaji wa mashambulizi yaliyokosekana unaendelea wakati modeli ya hatua ya kwanza inabadilika? |
| Mabadiliko ya mtaalamu | DT–X–X | Je, modeli ya mtaalamu inaweza kubadilisha uwiano wa FP/FN? |
| Mabadiliko ya pande zote mbili | X–X–X au X–Y–Z | Je, wasifu tofauti wa kiutendaji unaweza kuundwa? |
| Weak global filter | LR–Y–Z | Je, safu ya wataalamu inaweza kuokoa classifier dhaifu ya kwanza? |
Kwa hiyo, utafiti haudai kwamba umebaini optimum kamili kati ya configuration zote zinazowezekana.
Kwa nini 5G-NIDD na UNSW-NB15 zilitumiwa pamoja?
Hifadhidata hizi mbili zilichaguliwa ili kuwakilisha viwango tofauti vya ugumu. 5G-NIDD ina trafiki ya benign na ya mashambulizi iliyotengenezwa katika mtandao halisi unaofanya kazi wa majaribio ya 5G, na modeli za miti zilizotumiwa tayari zinaonyesha utendaji wa juu sana kwenye hifadhidata hii.
Katika 5G-NIDD, mgawanyo wa mafunzo/majaribio ulifanywa kwa stratified %80/%20; rekodi 972.712 zilitumiwa kwa mafunzo na rekodi 243.178 kwa majaribio. Kiwango cha malicious ni takriban 0,607 katika sehemu zote mbili.
Katika UNSW-NB15, sehemu zilizofafanuliwa mapema za hifadhidata zilihifadhiwa: rekodi 82.332 za mafunzo na 175.341 za majaribio. Baada ya One-hot encoding, vipengele 190 vilipatikana; kiwango cha malicious kiliwekwa kuwa 0,5506 katika mafunzo na 0,6806 katika majaribio.
Mabadiliko yote ya data yali-fit kwenye sehemu ya mafunzo pekee na kutumika bila kubadilishwa kwenye sehemu ya majaribio. Safu za Attack Type na Attack Tool katika 5G-NIDD ziliondolewa kwenye mafunzo ili kuzuia hatari ya label leakage.
Je, mashambulizi yanayokosekana kweli yanapungua?
Matokeo thabiti zaidi ya utafiti ni kupungua kwa idadi ya false negative. Katika majaribio ya Global-only na homogeneous tree-based substitution, jozi zote za dataset–configuration zilizochunguzwa katika hifadhidata zote mbili zilisababisha FN chache kuliko modeli yao ya global ya hatua ya kwanza.
Katika 5G-NIDD, upungufu wa jamaa wa FN ulitofautiana kati ya %36,5 na %79,6. Kiwango cha juu zaidi kilionekana katika configuration ya HGB–HGB–HGB; false negative 54 za modeli ya global ya HGB zilipungua hadi 11 baada ya pipeline.
Katika UNSW-NB15, athari ilikuwa ndogo zaidi. Upungufu wa FN ulikuwa takriban kati ya %0,9 na %5,8; katika configuration ya HGB–HGB–HGB, thamani ya 16.657 FN ilipungua hadi 15.697.
Matokeo haya yanaunga mkono, ndani ya upeo wa utafiti, kwamba athari ya attack recovery ya counter-inspection haitokani tu na tabia ya Decision Tree. Hata hivyo, hayathibitishi kwamba usanifu utaonyesha tabia ileile katika hifadhidata zote zinazowezekana au familia zote za modeli.
Je, FN chache daima humaanisha F1 bora?
Hapana. HGB–HGB–HGB ni mfano wazi. Katika 5G-NIDD, modeli ya global ya HGB ilizalisha false positive tatu pekee, lakini mwisho wa pipeline idadi ya FP iliongezeka hadi 109. Wakati huohuo, FN ilipungua kutoka 54 hadi 11.
Hivyo, mfumo uligundua mashambulizi mengi zaidi lakini pia uliweka alama trafiki nyingi zaidi za benign kama mashambulizi. Thamani ya F1 ilishuka kidogo kutoka 0,999807 hadi 0,999594.
Matokeo haya yanaunga mkono hoja kuu ya utafiti: safu ya wataalamu si “performance booster” tu; inaweza kubadilisha mwelekeo wa wasifu wa makosa.
Kubadilisha modeli ya mtaalamu kunaathirije uwiano wa FP/FN?
Global model ilipowekwa kuwa DT, wataalamu wa RF waliunda mojawapo ya wasifu wenye uwiano mzuri zaidi katika 5G-NIDD. FP 48 na FN 51 za standalone DT zilipungua hadi FP 28 na FN 26 kwa DT–RF–RF. Hii ni sawa na upungufu wa %41,7 katika FP na %49,0 katika FN.
Wataalamu wa HGB waliunda wasifu mkali zaidi wa usalama: FN ilipungua kutoka 51 hadi 14 huku FP ikiongezeka kutoka 48 hadi 64. Hivyo, missed-attack recovery iliimarika lakini gharama ya tahadhari ya uongo ikaongezeka.
Katika UNSW-NB15, wasifu wa makosa wa algoriti hizo hizo ulionyesha tabia tofauti. Safari hii wataalamu wa HGB walipunguza FP kwa %25,0 na FN kwa %5,2. Hali hii inaonyesha kwamba algoriti fulani ya mtaalamu haionyeshi tabia ileile ya FP/FN kwenye kila hifadhidata.
Je, kuna “configuration bora” moja?
Mbinu ya utafiti inapinga wazo hilo kwa makusudi. Configuration tofauti hutumikia malengo tofauti ya kiutendaji.
| Hifadhidata | Wasifu | Configuration | FP | FN | F1 |
|---|---|---|---|---|---|
| 5G-NIDD | Rejea ya Homogeneous | DT–DT–DT | 30 | 27 | 0,999807 |
| 5G-NIDD | F1 ya juu zaidi iliyotathminiwa | DT–RF–HGB | 13 | 30 | 0,999854 |
| 5G-NIDD | Attack recovery inayoendana na DT | DT–HGB–RF | 79 | 10 | 0,999699 |
| UNSW-NB15 | Rejea ya Homogeneous | DT–DT–DT | 1515 | 16.688 | 0,918558 |
| UNSW-NB15 | F1 ya juu zaidi ya tree-based | HGB–RF–RF | 2356 | 13.893 | 0,928464 |
Kwa mfano, katika UNSW-NB15, HGB–RF–RF iliongeza F1 na kupunguza FN huku ikiongeza idadi ya FP kutoka 1.515 hadi 2.356. Configuration hii inaweza kuwa na maana katika mazingira ambako kugundua mashambulizi kunapewa kipaumbele kikubwa; lakini katika operesheni nyingine ambako kiasi cha tahadhari ni muhimu, chaguo hilo hilo linaweza lisifae.
Je, hatua ya kwanza dhaifu inaweza kweli kuokolewa?
Mojawapo ya majaribio muhimu ya utafiti ilitumia Logistic Regression kimakusudi kama global classifier dhaifu.
Katika 5G-NIDD, standalone LR ilizalisha:
- 795 false positive,
- 571 false negative,
- 0,994410 F1
.
LR–RF–RF ilipotumiwa:
- FP ilifika 57,
- FN ilifika 24,
- F1 ilifika 0,999726
.
Verianla Live: Kuokoa weak LR filter kwenye 5G-NIDD
Idadi ghafi za makosa ni ulinganisho kati ya standalone Logistic Regression na pipeline ya LR–RF–RF kwenye seti ileile ya majaribio.
| Aina ya kosa | LR standalone | LR–RF–RF | Mabadiliko ya jamaa |
|---|---|---|---|
| False Positive | 795 | 57 | −%92,8 |
| False Negative | 571 | 24 | −%95,8 |
Verianla Live: Nambari hizi ni matokeo ghafi ya FP/FN yaliyotolewa na utafiti kwa hifadhidata ileile na sehemu ileile ya majaribio.
Katika UNSW-NB15, configuration ya LR–RF–DT ilitoa matokeo yaliyolenga recall kwa kiasi kikubwa. F1 iliongezeka kutoka 0,902575 hadi 0,934041; FN ilipungua kutoka 19.629 hadi 12.653. Kwa upande mwingine, FP iliongezeka kutoka 1.897 hadi 2.415.
Kwa hiyo, utafiti hauonyeshi kwamba weak first filter huboreshwa bila masharti katika kila aina ya kosa, bali kwamba inaweza kubadilishwa kwa kiasi kikubwa kwa kutumia safu ya wataalamu.
Je, pipeline kweli ni “lightweight”?
Usanifu una modeli saba tofauti: global model moja, wataalamu watatu wa EM na wataalamu watatu wa EB. Hata hivyo, kwa sababu ya routing, tawi moja tu la wataalamu huendeshwa kwenye mtiririko huo huo. Hivyo:
1 global model + 3 wataalamu = tathmini za modeli zisizozidi 4
hufanywa.
Katika vipimo vya single-threaded vya utafiti, latency ya classifier ya full pipeline ilibaki chini ya 0,1 ms kwa kila rekodi katika backbone zote zilizojaribiwa.
| Hifadhidata | Backbone | Pipeline latency (ms/rekodi) | Throughput (rekodi/s) | Ukubwa wa modeli 7 (MB) |
|---|---|---|---|---|
| 5G-NIDD | DT | 0,0024 | 425.393 | 0,20 |
| 5G-NIDD | RF | 0,0340 | 29.377 | 50,14 |
| 5G-NIDD | ET | 0,0554 | 18.062 | 435,63 |
| 5G-NIDD | HGB | 0,0395 | 25.311 | 2,83 |
| UNSW-NB15 | DT | 0,0057 | 174.853 | 1,19 |
| UNSW-NB15 | RF | 0,0733 | 13.635 | 383,01 |
| UNSW-NB15 | ET | 0,0978 | 10.228 | 1102,31 |
| UNSW-NB15 | HGB | 0,0497 | 20.127 | 2,77 |
Jedwali hili linaonyesha tofauti muhimu. Kwa upande wa routing, pipeline ina gharama ya inference iliyo chini na iliyowekewa kikomo; lakini si familia zote za modeli zina matumizi madogo ya kumbukumbu. Hasa, modeli za ET na RF zinaweza kufikia mamia ya megabaiti, hata takriban 1,1 GB ya nafasi ya jumla ya modeli.
Kwa hiyo, neno “lightweight” hapa halipaswi kumaanisha kwamba configuration zote ni ndogo. Wakati DT na HGB zinaonekana kuwa compact zaidi kwa upande wa kumbukumbu, baadhi ya wasifu wa makosa wa RF na ET hupatikana kwa gharama kubwa zaidi ya kumbukumbu.
Je, matokeo ya 0,1 ms ni latency halisi ya 5G?
Hapana. Hili ni mojawapo ya mambo muhimu zaidi ambayo hayapaswi kutafsiriwa vibaya katika utafiti huu.
Muda uliopimwa ni muda wa classifier inference pekee. Data ya majaribio ilikuwa imetayarishwa mapema na utabiri ulipimwa katika hali ya offline batch kwa kutumia thread moja.
Katika mfumo halisi wa 5G IDS, kwa kuongezea kungekuwa na:
- kunasa packet au flow za mtandao,
- kutoa flow feature,
- kuhamisha data kwenda kwenye modeli,
- preprocessing,
- kutengeneza alert,
- ujumuishaji wa SIEM/SOC,
- gharama nyingine za uchakataji ndani ya network function
.
Kwa hiyo, si “EPoLBFT...”, bali thamani zilizo chini ya 0,1 ms zilizotolewa kwa conditional counter-inspection IDS katika utafiti huu haziwezi kutafsiriwa kama latency halisi ya end-to-end ya kugundua mashambulizi katika 5G.
Uwezekano wa matumizi kwa MEC, UPF na NWDAF unatathminiwaje?
Watafiti wanajadili kuwa usanifu unaweza kutumiwa kwenye 5G network edge, Multi-access Edge Computing (MEC), sehemu za monitoring zilizo karibu na User Plane Function (UPF), au mifumo iliyo karibu na Network Data Analytics Function (NWDAF).
Sifa muhimu ya usanifu wa aina tofauti ni kwamba, ingawa modeli tofauti za wataalamu zinaongezwa, hauhitaji kipimo kipya cha upande wa mtandao. Global model na wataalamu wote hufanya kazi kwenye flow-level feature vector ileile.
Kwa hiyo, ikiwa vipengele vinavyohitajika na mfumo uliopo wa homogeneous CART tayari vinazalishwa katika sehemu fulani ya network monitoring, toleo la aina tofauti linaweza kutumia vipengele vilevile. Hata hivyo, ujumuishaji halisi wa MEC/UPF/NWDAF haukufanywa katika utafiti.
Matokeo yanayoungwa mkono na utafiti
- Imeonyeshwa kwamba majukumu ya G, EM na EB katika usanifu wa Conditional counter-inspection yanaweza kujazwa na algoriti tofauti za kujifunza.
- Configuration zote za miti zilizochunguzwa zilipunguza kiasi fulani cha FN ikilinganishwa na standalone global classifier zao katika hifadhidata zote mbili.
- Imeonyeshwa kwamba uchaguzi wa expert backbone unaweza kuwa na athari ya mwelekeo kwenye uwiano wa false positive na false negative.
- Mchanganyiko tofauti wa G–EM–EB ulizalisha wasifu tofauti wa operesheni za usalama.
- Imeonyeshwa kwamba hatua ya kwanza dhaifu ya Logistic Regression inaweza kuboreshwa kwa kiasi kikubwa kwa kutumia wataalamu wa tree-based.
- Kwa sababu ya Conditional routing, modeli zisizozidi nne zilitathminiwa kwa kila rekodi.
- Muda wa classifier-only inference uliopimwa katika utafiti ulibaki chini ya 0,1 ms kwa kila rekodi katika backbone zote zilizojaribiwa.
Matokeo ambayo utafiti hauungi mkono au bado haujayajaribu
- Haijaonyeshwa kwamba usanifu unafanya kazi kwa latency ileile katika mtandao halisi wa uzalishaji wa 5G.
- Kipimo cha chini ya 0,1 ms si end-to-end packet capture–feature extraction–alert latency.
- Mchanganyiko wote 64 wa G–EM–EB wa tree-based haukuchunguzwa.
- Wasifu wa kiutendaji uliochaguliwa katika utafiti haukubainishwa kama deployment optimum kupitia validation set huru.
- Modeli ilitathminiwa tu kwa uainishaji wa binary benign–malicious; uainishaji wa familia za mashambulizi haukujaribiwa.
- Haijaonyeshwa kwamba matokeo ya near-ceiling yaliyopatikana kwenye 5G-NIDD yanaweza kujumlishwa kwa namna ileile kwenye trafiki tofauti za mtandao halisi.
- Haijaonyeshwa kwamba configuration zote zinazotumia Random Forest na Extra Trees zinafaa kwa vifaa vya edge vyenye kumbukumbu ndogo.
- Hakuna validation iliyofanywa kwenye mitandao halisi ya 5G au 5G binafsi nchini Uturuki.
Mbinu na Matokeo ya Utafiti
Data na preprocessing
| Kipengele | 5G-NIDD | UNSW-NB15 |
|---|---|---|
| Kazi | Uainishaji wa binary wa Benign / malicious | Uainishaji wa binary wa Benign / malicious |
| Rekodi za mafunzo | 972.712 | 82.332 |
| Rekodi za majaribio | 243.178 | 175.341 |
| Split | Stratified %80 / %20 | Partition zilizofafanuliwa mapema za hifadhidata |
| Malicious prevalence | 0,607 mafunzo na majaribio | 0,5506 mafunzo; 0,6806 majaribio |
| Vipengele vya categorical | One-hot encoding | One-hot encoding |
| Hatua maalumu ya leakage | Attack Type na Attack Tool ziliondolewa | Chanzo hakitaji kuondolewa kwa safu ya ziada inayolingana |
Modeli zilizotumiwa na mazingira ya programu
| Kipengele | Mpangilio |
|---|---|
| Decision Tree | DecisionTreeClassifier, random_state=42 |
| Random Forest | 200 miti, random_state=42 |
| Extra Trees | 200 miti, random_state=42 |
| HGB | HistGradientBoostingClassifier, random_state=42 |
| Logistic Regression | Median imputation → StandardScaler → LogisticRegression; max_iter=3000, solver=lbfgs |
| Viwango vya Curriculum | 0,10; 0,20; 0,30 |
| Idadi ya wataalamu | 3 EM + 3 EB |
| Random seed | 42 |
| Python | 3.12.13 |
| scikit-learn | 1.6.1 |
| NumPy | 2.0.2 |
| pandas | 2.2.2 |
| SciPy | 1.16.3 |
Watafiti hawakufanya hyperparameter optimization tofauti kwa kila configuration. Lengo la mipangilio thabiti ya algoriti lilikuwa kuhakikisha kwamba tofauti ya utendaji inaakisi nafasi ambayo modeli imewekwa badala ya unequal tuning.
Vigezo vya tathmini
Kwa kuchukulia darasa la Malicious kuwa chanya, accuracy, precision, recall na F1 zilihesabiwa katika muundo wa kawaida ufuatao:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1=\frac{2\cdot Precision\cdot Recall}{Precision+Recall} \]
Utafiti pia ulihifadhi hasa idadi ghafi za FP na FN. Mbinu hii ni muhimu kwa sababu, chini ya thamani za F1 zilizo juu sana, tofauti ya kiutendaji kati ya makosa kadhaa ya makumi inaweza kuwa karibu isionekane katika alama zilizosanifishwa.
5G-NIDD: ulinganisho wa expert backbone
| DT global + expert backbone | Mabadiliko ya FP | Mabadiliko ya FN | F1 | Wasifu uliofafanuliwa katika chanzo |
|---|---|---|---|---|
| DT | −%37,5 | −%47,1 | 0,999807 | Rejea ya Homogeneous CART |
| RF | −%41,7 | −%49,0 | 0,999817 | Upungufu wa makosa wenye uwiano |
| ET | −%2,1 | −%37,3 | 0,999732 | Marekebisho yanayolenga recall |
| HGB | +%33,3 | −%72,5 | 0,999736 | Upungufu mkali wa FN |
UNSW-NB15: ulinganisho wa expert backbone
| DT global + expert backbone | Mabadiliko ya FP | Mabadiliko ya FN | F1 | Wasifu uliofafanuliwa katika chanzo |
|---|---|---|---|---|
| DT | −%27,0 | −%1,3 | 0,918558 | Zaidi upungufu wa FP |
| RF | +%1,2 | −%14,8 | 0,927151 | F1 ya juu zaidi kati ya variant za DT-global |
| ET | +%2,2 | −%6,2 | 0,920116 | Upungufu wa wastani wa FN |
| HGB | −%25,0 | −%5,2 | 0,921549 | Upungufu wa pamoja; unaoelemea FP |
Matokeo ya weak LR filter
| Hifadhidata | Configuration | FP | FN | F1 |
|---|---|---|---|---|
| 5G-NIDD | LR standalone | 795 | 571 | 0,994410 |
| 5G-NIDD | LR–DT–DT | 59 | 25 | 0,999716 |
| 5G-NIDD | LR–RF–RF | 57 | 24 | 0,999726 |
| 5G-NIDD | LR–HGB–HGB | 106 | 10 | 0,999607 |
| UNSW-NB15 | LR standalone | 1897 | 19.629 | 0,902575 |
| UNSW-NB15 | LR–DT–DT | 1530 | 16.761 | 0,918143 |
| UNSW-NB15 | LR–RF–DT | 2415 | 12.653 | 0,934041 |
Katika UNSW-NB15, LR–RF–DT ilitoa ongezeko kubwa zaidi la F1 kwa thamani halisi kati ya configuration zilizoripotiwa katika utafiti: +0,031466. Hata hivyo, configuration hiyohiyo iliongeza FP kwa %27,3 ikilinganishwa na standalone LR. Kwa hiyo, matokeo hayapaswi kutafsiriwa kama “classifier dhaifu iliboreka kwa kila namna”, bali kama imehamishwa hadi wasifu mpya wa makosa unaopendelea recall na aggregate F1.
Upimaji wa gharama ya inference
Majaribio ya latency yalifanywa kwenye rekodi 243.178 za held-out test za 5G-NIDD na rekodi 175.341 za UNSW-NB15. Utabiri uliendeshwa kwa single-threaded na, baada ya warm-up, matokeo bora ya majaribio matano ya muda yalitumiwa.
Uwiano wa latency wa pipeline/global ulitofautiana takriban kati ya 3,3× na 5,8×. Ongezeko hili halimaanishi kwamba modeli zote saba huendeshwa; kwa sababu ya conditional routing, global + wataalamu watatu walio hai pekee hutathminiwa.
Thamani ya chini zaidi ya full-pipeline katika utafiti ilikuwa 0,0024 ms/rekodi kwa DT ya 5G-NIDD, na thamani ya juu zaidi ilikuwa 0,0978 ms/rekodi kwa ET ya UNSW-NB15.
Muda huu ni wa classifier inference pekee; feature extraction, data movement na alert handling hazikujumuishwa.
Mapungufu makuu ya utafiti
- Si mchanganyiko wote 64 unaowezekana wa tree-based heterogeneous triples uliochunguzwa.
- Wasifu wa deployment-oriented ulifafanuliwa kutokana na matokeo ya held-out test; haukuchaguliwa kwa independent validation partition.
- Hifadhidata mbili tu zilitumiwa na kwa kuwa feature spaces ni tofauti, cross-dataset transfer haikufanywa.
- Vipimo vya latency vilifanywa katika hali ya offline, batch na single-threaded classifier inference.
- Utendaji wa end-to-end ndani ya live 5G network function haukupimwa.
- Tatizo limewekewa kikomo kwa binary benign/malicious classification.
- Wasifu wa wataalamu unaotegemea RF na ET unaweza kuhitaji kumbukumbu kubwa.
Mwelekeo wa utafiti wa baadaye
Waandishi wanapendekeza, kama kazi ya baadaye, upanuzi wa multi-class unaoshughulikia aina za mashambulizi kama madarasa tofauti, uchaguzi wa wasifu kwa kutumia cost function kwenye data maalumu ya validation, uthibitishaji kwenye hifadhidata zaidi za IDS, uchunguzi wa kimfumo zaidi wa heterogeneous combination space, na tathmini ya runtime katika mazingira halisi ya 5G edge/network-function.
Kwa upanuzi wa multi-class, chaguo zinazojadiliwa ni wataalamu wa familia za mashambulizi wanaohusishwa na single multi-class global classifier, one-vs-rest correction experts, group experts zinazofunika mashambulizi yanayofanana, au muundo wa hierarchical unaotenganisha kwanza benign/malicious na kisha kuainisha aina ya shambulio.
Maelezo ya Chanzo na Mbinu
Jina kamili la awali la utafiti: Heterogeneous Conditional Counter-Inspection: Configurable Error Control and Weak-Filter Recovery for 5G Network Intrusion Detection
Waandishi: Khaoula Tahori; Imade Fahd Eddine Fatani; Mohamed Moughit; Hicham Magri.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa bila kubadilishwa.
Mwandishi mwenza wa kwanza/mchango sawa: Chanzo hakionyeshi alama ya uandishi wa kwanza sawa.
Waandishi wanaowajibika: Imade Fahd Eddine Fatani na Mohamed Moughit.
Taasisi: Sciences and Techniques for the Engineer Laboratory (LASTI), National School of Applied Science, University Sultan Moulay Slimane, Khouribga, Morocco; Artificial Intelligence, Modeling & Computational Engineering Laboratory (AIMCE), The National Higher School of Arts and Crafts (ENSAM), Hassan II University of Casablanca, Casablanca, Morocco; Center for Studies and Research in Engineering and Organization Management, Higher School of Multimedia, Computer Science & Networks–Supemir, Hassan II University of Casablanca, Casablanca, Morocco.
Jarida: Future Internet.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / toleo / nambari ya makala: 18 / 7 / 381.
DOI: 10.3390/fi18070381
Tarehe ya kupokelewa: 16 Juni 2026.
Tarehe ya marekebisho: 15 Julai 2026.
Tarehe ya kukubaliwa: 17 Julai 2026.
Tarehe ya kuchapishwa: 22 Julai 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wataalamu; usanifu wa kugundua uvamizi wa mtandao unaotegemea machine learning na tathmini linganishi ya hifadhidata.
Hali ya peer review: Chapisho la kisayansi lililopitiwa na wataalamu.
Leseni: Creative Commons Attribution (CC BY).
Kiungo rasmi cha chapisho:https://doi.org/10.3390/fi18070381
Vyanzo vya data: Majaribio yalifanywa kwa hifadhidata za umma za 5G-NIDD na UNSW-NB15. Chanzo kinaeleza kwamba 5G-NIDD inapatikana kupitia IEEE Dataport, huku UNSW-NB15 ikipatikana kupitia wasambazaji wake wa awali.
Upatikanaji wa msimbo: Inaripotiwa kwamba modeli zilizofundishwa, jedwali za matokeo yaliyotokana na uchambuzi na implementation kamili zinaweza kutolewa na mwandishi anayewajibika kwa ombi linalofaa. Chanzo hakitoi repository ya msimbo iliyo wazi na inayoweza kupakuliwa moja kwa moja.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Michango ya waandishi: Conceptualization, data curation, method, software, project management na rasimu ya kwanza Khaoula Tahori; formal analysis Khaoula Tahori, Imade Fahd Eddine Fatani, Mohamed Moughit na Hicham Magri; supervision Imade Fahd Eddine Fatani na Mohamed Moughit; review na editing Khaoula Tahori, Imade Fahd Eddine Fatani na Mohamed Moughit. Chanzo kinaeleza kwamba waandishi wote walisoma na kuidhinisha toleo lililochapishwa.
Uhusiano na utafiti uliopita: Utafiti unapanua usanifu wa homogeneous CART-based conditional counter-inspection uliochapishwa hapo awali na kundi hilohilo. Mchango wa kazi mpya si kurekebisha tu pipeline ileile; ni kutenganisha majukumu ya G, EM na EB ili kupima kama algoriti tofauti za kujifunza zinaweza kuunda wasifu tofauti wa kiutendaji.
Kikomo cha uchaguzi wa configuration: Heterogeneous study space haikuchunguzwa kikamilifu kwa brute-force. Hasa, deployment-oriented profiles si deployment optima za uhakika zilizochaguliwa kupitia validation partition tofauti; ni wasifu wa maelezo uliotazamwa katika held-out test results.
Kikomo cha kipimo cha utendaji: Muda wa chini ya 0,1 ms si end-to-end IDS latency ya mtandao halisi, bali ni vipimo vya offline single-threaded classifier inference. Feature extraction, packet/flow acquisition, data movement na alert handling hazijajumuishwa.
Maelezo kuhusu neno “Lightweight”: Utafiti unaunganisha sifa ya lightweight primarily na muundo wa hesabu uliowekewa kikomo wa conditional routing, ambao hutathmini modeli zisizozidi nne kwa kila rekodi. Kwa kuwa katika configuration za Random Forest na Especially Extra Trees jumla ya model footprint inaweza kufikia mamia ya megabaiti au takriban 1,1 GB, haipaswi kuhitimishwa kwamba backbone zote zina mahitaji madogo ya kumbukumbu.
Kikomo cha upeo wa kisayansi: Matokeo yanahusu binary benign/malicious classification kwenye 5G-NIDD na UNSW-NB15. Multi-class attack identification, ujumuishaji halisi wa network-function, live MEC/UPF/NWDAF deployment na mazingira ya trafiki ya 5G nchini Uturuki hayakujaribiwa katika utafiti huu.
Maelezo ya Verianla Live: Uoneshaji wa mchakato unategemea conditional routing na unanimous dissent mechanism katika Kielelezo 1 cha utafiti. Katika ulinganisho wa LR–RF–RF, thamani ghafi za FP/FN za standalone LR na pipeline zilizoripotiwa kutoka seti ileile ya majaribio ya 5G-NIDD pekee zilitumiwa. Idadi ghafi za makosa kutoka hifadhidata tofauti hazikulinganishwa kwenye grafu ileile.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *