

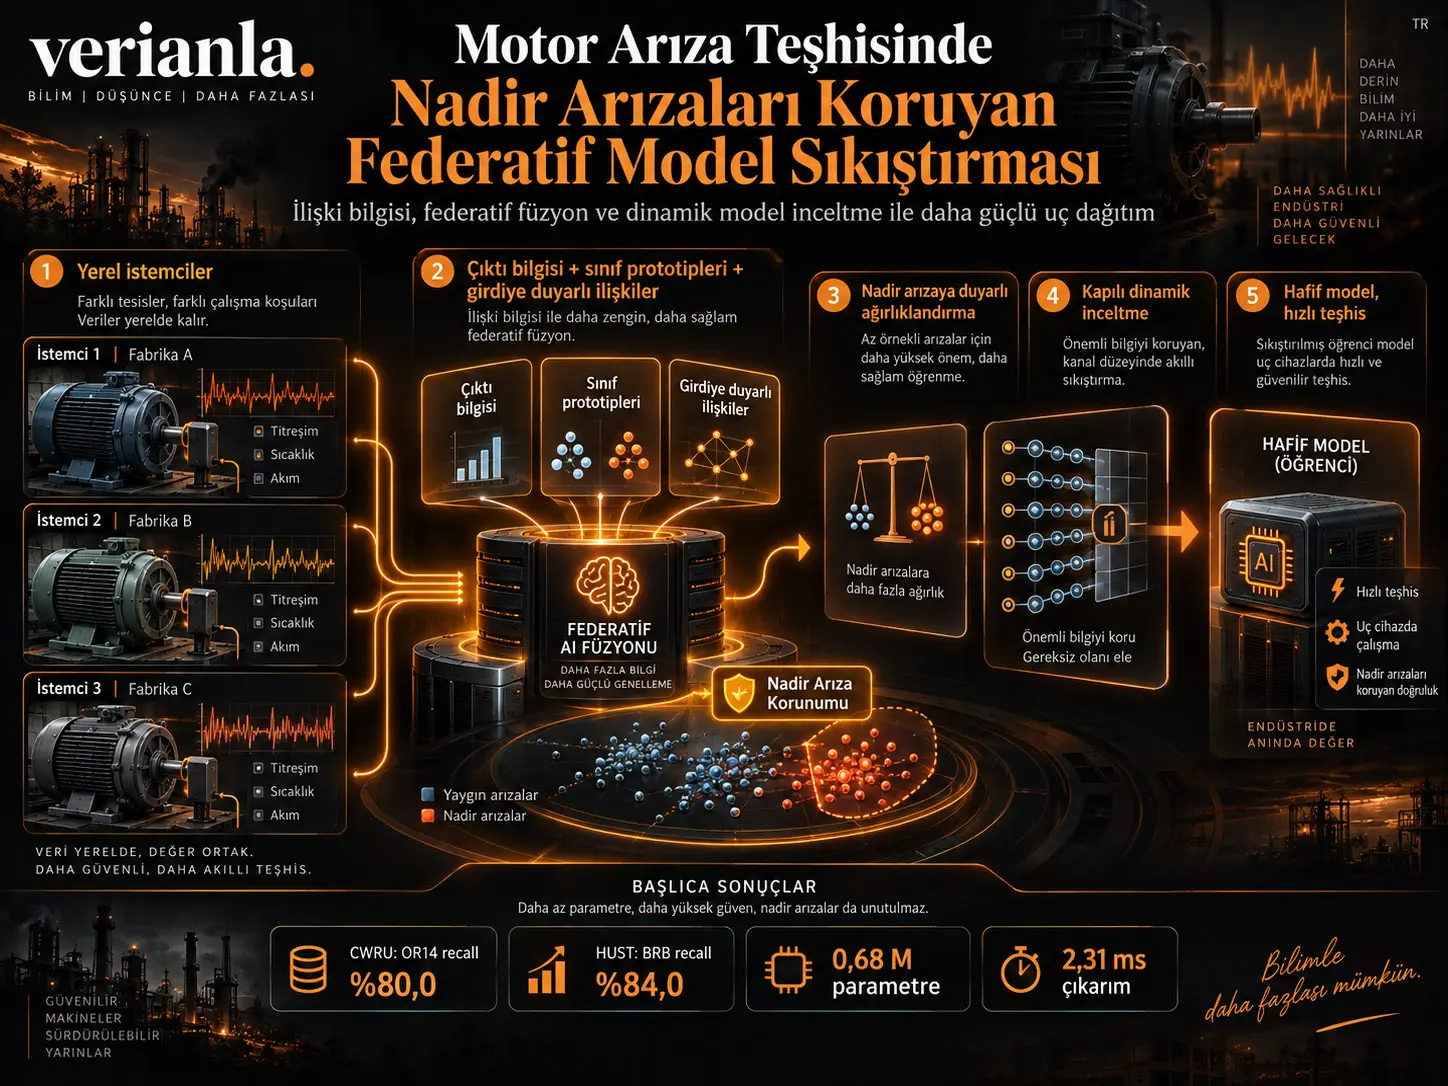
İlişki bilgisine dayalı nadir-arıza korumalı federatif dinamik model inceltme yöntemi, farklı motorlardan gelen ham izleme verilerini merkezi bir noktada toplamadan işbirlikli teşhis yapmayı, az sayıdaki nadir arıza örneğinin bilgisini federatif birleştirme sırasında kaybetmemeyi ve ortaya çıkan modeli uç cihazlarda çalışabilecek kadar küçültmeyi amaçlayan bir makine öğrenmesi çerçevesidir. Yöntem, her yerel istemciden üç bilgi türü çıkarır: çıktı-ayrıştırıcı bilgi, sınıf-prototip ilişkileri ve girdiye-duyarlı ilişkiler. Sunucuda örnek seyrekliği, çıktı güvenilirliği ve sınıf-içi dağılım dikkate alınarak nadir arıza bilgisine ağırlık verilir; daha sonra global öğretmen model, ilişki kısıtları altında kapılı bir öğrenci modele aktarılıp gereksiz kanallar bastırılır.
CWRU rulman veri setindeki birleşik dengesizlik senaryosunda yöntem %84,9 ortalama doğruluk, %84,0 Macro-F1 ve %80,0 OR14 recall elde etmiştir. Aynı koşulda Fed-KD'nin karşılık gelen değerleri %74,7, %72,0 ve %58,0'dır. HUST çok-modlu motor veri setindeki parçalanmış-modalite nadir-arıza senaryosunda yöntem %88,4 ortalama doğruluk, %87,8 Macro-F1 ve %84,0 kırık rotor çubuğu (BRB) recall değerine ulaşmıştır. Görülmemiş 30 Hz çalışma koşulunda ise %84,3 ortalama doğruluk, %83,5 Macro-F1 ve %78,0 BRB recall raporlanmıştır.
Model sıkıştırması yalnız parametre azaltma olarak uygulanmamıştır. Öğrenci ağındaki öğrenilebilir kapılar, nadir arızaların ayrımı için gerekli kanalları koruyan ilişki kayıplarıyla birlikte eğitilmiştir. HUST testinde nihai model 0,68 milyon parametre, 1,55 milyon FLOP, 2,31 ms tek-örnek çıkarım süresi ve 596,4 MiB tepe çıkarım belleğiyle raporlanmıştır. Bununla birlikte sonuçlar üç istemcili kontrollü non-IID deneylere ve iki kamu veri setine aittir; büyük ölçekli gerçek endüstriyel federasyon için henüz doğrudan kanıt sağlamaz. Ayrıca ham sinyallerin yerelde tutulması yöntemi “privacy-aware” yapar, fakat yazarların açıkça belirttiği gibi biçimsel bir gizlilik garantisi oluşturmaz.
Problemin mühendislik bağlamı
Endüstriyel motorlarda rulman hasarı, rotor dengesizliği, hizasızlık, kırık rotor çubuğu, sargı kısa devresi ve gerilim dengesizliği gibi arızalar üretim sürekliliğini ve bakım maliyetini doğrudan etkileyebilir. Ancak gerçek çok-istasyonlu teşhis ortamında bütün makineler aynı veri miktarına, aynı sensörlere veya aynı arıza dağılımına sahip değildir. Bazı istasyonlarda belirli arızalar hiç görülmezken başka bir istemcide nadir bir arızaya ait yalnız birkaç gürültülü kayıt bulunabilir.
Bu koşul klasik federatif öğrenme için zordur. Parametreleri basitçe örnek sayısına göre ortalamak, veri miktarı büyük istemcilerin global modeli baskılamasına neden olabilir. Nadir bir arıza yalnız küçük bir istemcide bulunuyorsa o arızanın karar sınırı global model içinde zayıflayabilir. Diğer taraftan bütün istemcilerden gelen tekrar eden veya çoğunluk sınıfları tarafından domine edilen özelliklerin korunması da gereksiz model büyüklüğüne yol açabilir.
Federatif Öğrenmede Nadir Arıza Bilgisi Neden Kaybolabilir?
Federatif öğrenmede yerel veri dağılımları non-IID olduğunda, büyük ve yüksek kaliteli veri kümelerine sahip istemciler global birleşimi daha güçlü etkileyebilir; yalnız az sayıdaki istemcide bulunan nadir arıza örnekleri ise ortalama içinde zayıflayabilir. Bu çalışmanın çözümü, istemci katkısını yalnız örnek sayısına göre değil nadirlik, çıktı güvenilirliği ve sınıf-içi dağılıma göre sınıf bazında ağırlıklandırmaktır.
Önerilen çerçevenin dört aşaması
Sayfa 6'daki kaynak Şekil 1, yöntemi dört ardışık süreç halinde gösterir: yerel bilgi madenciliği, federatif bilgi füzyonu, global öğretmen model optimizasyonu ve öğrenci modelin kapılı dinamik inceltilmesi.
Federatif sistemde istemci sayısı \(K\), sınıf sayısı \(C\), istemci \(k\)'nın veri seti \(D_k\), sunucudaki etiketli kalibrasyon seti \(D_a\), yerel model \(F_k\), global öğretmen \(F_G\) ve öğrenci model \(F_S\) ile gösterilir.
Yerel modelin temel tahmini
İstemci \(k\)'nın özellik çıkarıcısı \(\phi_k(\cdot)\), sınıflandırıcısı \(g_k(\cdot)\) ve parametreleri \(\theta_k\) olsun. Kaynağın Denklem (1)'i:
\[ z_{k,i}=g_k\!\left(\phi_k(x_{k,i};\theta_k)\right), \qquad p_{k,i}=\operatorname{softmax}(z_{k,i}) \tag{1} \]
\(z_{k,i}\) sınıflandırma logitlerini, \(p_{k,i}\) ise sınıf olasılıklarını ifade eder. Bu model yerel veride eğitilir; ham sinyal sunucuya gönderilmez.
Nadir sınıfları yerelde dengeleyen kayıp
Yerel eğitimde nadir sınıfların etkisini artırmak için sınıf dengeli çapraz entropi kullanılır:
\[ L_k^{ce} = -\frac{1}{n_k} \sum_{i=1}^{n_k} \gamma_{k,y_{k,i}} \log p_{k,i}^{(y_{k,i})} \tag{2} \]
\[ \gamma_{k,c} = \frac{(n_{k,c}+\varepsilon)^{-\eta}} {\sum_{j=1}^{C}(n_{k,j}+\varepsilon)^{-\eta}} \]
\(n_{k,c}\), istemci \(k\)'daki \(c\) sınıfı örnek sayısıdır. \(\varepsilon\) sıfıra bölünmeyi engeller; \(\eta\) ise nadir sınıfa yapılacak telafinin şiddetini belirler. Deneylerde \(\eta=0.5\) ve \(\varepsilon=10^{-6}\) kullanılmıştır.
Çok Granüler İlişki Bilgisi Nedir?
Bu çalışmadaki çok granüler ilişki bilgisi, model bilgisini yalnız nihai sınıf olasılıklarıyla değil üç tamamlayıcı düzeyde temsil eder: yumuşatılmış çıktı dağılımları karar sınırlarını, sınıf prototipleri arızalar arasındaki yapısal ilişkileri ve gradyan tabanlı girdiye-duyarlı ilişkiler zayıf veya sınırdaki nadir arıza özelliklerine duyarlılığı tanımlar.
1. Çıktı-ayrıştırıcı bilgi
Sert sınıf etiketi yerine sıcaklık \(T\) ile yumuşatılmış dağılım kullanılır:
\[ q^T_{k,i} = \operatorname{softmax} \left( \frac{z_{k,i}}{T} \right) \tag{3} \]
Deneylerde \(T=3\)'tür. Yumuşak olasılıklar yalnız doğru sınıfı değil diğer sınıfların göreli benzerliğini de içerdiğinden, özellikle birbirine yakın arıza tiplerinin karar sınırlarının aktarılmasına yardım eder.
2. Sınıf-prototip ilişkisi
Derin özellik \(h_{k,i}=\phi_k(x_{k,i};\theta_k)\) ile tanımlanır. Bir sınıfın prototipi, normalleştirilmiş özelliklerin ortalamasıdır:
\[ \pi_{k,c} = \frac{1}{n_{k,c}} \sum_{i:y_{k,i}=c} \frac{h_{k,i}} {\|h_{k,i}\|_2} \tag{4} \]
İki sınıf arasındaki ilişki kosinüs benzerliğiyle yazılır:
\[ R^p_k(c,c') = \frac{\pi_{k,c}^{\top}\pi_{k,c'}} {\|\pi_{k,c}\|_2\|\pi_{k,c'}\|_2} \tag{5} \]
Bu matris, örneğin iki dış bilezik arızasının özellik uzayında birbirine ne kadar yakın olduğunu modelin yalnız son sınıf kararından bağımsız şekilde korumaya çalışır.
3. Girdiye-duyarlı ilişki
Bir sınıfın hassasiyet prototipi, ilgili sınıf logitinin özelliğe göre gradyanından üretilir:
\[ s_{k,c} = \frac{1}{n_{k,c}} \sum_{i:y_{k,i}=c} \frac{\nabla_{h_{k,i}}z^{(c)}_{k,i}} {\|\nabla_{h_{k,i}}z^{(c)}_{k,i}\|_2} \tag{6} \]
Ardından sınıflar arası hassasiyet ilişkisi:
\[ R^s_k(c,c') = \frac{s_{k,c}^{\top}s_{k,c'}} {\|s_{k,c}\|_2\|s_{k,c'}\|_2} \tag{7} \]
Bu katmanın amacı, özellikle zayıf darbeli, düşük SNR'lı veya sınıf sınırında bulunan nadir arıza örneklerine hangi özellik kanallarının duyarlı olduğunu kaybetmemektir. Sayfa 18'deki Şekil 8, tam modelin OR14 örneklerinde daha yoğun ve kararlı nadir-arıza duyarlı kanal cevapları oluşturduğunu göstermektedir.
Ham veri gönderilmeden iletişim
Her istemci ham titreşim veya akustik sinyali yerine çıktı cevapları, prototipler, iki ilişki matrisi ve sınıf istatistikleri gönderir. Kaynak iletişim yükünü:
\[ B_{\mathrm{rel}} = b\left( N_aC+Cd+2C^2+3C \right) \]
olarak verir. Parametre tabanlı klasik federatif aktarım için:
\[ B_{\mathrm{param}}=b|\theta| \]
kullanılır. \(b\) bir kayan nokta değerinin bayt büyüklüğü, \(N_a\) kalibrasyon örneği sayısı, \(d\) prototip boyutudur. Bu karşılaştırma, tanımlayıcıların çoğu durumda tam model parametrelerinden küçük olabileceğini gösterir; ancak gerçek iletişim kazancı \(N_a\), \(C\), \(d\) ve model büyüklüğüne bağlıdır.
Çalışmanın Yöntemi ve Bulguları
Nadir-Arızaya Duyarlı Federatif Ağırlıklandırma Nasıl Çalışır?
Sunucu her istemci-sınıf çiftinin katkısını üç değişkenle değerlendirir: sınıfın ne kadar seyrek olduğu, model çıktısının ne kadar güvenilir olduğu ve aynı sınıfa ait özelliklerin ne kadar dağınık olduğu. Güvenilir fakat az örnekli nadir sınıf bilgisinin ağırlığı yükseltilirken düşük güvenilirlik veya yüksek dağılma, katkının aşırı büyümesini sınırlar.
Çıktı güvenilirliği
Sınıf \(c\) için bilgi güvenilirliği kaynakta:
\[ \rho_{k,c} = 1- \frac{1} {n_{k,c}\log C} \sum_{i:y_{k,i}=c} H(q^T_{k,i}) \tag{8} \]
olarak tanımlanır. Entropi düşükse çıktı dağılımı daha kararlıdır ve \(\rho_{k,c}\) yükselir.
Sınıf-içi dağılım
\[ d_{k,c} = \frac{1}{n_{k,c}} \sum_{i:y_{k,i}=c} \left\| \frac{h_{k,i}}{\|h_{k,i}\|_2} - \pi_{k,c} \right\|_2^2 \tag{9} \]
Büyük \(d_{k,c}\), aynı sınıfa ait özelliklerin prototip çevresinde daha dağınık olduğunu gösterir.
Sınıf düzeyinde federatif ağırlık
Kaynak Denklem (10)'da ağırlığı şu yapı ile verir:
\[ \alpha_{k,c} = \frac{ \exp\!\left( \beta_r r_{k,c} + \beta_\rho \rho_{k,c} - \beta_d d_{k,c} \right)} { \sum_{j\in K_c} \exp\!\left( \beta_r r_{j,c} + \beta_\rho \rho_{j,c} - \beta_d d_{j,c} \right)} \tag{10} \]
\[ r_{k,c} = \frac{1}{\log(e+n_{k,c})} \]
Burada \(r_{k,c}\) sınıf seyrekliğini ifade eder. Çalışmanın seçtiği ayar \((\beta_r,\beta_\rho,\beta_d)=(1.0,1.0,0.5)\)'tir. Kaynak formül gösteriminde ilk katsayılar bir yerde \(\beta_1,\beta_2,\beta_3\) olarak basılmış, açıklama ve sonraki deneylerde ise \(\beta_r,\beta_\rho,\beta_d\) kullanılmıştır; burada bilimsel anlam değiştirilmeden ikinci, deneylerle tutarlı adlandırma kullanılmış ve kaynak notasyon farkı bibliyografik notta belirtilmiştir.
İlişkilerin global birleşimi
Sunucu sınıf prototiplerini ve iki ilişki matrisini ağırlıklı olarak birleştirir:
\[ \pi_c = \sum_{k\in K_c} \alpha_{k,c}\pi_{k,c} \tag{11a} \]
\[ R^p(c,c') = \sum_{k\in K_{c,c'}} \alpha_{k,c,c'}R^p_k(c,c'), \qquad R^s(c,c') = \sum_{k\in K_{c,c'}} \alpha_{k,c,c'}R^s_k(c,c') \tag{11b} \]
Global öğretmenin optimizasyonu
Öğretmen model yalnız sınıflandırma kaybıyla değil çıktı, prototip ve hassasiyet ilişkilerinin birlikte korunmasıyla eğitilir:
\[ L_G = L^{ce}_0 + \lambda_oT^2 KL(\bar q^T\|q_G^T) + \lambda_p \|R_G^p-R^p\|_F^2 + \lambda_s \|R_G^s-R^s\|_F^2 \tag{12} \]
\[ \theta_G^{t+1} = \theta_G^t - \eta_G\nabla_{\theta_G}L_G \]
\(L_0^{ce}\), sunucudaki etiketli anchor/kalibrasyon seti üzerinde hesaplanan denetimli kayıptır. Kaynağa göre etiketli anchor veri bulunmuyorsa bu terim çıkarılabilir ve öğretmen yalnız damıtım ile ilişki kısıtlarından güncellenebilir.
Kapılı Dinamik Model İnceltme Nadir Arızaları Nasıl Korumaya Çalışır?
Öğrenci ağında her özellik kanalına öğrenilebilir bir kapı atanır. Seyreklik cezası düşük katkılı kanalları sıfıra doğru iterken çıktı, sınıf-prototip ve hassasiyet ilişkisi kayıpları nadir arıza ayrımı için gerekli kanalları korur; nihai kanal kümesi ayrıca genel doğruluk ve nadir-arıza recall toleranslarını geçmek zorundadır.
Öğrenilebilir kanal kapıları
\[ m_l=\sigma(a_l), \qquad \tilde h_{S,l}=m_l\odot h_{S,l} \tag{13} \]
\(a_l\) öğrenilen kapı parametresi, \(\sigma\) sigmoid fonksiyonu, \(m_l\) kanal tutma derecesidir. Küçük \(m_l\), kanalın ilişki-koruyan teşhise düşük katkı verdiğini ifade eder.
Öğrenci model kaybı
\[ \begin{aligned} L_S ={}& L_S^{ce} + \mu_oT^2KL(q_G^T\|q_S^T) + \mu_p\|R_G^p-R_S^p\|_F^2 \\ &+ \mu_s\|R_G^s-R_S^s\|_F^2 + \mu_g\sum_l\|m_l\|_1 + \mu_b\sum_l\|m_l(1-m_l)\|_1 \end{aligned} \tag{14} \]
Deneylerde \(\mu_o=1.0\), \(\mu_p=\mu_s=0.5\), \(\mu_g=10^{-4}\) ve \(\mu_b=10^{-3}\) kullanılmıştır. Son iki terim kanalları seyrekleştirmeyi ve kapıları belirsiz ara değerler yerine 0 veya 1'e yaklaştırmayı amaçlar.
Kanal seçim eşiği
\[ M_S^* = \left\{ j\mid \bar m_{l,j}\ge\xi,\ j\in M_S \right\} \tag{15} \]
Başlangıç tutma eşiği \(\xi=0.5\)'tir. Performans koruma koşulu sağlanmazsa eşik 0,05 azaltılıp öğrenci yeniden ince ayarlanır.
Aşırı sıkıştırmayı engelleyen koşul
\[ Acc(F_S^*) \ge Acc(F_G)-\delta_a \]
\[ Rec_{\mathrm{rare}}(F_S^*) \ge Rec_{\mathrm{rare}}(F_G)-\delta_r \tag{16} \]
Bu kriter yalnız çevrimdışı model seçimi ve inceltme aşamasında kullanılır. Çevrimiçi uç cihaz çıkarımında nadir arıza etiketi gerekmez.
Deney mimarisi ve eğitim parametreleri
| Öğe | Ayar |
|---|---|
| İstemci sayısı | 3 istemci her federatif turda katılıyor |
| Yerel eğitim | Her turda 5 yerel epoch |
| CWRU kalibrasyon seti | Sınıf başına 5 etiketli örnek |
| HUST kalibrasyon seti | Sınıf başına 10 etiketli örnek |
| Öğretmen mimarisi | 3 adet Conv–BN–ReLU–Pool bloklu 1D-CNN |
| Öğrenci | Daha dar 1D-CNN + konvolüsyon bloklarından sonra öğrenilebilir kanal kapıları |
| HUST modeli | Titreşim ve akustik için iki paralel dal, ardından füzyon |
| Optimizer | Adam |
| Yerel/öğretmen öğrenme hızı | \(1\times10^{-3}\) |
| Öğrenci öğrenme hızı | \(5\times10^{-4}\) |
| Kapı öğrenme hızı | \(1\times10^{-3}\) |
| Batch size | 64 |
| Maksimum federatif tur | 100 |
| Öğrenci eğitimi | En fazla 50 epoch |
| Sıcaklık | \(T=3\) |
| Tutma eşiği | \(\xi=0.5\) |
CWRU veri seti ve birleşik dengesizlik
CWRU deneyinde 1 HP yük, 1797 r/min dönüş hızı ve 48 kHz örnekleme frekansındaki veriler seçilmiştir. Birleşik dengesizlik senaryosunda Client 1, her sınıf için 20 örnek içeren 10 sınıflı fakat 2 dB gürültülü veriye ve nadir OR14 sınıfına sahiptir; Client 2 ve Client 3'te dokuz sınıf için sınıf başına 200 örnek vardır ve OR14 tamamen eksiktir.
| Yöntem | Ortalama doğruluk | Macro-F1 | OR14 recall |
|---|---|---|---|
| DNN | %53,0 | %50,6 | %18,0 |
| FedAvg | %64,0 | %60,8 | %34,0 |
| FedProx | %68,8 | %65,2 | %46,0 |
| FedProto | %72,9 | %70,5 | %56,0 |
| Fed-KD | %74,7 | %72,0 | %58,0 |
| Önerilen yöntem | %84,9 | %84,0 | %80,0 |
Kaynak karışıklık matrislerinde OR14'ün özellikle OR07 ve OR21 ile karıştırıldığını gösterir. Önerilen yöntemde bu karışıklık belirgin biçimde azalır. Bu sonuç, yalnız ortalama doğruluk artışından daha önemlidir; yöntemin tasarım amacı doğrudan nadir sınıf sınırını korumaktır.
HUST çok-modlu motor veri seti
HUST platformunda altı durum vardır: sağlıklı durum, rulman arızası, rotor eğriliği, kırık rotor çubuğu, rotor hizasızlığı ve gerilim dengesizliği. Çalışma 5, 10, 20 ve 30 Hz işletim frekanslarını ve 25,6 kHz örnekleme frekansını kullanır; her dosyada 163.840 veri noktası bulunur.
Parçalanmış modalite ve nadir BRB
| Yöntem | Ortalama doğruluk | Macro-F1 | BRB recall |
|---|---|---|---|
| FedAvg | %70,5 | %68,1 | %46,0 |
| FedBN | %75,1 | %73,6 | %52,0 |
| FedProto | %78,3 | %76,9 | %61,0 |
| FedDF | %79,6 | %78,2 | %63,0 |
| Fed-KD | %81,2 | %80,0 | %66,0 |
| FedSlim | %80,5 | %78,7 | %64,0 |
| Önerilen yöntem | %88,4 | %87,8 | %84,0 |
Görülmemiş 30 Hz koşuluna genelleme
Eğitim istemcileri 5, 10 ve 20 Hz koşullarını kullanırken 30 Hz tamamen test için ayrılmıştır.
| Yöntem | Ortalama doğruluk | Macro-F1 | BRB recall |
|---|---|---|---|
| Fed-KD | %76,8 | %75,1 | %61,0 |
| FedSlim | %75,0 | %72,8 | %59,0 |
| Önerilen yöntem | %84,3 | %83,5 | %78,0 |
Sayfa 23'teki t-SNE gösterimleri, önerilen yöntemde sınıf-içi kümelerin daha kompakt ve sınıflar arası ayrımın daha belirgin olduğunu göstermektedir. Bu bir görselleştirme bulgusudur; t-SNE tek başına nedensel veya kesin geometrik kanıt olarak yorumlanmamalıdır.
Uç cihazda modalite kaybı
Model eğitimde çift modalite görmesine rağmen dağıtım sırasında yalnız titreşim, yalnız akustik veya rastgele modalite kaybıyla sınanmıştır.
| Yöntem | Yalnız titreşim | Yalnız akustik | Rastgele modalite kaybı | BRB recall |
|---|---|---|---|---|
| Fed-KD | %82,5 | %79,0 | %80,8 | %66,0 |
| FedSlim | %81,7 | %78,2 | %79,6 | %64,0 |
| Önerilen yöntem | %89,2 | %84,6 | %87,4 | %83,0 |
Model boyutu ve gerçek ölçülen çıkarım maliyeti
Ölçümler NVIDIA RTX 3060Ti GPU, Intel i7 CPU, Python 3.9, PyTorch 1.13 ve CUDA 11.7 ortamında batch size 1 ile yapılmıştır. Önce 100 ısınma çalıştırması, ardından 1000 çıkarım tekrarı uygulanmıştır.
| Yöntem | Parametre | FLOPs | Çıkarım süresi | Bellek |
|---|---|---|---|---|
| FedAvg | 1,42 M | 3,84 M | 4,26 ms | 965,4 MiB |
| Fed-KD | 1,21 M | 3,10 M | 3,72 ms | 835,6 MiB |
| FedSlim | 0,74 M | 1,82 M | 2,64 ms | 628,2 MiB |
| Önerilen yöntem | 0,68 M | 1,55 M | 2,31 ms | 596,4 MiB |
Ablasyon Deneyleri Yöntemin Hangi Bileşenlerinin Kritik Olduğunu Gösteriyor?
CWRU birleşik dengesizlik ablasyonunda nadir-arıza ağırlıklandırmasını kaldırmak OR14 recall değerini %80'den %68'e düşürerek en büyük nadir-sınıf kaybını oluşturmuştur; prototip ilişkisi çıkarıldığında recall %72, girdiye-duyarlı ilişki çıkarıldığında %71 olmuştur. Kapılı inceltme kaldırıldığında performans hafifçe yükselmiş fakat parametre oranı 0,48'den 1,00'a çıkmıştır; dolayısıyla kapılama esas olarak performans–dağıtım maliyeti dengesini sağlar.
| Varyant | Ortalama doğruluk | Macro-F1 | OR14 recall | Parametre oranı |
|---|---|---|---|---|
| Fed-KD tabanı | %74,7 | %72,0 | %58,0 | 0,85 |
| Çıktı bilgisi olmadan | %82,4 | %81,0 | %74,0 | 0,48 |
| Prototip ilişkisi olmadan | %81,8 | %80,4 | %72,0 | 0,48 |
| Hassasiyet ilişkisi olmadan | %82,1 | %80,7 | %71,0 | 0,48 |
| Nadir-arıza ağırlığı olmadan | %81,5 | %80,2 | %68,0 | 0,48 |
| Kapılı inceltme olmadan | %85,8 | %84,9 | %82,0 | 1,00 |
| Tam yöntem | %84,9 | %84,0 | %80,0 | 0,48 |
Ağırlık katsayılarının duyarlılığı
Seçilen \((1.0,1.0,0.5)\) katsayı seti %84,9 doğruluk, %84,0 Macro-F1 ve %80 OR14 recall ile test edilen seçenekler içinde en iyi dengeyi vermiştir. Seyreklik terimi çıkarıldığında OR14 recall %72'ye, güvenilirlik terimi çıkarıldığında %70'e düşmektedir. Dağılım cezasının 1,0'a yükseltilmesi de OR14 recall'u %76'ya indirir; bu, küçük örnekli fakat yararlı nadir sınıf bilgisini fazla bastırmanın sakıncasını göstermektedir.
Tekrarlı deneyler ve istatistiksel anlamlılık
Deneyler farklı rastgele tohumlar ve yeniden oluşturulan istemci bölümleriyle beş kez tekrarlanmıştır. Önerilen yöntem ile ana güçlü distilasyon tabanı Fed-KD arasında eşleştirilmiş t-testi uygulanmış ve ana nadir-sınıf sonuçlarında \(p<0.01\) raporlanmıştır. Örneğin CWRU OR14 recall değeri Fed-KD için \(58\pm2.6\), önerilen yöntem için \(80\pm1.8\)'dir.
Çalışmanın söylediği ve söylemediği
Desteklediği: İncelenen CWRU ve HUST benchmark senaryolarında çok-granüler ilişki bilgisi, nadir-arızaya duyarlı federatif ağırlıklandırma ve kapılı inceltmenin birleşimi, seçilen karşılaştırma yöntemlerinden daha yüksek nadir-sınıf recall ve daha düşük uç dağıtım maliyeti sağlamıştır.
Desteklediği: Geleneksel kanal inceltmesi yerine ilişki koruma kısıtlarıyla kanal seçmek, test edilen senaryolarda nadir arıza bilgisini sıkıştırma sırasında daha iyi korumuştur.
Desteklemediği: Ham verinin gönderilmemesi, diferansiyel gizlilik veya kriptografik güvenlik düzeyinde biçimsel bir gizlilik garantisi değildir.
Desteklemediği: Üç istemci ve kontrollü non-IID dağılımlarda alınan sonuçlar, yüzlerce gerçek fabrika istemcisine doğrudan ölçekleneceğini kanıtlamaz.
Desteklemediği: Kamu veri setlerindeki başarı gerçek endüstriyel saha koşullarında aynı doğruluk veya gecikmenin garanti edildiği anlamına gelmez.
Yazarların gelecek çalışma alanları: daha ölçeklenebilir agregasyon, belirsizlik-duyarlı ağırlıklandırma, veri sürüklenmesine duyarlı güncelleme ve gerçek kurum-içi/endüstriyel çok-istemcili motor veri setlerinde doğrulama.
Kaynak ve Yöntem Notu
Özgün başlık: Relation Knowledge-Guided Federated Model Compression for Rare-Fault Preservation in Motor Fault Diagnosis
Yazarlar: Genbao Zhao; Juan Zhang
Sorumlu yazar: Juan Zhang
Afiliyasyon: Kaynak PDF'de “Automation with the College of Information Science and Engineering, Northeastern University, Shenyang 110000, China” biçiminde verilmiştir.
Dergi: Machines
Yayınevi: MDPI, Basel, Switzerland
Cilt / Sayı / Makale: 14(6), 689
DOI: 10.3390/machines14060689
Alınma tarihi: 14 Mayıs 2026
Revizyon: 8 Haziran 2026
Kabul: 11 Haziran 2026
Yayın: 15 Haziran 2026
Kaynak türü: Hakemli araştırma makalesi.
Lisans: Creative Commons Attribution (CC BY), kaynak PDF ve resmî MDPI yayın kaydıyla doğrulanmıştır.
Finansman: Yazarlar dış finansman alınmadığını bildirmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını bildirmiştir.
Veri erişilebilirliği: Kaynak, kullanılan verilerin makale içinde sunulduğunu bildirmektedir. Deneylerde CWRU ve HUST kamu veri setleri kullanılmıştır.
Yazar katkıları: Methodology: G.Z. ve J.Z.; writing—original draft: G.Z.; writing—review and editing: J.Z.
AI kullanım bildirimi: Yazarlar, makaledeki Şekil 1–4'ün algoritma uygulama sürecinin okunabilirliğini artırmak amacıyla ChatGPT 5.5 yardımıyla çizildiğini açıkça bildirmiştir.
Görsel hak notu: Verianla metni kaynak figürlerinin görsel düzenini kopyalamaz. Özellikle CWRU ve HUST deney platformu görüntülerinin kaynak zinciri ayrı olduğundan bu fotoğraflar doğrudan yeniden kullanılmamıştır.
Kaynak içi notasyon/editoryal notlar: Denklem (10)'da katsayıların sembolleri formül ve açıklama arasında farklı adlandırılmıştır; daha sonraki deney tabloları \(\beta_r,\beta_\rho,\beta_d\) gösterimini kullanır. Sayfa 19'da Şekil 9'u tartışan paragrafta “Figure 8” ifadesi bulunur. CWRU karışıklık matrisi anlatımında “quantization” adı geçmesine rağmen ilgili ana sonuç tablosunda ayrı bir quantization satırı yoktur. Bu noktalar yeni veri üretilerek düzeltilmemiştir.
Temel yöntemsel sınırlılıklar: Üç istemciyle sınırlı deneyler, kontrollü non-IID dağılımlar, yalnız iki kamu veri seti, online veri sürüklenmesinin doğrudan test edilmemesi ve biçimsel gizlilik garantisinin bulunmaması.
Verianla işleme yöntemi: Kaynak metin satır veya paragraf bazında çevrilmemiştir. Model mimarisi, denklem zinciri, deney koşulları, veri setleri, performans sonuçları, ablasyon, dağıtım maliyeti ve sınırlılıklar ayrı bilimsel öğelere ayrılmış; ardından bağımsız öğretici yapıda yeniden kurulmuştur.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir