

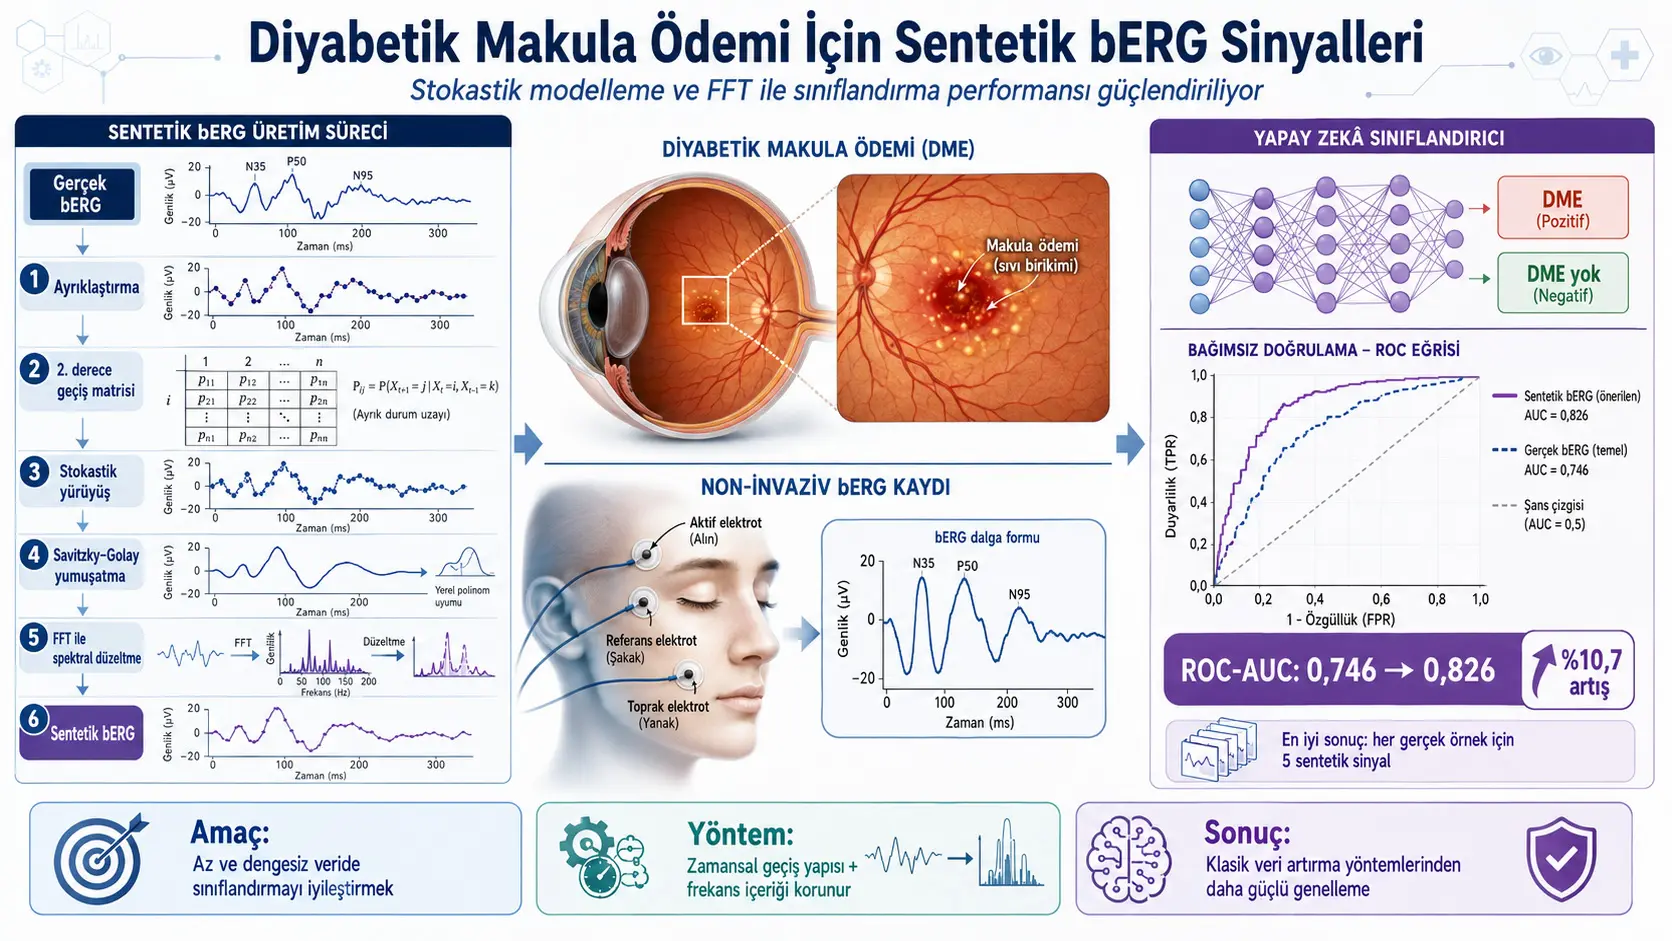
Diyabetik makula ödemi, tip 2 diyabetli bireylerde görme kaybına yol açabilen önemli bir retina komplikasyonudur. Makula, retinanın merkezi görmeden sorumlu bölgesidir. Diyabetik makula ödeminde bu bölgede retina kalınlaşması ve hücre dışı sıvı birikimi görülür. Çalışmada bu durumun dünya genelinde bildirilen prevalansının %3,2 ile %11 arasında değişebildiği belirtilir. Ayrıca diyabet süresi uzadıkça risk artmakla birlikte, erken hastalık dönemlerinde de diyabetik makula ödemi gelişebildiği için erken saptamanın oftalmolojik yönetimde önemli olduğu vurgulanır.
Geleneksel klinik değerlendirmede diyabetik makula ödemi tanısı, optik koherens tomografi yani OCT bulgularına dayanır. Bu çalışmada da diyabetik makula ödemi tanısı sertifikalı oftalmologlar tarafından OCT’de yaygın retina kalınlaşması, hücre dışı sıvı birikimi, kistoid boşluklar veya yapısal değişiklikler gibi bulgulara göre konmuştur. Dolayısıyla araştırmadaki bERG tabanlı sınıflandırma, klinik tanının yerine geçen bağımsız bir kesin tanı yöntemi olarak değil, mevcut klinik görüntüleme ve değerlendirme yaklaşımlarını tamamlayabilecek bir biyosinyal temelli sınıflandırma problemi olarak ele alınmıştır.
Çalışmanın merkezindeki biyosinyal bazal elektroretinogramdır. Klasik elektroretinogram uygulamalarında retinaya ışık uyarısı verilir ve retinanın bu uyarıya elektriksel yanıtı ölçülür. Bazal elektroretinogramda ise dış görsel uyarı verilmeden, fotopik yani gün ışığı koşullarında retinanın spontan elektriksel aktivitesi kaydedilir. Bu yönüyle bERG, retina fonksiyonundaki içsel dalgalanmaları yakalamaya çalışan non-invaziv bir ölçüm yaklaşımıdır. Çalışmada bERG’nin taşınabilir ERG cihazları ve cilt elektrotlarıyla kaydedilebildiği için retina taraması ve erken fonksiyonel bozulma tespiti açısından pratik potansiyel taşıdığı belirtilir.
Ancak bERG sinyallerinin otomatik sınıflandırmada kullanılmasını zorlaştıran iki temel sorun vardır. Birincisi veri azlığıdır. Belirli retina hastalıklarına sahip iyi tanımlanmış hasta gruplarından kaliteli biyosinyal kaydı toplamak zaman, maliyet ve klinik iş birliği gerektirir. İkincisi sınıf dengesizliğidir. Bu çalışmada diyabetik makula ödemi bulunan kayıt sayısı 74 iken, diyabetik makula ödemi bulunmayan kayıt sayısı 356’dır. Yapay zekâ modelleri böyle dengesiz veri setlerinde çoğunluk sınıfını daha iyi öğrenip azınlık sınıfı olan hastalıklı örnekleri daha zor ayırt edebilir.
Veri artırma, bu tip sorunları hafifletmek için kullanılan bir yaklaşımdır. Amaç, mevcut veriden yeni eğitim örnekleri üretmektir. Görüntü verilerinde döndürme, kırpma, parlaklık değiştirme gibi yöntemler sık kullanılır. Zaman serilerinde ise jittering, zaman kaydırma, faz rastgeleleştirme, interpolasyon ve MixUp gibi yöntemler uygulanabilir. Fakat araştırmacılar, bERG gibi karmaşık bir biyosinyalde bu klasik tekniklerin sinyalin altında yatan fizyolojik ve spektral yapıyı yeterince temsil etmeyebileceğini savunur.
Bu eleştiri önemlidir; çünkü cilt elektrotlarıyla alınan bERG sinyali yalnızca retina aktivitesinden oluşmayabilir. Çalışmada bu sinyallerin retina aktivitesinin yanı sıra glial sinyalleşme, kardiyak ritim, solunum ritmi, kas aktivitesi, cihaz kaynaklı elektriksel gürültü, elektrot-cilt arayüzü değişkenliği ve hareket artefaktları gibi birçok kaynaktan etkilenebileceği belirtilir. Yani bERG, tek bir düzgün dalga değil; farklı biyolojik ve biyolojik olmayan kaynakların üst üste bindiği, zamansal ve frekanssal yapısı olan karmaşık bir sinyaldir.
Bu nedenle çalışma, bERG sinyalini stokastik bir süreç olarak modellemeyi önerir. Stokastik süreç, zaman içinde ilerleyen ve her adımda belirli olasılıklara göre değişen bir sistem olarak düşünülebilir. Buradaki temel fikir şudur: Sinyalin bir sonraki değeri tamamen rastgele değildir; önceki değerlerden etkilenir. Örneğin kalp ritmi, solunum döngüsü veya retina-glia etkileşimleri gibi fizyolojik süreçlerde mevcut durum önceki durumların izini taşır. Bu çalışmada bu kısa süreli hafıza etkisini yakalamak için ikinci dereceden geçiş matrisi kullanılmıştır.
Çalışmada açıkça kullanılan temel uzunluk ilişkisi şudur:
\[ n = f_s \cdot s \]
Burada n, üretilecek sentetik sinyalin örnek sayısını; f_s, örnekleme frekansını; s ise saniye cinsinden istenen sinyal süresini ifade eder. Çalışmada sentetik parçalar 20 saniye olarak ayarlanmıştır. Sinyaller ön işlemden sonra 200 Hz’e yeniden örneklendiği için 20 saniyelik bir parça yaklaşık 4.000 örnek içerir. Bu ilişki, zaman serisi üretiminde “kaç noktalık sinyal oluşturulacak?” sorusunun matematiksel karşılığıdır.
İkinci dereceden geçiş matrisi mantığını açıklamak için şu temel ilişki kullanılabilir:
\[ P(X_t = x_k \mid X_{t-1}=x_j, X_{t-2}=x_i) \]
Burada X_t, sinyalin t anındaki ayrık durumunu; x_i, x_j ve x_k voltaj düzeylerinden türetilen ayrık durumları; P ise koşullu geçiş olasılığını ifade eder. Bu formül çalışmanın mantığını açıklamak için verilmiştir. Birinci dereceden model yalnızca bir önceki duruma bakarken, ikinci dereceden model iki önceki durumu dikkate alır. Böylece sinyalin kısa süreli hafızası daha gerçekçi temsil edilebilir.
Çalışmanın üretim hattı Şekil 1’de özetlenmiştir. İlk olarak 240 saniyelik gerçek bERG sinyali voltaj ekseninde belirli sayıda ayrık duruma bölünür. Bu işlem, sürekli genlik değerlerini sınırlı sayıda sembolik duruma dönüştürür. Ardından bu ayrık dizi ikinci dereceden geçiş matrisiyle modellenir. Geçiş olasılıkları Laplacian smoothing ile düzenlenir; bu düzenleme, bazı geçişlerin hiç gözlenmemesi nedeniyle modelin aşırı katı hale gelmesini önlemeye yarar. Daha sonra bu olasılıklara göre rastgele yürüyüş üretilir. Bu yürüyüş, sinyalin kaba sentetik iskeletini oluşturur.
Rastgele yürüyüşle üretilen diziler ayrık durum geçişlerinden geldiği için doğal sinyalden daha keskin ve basamaklı olabilir. Bu nedenle araştırmacılar Savitzky–Golay filtresi kullanarak sinyali yumuşatmıştır. Bu filtre, sinyalin genel şeklini korumaya çalışırken ani keskin geçişleri azaltır. Filtrenin pencere uzunluğu ve polinom derecesi ayarlanabilir parametreler olarak ele alınmıştır. Optimize edilen nihai parametrelerde Savitzky–Golay pencere boyutu 45, polinom derecesi 4 olarak seçilmiştir.
Yöntemin ikinci büyük bileşeni frekans alanı düzeltmesidir. Sinyal yalnızca zaman eksenindeki dalgalanmalardan oluşmaz; aynı zamanda hangi frekans bileşenlerinin ne kadar güçlü olduğuyla da tanımlanır. Bu nedenle çalışma, Hızlı Fourier Dönüşümü yani FFT kullanarak gerçek ve sentetik sinyal parçalarının frekans spektrumlarını karşılaştırmıştır. FFT’nin temel mantığı şu ilişkiyle anlaşılabilir:
\[ X_k = \sum_{n=0}^{N-1} x_n e^{-i2\pi kn/N} \]
Burada x_n, zaman alanındaki sinyal örneklerini; X_k, k frekans bileşenindeki karmaşık Fourier katsayısını; N, toplam örnek sayısını; i ise sanal birimi ifade eder. Bu formül, çalışmanın kullandığı FFT yaklaşımını açıklamak için verilen temel arka plan ilişkisidir. Basitçe söylenirse FFT, sinyali “zaman içinde nasıl değişiyor?” sorusundan “hangi frekanslarda ne kadar enerji taşıyor?” sorusuna dönüştürür.
Çalışmada gerçek sinyallerin her frekans bileşeni için minimum ve maksimum büyüklük aralıkları hesaplanmıştır. Sentetik sinyalin belirli bir frekanstaki büyüklüğü bu gerçek aralığın dışına çıkarsa, bu büyüklük gerçek veride gözlenen aralık içinde rastgele yeniden atanmıştır. Faz bilgisi korunmuş, ardından ters FFT uygulanarak son sentetik sinyal elde edilmiştir. Bu aşama, sentetik sinyalin yalnızca zaman alanında değil, spektral yapıda da gerçek bERG’ye benzemesini amaçlar.
Model parametreleri kapsamlı biçimde optimize edilmiştir. Araştırmacılar 3.456 parametre konfigürasyonunu grid search ile değerlendirmiştir. Optimizasyon yalnızca eğitim setinden çıkarılan 20 saniyelik ayrık sinyal parçaları üzerinde ve DME ile DME olmayan sınıflar için ayrı yürütülmüştür. Bu yaklaşım veri sızıntısını önlemek için önemlidir; çünkü doğrulama verisi sentetik sinyal üretiminin veya parametre seçiminin parçası haline gelirse modelin gerçek bağımsız performansı olduğundan yüksek görünebilir.
Gerçek ve sentetik sinyallerin benzerliği tek bir ölçüyle değerlendirilmemiştir. Hata tabanlı ölçüler olarak MSE ve MAE; benzerlik ve uyum ölçüleri olarak Pearson korelasyonu ve Lin’in uyum korelasyon katsayısı; dağılım uzaklıkları olarak Minkowski, Wasserstein ve Jensen–Shannon divergence; karmaşıklık için örnek entropisi, spektral entropi ve karşılıklı bilgi; dinamik özellikler için Hjorth activity, mobility ve complexity kullanılmıştır. Bu geniş ölçüm seti, sinyalin yalnızca ortalama hatasına değil, dağılımına, frekans yapısına, düzensizliğine ve dinamik karakterine de bakıldığını gösterir.
Şekil 2, hem parametre optimizasyonunu hem de gerçek-sentetik eşdeğerlik analizini gösterir. Optimize edilen nihai parametreler β = 0, Savitzky–Golay pencere boyutu 45, Savitzky–Golay polinom derecesi 4, α = 1e−20 ve ikinci dereceden geçiş matrisi için 200 durum olarak bildirilmiştir. Aynı şeklin eşdeğerlik panelinde, DME ve DME olmayan sınıflar için tüm metriklerde güven aralıklarının eşdeğerlik sınırları içinde kaldığı görülür. Bu, sentetik sinyallerin tek tek gerçek kayıtların kopyası olduğu anlamına gelmez; ancak popülasyon düzeyinde gerçek sinyallerle istatistiksel, spektral ve dinamik olarak uyumlu davrandığını gösterir.
Çalışmada eşdeğerlik değerlendirmesi TOST yaklaşımıyla yapılmıştır. TOST, iki tek yönlü test mantığına dayanır ve “iki grup arasında fark yoktur” demekten daha dikkatli bir istatistiksel çerçeve sunar. Araştırmacılar her metrik için eşdeğerlik sınırını, gerçek-referans karşılaştırmalarından hesaplanan ortalamanın %5’i olarak tanımlamış, çok dar sınırları önlemek için en az 0,05 mutlak alt sınır kullanmıştır. Sentetik-gerçek farklarının %95 güven aralıkları bu sınırların içinde kaldığında eşdeğerlik kabul edilmiştir.
Çalışmanın sınıflandırma tarafında, model mimarisi iki dallıdır. Birinci dal, zaman alanındaki özellikleri yakalamak için 1D konvolüsyonel sinir ağı kullanır. İkinci dal, frekans alanındaki özellikleri yakalamak için öğrenilebilir FFT tabanlı bir bloktan yararlanır. Her iki dalın çıkardığı temsiller Transformer encoder yapılarıyla işlenir; bu sayede daha uzun aralıklı zaman bağımlılıkları modellenir. Son aşamada birleşik temsil tam bağlantılı ağ ve sigmoid aktivasyonla iki sınıflı sınıflandırmaya dönüştürülür: DME var veya DME yok.
Şekil 3, veri artırma kullanılmadan elde edilen temel sınıflandırma performansını gösterir. Eğitim ve iç test eğrileri yaklaşık 0,80 doğruluk düzeyine yakınsayarak kararlı öğrenme göstermiştir. Ancak bağımsız doğrulama setinde ROC-AUC 0,746’dır. Duyarlılık 0,704, özgüllük 0,697, doğruluk 0,631, kesinlik 0,232, F1 skoru 0,357 ve Cohen kappa 0,194 olarak verilmiştir. Karmaşıklık matrisinde 119 doğru pozitif, 33 yanlış negatif, 395 yanlış pozitif ve 612 doğru negatif bulunur. Yanlış pozitif sayısının yüksek olması, sınıf dengesizliği ve sinyalin zor sınıflandırılabilir yapısıyla uyumludur.
Veri artırma eklendiğinde performansın nasıl değiştiği Şekil 4 ve Şekil 5’te gösterilmiştir. Araştırmacılar her gerçek örnek için 1’den 10’a kadar sentetik sinyal üretimini denemiş, performansın beş sentetik sinyale kadar iyileştiğini, daha fazla artırmada ise özellikle bağımsız doğrulamada gerilediğini bulmuştur. Bu nedenle kontrollü karşılaştırmalar 1–5 sentetik sinyal aralığında yapılmıştır. Beş sentetik sinyal kullanıldığında eğitim kaybı 0,391’den 0,329’a, iç test kaybı 0,395’ten 0,268’e düşmüştür. Eğitim doğruluğu 0,819’dan 0,851’e, iç test doğruluğu 0,810’dan 0,895’e yükselmiştir.
Asıl önemli nokta, performansın bağımsız doğrulama setinde artmasıdır. Çünkü bu set yalnızca gerçek ve artırılmamış sinyallerden oluşur; model eğitimi veya sentetik sinyal üretimi için kullanılmamıştır. Stokastik veri artırma ile ROC-AUC değerleri sentetik örnek sayısı arttıkça yükselmiştir: veri artırma olmadan 0,746, 1:1 artırmada 0,751, 2:1 artırmada 0,770, 3:1 artırmada 0,786, 4:1 artırmada 0,816 ve 5:1 artırmada 0,826. Üç sentetik örnekten itibaren iyileşme istatistiksel olarak anlamlı, dört ve beş sentetik örnekte ise daha güçlü anlamlılık düzeyindedir.
Beş sentetik sinyal per gerçek örnek kullanıldığında, duyarlılık veri artırma kullanılmayan modele kıyasla anlamlı biçimde değişmemiştir: 0,762’ye karşı 0,749. Buna karşılık özgüllük 0,607’den 0,777’ye, doğruluk 0,631’den 0,776’ya, F1 skoru 0,357’den 0,474’e, kesinlik 0,231’den 0,343’e ve Cohen kappa 0,194’ten 0,358’e yükselmiştir. Bu tablo, yöntemin özellikle yanlış pozitifleri azaltarak ve genel ayırt ediciliği iyileştirerek katkı sağladığını gösterir. DME vakalarını yakalama gücü yani duyarlılık ise anlamlı düzeyde artmamıştır; bunun olası nedeni DME sınıfındaki gerçek kayıt sayısının sınırlı olmasıdır.
Şekil 6, önerilen yöntemi klasik zaman serisi veri artırma yöntemleriyle karşılaştırır. Aynı sayıda, yani her gerçek örnek için beş sentetik örnek üretilerek jittering, zaman kaydırma, faz rastgeleleştirme, interpolasyon ve MixUp denenmiştir. İlginç biçimde bu klasik yöntemler eğitim ve iç test aşamasında daha düşük kayıp veya daha yüksek doğruluk gösterebilmiştir. Ancak bağımsız doğrulama setinde önerilen stokastik yöntem açık biçimde daha iyi performans vermiştir. Stokastik yöntemin AUC değeri 0,826 iken, jittering 0,749, zaman kaydırma 0,733, faz rastgeleleştirme 0,729, interpolasyon 0,733 ve MixUp 0,735 düzeyinde kalmıştır.
Bu sonuç, makalenin ana bilimsel mesajlarından biridir: Eğitim setinde iyi görünen veri artırma yöntemi, gerçek bağımsız hasta verisinde en iyi genellemeyi sağlamayabilir. Klasik yöntemler orijinal sinyale lokal veya deterministik dönüşümler uygular; bu nedenle bazı sınıfa özgü gürültüleri veya artefaktları da koruyabilir. Önerilen stokastik yöntem ise sinyalin olasılıksal geçiş yapısını ve frekans profilini modelleyerek daha yeni ama fizyolojik olarak makul örnekler üretmeye çalışır. Bu da bağımsız doğrulamada daha güçlü genelleme sağlayabilir.
Çalışmanın geçmiş açısından önemi, biyomedikal sinyal sınıflandırmasında veri azlığı ve sınıf dengesizliği sorununa klasik veri artırmanın ötesinde fizyolojik süreçle uyumlu bir çözüm önermesidir. Özellikle ERG gibi retina sinyalleri için daha önce sentetik veri üretiminde generative adversarial network gibi büyük veri gerektiren modeller kullanılmıştır. Bu çalışma ise daha küçük ve dengesiz veri setlerinde çalışabilecek, daha yorumlanabilir ve daha basit bir stokastik üretim çerçevesi sunar.
Bugün açısından önemi, diyabetik makula ödemi gibi görme kaybıyla ilişkili bir klinik problemin erken saptanmasına destek olabilecek yapay zekâ modellerinde eğitim verisinin nasıl güçlendirilebileceğini göstermesidir. bERG taşınabilir cihazlarla non-invaziv biçimde alınabildiği için, uzun vadede retina taraması ve karar destek sistemlerinde tamamlayıcı bir sinyal olabilir. Ancak bu çalışma böyle bir klinik sistemin hazır olduğunu göstermemektedir; yalnızca sınıflandırma modelinin eğitiminde sentetik veri kullanımının performansı artırabileceğini göstermektedir.
Gelecek açısından çalışma, yalnızca bERG için değil, EEG, EKG, solunum sinyali veya diğer fizyolojik zaman serileri için de benzer stokastik ve frekans alanı kontrollü veri artırma yaklaşımlarının denenebileceğini düşündürür. Ancak her sinyal türü, her hastalık ve her kayıt protokolü için aynı parametrelerin geçerli olacağı söylenemez. Yazarlar da yöntemin başka retinal koşullara, farklı cihazlara veya başka tanısal hedeflere uygulanması durumunda parametrelerin yeniden optimize edilmesi gerekebileceğini belirtir.
Gündelik yaşama etkisi açısından bu çalışma, yapay zekânın tıpta güvenilir çalışabilmesi için yalnızca güçlü algoritmalara değil, yeterli ve dengeli eğitim verisine de ihtiyaç duyduğunu gösterir. Diyabet gibi yaygın bir hastalıkta görme kaybını önlemek için erken tarama kritik olabilir. Fakat her klinik merkezde büyük ve dengeli biyosinyal veri setleri bulunmaz. Gerçek verinin yapısını bozmadan sentetik eğitim sinyali üretmek, ileride daha erişilebilir karar destek araçlarının geliştirilmesine katkı sağlayabilir. Yine de bu, hastaların tek başına yapay zekâ sonucuyla tanı alacağı anlamına gelmez; klinik değerlendirme, OCT ve uzman hekim yorumu hâlâ belirleyicidir.
Çalışmanın güçlü yönleri arasında hasta düzeyinde veri bölme yapılarak veri sızıntısının önlenmesi, sentetik verinin yalnızca eğitim setine uygulanması, bağımsız doğrulama setinin gerçek ve artırılmamış sinyallerden oluşması, çok sayıda eşdeğerlik metriği kullanılması, klasik veri artırma yöntemleriyle doğrudan karşılaştırma yapılması ve farklı performans metriklerinin raporlanması yer alır. Ayrıca yöntem, bERG sinyalinin hem zaman hem frekans özelliklerini korumaya çalıştığı için biyosinyalin yapısına daha saygılı bir veri artırma stratejisi sunar.
Sınırlılıklar da açıkça görülmektedir. Çalışma hakem değerlendirmesinden geçmemiş preprinttir. Veri setinde DME kayıtları azdır: 430 kaydın yalnızca 74’ü DME sınıfına aittir. Bu sınıf dengesizliği, duyarlılığın anlamlı biçimde artırılamamasının ve bazı metriklerin orta düzeyde kalmasının nedeni olabilir. Veriler iki klinik merkezden ve iki farklı kayıt sisteminden elde edilmiştir; bu durum cihaz veya merkez kaynaklı değişkenlik yaratabilir. Sentetik sinyaller popülasyon düzeyinde eşdeğer bulunmuştur; ancak bu, her bir sentetik sinyalin bireysel klinik gerçekliği kusursuz temsil ettiği anlamına gelmez. Ayrıca yöntem yalnızca diyabetik makula ödemi sınıflandırması için test edilmiştir; diğer retinal hastalıklara genellenebilirliği gösterilmemiştir.
Çalışmanın söylediği şey şudur: bERG gibi karmaşık fizyolojik zaman serilerinde, ikinci dereceden stokastik geçiş matrisi ve FFT tabanlı spektral düzeltme kullanarak gerçek sinyallere istatistiksel olarak eşdeğer sentetik sinyaller üretmek mümkündür. Bu sentetik sinyaller eğitim verisine kontrollü biçimde eklendiğinde, bağımsız doğrulama setinde diyabetik makula ödemi sınıflandırma performansı artmıştır.
Çalışmanın söylemediği şey ise şudur: Bu yöntem diyabetik makula ödemini klinikte tek başına güvenilir biçimde tanır dememektedir. bERG, OCT’nin veya oftalmolog değerlendirmesinin yerini alır dememektedir. Sentetik veriler gerçek hastaların tüm biyolojik çeşitliliğini eksiksiz temsil eder dememektedir. Ayrıca modelin farklı ülkelerde, cihazlarda, klinik popülasyonlarda veya daha büyük veri setlerinde aynı performansı göstereceği henüz kanıtlanmamıştır.
Çalışmanın Yöntemi ve Bulguları
Çalışma, diyabetik makula ödemi sınıflandırması için bERG sinyallerinden sentetik eğitim verisi üretmeye yönelik bir yöntem geliştirme ve doğrulama çalışmasıdır. Yöntem, gerçek sinyallerin zaman alanındaki geçiş istatistiklerini ve frekans alanındaki spektral yapısını korumayı amaçlar.
| Yöntem Bileşeni | Çalışmada Nasıl Kullanıldı? | Bilimsel Anlamı |
|---|---|---|
| İnsan verisi | 321 yetişkin katılımcıdan veri toplanmış, 233 katılımcı çalışmanın gerektirdiği tüm prosedürleri tamamlamıştır. | Klinik olarak tanımlanmış gerçek hasta verisi kullanılmıştır. |
| bERG kayıtları | Toplam 430 bERG kaydı: 74 DME, 356 DME olmayan kayıt. | Veri seti dengesizdir; hastalıklı sınıf daha az temsil edilmiştir. |
| DME tanısı | OCT bulgularına göre sertifikalı oftalmologlar tarafından konmuştur. | Sınıflandırma etiketleri klinik görüntülemeye dayanmaktadır. |
| Kayıt koşulları | 4 dakika fotopik koşulda, görsel uyarı olmadan, RETIMAX veya RETeval cihazlarıyla kayıt yapılmıştır. | Spontan retinal elektriksel aktiviteyi yansıtan bazal ERG sinyali kullanılmıştır. |
| Ön işleme | 0,3–40 Hz Butterworth band-pass filtre, 60 Hz notch filtre, artefakt temizleme, 0–1 normalizasyon ve 200 Hz’e yeniden örnekleme. | Sinyal gürültüsü azaltılmış ve modellemeye uygun hale getirilmiştir. |
| Ayrıklaştırma | Sinyal genliği N adet düzgün aralıklı duruma bölünmüştür. | Sürekli voltaj sinyali stokastik geçiş modeli için sembolik diziye çevrilmiştir. |
| İkinci dereceden geçiş matrisi | Bir sonraki durumun iki önceki duruma bağlı olasılığı modellenmiştir. | Sinyalin kısa süreli hafıza etkisi temsil edilmiştir. |
| Laplacian smoothing | Geçiş olasılıkları α parametresiyle düzenlenmiştir. | Hiç gözlenmeyen veya aşırı katı geçişlerin modele zarar vermesi önlenmiştir. |
| Stokastik yürüyüş | Geçiş matrisine göre 20 saniyelik sentetik diziler üretilmiştir. | Gerçek sinyalin olasılıksal yapısından yeni örnekler oluşturulmuştur. |
| Savitzky–Golay filtresi | Sentetik diziler yumuşatılmıştır. | Ayrıklaştırmadan gelen keskin geçişler azaltılmıştır. |
| FFT tabanlı düzeltme | Sentetik sinyalin frekans bileşenleri gerçek sinyal aralıklarına göre ayarlanmıştır. | Sentetik sinyalin spektral yapısı gerçek bERG’ye yaklaştırılmıştır. |
| Sınıflandırıcı | 1D CNN, öğrenilebilir FFT bloğu, Transformer encoder ve sigmoid çıkış kullanılmıştır. | Zaman ve frekans özelliklerini birleştiren hibrit derin öğrenme modeli kurulmuştur. |
Çalışmada açıkça verilen üretim uzunluğu ilişkisi şöyledir:
\[ n = f_s \cdot s \]
Burada n sentetik sinyaldeki örnek sayısını, f_s örnekleme frekansını, s ise saniye cinsinden sinyal süresini ifade eder. Çalışmada s = 20 saniye olarak belirlenmiştir.
İkinci dereceden stokastik geçiş mantığı şu açıklayıcı formülle özetlenebilir:
\[ P(X_t = x_k \mid X_{t-1}=x_j, X_{t-2}=x_i) \]
Bu ifade, sinyalin t anındaki durumunun yalnızca bir önceki duruma değil, iki önceki duruma bağlı olasılıkla üretildiğini gösterir. Bu, bERG gibi fizyolojik olarak hafıza etkisi taşıyabilen zaman serileri için daha gerçekçi bir modelleme varsayımıdır.
FFT’nin temel açıklayıcı ilişkisi ise şöyledir:
\[ X_k = \sum_{n=0}^{N-1} x_n e^{-i2\pi kn/N} \]
Bu formül, zaman alanındaki sinyal örneklerinin frekans alanındaki bileşenlere dönüştürülmesini açıklar. Çalışmada bu dönüşüm, sentetik sinyalin frekans büyüklüklerini gerçek bERG sinyallerinin gözlenen aralıklarıyla uyumlu hale getirmek için kullanılmıştır.
| Temel Bulgular | Sayısal Sonuç | Yorum |
|---|---|---|
| Toplam bERG kaydı | 430 | DME ve DME olmayan sınıflar için gerçek biyosinyal verisi kullanılmıştır. |
| DME kayıtları | 74 | Hastalıklı sınıf az temsil edilmiştir. |
| DME olmayan kayıtlar | 356 | Çoğunluk sınıfıdır. |
| Eğitim sinyal parçaları | 2.583 parça; 2.015 non-DME, 568 DME | 20 saniyelik örtüşmeyen parçalardan oluşmuştur. |
| İç test sinyal parçaları | 538 parça; 397 non-DME, 141 DME | Model geliştirme sürecindeki performansı izlemek için kullanılmıştır. |
| Bağımsız doğrulama seti | 1.159 parça; 1.007 non-DME, 152 DME | Modelin gerçek genelleme performansı burada ölçülmüştür. |
| Optimize edilen durum sayısı | 200 | İkinci dereceden geçiş matrisi için seçilen ayrık durum sayısıdır. |
| Optimize edilen Savitzky–Golay penceresi | 45 | Sentetik sinyalin yumuşatılmasında kullanılmıştır. |
| Optimize edilen Savitzky–Golay polinom derecesi | 4 | Sinyal şeklinin korunarak yumuşatılması hedeflenmiştir. |
| Optimize edilen α | 1e−20 | Laplacian smoothing parametresidir. |
Gerçek ve sentetik sinyal eşdeğerliği açısından çalışma, DME ve DME olmayan sınıflarda tüm ölçümlerde %95 güven aralıklarının eşdeğerlik sınırları içinde kaldığını bildirmiştir. Ortalama farklar çoğu metrikte 0,03’ün altında, MSE ve MAE farkları 0,003’ün altında, Wasserstein farkları yaklaşık −0,003 ve korelasyon temelli metriklerde farklar 0,001’in altında bulunmuştur. En büyük sapma Hjorth complexity ölçüsünde görülse de bu değer de önceden tanımlanan eşdeğerlik sınırları içinde kalmıştır.
| Model / Veri Artırma Durumu | Bağımsız Doğrulama ROC-AUC | Bilimsel Yorum |
|---|---|---|
| Veri artırma yok | 0,746 | Başlangıç performansı orta düzeydedir. |
| Stokastik 1:1 | 0,751 | Küçük artış vardır, anlamlı değildir. |
| Stokastik 2:1 | 0,770 | Performans artar, ancak anlamlılık sınırlıdır. |
| Stokastik 3:1 | 0,786 | Veri artırma yok durumuna göre anlamlı iyileşme görülür. |
| Stokastik 4:1 | 0,816 | Güçlü ve anlamlı performans artışı bildirilmiştir. |
| Stokastik 5:1 | 0,826 | En yüksek bağımsız doğrulama performansı elde edilmiştir. |
Beş sentetik örnek kullanılan stokastik veri artırma ile veri artırma kullanılmayan modelin bağımsız doğrulama metrikleri karşılaştırıldığında şu tablo ortaya çıkar:
| Metrik | Veri Artırma Yok | Stokastik 5:1 | Yorum |
|---|---|---|---|
| Duyarlılık | 0,749 | 0,762 | Anlamlı fark yoktur; DME yakalama oranı belirgin değişmemiştir. |
| Özgüllük | 0,607 | 0,777 | Yanlış pozitiflerin azalması açısından önemli artış vardır. |
| Doğruluk | 0,631 | 0,776 | Genel sınıflandırma başarısı artmıştır. |
| F1 skoru | 0,357 | 0,474 | Dengesiz veri koşullarında daha dengeli performans sağlanmıştır. |
| Kesinlik | 0,231 | 0,343 | Pozitif tahminlerin güvenilirliği artmıştır. |
| Cohen kappa | 0,194 | 0,358 | Şansa bağlı olmayan sınıflandırma uyumu güçlenmiştir. |
Klasik veri artırma yöntemleriyle karşılaştırma da önerilen yöntemin ayırt edici yönünü gösterir:
| Veri Artırma Yöntemi | ROC-AUC | Stokastik Yönteme Göre Durum |
|---|---|---|
| Stokastik geçiş matrisi + FFT | 0,826 | En yüksek bağımsız doğrulama performansı |
| Jittering | 0,749 | Daha düşük performans |
| Zaman kaydırma | 0,733 | Daha düşük performans |
| Faz rastgeleleştirme | 0,729 | Daha düşük performans |
| Interpolasyon | 0,733 | Daha düşük performans |
| MixUp | 0,735 | Daha düşük performans |
Bu bulgular, önerilen yöntemin özellikle bağımsız doğrulama verisinde daha iyi genelleme sağladığını gösterir. Çalışmanın teknik yorumu şudur: bERG gibi karmaşık biyosinyallerde başarılı veri artırma, yalnızca sinyali bozarak çoğaltmak değil; sinyalin olasılıksal geçiş yapısını, spektral dağılımını ve fizyolojik değişkenliğini birlikte koruyarak yeni örnekler üretmekle daha etkili olabilir.
Kaynak ve Yöntem Notu
Bu makale, Jorge Armando Hughes-Cano, Héctor Flores-Arguedas, María de Ángeles Pacheco-Blas, Ulises Olivares-Pinto ve Stephan C. Thébault tarafından hazırlanan “Synthetic basal electroretinograms for diabetic macular edema classification: a stochastic and frequency-domain modeling approach” başlıklı çalışmaya dayanılarak hazırlanmıştır.
Kaynak metin bir preprint araştırma makalesidir. Metinde açıkça “This preprint research paper has not been peer reviewed” ifadesi yer almaktadır. Bu nedenle çalışma hakem değerlendirmesinden geçmemiştir ve sonuçlar klinik uygulama rehberi veya kesin tanı standardı olarak değerlendirilmemelidir.
Çalışma, diyabetik makula ödemi tanısı koyan bir klinik tedavi çalışması değildir. Çalışmada DME tanısı OCT bulgularına göre sertifikalı oftalmologlar tarafından konmuş, bERG sinyalleri ise bu etiketlere göre sınıflandırma modelinin eğitilmesi ve değerlendirilmesi için kullanılmıştır. Önerilen yöntem, bERG verilerinden sentetik eğitim sinyali üretmeye yönelik bir yapay zekâ ve sinyal işleme yaklaşımıdır.
Bu içerikte PDF’de olmayan klinik etki, tedavi başarısı, tanı garantisi, cihaz güvenliği, ticari uygulanabilirlik veya hasta düzeyinde kesin risk hesaplama iddiası eklenmemiştir. Çalışmanın sunduğu sonuçlar, belirli bir veri setinde ve belirli bir sınıflandırma mimarisiyle elde edilen yöntemsel bulgulardır. Farklı cihazlar, farklı klinik merkezler, farklı hasta grupları veya başka retina hastalıkları için aynı performansın geçerli olacağı bu çalışma ile kanıtlanmamıştır.
Çalışmanın güçlü tarafı, sentetik verinin yalnızca eğitim aşamasında kullanılması ve bağımsız doğrulama setinin gerçek, artırılmamış sinyallerden oluşmasıdır. Bununla birlikte DME sınıfındaki gerçek kayıt sayısının sınırlı olması, sınıf dengesizliği, iki farklı kayıt cihazı ve iki farklı klinik merkezden veri toplanması gibi sınırlılıklar sonuçların yorumunda dikkate alınmalıdır.
Sonuç olarak çalışma, bERG gibi fizyolojik zaman serilerinde stokastik geçiş matrisleri ve FFT tabanlı spektral düzenleme ile gerçekçi sentetik veri üretiminin, yapay zekâ tabanlı DME sınıflandırmasını bağımsız doğrulama verisinde iyileştirebileceğini göstermektedir. Ancak bu bulgu, klinikte tek başına kullanılabilecek doğrulanmış bir tanı sistemi anlamına gelmez; daha büyük, dengeli ve çok merkezli çalışmalarla doğrulanması gereken bir yöntemsel katkıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir