

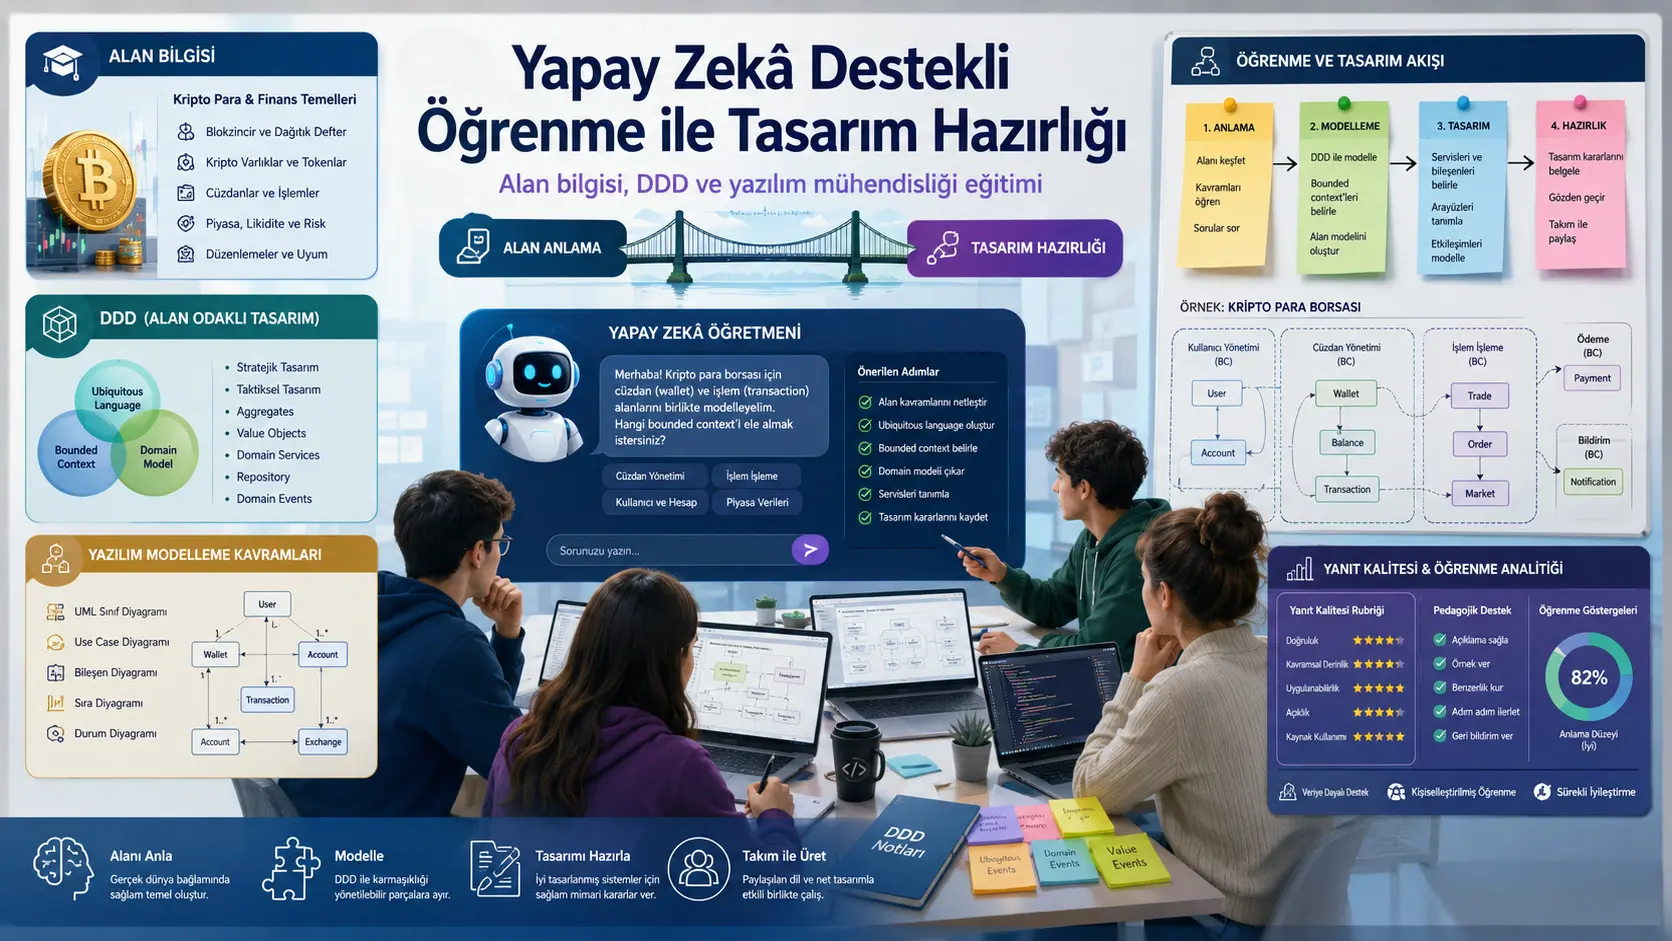
Bu çalışma, yazılım mühendisliği öğrencilerinin yalnızca programlama öğrenmekle kalmayıp yazılımını geliştirecekleri iş alanını ve bu alanı modellemek için gereken yöntemleri kısa sürede öğrenmeleri sorununa odaklanmaktadır. Araştırmada 29 yüksek lisans öğrencisi, kripto para arbitrajı alanındaki temel finans kavramlarını ve Alan Odaklı Tasarım yaklaşımını öğrenmek üzere ders materyalleriyle özelleştirilmiş bir ChatGPT öğretmeni kullanmıştır.
Uygulama, Carnegie Mellon University Silicon Valley’deki bir işlevsel programlama dersinin iki haftalık tasarım aşamasında gerçekleştirilmiştir. Öğrencilerin ekipler hâlinde geliştirdiği “ArbitrageGainer” adlı otomatik kripto para arbitraj sistemi için önce finans alanını anlamaları, ardından olay fırtınası, komutlar, haricî sistemler, iş akışları ve sınırlı bağlamlar gibi Alan Odaklı Tasarım öğelerini belirlemeleri gerekmiştir.
Özel yapay zekâ öğretmeni GPT-3.5 Turbo üzerine kurulmuş; ders slaytları, proje gereksinimleri ve örnek bir öğrenci tasarımıyla temellendirilmiştir. Öğrencilere üç ayrı ders öncesi etkinlikte ikişer standart istem verilmiş, konuşma kayıtlarını dışa aktarmaları ve kısa bilgi kontrolü raporlarını tamamlamaları istenmiştir. Böylece yaklaşık 174 standart istem-yanıt çifti oluşmuştur. Araştırmacı bunların 60’ını, yani yüzde 34,5’ini tabakalı rastgele örneklemeyle değerlendirmiştir.
Yanıtların doğruluk puanı yüzde 98,9, konuya uygunluk puanı yüzde 92,2 ve pedagojik değer puanı yüzde 89,4 olarak bildirilmiştir. Bilişsel yük açısından ortalama yüzde 82,78 elde edilirken, öğrenciyi cesaretlendirme ve sonraki adıma yönlendirme olarak tanımlanan destekleyicilik yalnızca yüzde 37,78’de kalmıştır. İncelenen 60 yanıtta araştırmacının “halüsinasyon veya yanlış bilgi” olarak sınıflandırdığı bir içerik bulunmamış; iki yanıtta öğrenciyi önemli ölçüde yanıltmayan küçük yanlışlık saptanmıştır.
Öğrencilerin yapay zekâ yardımıyla alan bilgisi öğrenme ve Alan Odaklı Tasarım uygulama konusundaki öz-yeterlikleri uygulama sonrasında anlamlı ölçüde yükselmiştir. Bununla birlikte çalışma bir kontrol grubu içermemektedir. Yapay zekâ etkinlikleri; kısa ders anlatımları, ekip çalışmaları, zorunlu bilgi kontrolleri ve not teşvikiyle aynı dönemde uygulanmıştır. Bu nedenle güven artışının yalnızca yapay zekâ öğretmeninden kaynaklandığı söylenemez.
Araştırmanın en önemli çıktısı, yapay zekâ öğretmeninin başarı yüzdelerinden çok, eğitimciler için oluşturulan 17 maddelik uygulama rehberidir. Ders materyallerinden oluşan kontrollü bilgi tabanı kullanmak, yanıt ayrıntısını ve uzunluğunu sınırlandırmak, örnekleri önceden denetlemek, bilinmeyen terimleri engellemek, öğrenciyi tek bir anlamlı takip sorusuna yönlendirmek ve çalışmayı küçük bir ders kredisiyle desteklemek başlıca öneriler arasındadır.
Araştırmanın temel problemi nedir?
Yazılım mühendisliği eğitimi yalnızca programlama dillerini ve kod üretimini kapsamaz. Bir yazılım geliştiricinin, çözüm üreteceği iş alanındaki kavramları, aktörleri, kuralları, olayları ve sınırları anlaması gerekir. Finans, sağlık, üretim veya lojistik gibi bir alanda temel kavramlar anlaşılmadan doğru gereksinim modeli ve yazılım mimarisi oluşturmak güçleşir.
Bu gereksinim eğitim ortamında iki önemli sorun doğurmaktadır:
- Öğrenciler yazılım geliştirme yöntemleriyle birlikte yabancı oldukları uygulama alanlarını da kısa sürede öğrenmek zorundadır.
- Eğitmenin ders sırasında her öğrenciye veya ekibe kişiselleştirilmiş açıklama ve anlık geri bildirim sağlaması ölçeklenebilir değildir.
Çalışmada önceki ders dönemlerinde eğitmenin ekipler arasında dolaşmasına rağmen bazı soruların ders sonuna kaldığı ve bazı öğrenci gruplarıyla ek olarak 10-30 dakika ilgilenmek gerektiği belirtilmiştir. Araştırmacının ders bağlamında görevlendirilen öğretim asistanının sınıf içi desteğe katılmaması da bireysel yardım açığını büyütmüştür.
Araştırmanın temel amacı, ders materyalleriyle sınırlandırılmış bir üretken yapay zekâ öğretmeninin bu yardım açığını azaltıp azaltamayacağını incelemektir. Çalışmada doğrudan “yapay zekâ öğrencilerin sınav başarısını artırdı mı?” sorusu değil, şu üç araştırma sorusu ele alınmıştır:
- Yapay zekâ destekli öğrenme, öğrencilerin tasarım aşamasına hazırlanması için ne ölçüde yüksek kaliteli destek sağlamıştır?
- Pedagojik değer, bilişsel yük ve destekleyicilik açısından yapay zekâ öğretmeninin yanıtları nasıl bir nitelik göstermiştir?
- Ders ortamındaki yapay zekâ destekli öğrenmenin etkililiğini hangi öğretim uygulamaları artırabilir?
Ders ve proje bağlamı
Uygulama, 2024 sonbahar dönemindeki 12 birimlik bir yüksek lisans işlevsel programlama dersinde gerçekleştirilmiştir. Ders, Carnegie Mellon University Silicon Valley’deki Yazılım Mühendisliği programının çekirdek derslerinden biridir. Haftada iki yüz yüze oturum yapılmış ve her oturum 1 saat 50 dakika sürmüştür.
Dersin amaçlarından biri, işlevsel programlamayı uygulamalı biçimde öğretmek ve endüstriyel bağlamlarda nasıl kullanılabileceğini göstermektir. Öğrenciler üç veya dört kişilik ekipler hâlinde “ArbitrageGainer” adlı gerçekçi bir otomatik işlem sistemi üzerinde çalışmıştır.
ArbitrageGainer projesi kripto para arbitrajına dayanmaktadır. Öğrencilerin yalnızca programlama yapması yeterli değildir; şu tür alan kavramlarını anlamaları gerekmiştir:
- Kripto para borsaları ve piyasa veri servisleri,
- Alış ve satış fiyatları arasındaki fark,
- Farklı borsalar arasında oluşan arbitraj fırsatları,
- Emir, bakiye, ücret ve işlem gerçekleştirme mekanizmaları,
- Haricî sistemler ve API bağımlılıkları,
- Otomatik işlem sistemindeki iş olayları ve komutlar.
Proje dört adet ikişer haftalık aşamaya ayrılmıştır. İncelenen çalışma yalnızca ilk aşamayı kapsamaktadır. Bu aşamada öğrenciler işlevsel gereksinimleri Alan Odaklı Tasarım modeline dönüştürmüş; sonraki uygulama ve kodlama aşamaları çalışmaya dâhil edilmemiştir.
Alan Odaklı Tasarım neden kullanılmıştır?
Alan Odaklı Tasarım veya Domain-Driven Design, yazılımın yapısını ve kullanılan dili temel iş alanının kavramlarıyla uyumlu hâle getirmeyi amaçlayan bir modelleme yaklaşımıdır. Teknik ekip ile alan uzmanlarının aynı kavramlar üzerinde anlaşmasını destekler.
Çalışmada DDD kavramları yaklaşık 30 dakikalık kısa ders anlatımlarıyla adım adım tanıtılmıştır. Her anlatımdan sonra öğrenciler Miro panosu üzerinde ekip çalışması yapmıştır. Uygulamalar şu öğeleri kapsamıştır:
- Olay fırtınasıyla iş olaylarının belirlenmesi,
- Olayların zaman sırasına yerleştirilmesi,
- Olayları başlatan komutların çıkarılması,
- Çözüm kapsamı dışındaki haricî sistemlerin belirlenmesi,
- İş akışlarının sözde kodla belgelenmesi,
- Sınırlı bağlamların oluşturulması.
Önceki derslerde öğrencilerin proje gereksinimlerinde adları açıkça geçen kripto para borsası ve piyasa verisi API’si gibi haricî sistemleri dahi modelden çıkaramadığı gözlenmiştir. Yapay zekâ etkinliklerinden birinde bu nedenle otomatik işlem sistemindeki tipik alt sistem ve bileşenlerin sorulduğu özel bir istem kullanılmıştır.
Bazı bireysel raporlarda yanlışlıklar sürmesine rağmen ekiplerin nihai tasarım teslimlerinde bütün haricî sistemleri doğru belirlediği bildirilmiştir. Bununla birlikte çalışmada önceki dönemle kontrollü karşılaştırma yapılmadığından bu iyileşmenin yalnızca yapay zekâ etkinliğinin sonucu olduğu kanıtlanmamaktadır.
Katılımcılar kimlerden oluşmuştur?
Dersi tamamlayan 29 yüksek lisans öğrencisinin tamamı çalışmaya gönüllü olarak katılmıştır. Lisans geçmişleri şöyledir:
- Bilgisayar Bilimleri: 15 öğrenci,
- Elektrik ve Bilgisayar Mühendisliği: 4 öğrenci,
- Yazılım Mühendisliği: 3 öğrenci,
- Diğer mühendislik, finans veya matematik alanları: 7 öğrenci.
Finans konusunda daha belirgin deneyimi bulunan öğrenciler arasında beş bireysel yatırımcı, finansal teknoloji sektöründe çalışmış iki öğrenci ve finans veya ekonomi yan dalına sahip bir öğrenci yer almıştır. Alan Odaklı Tasarım deneyimi ise üç öğrencide önceki derslerden, iki öğrencide endüstriyel deneyimden gelmiştir.
Şekil 1: Öğrencilerin başlangıç bilgisi
PDF’nin ikinci sayfasındaki Şekil 1, öğrencilerin finans ve DDD konularındaki öz-bildirimlerini iki dairesel grafikle göstermektedir.
| Bilgi düzeyi | Finans bilgisi veya deneyimi | DDD bilgisi veya deneyimi |
|---|---|---|
| Hiç yok | %31 | %39 |
| Biraz | %38 | %38 |
| Orta | %19 | %19 |
| Belirgin | %12 | %4 |
Finans alanında öğrencilerin yüzde 69’u, DDD alanında ise yüzde 77’si bilgisini “hiç yok” veya “biraz” olarak tanımlamıştır. Bu dağılım, yapay zekâ etkinliklerinin ileri düzey uzmanlık yerine başlangıç ve orta düzey hazırlık amacıyla kullanıldığını göstermektedir.
Yapay zekâ etkinlikleri ders programına nasıl yerleştirilmiştir?
Araştırmacı, öğrencilerin yapay zekâ çalışmasını isteğe bağlı bir ek ödev olarak görmesini önlemek için ders tasarımında üç değişiklik yapmıştır:
- Yapay zekâ kullanımını açık bir ders öğrenme çıktısı hâline getirmiştir.
- Etkinliklerin amacı ve ders içindeki rolü öğrencilere tekrar tekrar açıklanmıştır.
- Bütün yapay zekâ etkinlikleri zorunlu ve ders kredisiyle ödüllendirilen çalışmalar hâline getirilmiştir.
Belirlenen öğrenme çıktısı, öğrencilerin üretken yapay zekâyı alan bilgisi edinmek ve ortak bir projede DDD’yi doğru uygulamak için kullanmasını gerektirmiştir.
Üniversite ayrıca dersin ilk haftasında bütün öğrencilerin 90-120 dakikalık bir üretken yapay zekâ okuryazarlığı modülünü tamamlamasını istemiştir. Ders notunun yüzde 1’ine karşılık gelen bu modül; yapay zekâ sistemlerinin çalışma ilkeleri, etik ve bağlamsal konular ile sorumlu kullanım stratejilerini kapsamıştır.
İki haftalık etkinlik takvimi
| Aşama | Tahmini süre | Amaç | Öğrenci etkinliği | Üretilen çıktı |
|---|---|---|---|---|
| Ders öncesi 1 | 30-45 dakika | Finans alanı bilgisini başlatmak | Proje şartnamesini okuma, 1.1 ve 1.2 istemlerini çalıştırma, isteğe bağlı takip soruları, bilgi kontrolü 1 | İki standart istemin konuşma kaydı ve üç açık uçlu sorudan oluşan rapor |
| Sınıf içi 1 | 1 saat 50 dakika | Proje ve DDD modellemesini başlatmak | Sistem tanıtımı, DDD mini dersi ve ekip olarak olay fırtınası | İş olaylarını içeren Miro panosu |
| Ders öncesi 2 | 20-30 dakika | Temel DDD kavramlarını öğrenmek | 2.1 ve 2.2 istemlerini çalıştırma, konuşmayı dışa aktarma ve bilgi kontrolü 2 | Konuşma kaydı ve iki açık uçlu sorudan oluşan rapor |
| Sınıf içi 2 | 1 saat 50 dakika | Temel DDD etkinliğini tamamlamak | Olayları sıralama, komutları ve haricî sistemleri çıkarma | Güncellenmiş ekip Miro panosu |
| Ders öncesi 3 | 30-45 dakika | DDD terimlerini proje teslimlerine uygulamak | 3.1 ve 3.2 istemlerini çalıştırma, konuşmayı dışa aktarma ve bilgi kontrolü 3 | Konuşma kaydı ve bir açık uçlu sorudan oluşan rapor |
| Sınıf içi 3 | 1 saat 50 dakika | Aşama teslimlerini oluşturmak | İş akışlarını ve sınırlı bağlamları ekip olarak tanımlama | Sınırlı bağlamlar içeren Miro panosu ve iş akışı sözde kod taslağı |
Her yapay zekâ etkinliğinden sonra öğrencilerin konuşma dökümüyle birlikte bilgi kontrolü ve kısa yansıtma raporu teslim etmesi gerekmiştir. Raporun ilk seferde geçer sayılması için bütün bilgi kontrolü sorularının kısa gerekçelerle doğru yanıtlanması ve konuşma kaydının eklenmesi şartı aranmıştır.
Öğrencilerin yaklaşık yüzde 93’ünün üç raporu da beklenen zamanda teslim ettiği ve ilk teslimde geçtiği belirtilmiştir. Bu oran, derse hazırlığın yüksek olduğunu gösterir; ancak zorunlu çalışma ve not teşvikinin katılım üzerindeki etkisi ayrı olarak ölçülmemiştir.
Özel ChatGPT öğretmeni nasıl yapılandırılmıştır?
Öğretmen GPT-3.5 Turbo kullanılarak oluşturulmuştur. Model iki biçimde özelleştirilmiştir:
- Öğretmenin rolünü, görevlerini, sınırlarını, yapması ve yapmaması gerekenleri açıklayan ayrıntılı bir sistem istemi kullanılmıştır.
- Ders slaytları, proje şartnamesi ve örnek öğrenci DDD çözümü ChatGPT bilgi yapılandırmasına yüklenmiştir.
Sistem isteminde şu öğeler bulunmuştur:
- Öğretmen kişiliği ve bağlamı,
- Birincil kaynak olarak ders materyallerini kullanma talimatı,
- Desteklenecek öğrenme görevleri,
- Kısıtlamalar ve yasaklanan davranışlar,
- İstenen cevap biçimi ve anlatım özellikleri,
- Ders terminolojisine bağlı kalma kuralları.
Eğitmen, dönem başlamadan önce beklenen öğrenci etkileşimlerini temsil eden komut dosyalı denemelerle yapılandırmayı tekrar tekrar sınamıştır. Her sürüm beş denemede değerlendirilmiş; yanıtlar doğru ders terminolojisi, sonraki atölye için yeterli derinlik ve düşük miktarda kalıp metin üretene kadar düzenlenmiştir.
Yapılandırma dördüncü sürümde sonlandırılmış ve birinci etkinliğin başlangıcında dondurulmuştur. Bu karar öğrenciler arasında tutarlılık sağlamış, ancak farklı etkileşim biçimlerine uyarlanma olasılığını azaltmıştır.
Öğrenciler kimlik doğrulaması bulunmayan ortak bir öğretmen örneğine erişmiştir. Modelin sıcaklık veya diğer üretim parametreleri ChatGPT arayüzünde değiştirilemediği için varsayılan değerler kullanılmıştır. GPT-3.5 ile başka modeller arasında karşılaştırma yapılmamıştır.
Hangi veriler toplanmıştır?
Çalışmada üç zaman noktasından veri elde edilmiştir:
- Uygulama öncesi: Öğrenci geçmişi, finans, işlevsel programlama ve DDD deneyimi ile beş öz-yeterlik ifadesi.
- Uygulama sırasında: Standart istemlerin konuşma kayıtları, bilgi kontrolleri ve öğrenci yansıtma raporları.
- Uygulama sonrası: Dönem sonu öğrenci görüşleri ve öz-yeterlik ölçümleri.
Öz-yeterlik analizindeki iki temel ölçüt şunlardır:
- “Alan bilgisi edinmek için üretken yapay zekâyı kullanabilirim.”
- “Ortak bir projede DDD’yi doğru uygulamak için üretken yapay zekâyı kullanabilirim.”
“Gerçek iş gereksinimleri için alan odaklı bir model tasarlayabilirim” ifadesi üçüncü ve keşifsel bir ölçüt olarak kullanılmıştır. Bu ifade yapay zekâya doğrudan atıfta bulunmadığından elde edilen gelişmenin proje uygulamasından veya kısa derslerden kaynaklanması mümkündür.
Konuşma verisi ve örnekleme yöntemi
Her öğrencinin üç etkinlikte ikişer standart istem çalıştırması planlanmıştır:
\[ 29 \times 3 \times 2 = 174 \]
Böylece yaklaşık 174 standart istem-yanıt çifti oluşmuştur. Her etkinlikteki iki istem birlikte bir konuşma birimi olarak kabul edilmiş ve toplam:
\[ 29 \times 3 = 87 \]
konuşma birimi elde edilmiştir.
Her oturumdan rastgele 10 konuşma birimi seçilmiştir. Böylece üç oturumdan toplam 30 konuşma birimi ve 60 istem-yanıt çifti değerlendirilmiştir.
Aşağıdaki oran makalede ayrı bir denklem olarak verilmemiş, örneklem oranını açıklamak için eklenmiştir:
\[ \text{Örnekleme oranı} =\frac{60}{174}\times100 \approx34{,}5\% \]
Örnekleme random.org aracılığıyla, oturumlara göre tabakalı ve yerine koymadan yapılmıştır. İki standart istemin birlikte seçilmesi konuşma içi bağlamın korunmasını; her oturumdan eşit sayıda birim alınması ise finans, temel DDD ve ileri DDD konularının temsil edilmesini sağlamıştır.
Öğrencilerin kendi seçtiği takip sorularına izin verilmiş, ancak bu sorular standart olmadıkları için değerlendirmeye alınmamıştır. Dolayısıyla sonuçlar gerçek ve serbest biçimli yapay zekâ kullanımının tamamını değil, önceden belirlenen istemlere verilen yanıtları temsil etmektedir.
Yanıtlar hangi ölçütlerle değerlendirilmiştir?
Her yanıt 0 ile 3 arasında beş boyutta puanlanmıştır:
| Boyut | Ölçülen özellik | En yüksek puanın anlamı |
|---|---|---|
| Bilgi doğruluğu | Olgusal, kavramsal ve teknik doğruluk | Yanıt doğru, alan bilgisiyle uyumlu ve önemli hata içermiyor |
| İlgi düzeyi | Soruyu doğrudan ve bağlama uygun yanıtlama | Gereksiz veya konu dışı içeriği bulunmuyor |
| Pedagojik değer | Derinlik, yapılandırılmış açıklama, terimler ve örnekler | Öğrenmeyi ilerletecek yeterli açıklama ve uygun örnek sunuyor |
| Bilişsel yük | Açıklık, kısalık, erişilebilirlik ve seviye uygunluğu | Gereksiz karmaşıklık oluşturmadan kolay anlaşılabiliyor |
| Destek ve cesaretlendirme | Öğrencinin çabasını tanıma ve sonraki adıma yönlendirme | Öğrenciyi doğruluyor, cesaretlendiriyor ve öğrenmeye devam etmeye davet ediyor |
Destekleyicilik araştırmacının oluşturduğu bir vekil ölçüttür. Kısa övgü veya doğrulama ile sonraki adımı keşfetme davetinin birleşimi olarak tanımlanmıştır. Geçerliği doğrulanmış psikolojik bir duygu veya motivasyon ölçeği değildir.
Boyutların yüzdeye dönüştürülmesini açıklamak için kullanılabilecek ilişki aşağıdadır. Bu ifade makalede denklem olarak sunulmamıştır:
\[ \text{Boyut yüzdesi} =\frac{\sum_{i=1}^{n}s_i}{3n}\times100 \]
Burada si her yanıtın 0-3 arasındaki puanı, n ise değerlendirilen yanıt sayısıdır.
Değerlendirmeyi kim yaptı?
Temel puanlamayı dersin eğitmeni ve çalışmanın yazarı gerçekleştirmiştir. Yazar, ders bağlamını ve beklenen terminolojiyi en iyi bilen kişi olmasına karşın tek değerlendirici olması gözlemci yanlılığı riski doğurmaktadır.
Tutarlılık kontrolü için dersi daha önce almış iki eğitimli öğretim asistanı, her oturumdan beş olmak üzere aynı 15 konuşma kaydını bağımsız biçimde puanlamıştır. Değerlendiriciler önce anonimleştirilmiş beş kayıt üzerinde 90 dakikalık rubrik kalibrasyonu yapmıştır.
Eğitmen ile iki asistan arasındaki ağırlıklı Cohen kappa değerleri şöyledir:
- Birinci öğretim asistanı: κ=0,76,
- İkinci öğretim asistanı: κ=0,78.
Tam eşleşme yüzde 72-74, en fazla bir puan farklılıkla eşleşme yüzde 99,3 olarak bildirilmiştir. Bu değerler incelenen alt kümede güçlü bir tutarlılığa işaret eder; bütün 60 yanıt iki veya üç değerlendirici tarafından puanlanmamıştır.
Yanıtların doğruluğu
Doğruluk ortalaması yüzde 98,9’dur. Şekil 3’e göre yanıtların yaklaşık yüzde 97’si 3, yüzde 3’ü 2 puan almıştır. Bu dağılım 58 yanıtın tam, iki yanıtın küçük yanlışlık içeren düzeyde değerlendirilmesiyle uyumludur.
Araştırmacı, incelenen örneklemde bütünüyle yanlış veya öğrenciyi yanıltacak bir “halüsinasyon” saptamadığını belirtmektedir. İki küçük sorun şunlardır:
- İleri DDD konularında “domain service” kavramına ilişkin ikincil internet kaynaklarında da görülebilen, kısmen yanıltıcı bir tanımlama,
- Bir örnekte kullanılan olay adının belirtilen sınırlı bağlama tam olarak uymaması.
Bu sonuç, GPT-3.5’in genel olarak yüzde 98,9 doğru olduğu anlamına gelmez. Ölçüm; altı standart istem, ders materyalleriyle sınırlandırılmış bir bilgi tabanı ve tek bir ders bağlamındaki 60 yanıt için geçerlidir.
Yanıtların ilgi düzeyi
İlgi düzeyi ortalaması yüzde 92,2’dir. Şekil 3’e göre yanıtların yaklaşık yüzde 77’si en yüksek, yüzde 23’ü ikinci düzey puanı almış; hiçbir yanıt 0 veya 1 puana düşmemiştir.
Konuya uygunluğu düşüren üç sorun saptanmıştır:
- Bilgi tabanında bazı destekleyici finans kavramlarının eksik olması,
- Yanıtın öğrencinin proje kapsamının dışına taşması,
- Giriş, tekrar ve sonuç paragraflarının cevaba yeni bilgi eklemeden metni uzatması.
Öğrenciler, modelin proje açıklamasını bilmesinin yanıtları daha kısa ve bağlama uygun hâle getirdiğini bildirmiştir. Bazı öğrenciler ise gereksiz içerik arasından yararlı bölümü seçmenin zor olabildiğini söylemiştir.
Pedagojik değer
Pedagojik değer ortalaması yüzde 89,4’tür. Şekil 3’te yanıtların yüzde 70’i 3, yaklaşık yüzde 28’i 2 ve yaklaşık yüzde 2’si 1 puan almıştır.
Yanıtların çoğu doğru terimler, yapılandırılmış açıklama ve en az bir örnek içermiştir. Soyut konularda iki örnek kullanıldığı da olmuştur. Yalnızca bir yanıt, otomatik arbitraj sistemindeki tipik bileşenleri açıklamadan genel başlıklar hâlinde sıraladığı için 1 puan almıştır.
Öğrenciler iki zıt sorun bildirmiştir:
- Bazı açıklamaların başlangıç seviyesindeki öğrenci için fazla teknik olması,
- Bazı açıklamaların konuyu bilen öğrenci için fazla yüzeysel kalması.
Bu sorun, tek bir standart ayrıntı düzeyinin farklı ön bilgiye sahip bütün öğrenciler için uygun olmayacağını göstermektedir.
Bilişsel yük
Bilişsel yük boyutunun ortalaması yüzde 82,78’dir. Şekil 3’te yaklaşık yüzde 55 en yüksek, yüzde 38 ikinci ve yüzde 7 üçüncü düzeyde görünmektedir. Düşük puanlar; yanıtın uzunluğu, tekrar, açıklanmayan terimler ve fazla sayıda örnekle ilişkilendirilmiştir.
Araştırmacı metinde yanıtların yüzde 5’ini “bunaltıcı” olarak tanımlarken Şekil 3’te en düşük gözlenen dağılım yaklaşık yüzde 7’dir. Bu küçük fark, rapordaki sayısal tutarsızlıklardan biridir.
Belirlenen başlıca bilişsel yük kaynakları şunlardır:
- Giriş, ana gövde ve sonuçta aynı noktanın tekrar edilmesi,
- Ders bilgi tabanında bulunmayan terimlerin açıklanmadan kullanılması,
- Basit bir kavram için gereğinden fazla örnek verilmesi,
- Yanıtın öğrencinin istediği ayrıntı düzeyine uyum sağlamaması.
Destekleyicilik neden düşük kalmıştır?
Destek ve cesaretlendirme ortalaması yalnızca yüzde 37,78’dir. Şekil 3’e göre yanıtların yaklaşık yüzde 87’si 1, yüzde 13’ü 2 puan almış; hiçbir yanıt en yüksek destek düzeyine ulaşmamıştır.
Model çoğunlukla tarafsız ve bilgi aktaran bir üslup kullanmıştır. Öğrencinin sorusunu olumlu biçimde doğrulayan, çabasını tanıyan veya belirli bir sonraki adıma davet eden ifadeler seyrektir.
Cesaretlendirici ifadelerin çoğu, standart istemin öğrencinin bir görevi tamamladığını açıkça belirttiği üçüncü etkinlikte görülmüştür. Bu durum destekleyici tonun modelden kendiliğinden değil, istemdeki bağlamsal işaretten doğduğunu düşündürmektedir.
Düşük destekleyicilik, verilen bilginin yanlış olduğu anlamına gelmez. Ancak öğretmenin yalnızca doğru yanıt vermek yerine öğrencinin devam eden öğrenme sürecini de desteklemesi amaçlanıyorsa, sistem isteminde hafif bir öğretmenlik veya koçluk tonu açıkça tanımlanmalıdır.
Şekil 3 ve metindeki sayısal tutarsızlıklar
PDF’nin yedinci sayfasındaki Şekil 3, boyutların puan dağılımını göstermektedir. Şekil ve bildirilen ortalamalar birlikte değerlendirildiğinde yaklaşık dağılım şöyledir:
| Boyut | Puan 3 | Puan 2 | Puan 1 | Bildirilen ortalama |
|---|---|---|---|---|
| Doğruluk | %97 | %3 | %0 | %98,9 |
| İlgi düzeyi | %77 | %23 | %0 | %92,2 |
| Pedagojik değer | %70 | %28 | %2 | %89,4 |
| Bilişsel yük | %55 | %38 | %7 | %82,78 |
| Destekleyicilik | %0 | %13 | %87 | %37,78 |
Şekildeki dağılımlar ve ortalamalar matematiksel olarak birbirine yakındır. Buna karşılık ana metinde:
- İlgi düzeyinde en yüksek puan alanların oranı yüzde 82,5,
- Pedagojik değerde en yüksek puan alanların oranı yüzde 77,5
olarak yazılmıştır. Bu oranlar Şekil 3’le uyuşmamaktadır.
Ayrıca iki küçük yanlışlık 60 yanıtın:
\[ \frac{2}{60}\times100=3{,}33\% \]
oranına karşılık gelir. Özet bölümünde 2/60 ve yüzde 3,3 doğru biçimde verilirken tartışma bölümünde yüzde 1,1 yazılmıştır. Bu hata sonuçların ana yönünü değiştirmez, ancak raporlama doğruluğu bakımından belirtilmelidir.
Öz-yeterlik sonuçları
Öğrencilerin öz-yeterlikleri uygulama öncesi ve sonrası eşleştirilmiş analizle karşılaştırılmıştır.
| Öz-yeterlik maddesi | İstatistiksel sonuç | Etki büyüklüğü | Yorum |
|---|---|---|---|
| Yapay zekâyla alan bilgisi edinme | F(1,22)=24,41; p<0,001 | Kısmi η²=0,53; dz≈1,03 | Büyük güven artışı |
| Yapay zekâyla ortak projede DDD uygulama | F(1,21)=14,81; p<0,001 | Kısmi η²=0,41; dz≈0,82 | Büyük güven artışı |
| Gerçek iş gereksinimleri için DDD modeli tasarlama | F(1,21)=45,82; p<0,001 | Kısmi η²=0,69; dz≈1,44 | Çok büyük artış; yapay zekâya özgü olmayan keşifsel sonuç |
F(1,22) değeri ilk madde için 23, F(1,21) değerleri ise diğer maddeler için 22 eşleştirilmiş gözleme işaret etmektedir. Bu nedenle öz-yeterlik analizleri 29 öğrencinin tamamını kapsamamaktadır. Eksik eşleştirilmiş yanıtların nedenleri ayrıntılı olarak açıklanmamıştır.
Kısmi eta kare, toplam değişimin ne kadarının zaman veya uygulama öncesi-sonrası farkıyla ilişkilendirildiğini gösteren bir etki büyüklüğüdür. Eşleştirilmiş Cohen dz ise ortalama değişimi bireyler arası değişkenliğe göre standartlaştırır. Bildirilen değerler küçük bir istatistiksel farktan daha büyük, uygulamalı olarak belirgin güven artışlarına işaret etmektedir.
Ancak öz-yeterlik becerinin kendisi değildir. Öğrenci kendini daha yetkin hissederken nesnel bir tasarım sınavında aynı ölçüde gelişme göstermeyebilir. Çalışmada bağımsız, kör puanlanan bir yeterlik testi veya kontrol grubu bulunmamaktadır.
Şekil 2: Uygulama öncesi ve sonrası güven
PDF’nin altıncı sayfasındaki Şekil 2, yapay zekâyla alan bilgisi edinme ve DDD uygulama maddelerinin grup ortalamalarını yüzde 95 güven aralıklarıyla göstermektedir.
Grafikten yaklaşık olarak:
- Alan bilgisi edinme güveninin 58 düzeyinden 85 civarına,
- DDD uygulama güveninin 51 düzeyinden 77 civarına
yükseldiği okunmaktadır. Bu değerler grafikten yaklaşık olarak okunmuştur; ana metinde kesin ortalamalar tablo hâlinde verilmemiştir. Dikey hata çubukları yüzde 95 güven aralıklarını göstermektedir.
Öz-yeterlik artışı neden nedensel sonuç değildir?
Yapay zekâ öğretmeni tek başına uygulanmamıştır. Aynı dönemde öğrenciler:
- Kısa DDD dersleri almış,
- Ekip olarak gerçek proje üzerinde çalışmış,
- Miro panosunda olay fırtınası yapmış,
- Bilgi kontrolü sorularını yanıtlamış,
- Öğretim üyesinden veya diğer kaynaklardan yardım almış,
- Zorunlu ve notlandırılan etkinliklere katılmıştır.
Bu ortak uygulamalar birbirinden ayrılmadığı için gözlenen güven artışı yapay zekâ destekli bütün öğrenme ortamıyla ilişkilidir. “ChatGPT öz-yeterliği şu kadar artırdı” biçiminde nedensel bir ifade çalışma tarafından desteklenmemektedir.
Öğretim tasarımında kullanılan kuramsal çerçeveler
Araştırmacı sonuçları üç öğrenme kuramı üzerinden yorumlamıştır:
Bilişsel Yük Kuramı
Gereksiz tekrar, aşırı uzunluk, fazla sayıda örnek ve açıklanmayan terimler öğrencinin çalışma belleğini öğrenmeye katkısı olmayan içerikle doldurabilir. Yanıt uzunluğunu ve örnek sayısını sınırlayan öneriler bu çerçeveye dayanmaktadır.
ICAP çerçevesi
ICAP, öğrencinin katılımını pasif, aktif, yapıcı ve etkileşimli düzeylerde ele alır. Öğrencinin yalnızca yanıtı okuması aktif düzeyde kalabilir. Modelin belirli bir takip sorusu veya uygulama görevi önermesi, öğrenciyi yapıcı ve etkileşimli katılıma yönlendirebilir.
Öz-yeterlik
Öğrencinin bir görevi başarabileceğine ilişkin inancı, öğrenmeye devam etmesini ve zor görevlerde ısrarını etkileyebilir. Araştırmacı, düşük destekleyiciliğin bazı öğrencilerde güven artışını sınırlandırmış olabileceğini ileri sürmektedir. Bu olasılık doğrudan deneysel olarak sınanmamıştır.
Önerilen 17 öğretim uygulaması
| Kod | Uygulama | Amaç | Uygulama biçimi |
|---|---|---|---|
| P1 | Beklenen ayrıntı düzeyini belirle | Yanıtın fazla yüzeysel veya aşırı ayrıntılı olmasını önlemek | “3-4 cümle ve bir somut örnekle açıkla” gibi sınır yazmak |
| P2 | Uzunluğu sınırlandır | Tekrar ve uzun girişlerin bilişsel yükünü azaltmak | En fazla iki kısa paragraf ve gereksiz giriş/özet yasağı koymak |
| P3 | Örnek sayısını sınırla | Çok sayıda örneğin ana kavramı gölgelemesini önlemek | Basit konuda bir, karmaşık konuda en fazla iki örnek kullanmak |
| P4 | Koruyucu örnekleri önceden seç | Genel veya bağlama uymayan örnekleri azaltmak | Deneme çalıştırmalarından en iyi 1-3 örneği sistem istemine eklemek |
| P5 | Yabancı terimleri engelle | Açıklanmayan jargonun bilişsel yükünü azaltmak | Yasaklı terim listesi ve ders dışı her terim için tanım zorunluluğu kullanmak |
| P6 | Destekleyici ton ekle | Tarafsız bilgi aktarımını hafif öğretmenlik tonuyla tamamlamak | Öğrencinin çabasını tanıyan ve keşfe davet eden bir kişilik tanımlamak |
| P7 | Bilgi tabanını dikkatle oluştur | Doğruluk ve ilgi düzeyini korumak | Ana ve destekleyici bütün alanları kapsayan kısa, güvenilir ders materyalleri eklemek |
| P8 | İşaretle, tekrar etme | Aynı bilgiyi farklı bölümlerde yeniden anlatmayı önlemek | Kısa başlıklar, tek geçiş kuralı ve önceki tanıma kısa gönderme kullanmak |
| P9 | Yapay zekâ yönlendirmesi ekle | Öğrenciyi yapıcı takip etkileşimine taşımak | Her oturumda açıklama, uygulama veya genişletme için tek bir özel takip sorusu önermek |
| P10 | Yapay zekâ kullanımını öğrenme çıktısı yap | Çalışmanın dersle ilişkisini görünür kılmak | Ders çıktısına analiz veya modelleme için sorumlu yapay zekâ kullanımını eklemek |
| P11 | Başlangıçta küçük atölye düzenle | Öğrenciler arasındaki yapay zekâ okuryazarlığı farkını azaltmak | 30-45 dakikalık istem, takip sorusu ve eleştirel değerlendirme uygulaması yapmak |
| P12 | Çalışmaya ders kredisi ver | Katılımı sürdürmek ve harcanan zamanı meşrulaştırmak | Gerekli emeğe göre toplam notun yüzde 1-5’ini ayırmak |
| P13 | Yönergeleri merkezîleştir | Erişim ve kullanım karışıklığını azaltmak | LMS’de erişim, istem örnekleri ve beklentileri içeren tek bir sayfa oluşturmak |
| P14 | Kısa konuşma notları iste | Yansıtma ve kullanım izlenebilirliği sağlamak | Öğrencinin kısa bir şablonla konuşma kaydını dışa aktarmasını istemek |
| P15 | Basit bilgi kontrolü rubriği kullan | Dikkatli kullanım ile yüzeysel katılımı ayırmak | Her soru için üç düzeyli hızlı puanlama uygulamak |
| P16 | Ölçekte değerlendirmeyi devret | Eğitmen iş yükünü azaltmak | Öğretim asistanlarını ortak örneklerle kalibre edip soru bazında toplu puanlama yapmak |
| P17 | Soru güçlüğünü ve biçimini çeşitlendir | Farklı başlangıç düzeylerine hitap etmek | Tanım, projeye uygulama ve küçük tasarım görevlerini birlikte kullanmak |
En yüksek kaldıraçlı beş uygulama
PDF’nin dokuzuncu sayfasındaki Tablo 3, uygulama maliyeti ve farklı yazılım mühendisliği derslerine aktarılabilirlik bakımından beş uygulamayı en yüksek öncelikli olarak seçmektedir:
| Öncelik | Uygulama | Hedeflenen sorun | Uygulama maliyeti |
|---|---|---|---|
| P7 | Bilgi tabanını dikkatle oluşturmak | Doğruluk ve konuya uygunluk | Orta |
| P2 | Yanıt uzunluğunu sınırlandırmak | Bilişsel yük ve gereksiz metin | Düşük |
| P8 | Bilgiyi işaretlemek, tekrar etmemek | Tekrar kaynaklı bilişsel yük | Düşük |
| P9 | Tek bir anlamlı takip yönlendirmesi eklemek | Öğrenme etkileşimi ve amaçlı devam soruları | Düşük |
| P4 | Örnekleri önceden denetlemek | Yanlış veya bağlama uymayan örnekler | Orta |
Çalışmanın güçlü yönleri nelerdir?
- Yapay zekâ öğretmenini gerçek bir ders ve gerçek ekip projesi içinde değerlendirmektedir.
- Programlama desteği yerine alan bilgisi ve yazılım modelleme gibi daha az incelenen becerilere odaklanmaktadır.
- Öğretmeni ders slaytları, proje gereksinimleri ve örnek teslimle temellendirmektedir.
- Standart istemler kullanarak öğrenciler arasında karşılaştırılabilir veri üretmektedir.
- Oturumlara göre tabakalı rastgele örneklemeyle üç konu alanının temsil edilmesini sağlamaktadır.
- Doğruluğu tek ölçüt olarak kullanmayıp ilgi, pedagojik değer, bilişsel yük ve destekleyiciliği birlikte değerlendirmektedir.
- İki öğretim asistanıyla alt küme üzerinde değerlendirici tutarlılığını kontrol etmektedir.
- Yalnızca olumlu sonuçları değil, destekleyicilik, uzunluk, jargon ve örnek uyumsuzluğu sorunlarını da raporlamaktadır.
- Bulguları eğitimcilerin doğrudan uygulayabileceği 17 maddelik rehbere dönüştürmektedir.
- Çalışmanın nedensel olmadığını ve öz-yeterliğin beceriyle aynı anlama gelmediğini açıkça belirtmektedir.
- İstemler, yapılandırma, anonimleştirilmiş kayıtlar, rubrik ve analiz betiklerini içeren çoğaltma paketi sunduğunu bildirmektedir.
Çalışmanın sınırlılıkları nelerdir?
- Tek kurum ve tek ders: Sonuçlar yalnızca Carnegie Mellon Silicon Valley’deki bir yüksek lisans dersi bağlamından gelmektedir.
- Küçük katılımcı sayısı: Toplam 29 öğrenci bulunmaktadır.
- Kontrol grubu yokluğu: Aynı etkinlikleri yapay zekâ kullanmadan tamamlayan karşılaştırma grubu bulunmamaktadır.
- Nedensel ayrım yokluğu: Kısa dersler, ekip uygulaması, bilgi kontrolleri ve not teşviki yapay zekâyla aynı dönemde uygulanmıştır.
- Öz-yeterlik ölçümü: Güven artışı doğrudan bilgi veya tasarım becerisi artışı değildir.
- Eksik eşleştirilmiş anketler: Öz-yeterlik analizleri 29 yerine 22 veya 23 öğrenciye dayanmaktadır.
- Standart istemler: Serbest ve doğal öğrenci konuşmaları yerine önceden belirlenmiş altı istem değerlendirilmiştir.
- Takip sorularının dışarıda bırakılması: Yapay zekâ öğretmeninin etkileşimli öğretim performansı tam olarak ölçülmemiştir.
- Tek model: Yalnızca GPT-3.5 Turbo kullanılmış; başka modellerle karşılaştırma yapılmamıştır.
- Model sürümü: 2024 dönemindeki GPT-3.5 davranışı güncel modelleri temsil etmeyebilir.
- Tek temel değerlendirici: Bütün örneklemi ders eğitmeni puanlamıştır.
- Tavan etkisi: Doğruluk ve ilgi puanları çok yüksek olduğundan rubrik küçük kalite farklarını ayırt etmekte zorlanabilir.
- Destekleyicilik ölçeği: Geçerliği doğrulanmış psikolojik bir ölçek değil, araştırmacının tanımladığı vekil ölçüttür.
- Zorunlu katılım: Ders kredisi yüksek katılım sağlarken öğrencileri yüzeysel biçimde etkinliği tamamlamaya da teşvik edebilir.
- Ortak ve kimlik doğrulamasız öğretmen: Kullanıcı düzeyi kişiselleştirme ve güvenli erişim değerlendirilmemiştir.
- Bilgi tabanı eksikleri: Bazı finans ve ileri DDD konularının yeterince kapsanmaması yanıt kalitesini etkilemiştir.
- Sayısal raporlama sorunları: Metindeki bazı yüzdeler Şekil 3 ve temel aritmetikle uyuşmamaktadır.
- Uzun dönem sonuçları: Öğrencilerin bilgiyi haftalar veya aylar sonra koruyup korumadığı ölçülmemiştir.
- Mahremiyet ve izleme: Konuşma kaydı toplamanın öğrenci mahremiyeti üzerindeki etkisi ayrıntılı olarak incelenmemiştir.
Çalışma neyi desteklemektedir?
- Ders materyalleriyle temellendirilmiş ve istem kurallarıyla sınırlandırılmış bir yapay zekâ öğretmeni, incelenen standart sorulara yüksek doğrulukta yanıt verebilir.
- Yapay zekâ, kısa ve yoğun bir tasarım aşamasından önce öğrencilere alan bilgisi ve modelleme kavramları konusunda isteğe bağlı zamanlarda destek sağlayabilir.
- Bilgi tabanı, yanıt uzunluğu, terim kullanımı ve örnek seçimi öğretmen kalitesini önemli ölçüde etkileyen yapılandırma unsurlarıdır.
- Doğru ve ilgili yanıtlar otomatik olarak destekleyici veya motive edici öğretmenlik anlamına gelmez.
- Yapay zekâ destekli etkinliklerin açık bir öğrenme çıktısı, küçük ders kredisi ve bilgi kontrolüyle programa yerleştirilmesi katılımı artırabilir.
- Öğrenciler uygulama sonrasında yapay zekâyla alan bilgisi edinme ve DDD uygulama konusunda daha yüksek güven bildirmiştir.
- Kısa konuşma kayıtları ve basit rubrik, öğretmenin kullanımını izlemek ve kaliteyi değerlendirmek için uygulanabilir bir iş akışı oluşturabilir.
- Öğretim asistanlarının ortak örneklerle kalibre edilmesi daha büyük sınıflarda değerlendirme iş yükünün paylaşılmasını destekleyebilir.
Çalışma neyi kanıtlamamaktadır?
- Yapay zekâ öğretmeninin öğrencilerin nesnel sınav veya tasarım performansını artırdığını kanıtlamamaktadır.
- Öz-yeterlik artışının yalnızca ChatGPT kullanımından kaynaklandığını göstermemektedir.
- GPT-3.5’in genel eğitim sorularında yüzde 98,9 doğrulukla çalıştığını göstermemektedir.
- Ders materyaliyle temellendirilen bütün yapay zekâ sistemlerinin halüsinasyonsuz olacağını kanıtlamamaktadır.
- Öğretmenin eğitmen veya öğretim asistanının yerini tamamen alabileceğini göstermemektedir.
- Serbest, uzun ve beklenmedik öğrenci konuşmalarında aynı kalite düzeyinin korunacağını göstermemektedir.
- Sonuçların lisans öğrencilerine, büyük sınıflara veya yazılım mühendisliği dışındaki alanlara doğrudan aktarılabileceğini kanıtlamamaktadır.
- Destekleyici ifadelerin öğrenmeyi veya başarıyı artıracağını deneysel olarak göstermemektedir.
- Ders kredisi verilmesinin yüzeysel kullanım riskinden daha fazla yarar sağladığını ayrı bir deneyle göstermemektedir.
- Güncel veya daha güçlü dil modellerinin aynı yapılandırmayla daha iyi sonuç vereceğini kanıtlamamaktadır.
- Yapay zekâ kullanımının etik, mahremiyet ve akademik dürüstlük sorunlarını çözdüğünü göstermemektedir.
Yazılım mühendisliği eğitimi açısından önemi
Çalışmanın temel katkısı, yapay zekâyı kod yazan bir yardımcıdan önce “tasarıma hazırlık aracı” olarak ele almasıdır. Bir yazılım projesinde yanlış alan modeli, daha sonra yazılan kod doğru olsa bile sistemin yanlış problemi çözmesine neden olabilir.
Ders materyalleriyle sınırlı bir yapay zekâ öğretmeni şu tür hazırlık görevlerinde kullanılabilir:
- Öğrencinin yabancı olduğu iş alanındaki temel terimleri açıklamak,
- Proje gereksinimlerindeki aktörleri ve haricî sistemleri fark ettirmek,
- Modelleme kavramlarını öğrencinin projesiyle ilişkilendirmek,
- Sınıf çalışmasından önce ortak bir başlangıç düzeyi oluşturmak,
- Eğitmenin tekrar eden temel açıklamalara ayırdığı zamanı azaltmak.
Ancak öğretmenin yalnızca yanıt veren bir sistem olarak değil, ders akışıyla bütünleşmiş bir araç olarak tasarlanması gerekir. Bilgi kontrolü, yansıtma, amaçlı takip sorusu ve eğitmen denetimi olmadan öğrencinin yanıtı yalnızca kopyalaması mümkündür.
Önerilen benimseme yolu
Araştırmacı, yapay zekâ destekli öğretimi ilk kez kullanacak dersler için aşamalı bir yol önermektedir:
- Yapay zekâ kullanımını açık bir öğrenme çıktısıyla tanımlamak.
- Toplam ders notunun yüzde 1-2’si gibi küçük bir kredi ayırmak.
- Basit bir kalite ve bilgi kontrolü rubriği uygulamak.
- Her öğrenci veya ekipten tek bir amaçlı takip sorusu istemek.
- Öğrenci sayısı yaklaşık 30’u geçtiğinde kısa konuşma kaydı şablonu kullanmak.
- Öğretim asistanlarını ortak örneklerle kalibre etmek.
- Düşük kaliteli veya riskli yanıtları otomatik sınıflandırmayla işaretleyip nihai kararı eğitmene bırakmak.
Gelecek çalışma önerilerinde farklı yazılım mühendisliği konuları ve sınıf büyüklüklerinde çoğaltma, serbest takip sorularının kalite-yük dengesinin değerlendirilmesi ve rubriğe dayalı yarı otomatik kalite taraması bulunmaktadır.
Çalışmanın Yöntemi ve Bulguları
Teknik yöntem özeti
| Teknik unsur | Çalışmadaki uygulama |
|---|---|
| Araştırma yaklaşımı | Tek ders bağlamında sınıf uygulaması ve deneyim temelli nicel değerlendirme |
| Ders | 2024 sonbaharı, 12 birimlik yüksek lisans işlevsel programlama dersi |
| Kurum | Carnegie Mellon University Silicon Valley |
| Katılımcı | 29 yüksek lisans öğrencisi |
| Ekip büyüklüğü | 3-4 öğrenci |
| Proje | ArbitrageGainer adlı otomatik kripto para arbitraj sistemi |
| İncelenen süre | İki haftalık ilk proje aşaması |
| Öğrenme alanları | Kripto para finansı ve Domain-Driven Design |
| Yapay zekâ sistemi | GPT-3.5 Turbo tabanlı özelleştirilmiş ChatGPT öğretmeni |
| Bilgi tabanı | Ders slaytları, proje şartnamesi ve örnek DDD öğrenci çözümü |
| Yapılandırma | Persona, görevler, kısıtlamalar, yapılacaklar/yapılmayacaklar ve cevap biçimi |
| Prototipleme | Sürüm başına beş deneme; dördüncü sürümde dondurulan yapılandırma |
| Ders öncesi etkinlik | Üç oturum; her oturumda iki standart istem |
| Toplam standart çift | Yaklaşık 174 istem-yanıt çifti |
| Konuşma birimi | Aynı oturumdaki iki standart istem; toplam 87 birim |
| Örnekleme | Her oturumdan 10 birim; 30 konuşma ve 60 istem-yanıt çifti |
| Örnekleme oranı | Yüzde 34,5 |
| Örnekleme yöntemi | Oturuma göre tabakalı, yerine koymadan rastgele seçim |
| Değerlendirme boyutları | Doğruluk, ilgi, pedagojik değer, bilişsel yük ve destekleyicilik |
| Puanlama | Her boyutta 0-3 |
| Temel değerlendirici | Ders eğitmeni ve çalışma yazarı |
| Tutarlılık kontrolü | İki öğretim asistanı, 15 konuşma; ağırlıklı κ=0,76 ve 0,78 |
| Öğrenci sonucu | Uygulama öncesi ve sonrası öz-yeterlik |
| Nedensel kontrol | Kontrol grubu bulunmamaktadır |
Yanıt kalitesi bulguları
| Boyut | Ortalama | Ana bulgu |
|---|---|---|
| Doğruluk | %98,9 | 60 yanıtın ikisinde küçük yanlışlık, önemli hata veya araştırmacının sınıflandırdığı halüsinasyon yok |
| İlgi düzeyi | %92,2 | Hiçbir yanıt 2 puanın altına düşmedi |
| Pedagojik değer | %89,4 | Yanıtlar genel olarak yapılandırılmış ve örnekli; bir yüzeysel yanıt 1 puan aldı |
| Bilişsel yük | %82,78 | Çoğu yanıt anlaşılır; tekrar, jargon ve uzunluk temel sorunlar |
| Destekleyicilik | %37,78 | Yanıtlar çoğunlukla tarafsız; öğrenciyi doğrulama ve takip adımı önerme zayıf |
Öz-yeterlik bulguları
- Yapay zekâyla alan bilgisi edinme öz-yeterliğinde büyük artış: F(1,22)=24,41; p<0,001; kısmi η²=0,53; dz≈1,03.
- Yapay zekâyla ortak projede DDD uygulama öz-yeterliğinde büyük artış: F(1,21)=14,81; p<0,001; kısmi η²=0,41; dz≈0,82.
- Genel DDD modeli oluşturma öz-yeterliğinde çok büyük artış: F(1,21)=45,82; p<0,001; kısmi η²=0,69; dz≈1,44.
- Üçüncü madde yapay zekâya doğrudan atıfta bulunmadığından keşifsel sonuç olarak değerlendirilmiştir.
- Analizler 29 öğrencinin tamamını değil, 22 veya 23 eşleştirilmiş yanıtı kapsamaktadır.
Sonuçların teknik yorumu
En güçlü sonuç, ders materyalleriyle temellendirilmiş bir yapay zekâ öğretmeninin belirli ve önceden tasarlanmış sorular için yüksek doğrulukta ve konuya uygun yanıt sağlayabilmesidir. Bu sonuç, bilgi tabanının kapsamı ve istem kısıtlarıyla yakından bağlantılıdır.
Pedagojik kalite yalnızca doğru bilgiyle belirlenmemektedir. Yanıtın uzunluğu, kullanılan terimlerin öğrenci seviyesine uygunluğu, örneklerin proje bağlamıyla eşleşmesi ve öğrenciyi anlamlı bir sonraki adıma yönlendirmesi ayrı tasarım problemleridir.
Öz-yeterlik artışları eğitim ortamının olumlu bir göstergesidir; ancak kontrol grubu ve nesnel yeterlik testi bulunmadığından öğrenme başarısına ilişkin nedensel kanıt değildir. Çalışmanın bulguları, yapay zekânın eğitmeni değiştirmesinden çok, eğitmenin tasarladığı ders akışında ölçeklenebilir bir hazırlık katmanı oluşturmasını desteklemektedir.
Raporlanan yüzdelerdeki küçük tutarsızlıklar ana örüntüyü değiştirmemektedir: doğruluk, ilgi ve pedagojik değer yüksek; destekleyicilik düşüktür. Bununla birlikte çoğaltma çalışmalarında ham puan dağılımlarının ve hesaplama betiklerinin açık biçimde yayımlanması sonuçların denetlenebilirliğini güçlendirecektir.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: From Domain Understanding to Design Readiness: a playbook for GenAI-supported learning in Software Engineering
Yazar: Rafal Wlodarski.
Eş katkı veya eş birinci yazar: Tek yazarlı çalışma olduğundan eş katkı durumu bulunmamaktadır.
Sorumlu yazar: PDF’de ayrıca “corresponding author” işareti kullanılmamıştır. Tek yazarın rafal.wlodarski@sv.cmu.edu e-posta adresi verilmiştir.
Kurumsal bağlantı: Electrical & Computer Engineering, Carnegie Mellon University Silicon Valley, Mountain View, California, ABD.
Yazarın kurumsal görevi: Assistant Teaching Professor, Electrical and Computer Engineering, Carnegie Mellon University.
Kaynak türü: Gerçek ders uygulaması, yanıt kalitesi değerlendirmesi, öz-yeterlik analizi ve öğretim uygulamaları içeren hakemli konferans bildirisi.
Konferans: Companion Proceedings of the 34th ACM Symposium on the Foundations of Software Engineering, FSE Companion ’26.
Konferans bölümü: Software Engineering Education.
Konferans tarihi ve yeri: 5-9 Temmuz 2026; Montreal, Quebec, Kanada.
Sayfalar: 1078-1088.
Yayın yılı: 2026.
Yayınevi: Association for Computing Machinery.
DOI: 10.1145/3803437.3805783.
ACM ISBN: 979-8-4007-2636-1/26/07.
Hakemlik durumu: Çalışma FSE 2026 Software Engineering Education programında kabul edilmiş ve ACM konferans bildirileri içinde yayımlanmıştır. Konferans çağrısı bu bölümde çift anonim değerlendirme süreci uygulandığını belirtmektedir.
Lisans: Creative Commons Attribution 4.0 International.
Resmî ACM bağlantısı:https://dl.acm.org/doi/10.1145/3803437.3805783
Resmî konferans programı:https://conf.researchr.org/track/fse-2026/fse-2026-software-engineering-education
ArXiv sürümü: arXiv:2604.00120v1; 31 Mart 2026.
ArXiv DOI’si: 10.48550/arXiv.2604.00120. Bu DOI preprint sürümüne aittir; çalışmanın birincil yayımlanmış DOI’si ACM DOI’sidir.
Resmî arXiv bağlantısı:https://arxiv.org/abs/2604.00120
Finansman: Çalışma, Generative Artificial Intelligence Teaching as Research Fellowship kapsamında finanse edilmiştir. Eberly ekibine uygulamanın gerçekleştirilmesine verdiği destek için teşekkür edilmiştir.
Çoğaltma paketi: Çalışma; standart istemler, öğretmen yapılandırması, rubrik materyalleri, izin verilen ölçüde kimliksizleştirilmiş konuşma ve puanlar ile analiz betiklerinin ek materyal olarak sunulduğunu bildirmektedir. PDF içinde doğrudan açık depo adresi gösterilmemiştir.
Çalışmanın temel sınırlılıkları; tek kurum ve küçük örneklem, kontrol grubu bulunmaması, öz-yeterliğin doğrudan beceri olmaması, bütün yanıtların tek uzman tarafından puanlanması, yalnızca standart istemlerin değerlendirilmesi, GPT-3.5’in başka modellerle karşılaştırılmaması ve kısa uygulama süresidir.
Çalışma, yapay zekâ öğretmeninin insan eğitmenin yerini alabileceğini veya öğrencilerin nesnel tasarım becerisini tek başına artırdığını kanıtlamamaktadır. Bulgular, ders materyalleriyle sınırlandırılmış ve dikkatle yapılandırılmış bir yapay zekâ öğretmeninin kısa süreli alan bilgisi ve modelleme hazırlığında eğitimi tamamlayıcı bir araç olarak kullanılabileceğini göstermektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir