


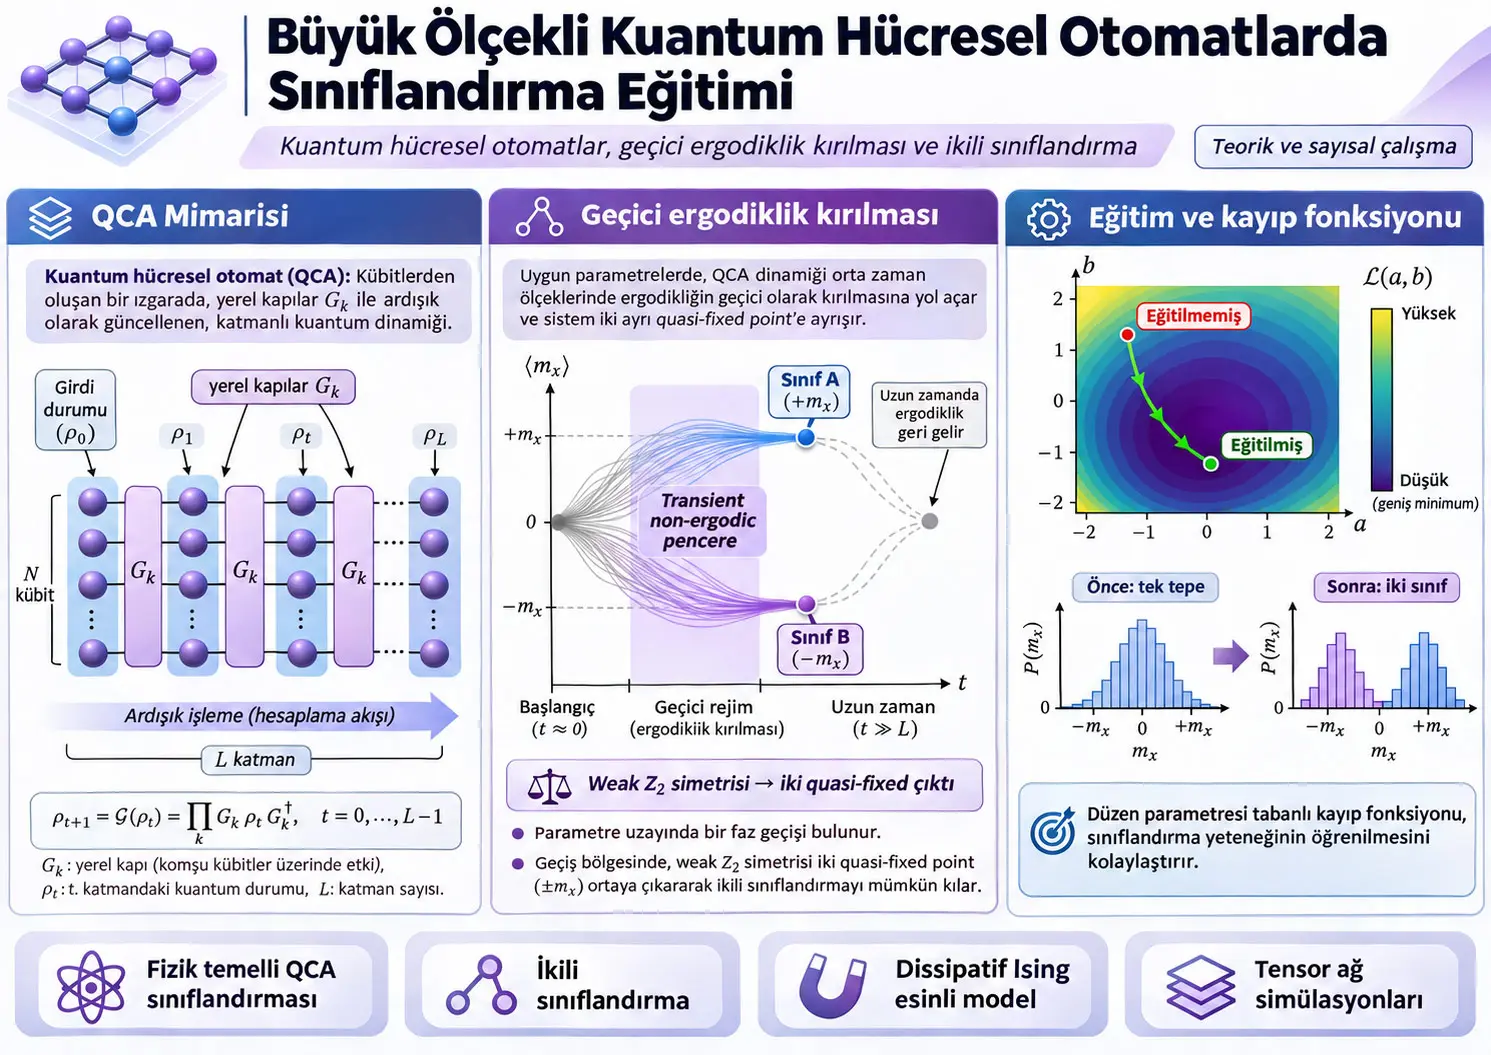
Kuantum hücresel otomat (quantum cellular automaton, QCA), kuantum bilgi taşıyan yerel hücrelerin belirli bir komşuluk kuralına göre tekrarlanan kuantum kapılarıyla katmandan katmana işlendiği bir kuantum hesaplama mimarisidir. Bu çalışma, dissipatif kuantum çok-cisim fiziğindeki faz geçişi, zayıf \(\mathbb{Z}_2\) simetrisi ve geçici ergodiklik kırılması mekanizmalarını kullanarak bir QCA'nın ikili sınıflandırma yeteneğinin yalnızca önceden elle seçilmiş fiziksel parametrelerle ortaya çıkmadığını, eğitim verilerinden gradient tabanlı optimizasyonla öğrenilebildiğini gösteren teorik ve sayısal bir çalışmadır.
Model, yerel etkileşim ve dissipasyon içeren \(\mathbb{Z}_2\)-simetrili dissipatif Ising dinamiğinden esinlenmiştir. Termodinamik limitte bu fiziksel model, paramanyetik ve ferromanyetik rejimler arasında sürekli bir faz geçişi gösterebilir. Ferromanyetik rejimde \(x\)-mıknatıslanmasının stationary order parameter'ı \(m_\infty^x\), birbirine simetriyle bağlı pozitif ve negatif iki değerden birini alabilir. Başlangıç durumunun hangi çekim havzasında bulunduğu, sistemin hangi sabit noktaya gideceğini belirler.
Ancak çalışmada kullanılan QCA sonlu boyutludur. Sonlu sistemde kalıcı spontan simetri kırılması ve sonsuza kadar süren katı ergodiklik kırılması beklenmez. Bunun yerine yazarlar, ara katmanlarda iki quasi-fixed point çevresinde kümelenmenin oluştuğu bir transient non-ergodic window gösterir. QCA'nın çıkış katmanı bu zaman penceresine yerleştirildiğinde iki makroskopik olarak farklı \(m^x\) değeri iki sınıf olarak okunabilir. Daha uzun zamanda ise bütün başlangıç durumları tek stationary state'e yaklaşır ve \(m^x\rightarrow0\) olur; yani ergodiklik geri gelir.
Faz geçişinin temel düzen parametresi, katmandaki bütün kübitlerin normalize edilmiş \(x\)-mıknatıslanmasıdır. Mean-field hesapları bir ferromanyetik faz bölgesi öngörür. Bir boyutta nearest-neighbor correlations hesaba katıldığında bu ferromanyetik bölge küçülür, fakat kaynakta incelenen geçiş sürekli kalır ve \(\mathbb{Z}_2\) simetri kırılması karakterini korur.
Doğrudan QCA simülasyonlarında \(\Omega=3\kappa\), \(V=15\kappa\) ve \(\kappa\delta t=0.1\) kullanılır. Başlangıç order parameter değerleri \(m_0^x\in[-0.5,0.5]\) aralığını kaplayan 2.000 durumun evriminde, \(N=10\) için geçici iki-kümeli yapı görülür; \(N=100\)'de aynı bimodal yapı daha belirgin ve histogram tepeleri daha keskin hale gelir. Bu büyüklük bağımlılığı, quasi-fixed point davranışının emergent many-body karakterini destekler.
Eğitim gösteriminde Hamiltonyen sabit tutulur ve yalnız jump operator:
içindeki iki gerçek parametre \(a\) ve \(b\) optimize edilir. Dört input–target eğitim çifti, sınıflandırma yapabilen bir referans QCA'dan üretilir. Sınıflandırma yapmayan \(a=-0.15,\;b=-1\) başlangıç noktasından başlayan QCA, \(L=10\) derinlikte, \(\epsilon=80\) learning rate ve ana gösterimde 100 parameter-update tekrarıyla eğitilir. Eğitim sonrasında tek tepeli output-magnetization dağılımı iki belirgin tepeye ayrılır; bu iki tepe ikili sınıflandırma davranışıdır.
Kayıp fonksiyonu tüm kuantum çıkış durumunun bir target state ile fidelity'sini ölçmek yerine fiziksel order parameter'daki hatayı ölçer. Kaynakta \(N=20\) için \((a,b)\) parametre düzlemindeki loss landscape'in geniş ve belirgin bir minimum sergilediği gösterilir. Yazarlar, bu physics-informed loss yapısının büyük durum uzaylarında ortaya çıkabilen barren-plateau türü trainability sorunlarına karşı avantaj sağlayabileceğini ileri sürer. Ancak çalışma bütün QCA veya kuantum sinir ağları için barren plateau'nun matematiksel olarak ortadan kaldırıldığını kanıtlamaz.
Çalışmanın “large-scale” ifadesi fiziksel bir büyük kuantum işlemcinin deneysel olarak eğitildiği anlamına gelmez. Sayısal hesaplamalar matrix product states ve matrix product operators kullanan tensor-network simülasyonlarıyla klasik hesaplama ortamında gerçekleştirilmiştir. Kaynakta tartışılan durum uzayı \(N=20\) için \(4^N\times4^N\), yaklaşık \(10^{24}\) ölçeğine ulaşır; tensor-network representation bu büyük uzayın tam yoğun matris biçiminde saklanmasını gerektirmeden ilgili yapının sıkıştırılmış biçimde işlenmesini mümkün kılar.
Araştırmanın temel problemi
Genel bir kuantum makine öğrenmesi mimarisinde iki ayrı problem vardır. Birincisi, kuantum dinamiğinin hangi fiziksel özelliğinin veri işlemede kullanılacağını anlamaktır. İkincisi ise bu özelliği ortaya çıkaran parametrelerin eğitim verilerinden güvenilir biçimde öğrenilip öğrenilemeyeceğidir.
Bu çalışma sınıflandırmayı doğrudan çok-cisim sistemindeki faz geçişi, simetri kırılması, quasi-fixed point ve order parameter kavramlarına bağlar. Böylece sınıflandırma için soyut bir yüksek-boyutlu target-state fidelity yerine fiziksel olarak yorumlanabilir makroskopik bir büyüklük kullanılır.
Klasik Hopfield ağlarında çekim havzaları ve sabit noktalar hafıza veya desen olarak yorumlanabilir. Kaynak benzer fiziksel mantığın dissipatif quantum many-body dynamics içinde QCA bilgi işleme işlevine dönüşebileceğini araştırır. Burada temel fikir, farklı başlangıç durumlarının geçici olarak birbirinden ayrılan iki makroskopik dinamik yola yönelmesidir.
Kuantum Hücresel Otomat Bu Çalışmada Nasıl Sınıflandırma Yapıyor?
Bu çalışmadaki kuantum hücresel otomat, başlangıç kuantum durumlarını dissipatif Ising-benzeri dinamik altında evrimleştirerek geçici non-ergodik zaman penceresinde \(x\)-mıknatıslanmasının birbirine \(\mathbb{Z}_2\) simetrisiyle bağlı iki quasi-fixed değerinden birine yönlendirir; QCA'nın çıkış katmanı bu pencereye yerleştirildiğinde pozitif ve negatif order-parameter kümeleri iki ayrı sınıf olarak okunur, ancak uzun zamanda bu ayrım ortadan kalkar ve sistem yeniden tek stationary state'e yaklaşır.
QCA'nın geometrisi ve katman mantığı
Kaynak QCA'yı iki boyutlu bir kübit kafesi üzerinde tanımlar. Dikey yönde \(N\) site, yatay yönde ise \(L+1\) katman bulunur.
Her site iki temel duruma sahip bir kübittir:
Dikey bir sütun, belirli bir \(t\) zaman indeksindeki QCA katmanıdır. İlk katmana:
giriş kuantum durumu yerleştirilir. Sonraki katmanlar başlangıçta vakum durumundadır.
Yatay yön fiziksel bir uzay koordinatı olmak zorunda değildir; QCA'nın tekrarlanan hesaplama/zaman yönü olarak yorumlanır. Böylece:
katmanları, dissipatif bir kuantum spin zincirinin ayrık zaman örnekleri gibi davranır.
Bir katmandan diğerine kuantum durum nasıl aktarılıyor?
Kaynak QCA durum güncellemesini Denklem (1) ile tanımlar:
Formül neyi hesaplar? Bir önceki katmanın reduced density matrix'i \(\rho_{t-1}\)'den yeni katmanın reduced density matrix'i \(\rho_t\)'yi üretir.
\(\rho_{t-1}\): önceki QCA katmanındaki kuantum durumudur.
\(|\mathbf 0\rangle\langle\mathbf 0|\): yeni katmandaki kübitlerin başlangıç vakum durumudur.
\(\mathcal G\): iki komşu katman üzerinde uygulanan global quantum gate'dir.
\(\mathcal G^\dagger\): global gate'in Hermitian conjugate'ıdır.
\(\mathrm{Tr}_{t-1}\): eski katmanın degrees of freedom'ları üzerinde partial trace alır. Başka bir ifadeyle eski katman artık çıktı sisteminin parçası değildir.
Bu nokta dissipatif dinamiği anlamak için önemlidir. İki katman birlikte daha büyük bir kuantum sisteminde gate evolution geçirirken, önceki katmanın trace edilmesi yeni katmanın reduced dynamics'ini genel olarak nonunitary hale getirir. Böylece gate-based QCA, Markovian open-quantum-system dinamiğine yaklaşabilir.
Global gate nasıl oluşturuluyor?
Yerel kapılar:
komşu iki katmanın \(k\). site çevresinde hareket eder. Global iki-katman gate, sınır terimleri dışında:
biçiminde oluşturulur.
Kaynağın Denklem (2)'si:
Burada kaynak:
tanımını kullanır.
Sağdaki üstel terim:
önceki katmandaki sistemin \(H_k\) yerel Hamiltonyeni altında coherent evolution'ını üretir.
Ortadaki üstel terim:
eski ve yeni katman arasında \(J_k\) jump operator'larına bağlı etkileşimi oluşturur. Yeni katmanla etkileşimden sonra eski katmanın trace edilmesi, effective dissipative dynamics üretir.
\(\mathrm{SWAP}_k\): ilgili eski ve yeni katman kübitlerinin durumlarını değiş tokuş eder.
\(\delta t\): ayrık zaman adımıdır. Kaynak, \(\delta t\ll1\) limitinde katman güncellemesinin sürekli Markovian dissipative dynamics'e yaklaştığını kullanır.
QCA ile Lindblad dinamiği arasındaki bağlantı
Küçük \(\delta t\) için:
Buradaki \(\mathcal L\), Lindblad generator'dır:
\([\ ,\ ]\): commutator'dır. İlk terim Hamiltonyen kaynaklı coherent quantum dynamics'i temsil eder.
\(\{\ ,\ \}\): anticommutator'dır.
\(J_k\bullet J_k^\dagger-\frac12\{J_k^\dagger J_k,\bullet\}\): Lindblad dissipator'ın jump-process contribution'ıdır.
\(\bullet\): superoperator'ın üzerine etki ettiği density operator için kullanılan yer tutucudur.
Dolayısıyla çalışma yalnız “kuantum devresi katmanları” diliyle kalmaz; aynı QCA'yı dissipatif many-body quantum dynamics açısından yorumlar. Sınıflandırma mekanizmasının fiziksel açıklaması da bu bağlantı üzerinden kurulur.
Ising-benzeri yerel Hamiltonyen ve dissipasyon
Kaynak özel sınıflandırıcı model için:
kullanır.
\(\Omega\): transverse field strength'tir.
\(V\): nearest-neighbor spin interaction strength'tir.
\(\kappa\): \(z\)-basis'teki local decay rate'tir.
\(\sigma_k^-\): lowering operator'dır.
Faz diyagramında doğal boyutsuz kontrol parametreleri:
olarak kullanılır. Böylece mutlak enerji/frekans ölçeğinden ziyade coherent drive ve interaction'ın decay scale'e göre büyüklüğü karşılaştırılır.
Zayıf \(\mathbb{Z}_2\) Simetrisi Sınıflandırma İçin Neden Önemli?
Zayıf \(\mathbb{Z}_2\) simetrisi, Lindblad generator'ın global \(z\)-parity dönüşümü altında değişmeden kalmasını ve \(m^x\) order parameter'ının birbirine simetriyle bağlı \(+m^x\) ve \(-m^x\) dinamik dallarının oluşabilmesini sağlar; termodinamik modelde bu iki dal symmetry-broken fixed points oluştururken sonlu QCA'da aynı yapı geçici iki quasi-fixed point halinde görünür ve bu iki makroskopik çıktı ikili sınıflandırmanın fiziksel temelini oluşturur.
Zayıf simetri matematiksel olarak nasıl yazılıyor?
Kaynak global parity superoperator'ını:
ile tanımlar.
Weak symmetry koşulu:
şeklindedir.
Bu, Lindblad evolution ile parity transformation'ın uyumlu olduğunu ifade eder. Bir başlangıç durumunun parity-dönüştürülmüş eşinin dinamiği, orijinal dinamiğin parity-dönüştürülmüş karşılığıdır.
\(\sigma^z\) dönüşümü altında \(x\)-mıknatıslanması işaret değiştirir. Bu nedenle birbirinin simetri partneri olan iki durum:
şeklinde eşleşebilir.
Ergodiklik nedir?
Bu çalışmanın bağlamında ergodiklik, uzun-zaman davranışının başlangıç durumuna ilişkin bilgiyi kaybetmesi ve farklı başlangıç durumlarının aynı stationary behavior'a yönelmesiyle ilişkilidir.
Ergodiklik kırıldığında ise farklı initial conditions farklı attraction basin'lerde bulunabilir ve farklı uzun-zaman veya metastable/quasi-stationary yapılara yönlenebilir.
Bu ayrım sınıflandırma açısından doğaldır:
- aynı basin'e yönelen girdiler aynı sınıfa,
- diğer basin'e yönelen girdiler diğer sınıfa
atanabilir.
Fixed point ile quasi-fixed point arasındaki fark
Fixed point, dinamiğin gerçekten değişmeden kalabildiği stationary durumdur.
Quasi-fixed point, sonlu bir zaman aralığında dinamiğin yakınında uzun süre kalabildiği fakat sonsuz zamanda kalıcı olmak zorunda olmayan metastable-benzeri dinamik yapıdır.
Bu makalenin QCA sınıflandırması için ikinci kavram kritiktir. Sonlu QCA'nın iki sınıfı kalıcı iki stationary state değildir; transient window içindeki iki quasi-fixed pointtir.
Order parameter nasıl tanımlanıyor?
Kaynak magnetization components'ı:
ile tanımlar.
\(N\): bir katmandaki kübit sayısıdır.
\(\sigma_k^\mu\): \(k\). site üzerindeki Pauli operator'dır.
\(\rho_t\): \(t\). katmanın density matrix'idir.
\(m_t^\mu\): bütün katmana yayılmış normalize edilmiş kolektif magnetization'dır.
Kaynağın normalizasyonu nedeniyle saf product-state sampling'de tek-kübit Bloch bileşenlerine karşılık gelen \(m^\mu\) değerlerinin doğal sınırı:
olur.
Mean-field yaklaşımı nedir?
Mean-field approximation, çok-cisim density matrix'ini translation-invariant tek-site durumlarının çarpımıyla yaklaşıklar:
Bu yaklaşımda siteler arasındaki connected quantum correlations ayrı bağımsız değişkenler olarak tutulmaz. Her site, diğerlerinin ortalama etkisini hisseder.
Kaynağın bir boyuttaki mean-field equations'ı:
Denklem (6a) ne anlatıyor?
ifadesinde \(-\Omega m^y\), transverse-field kaynaklı coherent rotation coupling'ini; \(-\kappa m^x/2\) ise dissipative decay'nin \(x\)-magnetization üzerindeki sönüm etkisini temsil eder.
Denklem (6b) ne anlatıyor?
ifadesi field-induced rotation ile many-body interaction contribution'ını birleştirir. \(2Vm^xm^z\) nonlinear terimi nedeniyle kolektif dinamik yalnız bağımsız tek-kübit rotasyonlarından oluşmaz.
Denklem (6c) ne anlatıyor?
ifadesinde interaction term \(x\) ve \(y\) magnetization components'ı üzerinden \(z\) bileşenini etkiler. Dissipative term sistemi kaynak normalizasyonunda \(m^z=-1/2\) yönüne doğru sürer.
Fazları ayıran order parameter
Stationary \(x\)-magnetization:
fazı ayırmak için kullanılır.
| Rejim | Stationary \(m_\infty^x\) | Simetri | Dinamik yorum |
|---|---|---|---|
| Paramanyetik (PM) | \(0\) | \(\mathbb{Z}_2\) kırılmamış | Tek stationary çözüm |
| Ferromanyetik (FM) | \(\neq0\) | \(\mathbb{Z}_2\) kırılmış | \(+m_\infty^x\) veya \(-m_\infty^x\); başlangıç durumuna bağlı iki dal |
Nearest-neighbor correlations neden ayrıca inceleniyor?
QCA bir-boyutlu spin zinciri dinamiğine karşılık geldiği için fluctuations ve spatial correlations mean-field approximation'ın öngörülerini değiştirebilir. Yazarlar bu nedenle tek bir nearest-neighbor bond üzerindeki iki-cisim korelasyonlarını açıkça tutan daha gelişmiş bir yaklaşık çözüm oluşturur.
Kaynak sonucuna göre nearest-neighbor correlations:
- ferromanyetik fazın parametre uzayındaki alanını küçültir,
- ancak incelenen PM–FM faz geçişinin sürekli karakterini değiştirmez,
- \(\mathbb{Z}_2\) symmetry-breaking mekanizmasını ortadan kaldırmaz.
Nearest-neighbor yaklaşımının temel yoğunluk matrisi
Supplementary Material tek-site ve iki-site reduced density matrices'i:
ile tanımlar.
Tek bir nearest-neighbor bond üzerindeki connected correlation:
şeklindedir.
Mean-field durum:
olduğundan saf mean-field limitinde:
Korelasyonlu trial state'in temel yapısı:
Bu yaklaşımda seçilen nearest-neighbor bond üzerindeki iki-site correlation açıkça korunurken, çevredeki diğer sitelerin etkisi mean-field düzeyinde tutulur.
Koordinasyon sayısı \(q\) neyi ifade ediyor?
Ek materyal modeli genel bir \(d\)-boyutlu hypercubic lattice üzerinde yazar:
\(q\), bir sitenin nearest-neighbor sayısıdır. Toplam bond sayısı:
olur. QCA için ele alınan bir-boyutlu durumda:
Bu nedenle tek-bond korelasyon düzeltmesi düşük boyutta ihmal edilemeyecek kadar önemlidir.
Tek-site ve iki-site Hamiltonyen parçaları
Supplementary Material:
ve:
ayrımını kullanır.
İki-body reduced density matrix'in exact dynamics'i genel olarak üç-body density matrix'e bağlandığından bir BBGKY-benzeri hierarchy ortaya çıkar. Bu hierarchy kendiliğinden kapalı değildir. Kaynak:
yaklaşımıyla seçilen \(a,b\) bond'unu exact tutup çevreyi factorized mean-field olarak ele alarak sistemi kapatır.
İki-site density matrix'in Pauli tabanındaki açılımı
İki kübitlik reduced density matrix, Pauli basis üzerinde:
şeklinde ifade edilir.
İki-point correlation functions:
Tek-site magnetization components ise translation invariance altında:
Bu parametrizasyon sonucunda üç one-point ve dokuz two-point quantity olmak üzere toplam 12 bağımsız dinamik değişken elde edilir.
Nearest-neighbor korelasyonlu 12 hareket denklemi
Kaynağın Supplementary Material'ında faz diyagramının correlation-corrected sürümünü üretmek için aşağıdaki denklem takımı kullanılır:
Bu denklemlerde iki farklı fiziksel katkı görülebilir. Seçilen bond üzerindeki terms \(Vm^{z,x}\), \(Vm^{y,x}\) gibi explicit two-point correlations içerir; diğer \(q-1\) komşunun etkisi ise \(V(q-1)m^\alpha m^\beta\) biçimindeki mean-field terms üzerinden gelir.
Kaynağın önemli boyut sonucu şudur: bir boyutta \(q=2\) olduğundan exact tutulan tek-bond korelasyonu ile çevredeki mean-field contribution aynı mertebededir. \(q\gg1\) olan yüksek boyutlarda ise tek bir bond'un contribution'ı göreli olarak küçülür ve mean-field yaklaşımı daha doğal hale gelir.
Yüksek koordinasyon sayısında mean-field limit
\(q\gg1\) için:
factorization kullanıldığında sistem:
denklemlerine iner.
Bir boyut için \(q=2\) yerleştirildiğinde ana metindeki Denklem (6a)–(6c) geri kazanılır.
Çalışmanın Yöntemi ve Bulguları
Faz diyagramı analizi
Yazarlar önce dissipatif Ising-inspired modelin stationary phase diagram'ını mean-field ile çözer. Yatay eksen:
dimensionless field strength, dikey eksen:
dimensionless interaction strength'tir.
Mean-field phase map iki temel bölge gösterir:
- \(m_\infty^x=0\) olan paramanyetik bölge,
- \(|m_\infty^x|>0\) olan ferromanyetik symmetry-broken bölge.
Nearest-neighbor correlations dahil edildiğinde FM bölgesi küçülür. Kaynak \(V=3\kappa\) doğrusu üzerindeki kesitte hem mean-field hem correlation-corrected çözümün PM–FM geçişini sürekli olarak gösterdiğini raporlar.
Kaynak grafiğinin ham grid değerleri verilmediği için Verianla belirli bir \(\Omega/\kappa\) kritik değerini görselden okuyup kesin sayı olarak üretmemektedir.
Finite-size QCA'da transient ergodicity breaking
Doğrudan QCA simülasyonunda kullanılan temel koşullar:
| Parametre | Kaynak değeri | Anlamı |
|---|---|---|
| \(\Omega\) | \(3\kappa\) | Transverse field |
| \(V\) | \(15\kappa\) | Nearest-neighbor interaction |
| \(\kappa\delta t\) | 0.1 | Boyutsuz ayrık zaman adımı |
| Initial states | 2.000 | \(m_0^x\in[-0.5,0.5]\) aralığını kaplayan başlangıç durumları |
| Sistem boyutları | \(N=10\) ve \(N=100\) | Layer başına kübit sayısı |
| \(\chi_{\mathrm{MPS}}\) | 48 | Matrix-product-state bond dimension |
| \(\chi_{\mathrm{MPO}}\) | 16 | Matrix-product-operator bond dimension |
| Histogram katmanı | \(t=8\) | Transient bimodality'nin incelendiği katman |
| Histogram bin size | 0.005 | Kaynak histogramının bin genişliği |
\(N=10\) ve \(N=100\) karşılaştırması
\(N=10\)'da 2.000 magnetization trajectory ara katmanlarda iki quasi-fixed value çevresinde yoğunlaşmaya başlar ve \(t=8\) histogramı bimodal yapı gösterir.
\(N=100\)'de iki grubun histogram tepeleri daha yüksek ve daha keskin hale gelir. Kaynak bunu quasi-fixed point'lerin sistem boyutu arttıkça daha belirgin hale gelen emergent davranışı olarak yorumlar.
Fakat bu iki tepe sonsuz zamanda sabit kalmaz. Daha uzun QCA derinliğinde trajectories tek \(m^x=0\) stationary state'e yaklaşır.
Başlangıç durumlarının nasıl üretildiği
Supplementary Material'da ilk olarak \(n=1000\) translation-invariant product states üretilir:
Tek-kübit saf durum:
Bloch-sphere açıları magnetization components üzerinden:
ve:
koşuluyla belirlenir.
Neden arctan2 kullanılıyor?
Normal \(\arctan(y/x)\), \(x\) ve \(y\)'nin işaret bilgisine bağlı olarak hangi quadrant'ta bulunulduğunu tek başına güvenilir biçimde ayıramaz. \(\operatorname{arctan2}(y,x)\), \(x\) ve \(y\) işaretlerini birlikte kullanarak doğru \(\phi\in(-\pi,\pi]\) açısını seçer.
İlk 1.000 state nasıl uniform dağıtılıyor?
Kaynak önce:
aralığında uniform sampling yapar.
Sonra:
ile diğer iki component belirlenir.
Bu sampling Bloch sphere üzerinde Haar-uniform sampling olarak tanımlanmamıştır. Kaynağın amacı \(m_0^x\) order parameter eksenini bias oluşturmadan kaplamaktır.
Diğer 1.000 başlangıç durumu nasıl elde ediliyor?
İkinci 1.000 durum bağımsız biçimde yeniden örneklenmez; ilk 1.000 durumun \(\mathbb Z_2\) partnerleri oluşturulur:
Bunun sonucu:
olur.
QCA map'i \(\Lambda\) için weak symmetry:
olduğundan bütün katmanlarda:
simetrisi korunur.
Bu sampling yöntemi neden önemli?
Eğer başlangıç durumları \(m_0^x\) açısından dengesiz örneklenmiş olsaydı, output histogramındaki iki tepenin yükseklik veya yoğunluk yapısı sampling bias'tan etkilenebilirdi. Kaynak bu nedenle \(m_0^x\) eksenini simetrik biçimde kaplayan 2.000 durum üretir.
Eğitilebilir jump operator
Classification-capable fiziksel modelde jump operator:
biçimindedir. Eğitimin amacı ise QCA'nın bunu doğrudan bilmeden uygun dissipative coupling'i öğrenip öğrenemeyeceğini araştırmaktır.
Bunun için iki trainable real parameter kullanılır:
\(a\): \(\sigma^x\) contribution'ının gerçek katsayısıdır.
\(b\): \(i\sigma^y\) contribution'ının gerçek katsayısıdır.
Bu parametrizasyon uygun \(a,b\) değerleri için kaynak Ising jump operator'ını da kapsar.
Eğitim sırasında \(H_k\) Hamiltonyenleri güncellenmez. Yani çalışma bütün QCA gate structure'ını serbestçe optimize etmez; yalnız jump operator'ın iki global parametresini eğitir.
Eğitim verisi nasıl hazırlanıyor?
Kaynak eğitim verisini:
input state–target magnetization çiftleri olarak tanımlar.
Ana eğitim gösteriminde:
Bu dört target pair, sınıflandırma özelliğine sahip bir referans QCA'nın evriminden elde edilir.
Referans QCA:
değerlerini kullanır ve bu seçim \(\sigma^-\)-tipi jump operator'ı gerçekleştirir.
Bu noktayı 2.000 trajectories ile karıştırmamak gerekir: model dört training pair ile eğitilir; 2.000 başlangıç durumu eğitim öncesi/sonrası dinamik sınıflandırma yapısını görselleştirmek için kullanılır.
Düzen Parametresi Tabanlı Kayıp Fonksiyonu Neden Önemli?
Çalışmanın düzen parametresi tabanlı kayıp fonksiyonu, yüksek boyutlu kuantum çıkış durumunun tamamını bir target state ile karşılaştırmak yerine yalnız sınıflandırmayı fiziksel olarak taşıyan makroskopik \(x\)-mıknatıslanmasının hedef değerden sapmasını cezalandırır; kaynakta bu seçim \((a,b)\) parametre düzleminde geniş ve belirgin minimumlara sahip yapılandırılmış bir loss landscape üretir ve gradient-descent eğitiminin büyük durum uzayında uygulanabilir kalmasına yardımcı olur.
Kayıp fonksiyonunun tam yapısı
Kaynak Denklem (8):
Formül neyi hesaplar? Her training sample için QCA output order parameter ile hedef output magnetization arasındaki farkı hesaplar, karesini alır ve bütün \(P\) örnek üzerinde ortalar.
\(\rho_{\mathrm{out}}^{(\nu)}\): \(\nu\). input state'in QCA çıkış density matrix'idir.
\(m_{x,\mathrm{out}}^{(\nu)}\): \(\nu\). örnek için istenen target output magnetization'dır.
\(\frac1{2N}\sum_k\sigma_k^x\): fiziksel classification observable'dır.
Bu loss tüm quantum state amplitudes'in tek tek target state ile eşleşmesini zorlamaz. Sınıflandırma için önemli olan tek makroskopik output quantity'yi optimize eder.
Barren plateau ile bağlantı
Barren plateau, bazı parametrik quantum circuits'te sistem büyüdükçe cost-function gradient'lerinin çok küçük hale gelmesi ve optimization landscape'in büyük bölgelerde neredeyse düzleşmesi problemidir.
Kaynakta order-parameter loss'un \((a,b)\) düzlemindeki landscape'i yapılandırılmış ve geniş bir minimum gösterir. Yazarlar bunun physics-informed architecture ve physical order-parameter loss ile bağlantılı olduğunu tartışır.
Ancak sonuç şu şekilde sınırlandırılmalıdır:
- çalışma incelenen QCA'nın trainable olduğunu sayısal olarak gösterir,
- loss landscape'in broad minima içerdiğini gösterir,
- fidelity-type losses ile bilinen barren-plateau sorunlarına kavramsal karşıtlık kurar,
- fakat bütün QCA'larda veya bütün sistem boyutlarında barren plateau bulunmayacağını matematiksel olarak kanıtlamaz.
Gradient update
Jump operator parametreleri:
şeklinde güncellenir.
Burada:
\(\widetilde a,\widetilde b\), loss'u en hızlı azaltan steepest-descent yönünü belirler; \(\epsilon\) ise learning rate'tir.
Ana eğitim koşulları
| Öğe | Değer |
|---|---|
| QCA depth | \(L=10\) |
| Loss-landscape sistem boyutu | \(N=20\) |
| Training pair | \(P=4\) |
| Reference/teacher jump parameters | \(a=1/2,\;b=-1/2\) |
| Untrained başlangıç | \(a=-0.15,\;b=-1\) |
| Hamiltonyen | \(\Omega=3\kappa,\;V=15\kappa\), eğitimde sabit |
| Learning rate | \(\epsilon=80\) |
| Ana Şekil 4 update repetitions | 100 |
| \(\chi_{\mathrm{MPS}}\) | 48 |
| \(\chi_{\mathrm{MPO}}\) | 16 |
| Output dağılımını gösteren initial states | 2.000 |
| Histogram bin size | 0.005 |
Eğitimden önce ne oluyor?
\(a=-0.15,\;b=-1\) parametreleriyle başlatılan untrained QCA, iki quasi-fixed output class üretmez. \(L=10\) output katmanındaki \(m_{10}^x\) histogramı kaynakta tek tepe çevresinde toplanır.
Eğitimden sonra ne oluyor?
100 parameter update sonrasında output trajectories iki farklı magnetization çevresinde yoğunlaşır. Kaynak Şekil 4 bunları class A ve class B olarak gösterir ve output histogramı iki açık tepe içerir.
Bu, QCA'nın başlangıçta bulunmayan binary classification capability'yi training data'dan edindiğinin kaynak içindeki doğrudan gösterimidir.
Neden yalnız iki parametreyle sınıflandırma öğrenilebiliyor?
Bu deney, genel bir kuantum sinir ağındaki milyonlarca serbest parametreyi optimize etmiyor. Fiziksel model sınıflandırma mekanizmasını zaten mümkün kılabilecek bir architecture ve symmetry structure içeriyor. Eğitim yalnız sistemin dissipative jump operator'ını uygun physical regime'e taşıyan iki coupling parameter'ı bulmaya çalışıyor.
Bu yüzden çalışma “her keyfi kuantum model dört örnekle eğitilebilir” sonucunu desteklemez. Dört training pair, fiziksel olarak ön-yapılandırılmış bu spesifik iki-parametreli demonstration için yeterli olmuştur.
Durum uzayı neden çok büyük?
Bir \(N\)-kübit saf state'in Hilbert-space dimension'ı üstel olarak büyür. Density-operator/superoperator description daha da büyük nesneler gerektirir. Kaynak, incelenen state spaces için:
ölçeğini verir.
\(N=20\) için:
ve dolayısıyla ilgili iki-indisli ölçek:
mertebesindedir.
Bu sayı kaynağın “\(\sim10^{24}\)” ifadesinin ne anlama geldiğini öğretmek amacıyla aritmetik olarak açılmıştır; yeni simülasyon sonucu değildir.
Tensor network neden gerekli?
Tam density matrices ve superoperators doğrudan tutulduğunda üstel büyüyen bellek ve hesaplama maliyeti ortaya çıkar. Matrix product state ve matrix product operator representations, belirli kuantum durum ve operatörlerdeki yapıyı sıkıştırılmış tensorlar halinde temsil ederek tam uzayın bütün katsayılarını explicit olarak depolamadan simülasyon yapılmasına olanak verir.
Bu yaklaşımın ana kontrol parametresi bond dimension \(\chi\)'dir. Genel olarak daha yüksek \(\chi\):
- daha fazla correlation/entanglement structure'ın korunmasına,
- daha düşük truncation error'a,
- fakat daha yüksek computational cost'a
karşılık gelir.
Bond-dimension sağlamlık kontrolü
| Analiz | Referans ayar | Kontrol ayarı | Kaynak sonucu |
|---|---|---|---|
| QCA dynamics | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=96,\;\chi_{\mathrm{MPO}}=16\) | Görünür nitel değişiklik yok; \(N=100\) histogram tepeleri yalnız biraz daha yüksek. |
| QCA dynamics | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=32\) | Kaynak görünür nitel değişiklik raporlamıyor. |
| Training stability | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=64,\;\chi_{\mathrm{MPO}}=16\) | Initial/trained dynamics, loss landscape ve gradient path ana sonuçla nitel olarak uyuşuyor. |
| Training stability | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=32\) | Sonuçlar ana training simulation ile nitel olarak aynı kalıyor. |
Supplementary training-stability kontrolünde 50 update repetition, \(\epsilon=80\) ve \(N=20\) kullanılır. Bu sayı ana Şekil 4'teki 100 update repetition ile karıştırılmamalıdır.
Kaynak ayrıca \(\chi_{\mathrm{MPO}}=16\) için discarded singular values'ın kareleri toplamının karekökünün makine hassasiyeti mertebesinde olduğunu belirtir ve bu MPO bond dimension'ını yeterli kabul eder.
Transient bimodality düşük bond dimension artefaktı mı?
Kaynağın Supplementary robustness tests'i bu olasılığı özellikle kontrol eder. Bond dimensions artırıldığında iki quasi-fixed-point yapısının ve bimodal output distribution'ın nitel olarak korunması, gözlenen transient ergodicity breaking'in yalnız \(\chi_{\mathrm{MPS}}=48\) veya \(\chi_{\mathrm{MPO}}=16\) truncation seçiminin ürettiği basit bir artefakt olmadığını destekler.
Bu Çalışma Kuantum Üstünlüğünü veya Gerçek Veri Sınıflandırma Başarısını Gösteriyor mu?
Hayır; çalışma tensor-network yöntemleriyle klasik bilgisayarda simüle edilen, sentetik kuantum başlangıç durumlarını fiziksel \(x\)-mıknatıslanması üzerinden iki sınıfa ayıran bir QCA'nın trainability'sini gösterir, ancak gerçek quantum hardware üzerinde quantum speedup veya quantum advantage ölçmez ve görüntü, metin, biyomedikal veri ya da başka bir gerçek dünya benchmark'ında accuracy, F1 veya AUC türü sınıflandırma performansı raporlamaz.
“Efficiently learned” ifadesi nasıl okunmalı?
Kaynağın “efficiently learned” iddiası, incelenen physics-informed QCA'da yüksek-boyutlu state space'e rağmen order-parameter loss landscape'in broad minima ve kullanılabilir gradient structure göstermesine dayanır.
Bu ifade:
- classical computational complexity açısından polynomial-time proof,
- kuantum işlemcide wall-clock speedup,
- classical classifier'a karşı üstün accuracy,
- ölçeklenebilir fault-tolerant hardware demonstration
anlamına gelmez.
Multiclass classification bu makalede gösterildi mi?
Hayır. Makalenin doğrudan sayısal demonstration'ı \(\mathbb Z_2\)-symmetry ve iki quasi-fixed point nedeniyle binary classification üzerindedir.
Yazarlar daha yüksek simetriye sahip many-body systems kullanılarak multiclass classification'ın benzer biçimde gerçekleştirilebileceğini gelecek/genelleştirilebilir yön olarak tartışır. Bu ifade makalede gösterilmiş bir multiclass benchmark sonucu değildir.
NISQ donanımı kullanıldı mı?
Hayır. Kaynak NISQ devices üzerindeki noise'un gelecekte azaltılıp azaltılamayacağını veya QCA dynamics zaten effective dissipative olduğu için gürültünün bazı durumlarda yararlı biçimde kullanılıp kullanılamayacağını gelecek araştırma sorusu olarak ortaya koyar.
Bu nedenle çalışma “NISQ gürültüsünü başarıyla kullandı” sonucunu desteklemez.
Çalışmanın doğrudan desteklediği sonuçlar
- Dissipatif Ising-inspired QCA dynamics ile data classification arasında fiziksel bir bağlantı kurulabilir.
- Thermodynamic-limit modelde \(\mathbb Z_2\)-symmetry breaking, iki opposite order-parameter fixed point oluşturabilir.
- Finite-size QCA'da kalıcı symmetry breaking yerine transient ergodicity breaking ve iki quasi-fixed point ortaya çıkabilir.
- Çıkış katmanı transient non-ergodic window'a yerleştirildiğinde iki quasi-fixed point binary classes olarak kullanılabilir.
- Nearest-neighbor correlations mean-field ferromagnetic region'ı küçültür fakat kaynakta incelenen geçişin continuous character'ını değiştirmez.
- \(N=100\)'de transient bimodality, \(N=10\)'a göre daha belirgin hale gelir.
- Başlangıçta sınıflandırma yapmayan iki-parametreli QCA, dört training pair kullanılarak binary classification behavior öğrenecek biçimde eğitilebilir.
- Order-parameter based loss, incelenen \((a,b)\) parameter plane'de broad minimum içeren structured loss landscape üretir.
- Tensor-network bond dimensions artırıldığında temel transient dynamics ve training conclusions nitel olarak korunur.
Çalışmanın desteklemediği sonuçlar
- Kalıcı ergodicity breaking'in finite QCA'da gerçekleştiği gösterilmemiştir; tam tersine kaynak uzun zamanda ergodicity'nin geri geldiğini gösterir.
- Gerçek quantum processor üzerinde eğitim yapılmamıştır.
- Quantum computational advantage veya quantum speedup gösterilmemiştir.
- Gerçek dünya veri seti sınıflandırılmamıştır.
- Accuracy, precision, recall, F1 veya AUC benchmark'ı raporlanmamıştır.
- Dört training pair ile genel quantum machine learning problemlerinin çözülebileceği gösterilmemiştir.
- Bütün quantum machine-learning architectures için barren plateau'nun ortadan kaldırıldığı kanıtlanmamıştır.
- Multiclass classification bu çalışmada sayısal olarak gösterilmemiştir.
- NISQ noise'un yararlı olduğu deneysel olarak gösterilmemiştir.
- Tensor-network simulation'ın fiziksel quantum hardware execution ile aynı computational cost'a sahip olduğu varsayılamaz.
Çalışmanın güçlü yönleri
- Sınıflandırma mekanizması soyut bir black-box quantum circuit yerine açık many-body physics kavramlarına bağlanmıştır.
- Symmetry, phase transition, ergodicity breaking ve machine-learning trainability aynı fiziksel çerçevede ele alınmıştır.
- Mean-field sonuçları nearest-neighbor correlations ile kontrol edilmiştir.
- Finite-QCA dynamics doğrudan tensor-network simulation ile incelenmiştir.
- Initial-state sampling \(\mathbb Z_2\) symmetry kullanılarak \(m_0^x\) açısından dengeli tasarlanmıştır.
- Training ve transient dynamics sonuçları bond-dimension artışıyla robustness kontrolünden geçirilmiştir.
- Loss function sınıflandırmanın fiziksel order parameter'ıyla doğrudan ilişkilidir.
Çalışmanın yöntemsel sınırlılıkları
- Sonuçlar klasik tensor-network simulation'a dayanır.
- Hardware noise, gate error ve physical-device connectivity doğrudan test edilmemiştir.
- Eğitim demonstration'ı yalnız iki global jump-operator parameter'ı içerir.
- Training set yalnız dört synthetic input–target pair'den oluşur.
- Sınıflandırma binary'dir.
- Gerçek dünya dataset benchmark'ı yoktur.
- Standard ML performance metrics raporlanmamıştır.
- Large-scale physical quantum hardware demonstration yoktur.
- Spatially ve temporally inhomogeneous \(k,t\)-dependent Hamiltonian/jump operators eğitilmemiştir.
- Order-parameter loss'un bütün QML architectures'ta barren plateau'yu önlediğine dair genel theorem yoktur.
Gelecek çalışma yönleri
Kaynak üç önemli araştırma yönünü öne çıkarır.
Birincisi, transient nonergodicity ile spectral-gap closing ve metastability arasındaki ilişkinin daha ayrıntılı anlaşılmasıdır.
İkincisi, yerel Hamiltonian ve jump operators'ın \(k\) site indeksine ve \(t\) katmanına bağlı olabildiği daha geniş spatially/temporally inhomogeneous parameter spaces'in eğitilmesidir.
Üçüncüsü, bu daha karmaşık ve klasik bilgisayarda pahalı yapıların quantum hardware üzerinde incelenmesi ve NISQ noise'un dissipative QCA dynamics ile nasıl etkileştiğinin araştırılmasıdır.
Kaynak ve Yöntem Notu
Özgün başlık: Training the classification capability of large-scale quantum cellular automata.
Yazarlar: Mario Boneberg; Simon Kochsiek; Gabriele Perfetto; Igor Lesanovsky.
Yüklenen kaynak sürümü: arXiv:2509.18262v1 [quant-ph], 22 Eylül 2025.
Güncel hakemli yayın: Physical Review A, Volume 114, Issue 1, Article 012209.
Hakemli yayın tarihi: 16 Temmuz 2026.
DOI: 10.1103/gds1-9vhy.
Alınma tarihi: 3 Ekim 2025.
Revizyon tarihi: 18 Şubat 2026.
Kabul tarihi: 1 Haziran 2026.
Dergi: Physical Review A.
Yayınevi: American Physical Society.
Hakemlik durumu: Hakemli ve yayımlanmış araştırma makalesi. Yüklenen çalışma dosyası ise yayımdan önceki arXiv v1 metnini taşımaktadır.
Lisans / yeniden kullanım: APS resmî makale sayfası ©2026 American Physical Society ve all rights reserved bilgisini göstermektedir; resmî kayıt üzerinde Creative Commons açık lisansı belirtilmemektedir. Bu nedenle kaynak figürleri Verianla içinde birebir kopyalanmamış, yalnız bilimsel ilişkiler bağımsız source-derived şemalarla yeniden ifade edilmiştir.
Yüklenen v1 afiliyasyonları: Institut für Theoretische Physik, Universität Tübingen and Center for Integrated Quantum Science and Technology, Tübingen, Germany; School of Physics and Astronomy and Centre for the Mathematics and Theoretical Physics of Quantum Non-Equilibrium Systems, University of Nottingham, United Kingdom.
Yayımlanmış APS sürümündeki güncel afiliyasyonlar: Mario Boneberg ve Simon Kochsiek — Universität Tübingen; Gabriele Perfetto — Institut für Theoretische Physik, ETH Zürich; Igor Lesanovsky — Universität Tübingen ve University of Nottingham.
Afili yasyon sürüm notu: Yüklenen arXiv v1, Gabriele Perfetto'yu Tübingen afiliyasyonuyla gösterirken final APS kaydı ETH Zürich afiliyasyonunu göstermektedir. Bu fark preprint ile yayımlanmış sürüm arasında bibliyografik güncelleme olarak korunmuştur.
Corresponding author: Yüklenen v1 PDF'de ayrı corresponding-author işareti görünmemektedir.
Eş katkı: Yüklenen kaynakta equal-contribution / co-first-author beyanı görünmemektedir.
Çalışma türü: Teorik ve sayısal kuantum çok-cisim / quantum machine-learning çalışması.
Ana sistem: Dissipatif Ising modelinden esinlenen, weak-\(\mathbb Z_2\)-symmetric gate-based quantum cellular automaton.
Ana bilimsel mekanizma: Faz geçişi yakınında oluşan transient ergodicity breaking ve iki quasi-fixed order-parameter state'in binary classes olarak kullanılması.
Ana order parameter: Normalize edilmiş \(x\)-magnetization \(m^x\).
Ana teorik yöntemler: Lindblad open-system description, mean-field approximation ve nearest-neighbor correlation correction.
Ana sayısal yöntem: Matrix product states ve matrix product operators kullanan tensor-network QCA simulation.
Ana QCA dinamik parametreleri: \(\Omega=3\kappa\), \(V=15\kappa\), \(\kappa\delta t=0.1\).
Transient-dynamics sistem boyutları: \(N=10\) ve \(N=100\).
Training/loss-landscape sistem boyutu: \(N=20\).
Ana QCA training depth: \(L=10\).
Training pair sayısı: \(P=4\).
Untrained başlangıç parametreleri: \(a=-0.15,\;b=-1\).
Reference/teacher parametreleri: \(a=1/2,\;b=-1/2\).
Learning rate: \(\epsilon=80\).
Ana training figure update sayısı: 100.
Supplementary robustness-training update sayısı: 50.
Ana tensor-network bond dimensions: \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\).
Robustness kontrolleri: QCA dynamics için \(\chi_{\mathrm{MPS}}=96\) ve \(\chi_{\mathrm{MPO}}=32\); training stability için \(\chi_{\mathrm{MPS}}=64\) ve \(\chi_{\mathrm{MPO}}=32\) alternatifleri ayrı ayrı test edilmiştir.
Başlangıç durumları: 1.000 product state \(m_0^x\in[0,0.5]\) üzerinden örneklenmiş, bunların 1.000 \(\mathbb Z_2\) symmetry partner'ı oluşturularak toplam 2.000 başlangıç durumu elde edilmiştir.
Gerçek dünya veri seti: Yoktur. İncelenen girdiler kontrollü synthetic quantum product states'tir.
Gerçek quantum hardware: Kullanılmamıştır.
Quantum advantage testi: Yapılmamıştır.
Standard classification metrics: Accuracy, precision, recall, F1 ve AUC raporlanmamıştır; sınıflandırma output order parameter'ın bimodal yapısı üzerinden gösterilmiştir.
Statistical hypothesis testing: Çalışma klasik örneklem-istatistiği araştırması değildir; p-değeri veya confidence interval tabanlı karşılaştırma raporlanmamıştır.
Kod erişilebilirliği: Yüklenen kaynakta ayrı Code Availability bölümü veya reproducibility code bağlantısı görünmemektedir.
Veri erişilebilirliği: Yüklenen kaynakta ayrı Data Availability bölümü görünmemektedir.
Yazar katkıları: Yüklenen v1 kaynakta ayrı CRediT/Author Contributions bölümü görünmemektedir.
Çıkar çatışması: Yüklenen v1 kaynakta ayrı competing-interest / conflict-of-interest bölümü görünmemektedir; bu nedenle Verianla “çıkar çatışması yoktur” şeklinde kaynakta bulunmayan bir beyan üretmemektedir.
Teşekkür: Yazarlar F. Carollo'ya tartışmalar için teşekkür etmektedir.
Finansman: Kaynak; Deutsche Forschungsgemeinschaft Project No. 449905436, Research Unit FOR 5413/1 Grant No. 465199066, European Union Horizon Europe Grant Agreement No. 101046968 (BRISQ), EPSRC Grant No. EP/V031201/1, German Federal Ministry of Research, Technology and Space NeuQuant project grant 13N17065, Machine Learning Cluster of Excellence EXC 2064/1 Project No. 390727645, Baden-Württemberg bwHPC ve DFG INST 40/575-1 FUGG (JUSTUS 2 cluster) desteklerini belirtmektedir.
Kaynak-içi editoryal not 1: Supplementary Material başlangıcında nearest-neighbor equation derivation ana metin “Eq. (7)” ile ilişkilendirilmiştir; ancak yüklenen ana metinde Denklem (7), trainable \(J_k(a,b)\) jump operator tanımıdır. Ek materyaldeki S15 denklemlerinin bilimsel içeriği mean-field magnetization dynamics'in correlation-corrected genişlemesidir. Verianla bu referans numarası tutarsızlığını sessizce değiştirmemektedir.
Kaynak-içi editoryal not 2: Supplementary Material'da S7 çevresindeki bir açıklama cümlesi dissipasyonu \(V\) ile ilişkilendiren ifade içerirken gösterilen jump operator \(J_j=\sqrt{\kappa}\sigma_j^-\) ve bütün ilgili dissipative terms \(\kappa\)'yı decay parameter olarak kullanmaktadır. Verianla displayed equations'ı korumuş ve bu metinsel uyuşmazlıktan yeni fiziksel sonuç üretmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir