


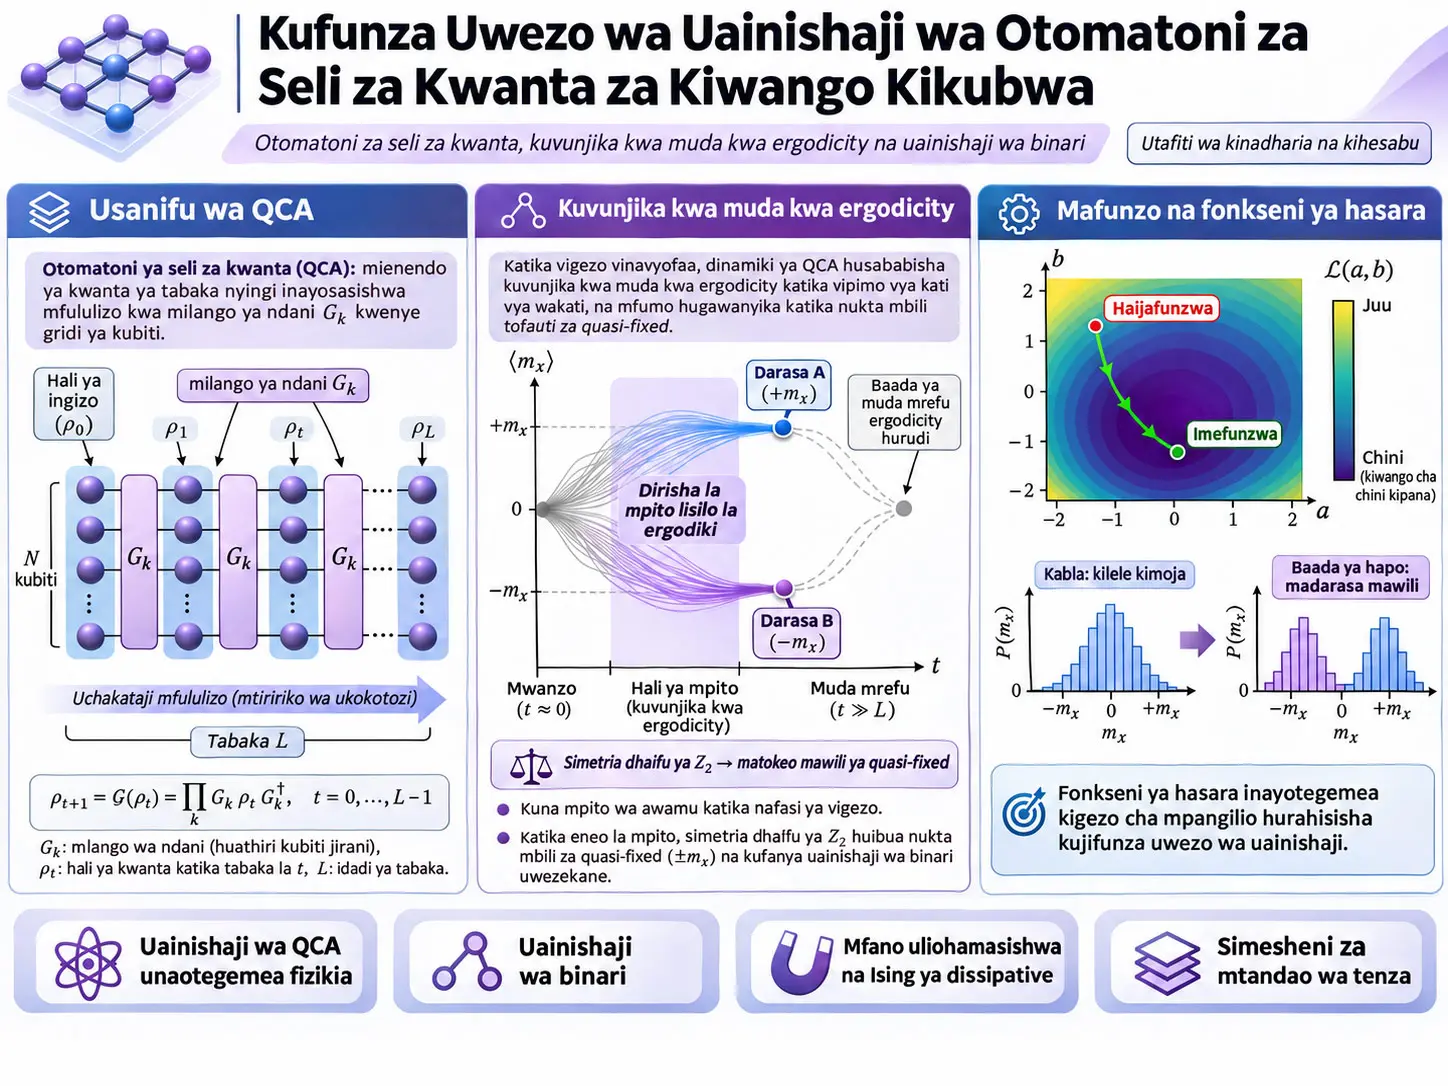
Otomatoni ya seli za kwanta (quantum cellular automaton, QCA), ni usanifu wa kompyuta ya kwanta ambamo seli za ndani zinazobeba taarifa za kwanta huchakatwa kutoka tabaka moja hadi jingine kwa milango ya kwanta inayorudiwa kulingana na kanuni maalumu ya ujirani. Utafiti huu ni kazi ya kinadharia na ya kihesabu inayoonyesha, kwa kutumia mpito wa awamu, ulinganifu dhaifu wa \(\mathbb{Z}_2\) na mifumo ya kuvunjika kwa ergodicity kwa muda katika fizikia dissipative ya mifumo mingi ya kwanta, kwamba uwezo wa QCA wa uainishaji wa aina mbili haujitokezi tu kupitia vigezo vya kimwili vilivyochaguliwa mapema kwa mkono, bali unaweza kujifunzwa kutoka data za mafunzo kwa optimization inayotegemea gradient.
Mfano umechochewa na dinamiki dissipative ya Ising yenye ulinganifu wa \(\mathbb{Z}_2\), inayojumuisha mwingiliano wa ndani na dissipation. Katika kikomo cha thermodynamic, mfano huu wa kimwili unaweza kuonyesha mpito endelevu wa awamu kati ya hali za paramagnetic na ferromagnetic. Katika hali ya ferromagnetic, stationary order parameter ya magnetization ya \(x\), \(m_\infty^x\), inaweza kuchukua mojawapo ya thamani mbili, chanya na hasi, zinazohusishwa kwa ulinganifu. Bonde la mvuto ambamo hali ya awali ipo huamua ni fixed point ipi mfumo utaelekea.
Hata hivyo, QCA inayotumiwa katika utafiti ina ukubwa wenye kikomo. Katika mfumo wenye kikomo, kuvunjika kwa ulinganifu kwa hiari kunakodumu na kuvunjika kabisa kwa ergodicity kunakoendelea milele hakutarajiwi. Badala yake, waandishi wanaonyesha kwamba katika tabaka za kati hutokea mkusanyiko karibu na quasi-fixed point mbili ndani ya transient non-ergodic window . Wakati tabaka la output la QCA linawekwa katika dirisha hili la muda, thamani mbili za \(m^x\) zinazotofautiana kwa kiwango cha macroscopic zinaweza kusomwa kama madarasa mawili. Kwa muda mrefu zaidi, hali zote za awali hukaribia stationary state moja na \(m^x\rightarrow0\); yaani ergodicity hurudi.
Order parameter kuu ya mpito wa awamu ni magnetization ya \(x\) iliyorekebishwa kwa idadi ya qubit zote katika tabaka. Hesabu za mean-field hutabiri eneo la awamu ya ferromagnetic. Katika mwelekeo mmoja, nearest-neighbor correlations zinapozingatiwa, eneo hili la ferromagnetic hupungua, lakini mpito unaochunguzwa katika chanzo unabaki endelevu na huhifadhi tabia ya kuvunjika kwa ulinganifu wa \(\mathbb{Z}_2\).
Katika simuleringi za moja kwa moja za QCA hutumika \(\Omega=3\kappa\), \(V=15\kappa\) na \(\kappa\delta t=0.1\). Thamani za awali za order parameter hufunika \(m_0^x\in[-0.5,0.5]\); katika mageuzi ya hali 2.000, muundo wa muda wa makundi mawili unaonekana kwa \(N=10\), na kwa \(N=100\) muundo huo huo wa bimodal huwa wazi zaidi huku peaks za histogram zikiwa kali zaidi. Utegemezi huu wa ukubwa unaunga mkono tabia ya emergent many-body ya quasi-fixed point.
Katika onyesho la mafunzo, Hamiltonian huwekwa thabiti na ni jump operator pekee:
vigezo viwili halisi \(a\) na \(b\) vilivyomo ndani yake vinafanyiwa optimization. Jozi nne za mafunzo za input–target hutengenezwa kutoka QCA ya marejeo yenye uwezo wa kufanya uainishaji. QCA inayoanza katika sehemu \(a=-0.15,\;b=-1\) ambayo haifanyi uainishaji, hufunzwa kwa kina \(L=10\), learning rate \(\epsilon=80\) na marudio 100 ya parameter-update katika onyesho kuu. Baada ya mafunzo, mgawanyo wa output-magnetization wenye kilele kimoja hugawanyika kuwa vilele viwili dhahiri; vilele hivi viwili ndivyo tabia ya uainishaji wa aina mbili.
Badala ya kupima fidelity ya hali yote ya output ya kwanta dhidi ya target state, loss function hupima hitilafu katika order parameter ya kimwili. Chanzo kinaonyesha kwamba kwa \(N=20\), loss landscape katika parameter plane ya \((a,b)\) ina minimum pana na iliyo wazi. Waandishi wanapendekeza kwamba muundo huu wa physics-informed loss unaweza kutoa faida dhidi ya matatizo ya trainability ya aina ya barren plateau yanayoweza kujitokeza katika state spaces kubwa. Hata hivyo, utafiti hauthibitishi kimahesabu kwamba barren plateau imeondolewa kwa QCA zote au neural networks za kwanta.
Usemi “large-scale” katika utafiti haumaanishi kwamba processor kubwa ya kwanta ya kimwili ilifunzwa kwa majaribio. Hesabu za namba zilifanywa katika mazingira ya kompyuta ya kawaida kwa tensor-network simulations zinazotumia matrix product states na matrix product operators. Kwa \(N=20\), state space inayojadiliwa katika chanzo hufikia kiwango cha \(4^N\times4^N\), takriban \(10^{24}\); tensor-network representation huwezesha muundo husika kuchakatwa katika umbo lililobanwa bila kuhitaji kuhifadhi nafasi hii kubwa kama full dense matrix.
Tatizo kuu la utafiti
Katika usanifu wa jumla wa quantum machine learning kuna matatizo mawili tofauti. La kwanza ni kuelewa ni sifa gani ya kimwili ya dinamiki ya kwanta inayoweza kutumika katika uchakataji wa data. La pili ni kama vigezo vinavyoibua sifa hiyo vinaweza kujifunzwa kwa kuaminika kutoka data za mafunzo.
Utafiti huu unaunganisha uainishaji moja kwa moja na dhana za mfumo wa many-body za mpito wa awamu, kuvunjika kwa ulinganifu, quasi-fixed point na order parameter . Hivyo, badala ya target-state fidelity ya kiwango cha juu yenye dimensionality kubwa, kiasi cha macroscopic kinachoweza kufasiriwa kimwili kinatumika kwa uainishaji.
Katika mitandao ya kawaida ya Hopfield, mabonde ya mvuto na fixed points yanaweza kufasiriwa kama kumbukumbu au ruwaza. Chanzo kinachunguza kama mantiki sawa ya kimwili inaweza kubadilishwa kuwa kazi ya uchakataji taarifa ya QCA ndani ya dissipative quantum many-body dynamics. Wazo kuu hapa ni kwamba hali tofauti za awali huongozwa kwa muda kwenye njia mbili tofauti za macroscopic dynamics.
Otomatoni ya Seli za Kwanta Hufanyaje Uainishaji Katika Utafiti Huu?
Otomatoni ya seli za kwanta katika utafiti huu huendeleza hali za awali za kwanta chini ya dinamiki dissipative inayofanana na Ising na, katika dirisha la muda lisilo ergodiki, huzielekeza kwenye mojawapo ya thamani mbili za quasi-fixed za magnetization ya \(x\) zinazohusishwa kwa ulinganifu wa \(\mathbb{Z}_2\); tabaka la output la QCA linapowekwa katika dirisha hili, makundi chanya na hasi ya order parameter husomwa kama madarasa mawili tofauti, lakini kwa muda mrefu mgawanyiko huu hutoweka na mfumo hurudi kukaribia stationary state moja.
Jiometri ya QCA na mantiki ya tabaka
Chanzo kinafafanua QCA kwenye lattice ya qubit ya pande mbili. Katika mwelekeo wa wima kuna site \(N\), na katika mwelekeo wa mlalo kuna tabaka \(L+1\).
Kila site ni qubit yenye hali mbili za msingi:
Safu wima ni tabaka la QCA katika time index fulani \(t\). Kwenye tabaka la kwanza huwekwa:
hali ya kwanta ya input. Tabaka zinazofuata mwanzoni huwa katika vacuum state.
Mwelekeo wa mlalo si lazima uwe coordinate ya nafasi ya kimwili; hufasiriwa kama mwelekeo wa computation/time unaorudiwa wa QCA. Hivyo:
tabaka zake hufanya kazi kama sampuli za muda uliogawanywa za mnyororo dissipative wa quantum spin.
Hali ya kwanta huhamishwaje kutoka tabaka moja hadi jingine?
Chanzo kinafafanua update ya hali ya QCA kwa Equation (1):
Fomula inahesabu nini? Hutengeneza reduced density matrix \(\rho_{t-1}\) ya tabaka jipya kutoka reduced density matrix \(\rho_t\) ya tabaka lililotangulia.
\(\rho_{t-1}\): ni hali ya kwanta katika tabaka la QCA lililotangulia.
\(|\mathbf 0\rangle\langle\mathbf 0|\): ni vacuum state ya awali ya qubit katika tabaka jipya.
\(\mathcal G\): ni global quantum gate inayotumika kwenye tabaka mbili jirani.
\(\mathcal G^\dagger\): ni Hermitian conjugate ya global gate.
\(\mathrm{Tr}_{t-1}\): huchukua partial trace juu ya degrees of freedom za tabaka la zamani. Kwa maneno mengine, tabaka la zamani halipo tena kama sehemu ya mfumo wa output.
Jambo hili ni muhimu ili kuelewa dinamiki dissipative. Wakati tabaka mbili kwa pamoja zinapitia gate evolution katika mfumo mkubwa zaidi wa kwanta, kutrace tabaka lililotangulia hufanya reduced dynamics ya tabaka jipya kwa ujumla kuwa nonunitary. Kwa hivyo QCA inayotegemea gates inaweza kukaribia Markovian open-quantum-system dynamics.
Global gate huundwaje?
Milango ya ndani:
hufanya kazi kuzunguka site ya \(k\) ya tabaka mbili jirani. Global two-layer gate, isipokuwa boundary terms, huundwa kwa:
umbo hilo.
Equation (2) ya chanzo:
Hapa chanzo kinatumia:
ufafanuzi huu.
Exponential term ya upande wa kulia:
huzalisha coherent evolution ya mfumo katika tabaka lililotangulia chini ya local Hamiltonian \(H_k\).
Exponential term ya katikati:
huunda mwingiliano kati ya tabaka la zamani na jipya unaohusiana na jump operators \(J_k\). Baada ya mwingiliano na tabaka jipya, kutrace tabaka la zamani huzalisha effective dissipative dynamics.
\(\mathrm{SWAP}_k\): hubadilishana hali za qubit husika za tabaka la zamani na jipya.
\(\delta t\): ni discrete time step. Chanzo kinatumia kwamba katika kikomo \(\delta t\ll1\), update ya tabaka hukaribia continuous Markovian dissipative dynamics.
Uhusiano kati ya QCA na dinamiki ya Lindblad
Kwa \(\delta t\) ndogo:
Hapa \(\mathcal L\) ni Lindblad generator:
\([\ ,\ ]\): ni commutator. Term ya kwanza inawakilisha coherent quantum dynamics inayotokana na Hamiltonian.
\(\{\ ,\ \}\): ni anticommutator.
\(J_k\bullet J_k^\dagger-\frac12\{J_k^\dagger J_k,\bullet\}\): ni jump-process contribution ya Lindblad dissipator.
\(\bullet\): ni placeholder ya density operator ambayo superoperator hufanyia kazi.
Kwa hivyo, utafiti hauishii kwenye lugha ya “tabaka za quantum circuit”; pia unafasiri QCA hiyo hiyo kwa mtazamo wa dissipative many-body quantum dynamics. Ufafanuzi wa kimwili wa mfumo wa uainishaji pia hujengwa kupitia uhusiano huu.
Local Hamiltonian inayofanana na Ising na dissipation
Kwa mfano maalumu wa classifier chanzo kinatumia:
.
\(\Omega\): ni transverse field strength.
\(V\): ni nearest-neighbor spin interaction strength.
\(\kappa\): ni local decay rate katika \(z\)-basis.
\(\sigma_k^-\): ni lowering operator.
Vigezo asilia visivyo na vipimo vya udhibiti katika phase diagram ni:
. Hivyo, badala ya absolute energy/frequency scale, ukubwa wa coherent drive na interaction hulinganishwa dhidi ya decay scale.
Kwa Nini Ulinganifu Dhaifu wa \(\mathbb{Z}_2\) ni Muhimu kwa Uainishaji?
Ulinganifu dhaifu wa \(\mathbb{Z}_2\) huwezesha Lindblad generator kubaki bila kubadilika chini ya global \(z\)-parity transformation na kuruhusu matawi ya dinamiki ya \(m^x\) na \(+m^x\) ya order parameter \(-m^x\) yanayohusishwa kwa ulinganifu; katika mfano wa thermodynamic matawi haya mawili huunda symmetry-broken fixed points, ilhali katika QCA yenye ukubwa wenye kikomo muundo huo huonekana kwa muda kama quasi-fixed point mbili, na output hizi mbili za macroscopic huunda msingi wa kimwili wa uainishaji wa aina mbili.
Ulinganifu dhaifu huandikwaje kimahesabu?
Chanzo kinafafanua global parity superoperator kama:
.
Sharti la weak symmetry ni:
.
Hii inaonyesha kwamba Lindblad evolution na parity transformation zinaendana. Dinamiki ya mshirika wa hali ya awali aliyebadilishwa kwa parity ni parity-transformed counterpart ya dinamiki ya asili.
Chini ya transformation ya \(\sigma^z\), magnetization ya \(x\) hubadilisha ishara. Kwa hiyo hali mbili ambazo ni symmetry partners za kila mmoja zinaweza kuoanishwa kama:
.
Ergodicity ni nini?
Katika muktadha wa utafiti huu, ergodicity inahusishwa na tabia ya muda mrefu kupoteza taarifa kuhusu hali ya awali na hali tofauti za awali kuelekea kwenye stationary behavior ile ile.
Ergodicity inapovunjika, initial conditions tofauti zinaweza kuwa katika attraction basins tofauti na kuelekea kwenye miundo tofauti ya muda mrefu au metastable/quasi-stationary.
Tofauti hii ni ya asili kwa uainishaji:
- inputs zinazoelekea kwenye basin moja zinaweza kupewa darasa moja,
- inputs zinazoelekea kwenye basin nyingine zinaweza kupewa darasa jingine
.
Tofauti kati ya fixed point na quasi-fixed point
Fixed pointni stationary state ambayo dinamiki inaweza kweli kubaki bila kubadilika.
Quasi-fixed pointni muundo wa dinamiki unaofanana na metastable ambao dinamiki inaweza kukaa karibu nao kwa muda mrefu katika kipindi chenye kikomo, lakini si lazima udumu milele.
Dhana ya pili ni muhimu kwa uainishaji wa QCA katika makala hii. Madarasa mawili ya QCA yenye ukubwa wenye kikomo si stationary states mbili za kudumu; ni quasi-fixed point mbili ndani ya transient windowtir.
Order parameter hufafanuwaje?
Chanzo kinafafanua magnetization components kama:
.
\(N\): ni idadi ya qubit katika tabaka moja.
\(\sigma_k^\mu\): ni Pauli operator kwenye site ya \(k\).
\(\rho_t\): ni density matrix ya tabaka la \(t\).
\(m_t^\mu\): ni collective magnetization iliyorekebishwa na kuenea katika tabaka lote.
Kwa sababu ya normalization ya chanzo, katika pure product-state sampling kikomo asilia cha thamani za \(m^\mu\) zinazolingana na vipengele vya Bloch vya qubit moja ni:
.
Mean-field approximation ni nini?
Mean-field approximation hukadiria many-body density matrix kama product ya translation-invariant single-site states:
Katika approximation hii, connected quantum correlations kati ya sites hazihifadhiwi kama independent variables tofauti. Kila site huhisi athari ya wastani ya nyingine.
Mean-field equations za chanzo katika mwelekeo mmoja ni:
Equation (6a) inaeleza nini?
Katika usemi huo, \(-\Omega m^y\) inawakilisha coherent rotation coupling inayotokana na transverse field; \(-\kappa m^x/2\) inawakilisha athari ya kuzimisha ya dissipative decay juu ya \(x\)-magnetization.
Equation (6b) inaeleza nini?
Usemi huu unaunganisha field-induced rotation na many-body interaction contribution. Kwa sababu ya nonlinear term \(2Vm^xm^z\), collective dynamics haijumuishi tu rotations huru za qubit moja.
Equation (6c) inaeleza nini?
Katika usemi huu, interaction term huathiri kipengele cha \(x\) kupitia magnetization components za \(y\) na \(z\). Dissipative term huendesha mfumo kuelekea \(m^z=-1/2\) chini ya normalization ya chanzo.
Order parameter inayotenganisha awamu
Stationary \(x\)-magnetization:
hutumiwa kutenganisha awamu.
| Hali | Stationary \(m_\infty^x\) | Ulinganifu | Tafsiri ya dinamiki |
|---|---|---|---|
| Paramagnetic (PM) | \(0\) | \(\mathbb{Z}_2\) haijavunjika | Suluhisho moja la stationary |
| Ferromagnetic (FM) | \(\neq0\) | \(\mathbb{Z}_2\) imevunjika | \(+m_\infty^x\) au \(-m_\infty^x\); matawi mawili yanayotegemea hali ya awali |
Kwa nini nearest-neighbor correlations zinachunguzwa pia?
Kwa kuwa QCA inalingana na dinamiki ya mnyororo wa spin wa mwelekeo mmoja, fluctuations na spatial correlations zinaweza kubadilisha utabiri wa mean-field approximation. Kwa hiyo waandishi huunda suluhisho la makadirio lililoendelezwa zaidi linalohifadhi wazi two-body correlations kwenye nearest-neighbor bond moja.
Kulingana na matokeo ya chanzo, nearest-neighbor correlations:
- hupunguza eneo la awamu ya ferromagnetic katika parameter space,
- lakini hazibadilishi tabia endelevu ya mpito wa awamu wa PM–FM unaochunguzwa,
- na haziondoi mfumo wa \(\mathbb{Z}_2\) symmetry-breaking.
Density matrix msingi ya mbinu ya nearest-neighbor
Supplementary Material hufafanua single-site na two-site reduced density matrices kama:
.
Connected correlation kwenye nearest-neighbor bond moja ni:
.
Hali ya mean-field:
kwa hiyo katika pure mean-field limit:
Muundo msingi wa correlated trial state ni:
Katika mbinu hii, two-site correlation kwenye nearest-neighbor bond iliyochaguliwa huhifadhiwa wazi, huku athari ya sites nyingine zinazozunguka ikihifadhiwa katika kiwango cha mean-field.
Coordination number \(q\) ina maana gani?
Supplementary Material huandika mfano kwenye hypercubic lattice ya jumla ya dimensionality \(d\):
\(q\) ni idadi ya nearest neighbors ya site moja. Jumla ya bonds ni:
. Kwa hali ya mwelekeo mmoja inayozingatiwa kwa QCA:
Kwa hiyo, correction ya single-bond correlation ni muhimu kiasi cha kutoweza kupuuzwa katika dimensionality ndogo.
Sehemu za single-site na two-site Hamiltonian
Supplementary Material hutumia:
na:
kama mgawanyo.
Kwa kuwa exact dynamics ya two-body reduced density matrix kwa ujumla inaunganishwa na three-body density matrix, hierarchy inayofanana na BBGKY hutokea. Hierarchy hii haijifungi yenyewe. Chanzo hutumia:
approximation hiyo ili kufunga mfumo kwa kuweka bond iliyochaguliwa ya \(a,b\) exact huku mazingira yakishughulikiwa kama factorized mean-field.
Upanuzi wa two-site density matrix katika Pauli basis
Reduced density matrix ya qubit mbili huandikwa juu ya Pauli basis kama:
.
Two-point correlation functions ni:
Single-site magnetization components chini ya translation invariance ni:
Kwa parametrization hii, hupatikana independent dynamic variables 12 kwa jumla: three one-point na nine two-point quantities.
Equations 12 za motion zenye nearest-neighbor correlations
Katika Supplementary Material ya chanzo, seti ifuatayo ya equations hutumiwa kuzalisha correlation-corrected version ya phase diagram:
Katika equations hizi kuna michango miwili tofauti ya kimwili. Terms kwenye bond iliyochaguliwa zina explicit two-point correlations kama \(Vm^{z,x}\), \(Vm^{y,x}\); athari ya neighbors wengine \(q-1\) huja kupitia mean-field terms za umbo \(V(q-1)m^\alpha m^\beta\).
Matokeo muhimu ya dimensionality katika chanzo ni haya: katika mwelekeo mmoja, kwa kuwa \(q=2\), single-bond correlation inayohifadhiwa exact na mean-field contribution kutoka mazingira zina order ile ile. Katika dimensionality kubwa ambapo \(q\gg1\), contribution ya bond moja hupungua kwa uwiano na mean-field approximation huwa ya asili zaidi.
Mean-field limit kwa coordination number kubwa
Kwa \(q\gg1\):
factorization inapotumiwa, mfumo hupungua kuwa:
equations hizo.
Kwa kuweka \(q=2\) kwa mwelekeo mmoja, Equations (6a)–(6c) za main text zinapatikana tena.
Mbinu na Matokeo ya Utafiti
Uchanganuzi wa phase diagram
Waandishi kwanza hutatua stationary phase diagram ya dissipative Ising-inspired model kwa mean-field. Mhimili wa mlalo ni:
dimensionless field strength, na mhimili wa wima ni:
dimensionless interaction strength.
Mean-field phase map inaonyesha maeneo mawili makuu:
- eneo la paramagnetic lenye \(m_\infty^x=0\),
- eneo la ferromagnetic symmetry-broken lenye \(|m_\infty^x|>0\).
Nearest-neighbor correlations zinapojumuishwa, eneo la FM hupungua. Chanzo kinaripoti kwamba kwenye section ya mstari \(V=3\kappa\), suluhisho la mean-field na correlation-corrected solution yote yanaonyesha mpito wa PM–FM kuwa endelevu.
Kwa kuwa raw grid values za grafu ya chanzo hazikutolewa, Verianla haisomi critical value fulani ya \(\Omega/\kappa\) kutoka kwenye picha na kuizalisha kama namba kamili.
Transient ergodicity breaking katika finite-size QCA
Masharti makuu yaliyotumiwa katika direct QCA simulation:
| Parameter | Thamani ya chanzo | Maana |
|---|---|---|
| \(\Omega\) | \(3\kappa\) | Transverse field |
| \(V\) | \(15\kappa\) | Nearest-neighbor interaction |
| \(\kappa\delta t\) | 0.1 | Discrete time step isiyo na dimension |
| Initial states | 2.000 | Hali za awali zinazofunika range \(m_0^x\in[-0.5,0.5]\) |
| Ukubwa wa mfumo | \(N=10\) na \(N=100\) | Idadi ya qubit kwa kila layer |
| \(\chi_{\mathrm{MPS}}\) | 48 | Matrix-product-state bond dimension |
| \(\chi_{\mathrm{MPO}}\) | 16 | Matrix-product-operator bond dimension |
| Tabaka la histogram | \(t=8\) | Tabaka ambako transient bimodality inachunguzwa |
| Histogram bin size | 0.005 | Bin width ya histogram ya chanzo |
Ulinganisho wa \(N=10\) na \(N=100\)
Kwa \(N=10\), magnetization trajectories 2.000 huanza kujikusanya karibu na quasi-fixed values mbili katika tabaka za kati, na histogram ya \(t=8\) huonyesha muundo wa bimodal.
Kwa \(N=100\), histogram peaks za makundi mawili huwa juu zaidi na kali zaidi. Chanzo hutafsiri hili kama emergent behavior ya quasi-fixed points inayokuwa wazi zaidi kadiri system size inavyoongezeka.
Lakini peaks hizi mbili hazibaki fixed milele. Kwa kina kikubwa zaidi cha QCA, trajectories hukaribia stationary state moja ya \(m^x=0\).
Jinsi hali za awali zilivyozalishwa
Katika Supplementary Material, kwanza hutengenezwa \(n=1000\) translation-invariant product states:
Single-qubit pure state ni:
Bloch-sphere angles hufafanuliwa kupitia magnetization components:
na:
chini ya sharti:
Kwa nini arctan2 inatumika?
\(\arctan(y/x)\) ya kawaida haiwezi kutofautisha kwa kuaminika quadrant ilipo kwa kutumia peke yake taarifa ya ishara ya \(x\) na \(y\). \(\operatorname{arctan2}(y,x)\) hutumia ishara za \(x\) na \(y\) pamoja ili kuchagua angle sahihi \(\phi\in(-\pi,\pi]\).
State 1.000 za kwanza zinasambazwaje uniformly?
Chanzo kwanza:
hufanya uniform sampling katika range hiyo.
Kisha:
vipengele vingine viwili huamuliwa kwa hayo.
Sampling hii haijafafanuliwa kama Haar-uniform sampling juu ya Bloch sphere. Lengo la chanzo ni kufunika mhimili wa order parameter \(m_0^x\) bila kuunda bias.
Hali nyingine 1.000 za awali zinapatikanaje?
Hali 1.000 za pili hazisampuliwi upya kwa kujitegemea; partners za hali 1.000 za kwanza chini ya \(\mathbb Z_2\) huundwa:
Matokeo yake:
.
Kwa QCA map \(\Lambda\), weak symmetry ni:
kwa hiyo katika tabaka zote:
ulinganifu huu huhifadhiwa.
Kwa nini sampling method hii ni muhimu?
Kama hali za awali zingesampuliwa bila uwiano kwa \(m_0^x\), muundo wa urefu au density ya peaks mbili katika output histogram ungeweza kuathiriwa na sampling bias. Kwa hiyo chanzo hufunika mhimili wa \(m_0^x\) kwa ulinganifu na kutengeneza hali 2.000.
Jump operator inayoweza kufunzwa
Katika mfano wa kimwili wenye uwezo wa classification, jump operator ni:
. Lengo la mafunzo ni kuchunguza kama QCA inaweza kujifunza dissipative coupling inayofaa bila kuijua moja kwa moja.
Kwa hili hutumiwa trainable real parameters mbili:
\(a\): ni coefficient halisi ya contribution ya \(\sigma^x\).
\(b\): ni coefficient halisi ya contribution ya \(i\sigma^y\).
Parametrization hii pia inajumuisha Ising jump operator ya chanzo kwa thamani zinazofaa za \(a,b\).
Wakati wa mafunzo, Hamiltonians \(H_k\) hazifanyiwi update. Yaani utafiti hau optimize kwa uhuru gate structure yote ya QCA; hufunza tu global parameters mbili za jump operator.
Data za mafunzo zinaandaliwaje?
Chanzo kinafafanua data za mafunzo kama:
jozi za input state–target magnetization.
Katika onyesho kuu la mafunzo:
Target pairs hizi nne hupatikana kutoka evolution ya QCA ya marejeo yenye uwezo wa uainishaji.
QCA ya marejeo:
hutumia thamani hizo na uchaguzi huu hutekeleza jump operator ya aina ya \(\sigma^-\).
Jambo hili lisichanganywe na trajectories 2.000: model hufunzwa kwa training pairs nne; hali 2.000 za awali hutumiwa kuonyesha muundo wa dynamic classification kabla na baada ya mafunzo.
Kwa Nini Loss Function Inayotegemea Order Parameter ni Muhimu?
Loss function inayotegemea order parameter ya utafiti hai linganishi hali yote ya output ya kwanta yenye dimensionality kubwa na target state; badala yake huadhibu tu mkengeuko wa macroscopic \(x\)-magnetization inayobeba uainishaji kimwili kutoka kwenye target value. Katika chanzo, uchaguzi huu huzalisha structured loss landscape yenye minima pana na wazi katika parameter plane ya \((a,b)\) na kusaidia gradient-descent training kubaki inayoweza kutekelezwa katika state space kubwa.
Muundo kamili wa loss function
Equation (8) ya chanzo:
Fomula inahesabu nini? Kwa kila training sample, huhesabu tofauti kati ya QCA output order parameter na target output magnetization, huiweka mraba na kuchukua wastani juu ya samples zote \(P\).
\(\rho_{\mathrm{out}}^{(\nu)}\): ni QCA output density matrix ya input state ya \(\nu\).
\(m_{x,\mathrm{out}}^{(\nu)}\): ni target output magnetization inayotakiwa kwa sample ya \(\nu\).
\(\frac1{2N}\sum_k\sigma_k^x\): ni physical classification observable.
Loss hii hailazimishi quantum state amplitudes zote zilingane moja moja na target state. Ina optimize macroscopic output quantity moja muhimu kwa uainishaji.
Uhusiano na barren plateau
Barren plateau ni tatizo ambapo katika baadhi ya parametric quantum circuits, gradients za cost function huwa ndogo sana kadiri system size inavyoongezeka na optimization landscape huwa karibu tambarare katika maeneo makubwa.
Katika chanzo, landscape ya order-parameter loss katika plane ya \((a,b)\) inaonyesha minimum iliyo structured na pana. Waandishi wanajadili kwamba hili linahusiana na physics-informed architecture na physical order-parameter loss.
Hata hivyo, hitimisho linapaswa kuwekwa ndani ya mipaka hii:
- utafiti unaonyesha kwa namba kwamba QCA iliyochunguzwa inaweza kufunzwa,
- unaonyesha kwamba loss landscape ina broad minima,
- unaweka ulinganisho wa kidhana na matatizo ya barren plateau yanayojulikana kwa fidelity-type losses,
- lakini hau thibitishi kimahesabu kwamba barren plateau haitatokea katika QCA zote au system sizes zote.
Gradient update
Parameters za jump operator:
hufanyiwa update kwa namna hiyo.
Hapa:
\(\widetilde a,\widetilde b\) huamua steepest-descent direction inayopunguza loss kwa kasi zaidi; \(\epsilon\) ni learning rate.
Masharti makuu ya mafunzo
| Kipengele | Thamani |
|---|---|
| QCA depth | \(L=10\) |
| System size ya loss landscape | \(N=20\) |
| Training pair | \(P=4\) |
| Reference/teacher jump parameters | \(a=1/2,\;b=-1/2\) |
| Mwanzo wa untrained | \(a=-0.15,\;b=-1\) |
| Hamiltonian | \(\Omega=3\kappa,\;V=15\kappa\), thabiti wakati wa mafunzo |
| Learning rate | \(\epsilon=80\) |
| Update repetitions katika Kielelezo 4 kikuu | 100 |
| \(\chi_{\mathrm{MPS}}\) | 48 |
| \(\chi_{\mathrm{MPO}}\) | 16 |
| Initial states zinazoonyesha output distribution | 2.000 |
| Histogram bin size | 0.005 |
Nini hutokea kabla ya mafunzo?
Untrained QCA inayoanzishwa na parameters \(a=-0.15,\;b=-1\) haitengenezi quasi-fixed output classes mbili. Histogram ya \(L=10\) katika output layer ya \(m_{10}^x\) hukusanyika karibu na peak moja katika chanzo.
Nini hutokea baada ya mafunzo?
Baada ya parameter updates 100, output trajectories hukusanyika karibu na magnetization mbili tofauti. Kielelezo 4 cha chanzo huonyesha hizi kama class A na class B, na output histogram ina peaks mbili wazi.
Hili ndilo onyesho la moja kwa moja ndani ya chanzo kwamba QCA imejifunza binary classification capability ambayo haikuwepo mwanzoni kutoka training data.
Kwa nini uainishaji unaweza kujifunzwa kwa parameters mbili tu?
Jaribio hili hali optimize mamilioni ya free parameters katika neural network ya jumla ya kwanta. Model ya kimwili tayari ina architecture na symmetry structure inayoweza kuwezesha mfumo wa uainishaji. Mafunzo hujaribu tu kupata coupling parameters mbili zinazohamisha dissipative jump operator ya mfumo kwenye physical regime inayofaa.
Kwa hiyo, utafiti hauungi mkono hitimisho kwamba “kila arbitrary quantum model inaweza kufunzwa kwa mifano minne”. Training pairs nne zilitosha kwa demonstration hii maalumu yenye parameters mbili na muundo wa kimwili uliowekwa mapema.
Kwa nini state space ni kubwa sana?
Hilbert-space dimension ya pure state ya qubit \(N\) hukua exponentially. Density-operator/superoperator description huhitaji objects kubwa zaidi. Chanzo kinatoa kiwango hiki kwa state spaces zilizochunguzwa:
.
Kwa \(N=20\):
na kwa hiyo related two-index scale ni:
kwa order hiyo.
Namba hii imepanuliwa kihesabu ili kueleza maana ya usemi wa chanzo “\(\sim10^{24}\)”; si matokeo mapya ya simulation.
Kwa nini tensor network ni muhimu?
Wakati full density matrices na superoperators zinahifadhiwa moja kwa moja, gharama za memory na computation hukua exponentially. Matrix product state na matrix product operator representations huwakilisha muundo katika hali na operators fulani za kwanta kama tensors zilizobanwa, na kuruhusu simulation bila kuhifadhi explicit coefficients zote za full space.
Control parameter kuu ya mbinu hii ni bond dimension \(\chi\). Kwa ujumla, \(\chi\) ya juu zaidi inalingana na:
- kuhifadhi correlation/entanglement structure zaidi,
- truncation error ndogo zaidi,
- lakini computational cost kubwa zaidi
.
Ukaguzi wa robustness wa bond dimension
| Uchanganuzi | Mpangilio wa marejeo | Mpangilio wa ukaguzi | Matokeo ya chanzo |
|---|---|---|---|
| QCA dynamics | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=96,\;\chi_{\mathrm{MPO}}=16\) | Hakuna qualitative change inayoonekana; peaks za histogram za \(N=100\) huwa juu kidogo tu. |
| QCA dynamics | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=32\) | Chanzo hakiripoti qualitative change inayoonekana. |
| Training stability | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=64,\;\chi_{\mathrm{MPO}}=16\) | Initial/trained dynamics, loss landscape na gradient path zinaendana kimaelezo na matokeo makuu. |
| Training stability | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\) | \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=32\) | Matokeo yanabaki kimaelezo sawa na main training simulation. |
Katika Supplementary training-stability check hutumiwa 50 update repetitions, \(\epsilon=80\) na \(N=20\). Namba hii haipaswi kuchanganywa na 4 update repetitions katika Kielelezo 100 kikuu.
Chanzo pia kinasema kwamba kwa \(\chi_{\mathrm{MPO}}=16\), square root ya jumla ya squares za discarded singular values iko katika order ya machine precision, na kinachukulia MPO bond dimension hii kuwa ya kutosha.
Je, transient bimodality ni artefact ya bond dimension ndogo?
Supplementary robustness tests za chanzo zinachunguza hasa uwezekano huu. Muundo wa quasi-fixed point mbili na bimodal output distribution unapobaki kimaelezo baada ya bond dimensions kuongezwa, hii inaunga mkono kwamba transient ergodicity breaking iliyoonekana si artefact rahisi iliyozalishwa tu na uchaguzi wa truncation wa \(\chi_{\mathrm{MPS}}=48\) au \(\chi_{\mathrm{MPO}}=16\).
Je, Utafiti Huu Unaonyesha Quantum Advantage au Mafanikio ya Uainishaji wa Data Halisi?
Hapana; utafiti unaonyesha trainability ya QCA inayosimuliwa kwenye kompyuta ya kawaida kwa tensor-network methods na inayotenganisha synthetic quantum initial states katika madarasa mawili kupitia physical \(x\)-magnetization. Hata hivyo, haupimi quantum speedup au quantum advantage kwenye quantum hardware halisi, wala hauripoti classification performance ya aina ya accuracy, F1 au AUC kwenye picha, maandishi, data ya biomedical au benchmark nyingine ya ulimwengu halisi.
Usemi “efficiently learned” unapaswa kusomwaje?
Dai la chanzo la “efficiently learned” linategemea kwamba katika physics-informed QCA iliyochunguzwa, order-parameter loss landscape ina broad minima na usable gradient structure licha ya state space yenye dimensionality kubwa.
Usemi huu haumaanishi:
- polynomial-time proof kwa mtazamo wa classical computational complexity,
- wall-clock speedup kwenye quantum processor,
- accuracy bora dhidi ya classical classifier,
- scalable fault-tolerant hardware demonstration
.
Je, multiclass classification imeonyeshwa katika makala hii?
Hapana. Direct numerical demonstration ya makala iko kwenye \(\mathbb Z_2\)-symmetry na quasi-fixed point mbili, kwa hiyo inalenga binary classification .
Waandishi wanajadili kama mwelekeo wa baadaye/wa jumla kwamba multiclass classification inaweza kutekelezwa kwa namna sawa kwa kutumia many-body systems zenye ulinganifu wa juu zaidi. Hili si matokeo ya multiclass benchmark yaliyoonyeshwa katika makala.
Je, NISQ hardware ilitumika?
Hapana. Chanzo kinaweka kama swali la utafiti wa baadaye kama noise kwenye NISQ devices inaweza kupunguzwa au, kwa kuwa QCA dynamics tayari ni effective dissipative, kama noise inaweza kutumiwa kwa manufaa katika baadhi ya hali.
Kwa hiyo utafiti hauungi mkono hitimisho kwamba “NISQ noise ilitumika kwa mafanikio”.
Matokeo yanayoungwa mkono moja kwa moja na utafiti
- Uhusiano wa kimwili unaweza kuanzishwa kati ya dissipative Ising-inspired QCA dynamics na data classification.
- Katika thermodynamic-limit model, \(\mathbb Z_2\)-symmetry breaking inaweza kuunda opposite order-parameter fixed points mbili.
- Katika finite-size QCA, badala ya permanent symmetry breaking, transient ergodicity breaking na quasi-fixed point mbili zinaweza kutokea.
- Output layer inapowekwa kwenye transient non-ergodic window, quasi-fixed point mbili zinaweza kutumiwa kama binary classes.
- Nearest-neighbor correlations hupunguza mean-field ferromagnetic region lakini hazibadilishi continuous character ya mpito unaochunguzwa katika chanzo.
- Kwa \(N=100\), transient bimodality huwa wazi zaidi kuliko kwa \(N=10\).
- QCA yenye parameters mbili ambayo mwanzoni haifanyi uainishaji inaweza kufunzwa kwa training pairs nne ili kujifunza binary classification behavior.
- Order-parameter based loss huzalisha structured loss landscape yenye broad minimum katika parameter plane ya \((a,b)\) iliyochunguzwa.
- Bond dimensions za tensor network zinapoongezwa, transient dynamics kuu na training conclusions hubaki kimaelezo.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kwamba permanent ergodicity breaking hutokea katika finite QCA; kinyume chake, chanzo kinaonyesha kwamba ergodicity hurudi kwa muda mrefu.
- Mafunzo hayakufanywa kwenye quantum processor halisi.
- Quantum computational advantage au quantum speedup haijaonyeshwa.
- Dataset ya ulimwengu halisi haijaainishwa.
- Benchmark ya accuracy, precision, recall, F1 au AUC haijaripotiwa.
- Haijaonyeshwa kwamba matatizo ya jumla ya quantum machine learning yanaweza kutatuliwa kwa training pairs nne.
- Haijathibitishwa kwamba barren plateau imeondolewa kwa quantum machine-learning architectures zote.
- Multiclass classification haijaonyeshwa kwa namba katika utafiti huu.
- Haijaonyeshwa kwa majaribio kwamba NISQ noise ni yenye manufaa.
- Haiwezi kudhaniwa kwamba tensor-network simulation ina computational cost sawa na physical quantum hardware execution.
Nguvu za utafiti
- Mfumo wa uainishaji umeunganishwa na dhana wazi za many-body physics badala ya black-box quantum circuit ya kufikirika.
- Symmetry, phase transition, ergodicity breaking na machine-learning trainability zimejadiliwa katika mfumo mmoja wa kimwili.
- Matokeo ya mean-field yamekaguliwa kwa nearest-neighbor correlations.
- Finite-QCA dynamics zimechunguzwa moja kwa moja kwa tensor-network simulation.
- Initial-state sampling imeundwa kwa uwiano katika \(\mathbb Z_2\) kwa kutumia \(m_0^x\) symmetry.
- Matokeo ya training na transient dynamics yamepitishwa kwenye robustness check kwa kuongeza bond dimension.
- Loss function inahusishwa moja kwa moja na physical order parameter ya uainishaji.
Mapungufu ya kimetodolojia ya utafiti
- Matokeo yanategemea classical tensor-network simulation.
- Hardware noise, gate error na physical-device connectivity hazijajaribiwa moja kwa moja.
- Training demonstration inajumuisha global jump-operator parameters mbili tu.
- Training set ina synthetic input–target pairs nne tu.
- Uainishaji ni binary.
- Hakuna benchmark ya real-world dataset.
- Standard ML performance metrics hazijaripotiwa.
- Hakuna large-scale physical quantum hardware demonstration.
- Spatially na temporally inhomogeneous \(k,t\)-dependent Hamiltonian/jump operators hazijafunzwa.
- Hakuna general theorem kwamba order-parameter loss huzuia barren plateau katika QML architectures zote.
Mielekeo ya utafiti wa baadaye
Chanzo kinaangazia mielekeo mitatu muhimu ya utafiti.
Kwanza, kuelewa kwa undani zaidi uhusiano kati ya transient nonergodicity na spectral-gap closing na metastability .
Pili, kufunza parameter spaces pana zaidi za spatially/temporally inhomogeneous ambapo local Hamiltonian na jump operators zinaweza kutegemea site index \(k\) na layer \(t\).
Tatu, kuchunguza miundo hii changamano zaidi na yenye gharama kubwa kwa classical computer kwenye quantum hardware na kutafiti jinsi NISQ noise inavyoingiliana na dissipative QCA dynamics.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Training the classification capability of large-scale quantum cellular automata.
Waandishi: Mario Boneberg; Simon Kochsiek; Gabriele Perfetto; Igor Lesanovsky.
Toleo la chanzo lililopakiwa: arXiv:2509.18262v1 [quant-ph], 22 Septemba 2025.
Chapisho la sasa lililopitiwa na rika: Physical Review A, Volume 114, Issue 1, Article 012209.
Tarehe ya chapisho lililopitiwa na rika: 16 Julai 2026.
DOI: 10.1103/gds1-9vhy.
Tarehe ya kupokelewa: 3 Oktoba 2025.
Tarehe ya marekebisho: 18 Februari 2026.
Tarehe ya kukubaliwa: 1 Juni 2026.
Jarida: Physical Review A.
Mchapishaji: American Physical Society.
Hali ya mapitio ya rika: Makala ya utafiti iliyopitiwa na rika na kuchapishwa. Faili ya utafiti iliyopakiwa ina maandishi ya arXiv v1 ya kabla ya uchapishaji.
Leseni / matumizi tena: Ukurasa rasmi wa makala wa APS unaonyesha ©2026 American Physical Society na taarifa ya all rights reserved; hakuna Creative Commons open license iliyoonyeshwa kwenye rekodi rasmi. Kwa hiyo source figures hazijanakiliwa pixel kwa pixel ndani ya Verianla; mahusiano ya kisayansi pekee yameelezwa upya kwa independent source-derived schematics.
Affiliations katika v1 iliyopakiwa: Institut für Theoretische Physik, Universität Tübingen and Center for Integrated Quantum Science and Technology, Tübingen, Germany; School of Physics and Astronomy and Centre for the Mathematics and Theoretical Physics of Quantum Non-Equilibrium Systems, University of Nottingham, United Kingdom.
Affiliations za sasa katika APS version iliyochapishwa: Mario Boneberg na Simon Kochsiek — Universität Tübingen; Gabriele Perfetto — Institut für Theoretische Physik, ETH Zürich; Igor Lesanovsky — Universität Tübingen na University of Nottingham.
Dokezo la toleo la affiliation: arXiv v1 iliyopakiwa inaonyesha Gabriele Perfetto akiwa na affiliation ya Tübingen, ilhali final APS record inaonyesha affiliation ya ETH Zürich. Tofauti hii imehifadhiwa kama bibliographic update kati ya preprint na published version.
Corresponding author: Katika v1 PDF iliyopakiwa hakuna separate corresponding-author mark inayoonekana.
Equal contribution: Katika chanzo kilichopakiwa hakuna equal-contribution / co-first-author statement inayoonekana.
Aina ya utafiti: Utafiti wa kinadharia na kihesabu wa quantum many-body / quantum machine learning.
Mfumo mkuu: Gate-based quantum cellular automaton yenye weak-\(\mathbb Z_2\)-symmetry, iliyochochewa na dissipative Ising model.
Mekanizimu kuu ya kisayansi: Transient ergodicity breaking inayotokea karibu na phase transition na matumizi ya quasi-fixed order-parameter states mbili kama binary classes.
Order parameter kuu: Normalized \(x\)-magnetization \(m^x\).
Mbinu kuu za kinadharia: Lindblad open-system description, mean-field approximation na nearest-neighbor correlation correction.
Mbinu kuu ya kihesabu: Tensor-network QCA simulation inayotumia matrix product states na matrix product operators.
Vigezo kuu vya dinamiki ya QCA: \(\Omega=3\kappa\), \(V=15\kappa\), \(\kappa\delta t=0.1\).
System sizes za transient dynamics: \(N=10\) na \(N=100\).
System size ya training/loss landscape: \(N=20\).
QCA training depth kuu: \(L=10\).
Idadi ya training pairs: \(P=4\).
Untrained initial parameters: \(a=-0.15,\;b=-1\).
Reference/teacher parameters: \(a=1/2,\;b=-1/2\).
Learning rate: \(\epsilon=80\).
Idadi ya updates katika main training figure: 100.
Idadi ya updates katika supplementary robustness training: 50.
Tensor-network bond dimensions kuu: \(\chi_{\mathrm{MPS}}=48,\;\chi_{\mathrm{MPO}}=16\).
Robustness checks: Kwa QCA dynamics, mbadala za \(\chi_{\mathrm{MPS}}=96\) na \(\chi_{\mathrm{MPO}}=32\); kwa training stability, mbadala za \(\chi_{\mathrm{MPS}}=64\) na \(\chi_{\mathrm{MPO}}=32\) zilijaribiwa kila moja kando.
Hali za awali: Product states 1.000 zilisampuliwa juu ya \(m_0^x\in[0,0.5]\), na partners 1.000 za hali hizo chini ya \(\mathbb Z_2\) symmetry zikatengenezwa, na hivyo kupata jumla ya hali 2.000 za awali.
Dataset ya ulimwengu halisi: Hakuna. Inputs zilizochunguzwa ni controlled synthetic quantum product states.
Quantum hardware halisi: Haikutumika.
Quantum advantage test: Haikufanywa.
Standard classification metrics: Accuracy, precision, recall, F1 na AUC hazijaripotiwa; uainishaji umeonyeshwa kupitia muundo wa bimodal wa output order parameter.
Statistical hypothesis testing: Utafiti si classical sample-statistics study; haujaripoti comparison inayotegemea p-value au confidence interval.
Upatikanaji wa code: Katika chanzo kilichopakiwa, separate Code Availability section au reproducibility code link haionekani.
Upatikanaji wa data: Katika chanzo kilichopakiwa, separate Data Availability section haionekani.
Michango ya waandishi: Katika chanzo cha v1 kilichopakiwa, separate CRediT/Author Contributions section haionekani.
Mgongano wa maslahi: Katika chanzo cha v1 kilichopakiwa, separate competing-interest / conflict-of-interest section haionekani; kwa hiyo Verianla haitengenezi statement ambayo haipo katika chanzo kwamba “hakuna mgongano wa maslahi”.
Shukrani: Waandishi wanamshukuru F. Carollo kwa majadiliano.
Ufadhili: Chanzo kinataja msaada kutoka Deutsche Forschungsgemeinschaft Project No. 449905436, Research Unit FOR 5413/1 Grant No. 465199066, European Union Horizon Europe Grant Agreement No. 101046968 (BRISQ), EPSRC Grant No. EP/V031201/1, German Federal Ministry of Research, Technology and Space NeuQuant project grant 13N17065, Machine Learning Cluster of Excellence EXC 2064/1 Project No. 390727645, Baden-Württemberg bwHPC na DFG INST 40/575-1 FUGG (JUSTUS 2 cluster).
Dokezo la uhariri ndani ya chanzo 1: Mwanzoni mwa Supplementary Material, nearest-neighbor equation derivation imehusishwa na “Eq. (7)” ya main text; hata hivyo, katika main text iliyopakiwa, Equation (7) ni ufafanuzi wa trainable \(J_k(a,b)\) jump operator. Maudhui ya kisayansi ya S15 equations katika supplementary material ni correlation-corrected extension ya mean-field magnetization dynamics. Verianla haibadilishi kimya kimya inconsistency hii ya reference number.
Dokezo la uhariri ndani ya chanzo 2: Katika Supplementary Material, sentensi ya maelezo karibu na S7 ina usemi unaohusisha dissipation na \(V\), ilhali jump operator iliyoonyeshwa \(J_j=\sqrt{\kappa}\sigma_j^-\) na dissipative terms zote husika hutumia \(\kappa\) kama decay parameter. Verianla imehifadhi displayed equations na haijatoa matokeo mapya ya kimwili kutoka textual inconsistency hii.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *