

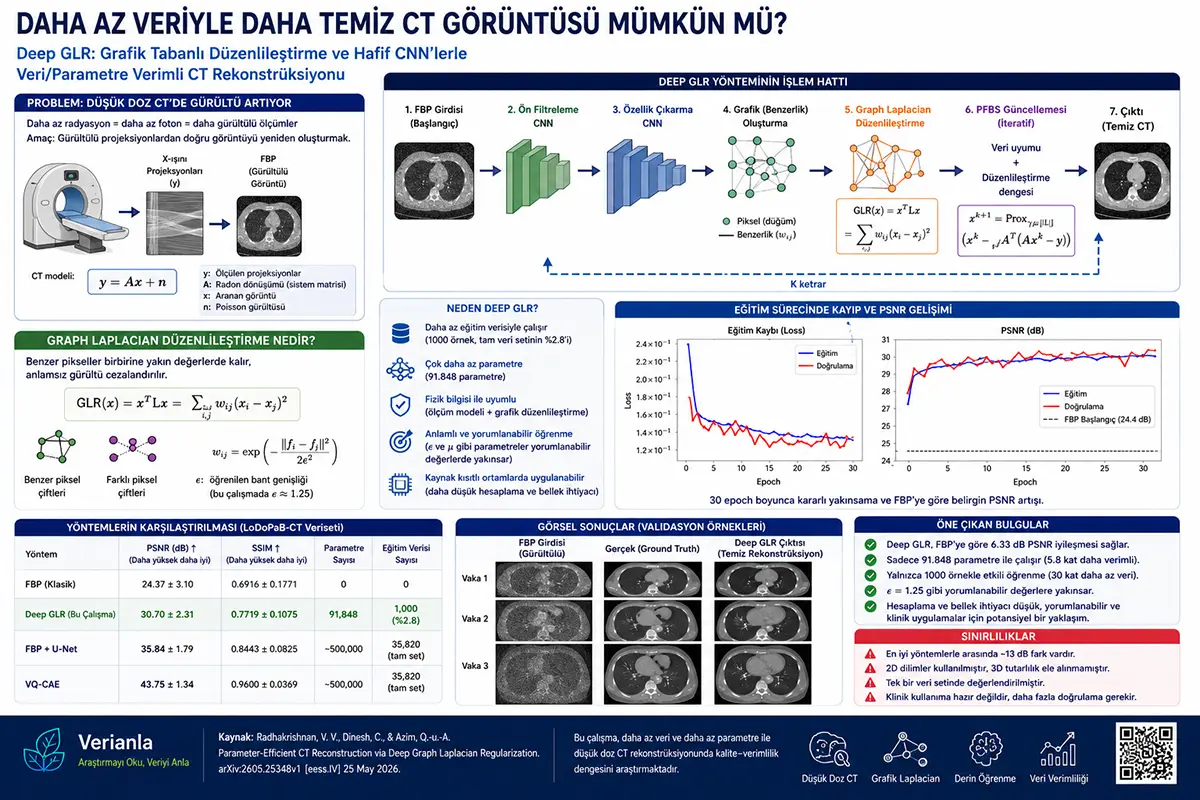
Problem Ne? Düşük Doz CT’de Görüntü Gürültüsü Artar
Bilgisayarlı tomografi, yani CT, vücudun iç yapısını kesitsel görüntülerle incelemek için kullanılan önemli bir tıbbi görüntüleme yöntemidir. Ancak CT taramaları iyonlaştırıcı radyasyon içerir. Bu nedenle araştırmacılar, görüntü kalitesini korurken radyasyon dozunu azaltmanın yollarını arar.
Düşük doz CT, hastanın aldığı radyasyonu azaltmayı hedefler. Fakat doz azaldıkça ölçüm verisi daha gürültülü hale gelir. Bu da görüntüde çizgilenme, bulanıklık veya yapay bozulmalar oluşturabilir.
Bu noktada temel soru şudur:
Daha düşük dozla alınan gürültülü ölçümlerden, yeterince temiz ve anlamlı CT görüntüsü yeniden oluşturulabilir mi?
Bu çalışma, bu soruya özellikle kaynak kısıtı açısından yaklaşıyor. Yani yalnızca “en yüksek kalite mümkün mü?” diye sormuyor. Aynı zamanda “daha az veri, daha az parametre ve daha yorumlanabilir bir modelle makul kalite elde edilebilir mi?” sorusunu inceliyor.
CT Yeniden Oluşturma Ne Demek?
CT cihazı doğrudan vücudun iç görüntüsünü çekmez. Cihaz, farklı açılardan geçen X-ışınlarının zayıflamasını ölçer. Bu ölçümlerden sonra bilgisayar, iç yapının görüntüsünü hesaplar.
Makalede bu temel problem şu formülle gösteriliyor:
y = Ax + n
Bu formül sade biçimde şöyle okunabilir:
y, cihazın ölçtüğü projeksiyon verisidir.
x, elde etmek istediğimiz gerçek CT görüntüsüdür.
A, CT taramasının fiziksel ölçüm sürecini temsil eder.
n, ölçüme karışan gürültüdür.
Yani elimizde doğrudan temiz görüntü yoktur. Gürültülü ölçümden, gerçek görüntüye en yakın sonucu bulmaya çalışırız.
Bu yüzden CT yeniden oluşturma bir “ters problem”dir. Sonuçtan yola çıkarak nedeni bulmaya çalışırız. Düşük dozda bu iş daha da zorlaşır çünkü ölçümdeki gürültü daha belirgindir.
Klasik Yöntem: FBP Neden Yetmeyebilir?
Filtered Backprojection, kısaca FBP, CT görüntüsü oluşturmak için kullanılan klasik ve hızlı bir yöntemdir. Hesaplama açısından pratiktir ve uzun yıllardır temel yaklaşımlardan biridir.
Ancak düşük doz CT’de FBP’nin önemli bir zayıflığı vardır: Ölçümdeki gürültü görüntüye güçlü biçimde yansıyabilir. Bu da özellikle düşük foton sayısına bağlı durumlarda çizgilenme ve gürültü bozulmaları oluşturabilir.
Bu çalışmada FBP, karşılaştırma için temel başlangıç noktası olarak kullanılıyor. Deep GLR yöntemi de ilk görüntüyü FBP ile başlatıyor, ardından bu görüntüyü adım adım iyileştirmeye çalışıyor.
Deep GLR Ne Öneriyor?
Deep GLR, klasik optimizasyon ile derin öğrenmeyi birleştiren hibrit bir yaklaşım öneriyor.
Buradaki fikir şudur:
Tamamen büyük ve karmaşık bir yapay zekâ modeline güvenmek yerine, CT’nin fiziksel yapısını ve görüntülerin komşuluk ilişkilerini açıkça modele dahil etmek.
Deep GLR üç temel parçadan oluşuyor:
1. Hafif CNN ağları
Görüntüyü ön işlemden geçirmek, piksellerin özelliklerini çıkarmak ve düzenlileştirme ağırlığını öğrenmek için küçük CNN modülleri kullanılıyor.
2. Graph Laplacian Regularization
Görüntüde benzer piksellerin birbirine yakın değerlerde kalmasını sağlayan grafik tabanlı bir düzenlileştirme kullanılıyor.
3. PFBS optimizasyon çerçevesi
Proximal Forward-Backward Splitting adı verilen iteratif optimizasyon yaklaşımıyla görüntü adım adım güncelleniyor.
Bu yapı, “sadece öğrenen” bir model yerine, öğrenen ama matematiksel düzenlileştirme ile sınırlandırılmış bir model kuruyor.
Grafik Tabanlı Düzenlileştirme Ne Demek?
Makalede görüntü, bir grafik gibi düşünülüyor. Burada her piksel bir düğüm olarak kabul ediliyor. Yakın pikseller arasında bağlantılar kuruluyor.
Eğer iki piksel birbirine benzer özelliklere sahipse, aralarındaki bağlantı daha güçlü oluyor. Eğer farklı özelliklere sahipse bağlantı zayıflıyor.
Bu bağlantı ağı, görüntünün nerede düz kalması ve nerede sınırları koruması gerektiğine dair bir ipucu veriyor.
Bir CT görüntüsünde akciğer, yumuşak doku, kemik ve organ sınırları farklı yapılar gösterir. Grafik tabanlı yaklaşım, komşu pikseller arasındaki benzerliği dikkate alarak gürültüyü azaltmaya çalışır.
Graph Laplacian Formülü Ne Anlatıyor?
Makalede kullanılan temel düzenlileştirme ifadesi şöyledir:
GLR(x) = xᵀLx = Σ wij(xi − xj)²
Bu formül ilk bakışta teknik görünür; fakat anlamı oldukça öğreticidir.
xi ve xj, iki komşu pikselin değeridir.
wij, bu iki piksel arasındaki benzerlik ağırlığıdır.
L, grafik Laplasyen matrisidir.
Toplam ifade, benzer piksellerin çok farklı değerlere sahip olmasını cezalandırır.
Sade anlatımla:
Eğer iki piksel birbirine benziyorsa, model onların değerlerinin çok kopuk olmasını istemez.
Bu gürültü azaltma açısından faydalıdır. Çünkü gürültü çoğu zaman komşu pikseller arasında ani ve anlamsız dalgalanmalar üretir.
Ancak burada bir denge vardır. Çok fazla düzleştirme yapılırsa ince anatomik detaylar kaybolabilir. Bu nedenle yöntemin başarısı, gürültüyü azaltırken önemli sınırları koruyabilmesine bağlıdır.
Piksel Benzerliği Nasıl Hesaplanıyor?
Makalede komşu pikseller arasındaki ağırlık şu formülle hesaplanıyor:
wij = exp(− ||fi − fj||² / 2ε²)
Bu formülün sade anlamı şudur:
İki pikselin öğrenilmiş özellikleri birbirine benziyorsa, aralarındaki bağlantı güçlü olur.
Özellikler çok farklıysa, bağlantı zayıflar.
Burada fi ve fj, iki pikselin CNN tarafından öğrenilen özellikleridir. ε ise benzerlik ölçüsünün ne kadar hassas olacağını belirleyen bant genişliği parametresidir.
Çalışmada bu ε parametresinin eğitim sonunda 1,25 civarında kararlı hale geldiği raporlanıyor. Bu değer, modelin tamamen rastgele ezberleme yapmak yerine görüntüde anlamlı bir benzerlik ölçeği öğrenmiş olabileceğine işaret ediyor. Yine de bu yorum, çalışmanın kendi deney koşulları içinde değerlendirilmelidir.
PFBS Güncellemesi Ne İşe Yarıyor?
Deep GLR, görüntüyü tek seferde üretmiyor. Başlangıçta FBP ile elde edilen görüntüden başlıyor ve bunu birçok küçük adımla iyileştiriyor.
Makalede bu süreç iki ana kuvvetin dengesi gibi düşünülebilir:
Veriye sadakat:
Üretilen görüntü, CT ölçüm verisiyle uyumlu olmalı.
Düzenlileştirme:
Görüntü gereksiz gürültüden arınmalı ve komşu pikseller arasında anlamlı bir yapı korunmalı.
Formülde bu, yaklaşık olarak şu optimizasyon problemiyle ifade ediliyor:
min 1/2 ||Ax − y||² + μ(xᵀLx)
Bunu sadeleştirelim:
İlk terim, görüntünün ölçüm verisine ne kadar uyduğunu ölçer.
İkinci terim, görüntünün grafik tabanlı düzgünlüğünü kontrol eder.
μ, bu iki hedef arasında denge kurar.
Eğer μ çok küçükse, gürültü daha fazla kalabilir. Eğer μ çok büyükse, görüntü fazla düzleşebilir. Bu yüzden μ’nün öğrenilmesi önemlidir.
Ağ Mimarisi Nasıl Kurulmuş?
Deep GLR sistemi üç hafif CNN modülü kullanıyor.
Pre-filtering Network:
FBP ile gelen ilk gürültülü görüntü üzerinde ön temizleme yapıyor.
Feature Extraction Network:
Her piksel için üç boyutlu özellik vektörü çıkarıyor. Bu özellikler, piksel benzerlik grafiğini kurmak için kullanılıyor.
Parameter Learning Network:
Her görüntü için düzenlileştirme ağırlığı olan μ değerini öğreniyor.
Bunlara ek olarak son aşamada küçük bir post-processing ağı kullanılıyor. Ama bütün sistem büyük bir derin öğrenme modeli olmaya çalışmıyor. Asıl gücü, küçük öğrenen modülleri matematiksel optimizasyonla birleştirmesinden geliyor.
Toplam parametre sayısı 91.848 olarak raporlanıyor. Bu, makalede karşılaştırılan bazı derin öğrenme yaklaşımlarına göre oldukça düşük bir model boyutu anlamına geliyor.
Deneyler Nasıl Yapılmış?
Araştırmacılar yöntemi LoDoPaB-CT adlı düşük doz CT benchmark veri seti üzerinde test ediyor.
Öne çıkan deney ayrıntıları şunlar:
- Görüntü çözünürlüğü: 362 × 362 piksel
- Projeksiyon geometrisi: 1000 açı ve 513 dedektör bölmesi
- Gürültü modeli: Poisson istatistiği
- Eğitim örneği: 1000 görüntü
- Doğrulama örneği: 100 görüntü
- Eğitim süresi: 30 epoch
- Toplam parametre: 91.848
1000 eğitim örneği, tam eğitim setinin yalnızca yüzde 2,8’ine karşılık geliyor. Bu, çalışmanın asıl hedefi olan veri verimliliği açısından önemli bir noktadır.
Tablo 1 Ne Gösteriyor?
Makaledeki Tablo 1, Deep GLR’nin FBP ve bazı benchmark yöntemlerle karşılaştırmasını veriyor.
Sonuçlar şöyle özetlenebilir:
FBP:
PSNR: 24,37 dB
SSIM: 0,6916
Deep GLR:
PSNR: 30,70 dB
SSIM: 0,7719
Parametre: 91.848
Eğitim verisi: 1000 örnek
FBP + U-Net:
PSNR: 35,84 dB
SSIM: 0,8443
Parametre: yaklaşık 500.000
Eğitim verisi: 35.820 örnek
VQ-CAE:
PSNR: 43,75 dB
SSIM: 0,96
Parametre: yaklaşık 500.000
Eğitim verisi: tam veri seti
Bu tablo bize iki şeyi aynı anda söylüyor.
Birincisi, Deep GLR klasik FBP’ye göre belirgin bir iyileşme sağlıyor. PSNR değeri 6,33 dB artıyor.
İkincisi, Deep GLR en iyi yöntem değil. Özellikle VQ-CAE ile arasında yaklaşık 13 dB’lik ciddi bir fark var. Yani yöntem maksimum kalite iddiasında değil; daha çok düşük veri ve düşük parametre koşullarında makul iyileşme sunan verimli bir yaklaşım olarak okunmalıdır.
Şekil 1 Ne Anlatıyor?
Makaledeki Şekil 1, Deep GLR işlem hattını gösteriyor. Görselde FBP ile başlayan CT görüntüsü, CNN tabanlı ön filtreleme ve özellik çıkarımı aşamalarından geçiyor. Ardından pikseller arasında grafik kuruluyor, Graph Laplacian düzenlileştirme hesaplanıyor ve PFBS iterasyonlarıyla görüntü güncelleniyor.
Bu görselin ana mesajı şudur:
Deep GLR, CT görüntüsünü yalnızca bir CNN filtresinden geçirmiyor. Görüntüyü fiziksel ölçüm modeli, piksel benzerliği ve iteratif optimizasyonla birlikte ele alıyor.
Bu nedenle yöntem, klasik optimizasyon ile modern derin öğrenme arasında bir köprü gibi düşünülebilir.
Şekil 2 Ne Gösteriyor?
Şekil 2, eğitim sürecindeki loss ve PSNR değişimini gösteriyor. Eğriler, 30 epoch boyunca modelin kararlı biçimde öğrendiğini ve doğrulama PSNR değerinin yaklaşık 30 dB seviyesinin üstüne çıktığını gösteriyor.
Grafikte FBP başlangıç seviyesinin yaklaşık 24,4 dB civarında olduğu görülüyor. Deep GLR eğitimi ilerledikçe bunun belirgin biçimde üzerine çıkıyor.
Bu görselin sade mesajı şudur:
Model, sınırlı veriyle bile FBP’ye göre daha temiz görüntü oluşturmayı öğreniyor. Ancak eğriler klinik başarı değil, benchmark üzerindeki sayısal iyileşmeyi gösterir.
Şekil 3 Ne Anlatıyor?
Şekil 3, üç farklı hasta örneği için FBP, ground truth ve Deep GLR sonuçlarını yan yana gösteriyor.
FBP görüntülerinde daha fazla gürültü ve bozulma görülürken, Deep GLR sonuçları daha temiz ve daha düzgün görünmektedir. Anatomik yapıların genel hatları korunuyor gibi görünse de bazı ince detaylarda fazla düzleştirme riski vardır.
Bu görselin ana mesajı:
Deep GLR, gürültüyü azaltmada başarılı bir eğilim gösteriyor; fakat görüntünün tanısal olarak yeterli olup olmadığı yalnızca bu görsellerle belirlenemez. Bunun için radyolog değerlendirmesi, farklı klinik görevler ve gerçek cihaz verileriyle ek test gerekir.
Araştırma Ne Söylüyor?
Çalışmanın ana mesajı şudur:
Düşük doz CT yeniden oluşturma için her zaman çok büyük model ve çok büyük veri seti gerekmeyebilir. Grafik tabanlı düzenlileştirme, klasik optimizasyon ve küçük CNN modülleri birlikte kullanıldığında, sınırlı kaynakla anlamlı kalite artışı sağlanabilir.
Deep GLR, FBP’ye göre görüntü kalitesini artırıyor. Ancak en gelişmiş derin öğrenme yöntemlerinin seviyesine ulaşmıyor. Bu da çalışmanın dürüst ve önemli tarafıdır: yöntem kaliteyi artırıyor ama “en iyi kalite” yerine “verimli kalite” hedefliyor.
Bu Neden Önemli?
Tıbbi görüntüleme alanında veri toplamak her zaman kolay değildir. Hasta gizliliği, nadir hastalıklar, cihaz farkları ve kurumlar arası veri paylaşımı gibi nedenlerle büyük veri setleri her zaman erişilebilir olmayabilir.
Ayrıca her klinik veya araştırma merkezi büyük modelleri eğitecek donanıma sahip olmayabilir. Bu nedenle daha küçük, daha yorumlanabilir ve daha az veri isteyen yöntemler özellikle kaynak kısıtlı ortamlar için önemlidir.
Deep GLR gibi çalışmalar, tıbbi yapay zekâda yalnızca “en yüksek skor” aramanın yeterli olmadığını hatırlatıyor. Bazen daha küçük ama daha anlaşılır ve daha uygulanabilir modeller de değerlidir.
Dikkat Edilmesi Gereken Noktalar
Bu çalışma sağlık alanıyla ilişkili olduğu için dikkatli okunmalıdır.
İlk olarak, çalışma preprinttir. Hakem değerlendirmesinden geçtiği varsayılmamalıdır.
İkinci olarak, deneyler tek bir benchmark veri seti üzerinde yapılmıştır. Farklı anatomik bölgeler, farklı scanner türleri, farklı protokoller ve gerçek klinik koşullarda sonuçlar değişebilir.
Üçüncü olarak, yöntem 2D dilimler üzerinde çalışmaktadır. Klinik CT taramaları çoğu zaman 3D hacim olarak değerlendirilir. Dilimler arası ilişkiyi kullanmamak bazı bilgilerin kaçmasına neden olabilir.
Dördüncü olarak, Deep GLR daha az parametre ve daha az veriyle çalışsa da en gelişmiş yöntemlerle arasında belirgin kalite farkı vardır.
Beşinci olarak, PSNR ve SSIM gibi sayısal metrikler faydalıdır; ancak klinik tanı yeterliliği için tek başına yeterli değildir. Radyolog değerlendirmesi ve görev bazlı ölçümler gerekir.
Son olarak, bu içerik tıbbi tavsiye değildir. CT dozu, görüntüleme yöntemi veya tanı kararı ancak sağlık profesyonelleri tarafından verilmelidir.
Sonuç
Bu araştırma, düşük doz CT yeniden oluşturma için daha küçük ve daha veri verimli bir yapay zekâ yaklaşımının mümkün olabileceğini gösteriyor.
Deep GLR; grafik tabanlı düzenlileştirme, klasik PFBS optimizasyonu ve hafif CNN modüllerini birleştirerek FBP’ye göre belirgin kalite artışı sağlamıştır. Yöntem, yalnızca 91.848 parametre ve 1000 eğitim örneğiyle 30,70 dB PSNR değerine ulaşmıştır.
Ancak sonuçlar en gelişmiş yöntemlerin gerisindedir ve klinik kullanıma hazır olduğu anlamına gelmez. Çalışmanın asıl değeri, kaynak kısıtlı tıbbi görüntüleme senaryoları için kalite-verimlilik dengesini araştırmasındadır.
Bu makalenin en önemli mesajı şudur:
Tıbbi yapay zekâda daha büyük model her zaman tek yol değildir; doğru matematiksel yapı ve verimli öğrenme, sınırlı kaynaklarda da anlamlı iyileşme sağlayabilir.
Kaynak ve Yöntem Notu
Bu içerik, Veera Varuni Radhakrishnan, Chinthaka Dinesh ve Qurat-ul-Ain Azim tarafından hazırlanan “Parameter-Efficient CT Reconstruction via Deep Graph Laplacian Regularization” başlıklı akademik çalışmadan yararlanılarak Verianla editoryal formatında özgün olarak hazırlanmıştır.
Çalışma arXiv üzerinde yayımlanmış preprint niteliğindedir. İçerik bilgilendirme ve eğitim amacı taşır. Tıbbi tanı, tedavi, görüntüleme protokolü, radyasyon dozu kararı veya klinik uygulama tavsiyesi yerine geçmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir