

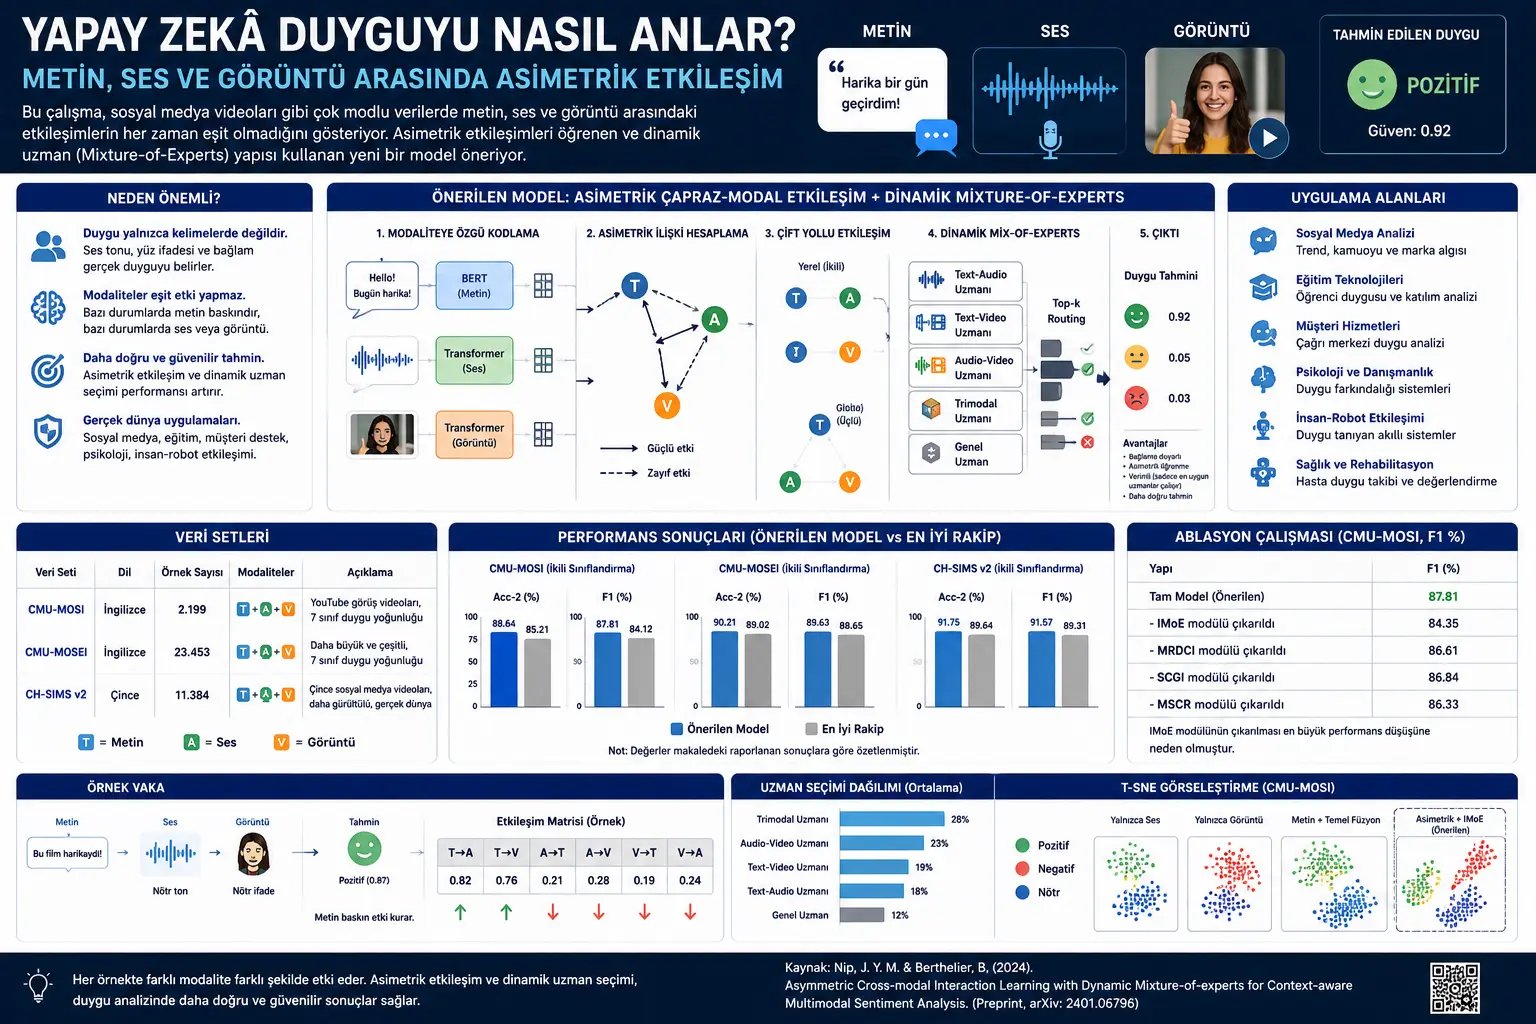
İnsan duyğusu çox vaxt yalnız sözlərdə üzə çıxmır. Bir insanın dediyi cümlə səs tonu və üz ifadəsi ilə birlikdə məna qazanır. Eyni cümlə düz səs tonu ilə deyildikdə neytral; istehzalı tonla deyildikdə mənfi; həyəcanlı üz ifadəsi ilə deyildikdə isə müsbət qəbul edilə bilər. Buna görə süni intellekt sistemləri duyğu analizində yalnız mətni deyil, səs və görüntü ipuclarını da nəzərə almalıdır.
Bu tədqiqat çoxmodallı duyğu analizində mühüm bir fərziyyəni sorğulayır: Mətn, səs və görüntü arasındakı qarşılıqlı təsirlər həqiqətən simmetrikdirmi? Yəni mətn səsə nə qədər təsir edirsə, səs də mətnə eyni dərəcədə təsir edirmi? Tədqiqatın cavabı xeyrdir. Modallıqlar arasında istiqamətli və qeyri-bərabər təsirlər ola bilər. Bəzi nümunələrdə mətn üstün məna mənbəyidir; bəzi hallarda isə səs və ya görüntü mətndəki qeyri-müəyyənliyi düzəldə, gücləndirə və ya əksinə çevirə bilər.
Məqalə buna görə asimmetrik çarpaz-modal qarşılıqlı təsir öyrənmə modeli təklif edir. Model hansı modallığın digərinə nə qədər təsir etdiyini ayrı-ayrılıqda hesablayır; sonra fərqli qarşılıqlı təsir növlərini emal etmək üçün dinamik Mixture-of-Experts quruluşundan istifadə edir. Mixture-of-Experts Azərbaycan dilində “ekspertlər qarışığı” kimi ifadə oluna bilər: Model hər nümunədə bütün ekspertləri işlətmək əvəzinə, həmin nümunəyə ən uyğun bir neçə ekspert alt şəbəkəsini seçərək daha çevik və səmərəli təmsil yaradır.
Problem Nədir?
Çoxmodallı duyğu analizi mətn, səs və görüntü kimi fərqli verilən növlərini birləşdirərək emosional vəziyyəti proqnozlaşdırmağa çalışır. Bu sahə sosial media, onlayn video şərhi, təhsil texnologiyaları, insan-kompüter qarşılıqlı əlaqəsi və duyğu-fərqində olan süni intellekt sistemləri üçün vacibdir. Lakin fərqli modallıqları birləşdirmək texniki baxımdan çətindir.
Birinci çətinlik modallıqların eyni növ məlumat daşımamasıdır. Mətn adətən məna sıxlığı yüksək olan mənbədir; insanın nə dediyini birbaşa ehtiva edir. Səs vurğu, sürət, ton hündürlüyü və emosional ton kimi ipucları daşıyır. Görüntü isə üz ifadəsi, jest, mimika və bədən duruşu vasitəsilə əlavə siqnallar verir. Bu üç kanal bir-birini tamamlaya bilər; lakin hər nümunədə eyni gücdə işləmirlər.
İkinci çətinlik əvvəlki bir çox metodun modallıqlar arasındakı qarşılıqlı təsiri simmetrik və ya bərabər qəbul etməsidir. Halbuki real danışıqlarda bu həmişə doğru deyil. Mətn səsin necə şərh olunacağını güclü şəkildə müəyyən edə bilər; lakin səsin mətnə təsir gücü eyni dərəcədə olmaya bilər. Eyni şəkildə, görüntü bəzi nümunələrdə çox həlledici olduğu halda, bəzi nümunələrdə demək olar ki, heç bir duyğu siqnalı daşımaya bilər.
Üçüncü çətinlik kontekstdən asılı olaraq dəyişən qarşılıqlı təsirdir. Yumor, ironiya, istehza, qeyri-müəyyən mətn, zəif duyğu ifadəsi və ya səs-küylü video kimi hallarda model hansı modallığa daha çox etibar edəcəyini dinamik şəkildə tənzimləməlidir. Sabit çəkilər və ya sadə birləşdirmə üsulları bu çevikliyi həmişə təmin edə bilmir.
Tədqiqatın əsas sualı bu nöqtədə ortaya çıxır: Süni intellekt mətn, səs və görüntü arasındakı istiqamətli və nümunədən asılı qarşılıqlı təsirləri necə daha yaxşı öyrənə bilər?
Metod Nə Təklif Edir?
Tədqiqat kontekst-fərqində olan çoxmodallı duyğu analizi üçün asimmetrik çarpaz-modal qarşılıqlı təsir öyrənmə modeli təklif edir. Modelin əsas ideyası hər modallığın digər modallıqlara təsirini ayrı istiqamətlərdə hesablamaq və bu qarşılıqlı təsirləri dinamik ekspert şəbəkələri ilə emal etməkdir.
Birinci komponent modallığa xas kodlaşdırma moduludur. Mətn üçün BERT istifadə olunur. BERT cümlədəki sözləri kontekst daxilində təmsil edən güclü dil modelidir. Səs və görüntü üçün isə mövqe məlumatı əlavə edilmiş Transformer encoder quruluşlarından istifadə olunur. Beləliklə, hər modallıq əvvəlcə öz daxilində mənalı bir təmsilə çevrilir.
İkinci komponent Modality Relation-aware Dual-path Cross-modal Interaction, yəni modallıq münasibətindən xəbərdar iki yollu çarpaz-modal qarşılıqlı təsir moduludur. Bu modul mətn, səs və görüntü arasındakı istiqamətli təsir çəkilərini hesablayır. Məsələn, mətndən səsə təsirlə səsdən mətnə təsir eyni qəbul edilmir; hər istiqamət ayrıca etibar çəkisi ilə modelləşdirilir.
Üçüncü komponent iki yollu qarşılıqlı təsir quruluşudur. Model həm lokal ikili qarşılıqlı təsirləri, həm də qlobal üçlü qarşılıqlı təsiri tutmağa çalışır. Lokal yol mətn-səs, mətn-görüntü və səs-görüntü kimi ikili münasibətləri araşdırır. Qlobal yol isə üç modallığın birlikdə yaratdığı daha geniş qarşılıqlı təsir nümunəsini tutur.
Dördüncü komponent Interaction-aware Mixture-of-Experts moduludur. Bu quruluş fərqli çarpaz-modal qarşılıqlı təsir növləri üçün fərqli ekspert şəbəkələri yaradır. Text-Audio Expert, Text-Video Expert, Audio-Video Expert, Trimodal Expert və General Expert kimi ekspertlər mövcuddur. Model hər nümunədə bütün ekspertlərdən bərabər istifadə etmir; top-k routing strategiyası ilə ən uyğun bir neçə eksperti seçir.
Beşinci komponent Semantically Complementary Global Interaction moduludur. Bu quruluş asimmetrik qarşılıqlı təsirlər zamanı itə biləcək tamamlayıcı duyğu ipuclarını yenidən tutmağı hədəfləyir. Altıncı komponent isə Modality-Specific Channel Refinement moduludur. Bu modul hər modallığın öz daxilində daşıdığı mühüm duyğu siqnallarını qoruyaraq birləşdirilmiş təmsilin zəifləməsinin qarşısını almağa çalışır.
Formullar Nəyi İzah Edir?
Tədqiqatda çoxsaylı riyazi ifadələr yer alır. Aşağıdakı formullar məqalədəki simvol quruluşuna mümkün qədər sadiq şəkildə verilib və Verianla oxucusu üçün sadə izahlarla birlikdə təqdim olunub.
Mətn modallığı BERT ilə kodlaşdırılır. Burada \(X_t\) mətn girişini; \(H_t\) isə mətndən çıxarılan kontekstual təmsil ardıcıllığını ifadə edir.
Səs və görüntü modallıqlarına mövqe məlumatı əlavə edilir və Transformer encoder vasitəsilə təmsil çıxarılır. Burada \(m \in \{a,v\}\) səs və ya görüntü modallığını təmsil edir.
Model daha sonra modallıqları ortaq ölçüyə proyeksiya edir. Mətn üçün [CLS] təmsilindən, səs və görüntü üçün isə orta hovuzlamadan istifadə olunur.
Asimmetrik münasibət aşkarlama mexanizmi bir modallığın başqa modallığa istiqamətli təsirini hesablayır. Burada \(w_{j \rightarrow i}\) mənbə modallıq \(j\)-dən hədəf modallıq \(i\)-yə təsirin etibar çəkisini təmsil edir.
Bu çəkilərdən istifadə etməklə hər modallıq digər modallıqlardan gələn istiqamətli təsirə uyğun olaraq yenidən miqyaslanır. Burada \(\odot\) element-səviyyəli vurmanı göstərir.
Lokal ikili qarşılıqlı təsirdə iki modallığın gücləndirilmiş təmsilləri birləşdirilir və qeyri-xətti çevrilmədən keçirilir.
Üç ikili qarşılıqlı təsir vektoru üst-üstə yığılaraq daha geniş münasibət quruluşu yaradılır.
Mixture-of-Experts quruluşunda fərqli ekspertlər fərqli qarşılıqlı təsir növlərini emal edir. Məsələn, mətn-səs, mətn-görüntü, səs-görüntü, üçlü modallıq və ümumi ekspertlər ayrı qarşılıqlı təsir nümunələrinə fokuslanır.
Routing, yəni yönləndirmə şəbəkəsi hər nümunə üçün hansı ekspertlərin seçiləcəyini müəyyən edir. Model bütün ekspertləri işlətmək əvəzinə ən uyğun \(k\) eksperti seçir.
Seçilmiş ekspertlərin çıxışları çəkili şəkildə birləşdirilir.
Ekspert çökməsinin qarşısını almaq üçün yük balanslaşdırma itkisi istifadə olunur. Ekspert çökməsi modelin davamlı olaraq eyni bir neçə ekspertə yönəlməsi və digər ekspertlərin öyrənə bilməməsi vəziyyətidir.
Reqressiya tərəfində duyğu balının proqnozu üçün L1 itkisi istifadə olunur. Bu itki proqnozlaşdırılan duyğu dəyəri ilə həqiqi duyğu dəyəri arasındakı mütləq fərqi ölçür.
Ümumi təlim məqsədi reqressiya itkisini, duyğu-fərqində kontrastiv itkini və yük balanslaşdırma itkisini birləşdirir.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
Model arxitekturasının sxemi sistemin mətn, səs və görüntü girişlərini əvvəlcə ayrı-ayrılıqda kodlaşdırdığını, sonra isə bu modallıqlar arasındakı istiqamətli təsirləri hesabladığını göstərir. Sxemin əsas mesajı budur: Model “mətn + səs + görüntü” birləşməsini sadə toplama əməliyyatı kimi görmür; hansı kanalın hansı kanala nə qədər təsir etdiyini ayrıca öyrənir.
Asimmetrik münasibət sxemi modallıq qarşılıqlı təsirlərinin tək istiqamətli və bərabər olmadığını göstərir. Məsələn, bir nümunədə mətn səs və görüntü üzərində güclü təsir yarada bilər; lakin səs və ya görüntü mətni eyni dərəcədə dəyişdirməyə bilər. Bu yanaşma xüsusilə ironiya, qeyri-müəyyən mətn və zəif duyğu siqnalı olan hallarda vacibdir.
Semantically Complementary Global Interaction sxemi modelin yalnız asimmetrik qarşılıqlı təsirlə kifayətlənmədiyini göstərir. Bəzi duyğu ipucları istiqamətli qarşılıqlı təsir zamanı zəifləyə və ya itə bilər. Buna görə model üç modallığın ortaq təmsilindən həm lokal, həm də qlobal tamamlayıcı duyğu məlumatı çıxarmağa çalışır.
Verilənlər dəsti cədvəlinin əsas mesajı modelin həm ingilis, həm də çin dilli çoxmodallı duyğu analizi verilənləri üzərində sınaqdan keçirilməsidir. CMU-MOSI daha kiçik və klassik benchmarkdır. CMU-MOSEI daha böyükdür və daha müxtəlif duyğu nümunələri ehtiva edir. CH-SIMS v2 isə çin dili verilənlər dəsti kimi daha çox real dünya səs-küyü və zəif duyğu ifadələri ilə modeli fərqli kontekstdə sınağa çəkir.
Performans cədvəlləri təklif olunan modelin xüsusilə ikili duyğu təsnifatında güclü nəticə verdiyini göstərir. CMU-MOSI üzərində Acc-2 və F1 ballarında nəzərəçarpacaq artım bildirilir. CMU-MOSEI-də daha kiçik, lakin ardıcıl yaxşılaşmalar görünür. CH-SIMS v2-də isə səs-küylü və zəif duyğu siqnalları olan nümunələrdə müsbət nəticələr önə çıxır.
Ablasiya cədvəli modelin hansı hissələrinin həqiqətən töhfə verdiyini göstərir. IMoE modulu çıxarıldıqda F1 balında ən böyük azalmalardan biri baş verir. Bu, dinamik ekspert seçiminin mürəkkəb kontekstlərdə incə duyğu siqnallarını tutmaq üçün vacib olduğunu göstərir. MRDCI və SCGI modulları çıxarıldıqda da performans azalır; bu da asimmetrik qarşılıqlı təsirin və tamamlayıcı qlobal təmsilin model üçün əsas olduğunu düşündürür.
Nümunə hal təhlili mətnin açıq şəkildə mənfi duyğu daşıdığı, səs və görüntünün isə aydın duyğu siqnalı vermədiyi vəziyyəti göstərir. Qarşılıqlı təsir matrisi mətnin digər modallıqlar üzərində güclü təsir yaratdığını; səs və görüntünün mətn üzərində əks təsirinin aşağı qaldığını göstərir. Bu nümunə “hər modallıq bərabər çəkiyə malik deyil” fikrini konkretləşdirir.
Ekspert seçimi paylanması modelin yalnız bir ekspertə çökmədiyini göstərir. Trimodal Expert və Audio-Video Expert daha tez-tez seçilsə də, digər ekspertlərdən də mənalı şəkildə istifadə olunur. Bu, top-k routing mexanizminin fərqli nümunələrdə fərqli qarşılıqlı təsir ekspertlərini işə sala bildiyini göstərir.
T-SNE vizuallaşdırması modelin təmsil keyfiyyətini vizual şəkildə izah edir. Yalnız səs və ya görüntüdən istifadə edildikdə duyğu qrupları bir-birinə çox qarışır. Mətn daha yaxşı ayrılma təmin etsə də, neytral duyğu hələ də dağınıqdır. Çarpaz-modal qarşılıqlı təsir və IMoE əlavə edildikdə müsbət, mənfi və neytral nümunələrin daha yaxşı ayrıldığı görünür. Bu, modelin xüsusilə neytral duyğu ilə qütbləşmiş müsbət/mənfi duyğu arasındakı sərhədi daha yaxşı çəkə bildiyini göstərir.
Təcrübələr Necə Aparılıb?
Tədqiqatda üç geniş istifadə olunan çoxmodallı duyğu analizi verilənlər dəstindən istifadə olunub: CMU-MOSI, CMU-MOSEI və CH-SIMS v2. CMU-MOSI YouTube rəy videolarından ibarət klassik benchmarkdır. CMU-MOSEI daha böyük miqyaslı və daha müxtəlif mövzu paylanmasına malik genişləndirilmiş verilənlər dəstidir. CH-SIMS v2 isə çin dili çoxmodallı duyğu analizi üçün istifadə olunan, daha realistik səs-küy və zəif duyğu ifadələri ehtiva edən verilənlər dəstidir.
Model mətn, səs və görüntü xüsusiyyətlərini ayrı-ayrılıqda emal edir. Mətn tərəfində BERT-base, çin dili verilənlər dəsti üçün isə BERT-base-cn istifadə olunur. Səs və görüntü tərəfində verilənlər dəstinə görə fərqli xüsusiyyət ölçüləri tətbiq edilir. Təcrübələr PyTorch ilə həyata keçirilir və tək NVIDIA RTX 3090 GPU üzərində aparılır.
Qiymətləndirmə həm reqressiya, həm də təsnifat metrikləri ilə aparılır. Reqressiya tərəfində MAE və Pearson korrelyasiyası istifadə olunur. MAE proqnozlaşdırılan duyğu balı ilə həqiqi duyğu balı arasındakı orta mütləq xətanı ölçür. Pearson korrelyasiyası proqnozla həqiqi etiket arasındakı xətti əlaqəni göstərir.
Təsnifat tərəfində Acc-7, Acc-5, Acc-2 və F1 balları bildirilir. Acc-7 və Acc-5 daha incə dənəli duyğu təsnifatını ölçür. Acc-2 və F1 isə müsbət/mənfi ayrımı kimi daha kobud, lakin praktikada mühüm olan duyğu təsnifatını qiymətləndirir.
Model klassik füzyon üsulları, Transformer əsaslı metodlar, kontrastiv öyrənmə yanaşmaları, təmsilin ayrışdırılması üsulları, adaptiv ekspert mexanizmləri və multimodal böyük dil modeli əsaslı metodlarla müqayisə edilir. Beləliklə, təklif olunan modelin yalnız köhnə metodlara deyil, daha yeni və güclü yanaşmalara qarşı da necə mövqe tutduğu görünür.
Bundan əlavə, ablation tədqiqatları aparılır. Ablation modeldən komponentləri bir-bir çıxararaq hər hissənin performansa nə qədər töhfə verdiyini ölçən üsuldur. MRDCI, APMR, GPTA, LBI, IMoE, SCGI və MSCR kimi komponentlər çıxarıldıqda performansdakı dəyişiklik araşdırılır.
Nəticələr Nəyi Göstərir?
Birinci nəticə çoxmodallı duyğu analizində modallıqlar arasındakı qarşılıqlı təsiri simmetrik qəbul etməyin məhdud yanaşma olmasıdır. Mətn, səs və görüntü hər nümunədə eyni çəkidə işləmir. Bəzi hallarda mətn üstün müəyyənedicidir; bəzi hallarda isə səs və ya görüntü mətni tamamlayır, düzəldir və ya zəif duyğunu görünən edir.
İkinci nəticə asimmetrik qarşılıqlı təsirin modelləşdirilməsinin performansa mənalı töhfə verməsidir. MRDCI modulu çıxarıldıqda F1 balında nəzərəçarpacaq azalma baş verməsi istiqamətli modallıq münasibətlərini öyrənməyin duyğu proqnozunda vacib olduğunu göstərir.
Üçüncü nəticə dinamik ekspert seçiminin kritik olmasıdır. IMoE modulu çıxarıldıqda performans ciddi şəkildə azalır. Bu, hər nümunə üçün eyni füzyon strategiyasının kifayət etmədiyini; modelin kontekstə görə fərqli ekspertləri seçməsinin daha yaxşı nəticə verə bildiyini göstərir.
Dördüncü nəticə tamamlayıcı qlobal qarşılıqlı təsirin və modallığa xas kanal təkmilləşdirməsinin duyğu siqnallarının itkisinin azaldılmasına kömək edə bilməsidir. SCGI üç modallıq arasındakı ortaq və lokal-qlobal duyğu ipuclarını gücləndirir. MSCR isə hər modallığın öz daxilində daşıdığı mühüm siqnalları qoruyur.
Beşinci nəticə modelin xüsusilə zəif duyğu siqnalları və səs-küylü nümunələrdə üstünlük təmin etməsidir. CH-SIMS v2 nəticələri neytral duyğunu müsbət və ya mənfi siniflərdən ayırmağın çətin olduğu hallarda modelin daha güclü ayrım edə bildiyini göstərir.
Altıncı nəticə daha çox ekspert işlətməyin həmişə daha yaxşı olmamasıdır. Top-k sparse routing yanaşması yalnız ən uyğun ekspertləri seçərək həm hesablama yükünü azaldır, həm də nümunəyə uyğun təmsil yaradır. Tədqiqatda 5 ekspert və top-2 aktivləşdirmə strategiyası kobud duyğu təsnifatı və korrelyasiya metriklərində yaxşı tarazlıq təmin edir.
Bu Niyə Vacibdir?
Bu tədqiqat duyğu analizində “daha çox verilən kanalını birləşdirək” düşüncəsinin təkbaşına kifayət etmədiyini göstərir. Əsas məsələ bu kanalların bir-birinə necə təsir etdiyini və hansı kontekstdə hansı kanalın daha etibarlı olduğunu anlaya bilməkdir.
Sosial media videoları, onlayn təhsil qeydləri, müştəri dəstəyi danışıqları, insan-robot qarşılıqlı əlaqəsi və duyğu-fərqində olan tətbiqlərdə mətn, səs və görüntü çox vaxt birlikdə mövcuddur. Lakin bu verilənlər həmişə uyğun olmur. İnsan müsbət sözlər işlədərkən üz ifadəsi mənfi ola bilər; səs tonu mətndəki mənanı tərsinə çevirə bilər; görüntü aşağı keyfiyyətli ola bilər; danışıq qeyri-müəyyən və ya ironik ola bilər.
Buna görə kontekst-fərqində olan və asimmetrik qarşılıqlı təsiri öyrənən modellər klassik “üç kanalı birləşdir və proqnoz ver” yanaşmasından daha irəli addım təqdim edir. Model yalnız modallıqları toplamaqla kifayətlənmir; onların arasındakı güc tarazlığını öyrənməyə çalışır.
Tədqiqat eyni zamanda Mixture-of-Experts arxitekturasının çoxmodallı duyğu analizində niyə vacib ola biləcəyini göstərir. Əgər hər nümunə fərqli duyğu qarşılıqlı təsir nümunəsi daşıyırsa, tək ümumi model əvəzinə fərqli ekspertlərin kontekstə görə seçilməsi daha çevik və səmərəli ola bilər.
Lakin belə sistemlərin real dünyada istifadəsi diqqət tələb edir. Duyğunun tanınması insanın daxili dünyasını qəti şəkildə oxuma vasitəsi deyil. Model verilənlərdəki mətn, səs və görüntü siqnallarından proqnoz yaradır; bu proqnozlar kontekstdən, mədəniyyətdən, verilənlərin keyfiyyətindən, istifadəçi davranışından və etik məhdudiyyətlərdən asılıdır.
Diqqət Edilməli Məqamlar
Birinci diqqət məqamı tədqiqatın preprint olmasıdır. Rəyçi qiymətləndirməsindən keçmədiyi üçün metod, nəticələr və iddialar gələcəkdə dəyişə bilər. Buna görə tapıntılar ümidverici tədqiqat nəticəsi kimi oxunmalı, təsdiqlənmiş standart kimi qiymətləndirilməməlidir.
İkinci diqqət məqamı duyğu tanımanın etik sərhədləridir. Bir insanın duyğusunu mətn, səs və görüntüdən avtomatik proqnozlaşdırmaq həssas prosesdir. Təhsil, işə qəbul, səhiyyə, təhlükəsizlik, müşahidə və ya müştəri qiymətləndirilməsi kimi sahələrdə belə sistemlər insanları avtomatik etiketləmək üçün təkbaşına istifadə edilməməlidir.
Üçüncü diqqət məqamı verilənlər dəstindən asılılıqdır. CMU-MOSI, CMU-MOSEI və CH-SIMS v2 güclü benchmarklar olsa da, real dünya verilənləri daha mürəkkəb ola bilər. Fərqli dillər, mədəniyyətlər, aksentlər, kamera keyfiyyəti, sosial kontekstlər və üz ifadəsi normaları modelin performansını dəyişdirə bilər.
Dördüncü diqqət məqamı incə dənəli duyğu təsnifatıdır. Tədqiqat bəzi modulların ikili təsnifatı gücləndirdiyi halda Acc-5 və Acc-7 kimi daha incə duyğu metriklərində həmişə eyni faydanı vermədiyini bildirir. Bu, müsbət/mənfi ayrımının daha asan; incə duyğu intensivliyinin və neytral sərhədlərin isə daha çətin olduğunu göstərir.
Beşinci diqqət məqamı modelin mürəkkəbliyidir. Dinamik ekspertlər, top-k routing, asimmetrik qarşılıqlı təsir və çoxsaylı itki funksiyaları güclü arxitektura yaratsa da, sistemi daha mürəkkəb edir. Real istehsal mühitində izah edilə bilənlik, hesablama xərci, gecikmə, məlumat məxfiliyi və texniki xidmət tələbləri ayrıca qiymətləndirilməlidir.
Nəticə
Bu tədqiqat çoxmodallı duyğu analizində mühüm bir fikri mərkəzə gətirir: Mətn, səs və görüntü arasındakı münasibət həmişə bərabər və simmetrik deyil. Bəzi nümunələrdə mətn digər modallıqları yönləndirir; bəzi nümunələrdə səs və görüntü mətnin mənasını tamamlayır; bəzi hallarda isə üç modallığın birlikdə emal olunması tələb olunur.
Təklif olunan model bu mürəkkəbliyi asimmetrik çarpaz-modal qarşılıqlı təsir və dinamik Mixture-of-Experts quruluşu ilə həll edir. MRDCI modallıqlar arasındakı istiqamətli təsirləri tutur. IMoE kontekstə uyğun ekspertləri seçərək incə duyğu siqnallarını emal edir. SCGI itə biləcək tamamlayıcı qlobal ipuclarını gücləndirir. MSCR isə modallığa xas mühüm siqnalları qoruyur.
Təcrübə nəticələri modelin üç benchmark verilənlər dəstində güclü performans göstərdiyini və xüsusilə ikili duyğu təsnifatı, səs-küylü nümunələr və zəif duyğu siqnallarında üstünlük təmin edə bildiyini göstərir.
Verianla baxımından tədqiqatın əsas mesajı budur: Süni intellektin insan duyğusunu daha yaxşı anlaması üçün yalnız mətn, səs və görüntüdən birlikdə istifadə etməsi kifayət deyil. Bu kanallar arasındakı istiqamətli güc münasibətini, konteksti və nümunəyə xas qarşılıqlı təsirləri də öyrənməlidir.
Mənbə və Metod Qeydi
Bu məzmun “Asymmetric Cross-modal Interaction Learning with Dynamic Mixture-of-experts for Context-aware Multimodal Sentiment Analysis” adlı preprint tədqiqata əsasən hazırlanıb. Tədqiqat çoxmodallı duyğu analizi, asimmetrik çarpaz-modal qarşılıqlı təsir, dinamik Mixture-of-Experts, top-k routing, semantik tamamlayıcı qlobal qarşılıqlı təsir və modallığa xas kanal təkmilləşdirmə yanaşmalarını CMU-MOSI, CMU-MOSEI və CH-SIMS v2 verilənlər dəstləri üzərində araşdırır.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla-nın nəşr xəttinə uyğun şəkildə sadələşdirilib və orijinal türkcə redaksiya məqaləsinə çevrilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib