

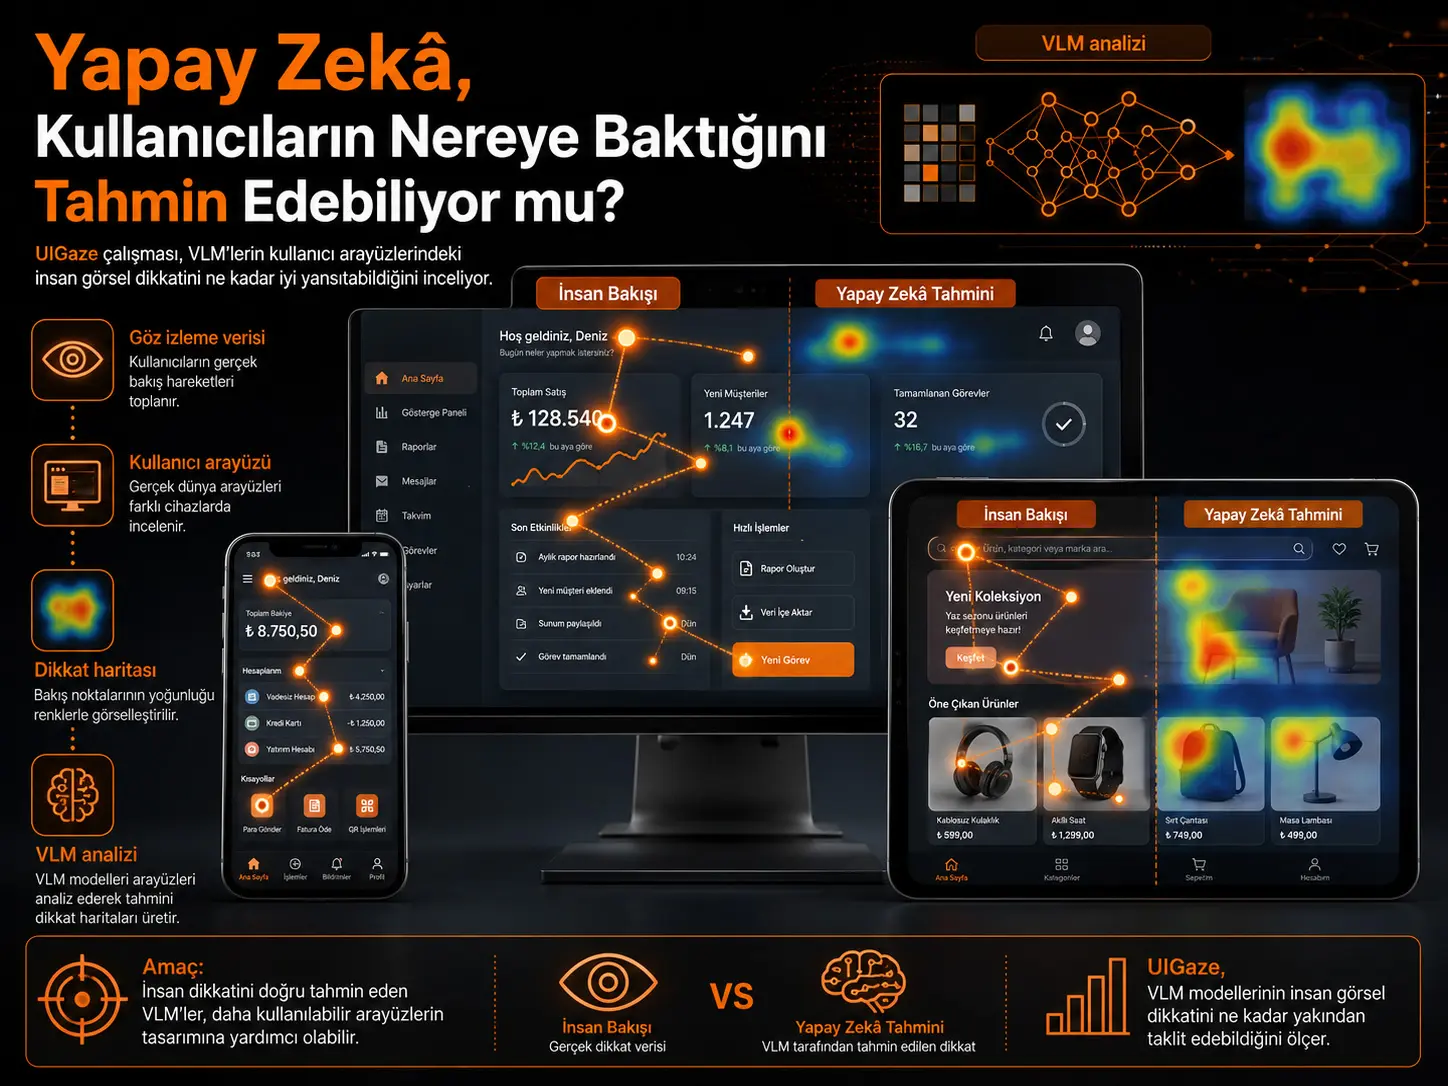
Min Song, Yoonseong Lee və Yeonhu Seo tərəfindən hazırlanmış UIGaze tədqiqatı görsel-dil modellərinin (Vision Language Models, VLM) istifadəçi interfeysinə baxan insanların vizual diqqət paylanmasını real göz izləmə məlumatlarına nə dərəcədə yaxınlaşdıra bildiyini sınaqdan keçirir. Tədqiqatda 62 iştirakçıdan əldə olunmuş göz izləmə məlumatlarını ehtiva edən UEyes məlumat dəstindəki 1.980 istifadəçi interfeysi görüntüsü istifadə olunur; hər biri 495 görüntüdən ibarət veb səhifə, masaüstü interfeysi, mobil interfeys və poster olmaqla dörd kateqoriya qiymətləndirilir. Doqquz VLM hər hansı göz izləmə məlumatı ilə öyrədilmədən sıfır-nümunəli tapşırıqda 30–50 baxış nöqtəsi proqnozlaşdırır. Bu nöqtələr Gauss bulanıqlaşdırması ilə diqqət xəritələrinə çevrilir və insan baxış xəritələri ilə CC, SIM və KL metrikləri üzrə müqayisə olunur. Ən güclü ümumi nəticə 7 saniyəlik müşahidə müddətində GPT-5.4 tərəfindən əldə olunur: CC=0,408, SIM=0,503 və KL=1,345. Nəticələr VLM proqnozlarının insanların ilkin baxış fiksasiyalarından çox, interfeysi bir neçə saniyə araşdırdıqdan sonra formalaşan kəşfiyyat xarakterli diqqət davranışına bənzədiyini göstərir. Bununla yanaşı göz izləmə ilə uyğunluq orta səviyyədə qalır və modellərin real istifadəçi tədqiqatlarını əvəz edəcək dəqiqlikdə olduğu göstərilmir.
İzləmə müddəti bu fərqin ən aydın göstəricilərindən biridir. GPT-5.4-ün korrelyasiya əmsalı 1 saniyəlik insan baxış xəritəsinə qarşı 0,217 ikən 3 saniyədə 0,326-ya, 7 saniyədə isə 0,408-ə yüksəlir. Oxşar meyl modellərin çoxunda görünür. Tədqiqatçılar bunu VLM-lərin görüntünün hamısını təhlil edərək semantik baxımdan vacib bölgələri müəyyən etməsi ilə əlaqələndirirlər: bu davranış insan gözünün ilk anda verdiyi sürətli yönəlmə reaksiyasından daha çox zamanla inkişaf edən şüurlu və kəşfiyyat xarakterli skan etməyə bənzəyir.
İnterfeys növü də nəticələri əhəmiyyətli dərəcədə dəyişir. GPT-5.4, 7 saniyəlik müqayisədə masaüstü interfeyslərində CC=0,506 ilə tədqiqatdakı bütün model-kateqoriya kombinasiyalarının ən yüksək korrelyasiyasına çatır. Eyni model mobil interfeyslərdə 0,369, posterlərdə 0,388 və veb interfeyslərdə 0,371 nəticə verir. Buna qarşılıq istifadəçi interfeyslərində avtonom əməliyyat aparmaq üçün hazırlanmış UI-TARS 1.5-in ümumi 7 saniyəlik CC dəyəri yalnız 0,086; mobil interfeyslərdə isə CC=-0,008-dir. Tədqiqatın mühüm nəticələrindən biri buna görə interfeysdə hansı elementə kliklənəcəyini və ya hansı əməliyyatın ediləcəyini müəyyənləşdirə bilməyin insanların hara baxdığını modelləşdirməklə eyni bacarıq olmadığını göstərməsidir.
Türkiyə baxımından: Tədqiqat Cənubi Koreya mərkəzli tədqiqatçılar tərəfindən aparılsa da, istifadə olunan UEyes məlumat dəsti üzərindən aparılan qiymətləndirmə Türkiyəyə xas istifadəçi davranışını ölçmür. Nəticələr Türkiyədəki e-ticarət saytları, korporativ veb interfeyslər, mobil tətbiqlər və ya dövlət xidməti ekranları üçün birbaşa istifadəçi davranışı məlumatı kimi qəbul edilməməlidir. Bununla yanaşı sıfır-nümunəli VLM əsaslı diqqət proqnozu dizaynın erkən mərhələsində real göz izləmə testi aparılmadan əvvəl potensial diqqət bölgələrinin ilkin yoxlanışında tədqiqata dəyər bir alət ola bilər. Türk istifadəçilər üçün etibarlılığın göstərilməsi dil, oxuma istiqaməti, yaş, təcrübə, mədəni fon və interfeys vərdişlərini ehtiva edən yerli göz izləmə məlumatları ilə ayrıca doğrulama tələb edir.
Tədqiqatın əsas sualı nədir?
İstifadəçi interfeysi dizaynında yalnız ekranda hansı elementlərin olduğu deyil, insanların bu elementlərdən hansına baxdığı və diqqətlərini ekran boyunca necə payladığı da vacibdir. Göz izləmə tədqiqatlarından əldə olunan diqqət xəritələri başlıqların, düymələrin, menyuların, şəkillərin və digər interfeys komponentlərinin diqqət çəkmə səviyyələrini göstərə bilər. Lakin real göz izləmə təcrübəsi iştirakçı, xüsusi avadanlıq, zaman və məlumat toplama infrastrukturu tələb edir.
UIGaze tədqiqatının sualı bu nöqtədə ortaya çıxır: Şəkilləri və vizual məzmundakı mənanı şərh edə bilən müasir VLM-lər xüsusi olaraq göz izləmə məlumatı üzərində öyrədilmədən istifadəçi interfeysində insanların baxma ehtimalı olan bölgələri proqnozlaşdıra bilərmi?
Tədqiqatçılar bunu istifadəçi interfeysi elementi tapma tapşırığı kimi deyil, bütün ekran üzrə insan baxış paylanmasını proqnozlaşdırma problemi kimi nəzərdən keçirirlər. Bu fərq vacibdir. Məsələn, modelə “axtarış düyməsini tap” deyildikdə müəyyən obyektin koordinatını tapmaq, insanların sərbəst şəkildə baxdığı ekranda diqqət sıxlığının bütün görüntüyə necə yayıldığını proqnozlaşdırmaqla eyni problem deyil.
UEyes məlumat dəsti niyə istifadə edildi?
Ground truth kimi UEyes göz izləmə məlumat dəsti istifadə olunur. Məlumat dəsti ümumilikdə 1.980 istifadəçi interfeysi ekran görüntüsündən ibarətdir və dörd kateqoriya bərabər şəkildə təmsil olunur:
| İnterfeys kateqoriyası | Görüntü sayı |
|---|---|
| Veb səhifə | 495 |
| Masaüstü istifadəçi interfeysi | 495 |
| Mobil istifadəçi interfeysi | 495 |
| Poster | 495 |
| Cəmi | 1.980 |
UEyes məlumatları 62 iştirakçının laboratoriya şəraitində yüksək dəqiqlikli göz izləyicisi istifadə olunaraq toplanmış baxış ölçmələrini ehtiva edir. Hər iştirakçı görüntüləri 7 saniyə ərzində araşdırır. Məlumat dəstində 1, 3 və 7 saniyəlik üç ayrı zaman pəncərəsinə uyğun diqqət xəritələri mövcuddur.
Bu üç müddət tədqiqatın mühüm hissəsidir. Bir saniyəlik xəritə görüntü ilə ilk qarşılaşmadakı diqqət davranışına daha yaxındır, 7 saniyəlik xəritə isə istifadəçiyə ekranı araşdırmaq üçün daha çox vaxt verildiyi vəziyyətdəki kəşfiyyat xarakterli vizual davranışı təmsil edir. UIGaze beləliklə yalnız “model insana bənzəyirmi?” sualını deyil, insan diqqətinin hansı zaman mərhələsinə daha çox bənzədiyini də araşdıra bilir.
VLM-lərdən baxış nöqtələri necə əldə edildi?
Tədqiqatçılar hər ekran görüntüsünü VLM-yə tək bir sıfır-nümunəli prompt ilə göndərirlər. Modeldən insanların baxması ehtimal olunan 30–50 nöqtəni normallaşdırılmış x və y koordinatları və hər nöqtə üçün intensivlik dəyəri ilə yaratması istənilir.
Proses üç əsas mərhələdən ibarətdir:
- İnterfeys görüntüsü VLM-yə göndərilir və modeldən baxış koordinatları istənilir.
- Normallaşdırılmış koordinatlar orijinal ekran görüntüsünün piksel ölçülərinə proyeksiya olunur.
- Hər nöqtəyə intensivlik dəyəri ilə çəkiləndirilmiş Gauss bulanıqlaşdırması tətbiq edilərək davamlı diqqət xəritəsi yaradılır.
Gauss bulanıqlaşdırmasının standart sapması \(\sigma=40\) piksel olaraq müəyyənləşdirilmişdir. Tədqiqatçılar bu dəyəri UEyes istilik xəritələrinin yaradılma parametrləri ilə uyğunlaşdırmaq və təxminən 1 dərəcəlik vizual bucaq yanaşmasını qorumaq məqsədilə istifadə edirlər.
Modeldən birbaşa yeni istilik xəritəsi görüntüsü çəkməsinin istənməməsinin də metodoloji səbəbi var. Generativ görüntü modeli orijinal istifadəçi interfeysindəki pikselləri dəyişə bilər. Belə halda model nəticəsi ilə göz izləmə ground truth-u arasında piksel səviyyəsində etibarlı müqayisə aparmaq mümkün olmaz. Koordinat yaratma yanaşması orijinal interfeys geometriyasını dəyişmədən qiymətləndirmə aparmağa imkan verir.
Hansı modellər müqayisə edildi?
Tədqiqat beş provayderdən doqquz VLM-ni eyni qiymətləndirmə pipeline-ında müqayisə edir. Tədqiqatda istifadə edilən model versiyaları və snapshot tarixləri belədir:
| Provayder | Model | Tədqiqatda istifadə edilən snapshot |
|---|---|---|
| OpenAI | GPT-5.4 | 2026-03-05 |
| OpenAI | GPT-5.4-mini | 2026-03-17 |
| Gemini 3.1 Pro | 2026-02-19 | |
| Gemini 3.1 Flash Lite | 2026-03-03 | |
| Anthropic | Claude Opus 4.6 | 2026-02-05 |
| Anthropic | Claude Sonnet 4.6 | 2026-02-17 |
| Qwen | Qwen 3.5 Plus | 2026-02-16 |
| Qwen | Qwen 3.5 Flash | 2026-02-24 |
| ByteDance | UI-TARS 1.5 | Model identifikatorunda tarix göstərilməyib |
Bütün modellər tədqiqatda OpenRouter API üzərindən ortaq interfeyslə işlədilmişdir. Bu detal eksperimentin müxtəlif model provayderlərini eyni koordinat istehsalı və qiymətləndirmə pipeline-ına daxil etməsi baxımından vacibdir.
CC, SIM və KL nəyi ölçür?
VLM-nin yaratdığı diqqət xəritəsi ilə real insan göz izləmə xəritəsi üç standart ölçü üzrə müqayisə edilmişdir.
CC (Correlation Coefficient): Proqnozlaşdırılmış xəritə ilə real xəritənin məkan nümunələri arasındakı xətti korrelyasiyanı ölçür. Dəyərin 1-ə yaxınlaşması daha yüksək oxşarlıq deməkdir.
SIM (Similarity): İki xəritəni ehtimal paylanmaları kimi qiymətləndirərək nə qədər üst-üstə düşdüklərini ölçür. 1 dəyəri eyni paylanmanı ifadə edir.
KL divergence: Real diqqət paylanmasının proqnozlaşdırılan paylanma ilə təmsil edilməsi zamanı yaranan informasiya itkisini ölçür. Burada daha aşağı dəyər daha yaxşı uyğunluq deməkdir.
Buna görə CC və SIM-də yüksək, KL-də aşağı dəyərlər üstün sayılır.
Eksperiment necə təkrarlandı?
1.980 görüntünün hər biri doqquz modellə qiymətləndirilmiş və model nəticələrindəki dəyişkənliyi nəzərə almaq məqsədilə hər model-görüntü cütü üçün üç müstəqil run aparılmışdır. Hər proqnoz həmçinin 1, 3 və 7 saniyəlik insan baxış xəritələrinin üçü ilə müqayisə edilmişdir.
Tədqiqatçılar üç təkrarın kifayət edib-etmədiyini müəyyən etmək üçün 40 görüntülük alt dəstdə 10 təkrarlı pilot eksperiment aparmışlar. Üç və 10 təkrar əsasında əldə edilən orta metriklər arasında nəzərə alınmayacaq fərq tapıldığı üçün tam eksperimentdə üç təkrar istifadə edilmişdir. Eksperimentlərin Aprel 2026-da aparıldığı bildirilir.
7 saniyədə ümumi performans nə göstərir?
Yeddi saniyəlik insan baxış xəritələrinə qarşı ən yüksək uyğunluq GPT-5.4 tərəfindən əldə edilmişdir. Lakin CC=0,408 dəyəri tam və ya çox yüksək insan uyğunluğunu deyil, tədqiqatçıların da ifadə etdiyi kimi orta səviyyəli davranış uyğunluğunu göstərir.
| Model | CC ↑ | SIM ↑ | KL ↓ |
|---|---|---|---|
| GPT-5.4 | 0,408 ± 0,169 | 0,503 ± 0,085 | 1,345 ± 0,793 |
| Claude Opus 4.6 | 0,344 ± 0,200 | 0,468 ± 0,102 | 1,670 ± 0,957 |
| Qwen 3.5 Plus | 0,337 ± 0,167 | 0,466 ± 0,085 | 1,612 ± 0,869 |
| Qwen 3.5 Flash | 0,295 ± 0,171 | 0,424 ± 0,102 | 2,214 ± 1,372 |
| GPT-5.4-mini | 0,289 ± 0,171 | 0,453 ± 0,084 | 1,600 ± 0,918 |
| Claude Sonnet 4.6 | 0,279 ± 0,195 | 0,436 ± 0,110 | 1,924 ± 1,247 |
| Gemini 3.1 Pro | 0,144 ± 0,228 | 0,255 ± 0,196 | 5,457 ± 3,385 |
| Gemini 3.1 Flash Lite | 0,105 ± 0,242 | 0,234 ± 0,216 | 5,823 ± 3,871 |
| UI-TARS 1.5 | 0,086 ± 0,171 | 0,142 ± 0,143 | 7,448 ± 2,580 |
Qwen 3.5 Plus və Qwen 3.5 Flash üçün iki görüntüdə davamlı cavab uğursuzluğu yarandığından bu iki modelin metrikləri 1.980 əvəzinə qalan 1.978 görüntü üzərindən hesablanmışdır.
İnsan baxışı ilə oxşarlıq niyə zamanla artır?
Tədqiqatın diqqət çəkən nəticələrindən biri demək olar ki, bütün modellərdə 7 saniyəlik baxış paylanmasına uyğunluğun 1 saniyəlik paylanmadan yüksək olmasıdır.
| Model | 1 saniyə CC | 3 saniyə CC | 7 saniyə CC |
|---|---|---|---|
| GPT-5.4 | 0,217 ± 0,143 | 0,326 ± 0,163 | 0,408 ± 0,169 |
| Claude Opus 4.6 | 0,227 ± 0,157 | 0,303 ± 0,181 | 0,344 ± 0,200 |
| Qwen 3.5 Plus | 0,161 ± 0,131 | 0,245 ± 0,162 | 0,337 ± 0,167 |
| Qwen 3.5 Flash | 0,135 ± 0,137 | 0,210 ± 0,162 | 0,295 ± 0,171 |
| GPT-5.4-mini | 0,154 ± 0,133 | 0,220 ± 0,161 | 0,289 ± 0,171 |
| Claude Sonnet 4.6 | 0,142 ± 0,149 | 0,213 ± 0,178 | 0,279 ± 0,195 |
| Gemini 3.1 Pro | 0,059 ± 0,140 | 0,103 ± 0,189 | 0,144 ± 0,228 |
| Gemini 3.1 Flash Lite | 0,038 ± 0,147 | 0,070 ± 0,196 | 0,105 ± 0,242 |
| UI-TARS 1.5 | 0,078 ± 0,153 | 0,101 ± 0,180 | 0,086 ± 0,171 |
GPT-5.4 üçün 1 saniyədən 7 saniyəyə CC artımı nisbi olaraq %88-dir. Lakin 1 saniyəlik ölçmədə ən yüksək CC GPT-5.4-ə deyil Claude Opus 4.6-ya məxsusdur: 0,227-yə qarşı 0,217. GPT-5.4 daha sonra 3 və 7 saniyəlik qiymətləndirmələrdə önə keçir.
Tədqiqatçılar bu nəticəni müxtəlif modellərin insan vizual diqqətinin fərqli zaman komponentlərini müxtəlif səviyyələrdə tuta biləcəyinə işarə kimi qiymətləndirirlər. Ümumi nümunə isə VLM-lərin sürətli ilk fiksasiyadan çox semantik yönləndirilmiş kəşfiyyat baxışına yaxınlaşmasıdır.
İnterfeys strukturu nəticəni nə qədər dəyişir?
Yeddi saniyəlik CC nəticələri interfeys kateqoriyalarına ayrıldıqda model davranışı daha da aydınlaşır:
| Model | Masaüstü | Mobil | Poster | Veb |
|---|---|---|---|---|
| GPT-5.4 | 0,506 ± 0,156 | 0,369 ± 0,165 | 0,388 ± 0,169 | 0,371 ± 0,145 |
| Claude Opus 4.6 | 0,404 ± 0,193 | 0,275 ± 0,210 | 0,371 ± 0,183 | 0,325 ± 0,191 |
| Qwen 3.5 Plus | 0,402 ± 0,162 | 0,325 ± 0,158 | 0,323 ± 0,182 | 0,298 ± 0,146 |
| GPT-5.4-mini | 0,399 ± 0,168 | 0,230 ± 0,148 | 0,255 ± 0,177 | 0,272 ± 0,134 |
| Claude Sonnet 4.6 | 0,393 ± 0,180 | 0,187 ± 0,203 | 0,270 ± 0,167 | 0,265 ± 0,167 |
| Qwen 3.5 Flash | 0,359 ± 0,185 | 0,312 ± 0,163 | 0,246 ± 0,168 | 0,263 ± 0,145 |
| Gemini 3.1 Pro | 0,220 ± 0,258 | 0,134 ± 0,213 | 0,129 ± 0,208 | 0,093 ± 0,211 |
| Gemini 3.1 Flash Lite | 0,113 ± 0,258 | 0,112 ± 0,250 | 0,186 ± 0,240 | 0,007 ± 0,179 |
| UI-TARS 1.5 | 0,108 ± 0,171 | -0,008 ± 0,111 | 0,169 ± 0,173 | 0,076 ± 0,171 |
GPT-5.4-ün masaüstü interfeyslərindəki 0,506 CC dəyəri tədqiqatın ən yüksək model-kateqoriya nəticəsidir. Tədqiqatçılar masaüstü interfeyslərinin adətən menyu, məzmun sahəsi, yan panel və digər funksional bölgələr arasında daha açıq vizual iyerarxiya yaratmasının VLM-lərə güclü məkan ipucları verə biləcəyini müzakirə edirlər.
Bununla yanaşı nəticələr “daha sadə ekran həmişə daha asandır” şəklində şərh edilə bilməz. Məsələn, posterlərdə dekorativ elementlər semantik vaciblikdən fərqli şəkildə insan diqqətinə təsir edə bilər. Mobil interfeyslərdə isə dar görüntü sahəsində sıx və bir-biri ilə rəqabət aparan qarşılıqlı əlaqə elementləri model proqnozları ilə insan baxışı arasındakı fərqi böyüdə bilər.
Şəkil 1 nə göstərir?
Tədqiqatın 5. səhifəsindəki Şəkil 1, GPT-5.4-ün 7 saniyəlik qiymətləndirmədə reprezentativ ən yaxşı və ən pis nümunələrini yan-yana göstərir. Hər sətirdə solda orijinal istifadəçi interfeysi, ortada model tərəfindən proqnozlaşdırılan diqqət xəritəsi və sağda UEyes real göz izləmə xəritəsi yerləşir.
Yuxarıdakı uğurlu masaüstü nümunəsində modelin sıxlaşdırdığı diqqət bölgəsi real insan baxış sıxlığı ilə aydın şəkildə üst-üstə düşür. Tədqiqatçılar bu ekranın aydın vizual iyerarxiyasını və bir-birindən ayrılmış funksional bölgələrini model baxımından üstünlük kimi şərh edirlər.
Aşağıdakı mobil nümunədə isə fərq daha böyükdür. GPT-5.4 semantik baxımdan vacib hesab etdiyi çoxsaylı interfeys elementlərinə dağınıq diqqət nöqtələri yerləşdirərkən real insan baxış məlumatı müəyyən qarşılıqlı əlaqə bölgələrində daha sıx qruplaşır. Bu nümunə VLM-nin “hansı elementlər mənalıdır?” sualına verdiyi cavabla insan gözünün həqiqətən “hara baxdığı” arasındakı fərqi vizual şəkildə göstərir.
UI-TARS nəticəsi niyə vacibdir?
UI-TARS 1.5 istifadəçi interfeysi qarşılıqlı əlaqəsinə xüsusi model olmasına baxmayaraq insan baxışı proqnozunda doqquz model arasında sonuncu yerdədir. Ümumi 7 saniyəlik nəticədə CC=0,086 və KL=7,448 əldə edir. Kateqoriyalara görə KL sapmasının 5,4 ilə 8,8 arasında olduğu bildirilir; mobil CC isə -0,008-ə düşür.
Tədqiqatçılar bu nəticəni iki tapşırığın əsaslı şəkildə fərqli olması ilə izah edirlər. İnterfeys agenti tapşırığı yerinə yetirmək üçün kliklənə bilən və ya əməliyyat aparıla bilən elementi tapmağı öyrənə bilər. İnsan vizual diqqəti isə tək hədəf elementdən ibarət deyil; vizual saliency, düzən sıxlığı, semantik məna və qarşılıqlı əlaqə ipuclarının bütün ekran üzrə birləşməsi ilə yaranır.
Sıfır-nümunəli VLM ilə xüsusi diqqət modeli eyni şey deyil
Tədqiqatda UEyes üzərində yenidən öyrədilmiş UMSI modelinin əvvəlki tədqiqatda AUC=0,878-ə çatdığı bildirilir. UIGaze-dəki ən güclü VLM isə sıfır-nümunəli şəraitdə 7 saniyədə CC=0,408 əldə edir.
Bu iki ədədin birbaşa müqayisəsi düzgün deyil; çünki AUC və CC fərqli metriklərdir. Tədqiqatçılar da bunları bir-birinə qarşı birbaşa performans yarışı kimi təqdim etmirlər. Buradakı elmi fərq sahəyə xüsusi göz izləmə məlumatı ilə öyrədilmiş model ilə heç bir diqqət məlumatı ilə yenidən öyrədilmədən birbaşa istifadə olunan ümumi məqsədli VLM arasındadır.
VLM yanaşmasının üstünlüyü dəqiqlikdə deyil, istifadə həddində ortaya çıxır: göz izləmə təlim məlumatı, əlavə model təlimi və ya fine-tuning tələb etmədən yeni ekran görüntüsünə tətbiq edilə bilər. Buna görə tədqiqatçılar VLM əsaslı xəritələri rəsmi istifadəçi testinin əvəzinə deyil, erkən dizayn baxışında istifadə oluna biləcək təxmini ilkin siqnal kimi qiymətləndirirlər.
Tədqiqatın dəstəklədiyi nəticələr
- Müasir VLM-lər sıfır-nümunəli şəraitdə insan UI baxış paylanması ilə ölçülə bilən, lakin orta səviyyəli uyğunluq göstərə bilir.
- İnsan baxışı ilə uyğunluq ümumiyyətlə 1 saniyədən 7 saniyəyə doğru artır.
- Bu zaman davranışı VLM proqnozlarının ilk refleksiv baxışdan daha çox kəşfiyyat və semantik diqqət paylanmasına bənzədiyini dəstəkləyir.
- Model uğuru interfeys kateqoriyasına görə dəyişir.
- Aydın vizual iyerarxiyaya malik bəzi masaüstü interfeyslərində daha yüksək uyğunluq əldə edilir.
- UI-da əməliyyat yerinə yetirmə bacarığı insan baxış paylanmasını düzgün proqnozlaşdırma bacarığı ilə eyni deyil.
- VLM əsaslı yanaşma real istifadəçi məlumatı olmayan erkən dizayn mərhələlərində təxmini diqqət ilkin qiymətləndirməsi təmin edə bilər.
Tədqiqatın dəstəkləmədiyi və ya sınaqdan keçirmədiyi nəticələr
- VLM diqqət xəritələrinin real göz izləmə tədqiqatlarını əvəz edə biləcəyi göstərilməmişdir.
- CC=0,408 dəyəri insan baxışının düzgün və ya tam kopyalandığı demək deyil.
- Modelin ümumi görsel-dil qabiliyyəti və ya UI agenti performansı bu eksperimentdən çıxarıla bilməz; tədqiqat yalnız insan diqqət paylanması ilə davranış uyğunluğunu ölçür.
- Tədqiqat fərdi istifadəçilərin baxış davranışını proqnozlaşdırmır; ground truth 62 iştirakçının aqreqasiya edilmiş məlumatıdır.
- Yaş, ekspertlik, mədəniyyət və ya digər demoqrafik xüsusiyyətlərə görə model dəqiqliyi sınaqdan keçirilməyib.
- Tək sıfır-nümunəli prompt istifadə edildiyi üçün fərqli prompt dizaynlarının nəticəni necə dəyişdirəcəyi müəyyən edilməyib.
- VLM və xüsusi öyrədilmiş saliency modelləri eyni metriklərlə nəzarətli başa-baş eksperimentdə müqayisə edilməyib.
- Nəticələr Türkiyədəki istifadəçilərin diqqət davranışına birbaşa ümumiləşdirilə bilməz.
Tədqiqatın Metodu və Nəticələri
Eksperiment dizaynının texniki xülasəsi
| Eksperiment komponenti | Mənbədə verilən dəyər və ya metod |
|---|---|
| Məlumat dəsti | UEyes |
| Ümumi UI görüntüsü | 1.980 |
| Kateqoriya sayı | 4 |
| Kateqoriya başına görüntü | 495 |
| Göz izləmə iştirakçısı | 62 |
| Ümumi izləmə müddəti | 7 saniyə |
| Qiymətləndirilən insan baxış müddətləri | 1 s, 3 s, 7 s |
| VLM sayı | 9 |
| Model başına istənən baxış nöqtəsi | 30–50 |
| Koordinatlar | Normallaşdırılmış x, y və intensivlik |
| Gauss bulanıqlaşdırması | \(\sigma=40\) piksel |
| Hər model-görüntü cütü üçün təkrar | 3 |
| Pilot eksperiment | 40 görüntü üzərində 10 təkrar |
| Qiymətləndirmə metrikləri | CC, SIM, KL divergence |
| Modelə giriş | OpenRouter API |
| Eksperiment vaxtı | Aprel 2026 |
Ən güclü və ən zəif ümumi nəticə
Yeddi saniyəlik ground truth-a görə GPT-5.4 üç metrikanın hamısında ən güclü ümumi nəticəni verir: CC=0,408 ± 0,169, SIM=0,503 ± 0,085 və KL=1,345 ± 0,793.
UI-TARS 1.5 isə eyni qiymətləndirmədə CC=0,086 ± 0,171, SIM=0,142 ± 0,143 və KL=7,448 ± 2,580 ilə ən aşağı ümumi uyğunluğu göstərir.
Bu müqayisədə “ən güclü” ifadəsi insan göz izləmə xəritəsi ilə oxşarlığı bildirir; modellərin digər vizual tapşırıqlardakı ümumi performans sıralaması demək deyil.
Zaman nəticələrinin texniki şərhi
GPT-5.4 üçün CC ardıcıllığı
\[ 0{,}217\;(1\,s) \rightarrow 0{,}326\;(3\,s) \rightarrow 0{,}408\;(7\,s) \]
şəklindədir.
Claude Opus 4.6 üçün eyni sıra
\[ 0{,}227 \rightarrow 0{,}303 \rightarrow 0{,}344 \]
və Qwen 3.5 Plus üçün
\[ 0{,}161 \rightarrow 0{,}245 \rightarrow 0{,}337 \]
kimi verilmişdir. Modellərin çoxundakı bu monoton artım VLM-nin proqnozlaşdırdığı məkan diqqətinin daha uzunmüddətli insan skanı ilə getdikcə daha çox üst-üstə düşdüyünü göstərir.
UI-TARS 1.5 bu ümumi nümunənin aydın istisnasıdır. CC dəyərləri 0,078 → 0,101 → 0,086 olduğuna görə 7 saniyədə davamlı yaxşılaşma müşahidə edilmir.
İnterfeys kateqoriyasının təsiri
GPT-5.4-də ən yüksək kateqoriya CC dəyəri masaüstündə 0,506-dır. Qwen 3.5 Plus da masaüstündə 0,402-yə, Claude Opus 4.6 isə 0,404-ə çatır. Bu nəticə ən güclü modellərin aydın iyerarxiyaya malik masaüstü düzənlərində insan baxışı ilə daha yüksək ortaq məkan strukturu tuta bildiyini göstərir.
Buna qarşılıq kateqoriya təsiri bütün modellərdə eyni deyil. Məsələn, Qwen 3.5 Flash mobil interfeyslərdə CC=0,312 əldə edərkən posterlərdə 0,246-ya düşür. Claude Opus 4.6 isə posterlərdə 0,371 ilə mobildəki 0,275 dəyərindən daha yüksək uyğunluq göstərir. Buna görə müəyyən UI kateqoriyasının bütün VLM-lər üçün universal olaraq asan və ya çətin olduğu nəticəsi dəstəklənmir.
Qeyri-müəyyənlik və eksperimental məhdudiyyətlər
Cədvəllərdə yalnız ortalamalar deyil, standart sapmalar da göstərilmişdir və bəzi aşağı performanslı modellərdə standart sapmalar orta CC böyüklüyünə nisbətən xeyli yüksəkdir. Bu vəziyyət görüntülər arasında model davranışının ciddi dəyişə bildiyini göstərir.
Bundan əlavə tədqiqat aşağıdakı metodoloji məhdudiyyətləri açıq şəkildə qeyd edir:
- Yalnız bir sıfır-nümunəli prompt istifadə edilmişdir.
- İstənilən 30–50 baxış nöqtəsi sayının və ya zaman ifadələrinin dəyişdirilməsi sınaqdan keçirilməmişdir.
- UEyes məlumatı 62 iştirakçının göz hərəkətlərini aqreqasiya edir və fərdi fərqləri görünməz edir.
- Yaş, ekspertlik və mədəni fon kimi demoqrafik dəyişənlərə görə ayrıca qiymətləndirmə aparılmayıb.
- Yalnız CC, SIM və KL metrikləri istifadə edilmişdir.
- AUC-Judd və NSS kimi əlavə metriklərin fərqli performans ölçülərini göstərə biləcəyi qeyd edilir.
- Sıfır-nümunəli VLM-lərlə UEyes üzərində öyrədilmiş CNN əsaslı saliency modelləri eyni metriklərdən istifadə edilərək nəzarətli şəkildə müqayisə edilməmişdir.
Praktik istifadə baxımından nəticə nədir?
Tədqiqatçılar VLM əsaslı diqqət proqnozunu göz izləmə eksperimentlərinə alternativ kimi deyil, xüsusilə hələ real istifadəçisi olmayan və ya erkən prototip mərhələsindəki interfeyslər üçün aşağı giriş xərcinə malik ilkin siqnal kimi yerləşdirirlər.
Məsələn, model proqnozları istifadəçi testi aparılmadan əvvəl dizaynda mümkün diqqət kor nöqtələrinin müəyyənləşdirilməsi və ya A/B testindən əvvəl interfeysin sürətli ilkin yoxlanışdan keçirilməsi üçün istifadə oluna bilər. Lakin orta səviyyəli korrelyasiya dəyərləri və ilkin fiksasiyalardakı zəiflik səbəbilə kritik UX qərarlarının yalnız VLM istilik xəritəsinə əsaslandırılması bu tədqiqatın nəticələri tərəfindən dəstəklənmir.
Mənbə və Metod Qeydi
Tam orijinal işin adı: UIGaze: How Closely Can VLMs Approximate Human Visual Attention on User Interfaces?
Müəlliflər: Min Song, Yoonseong Lee, Yeonhu Seo.
Müəllif sırası: Min Song → Yoonseong Lee → Yeonhu Seo.
Bərabər töhfə/bərabər birinci müəllif: Araşdırılan versiyada bərabər birinci müəllif və ya bərabər töhfə bəyanı yoxdur.
Məsul müəllif: Mənbə müəyyən müəllifi açıq şəkildə “corresponding author” kimi tanımlamır. Hər üç müəllifin korporativ e-poçt ünvanları başlıq hissəsində verilib; buna görə doğrulanmamış məsul müəllif təyinatı edilməyib.
Qurum: Xebec Inc., South Korea. Hər üç müəllif üçün eyni qurum göstərilmişdir.
Mənbə növü: arXiv preprint.
Resenziya vəziyyəti: Bu tədqiqat resenziyadan keçməmiş preprintdir; nəticələr bu nəşr mərhələsi nəzərə alınaraq qiymətləndirilməlidir. 12 Avqust 2026 etibarilə müstəqil rəsmi biblioqrafik yoxlamada resenziyalı jurnal və ya konfrans versiyası doğrulanmamışdır.
arXiv: arXiv:2604.26352v1 [cs.HC].
arXiv DataCite DOI: 10.48550/arXiv.2604.26352. Bu DOI arXiv qeydinin DOI-sidir; resenziyalı jurnal DOI-si kimi şərh edilməməlidir.
Göndərilmə tarixi: 29 Aprel 2026.
Mövzu sahəsi: Computer Science — Human-Computer Interaction (cs.HC).
Jurnal/konfrans: Araşdırılan versiyada doğrulanmış resenziyalı jurnal və ya konfrans məlumatı yoxdur.
Nəşriyyat: Resenziyalı nəşr üçün doğrulanmış nəşriyyat yoxdur; mənbə arXiv-də yayımlanan preprintdir.
Rəsmi keçid: https://arxiv.org/abs/2604.26352
Lisenziya: CC BY 4.0 (Creative Commons Attribution 4.0 International). Təkrar istifadə və adaptasiya aparıldıqda uyğun istinad və dəyişiklik məlumatı qorunmalıdır.
Məlumat və kod əlçatanlığı: Tədqiqatçılar kodu, model proqnozlarını və qiymətləndirmə nəticələrini ictimai şəkildə təqdim etdiklərini bildirirlər. Tədqiqatda verilən layihə ünvanı: https://github.com/dunward/uigaze
Maliyyələşdirmə: Araşdırılan altı səhifəlik versiyada ayrıca maliyyələşdirmə və ya təşəkkür bölməsi yoxdur; maliyyələşdirmə məlumatı doğrulanmadığı üçün əlavə edilməyib.
Maraq toqquşması: Araşdırılan versiyada ayrıca maraq toqquşması bəyanı yoxdur. Buradan müəlliflərin maraq toqquşmasının olmadığı nəticəsi çıxarılmayıb.
Əsas metodoloji məhdudiyyət: Tədqiqat real istifadəçilərin aqreqasiya edilmiş göz izləmə məlumatları ilə VLM proqnozları arasındakı məkan oxşarlığını ölçür. Fərdi baxış davranışını proqnozlaşdırmır. Modellər tək bir sıfır-nümunəli prompt ilə qiymətləndirilmiş və yalnız CC, SIM və KL metrikləri istifadə edilmişdir. VLM-lər ilə xüsusi olaraq UEyes üzərində öyrədilmiş saliency modelləri eyni metriklərlə nəzarətli başa-baş eksperimentdə müqayisə edilməmişdir.
Vizual qiymətləndirmə: Tədqiqatın 5. səhifəsindəki Şəkil 1, GPT-5.4-ün 7 saniyəlik qiymətləndirmədə reprezentativ ən yaxşı və ən pis nümunələrini orijinal UI, VLM proqnozu və UEyes göz izləmə ground truth-u şəklində yan-yana göstərir. Uğurlu nümunədə model ilə insan sıxlıq bölgələri daha çox üst-üstə düşərkən, sıx mobil interfeys nümunəsində model çoxsaylı semantik elementə dağınıq diqqət təyin edir və real insan fiksasiyaları daha müəyyən bölgələrdə sıxlaşır.
Verianla Live məlumat mənbəyi: Məqalədəki Live qrafik yalnız tədqiqatın Cədvəl 2-sində bildirilən 7 saniyəlik orta CC dəyərlərindən istifadə edir. Mənbədə olmayan məlumat nöqtəsi, interpolyasiya və ya ara dəyər yaradılmamışdır.
Elmi məzmun sərhədi: Bu Verianla məqaləsindəki eksperiment quruluşu, modellər, sayısal dəyərlər, şərhlər və məhdudiyyətlər araşdırılan tədqiqata əsaslanır. Xarici doğrulama yalnız başlıq, müəlliflər, arXiv identifikatoru, DOI, tarix, nəşr vəziyyəti və lisenziya kimi biblioqrafik sahələr üçün istifadə edilmiş; xarici mənbələrdən yeni elmi nəticə əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib