

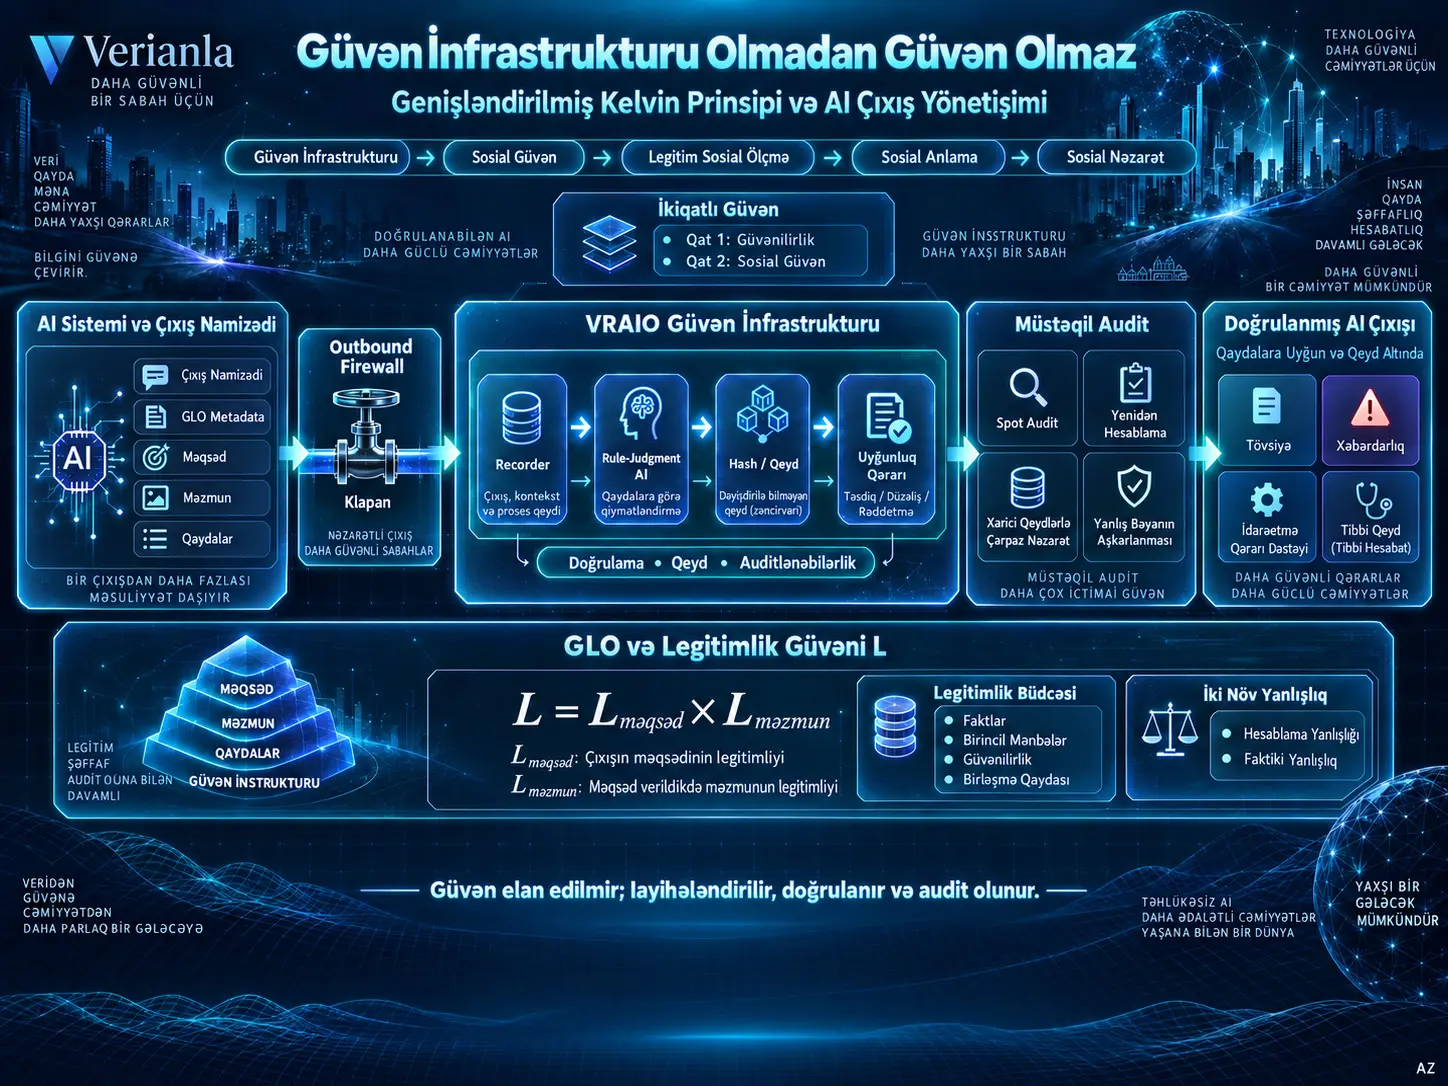
Bu tədqiqat süni intellektə ictimai etimadı fərdlərin və ya qurumların “bizə etibar edin” tipli bəyanatları ilə deyil, çıxışları yoxlanıla bilən, qeydə alına bilən və müstəqil şəkildə audit edilə bilən edən bir etimad infrastrukturu vasitəsilə izah edən konseptual idarəetmə çərçivəsi təklif edir. Yusaku Fujii tərəfindən işlənib hazırlanmış Genişləndirilmiş Kelvin Prinsipi klassik ölçmə–anlama–nəzarət zəncirinin əvvəlinə iki yeni şərt əlavə edir: sosial etimad üçün etimad infrastrukturu, legitim sosial ölçmə üçün isə sosial etimad tələb olunur. Tədqiqat bu nəzəri prinsipi süni intellekt çıxışlarının idarə edilməsinə tətbiq etmək üçün GLO (Guide to the Expression of Legitimacy of Output) adlı ortaq çıxış-legitimlik dili ilə VRAIO (Verifiable Record of AI Output) adlı yoxlama, qeyd və audit infrastrukturunu birlikdə nəzərdən keçirir.
Çərçivədə bir AI çıxışı yalnız mətn, görüntü və ya qərar kimi deyil, qaydalara uyğunluğu əsaslandırılmalı olan bir iddia kimi qəbul edilir. Çıxışın məqsədi və məzmunu üçün qaydalara uyğunluq dərəcəsi \(L\) adlı legitimlik etimadı ilə ifadə olunur; lakin \(L\) təkbaşına yayımlana bilməz. Dəyəri formalaşdıran faktların, ilkin mənbələrin, etibarlılıq qiymətləndirmələrinin və birləşdirmə üsulunun yer aldığı bir legitimlik büdcəsi də olmalıdır. Müstəqil Recorder, deterministik Rule-Judgment AI, dəyişdirilməyə davamlı qeyd infrastrukturu və əvvəlcədən xəbər verilməyən spot auditlər bu bəyanatların sonradan yoxlanıla bilməsini təmin etməyi hədəfləyir.
Məqalənin töhfəsi eksperimental olaraq təsdiqlənmiş qlobal AI idarəetmə sistemi təqdim etmək deyil. GLO və VRAIO gələcəkdə konkretləşdirilməli və müxtəlif sahələrdə sınaqdan keçirilməli institusional-texniki dizayn təklifidir. Xüsusilə \(L\)-nin ümumi birləşdirmə qaydası, Rule-Judgment AI-ın real tətbiqi, beynəlxalq qarşılıqlı işləyə bilmə, audit qurumlarının müstəqilliyi, safe-harbor mexanizmləri və kompensasiya modelinin təfərrüatları hələ də açıq tədqiqat və siyasət dizaynı sahələridir.
Texniki cəhətdən yaxşı sistem niyə təkbaşına ictimai etimad yaratmaya bilər?
Məqalə çıxış nöqtəsini COVID-19 dövründəki rəqəmsal təmas izləmə tətbiqlərindən götürür. Texniki baxımdan məxfiliyi qoruyan sistemlər hazırlanmış olsa belə, tətbiqin sosial funksiyası istifadəçilərin tətbiqi quraşdırmasına, istifadə etməsinə, müsbət hal məlumatını qeyd etməsinə və daxil olan xəbərdarlıqlara əsasən davranışını dəyişdirməsinə bağlı idi. İnsanlar sistemə etibar etmədikdə texniki ölçmə infrastrukturu özü işləsə belə sosial ölçmə zəncirinin ilk halqası çatışmaya bilər.
Fiziki ölçmədə temperatur, kütlə və ya elektrik cərəyanı ölçülməyə etiraz etmir. Sosial ölçmədə isə ölçülən obyekt insan davranışıdır. İnsanlar məlumat toplanmasına icazə verə, imtina edə, sistemdən yayına və ya sistemin verdiyi qərara etiraz edə bilərlər. Buna görə sosial ölçmə yalnız sensor və alqoritm məsələsi deyil; məxfilik, razılıq, legitimlik, hesabatlılıq və institusional etimad da sistemin işləməsinin şərtlərinə çevrilir.
Genişləndirilmiş Kelvin Prinsipi Nədir?
Genişləndirilmiş Kelvin Prinsipi klassik Kelvin yanaşmasındakı “ölçmə olmadan anlama, anlama olmadan nəzarət olmaz” məntiqini sosial ölçmə və süni intellekt idarəetməsi üçün genişləndirən konseptual zəncirdir. Məqalənin təklif etdiyi genişləndirilmiş quruluş etimad infrastrukturu → sosial etimad → legitim sosial ölçmə → sosial anlama → sosial nəzarət şəklində irəliləyir.
Mənbənin qurduğu zəncirin mahiyyəti aşağıdakı məntiqdədir:
Etimad infrastrukturu yoxdursa sosial etimad qurula bilməz → sosial etimad yoxdursa legitim sosial ölçmə qurula bilməz → sosial ölçmə yoxdursa sosial anlama qurula bilməz → sosial anlama yoxdursa sosial nəzarət qurula bilməz.
Burada “nəzarət” ifadəsi özbaşına sosial nəzarət mənasında işlədilmir; Kelvin zəncirində ölçmədən biliyə və bilikdən müdaxilə/qərar vermə qabiliyyətinə keçidin sosial ölçmə kontekstindəki qarşılığıdır. Məqalənin özü bu zənciri xüsusilə demokratik cəmiyyətlərdə legitim, razılığa və davamlı əməkdaşlığa əsaslanan sosial ölçmə ilə məhdudlaşdırır.
Legitim sosial ölçmə niyə ayrıca fərqləndirilir?
Müəllif insanlardan məlumat toplamağın etimad olmadan texniki baxımdan mümkün olmadığını demir. Məcburetmə, gizli məlumat toplama və ya həddindən artıq nəzarət şəraitində sosial məlumat toplana bilər. Lakin məqalənin müzakirə etdiyi quruluş bu deyil. Çərçivə demokratik cəmiyyətdə vətəndaş əməkdaşlığı və razılığına əsaslanan, uzunmüddətli davamlı və legitim sosial ölçmə ilə maraqlanır.
Buna görə Genişləndirilmiş Kelvin Prinsipi “etimad olmadan heç bir məlumat əldə edilə bilməz” kimi oxunmamalıdır. İddia daha məhduddur: insanların ölçülməyə və AI tərəfindən qiymətləndirilməyə dair legitim qəbulunun tələb olunduğu sosial infrastrukturlarda etimad ölçmə sisteminin institusional şərtlərindən biridir.
Etimad ilə Etibarlılıq Arasındakı Fərq Nədir?
Məqalə etimadı iki səviyyəyə ayırır. Birinci səviyyə trustworthiness — etibarlılıq, yəni AI çıxışlarının həqiqətən qaydalara uyğun olmasının obyektiv və yoxlanıla bilən olmasıdır. İkinci səviyyə isə trust — etimad, insanların bu yoxlanıla bilən şərtin işlədiyini görərək AI tərəfindən tanınan və ya qiymətləndirilən subyekt olmağı qəbul etməsidir.
Birinci səviyyə sosial bəyanatlarla deyil; yoxlanıla bilmə, qeyd, dəyişdirilməyə müqavimət, müstəqil audit edilə bilmə və yanlış bəyanın dəyərini artıran sanksiya mexanizmləri ilə qurulmağa çalışılır. İkinci səviyyədə isə insanların bu infrastrukturun həqiqətən işlədiyinə dair təcrübə və bilik əsasında formalaşdırdığı qəbul yerləşir.
Məqalə ikinci səviyyədə də mühüm fərq qoyur. İnsanlar sistemi həqiqətən yoxlanıla bilən hesab etdikləri üçün qəbul edə bilərlər; lakin yalnız etiraz etməkdən vaz keçdikləri üçün də sistemə alışa bilərlər. Müəllif demokratik legitimlik baxımından üstün tutulan formanı “təcrübə ilə dəstəklənən şüurlu qəbul” kimi müəyyən edir.
Cəmiyyətin etimad infrastrukturunu dəyişə bilməsi
Etimad modeli birtərəfli deyil. Vətəndaş nəzarəti, ictimai müzakirə və demokratik proseslərdə ortaya çıxan etirazlar tətbiq ediləcək Rules məzmununu və beləliklə birinci səviyyədəki yoxlama meyarlarını dəyişə bilər. Beləliklə etimad infrastrukturu sabit texniki qurğu əvəzinə cəmiyyətin geribildirimi ilə qaydalarını yeniləyə bilən institusional dövr kimi nəzərdən keçirilir.
Giriş, modeldaxili və çıxış idarəetməsi
Tədqiqat mövcud AI idarəetməsi yanaşmalarını üç geniş qrupda müzakirə edir.
- Giriş tənzimlənməsi: şəxsi məlumatların necə toplandığı, saxlandığı və istifadə edildiyi.
- Daxili strukturun tənzimlənməsi: model şəffaflığı, izah edilə bilən AI, alqoritmik audit, model cards və datasheets.
- Çıxış tənzimlənməsi: məzmun filtrləri, təhlükəsizlik yoxlamaları və zərərli çıxışın məhdudlaşdırılması.
Məqalənin iddiasına görə bu səviyyələrin heç biri lazımsız deyil; lakin çıxış xüsusi olaraq “hansı qaydaya əsasən icazə verildi, hansı yoxlama aparıldı, hansı qeyd yaradıldı və daha sonra bunu kim audit edə bilər?” suallarını təkbaşına yetərincə həll etmir.
AI-ın cəmiyyətə birbaşa toxunan tərəfi əksər hallarda model çəkiləri deyil, yaranan mətn, görüntü, tövsiyə, xəbərdarlıq, qərar dəstəyi və ya təsnifatdır. Buna görə tədqiqat çıxış səviyyəsində ayrıca idarəetmə infrastrukturu təklif edir.
GLO Nədir və Nəyi İzah Etməyi Hədəfləyir?
GLO — Guide to the Expression of Legitimacy of Output — AI çıxışının məqsədinin və məzmununun əvvəlcədən müəyyən edilmiş qaydalara nə dərəcədə uyğun olduğunu strukturlaşdırılmış metadata vasitəsilə ifadə etməyi hədəfləyən ortaq dildir. GLO modelin daxili çəkilərini və ya tam inferensiya yolunu açıqlamağa çalışmır; çıxış namizədinin özünü “iddia” kimi qəbul edir və bu iddianın qaydalara uyğunluğunun faktlarla əsaslandırılmasını tələb edir.
Bu baxımdan GLO-nun mənbədəki rolu ölçmə elmindəki GUM-un birbaşa AI ekvivalenti olmaq deyil. Müəllif onların arasında struktur analogiya qurur: GUM ölçmə qeyri-müəyyənliyinin ortaq ifadə dilini təmin edərkən GLO AI çıxışı legitimliyinin ortaq ifadə dili olmağı hədəfləyir.
GLO metadata sahələri
| Sahə | Funksiya |
|---|---|
| Output ID | Hər çıxış namizədinə unikal kimlik verir. |
| Timestamp | Çıxışın yaradılma vaxtını qeyd edir. |
| Operator ID | AI sistemini işlədən tərəfi və məsuliyyət əlaqəsini müəyyən edir. |
| Receiver ID / Category | Çıxışın kimə və ya hansı alıcı sinfinə göndəriləcəyini göstərir. |
| Output Type | Çıxışı əvvəlcədən müəyyən edilmiş ontology/təsnifata bağlayır. |
| Risk Classification | Çıxışın müəyyən edilmiş risk sinfini göstərir. |
| Applicable Rules Reference | Hansı qaydaların tətbiq olunduğunu göstərir. |
| Legitimacy Confidence L | Məqsəd və məzmunun Rules-a uyğunluq dərəcəsinin törəmə dəyəridir. |
| Legitimacy Budget | L-nin hansı faktlara, mənbələrə və birləşdirmə üsuluna əsaslandığını göstərir. |
| Output Hash | Deklarasiyanın sonradan real çıxışla uyğunlaşdırılmasını təmin edir. |
| Domain-Specific Fields | Sahəyə məxsus əlavə təhlükəsizlik və idarəetmə məlumatlarını daşıyır. |
Legitimlik Etimadı L Nəyi İfadə Edir?
Legitimlik etimadı \(L\), məqalədə bir çıxış namizədinin məqsədinin və məzmununun müəyyən edilmiş Rules-a uyğunluğuna dair törəmə dəyər kimi \(0\) ilə \(1\) arasında müəyyən edilir. Əsas formullaşdırmada məqsəd legitimliyi ilə, həmin məqsəd verildikdə məzmun legitimliyinin hasili istifadə olunur:
\[ L=L_{\mathrm{purpose}}\times L_{\mathrm{content}} \]
Burada:
- \(L_{\mathrm{purpose}}\): çıxışın məqsədinin qaydalara uyğunluğunun etimad səviyyəsi,
- \(L_{\mathrm{content}}\): bəyan edilmiş məqsəd nəzərə alındıqda məzmunun qaydalara uyğunluğunun etimad səviyyəsidir.
Hasil formasının iki mühüm nəticəsi var. Birincisi, məqsəd və ya məzmundan biri sıfıra düşərsə ümumi \(L\) də sıfıra enir. İkincisi, hər iki komponent ehtimallı uyğunluq kimi şərh edildikdə hasil məqsəd və məzmunun birlikdə uyğun olma ehtimalına bənzər struktur təqdim edir.
Lakin məqalə hasil qaydasını universal və dəyişdirilməz standart elan etmir. \(L\)-nin tək dəyər kimi, yoxsa iki ayrı komponent şəklində yayımlanacağı və daha mürəkkəb arqumentlərdə birləşdirmə qaydasının necə olacağı Rules çərçivəsində müəyyən edilməli dizayn problemləridir.
Legitimlik Büdcəsi Niyə L Dəyərindən Daha Artığını Tələb Edir?
Legitimlik büdcəsi \(L\)-nin təkbaşına dövriyyəyə buraxılmasının qarşısını almaq və dəyərlə birlikdə onu yaradan faktları, hər faktın əsaslandığı ilkin mənbəni, faktın etibarlılığını və birləşdirmə üsulunu izlənə bilən etmək üçün təklif olunan strukturlaşdırılmış əsaslandırma səviyyəsidir.
Məqalə burada ölçmə elmindəki qeyri-müəyyənlik büdcəsi ilə struktur oxşarlıq qurur. Ölçmə dəyərinin yanında qeyri-müəyyənlik, qeyri-müəyyənliyin yanında isə onu yaradan komponentlərin büdcəsi ola bildiyi kimi; AI çıxışının yanında \(L\), \(L\)-nin yanında da legitimlik büdcəsi yerləşir.
Buna görə \(L\), modelin və ya operatorun “0,94 etibarlı” kimi izahsız bal verməsi demək deyil. Dəyərin hansı faktlardan necə törədildiyinin yenidən hesablana bilməsi lazımdır.
Məqalənin xüsusilə vurğuladığı məqamlardan biri legitimlik büdcəsinin hamı üçün açıq olmasının vacib olmadığıdır. Büdcə məxfilik baxımından həssas məlumatlar ehtiva edə bilər. Axtarılan xüsusiyyət “ümumi açıqlama” deyil, səlahiyyətli audit kanalı tərəfindən əlçatan və yoxlanıla bilən olmaqdır.
VRAIO Nədir və GLO ilə Necə Birlikdə İşləyir?
VRAIO — Verifiable Record of AI Output — GLO metadata bəyanını institusional baxımdan yoxlanıla bilən, qeydə alına bilən və audit edilə bilən hala gətirməyi hədəfləyən çıxış idarəetmə infrastrukturudur. GLO “legitimlik hansı dil və formatla bəyan ediləcək?” sualına fokuslanarkən VRAIO “bu bəyanın həqiqətən edildiyini, qaydalarla müqayisə olunduğunu və sonradan audit edilə biləcəyini hansı infrastruktur təmin edəcək?” sualına cavab verməyi hədəfləyir.
VRAIO-nun əsas komponentləri
- Rules: tətbiq edilə bilən məqsədləri, hədəfləri, şərtləri və qadağaları müəyyən edir.
- AI sistemi: çıxış namizədi ilə birlikdə GLO metadata bəyanı yaradır.
- Outbound Firewall: namizəd çıxışın birbaşa xaricə çıxmasının qarşısını alan çıxış qatıdır.
- Recorder: GLO metadata ilə qaydalar arasındakı formal uyğunluğu yoxlayan müstəqil üçüncü tərəf roludur.
- Valve: uyğunluq şərti təmin edildikdə çıxışın xaricə çıxmasına icazə verən qapıdır.
- Tamper-resistant ledger: çıxış kimliyi, metadata, tətbiq olunan qaydalar, qərar, timestamp və output hash kimi məlumatları sonradan dəyişdirilməyə qarşı davamlı şəkildə qeyd edir.
- Audit body / vətəndaş nəzarəti: qeydlərdən və spot auditlərdən istifadə edərək sistemin bəyanatları üzərində müstəqil nəzarət təmin edir.
VRAIO əməliyyat axını
- Qaydalar sosial, hüquqi və demokratik prosedurlar vasitəsilə müəyyən edilir.
- AI sistemi çıxış namizədi və ona bağlı GLO metadata yaradır.
- Recorder bəyanı Rules ilə müqayisə edir; qərar və metadata qeyd infrastrukturuna işlənir.
- Şərtlər təmin olunursa Valve açılır və çıxış alıcıya göndərilir.
- Vətəndaşlar və ya səlahiyyətli audit orqanları sonradan qeydləri araşdıra və spot auditlər apara bilər.
- Audit nəticələri lazım gəldikdə Rules-un yenilənməsinə geribildirim kimi ötürülür.
Niyə hər çıxış davamlı məzmun auditinə məruz qalmır?
VRAIO-nun əsas dizaynı hər çıxışın bütün məzmununu real vaxtda insan auditoruna oxutmaq deyil. Çərçivənin çəkindirici təsiri qeyd, hash, yenidən hesablama, təsadüfi/spot audit və yanlış bəyan aşkarlandıqda ciddi sanksiya ehtimalının birlikdə işləməsinə əsaslanır.
Müəllifin arqumentinə görə məqsəd yanlış deklarasiyanı iqtisadi və institusional baxımdan rasional davranış olmaqdan çıxarmaqdır. Buna görə Valve-ın real vaxtda bloklaması sistemin yeganə təminat nöqtəsi deyil.
Rule-Judgment AI Nədir?
Rule-Judgment AI çıxış namizədini və GLO çərçivəsində bildirilən fakt/arqumentləri qəbul edib onları əvvəlcədən müəyyən edilmiş Rules-a görə qiymətləndirən, eyni girişə eyni nəticəni verməsi nəzərdə tutulan müstəqil və deterministik yoxlayıcı komponentdir. Məqalədə bu komponentin “sealed” olması, yəni lazımi məlumatı oxuya bilməsinə baxmayaraq xaricə yalnız \(L\) və uyğunluq nəticəsi kimi məhdud qərar çıxarması nəzərdə tutulur.
Sealed yoxlama niyə istifadə olunur?
Legitimlik büdcəsi tibbi qeyd, axtarış səlahiyyəti, şəxsi görüntü və ya başqa həssas məlumatları ehtiva edə bilər. Əgər audit edilə bilmə bütün bu məlumatların ictimaiyyətə açılmasını tələb edərsə məxfiliklə ciddi ziddiyyət yaranar.
Məqalənin təklif etdiyi asimmetriya belədir: yoxlayıcı ehtiyac olduğu qədər məlumat oxuya bilər; lakin xaricə yalnız minimum qərar məlumatını çıxarır. Müəllif bu yanaşmanı sıfır bilik sübutları, təhlükəsiz hesablama və trusted execution environment kimi məxfiliyi artıran texnologiya sinifləri ilə struktur baxımdan əlaqələndirir.
Hesablama Yanlışlığı ilə Faktual Yanlışlıq Necə Fərqləndirilir?
Tədqiqat yanlış bəyanı iki fərqli səviyyədə nəzərdən keçirir. Hesablama yanlışlığı, verilmiş faktlar aşağı \(L\) tələb etdiyi halda AI sisteminin yüksək \(L\) bildirməsidir. Deterministik Rule-Judgment AI eyni faktlarla \(L\)-ni yenidən hesablaya bildiyi üçün belə uyğunsuzluq birbaşa aşkar edilə bilər. Faktual yanlışlıq isə hesablamaya daxil olan faktın özünün doğru olmamasıdır; məsələn, əslində mövcud olmayan məhkəmə qərarının “mövcud” kimi bildirilməsi. Bu ikinci yanlışlıq xarici səlahiyyətli qeydlərlə çarpaz yoxlama tələb edir.
Beləliklə Rule-Judgment AI-ın məsuliyyəti “verilən faktlardan \(L\) düzgün hesablandımı?” sualı ilə məhdudlaşdırılır. “Faktlar həqiqətən doğrudurmu?” sualının cavabı isə məhkəmə, səhiyyə qurumu və ya başqa ilkin qeyd sahibinin səlahiyyətli qeydlərindən yoxlanılır.
Deterministik olması niyə vacibdir?
Eyni giriş müxtəlif vaxtlarda fərqli nəticə verərsə keçmiş bəyanın həqiqətən düzgün hesablanıb-hesablanmadığını dəqiq şəkildə yenidən yoxlamaq çətinləşir. Deterministik dizaynda eyni məlumat və eyni Rules eyni \(L\)-ni yaratmalıdır. Bu xüsusiyyət məqalənin ölçmə elmində dəyişməz istinad standartı ilə qurduğu analogiyanın mərkəzindədir.
LLM-in rolu niyə məhdudlaşdırılır?
Məqalədəki Rule-Judgment AI dizaynında LLM tipli komponentin vəzifəsi yekun legitimlik qərarı vermək deyil. LLM təbii dildəki fakt və arqumentləri Rules-un müəyyən etdiyi strukturlaşdırılmış parametr məkanına çevirmək üçün istifadə oluna bilər. Yekun uyğunluq qərarı isə bu strukturlaşdırılmış parametrlərin qaydalarla mexaniki müqayisəsinə əsaslanmalıdır.
Agreement gate nəyi təmin edir?
AI sisteminin bildirdiyi \(L\) ilə Rule-Judgment AI-ın hesabladığı \(L\) əhəmiyyətli dərəcədə üst-üstə düşürsə çıxış sərbəst buraxıla bilər. Lakin məqalə bunun “həqiqət zəmanəti” olmadığını açıq şəkildə qəbul edir. AI sistemi ilə yoxlayıcı eyni qərəzi və ya eyni səhv fərziyyəni paylaşa və yenə də bir-biri ilə razılaşa bilər. Buna görə agreement gate ilkin filtr xarakteri daşıyır; xarici qeyd yoxlamasının və spot auditin yerini tutmur.
Tədqiqatın Metodu və Nəticələri
Tədqiqatın metodoloji xarakteri
Bu tədqiqat klassik mənada təlim/test məlumat dəstlərində AI modelini sınaqdan keçirib dəqiqlik metrikası hesabatlayan empirik məqalə deyil. Metod; ədəbiyyatdakı etimad, sosial ölçmə, AI idarəetməsi, alqoritmik hesabatlılıq və ölçmə elmi anlayışları üzərindən institusional problem müəyyən etmək, Kelvin prinsipini sosial ölçməyə genişləndirmək və sonra GLO/VRAIO arxitekturasını bu problem üçün həll istiqaməti kimi formullaşdırmaq üzərində qurulub.
Buna görə “nəticə” sözü burada eksperimental performans nəticəsi demək deyil. Tədqiqatın nəticəsi müəllifin qurduğu konseptual zəncir və ondan törətdiyi institusional arxitekturadır.
Kelvin prinsipi ilə AI idarəetməsi arasındakı nəzəri keçid
Mənbə əvvəlcə fiziki ölçmədə ölçmə, anlama və nəzarət arasındakı əlaqəni nəzərdən keçirir. Daha sonra insanın ölçülməyə qarşı mövqe formalaşdıra bildiyi sosial ölçmə sahəsində razılıq və etimadın bu zəncirin ilkin şərti olduğunu müdafiə edir.
Buradan iki genişləndirmə çıxır:
- Legitim sosial ölçmə sosial etimad tələb edir.
- Sosial etimad etimad infrastrukturu tələb edir.
Son zəncir:
Trust Infrastructure → Social Trust → Legitimate Social Measurement → Social Understanding → Social Control
şəklində qurulur.
GUM ilə GLO arasındakı struktur analogiya
| Ölçmə elmi | AI çıxış idarəetməsi |
|---|---|
| Ölçmə qeyri-müəyyənliyinin ifadəsi | AI çıxışının legitimliyinin ifadəsi |
| GUM | GLO |
| Kalibrləmə infrastrukturu, milli metrologiya qurumları | VRAIO, Recorder, audit bodies, tamper-resistant ledger |
| Ölçmə dəyərlərinə sosial etimad | AI çıxışlarına sosial etimad |
| Beynəlxalq metrologiya sistemi | AI çıxış idarəetməsində beynəlxalq qarşılıqlı işləyə bilmə hədəfi |
Bu cədvəl fiziki ölçmə qeyri-müəyyənliyi ilə AI legitimliyini eyni şey elan etmir. Müəllif açıq şəkildə iki sahənin normativ strukturlarının fərqli olduğunu bildirir. Oxşarlıq ortaq ifadə dili ilə onu dəstəkləyən institusional yoxlama infrastrukturu arasındakı əlaqədədir.
L-nin üçsəviyyəli informasiya strukturu
Tədqiqatın GUM analogiyası individual-output səviyyəsində üç qat üzrə genişləndirilir:
- Çıxış namizədi
- Legitimlik etimadı \(L\)
- Legitimlik büdcəsi
Beləliklə \(L\) ilkin məlumat və ya AI çıxışının özü deyil. Çıxışa dair ikinci dərəcəli uyğunluq kəmiyyətidir. Legitimlik büdcəsi isə bu kəmiyyətin hansı faktlara və birləşdirmə məntiqinə əsaslandığını açıqlayan üçüncü dərəcəli məlumatdır.
Daha mürəkkəb çıxışlarda L
Sadə halda:
\[ L=L_{\mathrm{purpose}}\times L_{\mathrm{content}} \]
istifadə olunur. Lakin məsələn, çoxlu faktın iyerarxik şəkildə siyasət tövsiyəsini dəstəklədiyi daha mürəkkəb hallarda məqalə arqument qrafından bəhs edir. Belə qrafın yarpaqlarında faktlar, kökündə isə nəticə yerləşə bilər.
Bu halda fakt etibarlılıqlarının son \(L\)-yə necə daşınacağı — variasiya yayılmasına bənzər birləşdirməmi, yoxsa ən zəif arqumentin dominant olduğu başqa qaydamı — bu məqalədə ümumi şəkildə həll edilmir. Müəllif bunu gələcək tədqiqat mövzularından biri kimi saxlayır.
Tətbiq nümunəsi: tam izlənən ictimai məkanda itkin uşağın axtarışı
Məqalə təklif olunan çərçivəni daha konkret göstərmək üçün FMPS — Fully Monitored Public Space — ssenarisindən istifadə edir. Çoxsaylı kameraların mərkəzi AI sisteminə qoşulduğu ictimai məkanda itkin uşağın tapılması nümunəsi araşdırılır.
Bu nümunə xüsusilə uyğundur, çünki iki dəyər eyni vaxtda yüksəkdir:
- uşağın həyatı və təhlükəsizliyi səbəbilə axtarış sosial baxımdan yüksək əhəmiyyət daşıyır;
- kamera görüntüləri və insanların hərəkət marşrutları səbəbilə məxfilik riski də yüksəkdir.
Məqsəd legitimliyi
İtkin uşaq axtarışının məqsədi, məsələn, qüvvədə olan axtarış icazəsi, valideyn müraciəti və ya təsdiqlənmiş hüquq-mühafizə tələbi kimi faktlarla dəstəklənə bilər. Bu faktlar səlahiyyətli ilkin qeydlərdə yoxlana bilirsə \(L_{\mathrm{purpose}}\) yüksək ola bilər.
Heç bir səlahiyyətli tələb və ya hüquqi əsas yoxdursa məqsəd legitimliyinin əsaslandırılması zəifləyir.
Məzmun legitimliyi
Axtarışın məqsədi legitim olsa belə sistemin əldə etdiyi və ya xaricə çıxardığı məlumatın əhatəsi limitsiz deyil. Uşağın cari yerinə çatmaq üçün zəruri hərəkət izi ilə ərazidə təsadüfən olan bütün şəxslərin uzunmüddətli hərəkət tarixçəsinin çıxarılması eyni şey deyil.
Məqalənin yanaşmasına görə məzmun əhatəsi bəyan edilmiş məqsədi aşmağa başladıqca \(L_{\mathrm{content}}\) azalmalıdır. Beləliklə məlumat minimallaşdırılması və proporsionallıq abstrakt prinsip olmaq əvəzinə \(L\)-nin məzmun komponentinə bağlanan idarəetmə meyarına çevrilir.
Məxfiliyin və audit edilə bilmənin eyni anda qorunması
İtkin uşaq ssenarisində legitimlik büdcəsinin özü də həssasdır: uşağın hərəkət izi, axtarış əhatəsi və səlahiyyət məlumatları daxil ola bilər.
Müəllifin həll istiqaməti “hər şeyi açıqlamaq” deyil. Büdcənin audit üçün əlçatan, lakin ictimaiyyətə açıq olmayan formada qorunması və sealed Rule-Judgment AI-ın həssas məzmunu xaricə sızdırmadan yalnız \(L\) ilə uyğunluq nəticəsini qaytarması təklif edilir.
Bu ssenaridə yanlışlığın aşkarlanması
Əgər sistem verilmiş faktlara görə aşağı olmalı olan \(L_{\mathrm{content}}\)-i yüksək bildirirsə deterministik yenidən hesablama bunu aşkar edə bilər.
Əgər sistem əslində mövcud olmayan axtarış əmrini “var” kimi bildirirsə yenidən hesablama təkbaşına yetərli deyil; bildirilən səlahiyyətin həqiqətən olub-olmaması məhkəmə və ya səlahiyyətli orqan qeydləri ilə çarpaz yoxlanmalıdır.
Bu nümunə niyə eyni zamanda VRAIO-nun sərhədini göstərir?
İtkin uşaq ssenarisindəki mühüm faktların çoxu xarici səlahiyyətli qeydlərdən yoxlana bilir. Buna görə VRAIO-nun yanlış bəyanı aşkarlama məntiqi burada nisbətən güclüdür.
Əksinə, tamamilə subyektiv dəyər mühakimələrində xarici aləmdə yoxlana bilən səlahiyyətli qeyd olmaya bilər. Məqalə bunu çərçivənin mühüm tətbiqolunma məhdudiyyətlərindən biri kimi qəbul edir.
Təşviq və məsuliyyət modeli
Tədqiqat yalnız texniki yoxlamanı deyil, operator təşviqlərini də müzakirə edir. Təklif olunan məntiqdə qaydalara uyğun və həqiqətə uyğun bəyan edən operator üçün tənzimləyici/cəza məsuliyyəti baxımından proqnozlaşdırıla bilən safe-harbor yanaşması düşünülə bilər. Əksinə, yanlış bəyan aşkar edilərsə ciddi sanksiya tətbiqi nəzərdə tutulur.
Məqalə zərərçəkən tərəfin kompensasiyası ilə operatorun cinayət/tənzimləyici məsuliyyətini bir-birindən ayırır. Operator dürüst bəyan səbəbilə tənzimləyici qoruma alsa belə real zərər yaranıbsa zərərçəkənin kompensasiyası aradan qalxmır. Bu məqsədlə operator töhfələri ilə maliyyələşdirilən kompensasiya fondu kimi institusional modellər müzakirə olunur.
Bunlar qüvvədə olan universal hüquq qaydaları kimi təqdim edilmir. Müəllif exact safe-harbor əhatəsi, fond strukturu və təqsirsiz yanılmanın necə qiymətləndiriləcəyi kimi hüquqi təfərrüatları gələcək dizayn işlərinə açıq şəkildə saxlayır.
Tədqiqatın dəstəklədiyi əsas konseptual nəticələr
- AI-a yönəlmiş ictimai etimad yalnız texniki keyfiyyət və ya etik deklarasiya ilə izah edilə bilməyəcək institusional ölçüyə malikdir.
- Çıxış idarəetməsi AI sistemlərinin cəmiyyətlə birbaşa təmas etdiyi son qatı ayrıca nəzərdən keçirməlidir.
- Çıxış namizədinin məqsəd və məzmun legitimliyi strukturlaşdırılmış metadata ilə ifadə edilə bilər.
- Bu ifadə audit edilə bilən legitimlik büdcəsi ilə dəstəklənməlidir.
- Deterministik yenidən hesablama hesablama yanlışlığının aşkarlanmasını gücləndirə bilər.
- Faktual yanlışlıq xarici səlahiyyətli qeydlərlə çarpaz yoxlama tələb edir.
- Qeyd, spot audit və sanksiya strukturu yanlış deklarasiyanın təşviqlərini dəyişə bilər.
Tədqiqatın dəstəkləmədiyi və ya hələ göstərmədiyi iddialar
- VRAIO-nun real dünyada geniş miqyasda işlədiyi eksperimental olaraq göstərilməyib.
- GLO beynəlxalq səviyyədə qəbul edilmiş mövcud standart deyil; məqalənin təklif etdiyi ortaq dil yanaşmasıdır.
- \(L\) üçün universal və elmi olaraq təsdiqlənmiş vahid birləşdirmə qaydası təqdim edilmir.
- Rule-Judgment AI-ın istehsal mühitində təhlükəsizliyi, xərci və performansı eksperimental olaraq təsdiqlənməyib.
- Agreement gate doğruluq və ya həqiqət zəmanəti deyil.
- Eyni qərəzi paylaşan prover və verifier birlikdə səhv ola bilər.
- Xarici mənbədən yoxlana bilən faktı olmayan subyektiv sahələrdə faktual yanlışlığın aşkarlanması daha çətindir.
- Beynəlxalq qarşılıqlı işləyə bilmə həll olunmayıb.
- Audit orqanlarının müstəqilliyinin necə təmin ediləcəyi açıq tətbiq problemidir.
- Safe-harbor, kompensasiya fondu və təqsirsiz yanılma proseslərinin ətraflı hüquqi dizaynı tamamlanmayıb.
Tədqiqatın elmi və institusional mənası
Məqalənin mərkəzi töhfəsi “AI-ın özünə etibar edək” düşüncəsindən “AI çıxışlarının idarəetmə prosesini sonradan sınaqdan keçirə bilən infrastruktur quraq” düşüncəsinə keçidi təklif etməsidir. Bu yanaşmada etimad başlanğıc fərziyyəsi deyil, yoxlanıla bilən etibarlılığın zamanla sosial qəbul yaratmasının mümkün nəticəsi kimi nəzərdən keçirilir.
Lakin bu çərçivənin tətbiq oluna bilməsi böyük ölçüdə Rules-un kim tərəfindən və hansı proseslərlə müəyyən ediləcəyinə, Rule-Judgment AI-ın həqiqətən deterministik və müstəqil saxlanıla biləcəyinə, xarici ilkin qeydlərin düzgünlüyünə, audit qurumlarının müstəqilliyinə və beynəlxalq sistemlər arasında ortaq standartların qurulub-qurula bilməyəcəyinə bağlıdır.
Mənbə və Metod Qeydi
Orijinal başlıq: No Trust Without Trust Infrastructure: The Extended Kelvin Principle and Its Application to AI Output Governance
Müəllif: Yusaku Fujii
Qurum: School of Science and Technology, Gunma University, Kiryu 376-8515, Japan.
Jurnal: AI, 2026, 7(6), 218.
DOI: 10.3390/ai7060218
Nəşriyyat: MDPI.
Nəşr tarixi: 14 iyun 2026.
Mənbə növü: Resenziyalı tədqiqat məqaləsi; konseptual və institusional AI idarəetmə çərçivəsi.
Lisenziya: Creative Commons Attribution (CC BY).
Maliyyələşmə: Japan Society for the Promotion of Science, Grants-in-Aid for Scientific Research (JSPS KAKENHI), Grant No. 25K00735.
Etik komitə: Tətbiq edilə bilməz kimi bildirilib.
Məlumatlandırılmış razılıq: Tətbiq edilə bilməz kimi bildirilib.
Məlumatların əlçatanlığı: Tədqiqatın orijinal töhfələrinin məqalənin içində olduğu, əlavə məlumat üçün müəlliflə əlaqə saxlamağın mümkün olduğu bildirilir.
Maraqlar toqquşması: Müəllif maraqlar toqquşması olmadığını bildirib.
Əsas metodoloji məhdudiyyət: Tədqiqat VRAIO/GLO-nun empirik miqyas testini həyata keçirmir. \(L\)-nin ümumi birləşdirmə üsulunun formullaşdırılması, deterministik yoxlayıcının real tətbiqi və qiymətləndirilməsi, safe-harbor ilə kompensasiya mexanizmlərinin hüquqi dizaynı, demokratik Rules istehsalı, beynəlxalq qarşılıqlı işləyə bilmə və audit orqanlarının müstəqilliyi sonrakı tədqiqat və institusional dizayn işlərinə saxlanılıb.
Şəkil istifadəsi: Mənbənin Şəkil 1 və Şəkil 2-si birbaşa kopyalanmamalıdır. Verianla üçün Genişləndirilmiş Kelvin zənciri ilə VRAIO arxitekturası eyni elmi münasibətləri qoruyan, lakin kompozisiyası, ikonoqrafiyası və vizual dili müstəqil iki yeni texniki sxem kimi hazırlana bilər.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib