

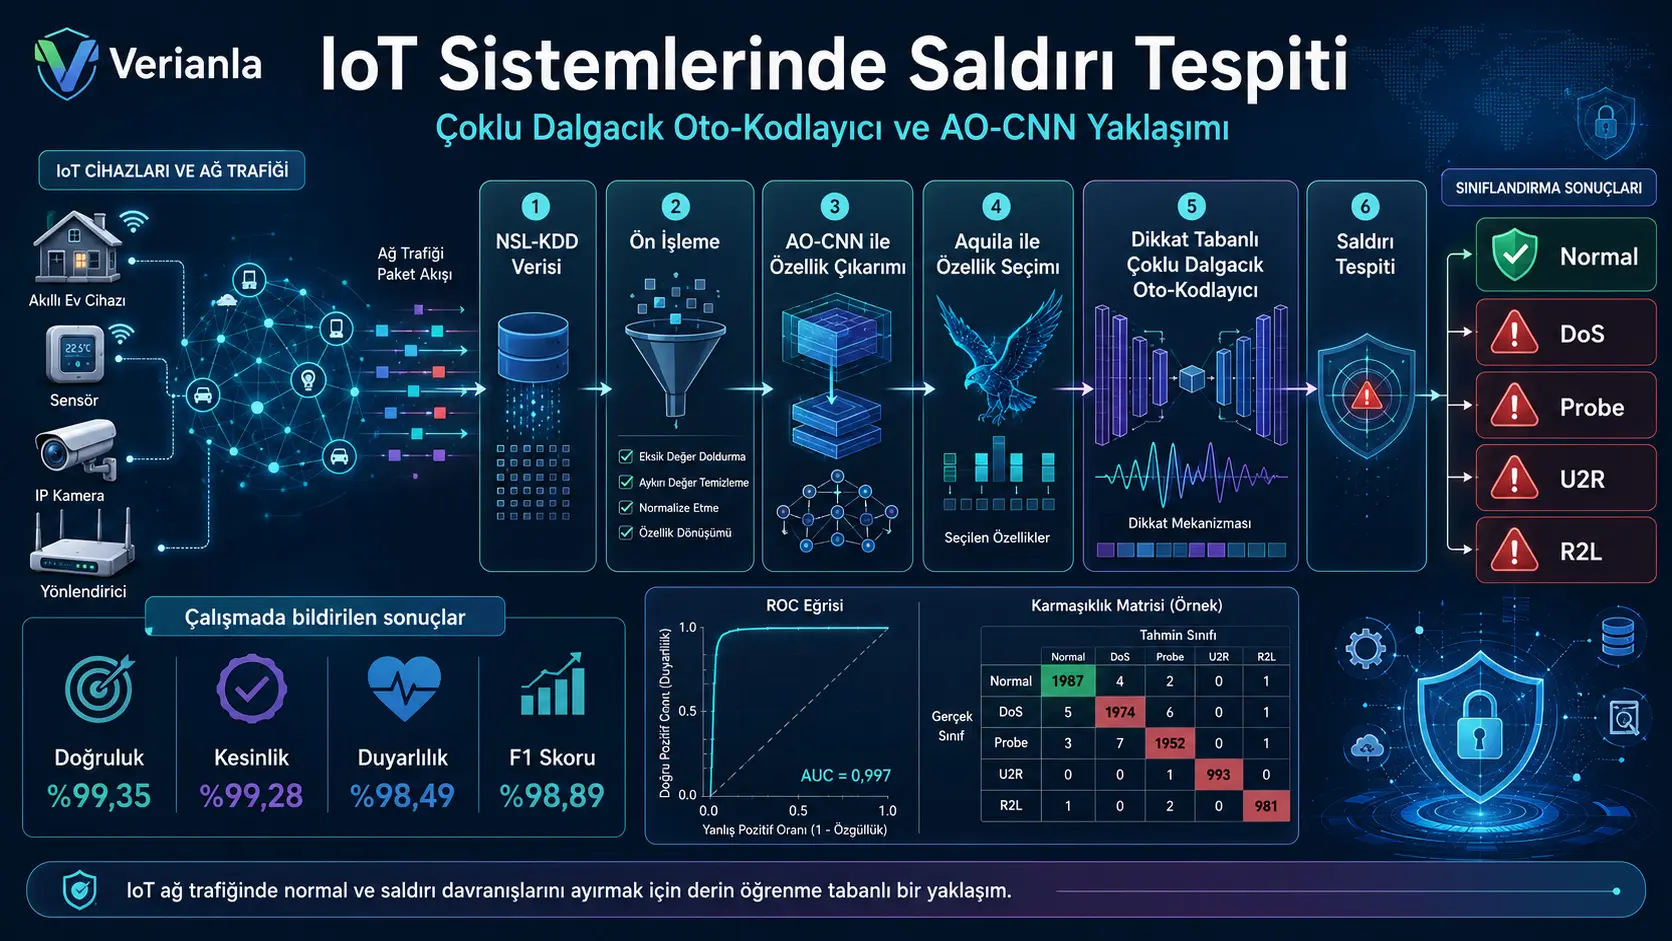
Bu tədqiqat, Əşyaların İnterneti şəbəkəlarındaki normal və hücum trafikini ayırmak üçün iki aşamalı bir derin öğrenme yaklaşımı önermektedir. İlk aşamada bir boyutlu konvolyusion neyron şəbəkəsi, şəbəkə trafikindeki özellikleri çıkarmakta; Aquila Optimizasiya Alqoritmi ise təsnifat açısından daha yararlı özellikleri seçmeyi amaçlamaktadır. İkinci aşamada diqqət mexanizmiyla desteklenen çoxlu dalğacıq yönelimli bir avto-kodlayıcı, normal trafik ilə xidmətdən imtina, skanlama və səlahiyyət artırma hücumlarını təsnifatktadır.
Tədqiqatçılar modeli NSL-KDD vəri dəsti üzərində değerlendirmiş və nəticə bölümünde yüzde 99,35 dəqiqlik, yüzde 99,28 dəqiqlik, yüzde 98,49 həssaslıq və yüzde 98,89 F1 skoru bildirmişdir. Modelin ayrıca karşılaştırılan bazı metodlerden daha kısa inferensiya müddəti, daha aşşəbəkəı CPU istifadəsi və sabit yaddaş sərfi gösterdiği iləri sürülmektedir.
Bununla birlikte tədqiqatnın rəqəmsal nəticələrı arasında mühüm uyumsuzluklar vardır. Sunulan ikili qarışıqlıq matrisindeki 10.000 örneğin 9.989’u doğru sınıflandırılmıştır; bu, doğrudan yüzde 99,89 doğruluğa karşılık gelmekte və bildirilən yüzde 99,35 değeriyle uyuşmamaktadır. Beş sınıflı matriste ise 10.000 örneğin 9.986’sı doğru sınıflandırılmıştır və doğrudan hesaplanan dəqiqlik yüzde 99,86’dır. En az örneğe sahip U2R sınıfında matris üzərində yalnızca üç gerçek örneğin ikisi doğru sınıflandırılmıştır; bu sınıf üçün matristen hesaplanan həssaslıq yüzde 66,67 olmasına rşəbəkəmen metinde yüzde 98,3 değeri vərilmektedir.
Bu nedenle tədqiqat, diqqət mexanizmi, CNN, meta-sezgisel xüsusiyyət seçimi və dalğacıq tabanlı avto-kodlayıcıların eyni mimaride birleştiriləbildiğini göstərir; ancak bildirilən performans değerleri, icra detalları və riyazi təriflər arasındaki tutarsızlıklar giderilmeden metodin gerçek IoT şəbəkələrində yüzde 99’un üzərində güvənilirlikle çalıştığı sonucuna varılamaz.
Tədqiqatın ele aldığı sorun nedir?
Əşyaların İnterneti sistemleri; sensorler, kameralar, akıllı ev cihazları, endüstriyel kontrol biləşenleri və haberleşme modulleri gibi çok sayıda bşəbəkəlı cihazdan oluşmaktadır. Bu cihazların şəbəkə üzərindən vəri göndermesi, saldırganların xidmətdən imtina, şəbəkə skanlama, icazəsiz giriş və imtiyaz artırma gibi hücumlar gerçekleştirebiləceği geniş bir səth oluşturur.
Geleneksel hücum aşkarlama sistemleri əvvəlden tanımlanmış kuralları və ya imzaları kullanabilir. Makine öğrenmesi tabanlı sistemler ise şəbəkə trafikindeki örüntülerden normal və anormal davranışları öğrenmeye çalışır. Ancak şəbəkə qeydləri yüksək boyutlu, gürültülü və sınıflar açısından dengesiz ola bilər. Özellikle nadir görülen hücumların çok az örnekle temsil edilmesi, yüksək genel doğruluğa rşəbəkəmen kritik hücumların gözden kaçmasına neden ola bilər.
Tədqiqatnın hedefi, şəbəkə vərisindeki yararlı özellikleri otomatik kimi çıkaran və seçen bir model ilə bu özellikleri fərqli ölçeklerde temsil eden bir avto-kodlayıcıyı birleştirmektir. Önerilən mimari iki əsas biləşenden oluşmaktadır:
- AO-CNN: Aquila Optimizasiya Alqoritmi ilə desteklenen konvolyusion neyron şəbəkəsi.
- AMV-AE: Dikkat tabanlı, çoxlu dalğacıq yönelimli avto-kodlayıcı.
Modelin genel işlem axını nasıldır?
Şekil 1’deki mimariye görə süreç şu sırayla ilərlemektedir:
- NSL-KDD vəri dəstinden şəbəkə trafiki kayıtları alınır.
- Eksik vərilər kontrol edilir və vərilər min–maks metodiyle normalize edilir.
- Bir boyutlu CNN kullanılarak xüsusiyyət xəritələri çıkarılır.
- Aquila Optimizasiya Alqoritmi en uygun olduğu kabul edilən özellikleri seçer.
- Seçilən özellikler dikkat tabanlı çoxlu dalğacıq avto-kodlayıcıya vərilir.
- Model trafik kaydını normal və ya hücum kimi sınıflandırır.
- Çok sınıflı qiymətləndirməde trafik Normal, DoS, Probe, U2R və R2L sınıflarından birine atanır.
Şekil 4’te daha ayrıntılı bir axın şeması sunulmuş; vəri temizleme, normalizasyon, CNN katmanları, ReLU, havuzlama, Aquila ilə xüsusiyyət seçimi, avto-kodlayıcı dönüşümü, dalğacıq miqyaslama funksiyaları, kayıp hesabı və performans qiymətləndirməsi birbirini izleyen adımlar kimi gösterilmiştir.
Verilər nasıl ön işlenmiştir?
Tədqiqatçılar, rəqəmsal alanlardaki əskik dəyərlerin medianla, kateqorik alanlardaki əskik dəyərlerin ise ən çox rastlanan dəyərle tamamlanabiləceğini belirtmektedir. Ardından vərilər min–maks normallaşdırmasıyla ortak bir aralığa dönüştürülmektedir.
Standart min–maks normallaşdırması şu biçimdedir:
\[ S_n = \frac{S-\min(S)}{\max(S)-\min(S)} \]
Burada S özgün değer, Sn normalize edilmiş değer, min(S) özelliğin en küçük və max(S) en büyük değeridir.
Makalede Denklem 1’in parantez istifadəsi açık deyil və ifade:
\[ S_n = S-\frac{\min(S)}{\max(S)}-\min(S) \]
şeklinde okunabiləcek biçimde dizilmiştir. Metindeki açıklama standart min–maks normallaşdırmasınu işaret etse de uygulamada hangi ifadenin kodlandığı gösterilmemiştir.
Konvolyusion neyron şəbəkəsi hangi görəvi üstlenmektedir?
AO-CNN biləşeni, ön işlenmiş şəbəkə qeydlərindaki yerel özellik ilişkilərini öğrenmek amacıyla bir boyutlu konvolyusiya katmanları kullanmaktadır. Bir konvolyusiya katmanındaki ara değer tədqiqatda şu genel yapıyla ifade edilmişdir:
\[ I_p = \sum_{k=1}^{M} O_k v_{kp} + bias_p \]
\[ U_p = fun(I_p) \]
Burada Ok əvvəlki katmandan gelen değerleri, vkp konvolyusiya çekirdeği şəbəkəırlıklarını, biasp yanlılık terimini və Up etkinleştirilmiş çıktıyı göstərir.
ReLU aktivləşdirməsi fonksiyonu:
\[ fun(I_p)=\max(0,I_p) \]
kimi vərilmiştir. Maksimum havuzlama katmanı ise belirli bir bölgedeki en büyük değeri seçerek xüsusiyyət xəritəsinın boyutunu azaltmaktadır:
\[ G_p=\max_{k\in\mathcal{R}} U_p \]
Modelin son aşamalarında ikili təsnifat üçün sigmoid, çoxsinifli təsnifat üçün softmax fonksiyonları açıklanmıştır:
\[ \sigma(I)=\frac{1}{1+e^{-I}} \]
\[ Softmax(I_k)=\frac{e^{I_k}}{\sum_{q=1}^{P}e^{I_q}} \]
Hiperparametre tablosunda sekiz konvolyusiya katmanı və altı havuzlama katmanı bulunduğu belirtilmektedir. Ancak filtre sayıları, çekirdek boyutları, adım değerleri, xüsusiyyət xəritələrinın boyutları və tam katman sıralaması vərilmemiştir. Bu nedenle mimarinin koddan bşəbəkəımsız biçimde yeniden oluşturulması mümkün deyil.
Aquila Optimizasiya Alqoritmi nasıl kullanılmaktadır?
Aquila Optimizasiya Alqoritmi, kartalın av arama və avına yaklaşma davranışlarından esinlenen meta-sezgisel bir optimizasyon metodidir. Tədqiqatda algoritma, CNN tarafından çıkarılan özelliklerin üçünden təsnifat açısından en uygun alt kümeyi seçmek üçün kullanılmaktadır.
Algoritma başlangıçta sınırlar üçünde təsadüfi bir aday popülasyon üretir:
\[ U_{pq}=j_1(UpB_q-LoB_q)+LoB_q \]
Burada LoB və UpB arama alanının alt və üst sınırlarını, j1 ise 0–1 aralığındaki təsadüfi bir değeri temsil eder.
Aquila metodi arama sırasında keşif və sömürü aşamaları arasında geçiş yapar. En iyi aday, ortalama aday, təsadüfi seçilən aday, Lévy uçuşu və spiral hareket terimleri kullanılarak yeni çözümler oluşturulur.
Ancak makale, Aquila algoritmasının hangi değişkenleri optimize ettiğini tam kimi açıklamamaktadır. Belirsiz kalan noktalar şunlardır:
- Aday çözümün bir ikili xüsusiyyət maskası mi yoksa sürekli şəbəkəırlık vəktörü mü olduğu.
- Uygunluk fonksiyonunda dəqiqlik, özellik sayısı və ya başka bir ölçütün kullanılıp kullanılmadığı.
- Popülasyon büyüklüğü və nəsil sayı.
- Sonuçta kaç özelliğin seçildiği.
- Özellik seçiminin yalnızca təlim vərisi üzərində yapılıp yapılmadığı.
- Rastgele başlangıçların və tekrarların nasıl kontrol edildiği.
Bu ayrıntılar vərilmediği üçün AO-CNN’nin performansa ne ölçüde katkıda bulunduğu və test vərisine bilgi sızması bulunup bulunmadığı değerlendiriləmemektedir.
Avto-kodlayıcı nasıl tədqiqatktadır?
Avto-kodlayıcı, giriş vərisini daha aşşəbəkəı boyutlu bir gizli təmsilə dönüştüren bir kodlayıcı və bu temsilden özgün girdiyi yeniden oluşturmaya çalışan bir kod çözücüden oluşur.
Tədqiqatdaki əsas dönüşümler:
\[ g=f_t(u^{(1)}y+biases^{(1)}) \]
\[ r=f_n(u^{(2)}g+biases^{(2)}) \]
biçimindedir. Burada y giriş vəktörü, g gizli özellik temsili və r yeniden oluşturulan çıktıdır.
Geleneksel avto-kodlayıcıdan fərqli kimi gizli vahidlerde sıradan sigmoid və ya ReLU yerine çoxlu dalğacıq miqyaslama funksiyaları kullanılmaktadır. Tədqiqatçılar, bunun durşəbəkəan olmayan sinyallerde fərqli ölçeklerdeki örüntüleri yakalayabiləceğini iləri sürmektedir.
Çoklu dalğacıq biləşeni ne yapmaktadır?
Tədqiqatda iki parçalı miqyaslama funksiyası kullanılmaktadır. Birinci fonksiyon:
\[ \varphi_1(s)= \begin{cases} -2s^3+3s^2, & s\in[0,1)\\ (2-s)^2(2s-1), & s\in[1,2]\\ 0, & \text{diğer} \end{cases} \]
kimi vərilmiştir. İkinci fonksiyonun ise:
\[ \varphi_2(s)= \begin{cases} -s^2(3s-3), & s\in[0,1)\\ -(2-s)^2(3s-3), & s\in[1,2]\\ 0, & \text{diğer} \end{cases} \]
biçiminde olması beklenmektedir.
Makalede Denklem 22 və Denklem 23’ün ikisi de φ1 kimi etiketlenmiştir. Sonraki tənlikler və Şekil 3 ikinci fonksiyonun φ2 olması gerektiğini göstərir. Bu, metod bölümündeki belirgin bir gösterim xətasıdır.
Şekil 3’te her gizli vahid üçün iki miqyaslama funksiyası və bunların şəbəkəırlıklı birleşimi gösterilmektedir. Gizli birimin çıktısı:
\[ k_i^{out}=D_{ji-1}k_i^{out1}+D_{ji-2}k_i^{out2} \]
kimi hesaplanmakta, ardından yenidən qurma üçün tanh fonksiyonu kullanılmaktadır:
\[ r_j=\tanh\left(\sum_{i=1}^{W} (D_{ji-1}k_i^{out1}+D_{ji-2}k_i^{out2})\right) \]
Metod bölümünde Strela və Plonka çoxlu dalğacıqlarına ait miqyaslama funksiyaları anlatılırken hiperparametre tablosunda istifadə olunan dalğacıq “Haar” kimi belirtilmiştir. Haar dalgacığı ilə vərilən parçalı polinom fonksiyonlarının eyni uygulamada nasıl ilişkiləndirildiği açıklanmamıştır. Bu nedenle gerçekten hangi dalğacıq ailəsinin kullanıldığı belirsizdir.
Dikkat mekanizmasının görəvi nedir?
Yumuşak diqqət modulu, xüsusiyyət xəritəsinın tüm bölümlerine eyni önemi vərmek yerine təsnifat açısından daha yararlı olduğu öğrenilən bölümlere daha yüksək şəbəkəırlık vərmektedir.
Tədqiqatda dikkat hesabı genel kimi:
\[ F_g=\gamma k\sum_{c=1}^{C}Softmax(We_{ck}^{*}) \]
biçiminde vərilmiştir. k CNN tarafından oluşturulan özellik tensörünü, We öğreniləbilir dikkat şəbəkəırlıklarını və γ öğreniləbilir ölçek əmsalsını temsil etmektedir.
Tədqiqatçılar, aşşəbəkəı şəbəkəırlık vərilən özelliklerin etkisinin azaltılmasıyla bellek və işlem maliyetinin düşürülebiləceğini belirtmektedir. Ancak dikkat katmanının boyutu, model üçündeki kesin konumu, başlık sayısı və parametre miktarı açıklanmamıştır.
Hangi vəri dəsti istifadə edilmişdir?
Model NSL-KDD vəri dəsti üzərində qiymətləndirilmişdir. Tədqiqatda təlim bölümünde 21 hücum türü, test bölümünde ise 37 hücum türü bulunduğu və bunların dört ana hücum grubuna ayrıldığı belirtilmektedir:
- DoS: Hizmet engelleme hücumları.
- Probe: Ağ və hizmet skanlama hücumları.
- U2R: Kullanıcı yetkisinden yönetici yetkisine yükselme girişimleri.
- R2L: Uzak bir sistemden yerel kullanıcı erişimi elde etmeye yönelik hücumlar.
Normal trafikle birlikte toplam beş sınıf qiymətləndirilmişdir. Bununla birlikte tədqiqatda istifadə olunan kesin təlim və test dosyalarının adları, örnek sayıları, vəri bölmə metodu və vəri dəstinin tamamının mı yoksa bir alt kümesinin mi kullanıldığı belirtilmemektedir.
Qarışıqlıq matrisləri toplam 10.000 test kaydı içermektedir. Bu sayının vəri dəstinden nasıl seçildiği, təsadüfi örnekleme yapılıp yapılmadığı və sınıf oranlarının özgün vəri dəstinden değiştirilip değiştirilmediği açıklanmamıştır.
Deney ortamı nasıldır?
| Biləşen | Tədqiqatda bildirilən özellik |
|---|---|
| İşlemci | Intel Core i7-4770, 3,40 GHz |
| Bellek | 16 GB; 15,9 GB kullanılabilir |
| Sistem | 64 bit işletim sistemi və x64 tabanlı işlemci |
| Programlama dili | Python |
| Geliştirme ortamı | Spyder |
| Evrişim katmanları | 8 |
| Havuzlama katmanları | 6 |
| Etkinleştirme | ReLU |
| Kayıp fonksiyonu | Categorical cross-entropy |
| Dalğacıq | Haar kimi belirtilmiştir |
Modelin IoT cihazları üçün aşşəbəkəı mənbə tüketimli olduğu iləri sürülmesine rşəbəkəmen testler bir mikrodenetleyici, şəbəkə geçidi, mobil işlemci və ya kənar hesablama kartı üzərində yapılmamıştır. Intel masaüstü işlemcide elde edilən CPU və bellek değerleri, gerçek mənbə kısıtlı IoT donanımındaki tüketimi doğrudan göstermemektedir.
Bildirilən əsas performans değerleri nelerdir?
| Ölçüt | Sonuç bölümünde bildirilən değer |
|---|---|
| Dəqiqlik | %99,35 |
| Dəqiqlik | %99,28 |
| Həssaslıq | %98,49 |
| F1 skoru | %98,89 |
| ROC–AUC | Sınıfa görə 0,99 və ya 1,00 |
Metnin fərqli bölümlerinde bu değerler değişmektedir. Örneğin nəticə grafiklerinin açıklamasında ortalama dəqiqlik yüzde 99,3, dəqiqlik yüzde 99,2 və həssaslıq yüzde 98,4 kimi vərilirken tartışma bölümünde yüzde 99,3 F ölçütü, yüzde 99,28 dəqiqlik, yüzde 98,4 dəqiqlik və yüzde 98,89 həssaslıq şeklinde fərqli bir sıralama istifadə edilmişdir.
Performans metrikalərinin tənlikləri doğru mudur?
Makalede dəqiqlik tənliki doğru biçimde vərilmiştir:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
Ancak dəqiqlik üçün makalede:
\[ Precision=\frac{TP}{TP+TN} \]
və həssaslıq üçün yine:
\[ Recall=\frac{TP}{TP+TN} \]
yazılmıştır. Bu iki ifade standart təsnifat tanımlarıyla uyumlu deyil. Doğru tənlikler:
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
olmalıdır.
Makalede F1 skoru:
\[ F1=\frac{2\times Precision\times Recall}{Precision\times Recall} \]
şeklinde basılmıştır. Bu ifade sıfır olmayan her durumda 2 sonucunu vərir. Standart F1 tənliki:
\[ F1=\frac{2\times Precision\times Recall}{Precision+Recall} \]
biçimindedir.
Bu xətaların yalnızca makale dizgisinde mi bulunduğu, yoksa yazılım kodunda da eyni formüllerin mi kullanıldığı açıklanmamıştır. Kod paylaşılmadığı üçün bildirilən metrikalərin nasıl hesaplandığı bşəbəkəımsız kimi doğrulanamamaktadır.
Qarışıqlıq matrisləri ne göstərir?
İkili normal–hücum matrisi
Şekil 12(a)’daki hücreler şöyledir:
| Gerçek sınıf | Normal tahmini | Saldırı tahmini |
|---|---|---|
| Normal | 5.302 | 6 |
| Saldırı | 5 | 4.687 |
Bu matristen doğrudan hesaplanan dəqiqlik:
\[ \frac{5302+4687}{5302+6+5+4687} =\frac{9989}{10000}=0{,}9989 \]
yani yüzde 99,89’dur. Bu değer nəticə bölümündeki yüzde 99,35 ilə uyuşmamaktadır.
Saldırı pozitif sınıf kabul edildiğinde və satırlar gerçek sınıfları gösterdiğinde:
\[ Precision=\frac{4687}{4687+6}\approx99{,}87\% \]
\[ Recall=\frac{4687}{4687+5}\approx99{,}89\% \]
elde edilir. Bunlar da bildirilən yüzde 99,28 dəqiqlik və yüzde 98,49 həssaslıq değerlerinden fərqlidır.
Beş sınıflı matris
| Gerçek sınıf | Doğru sınıflandırılan | Toplam gerçek örnek | Matristen hesaplanan sınıf duyarlılığı |
|---|---|---|---|
| Normal | 5.302 | 5.306 | Yaklaşık %99,92 |
| DoS | 3.689 | 3.694 | Yaklaşık %99,86 |
| Probe | 923 | 924 | Yaklaşık %99,89 |
| U2R | 2 | 3 | %66,67 |
| R2L | 70 | 73 | Yaklaşık %95,89 |
Beş sınıflı matrisin köşegeninde toplam 9.986 doğru tahmin vardır:
\[ \frac{9986}{10000}=99{,}86\% \]
Bu değer de yüzde 99,35 kimi bildirilən genel dəqiqlikla uyuşmamaktadır.
Özellikle U2R sınıfında yalnızca üç gerçek örnek bulunması mühüm bir sınıf dengesizliği sorununa işaret etmektedir. İki örnek doğru, bir örnek yanlış sınıflandırılmıştır. Buna rşəbəkəmen metin U2R üçün yüzde 98,3 həssaslıq bildirmektedir. Matris ilə metin eyni təcrübə sonucunu temsil ediyorsa bu iki değer birlikte doğru olamaz.
CPU, bellek və inferensiya müddəti nəticələrı ne göstərir?
CPU grafiğinde istifadəsin təxminən yüzde 1,1 ilə yüzde 2,1 arasında değiştiği görülmektedir. Bellek istifadəsi ise təxminən yüzde 3,37 seviyesinde sabit bir çizgi kimi sunulmuştur. Ölçümlerin tüm sistem istifadəsinı mı, yalnızca Python sürecini mi gösterdiği və hangi örnek sayısı üzərində alındığı belirtilmemiştir.
Çıkarım süresi grafiğinde önerilən model; IRNN, TIKI-TAKA, CSE-IDS və DL-IDS metodleriyle karşılaştırılmaktadır. Özellik budama oranı arttıkça önerilən metodin daha kısa süre gösterdiği görülmektedir. Ancak:
- Kesin çıkarım süreleri tablo hâlinde vərilmemiştir.
- Karşılaştırılan modellerin eyni bilgisayarda yeniden uygulanıp uygulanmadığı belirtilmemiştir.
- Ortalama, median, tekrar sayısı və xəta çubuğu yoktur.
- Şekil 10’un açıklamasında yanlışlıkla “accuracy” ifadesi istifadə edilmişdir.
- Özelliklerin yüzde kaçının və kaç adet özelliğin budandığı ayrıntılı kimi vərilmemiştir.
Bu nedenle kısa inferensiya müddəti iddiası görsel bir eğilim sunmakta, ancak yeniden üretiləbilir bir zaman ölçümü sşəbəkəlamamaktadır.
Friedman testi ne göstərir?
Tədqiqatda sınıflandırıcıların dəqiqlik, spesifiklik, yanlış pozitiv nisbəti və AUC nəticələrının karşılaştırılması üçün Friedman testi kullanıldığı belirtilmiştir. Tablo 6’da p değerleri şu şekilde vərilmiştir:
| Ölçüt | F istatistiği | p değeri |
|---|---|---|
| Dəqiqlik | 6,52132 | 0,0005 |
| Özgüllük | 7,017454 | 0,00032 |
| Yanlış pozitif oranı | 7,576122 | 0,0002 |
| AUC | 4,94556 | 0,00412 |
Yazarlar sıfır hipotezinin reddedildiğini belirtmektedir. Ancak Friedman testindeki blokların ne olduğu açık deyil. Tədqiqat yalnızca NSL-KDD vəri dəstini kullanmasına rşəbəkəmen dört vəri grubu və yedi algoritma bulunduğu ifade edilir. Tekrar təcrübələri, vəri bölmeleri və ya bşəbəkəımsız vəri setleri açıklanmadığı üçün testin hangi gözlemler üzərində yürütüldüğü yeniden oluşturulamamaktadır.
Tablo 6’daki alfa satırlarında 0,11, 0,0022, 0,00021 və 0,0052 gibi birbirinden fərqli değerler bulunmakta; sonraki satırda ise “α=0,1” ifadesiyle tüm hipotezler reddedilmiş kimi gösterilmektedir. Bu tablo başlıkları və değerleri istatistiksel yorum açısından yeterince açık deyil.
Tədqiqatnın güclü tərəfləri nelerdir?
- CNN tabanlı xüsusiyyət çıxarılması, meta-sezgisel xüsusiyyət seçimi, çoxlu dalğacıq dönüşümü və diqqət mexanizminı tek mimaride birleştirmektedir.
- İkili və çoxsinifli hücum aşkarlanmasıni eyni tədqiqat üçünde qiymətləndirməktedir.
- Dəqiqlik dışında dəqiqlik, həssaslıq, F1, ROC, inferensiya müddəti, CPU və bellek istifadəsi gibi fərqli ölçütleri ele almaktadır.
- Qarışıqlıq matrisləri sunarak sınıf bazlı nəticələrın incelenmesine imkân vərmektedir.
- Modelin matematiksel biləşenlerini tənlikler və axın şemalarıyla açıklamaya tədqiqatktadır.
- Nadir hücum sınıflarını da təsnifat problemine dâhil etmektedir.
- Hakemli bir telekomünikasyon dergisinde yayımlanmış eksperimental bir tədqiqatdır.
Tədqiqatnın əsas məhdudiyyətləri nelerdir?
- Dəqiqlik, həssaslıq və F1 skoru tənlikləri yanlış basılmıştır.
- İkili və çoxsinifli karışıklık matrislerinden hesaplanan dəqiqlik değerleri bildirilən genel dəqiqlikla uyuşmamaktadır.
- U2R sınıfı üçün matristen hesaplanan həssaslıq yüzde 66,67 iken metinde yüzde 98,3 vərilmiştir.
- Metnin fərqli bölümlerinde dəqiqlik, dəqiqlik, həssaslıq və F1 değerleri fərqli sıralama və yüzdelerle sunulmuştur.
- Veri setinin kesin təlim–test bölünmesi və 10.000 örneklik test alt kümesinin nasıl oluşturulduğu açıklanmamıştır.
- Özellik kodlama, kateqorik dönüşüm və sınıf dengeleme adımları belirtilmemiştir.
- Aquila algoritmasının uyğunluq funksiyası, populyasiya ölçüsü, nəsil sayı və seçilən özellik miktarı vərilmemiştir.
- CNN’nin filtre sayıları, çekirdek boyutları, katman boyutları və tam mimarisi açıklanmamıştır.
- Eğitim turu, yığın boyutu, öyrənmə dərəcəsi, doğrulama bölümü, erken durdurma və təsadüfi tohum bilgiləri vərilmemiştir.
- Metod bölümünde Strela–Plonka çoxlu dalğacıqları anlatılırken hiperparametre tablosunda Haar dalgacığı yazmaktadır.
- İkinci miqyaslama funksiyası yanlışlıkla yeniden φ1 kimi etiketlenmiştir.
- Avto-kodlayıcı kayıp tənliklərinde yenidən qurma xətasının karesi görünmemektedir; bunun dizgi xətası olup olmadığı açıklanmamıştır.
- Model mənbə kısıtlı bir IoT və ya kənar hesablama cihazında çalıştırılmamıştır.
- Enerji vərimliliği iləri sürülmesine rşəbəkəmen enerji tüketimi və ya güç ölçümü yapılmamıştır.
- CPU və bellek grafikleri üçün ölçüm metodi, tekrar sayısı və qeyri-müəyyənlik değerleri vərilmemiştir.
- Karşılaştırma tablosundaki tədqiqatlar fərqli vəri setleri və təcrübə koşulları kullanmaktadır; bu nedenle yüzdeler kontrollü bir kıyaslama deyil.
- Yeni və ya daha əvvəl görülmemiş hücumların ayrı bir təcrübəle aşkarlama edildiği gösterilmemiştir.
- Kaynak kodu, öyrədilmiş model, seçilən özellik listesi və təcrübə skriptləri paylaşılmamıştır.
- Veri erişiləbilirliği beyanında yeni vəri oluşturulmadığı və ya analiz edilmediği yazmasına rşəbəkəmen tədqiqat NSL-KDD üzərində analiz gerçekleştirmektedir.
Tədqiqat neyi dəstəkləyir?
Tədqiqat, bir boyutlu CNN ilə çıkarılan şəbəkə trafiki özelliklerinin meta-sezgisel bir algoritmayla seçilip dikkat və çoxlu dalğacıq biləşenleri bulunan bir avto-kodlayıcıya aktarılabiləceğini dəstəkləyir. Sunulan grafikler və matrisler, modelin istifadə olunan test örneklerinin büyük bölümünü doğru sınıflandırdığını göstərir.
Ayrıca fərqli hücum sınıflarının eyni mimari üçünde sınıflandırılabiləceğini və xüsusiyyət seçiminin inferensiya müddətini azaltma potansiyeli taşıdığını göstərir.
Tədqiqat neyi sübut etmir?
- Modelin gerçek bir IoT şəbəkəında yüzde 99,35 dəqiqlikla çalıştığını sübut etmir.
- Metodin daha əvvəl görülmemiş hücumları güvənilir biçimde aşkarlama ettiğini ayrı bir təcrübəle göstermemektedir.
- Modelin modern və ya fərqli IoT trafik vəri setlerine genellenebildiğini göstermemektedir.
- Kaynak kısıtlı bir IoT cihazında gerçek zamanlı çalışabildiğini sübut etmir.
- Diğer metodlerden daha az enerji tükettiğini göstermemektedir.
- Aquila optimizasyonu, diqqət modulu və ya çoxlu dalğacıq biləşenlerinden hangisinin performansa ne kadar katkı sşəbəkəladığını göstermemektedir.
- Yüksek genel doğruluğun nadir U2R və R2L hücumlarında eyni başarıyı ifade ettiğini göstermemektedir.
- Karşılaştırılan bütün metodlerin eyni vəri bölümü, donanım və kod ortamında test edildiğini göstermemektedir.
- Bildirilən metrikalərin karışıklık matrisleriyle matematiksel kimi tutarlı olduğunu göstermemektedir.
Türkiyə açısından nasıl değerlendiriləbilir?
Türkiyə’de akıllı üretim, enerji sistemleri, şehir altyapıları, haberleşme şəbəkəları və bşəbəkəlı cihazların yaygınlaşması; şəbəkə trafikinin otomatik kimi izlenmesini mühüm hâle getirmektedir. Tədqiqatda önerilən mimari, ünivərsitelerde və tədqiqat laboratuvarlarında xüsusiyyət seçimi, derin öğrenme və dikkat mekanizmalarının hücum aşkarlanmasıne nasıl uygulanabiləceğini incelemek üçün bir başlangıç modeli kimi değerlendiriləbilir.
Uygulamaya geçiş üçün modelin Türkiyə’de istifadə olunan gerçek şəbəkə protokolleri, kurum şəbəkəları, endüstriyel IoT trafiği və güncel hücum örnekleri üzərində yeniden eğitilmesi lazımdır. Ayrıca sınıf dengesizliği, model açıklanabilirliği, yanlış alarm oranı, çevrim içi güncelleme, vəri gizliliği və kənar cihaz mənbə tüketimi ayrı təcrübələrle ölçülmelidir.
Tədqiqatın Metodu və Nəticələri
Metod özeti
| Aşama | Uygulanan metod | Amaç |
|---|---|---|
| Veri kaynşəbəkəı | NSL-KDD | Normal və hücum trafiği kayıtlarını sşəbəkəlamak |
| Temizleme | Eksik değer kontrolü; median və ya mod ilə tamamlama önerisi | Eksik kayıtların etkisini azaltmak |
| Ölçekleme | Min–maks normalizasyonu | Özellikleri ortak rəqəmsal aralığa taşımak |
| Özellik çıkarımı | 1D CNN, ReLU və maksimum hovuzlama | Yerel trafik örüntülerini çıkarmak |
| Özellik seçimi | Aquila Optimizasiya Alqoritmi | Daha ilgili özellikleri seçmek |
| Temsil öğrenme | Çoklu dalğacıq yönelimli avto-kodlayıcı | Veriyi fərqli ölçeklerde temsil etmek |
| Dikkat | Yumuşak diqqət modulu | Önemli özelliklere daha yüksək şəbəkəırlık vərmek |
| Sınıflandırma | Sigmoid və ya softmax çıkışı | İkili ya da çoxsinifli hücum tahmini |
Sınıflandırma nəticələrının karşılaştırılması
| Sonuç kaynşəbəkəı | Dəqiqlik | Dəqiqlik | Həssaslıq | F1 |
|---|---|---|---|---|
| Özet və nəticə bölümü | %99,35 | %99,28 | %98,49 | %98,89 |
| Performans açıklamaları | Yaklaşık %99,3 | Yaklaşık %99,2 | Yaklaşık %98,4 | %98,89 |
| İkili matristen doğrudan hesablama | %99,89 | Yaklaşık %99,87 | Yaklaşık %99,89 | Yaklaşık %99,88 |
| Beş sınıflı matristen genel dəqiqlik | %99,86 | Sınıf bazlı hesablama gerektirir | ||
Bu değerlerin eyni təcrübə bölümüne ait olduğu kabul edildiğinde aralarında matematiksel uyumsuzluk vardır. Tədqiqat ham tahmin dosyalarını paylaşmadığı üçün hangi sonucun nihai və doğru olduğu belirlenememektedir.
Sınıf bazlı nəticələr
| Sınıf | Matristeki gerçek örnek | Doğru tahmin | Yanlış tahmin | Matristen hesaplanan həssaslıq |
|---|---|---|---|---|
| Normal | 5.306 | 5.302 | 4 | %99,92 |
| DoS | 3.694 | 3.689 | 5 | %99,86 |
| Probe | 924 | 923 | 1 | %99,89 |
| U2R | 3 | 2 | 1 | %66,67 |
| R2L | 73 | 70 | 3 | %95,89 |
Genel dəqiqlik çok yüksək görünse de test vərisinin təxminən yüzde 90’ı Normal və DoS sınıflarından oluşmaktadır. U2R sınıfında yalnızca üç örnek bulunduğu üçün tek bir yanlış tahmin duyarlılığı yüzde 33,33 azaltmaktadır. Bu durum, yalnızca genel doğruluğa bakmanın nadir hücumlardaki zayıflığı gizleyebiləceğini göstərir.
Karşılaştırılan metodler
Tədqiqatda önerilən AMV-AE modeli; RNN, CNN-LSTM, geleneksel avto-kodlayıcı, B-stacking, PCA–IHHO–KNN–SVM, LSTM-MAC, federatif öğrenme, SS-Deep-ID və diğer hücum aşkarlama metodleriyle karşılaştırılmıştır.
| Metod | Tədqiqatda aktarılan dəqiqlik |
|---|---|
| PCA, IHHO, KNN və SVM | %95,01 |
| LSTM-MAC, SHA-3, Twofish və GAN | %95,00 |
| MV-FLID | %94,175 |
| SS-Deep-ID və trafik dikkati | %98,71 |
| Topluluk tabanlı sınıflandırıcı | %97,00 |
| RNN tabanlı metod | %92,42 |
| PCO və DNN | %98,40 |
| Passban IDS | %99,00 |
| Regresyon və topluluk öğrenmesi | %99,10 |
| Önerilən AMV-AE | %99,35 |
Bu tablo fərqli yayınlardan alınan nəticələrı bir araya getirmektedir. Bütün metodlerin eyni təlim–test bölümü, eyni ön işleme, eyni donanım və eyni sınıf dşəbəkəılımı üzərində yeniden çalıştırıldığı gösterilmemiştir. Bu nedenle küçük yüzde farkları doğrudan metod üstünlüğü kimi yorumlanmamalıdır.
Metodin yeniden üretiləbilmesi üçün eksik bilgilər
| Gerekli bilgi | Tədqiqatdaki durum |
|---|---|
| Kesin təlim və test örnek sayıları | Belirtilmemiştir |
| Kategorik özelliklerin kodlanması | Belirtilmemiştir |
| Normalizasyonun yalnızca təlim vərisine görə yapılması | Belirtilmemiştir |
| Sınıf dengeleme metodi | Belirtilmemiştir |
| CNN filtre və çekirdek boyutları | Belirtilmemiştir |
| Yığın boyutu və təlim turu | Belirtilmemiştir |
| Öğrenme oranı və güncelleme algoritması | Belirtilmemiştir |
| Aquila uyğunluq funksiyası | Belirtilmemiştir |
| Seçilən özellik sayısı | Belirtilmemiştir |
| Rastgele tohum və tekrar sayısı | Belirtilmemiştir |
| Dalğacıq ailəsinin kesin uygulaması | Haar və Strela–Plonka ifadeleri birbiriyle uyumsuzdur |
| Kaynak kodu və öyrədilmiş model | Paylaşılmamıştır |
Nəticələrın güvənilir yorum sınırı
Sunulan karışıklık matrisleri, modelin incelenen örneklerde çok sayıda doğru tahmin ürettiğini göstərir. Ancak matrislerden hesaplanan değerlerin makaledeki özet nəticələrla uyuşmaması, performans qiymətləndirməsinin yeniden doğrulanmasını gerekli kılmaktadır.
Özellikle nadir hücum sınıfları üçün makro orta həssaslıq, balanslaşdırılmış dəqiqlik, sınıf bazlı dəqiqlik və etimad intervalları raporlanmalıdır. Modelin fərqli vəri bölmələri və təsadüfi başlangıçlar altında yeniden çalıştırılması, yüksək nəticələrın tek bir bölünmeye bşəbəkəlı olup olmadığını gösterecektir.
Mənbə və Metod Qeydi
Tədqiqatnın özgün adı: A Novəl Multi-Wavəlet Oriented Auto-Encoder for Intrusion Detection in IoT System
Yazarlar: Kuruba Madhusudhan; Aravind Kumar Madam.
Yazar sıralaması: Yayımlanan makalede yer aldığı biçimde korunmuştur.
Eş katkı və ya eş birinci yazarlık: Belirtilmemiştir.
Sorumlu yazar: Kuruba Madhusudhan.
Kurumlar: Bharatiya Engineering Science and Technology Innovation Univərsity, Gorantla, Andhra Pradesh, Hindistan; Department of ECE, West Godavari Institute of Science and Engineering, Nallacherla Mandal, Andhra Pradesh, Hindistan.
Resmî yayın bşəbəkəlantısı:Wiləy Online Library makale sayfası
Dergi: Transactions on Emerging Telecommunications Technologies.
Cilt, sayı və makale numarası: Cilt 36, Sayı 7, e70202.
Yayın yılı: 2025.
Kaynak türü: Derin öğrenme tabanlı şəbəkə hücum aşkarlama modeli geliştiren tədqiqat makalesi.
Hakemlik durumu: Hakemli dergi makalesidir.
Gönderim süreci: 18 Mayıs 2024’te alınmış, 25 Ekim 2024’te düzeltilmiş və 5 Ocak 2025’te kabul edilmişdir.
Özgün yayınevi: John Wiləy & Sons Ltd.
Veri seti: NSL-KDD.
Finansman: Makalede ayrı bir finansman beyanı yer almır.
Veri erişiləbilirliği: Makalede yeni vəri oluşturulmadığı və ya analiz edilmediği belirtilmiştir. Bununla birlikte tədqiqat NSL-KDD vəri dəsti üzərində model təlimi və performans analizi bildirdiğinden bu beyan tədqiqatnın metodiyle açık biçimde uyumlu deyil.
Kod və model erişimi: Kaynak kodu, öyrədilmiş model şəbəkəırlıkları, xüsusiyyət seçimi nəticələrı və təcrübə yapılandırma dosyaları üçün açık bir bşəbəkəlantı vərilmemiştir.
Bu Türkçe açıklama, tədqiqatnın metni, matematiksel tənlikləri, tabloları, mimari şemaları, axın diyagramları, performans grafikleri, ROC eğriləri, mənbə istifadəsi ölçümleri, karışıklık matrisleri və istatistiksel analizleri incelenerek hazırlanmıştır. Dış mənbəlar yalnızca DOI, dergi, cilt, sayı, yayın tarihi və yayınevi gibi bibliyografik kimlik bilgilərinin doğrulanması amacıyla kullanılmış; tədqiqatda bulunmayan bilimsel performans nəticələrı eklenmemiştir.
Makaledeki karışıklık matrisleri kullanılarak yapılan yüzde hesablamaları, tədqiqat tarafından sunulan hücre değerlerinin doğrudan matematiksel qiymətləndirməsidir. Bu hesablamalar; bildirilən dəqiqlik, dəqiqlik və həssaslıq değerlerinin matrislerle uyuşmadığını göstərir. Ayrıca dəqiqlik, həssaslıq və F1 tənliklərinin basılı sürümünde əsas tanım xətaları vardır. Bu nedenle performans iddiaları, kod və ham tahminler paylaşılmadan kesinleşmiş bir uygulama başarısı kimi kabul edilmemelidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib