

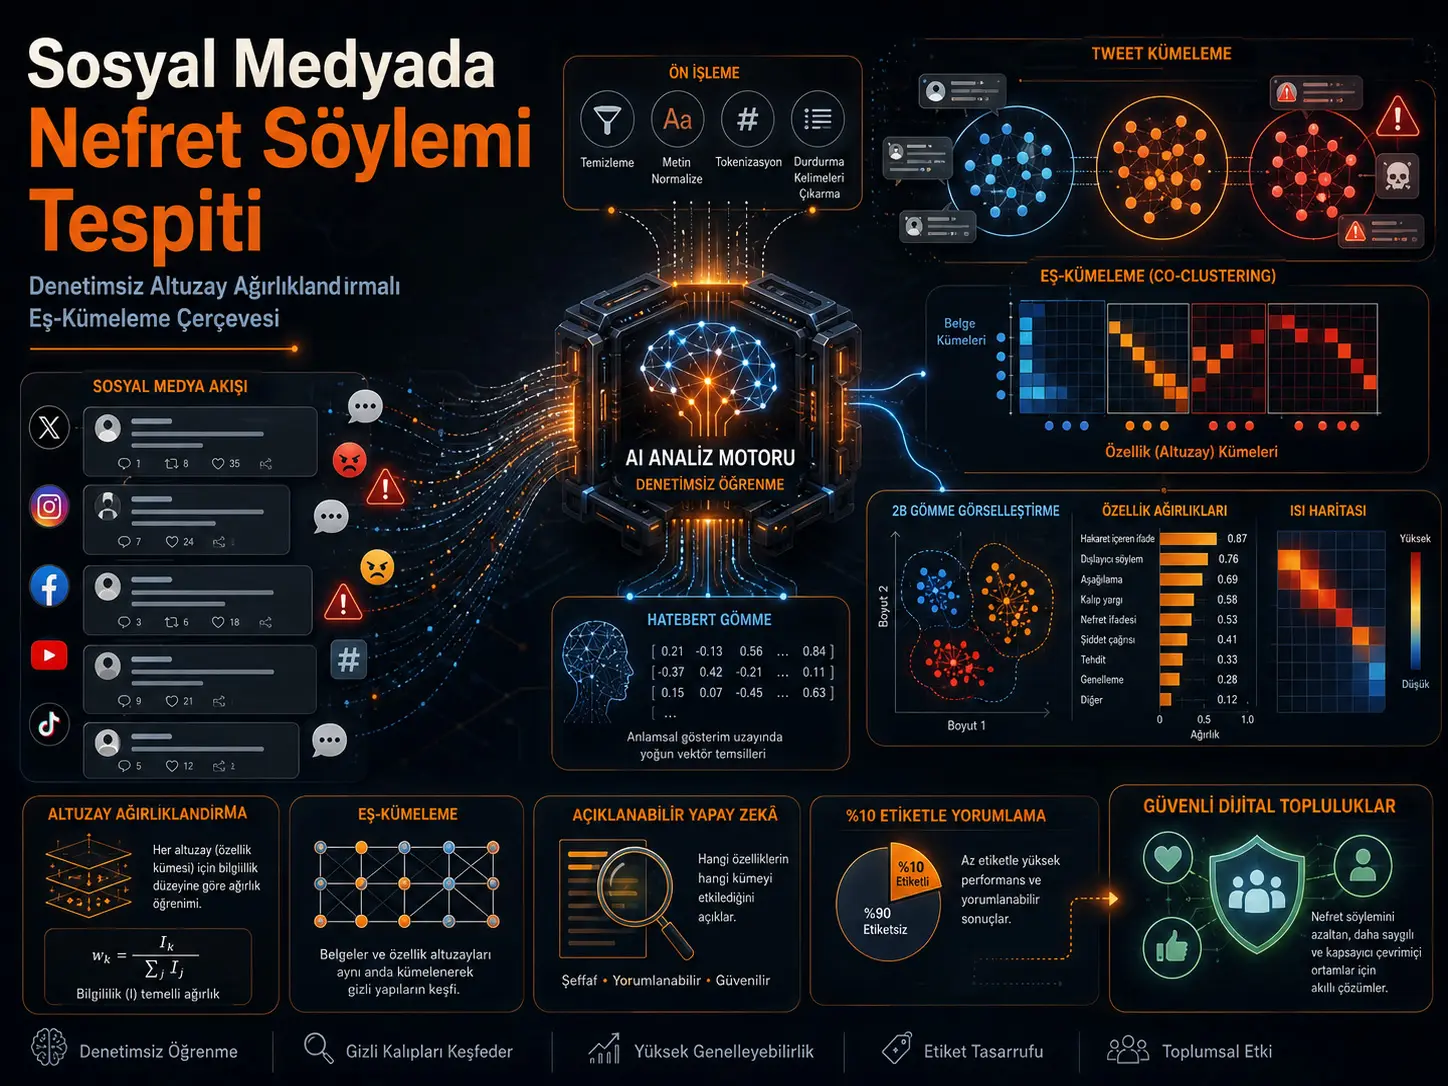
Bu tədqiqat sosial mediadakı ingilisdilli nifrət nitqi nümunələrini böyük həcmdə etiketlənmiş təlim məlumatına ehtiyac olmadan aşkar etmək məqsədilə Subspace Weighting Co-Clustering (SWCC; Altməkan Çəkiləndirməli Birgə Klasterləşdirmə) adlı metod təklif edir. Sistem mətnləri 768 ölçülü kontekstual embedding-lərə çevirən BERT-əsaslı dil modeli ilə başlayır; daha sonra tweetləri və bu embedding məkanındakı xüsusiyyət ölçülərini eyni vaxtda klasterləşdirir və hər klaster üçün fərqli altməkan çəkilərini öyrənir. Müəlliflərin hesabatına görə SWCC daxili klasterləşdirmə qiymətləndirməsində 0,68 Silhouette, 0,85 Davies–Bouldin, 1580,5 Calinski–Harabasz və 0,43 Dunn dəyərlərinə çatır. Waseem məlumat dəstində xarici qiymətləndirmədə isə klasterlər yaradıldıqdan sonra etiketlərin %10-u kateqoriya uyğunlaşdırması üçün istifadə edildikdə %93,1 dəqiqlik və %93,5 F1 skoru bildirilir. Bununla belə, tədqiqat tamamilə etiketsiz ucdan-uca təsnifatlandırıcı deyil; kateqoriya adlarının təyin edilməsi üçün etiketlənmiş doğrulama altçoxluğu tələb olunur. Bundan əlavə, istifadə olunan model identifikatoru və məlumat dəstlərinin sinif paylanmaları barədə mənbə mətndə təkrar istehsal oluna bilməyə təsir göstərə biləcək uyğunsuzluqlar mövcuddur.
Tədqiqatın əsas ideyası nifrət nitqinin bütün növlərinin eyni dil xüsusiyyətlərinə bərabər dərəcədə əsaslanmadığı fərziyyəsidir. İrq əsaslı nifrət, seksist ifadə və nifrət ehtiva etməyən təhqiramiz dil müxtəlif semantik ölçülərdə cəmləşə bilər. Buna görə SWCC yalnız tweetləri klasterlərə ayırmır; 768 ölçülü embedding məkanını da altməkanlara bölür və hər tweet klasteri üçün bu altməkanlara uyğunlaşdırıla bilən əhəmiyyət çəkiləri təyin edir. Ablation təcrübəsində öyrənilmiş çəkiləndirmə aradan qaldırıldıqda Silhouette skoru 0,68-dən 0,55-ə, çəkilər təsadüfi seçildikdə 0,47-yə və bərabər saxlanıldıqda 0,51-ə düşür. Bu nəticə araşdırılan məlumat və eksperimental quruluşda adaptiv çəkiləndirmənin klasterlərin ayrılmasına töhfə verdiyini dəstəkləyir.
Bununla belə, məqalənin “örtülü nifrət nitqi” və “aşağı resurslu dillər” üçün daha geniş istifadə iddiaları hələ eksperimental olaraq təsdiqlənməyib. Təcrübələr ingilisdilli Twitter məlumatları üzərində və müəlliflərin öz ifadəsi ilə explicit hate məlumat dəstlərində aparılıb. Buna görə tədqiqat müxtəlif platformalara, müxtəlif dillərə və ya birbaşa implicit hate məlumat dəstlərinə ümumiləşdirilmiş uğur sübutu təqdim etmir.
Niyə klassik nəzarətli nifrət nitqi aşkarlanmasından fərqli yanaşma axtarılır?
Nifrət nitqinin aşkarlanmasında geniş yayılmış üsul əvvəldən insanlar tərəfindən təsnif edilmiş minlərlə və ya milyonlarla mətndən istifadə etməklə təsnifatlandırıcı öyrətməkdir. Bu yanaşma yüksək performans verə bilsə də, yeni dillər, yeni icmalar, sürətlə dəyişən sleng və yeni nifrət nitqi formaları üçün davamlı annotasiya xərci yaradır.
Tədqiqatın hədəflədiyi boşluq məhz burada ortaya çıxır: etiketlərin modelin klaster yaratma mərhələsində istifadə edilmədiyi, lakin semantik baxımdan mənalı tweet qruplarının yenə də aşkar edilə bildiyi bir struktur qurmaq mümkündürmü?
Müəlliflərin təklifi iki texnikanı birləşdirir:
- Kontekstual dil təmsilçisi: tweetin mənasını sabit söz siyahılarından daha çox çoxölçülü embedding məkanına çevirmək.
- Altməkan çəkiləndirməli birgə klasterləşdirmə: həm sənədləri, həm də embedding ölçülərini birlikdə təşkil etmək və hər sənəd klasterində hansı altməkanların daha fərqləndirici olduğunu öyrənmək.
“Nəzarətsiz” sözü burada dəqiq olaraq nə deməkdir?
Tədqiqatda document cluster-larının yaradılması zamanı insan tərəfindən verilmiş nifrət nitqi siniflərindən istifadə edilmir. Bu baxımdan SWCC-nin əsas klasterləşdirmə mərhələsi nəzarətsizdir.
Lakin əldə edilən Cluster 1, Cluster 2 və ya Cluster 3 kimi klasterlərin hansının “irqçi”, “seksist”, “nifrət ehtiva etməyən təhqiramiz dil” və ya məlumat dəstinin başqa rəsmi sinfinə uyğun gəldiyini müəyyən etmək üçün etiketlərin ən az %10-u istifadə olunub.
Buna görə metod üçün ən ehtiyatlı tərif belədir:
SWCC klasterləşdirmə mərhələsində nəzarətsiz, kateqoriya adlandırılması və xarici performans qiymətləndirməsində isə minimal etiketdən istifadə edən çərçivədir.
Bu fərq vacibdir. %93,1 dəqiqlik və ya %93,5 F1 skoru heç bir etiketə baxmadan avtomatik olaraq mənalı kateqoriya adları yaradan tam etiketsiz sistemin performansı deyil.
HateBERT niyə istifadə olunur?
Sadə söz sayımları eyni sözün fərqli kontekstlərdəki mənasını ayırd etməkdə çətinlik çəkə bilər. BERT-əsaslı modellər isə sözün təmsilini ətrafındakı sözlərə görə dəyişə bilir.
Tədqiqatın konseptual modelində HateBERT sosial media aqressiyası və nifrət nitqi ilə əlaqəli dil nümunələrinə uyğunlaşdırılmış kontekstual təmsil istehsalçısı kimi istifadə olunur.
Hər mətn ümumilikdə:
\[ M=768 \]
ölçülü latent semantik məkana çevrilir. Bütün məlumat dəsti:
\[ X\in\mathbb{R}^{N\times768} \]
matrisi ilə təmsil olunur. Burada \(N\) sənəd/tweet sayıdır.
Embedding ölçüləri sözdürmü?
Xeyr. 768 embedding ölçüsünün hər biri birbaşa “irq”, “cinsiyyət”, “təhqir” və ya müəyyən bir söz mənasına gəlmir. Bunlar model daxilində paylanmış şəkildə öyrənilmiş latent ədədi xüsusiyyətlərdir.
Məqalə şərh edilə bilməni təmin etmək üçün daha sonra yüksək çəkili embedding ölçülərinin məlumat dəstində ən çox aktivləşdiyi token-ları müəyyən edir və onları semantik kateqoriyalarla uyğunlaşdırır.
Buna görə xüsusiyyətlərin şərhi iki mərhələlidir:
- SWCC hansı latent ölçü/altməkanın vacib olduğunu müəyyən edir.
- Post hoc analiz bu latent ölçüləri insanın anlaya biləcəyi token və ya anlayışlarla əlaqələndirməyə çalışır.
Beləliklə, cədvəldə görünən sözlər birbaşa BERT-in 768 sütununun təbii adları deyil; tədqiqat tərəfindən aparılan sonrakı şərhləndirmə qatının nəticəsidir.
Birgə klasterləşdirmə nəyi fərqli edir?
Klassik K-means yalnız sətirləri, yəni bu nümunədə tweetləri klasterləşdirir. SWCC isə iki oxu eyni vaxtda təşkil edir:
- Sətirlər: tweetlər / sənədlər.
- Sütunlar: embedding xüsusiyyət ölçüləri.
Tweet klaster təyinatı:
\[ U\in\{0,1\}^{N\times K} \]
matrisi ilə; feature-subspace üzvlüyü isə:
\[ V\in\{0,1\}^{M\times L} \]
matrisi ilə ifadə olunur.
Tədqiqatın yekun eksperimental parametrlərində:
\[ K=3 \]
tweet klasteri və:
\[ L=32 \]
xüsusiyyət altməkanı seçilib.
Altməkan çəkisi nə işə yarayır?
Hər nifrət nitqi kateqoriyasının eyni semantik ölçülərə eyni dərəcədə ehtiyac duyduğu fərz edilmir. Bunun əvəzinə:
\[ C\in\mathbb{R}^{K\times L} \]
şəklində çəki matrisi təyin edilir.
\[ c_{g,h} \]
dəyəri \(g\)-ci tweet klasteri üçün \(h\)-ci altməkanın əhəmiyyətini göstərir.
Məsələn, bir klasterdə kimlik/qrup hədəflənməsinə həssas latent xüsusiyyətlər güclü ola bilər, başqa klasterdə isə ümumi aqressiya və ya alçaldıcı dil nümunələrini daşıyan ölçülər daha yüksək çəki ala bilər.
Bu yanaşmanın nəzəri üstünlüyü 768 ölçünün hamısına vahid və qlobal əhəmiyyət dəyəri vermək əvəzinə klasterdən asılı xüsusiyyət əhəmiyyəti öyrənə bilməsidir.
SWCC məqsəd funksiyası necə işləyir?
Məqalədə verilən əsas məqsəd funksiyası:
\[ J(U,V,Z,C) = \frac{1}{NM} \sum_{g=1}^{K} \sum_{h=1}^{L} \sum_{i=1}^{N} \sum_{j=1}^{M} u_{i,g}v_{j,h}c_{g,h} (x_{i,j}-z_{g,h})^2 + \eta \sum_{g=1}^{K} \sum_{h=1}^{L} c_{g,h}\log(c_{g,h}) \]
şəklindədir.
Birinci termin hər tweetin aid olduğu klasterin müvafiq altməkan mərkəzinə çəkili kvadrat məsafəsini minimumlaşdırmağa çalışır. Tweet ilə centroid bir-birinə nə qədər yaxındırsa reconstruction/clustering xətası bir o qədər kiçik olur.
İkinci termin entropiya əsaslı regularization komponentidir:
\[ R_{\mathrm{entropy}} = \eta \sum_{g,h} c_{g,h}\log c_{g,h}. \]
Buradakı:
\[ \eta>0 \]
parametri çəkilərin nə qədər konsentrasiyalı və ya balanslı olacağını təsir edir.
Entropiya nizamlaması niyə lazımdır?
Çəkilər tam sərbəst buraxılarsa, model bütün əhəmiyyəti bir neçə feature-a yığaraq həddindən artıq kəskin və qeyri-sabit həllər yarada bilər. Entropiya termini bu davranışı nəzarətdə saxlamağa çalışır.
Tədqiqatın həssaslıq təcrübəsində:
| \(\eta\) | Silhouette | Mənbənin şərhi |
|---|---|---|
| 0,01 | 0,52 | Çəkilər həddindən artıq seyrəkdir |
| 0,1 | 0,61 | Qeyri-kafi nizamlandırma |
| 0,5 | 0,68 | Ən yaxşı tarazlıq |
| 1,0 | 0,65 | Həddindən artıq nizamlandırma |
| 2,0 | 0,58 | Həddindən artıq nizamlandırma |
| 5,0 | 0,49 | Şiddətli həddindən artıq nizamlandırma |
Bu təcrübə çərçivəsində:
\[ \eta=0{,}5 \]
ən yüksək Silhouette dəyərini yaradıb.
Alqoritmin iterativ axını necədir?
Məqalədəki SWCC alqoritmi alternating minimization yanaşmasını izləyir:
- Tweet və feature klasterləri başlanğıcda təyin olunur.
- Tweetlər çəkili məsafəyə görə yenidən klasterləşdirilir.
- Cluster centroid-ləri yenilənir.
- Feature ölçüləri müvafiq altməkanlara yenidən təyin olunur.
- Hər cluster–subspace cütü üçün paylanmadan asılı çəkilər yenilənir.
- Təyinatlar sabitləşdikdə və ya maksimum iterasiya sayına çatdıqda proses dayanır.
Beləliklə sənəd klasterləri, feature altməkanları, centroid-lər və altməkan çəkiləri bir-birindən müstəqil şəkildə yalnız bir dəfə hesablanmır; onlar iterativ şəkildə bir-birinə təsir göstərir.
Hesablama xərci nədir?
Məqalə bir iterasiya üçün təxmini mürəkkəbliyi:
\[ O(NKML) \]
kimi verir.
\[ K=3,\qquad L=32,\qquad M=768 \]
olduqda hər sənəd üçün təxminən:
\[ 7{,}4\times10^4 \]
əsas əməliyyat miqyası hesablanır.
Müəlliflərin miqyas qiymətləndirməsinə görə \(N=10^6\) və 50 iterasiya səviyyəsində ümumi əməliyyat sayı təxminən:
\[ 3{,}7\times10^{12} \]
ola bilər. Buna görə tədqiqat milyonlarla sənəd miqyasında paylanmış tətbiqin tələb oluna biləcəyini bildirir.
Real təcrübə nə qədər davam etdi?
Təkrar istehsal oluna bilmə bölməsində Davidson məlumat dəsti üçün embedding çıxarılmasının:
\[ 2887\ \text{saniye} \]
yəni təxminən 48 dəqiqə davam etdiyi bildirilir.
SWCC üçün 30 iterasiya istifadə olunub və hər iterasiya üçün təxminən 2–3 saniyə bildirilib. Tam pipeline müddəti təxminən 50–55 dəqiqə kimi verilib.
Embedding matrisinin:
\[ 24.783\times768 \]
ölçüsündə olduğu və təxminən 72,61 MB yaddaş tutduğu qeyd olunur.
Hansı məlumat dəstlərindən istifadə olunub?
Tədqiqat iki ingilisdilli Twitter məlumat dəstindən istifadə edir:
| Məlumat dəsti | Mənbədə bildirilən ölçü | İstifadə məqsədi |
|---|---|---|
| Davidson və dig. (2017) | 24.783 tweet | Nifrət nitqi / təhqiramiz dil / neytral məzmun üzrə təcrübələr |
| Waseem (2016) | 16.000 tweet kimi bildirilir | İrqçilik / seksizm / digər siniflər üzrə qiymətləndirmə |
Buradakı sinif paylanmaları üçün mənbə mətndə təkrar istehsal oluna bilmə baxımından mühüm uyğunsuzluqlar olduğuna görə nisbətlər sorğulanmadan “doğru məlumat dəsti paylanması” kimi yenidən dərc edilməməlidir. Məqalənin metodoloji nəticələri qiymətləndirilərkən bu məqam ayrıca nəzərə alınmalıdır.
Məlumatların ilkin emalı necə aparılıb?
Tweetlərdə olan URL-lərin, istifadəçi adlarının, hashtag işarələrinin, durğu işarələrinin, stop-word-lərin və müxtəlif sosial media səs-küylərinin təmizlənməsi hədəflənib. Sleng və qısaltmaların məna qarşılıqları ilə əvəz edildiyi, emoticon-ların da izahlı sözlərə çevrildiyi bildirilir.
Tədqiqatın ilkin emal analizində hər tweet üçün orta hesabla təxminən:
\[ 19{,}1 \]
simvolun silindiyi bildirilir.
Bu proses embedding modelinə daha standartlaşdırılmış mətn verməyi məqsəd qoyur. Bununla belə, hashtag və ya sosial media işarələrinin bəzi hallarda nifrət nitqi konteksti daşıya biləcəyi nəzərə alındıqda, təmizləmə qərarlarının məlumat itkisi yaradıb-yaratmadığı tədqiqat daxilində ayrıca ablation təcrübəsi ilə yoxlanmayıb.
\(K=3\) niyə seçilib?
Tweet cluster sayı üçün:
\[ K=2,\ldots,10 \]
aralığında Within-Cluster Sum of Squares qiymətləndirməsi aparılıb. Tədqiqat \(K=2\)-dən \(K=3\)-ə keçərkən WCSS-in %23,7 azaldığını bildirərək elbow nöqtəsini \(K=3\) kimi seçir.
Şəkil 7 həmçinin Silhouette, Davies–Bouldin və Calinski–Harabasz ölçülərini göstərir. Lakin bu köməkçi indekslərin qrafikdəki optimumları tam olaraq eyni nöqtədə birləşmir. Buna görə \(K=3\) seçimini ən düzgün şəkildə elbow analizinin üstünlük verdiyi üçlü klasterləşdirmə həlli kimi təsvir etmək lazımdır.
Niyə \(L=32\)?
Embedding ölçülərinin sayı:
\[ M=768 \]
olduğuna görə tədqiqat feature-subspace sayını square-root heuristic ilə:
\[ L\approx\sqrt{768}\approx32 \]
kimi müəyyən edir.
Bu seçim məlumatdan öyrənilmiş dəqiq optimum deyil; istifadə olunan heuristic-dən gələn hiperparametr seçimidir.
Daxili klasterləşdirmə keyfiyyəti nə göstərdi?
SWCC üçün tədqiqat dörd əsas daxili doğrulama metrikası bildirir:
| Metrika | SWCC nəticəsi | Şərh istiqaməti |
|---|---|---|
| Silhouette | 0,68 | Yüksək dəyər daha yaxşı ayrılma |
| Davies–Bouldin | 0,85 | Aşağı dəyər daha yaxşıdır |
| Calinski–Harabasz | 1580,5 | Yüksək dəyər daha yaxşıdır |
| Dunn | 0,43 | Yüksək dəyər daha yaxşı ayrılma |
On təkrarlı müqayisədə bildirilən Silhouette dəyərləri belədir:
| Metod | Silhouette |
|---|---|
| K-means + BERT | 0,45 ± 0,03 |
| LDA | 0,38 ± 0,04 |
| Spectral Clustering | 0,52 ± 0,02 |
| BERTopic | 0,58 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 |
| SWCC | 0,68 ± 0,01 |
Mənbədə eyni cədvəl üçün SWCC-nin DB, CH və Dunn dəyərlərində də müqayisə edilən metodlardan daha yaxşı nəticə verdiyi bildirilir.
Xarici qiymətləndirmədə nə əldə edildi?
Klasterlər yaradıldıqdan sonra etiketlərin %10-u cluster-to-category mapping üçün istifadə olunub və Waseem məlumat dəstində:
\[ \mathrm{Accuracy}=93{,}1\% \]
və:
\[ F1=93{,}5\% \]
bildirilib.
Tədqiqat həmçinin sinif üzrə macro F1 üçün:
\[ 0{,}89 \]
dəyərini və racism, neither və sexism üçün müvafiq olaraq təxminən:
\[ 0{,}85,\quad0{,}94,\quad0{,}89 \]
F1 dəyərlərini bildirir.
Lakin mənbədə tam confusion matrix dərc edilməyib; “sorğu əsasında əldə edilə bilər” deyilib. Bundan əlavə, məlumat dəstinin sinif nisbətlərinin bildirilməsindəki problem səbəbilə sinif üzrə nəticələrin təkrar istehsalı xüsusilə vacibdir.
Nəzarətli modelləri keçdiyini demək olarmı?
Məqalənin Cədvəl 7-də SWCC-nin F1 dəyəri bəzi nəzarətli ədəbiyyat nəticələrindən daha yüksək görünür. Məsələn, mənbədə GLTR+BERT üçün %93,1 F1, BERTweet-large üçün %90,9 və bəzi digər metodlar üçün daha aşağı dəyərlər verilir.
Lakin eyni tədqiqat tam nəzarətli metodlarla birbaşa müqayisənin uyğun olmadığını da bildirir. Bunun səbəbi:
- etiket istifadə nisbətlərinin fərqli olması,
- train/test protokollarının eyni olmaması,
- müxtəlif məqalələrdə fərqli məlumat emalı qərarlarının olması,
- SWCC-də etiketlərin cluster mapping məqsədilə sonradan istifadə edilməsidir.
Buna görə ən etibarlı nəticə:
“SWCC bildirilən skorlar baxımından bəzi ədəbiyyat nəticələri ilə rəqabətədavamlı görünür.”
şəklindədir.
“Bərabər eksperimental şərtlərdə bütün nəzarətli modellərdən daha uğurlu olduğu sübut olunub.”
nəticəsi bu eksperimental dizayndan çıxarıla bilməz.
Ablation tədqiqatı əsas mexanizm haqqında nə göstərir?
Tədqiqatın ən təmiz nəzarətli müqayisələrindən biri eyni SWCC sisteminin feature-weighting mexanizmini dəyişdirərək aparılan ablation təcrübəsidir.
Tam model:
\[ S=0{,}68 \]
Silhouette dəyərinə çatdığı halda:
\[ S_{\mathrm{no\ weighting}}=0{,}55, \]
\[ S_{\mathrm{random}}=0{,}47, \]
\[ S_{\mathrm{equal}}=0{,}51 \]
bildirilir.
Bu nəticə araşdırılan eksperimental mühitdə yalnız co-clustering strukturunun deyil, öyrənilmiş və cluster-a xas subspace weighting mexanizminin də performansa töhfə verdiyini dəstəkləyir.
Şərh edilə bilmə həqiqətən təmin olunurmu?
SWCC-nin üstünlüklərindən biri hər cluster üçün hansı altməkanların yüksək çəki aldığını göstərə bilməsidir. Mənbə daha sonra bu embedding ölçülərini yüksək aktivlik göstərən token-larla əlaqələndirərək irq əsaslı nifrət, seksist ifadə və nifrət xarici təhqiramiz dil üçün xarakterik söz qrupları çıxarır.
Lakin iki elmi sərhəd qorunmalıdır.
Birincisi, embedding dimension ilə insanın anlaya biləcəyi anlayış arasında birbaşa birə-bir semantik bərabərlik yoxdur. Xəritələmə post hoc-dur.
İkincisi, müəlliflər gələcəkdə yüksək çəkili xüsusiyyətlərin müstəqil insan qiymətləndiriciləri tərəfindən araşdırılmalı olduğunu özləri açıq tədqiqat sualı kimi saxlayırlar.
Beləliklə, tədqiqat “tam izah edilə bilən AI” hazırladığını sübut etməkdən daha çox klassik black-box embedding-lə müqayisədə xüsusiyyət çəkisi səviyyəsində əlavə şərh kanalı təqdim edir.
Implicit nifrət nitqi həqiqətən sınaqdan keçirilibmi?
Xeyr. Tədqiqatın girişində örtülü nifrət nitqinin sarcasm, kodlaşdırılmış dil və ya birbaşa təhqir ehtiva etməyən dolayı ifadələrlə ortaya çıxa biləcəyi izah olunur.
Lakin müəlliflər açıq şəkildə:
eksperimental qiymətləndirmənin Davidson və Waseem explicit-hate məlumat dəstləri üzərində aparıldığını
və dedicated implicit-hate məlumat dəstlərinin gələcəkdə istifadə ediləcəyini bildirirlər.
Buna görə tədqiqatın:
“örtülü nifrət nitqini uğurla aşkar etdiyi”
nəticəsi mövcud təcrübədən çıxarıla bilməz.
Aşağı resurslu dillər üçün nəticə varmı?
Tədqiqat annotasiya ehtiyacını azaltmasının aşağı resurslu dillər üçün faydalı ola biləcəyini irəli sürür. Lakin bütün təcrübələr ingilis dilindədir və istifadə olunan embedding modeli də ingilis dilinə yönəlib.
Müəlliflərin gələcək iş planında XLM-RoBERTa və mBERT kimi çoxdilli modellərlə dil tanıma + dilə xas subspace weighting strukturunun araşdırılması təklif olunur.
Beləliklə, aşağı resurslu dillər üçün istifadə hazırda potensial tətbiq istiqamətidir, təsdiqlənmiş nəticə deyil.
Türkiyə və türk dili baxımından bu nə deməkdir?
Tədqiqatda türk dilində məlumat istifadə edilmədiyi üçün Türkiyədəki sosial media məzmunu üçün birbaşa performans nəticəsi yoxdur.
Türk dilinə uyğunlaşdırılacaq versiyada yalnız ingilis modelini türk tweetlərinə tətbiq etmək kifayət etməz. Türk dilinin aqqlütinativ quruluşu, yerli sleng, kontekstdən asılı örtülü ayrı-seçkilik, kod dəyişdirmə, yazı variasiyaları və Türkiyədə sosial media dilinin özünəməxsus xüsusiyyətləri üçün yeni embedding və insan doğrulaması tədqiqatı tələb olunur.
Buna görə tədqiqat Türkiyə baxımından hazır moderasiya modeli deyil; türk dili üçün ayrıca sınaqdan keçirilə bilən clustering arxitekturası təqdim edir.
Tədqiqatın dəstəklədiyi nəticələr
- Araşdırılan ingilisdilli Twitter məlumat dəstlərində SWCC bildirilən daxili klasterləşdirmə metrikalarında müqayisə edilən nəzarətsiz metodlardan daha yaxşı nəticə verib.
- Ablation tədqiqatı adaptiv subspace weighting aradan qaldırıldıqda və ya pozulduqda clustering keyfiyyətinin azaldığını göstərir.
- Klaster yaratma prosesi ground-truth label-lardan istifadə edilmədən həyata keçirilib.
- %10 etiketlə aparılan post hoc cluster mapping-dən sonra Waseem qiymətləndirməsində yüksək Accuracy və F1 dəyərləri bildirilib.
- Cluster-specific subspace weights müxtəlif klasterlərdə fərqli feature bölgələrinin əhəmiyyət qazana bildiyini göstərir.
- Çərçivənin hesablama və təkrar istehsal oluna bilmə parametrlərinin mühüm hissəsi mənbədə açıq şəkildə bildirilib.
Tədqiqatın dəstəkləmədiyi və ya sübut etmədiyi nəticələr
- Sistem ucdan-uca tam etiketsiz deyil; category mapping üçün %10 label istifadə olunur.
- Implicit hate speech uğuru birbaşa sınaqdan keçirilməyib.
- Türk dili və ya digər aşağı resurslu dillərdə uğur göstərilməyib.
- Facebook, YouTube, TikTok və ya başqa platformalarda cross-platform ümumiləşdirilə bilmə test edilməyib.
- Cədvəl 7 bərabər train/test protokolunda aparılmış nəzarətli head-to-head supervised benchmark deyil.
- Feature çəkiləri birbaşa insan tərəfindən müəyyən edilmiş məna ölçüləri deyil.
- Cluster-ların insan nifrət nitqi taksonomiyası ilə tam üst-üstə düşməsi müstəqil istifadəçi tədqiqatı ilə doğrulanmayıb.
- Sistem real vaxt rejimində, milyonlarla istifadəçili sosial media istehsal infrastrukturunda sahə sınağından keçirilməyib.
- Hard assignment səbəbindən bir tweetin eyni vaxtda birdən çox nifrət kateqoriyasına aid olması ehtimalı mövcud versiyada modelləşdirilmir.
Tədqiqatın Metodu və Nəticələri
Metod axınının dörd əsas mərhələsi
Mənbə tədqiqatın 5-ci səhifəsindəki Şəkil 1 və Şəkil 2 sistemi dörd mərhələli pipeline kimi göstərir:
- Məlumatların ilkin emalı: sosial media mətninin təmizlənməsi və normallaşdırılması.
- Feature embedding: mətnin BERT-əsaslı model ilə 768 ölçülü semantik təmsilə çevrilməsi.
- SWCC: tweet və feature altməkanlarının birlikdə klasterləşdirilməsi, cluster-specific çəkilərin öyrənilməsi.
- Qiymətləndirmə: daxili clustering metrikaları və %10 etiketli post hoc category mapping ilə xarici qiymətləndirmə.
Modelin dörd əsas çıxışı
| Obyekt | Mənası | Mənbədə bildirilən eksperimental ölçü |
|---|---|---|
| \(U\) | Tweet → cluster üzvlük matrisi | \((19.971,3)\) kimi bildirilir |
| \(V\) | Feature dimension → subspace üzvlük matrisi | \((768,32)\) |
| \(Z\) | Centroid strukturu | Eksperiment bölməsində \((3,768)\) kimi bildirilir |
| \(C\) | Cluster → subspace çəkiləri | \((3,32)\) |
Buradakı \(U=(19.971,3)\) ilə tədqiqatın başqa bölmələrində verilən 24.783 tweetlik embedding matrisi arasında mənbədə izah olunmamış nümunə sayı fərqi mövcuddur.
Daxili metrikaların müqayisəsi
| Metod | Silhouette ↑ | DB ↓ | CH ↑ | Dunn ↑ |
|---|---|---|---|---|
| K-means (BERT) | 0,45 ± 0,03 | 1,42 ± 0,15 | 980,2 ± 45,3 | 0,28 ± 0,02 |
| LDA | 0,38 ± 0,04 | 1,65 ± 0,18 | 720,5 ± 38,2 | 0,21 ± 0,03 |
| Spectral Clustering | 0,52 ± 0,02 | 1,18 ± 0,12 | 1205,7 ± 52,1 | 0,35 ± 0,02 |
| BERTopic | 0,58 ± 0,02 | 1,05 ± 0,10 | 1350,8 ± 48,7 | 0,39 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 | 1,55 ± 0,16 | 850,3 ± 42,5 | 0,25 ± 0,02 |
| SWCC | 0,68 ± 0,01 | 0,85 ± 0,08 | 1580,5 ± 35,2 | 0,43 ± 0,01 |
Mənbə bu dəyərlərin 10 işə salmanın orta ± standart yayınması olduğunu bildirir.
Verianla Live: Adaptiv çəkiləndirmənin ablation nəticəsinə təsiri
Eyni ablation cədvəlində full SWCC üçün:
\[ DB=0{,}85,\qquad CH=1580{,}5,\qquad Dunn=0{,}43 \]
bildirilib. Çəkiləndirməsiz modeldə bu dəyərlər müvafiq olaraq:
\[ 1{,}10,\qquad1250{,}3,\qquad0{,}36 \]
olub.
Bu nəzarətli təcrübə tədqiqatın ən güclü mexanizm sübutlarından biridir; çünki müqayisə olunan şey fərqli məqalələrdən gələn sistemlər deyil, eyni arxitekturanın weighting komponenti dəyişdirilmiş variantlarıdır.
Waseem xarici qiymətləndirməsi
| Model | Accuracy | F1 |
|---|---|---|
| SWCC | %93,1 | %93,5 |
| GLTR with BERT | %92,7 | %93,1 |
| BERTweet-large | Mənbədə verilməyib | %90,90 |
| CAT Boost | %89,03 | %87,74 |
| RoBERTa-based transformer | %86 | %86 |
| AAEBERT | Mənbədə verilməyib | %46,2 |
| BERTweet trained on GPT-4 | Mənbədə verilməyib | %90,1 |
Bu cədvəli qiymətləndirərkən metodların etiket istifadəsi və eksperimental protokollarının eyni olmadığı unudulmamalıdır. Mənbənin öz qeydi SWCC-nin label-ların %10-unu post hoc cluster mapping üçün istifadə etdiyini, supervised müqayisələrin isə tipik olaraq daha böyük etiketlənmiş train hissələrindən istifadə etdiyini vurğulayır.
Təkrar istehsal oluna bilmə üçün verilən proqram mühiti
| Komponent | Mənbədə verilən dəyər |
|---|---|
| Python | 3.9.12 |
| PyTorch | 1.12.1 |
| Transformers | 4.21.1 |
| NumPy | 1.21.5 |
| Scikit-learn | 1.0.2 |
| Random seed | 42 |
| HateBERT maksimum uzunluq | 512 token |
| Embedding batch size | 8 |
| \(K\) | 3 |
| \(L\) | 32 |
| \(\eta\) | 0,5 |
| SWCC iterasiya sayı | 30 |
Avadanlıq mühiti
Tədqiqat Google Colab mühitini; təxminən 12–25 GB RAM, 2 vCPU Intel Xeon və sessiya ayrılmasından asılı olaraq NVIDIA Tesla V100 və ya T4 GPU ilə bildirir.
Bu məlumatlar təkrar istehsal oluna bilmə baxımından faydalıdır. Lakin istifadə olunan embedding modelinin adı müxtəlif bölmələrdə fərqli verildiyinə görə eyni proqram təminatı və seed dəyərlərindən istifadə etmək təkbaşına birə-bir replikasiyaya zəmanət vermir.
Mənbə daxilində model identifikatoru uyğunsuzluğu
Metod bölməsində istifadə olunan model:
GroNLP/HateBERT
kimi göstərildiyi halda, təkrar istehsal oluna bilmə bölməsində:
Hate-speech-CNERG/bert-base-uncased-hatexplain
yazılır.
Bunlar fərqli model mənbələri olduğuna görə aşağıdakı suallar mənbə mətnindən qəti şəkildə cavablandırıla bilmir:
- Bildirilən 768 ölçülü embedding-lər hansı checkpoint-dən yaradılıb?
- Model fallback-i hansı şərtlərdə işə düşüb?
- Yekun performans cədvəlləri hansı checkpoint-ə aiddir?
- Fərqli checkpoint-lərin SWCC nəticələri ayrıca sınaqdan keçirilibmi?
Buna görə Verianla mətni bütün nəticələri səssizcə “orijinal GroNLP HateBERT nəticəsi” kimi yenidən etiketləmir.
Mənbə daxilində məlumat dəsti uyğunsuzluqları
Waseem məlumat dəsti üçün mənbədə verilən sinif faizləri öz daxilində cəmi %100-ü aşır. Davidson məlumat dəsti üçün bildirilən %22,8 / %51,8 / %25,4 paylanması da tədqiqatın istinad etdiyi standart Davidson məlumat dəstinin geniş yayılmış sinif paylanması ilə uyğun gəlmir.
Bu problem birbaşa clustering metodunun riyazi tərifini etibarsız etmir; lakin Accuracy/F1 nəticələrinin hansı dəqiq label paylanması və hansı məlumat versiyası üzərində yaradıldığının müstəqil şəkildə təkrar istehsalı baxımından vacibdir.
Centroid və başlanğıc çəkisinin göstərilməsində uyğunsuzluq
Riyazi notation cədvəli centroid-i:
\[ Z\in\mathbb R^{K\times L} \]
kimi təyin etdiyi halda tətbiq bölməsində:
\[ Z=(3,768) \]
şəklində \(K\times M\) ölçüsü verilir.
Eyni şəkildə alqoritmdən əvvəlki izahda başlanğıc çəkisinin \(1/K\) olduğu bildirildiyi halda Algorithm 1 daxilində:
\[ C^{(0)}\leftarrow[1/L] \]
yazılır.
Bu fərqlər xüsusilə metodu koddan yenidən həyata keçirmək istəyən tədqiqatçılar üçün aydınlaşdırılmalı məqamlardır.
Modelin əsas güclü tərəfləri
- Klaster yaradarkən ground-truth siniflərinə ehtiyac duymaması.
- Tweet və feature subspace strukturlarını eyni vaxtda modelləşdirməsi.
- Hər klaster üçün ayrıca feature/subspace əhəmiyyət çəkiləri öyrənməsi.
- Çəkiləndirmə mexanizminin ablation ilə sınaqdan keçirilməsi.
- Birdən çox daxili clustering metrikası bildirməsi.
- Hiperparametr həssaslıq analizi təqdim etməsi.
- Proqram versiyası, seed, avadanlıq və runtime məlumatlarının mühüm hissəsini paylaşması.
- Klaster nəticəsini yalnız bir Accuracy dəyərinə endirməyib daxili struktur metrikaları ilə də qiymətləndirməsi.
Əsas məhdudiyyətlər
- Təcrübələr yalnız ingilisdilli Twitter məlumatlarıdır.
- Implicit hate üçün dedicated test set istifadə olunmayıb.
- Kateqoriya adlandırılması üçün %10 label tələb olunur.
- Hard cluster assignment istifadə olunur; çoxlu/üst-üstə düşən kateqoriya üzvlükləri modelləşdirilmir.
- Embedding keyfiyyəti seçilmiş dil modelindən asılıdır.
- Feature-to-word şərhləndirmə prosesi post hoc-dur və müstəqil insan doğrulaması aparılmayıb.
- Cross-platform test yoxdur.
- Məlumat dəsti sinif nisbətlərində mənbə-daxili uyğunsuzluqlar var.
- İstifadə olunan transformer checkpoint-in identifikatoru iki fərqli şəkildə bildirilib.
- 24.783 embedding ilə 19.971 cluster-assignment sətri arasındakı fərq izah olunmayıb.
- Supervised modellərlə cədvəl şəklində müqayisələr vahid ortaq eksperimental protokoldan gəlmir.
Gələcək tədqiqatlar
Müəlliflər dörd əsas istiqamət təklif edirlər:
- Çoxdillilik: mBERT və ya XLM-RoBERTa kimi modellərlə dilə xas və ortaq nifrət nitqi altməkanlarının araşdırılması.
- İnsan tərəfindən şərh edilə bilən doğrulama: annotator-ların yüksək çəkili feature-ları araşdıraraq cluster mənasını doğrulaması.
- Embedding model müqayisəsi: domain specificity, hesablama xərci və kontekstual anlama arasında tarazlıq yaradan alternativ modellərin sınaqdan keçirilməsi.
- Fuzzy clustering: tweetin birdən çox kateqoriyaya qismən üzvlük göstərə bilməsini təmin edən probabilistic/fuzzy genişləndirmələr.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: An Unsupervised Subspace Weighting Co-Clustering Framework for Hate Speech Detection Patterns in Social Media
Müəlliflər: Maya Sultan ALGhafri; Imran Khan; Abdelhamid Abdesselam.
Bərabər birinci/bərabər töhfə: Mənbədə bərabər birinci və ya bərabər töhfə bəyanı yoxdur.
Məsul müəllif: Maya Sultan ALGhafri.
Qurum: Department of Computer Science, Sultan Qaboos University, Muscat 123, Oman.
Mənbə növü: Rəyli orijinal tədqiqat məqaləsi; təbii dil emalı, maşın öyrənməsi və klasterləşdirmə tədqiqatı.
Jurnal: AI.
Nəşriyyat: MDPI, Basel, İsveçrə.
Biblioqrafik qeyd: AI, 2026, Cild 7, Say 6, Məqalə 204.
DOI: 10.3390/ai7060204.
Qəbul / reviziya / qəbul olunma / nəşr: 26 aprel 2026 / 20 may 2026 / 27 may 2026 / 4 iyun 2026.
Rəyləndirmə statusu: Rəyli jurnal nəşridir.
Lisenziya: Creative Commons Attribution (CC BY).
Akademik redaktorlar: Michal Ptaszynski; Rafal Rzepka; Hisami Suzuki.
Əsas metod: BERT-əsaslı kontekstual embedding-lər ilə Subspace Weighting Co-Clustering (SWCC).
SWCC strukturu: Tweet klasterləri \(U\), feature-subspace təyinatları \(V\), centroid strukturu \(Z\) və cluster-specific subspace weighting matrisi \(C\) birlikdə iterativ şəkildə optimallaşdırılır.
Eksperimental embedding ölçüsü: 768.
Tweet cluster sayı: \(K=3\).
Feature-subspace sayı: \(L=32\).
Regularization: \(\eta=0,5\).
Əsas məlumat dəstləri: Davidson et al. (2017) Hate Speech and Offensive Language məlumat dəsti və Waseem/Hovy ingilisdilli Twitter hate-speech məlumat dəsti.
Etiket istifadəsi: Cluster formation zamanı ground-truth label istifadə edilmədiyi bildirilir. Xarici category mapping və evaluation üçün label-ların ən az %10-u post hoc istifadə olunur. Buna görə sistemin clustering nüvəsi nəzarətsiz olsa da, ucdan-uca kateqoriya istehsalı tam etiketsiz deyil.
Ən mühüm daxili clustering nəticəsi: SWCC üçün Silhouette 0,68 ± 0,01; Davies–Bouldin 0,85 ± 0,08; Calinski–Harabasz 1580,5 ± 35,2; Dunn 0,43 ± 0,01.
Waseem üzərində bildirilən xarici nəticə: %93,1 Accuracy və %93,5 F1; %10 label ilə post hoc cluster-to-category mapping-dən sonra.
Ablation nəticəsi: Silhouette tam SWCC-də 0,68; weighting olmadan 0,55; random weighting ilə 0,47; equal weighting ilə 0,51.
Hesablama mürəkkəbliyi: Mənbə bir SWCC iterasiyasını \(O(NKML)\) kimi verir.
Mənbədə verilən runtime: Embedding istehsalı təxminən 2887 saniyə; SWCC 30 iterasiya; hər iterasiya üçün təxminən 2–3 saniyə; tam pipeline təxminən 50–55 dəqiqə.
Eksperimental mühit: Python 3.9.12; PyTorch 1.12.1; Transformers 4.21.1; NumPy 1.21.5; Scikit-learn 1.0.2; Google Colab; seed 42.
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almadığını bildirir.
Etika komitəsi: Tətbiq edilə bilməz kimi göstərilib.
Məlumatlandırılmış razılıq: Tətbiq edilə bilməz kimi göstərilib.
Məlumat əlçatanlığı: Mənbə Davidson və Waseem məlumat dəstlərinin açıq repository-lərdən əldə edildiyini bildirir.
Müəllif töhfələri: Konseptuallaşdırma M.S.A.; metodologiya M.S.A. və I.K.; proqram təminatı, doğrulama, formal analiz, araşdırma, resurslar, məlumat kurasiyası, ilkin qaralama və vizuallaşdırma M.S.A.; nəzərdən keçirmə və redaktə M.S.A.; rəhbərlik I.K. və A.A.; layihə idarəçiliyi və maliyyə əldə etmə M.S.A. kimi bildirilib.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması bildirməyiblər.
Mənbəyə sadiqlik baxımından kritik təkrar istehsal oluna bilmə qeydləri
Tədqiqatın metod bölməsində embedding modeli GroNLP/HateBERT kimi təsvir olunduğu halda, təkrar istehsal oluna bilmə bölməsində Hate-speech-CNERG/bert-base-uncased-hatexplain adı verilir. Bu iki checkpoint eyni model deyil. Buna görə hansı checkpoint-in yekun performans cədvəllərini yaratdığı mənbə mətnindən dəqiq müəyyən edilə bilmir.
Bundan əlavə, istifadə olunan məlumat dəstlərinin sinif paylanmaları ilə bağlı mənbə daxilində və orijinal məlumat mənbələri ilə uyğunsuzluqlar var. Waseem üçün Cədvəl 4-dəki nisbətlərin cəmi %100-ü aşır. Davidson üçün bildirilən sinif nisbətləri də standart açıq məlumat faylındakı label paylanması ilə uyğun gəlmir. Buna görə xüsusilə external Accuracy/F1 dəyərlərinin müstəqil replikasiyası zamanı xam məlumat versiyası və preprocessing çıxışı yoxlanmalıdır.
Riyazi notation-da \(Z\) centroid matrisinin ölçüsü və başlanğıc subspace çəkisi üçün də fərqli ifadələr var. Bundan əlavə, Algorithm 1-dən sonra dərc olunmuş mətndə qalan “Please remove it from the final published version.” ifadəsi redaksiya istehsal qalığıdır.
Bu uyğunsuzluqlar Verianla mətnində səssizcə vahid “doğru” versiyaya çevrilməyib. Çünki alternativlərdən hansının müəlliflərin real eksperimental kodunu təmsil etdiyi mənbə tədqiqat tərəfindən qəti şəkildə izah olunmur.
Elmi şərh sərhədi
Bu tədqiqatdakı %93,1 Accuracy və %93,5 F1 dəyərləri sıfır insan etiketi istifadə edən tam avtonom nifrət nitqi kateqoriyalaşdırma sisteminin nəticəsi deyil. Etiketlərin %10-u post hoc kateqoriya uyğunlaşdırması üçün istifadə olunur.
Tədqiqatın implicit hate speech haqqındakı motivasiyası vacib olsa da, eksperimental nəticələr explicit-hate yönümlü Davidson və Waseem məlumat dəstlərinə əsaslanır. Buna görə implicit hate uğur faizi bildirilməyib.
Supervised modellərlə Cədvəl 7-də aparılan müqayisələr də ortaq train/test split, ortaq preprocessing və ortaq label büdcəsi ilə aparılan vahid benchmark təcrübəsi deyil. Buna görə SWCC-nin bəzi dərc olunmuş skorları aşması bütün bu modellər üzərində nəzarətli statistik üstünlüyün sübutu kimi şərh edilməməlidir.
Nəhayət, model yalnız ingilisdilli Twitter məlumatlarında qiymətləndirilib. Başqa dillər, başqa sosial media platformaları və real vaxt istehsal moderasiya sistemləri üçün ayrıca doğrulama tələb olunur.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib