

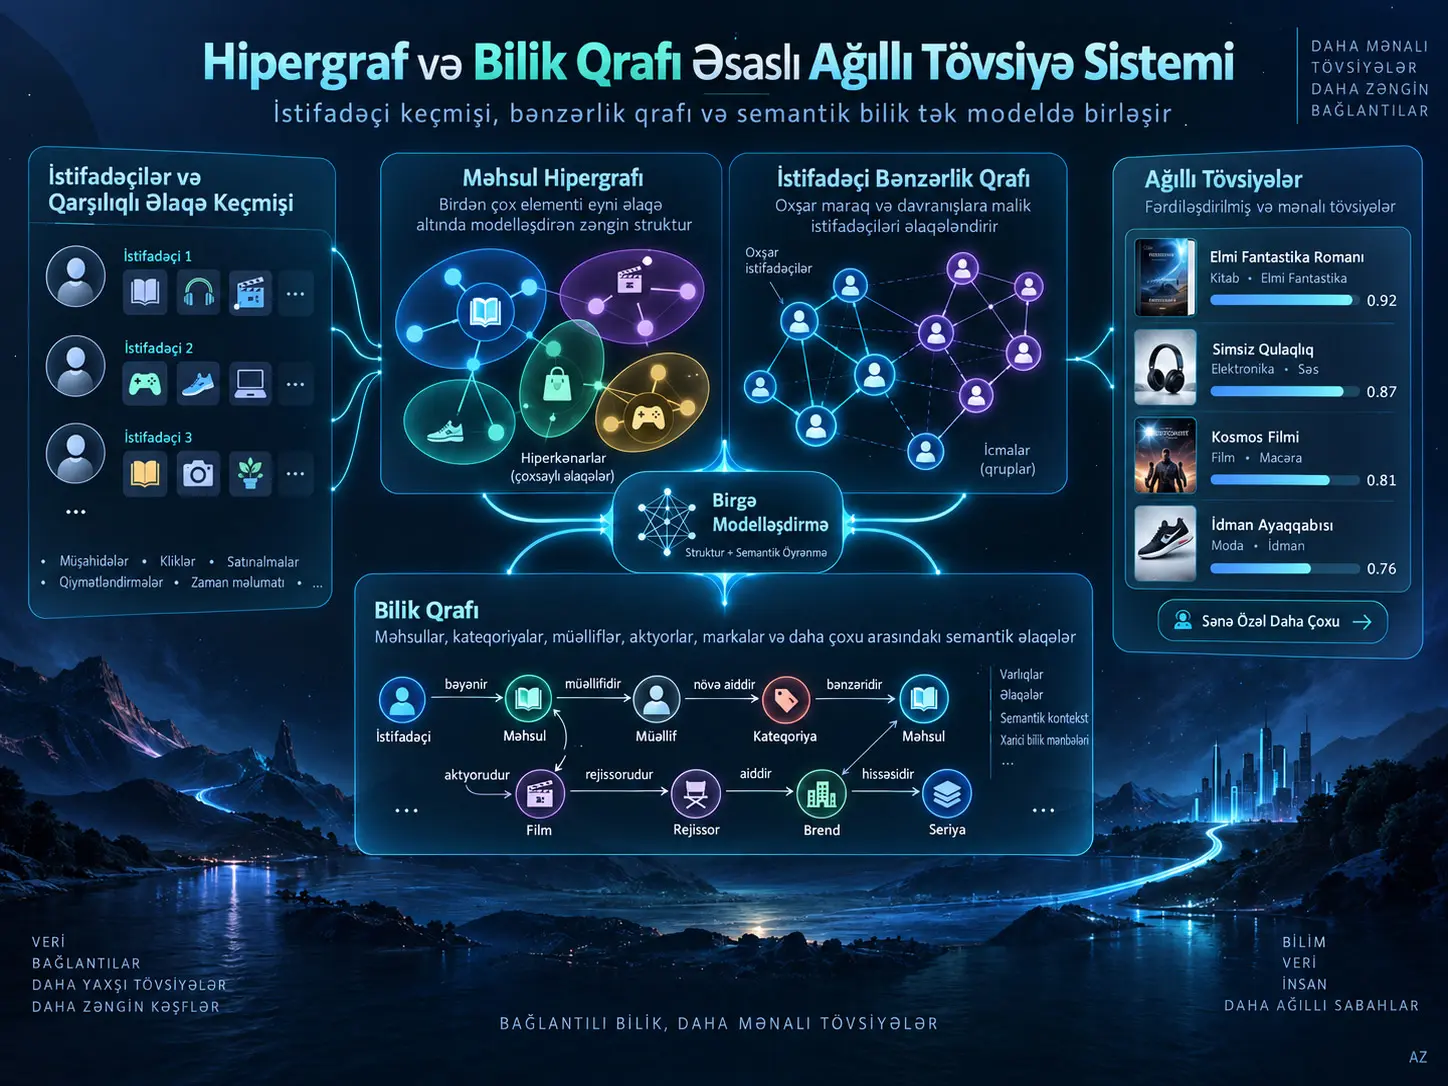
Bu tədqiqat, seyrək istifadəçi–element qarşılıqlı əlaqələrində yalnız ikili istifadəçi–element bağlantılarına əsaslanan ənənəvi tövsiyə üsullarının nəzərdən qaçıra bildiyi yüksək dərəcəli əməkdaşlıq strukturunu və elementlərin xarici semantik biliklərini eyni modeldə birləşdirən bilik-fərqində olan tövsiyə sistemi çərçivəsini araşdırır. Təklif olunan çərçivə; istifadəçi tarixçələrindən yaradılan bir element hipergrafı, başlanğıc istifadəçi təsvirlərini lokal şəkildə təkmilləşdirən top-k istifadəçi oxşarlıq qrafı və elementlərin bilik qrafındakı bir-atlamalı qonşularını istifadəçidən asılı münasibət çəkiləri ilə birləşdirən bilik qrafı aqreqatorundan ibarətdir. Hipergraf, ikili bağlantıdan kənarda eyni istifadəçi tarixçəsində birlikdə görünən elementlərin qrup səviyyəli strukturunu öyrənərkən, bilik qrafı qolu elementlərə semantik kontekst qazandırır. Son istifadəçi və element təsvirləri çoxqatlı perseptrona ötürülür və model istifadəçi–element uyğunluq balı yaradır.
MovieLens-1M, Last.FM və Book-Crossing məlumat dəstlərində aparılan sabit oflayn benchmark qiymətləndirməsində təklif olunan model, məqalədə müqayisə edilən LightGCN, ENMF, NeuMF və HMKRec üsullarına qarşı AUC, dəqiqlik və Recall@K meyarlarında ümumilikdə güclü nəticələr göstərmişdir. Məsələn, sabit benchmark protokolunda MovieLens-1M üçün AUC 0,8737 və ACC 0,7202; Last.FM üçün AUC 0,8620 və ACC 0,6954; Book-Crossing üçün AUC 0,7287 və ACC 0,5623 bildirilmişdir. Bununla belə, bu nəticələr yalnız tədqiqatda istifadə olunan məlumat emalı, mənfi nümunələmə və namizəd siyahılama protokolu çərçivəsində qiymətləndirilməlidir. Tədqiqat modelin bütün tövsiyə sistemlərində universal şəkildə üstün olduğunu və ya oflayn benchmark uğurunun birbaşa real dünya istifadəçi məmnuniyyətinə çevrildiyini göstərmir.
Tövsiyə sistemlərində əsas problem
Bir tövsiyə sistemi müəyyən bir istifadəçinin hansı film, mahnı, kitab və ya başqa elementlə maraqlanma ehtimalının yüksək olduğunu təxmin etməyə çalışır. Ən sadə əməkdaşlıq əsaslı filtrləmə yanaşmaları bu təxmini keçmiş istifadəçi–element qarşılıqlı əlaqələrindən çıxarır. Lakin real məlumat dəstlərində istifadəçilərin kataloqdakı elementlərin çox kiçik bir hissəsi ilə qarşılıqlı əlaqəyə girməsi səbəbindən qarşılıqlı əlaqə matrisi adətən son dərəcə seyrək olur.
Bu seyrək struktur iki mühüm məlumat itkisinə səbəb ola bilər. Birincisi, standart istifadəçi–element qrafı əsasən ikili bağlantıları təmsil edir və eyni istifadəçinin tarixçəsində birlikdə olan çoxsaylı elementlərin yaratdığı qrup strukturunu birbaşa kodlaşdırmır. İkincisi, yalnız qarşılıqlı əlaqə qeydlərinə baxıldıqda elementlərin növü, münasibətləri və ya xarici bilik bazasındakı semantik əlaqələri yetərincə istifadə edilmir.
Tədqiqatın əsas yanaşması bu iki məlumat mənbəyini ayrı, lakin bir-birini tamamlayan qollarda emal etməkdir. İstifadəçi tarixçələri hipergraf üzərindən yüksək dərəcəli əməkdaşlıq strukturu yaradır; bilik qrafı isə elementlərin semantik kontekstini təmin edir. Bunlara əlavə olaraq, istifadəçilərin ilkin təsvirləri arasındakı oxşarlıqlar ayrıca istifadəçi qrafında yayılır.
Hipergraf Bu Tövsiyə Sistemində Nəyi Təmsil Edir?
Bu tədqiqatdakı hipergraf, düyünlərini elementlərin təşkil etdiyi və hər bir istifadəçinin keçmişdə qarşılıqlı əlaqə qurduğu elementlər dəstinin vahid hiper-kənar kimi təmsil edildiyi yüksək dərəcəli münasibət strukturudur. Beləliklə, adi qrafın iki düyün arasındakı tək bağlantısından fərqli olaraq, bir istifadəçinin eyni tarixçə daxilində seçdiyi çoxsaylı elementlər ortaq bir hiper-kənar altında birlikdə modelləşdirilə bilər.
İstifadəçi çoxluğu \(U\), element çoxluğu \(V\) və istifadəçi \(u\)-nun qarşılıqlı əlaqə qurduğu elementlər \(I_u\) ilə göstərildikdə istifadəçiyə uyğun hiper-kənar belə müəyyən edilir:
\[ e_u=\{v\mid v\in I_u\} \]
Burada mühüm detal istifadəçinin hipergraf düyünü olmamasıdır. Hipergrafın düyünləri elementlərdir; istifadəçinin tarixçəsi isə bu elementləri bir-birinə bağlayan hiper-kənarı müəyyən edir. Bu dizayn, məsələn, eyni istifadəçinin seçdiyi beş elementi beş ayrı ikili bağlantı kimi görmək əvəzinə həmin beş elementin ortaq davranış kontekstini vahid struktur vahidində ifadə etməyə imkan verir.
Hipergrafın insidens matrisi \(H\), bir elementin müəyyən hiper-kənara aid olub-olmadığını göstərir:
\[ H_{v,e_u}= \begin{cases} 1, & v\in e_u\\ 0, & \text{aksi halde} \end{cases} \]
Hipergraf konvolyusiyası zamanı məlumat əvvəlcə elementlərdən hiper-kənarlara, sonra isə hiper-kənarlardan yenidən elementlərə yayılır. Mənbədə istifadə olunan əsas yayılma strukturu:
\[ X^{(l+1)}= \sigma\left( D_v^{-1/2} H D_e^{-1} H^{T}D_v^{-1/2} X^{(l)}W^{(l)} \right) \]
şəklindədir. Burada \(X^{(l)}\), \(l\)-ci qatda element embedding matrisini; \(W^{(l)}\), öyrənilə bilən çəki matrisini; \(D_v\), element dərəcə matrisini; \(D_e\), hiper-kənar dərəcə matrisini; \(\sigma\) isə aktivasiya funksiyasını təmsil edir. Normallaşdırılmış matris hasili, çox tez-tez görünən elementlərin yalnız yüksək bağlantı sayına görə yayılmanı nəzarətsiz şəkildə dominant etməsini azaltmağa kömək edir.
Element təsvirlərindən istifadəçi təsvirinə keçid
Hipergraf qatları ilk mərhələdə birbaşa istifadəçi embedding-i yaratmır. Əvvəlcə yüksək dərəcəli münasibətləri daşıyan element embedding-ləri öyrənilir. Daha sonra hər istifadəçi üçün həmin istifadəçinin qarşılıqlı əlaqə qurduğu elementlərin son hipergraf təsvirləri ortalanaraq ilkin istifadəçi vektoru əldə edilir:
\[ h_u^{(0)} = \frac{1}{|I_u|} \sum_{v\in I_u} x_v^{(L_h)} \]
Bu fərq modelin arxitekturasını anlamaq baxımından mühümdür: hipergraf qolu “istifadəçi düyünlərini” birbaşa emal etmir, istifadəçi tarixçəsinin yaratdığı hiper-kənarlar üzərindən elementləri emal edir və istifadəçi təsviri sonradan bu element təsvirlərindən törədilir.
İstifadəçi Oxşarlıq Qrafı Niyə İkinci İstifadəçi Modelləşdirmə Mərhələsi Əlavə Edir?
İstifadəçi oxşarlıq qrafı, hipergrafdan törədilən ilkin istifadəçi embedding-lərini bir-birinə yaxın istifadəçilər arasında yayaraq lokal üstünlük oxşarlığını modelləşdirən ikinci istifadəçi-təsvir mərhələsidir. Hipergraf daha geniş qrup səviyyəli ortaq element strukturunu tutarkən, oxşarlıq qrafı embedding məkanında bir-birinə yaxın istifadəçilərin məlumatını birbaşa qonşuluq münasibəti kimi emal edir.
İki istifadəçinin oxşarlığı ilkin istifadəçi vektorlarının kosinus oxşarlığı ilə hesablanır:
\[ S(u_i,u_j) = \frac{ h_{u_i}^{T}h_{u_j} }{ \|h_{u_i}\|\|h_{u_j}\| } \]
Bütün istifadəçi cütlərini tam bağlı qrafa çevirmək həm hesablama xərcini, həm də mənasız zəif bağlantıları artıracağından model hər istifadəçi üçün yalnız ən yüksək oxşarlığa malik 50 istifadəçini saxlayır. Beləliklə top-k seyrəkləşdirilmiş istifadəçi qrafı əldə edilir.
Tədqiqatın mövcud tətbiqində bu istifadəçi qrafı təlim boyunca dinamik olaraq yenidən yaradılmır. Hipergrafdan hovuzlaşdırılmış ilkin istifadəçi vektorlarından bir dəfə yaradılır və sabit saxlanılır. İstifadəçi qrafı qolunda bir qraf yayılma qatı istifadə olunur; müəlliflər bunu həddindən artıq hamarlanma riskini məhdudlaşdıran dizayn kimi təqdim edirlər.
Statik hipergraf fərziyyəsi
Hipergraf da keçmiş qarşılıqlı əlaqələrdən çıxarılan sabit oflayn görüntü kimi istifadə olunur. Bu seçim MovieLens-1M, Last.FM və Book-Crossing kimi sabit benchmark məlumat dəstləri ilə uyğundur. Lakin istifadəçi üstünlükləri zamanla dəyişə bildiyindən bu fərziyyə canlı istehsal mühitlərində ayrıca sınaqdan keçirilməlidir. Tədqiqatın özü zaman üzrə üstünlük sürüşməsini modelləşdirmir və dinamik hipergraf inkişafını gələcək iş mövzusu kimi saxlayır.
Bilik Qrafı İstifadəçiyə Xüsusi Element Təsvirini Necə Yaradır?
Bilik qrafı qolu hər bir elementi bilik qrafındakı uyğun entity ilə eşləşdirir və həmin entity-nin bir-atlamalı qonşularından semantik məlumat toplayır. Bu toplama prosesi sabit qonşu ortalaması deyil; hansı münasibətin daha vacib olduğu hədəf istifadəçiyə görə çəkiləndirilir. Beləliklə eyni elementin semantik təsviri müxtəlif istifadəçilər üçün fərqli münasibət vurğularına malik ola bilər.
Modeldə hər element üçün 16 bilik qrafı qonşusu saxlanılır. Entity və relation embedding-ləri əvvəlcə DistMult ilə yüngül ön təlimdən keçirilir və sonra tövsiyə sistemi ilə birlikdə incə tənzimlənir.
İstifadəçi \(u\) və münasibət növü \(r\) üçün üstünlük əmsalı softmax quruluşu ilə hesablanır:
\[ \alpha_{u,r} = \frac{ \exp(z_u^{T}r) }{ \sum_{r'\in\mathcal{R}_u} \exp(z_u^{T}r') } \]
Bu əmsal, istifadəçi embedding-i ilə münasibət embedding-i arasındakı uyğunluğa görə müəyyən münasibət növlərini daha çox və ya daha az təsirli edir. Daha sonra hədəf entity \(e_v\) ilə qonşu entity-lər birləşdirilərək istifadəçiyə şərtlənmiş semantik element təsviri yaradılır:
\[ z_{u,v} = \sigma \left( W_e \left[ e_v+ \sum_{(r,e_j)\in\mathcal{N}(e_v)} \alpha_{u,r}e_j \right] \right) \]
Bu mexanizm çox-atlamalı KG mesajlaşması deyil. Tədqiqatda xüsusilə bir-atlamalı qonşuluq istifadə olunur. Buna görə nəticələr “dərin bilik qrafı mühakiməsi” kimi şərh edilməməlidir.
Proqnoz vektoru və MLP
Son mərhələdə təkmilləşdirilmiş istifadəçi embedding-i ilə istifadəçiyə xüsusi element embedding-i birləşdirilir. Mənbənin kompakt tənliyində istifadəçi və element vektorları ilə element-bazlı qarşılıqlı təsir istifadə olunsa da, alqoritmik izah həmçinin mütləq fərq komponentinin də tam deskriptora daxil edildiyini bildirir. Buna görə tədqiqatın mətn izahı ilə kompakt Tənlik (8) arasında təqdimat səviyyəsində fərq mövcuddur; Verianla izahında bu fərq gizlədilməməlidir.
MLP proqnozu ümumilikdə:
\[ \hat y_{u,v} = \sigma \left( W_2\, \phi(W_1x_{u,v}+b_1)+b_2 \right) \]
şəklindədir. Burada \(\phi\), ReLU aktivasiya funksiyasını; son sigmoid qatı isə istifadəçi–element cütünün müsbət qarşılıqlı əlaqə ehtimalına uyğun balı yaradır.
Populyarlıq Düzəlişi Modelin Öyrəndiyi Əsas Mexanizmdirmi?
Xeyr. Populyarlıq-fərqində olan proses, əsas modelin təlim arxitekturasını əvəz edən başlıca öyrənmə mexanizmi deyil, yaradılmış tövsiyə ballarına istəyə bağlı tətbiq edilə bilən yüngül son-emal kalibrlənməsidir. Tədqiqat bu addımın “uzun quyruq performansını təkbaşına təmin edən mexanizm” kimi şərh edilməməli olduğunu xüsusilə məhdudlaşdırır.
Mənbədə verilən son-bal düzəlişi:
\[ y'_{u,v} = \hat y_{u,v} - \lambda\log(1+\mathrm{pop}(v)) \]
şəklindədir. Burada \(\mathrm{pop}(v)\), elementin təlim məlumatındakı qarşılıqlı əlaqə sayını; \(\lambda\) isə doğrulama protokolunda tənzimlənən əmsalı təmsil edir. Populyar elementin qarşılıqlı əlaqə sayı artdıqca loqarifmik cəza böyüyür və yekun sıralamadakı həddindən artıq üstünlüyü azaldıla bilər.
Lakin tədqiqatda bu son-emal komponentinin izolə olunmuş təsirini ölçən müstəqil ablasiya yoxdur. Buna görə modelin uzun quyruq davranışındakı dəyişikliyin nə qədərinin bu düzəlişə, nə qədərinin hipergraf/KG strukturuna aid olduğunu dəqiq ayırmaq mümkün deyil.
Təlim itkisi
Model müşahidə olunan müsbət istifadəçi–element cütləri və nümunələnmiş mənfi cütlər üzərində nöqtəvi binary cross-entropy ilə öyrədilir:
\[ \mathcal{L} = - \sum_{(u,v)\in\mathcal{Y}^{+}} \log \hat y_{u,v} - \sum_{(u,v)\in\mathcal{Y}^{-}} \log(1-\hat y_{u,v}) \]
Bu itki müsbət qarşılıqlı əlaqələrin yüksək, mənfi nümunələrin isə aşağı bal almasını təşviq edir. Buradakı “mənfi” istifadəçinin həqiqətən elementi bəyənmədiyini mütləq göstərmir; tədqiqat protokolunda müşahidə olunmamış elementlər arasından nümunələnən təlim cütlərini ifadə edir.
Qiymətləndirmə metrikləri
Tədqiqat bağlantı proqnozu üçün Accuracy (ACC) və ROC əyrisinin altında qalan sahəni göstərən AUC; Top-K tövsiyə üçün isə Recall@K istifadə edir.
\[ ACC= \frac{TP+TN} {TP+TN+FP+FN} \]
AUC təsadüfi seçilmiş müsbət qarşılıqlı əlaqəyə təsadüfi seçilmiş mənfi qarşılıqlı əlaqədən daha yüksək bal vermə ehtimalı üzərindən modelin sıralama ayırdetmə qabiliyyətini ölçür.
Bir istifadəçi üçün Recall@K:
\[ Recall@K(u) = \frac{ |\mathcal{R}_u(K)\cap\mathcal{T}_u| }{ |\mathcal{T}_u| } \]
kimi hesablanır. Burada \(\mathcal{R}_u(K)\), istifadəçiyə tövsiyə edilən ilk K elementi; \(\mathcal{T}_u\) isə test məlumatındakı həqiqi müsbət elementləri təmsil edir. Sistem səviyyəli Recall@K istifadəçi-bazlı dəyərlərin makro ortalamasıdır.
Tədqiqatın Metodu və Nəticələri
Məlumat dəstləri və ön emal
Tədqiqat üç fərqli sahəni təmsil edən MovieLens-1M, Last.FM və Book-Crossing benchmarklarını istifadə edir. Film, musiqi və kitab sahələrinin birlikdə qiymətləndirilməsi modelin yalnız bir qarşılıqlı əlaqə strukturundan asılı olub-olmadığını müşahidə etmək baxımından vacibdir.
| Məlumat dəsti | İstifadəçi | Element | Qarşılıqlı əlaqə | KG münasibət növü | KG entity | KG üçlüsü |
|---|---|---|---|---|---|---|
| MovieLens-1M | 5.148 | 2.380 | 553.277 | 2 | 96 | 6.706 |
| Last.FM | 1.265 | 606 | 41.879 | 1 | 9.749 | 28.383 |
| Book-Crossing | 8.380 | 12.634 | 91.810 | 3 | 5.213 | 36.375 |
MovieLens-1M-də 4 və daha yüksək ballar müsbət dolayı geribildirim kimi işarələnir. Last.FM-in dolayı geribildirim strukturu və Book-Crossing-in yüksək seyrəkliyi səbəbindən saxlanılan keçmiş qarşılıqlı əlaqələr müsbət qəbul edilir. Minimum dəstək həddi MovieLens-1M və Last.FM üçün 20 qarşılıqlı əlaqə; Book-Crossing üçün uyğunlaşdırılmış fallback-dən sonra 3 qarşılıqlı əlaqədir.
Emaldan sonra məlumat dəstlərinin seyrəkliyinin müvafiq olaraq %95,48, %94,54 və %99,91 olduğu bildirilmişdir. Bu dəyərlər xüsusilə Book-Crossing-də istifadəçi–element matrisindəki məlumatın nə qədər məhdud olduğunu göstərir.
| Məlumat dəsti | Seyrəklik | Uzun-quyruq element nisbəti | Ən populyar %20 elementin qarşılıqlı əlaqə payı | Gini əmsalı |
|---|---|---|---|---|
| MovieLens-1M | %95,48 | %63,36 | %61,79 | 0,581 |
| Last.FM | %94,54 | %49,01 | %52,58 | 0,449 |
| Book-Crossing | %99,91 | %45,27 | %53,73 | 0,441 |
Təlim parametrləri
- Embedding ölçüsü: 128.
- KG DistMult ön təlimi: Adam, öyrənmə sürəti 1×10⁻³, weight decay 1×10⁻⁵, batch size 2048, 5 epoch.
- Əsas model: Adam, 30 epoch.
- Əsas öyrənmə sürəti: 5×10⁻⁴.
- Weight decay: 5×10⁻⁵.
- Batch size: 2048.
- KG qonşu sayı: 16.
- İstifadəçi oxşarlıq qrafında top-k: 50.
- MovieLens-1M və Last.FM təlimində hər müsbətə 4 mənfi.
- Book-Crossing təlimində hər müsbətə 8 mənfi.
- Təkrarlanan ablasiyada hər müsbətə 6 mənfi.
- AUC/ACC qiymətləndirməsində hər müsbətə 1 mənfi.
- Recall@K qiymətləndirməsində hər istifadəçiyə 100 namizəd element.
Tətbiq Python 3.12 və PyTorch 2.5.1 ilə Windows 11 üzərində həyata keçirilmişdir. Tədqiqatda həmçinin NumPy 2.3.5, pandas 3.0.1 və Pillow 12.2.0 istifadə edildiyi; hesablamaların Intel Core i7-12800HX prosessoru və NVIDIA GeForce RTX 4070 Laptop GPU üzərində aparıldığı bildirilmişdir.
Müqayisə edilən üsullar
Təklif olunan model eyni məlumat bölünməsi və qiymətləndirmə protokolu altında dörd baseline ilə yenidən işlədilərək müqayisə edilmişdir:
- LightGCN
- ENMF
- NeuMF
- HMKRec
Bu məqam nəticələrin şərhində kritikdir. Tədqiqat ədəbiyyatdakı bütün üsulların nəticələrini bir araya gətirib universal sıralama aparmır. Müəlliflərin iddiası yalnız eyni eksperimental protokol altında müqayisə edilən bu baseline dəsti ilə məhdudlaşır.
Sabit benchmark AUC və ACC nəticələri
| Məlumat dəsti | Model | AUC | ACC |
|---|---|---|---|
| MovieLens-1M | Təklif olunan üsul | 0,8737 | 0,7202 |
| MovieLens-1M | HMKRec | 0,8384 | 0,6565 |
| MovieLens-1M | LightGCN | 0,8085 | 0,6489 |
| MovieLens-1M | ENMF | 0,7722 | 0,6081 |
| MovieLens-1M | NeuMF | 0,8650 | 0,7057 |
| Last.FM | Təklif olunan üsul | 0,8620 | 0,6954 |
| Last.FM | HMKRec | 0,7891 | 0,5917 |
| Last.FM | LightGCN | 0,8549 | 0,6885 |
| Last.FM | ENMF | 0,7809 | 0,6009 |
| Last.FM | NeuMF | 0,8249 | 0,6593 |
| Book-Crossing | Təklif olunan üsul | 0,7287 | 0,5623 |
| Book-Crossing | HMKRec | 0,6887 | 0,5360 |
| Book-Crossing | LightGCN | 0,6797 | 0,5587 |
| Book-Crossing | ENMF | 0,5528 | 0,5388 |
| Book-Crossing | NeuMF | 0,6611 | 0,5375 |
Sabit benchmark nəticələrində təklif olunan üsul hər üç məlumat dəstində müqayisə edilən baseline modelləri arasında ən yüksək AUC dəyərini verir. ACC baxımından da bu əsas benchmark cədvəlində ən yüksək dəyərlər təklif olunan üsula aiddir.
Recall@K nəticələri
| Məlumat dəsti | Recall@10 | Recall@20 | Recall@50 |
|---|---|---|---|
| MovieLens-1M | 0,3584 | 0,5597 | 0,8455 |
| Last.FM | 0,4665 | 0,6569 | 0,9233 |
| Book-Crossing | 0,3817 | 0,4996 | 0,7541 |
Recall@K əyriləri təklif olunan üsulun tədqiqatda müqayisə edilən baseline modellərinə qarşı güclü sıralama performansı göstərdiyini göstərir. Lakin Recall@K bu təcrübədə 100 namizəd element üzərindən nümunələnmiş sıralama protokolunda hesablandığından tam kataloq tövsiyə performansı ilə birbaşa eyni deyil. Bundan əlavə, yüksək Recall@K təkbaşına uzun-quyruq elementlərinin daha çox göstərildiyini sübut etmir.
Ablasiya Tədqiqatı Modelin Hansı Komponentlərinin Vacib Olduğunu Göstərir?
Ablasiya tədqiqatı, tam modeldən istifadəçi oxşarlıq qrafı və ya hipergraf qolu çıxarıldıqda performansın necə dəyişdiyini beş müstəqil random seed üzərindən müqayisə edir. Nəticələr həm hipergrafın, həm də istifadəçi oxşarlıq qolunun ümumi sıralama performansına töhfə verdiyini, AUC baxımından xüsusilə istifadəçi oxşarlıq qolunun çıxarılmasının daha böyük azalma yaratdığını göstərir.
| Məlumat dəsti | Tam model AUC | Oxşarlıq yoxdur AUC | Hipergraf yoxdur AUC |
|---|---|---|---|
| MovieLens-1M | 0,8398 | 0,7980 | 0,8255 |
| Book-Crossing | 0,7205 | 0,6893 | 0,6896 |
| Last.FM | 0,8210 | 0,8012 | 0,8048 |
Ablasiya nəticələrində mühüm nüans var. MovieLens-1M-də tam modelin ACC dəyəri 0,6210 olduğu halda hipergrafın çıxarıldığı variant 0,6353 ACC-yə çatmışdır. Buna görə “tam model hər məlumat dəstində və hər metrikdə mütləq ən yaxşıdır” kimi şərh mənbə tərəfindən dəstəklənmir. Müəlliflər də nəticələri daha ehtiyatlı şəkildə, tam modelin xüsusilə AUC və məlumat dəstləri üzrə çoxmetrik balans baxımından güclü olduğu kimi şərh edirlər.
Əsas benchmarkdakı tam model dəyərləri ilə ablasiya qrafikindəki tam model dəyərlərinin eyni olmaması səhv deyil. Mənbə açıq şəkildə Şəkil 2-nin sabit əsas benchmark protokolunu, Şəkil 4-ün isə ayrıca təkrarlanan-seed ablasiya protokolunu göstərdiyini bildirir.
Hesablama mürəkkəbliyi
Modelin xərcinin mühüm komponentləri bunlardır:
- Hipergraf yayılması: \(O(L_h \cdot nnz(H)\cdot d)\)
- İstifadəçi oxşarlıq qrafını bütün cütlər üzərindən qurma: seyrəkləşdirmədən əvvəl təxminən \(O(|U|^2d)\)
- İstifadəçi qrafı yayılması: \(O(L_g\cdot |E_u|\cdot d)\)
- Bir-atlamalı KG aqreqasiyası: \(O(B\cdot K\cdot d)\)
- MLP ballandırması: təxminən \(O(B\cdot d^2)\)
Bu mürəkkəblik strukturunda xüsusilə istifadəçilər arasındakı cütlü oxşarlıq hesabı böyük istifadəçi kainatlarında miqyaslana bilmə darboğazı yarada bilər. Mənbənin müzakirə bölməsində də istifadəçi oxşarlıq qrafının daha böyük istifadəçi çoxluqlarında bahalı ola biləcəyi açıq məhdudiyyət kimi göstərilir.
Tədqiqatın dəstəklədiyi nəticələr
- Hipergraf istifadəçi tarixçəsindəki qrup səviyyəli element birgəliklərindən yüksək dərəcəli əməkdaşlıq siqnalı yarada bilər.
- Hipergrafdan yaradılan ilkin istifadəçi embedding-lərinin ayrıca istifadəçi oxşarlıq qrafı ilə təkmilləşdirilməsi təcrübələrdə əlavə töhfə vermişdir.
- Bir-atlamalı bilik qrafı qonşularının istifadəçiyə şərtlənmiş münasibət çəkiləri ilə toplanması semantik element təsvirinə əlavə məlumat verir.
- Üç komponentin birlikdə istifadə edildiyi model bildirilən əsas benchmark protokolunda müqayisə edilən baseline dəstinə qarşı güclü nəticə vermişdir.
- Ablasiya istifadəçi oxşarlıq qolu ilə hipergraf qolunun xüsusilə AUC baxımından töhfə verdiyini göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Modelin bütün mövcud tövsiyə sistemlərindən universal şəkildə üstün olduğu göstərilməmişdir.
- Oflayn benchmark nəticəsi real istifadəçi məmnuniyyətini və ya kommersiya çevrilməsini birbaşa sübut etmir.
- Tədqiqat canlı A/B testi ehtiva etmir.
- Model istifadəçi üstünlüklərinin zamanla dəyişməsini dinamik şəkildə modelləşdirmir.
- Bilik qrafı qolu bir-atlamalıdır; dərin çox-atlamalı semantik mühakimə sınaqdan keçirilməmişdir.
- Populyarlıq-fərqində olan son-bal düzəlişinin müstəqil töhfəsi xüsusi ablasiya ilə ölçülməmişdir.
- Recall@K nəticələri təkbaşına uzun-quyruq görünürlüğünün artdığının sübutu deyil.
- Film, musiqi və kitabdan kənar sektorlara ümumiləşdirmə bu tədqiqat daxilində eksperimental olaraq doğrulanmamışdır.
Elmi məna
Tədqiqatın mühüm cəhəti tək bir qraf təsvirini “daha dərin” etmək əvəzinə üç fərqli məlumat növünü ayrı funksiyalarla birləşdirməsidir. Hipergraf qrup səviyyəli davranışı, istifadəçi oxşarlıq qrafı lokal istifadəçi yaxınlığını və bilik qrafı elementlərin münasibət semantikasını daşıyır. Bu fərqləndirmə seyrək məlumat şəraitində eyni problemi müxtəlif məlumat mənbələrindən tamamlamağı hədəfləyən təsvir öyrənmə strategiyasıdır.
Bununla yanaşı arxitekturanın mürəkkəbliyi də artır. Hipergrafın, istifadəçi qrafının, bilik qrafının və MLP-nin birlikdə saxlanması daha çox məlumat hazırlığı, entity uyğunlaşdırılması və hesablama addımı tələb edir. Xüsusilə bilik qrafının keyfiyyətinin aşağı olduğu və ya elementlərin xarici entity-lərə etibarlı şəkildə uyğunlaşdırıla bilmədiyi sahələrdə KG qolunun gözlənilən töhfəsi azala bilər.
Mənbə və Metod Qeydi
Orijinal başlıq: Knowledge-Aware Recommendation Based on Hypergraph and Knowledge Graph
Müəlliflər: Shunping Niu; Kuo Chi; Ting Su; Yongqin Yang; Jiabao Gao.
Məsul müəllif: Kuo Chi.
Qurum: School of Information and Communication Engineering, Hainan University, Haikou 570228, China.
Jurnal: AI, 2026, Cild 7, Say 6, Məqalə 215.
DOI: 10.3390/ai7060215
Nəşriyyat: MDPI.
Təqdim: 22 aprel 2026. Reviziya: 7 iyun 2026. Qəbul: 8 iyun 2026. Nəşr: 11 iyun 2026.
Lisenziya: Creative Commons Attribution (CC BY). Bu Verianla mətni mənbə məqalənin cümlə quruluşunu və ya orijinal şəkil kompozisiyalarını yenidən istehsal etmir; elmi faktlar, tənliklər, metod və ölçmə nəticələri müstəqil öyrədici düzəndə izah edilmişdir.
Maliyyələşdirmə: Tədqiqat Hainan Provincial Natural Science Foundation, Hainan Province Key Research and Development Program və National Natural Science Foundation of China çərçivəsində müxtəlif qrantlarla dəstəklənmişdir.
Məlumat əlçatanlığı: MovieLens-1M, Last.FM və Book-Crossing ictimaiyyətə açıq benchmark məlumat dəstləridir. Tədqiqatda istifadə olunan bilik qrafı strukturları məqalədə istinad edilən əvvəlki məlumat hazırlama işlərinə əsaslanır.
Maraqların toqquşması: Müəlliflər maraqların toqquşmasını bildirməmişdir.
Əsas metodoloji məhdudiyyətlər: İstifadəçi oxşarlıq qrafı sabit və top-k seyrəkləşdirilmişdir; istifadəçi sayı artdıqca yaradılma xərci arta bilər. KG kodlayıcısı bir-atlamalıdır və entity uyğunlaşdırma keyfiyyətindən asılıdır. Populyarlıq-fərqində olan yenidən sıralama komponentinin müstəqil təsirini ölçən xüsusi ablasiya yoxdur. Təcrübələr oflayn benchmark protokolu ilə məhdudlaşır.
Şəkil və qrafik istifadəsi: Mənbə məqalənin orijinal Şəkil 1–5 dizaynları birbaşa kopyalanmamalıdır. Verianla versiyasında faktiki məlumat istifadə edilirsə yeni ox, tipoqrafiya və kompozisiya ilə müstəqil qrafiklər; model arxitekturası üçün isə eyni elmi münasibətləri qoruyan, lakin vizual olaraq müstəqil texniki sxem hazırlanmalıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib