

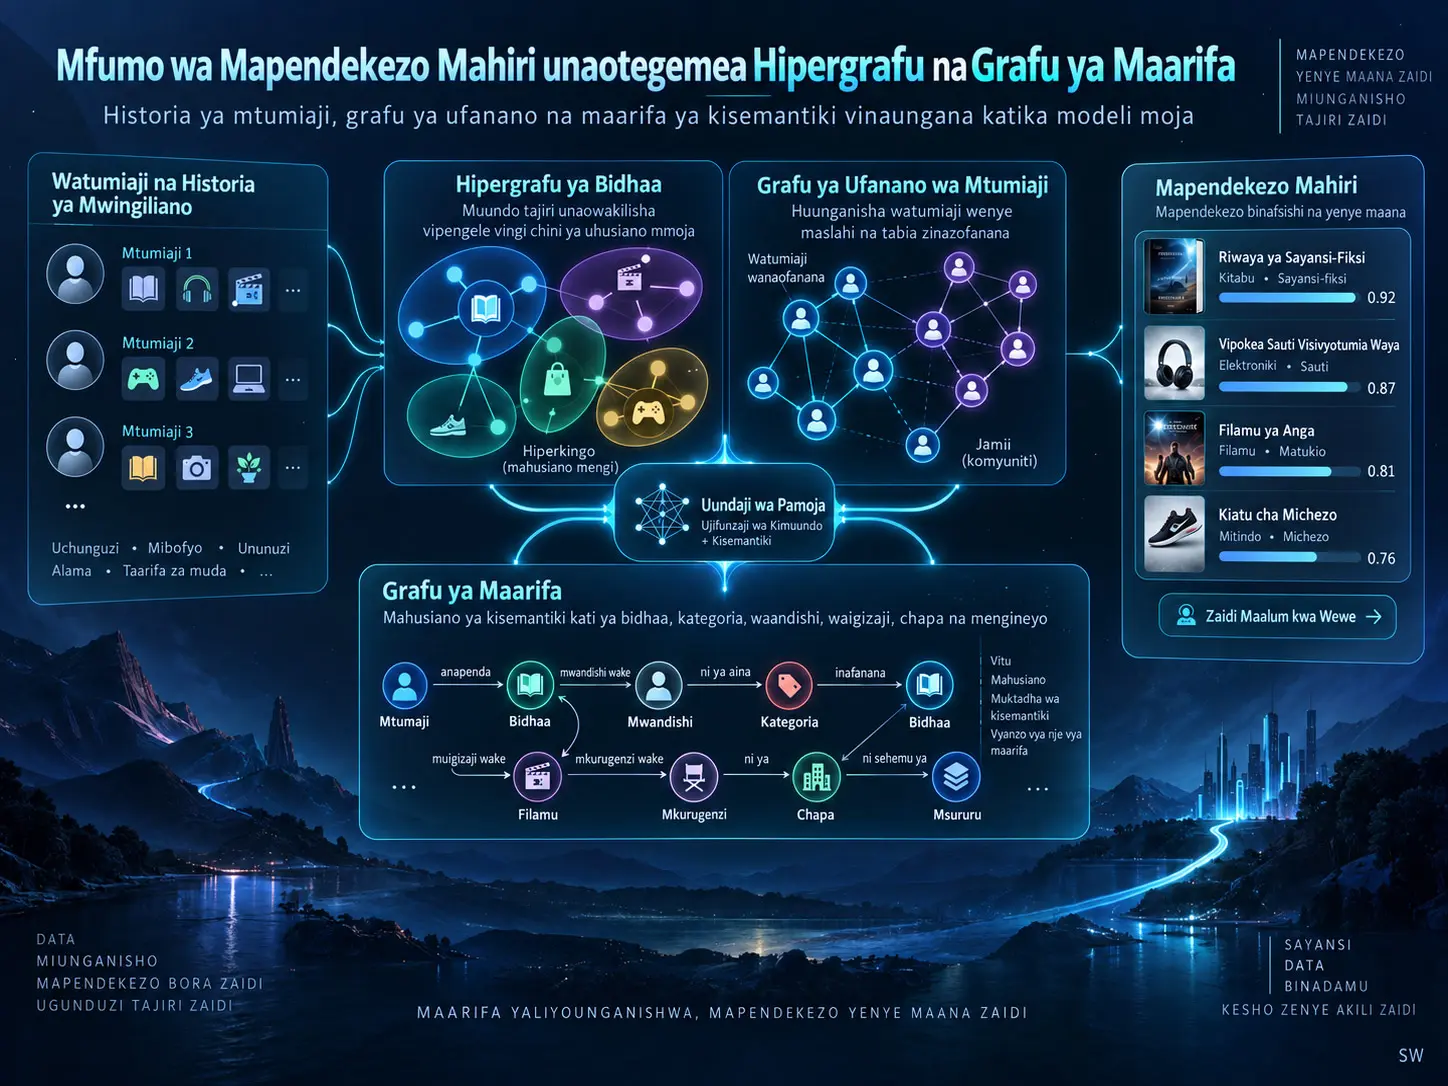
Utafiti huu unachunguza mfumo wa mapendekezo unaozingatia maarifa unaounganisha ndani ya modeli moja muundo wa ushirikiano wa kiwango cha juu ambao mbinu za jadi za mapendekezo zinazotegemea tu miunganisho ya jozi ya mtumiaji–kipengee zinaweza kuupuuza katika mwingiliano haba wa mtumiaji–kipengee, pamoja na maarifa ya nje ya kisemantiki ya vipengee. Mfumo uliopendekezwa unajumuisha hipergrafu ya vipengee inayoundwa kutokana na historia za watumiaji, grafu ya ufanano wa watumiaji ya top-k inayoboresha kwa kiwango cha ndani uwakilishi wa awali wa watumiaji, na kikusanyaji cha grafu ya maarifa kinachounganisha majirani wa hatua moja wa vipengee katika grafu ya maarifa kwa uzani wa mahusiano unaotegemea mtumiaji. Hipergrafu hujifunza muundo wa kiwango cha kikundi wa vipengee vinavyoonekana pamoja katika historia ya mtumiaji mmoja zaidi ya uhusiano wa jozi, huku tawi la grafu ya maarifa likipa vipengee muktadha wa kisemantiki. Uwakilishi wa mwisho wa watumiaji na vipengee hupelekwa kwenye perceptron yenye tabaka nyingi, na modeli hutengeneza alama ya ulinganifu wa mtumiaji–kipengee.
Katika tathmini thabiti ya benchmark ya nje ya mtandao iliyofanywa kwenye seti za data za MovieLens-1M, Last.FM na Book-Crossing, modeli iliyopendekezwa kwa ujumla ilitoa matokeo mazuri dhidi ya mbinu za LightGCN, ENMF, NeuMF na HMKRec zilizolinganishwa katika makala, kwa vipimo vya AUC, usahihi na Recall@K. Kwa mfano, katika itifaki thabiti ya benchmark, kwa MovieLens-1M iliripotiwa AUC 0,8737 na ACC 0,7202; kwa Last.FM AUC 0,8620 na ACC 0,6954; na kwa Book-Crossing AUC 0,7287 na ACC 0,5623. Hata hivyo, matokeo haya yanapaswa kutathminiwa tu chini ya uchakataji wa data, usampulishaji hasi na itifaki ya kuorodhesha wagombea iliyotumika katika utafiti. Utafiti hauonyeshi kwamba modeli ni bora kwa ujumla katika mifumo yote ya mapendekezo au kwamba mafanikio ya benchmark ya nje ya mtandao yanabadilika moja kwa moja kuwa kuridhika kwa watumiaji katika ulimwengu halisi.
Tatizo la msingi katika mifumo ya mapendekezo
Mfumo wa mapendekezo hujaribu kutabiri ni filamu, wimbo, kitabu au kipengee kingine gani ambacho mtumiaji fulani ana uwezekano mkubwa wa kukivutiwa. Mbinu rahisi zaidi za uchujaji shirikishi hutoa utabiri huu kutoka kwenye mwingiliano wa awali wa mtumiaji–kipengee. Hata hivyo, katika seti halisi za data, kwa sababu watumiaji huingiliana na sehemu ndogo sana ya vipengee vilivyo kwenye katalogi, matriki ya mwingiliano kwa kawaida huwa haba sana.
Muundo huu haba unaweza kusababisha upotevu wa aina mbili muhimu za taarifa. Kwanza, grafu ya kawaida ya mtumiaji–kipengee mara nyingi huwakilisha miunganisho ya jozi na haikosimbwi moja kwa moja muundo wa kikundi unaoundwa na vipengee vingi vilivyopo pamoja katika historia ya mtumiaji mmoja. Pili, ikiwa rekodi za mwingiliano pekee ndizo zinazotazamwa, aina za vipengee, mahusiano yao au miunganisho yao ya kisemantiki katika msingi wa maarifa wa nje haziwezi kutumiwa vya kutosha.
Mbinu kuu ya utafiti ni kuchakata vyanzo hivi viwili vya taarifa katika matawi tofauti lakini yanayokamilishana. Historia za watumiaji huunda muundo wa ushirikiano wa kiwango cha juu kupitia hipergrafu; grafu ya maarifa hutoa muktadha wa kisemantiki wa vipengee. Zaidi ya hayo, ufanano kati ya uwakilishi wa awali wa watumiaji husambazwa katika grafu tofauti ya watumiaji.
Hipergrafu Inawakilisha Nini Katika Mfumo Huu wa Mapendekezo?
Hipergrafu katika utafiti huu ni muundo wa mahusiano wa kiwango cha juu ambapo nodi zake ni vipengee na seti ya vipengee ambavyo kila mtumiaji amewahi kuingiliana navyo inawakilishwa kama ukingo-hipa mmoja. Hivyo, tofauti na muunganisho mmoja kati ya nodi mbili katika grafu ya kawaida, vipengee vingi vilivyochaguliwa na mtumiaji mmoja ndani ya historia moja vinaweza kuigwa pamoja chini ya ukingo-hipa mmoja wa pamoja.
Seti ya watumiaji ikionyeshwa kwa \(U\), seti ya vipengee kwa \(V\), na vipengee ambavyo mtumiaji \(u\) ameviingiliana kwa \(I_u\), ukingo-hipa unaolingana na mtumiaji hufafanuliwa kama ifuatavyo:
\[ e_u=\{v\mid v\in I_u\} \]
Jambo muhimu hapa ni kwamba mtumiaji si nodi ya hipergrafu. Nodi za hipergrafu ni vipengee; historia ya mtumiaji ndiyo hufafanua ukingo-hipa unaoviunganisha vipengee hivyo. Muundo huu unaruhusu, kwa mfano, badala ya kuona vipengee vitano vilivyochaguliwa na mtumiaji mmoja kama miunganisho mitano tofauti ya jozi, muktadha wa pamoja wa kitabia wa vipengee hivyo vitano kuonyeshwa ndani ya kitengo kimoja cha kimuundo.
Matriki ya incidence ya hipergrafu \(H\) huonyesha kama kipengee ni sehemu ya ukingo-hipa fulani au la:
\[ H_{v,e_u}= \begin{cases} 1, & v\in e_u\\ 0, & \text{aksi halde} \end{cases} \]
Wakati wa convolution ya hipergrafu, taarifa husambazwa kwanza kutoka vipengee kwenda kwenye kingo-hipa na kisha kutoka kingo-hipa kurudi kwenye vipengee. Muundo msingi wa usambazaji uliotumika katika chanzo ni:
\[ X^{(l+1)}= \sigma\left( D_v^{-1/2} H D_e^{-1} H^{T}D_v^{-1/2} X^{(l)}W^{(l)} \right) \]
Katika usemi huu, \(X^{(l)}\) huwakilisha matriki ya embedding ya vipengee katika tabaka la \(l\); \(W^{(l)}\) ni matriki ya uzani inayojifunza; \(D_v\) ni matriki ya degree ya vipengee; \(D_e\) ni matriki ya degree ya kingo-hipa; na \(\sigma\) ni kazi ya uanzishaji. Uzalishaji wa matriki uliorekebishwa kwa normalization husaidia kupunguza hali ambapo vipengee vinavyoonekana mara nyingi vinatawala usambazaji bila udhibiti kwa sababu tu vina idadi kubwa ya miunganisho.
Kutoka uwakilishi wa vipengee kwenda uwakilishi wa mtumiaji
Tabaka za hipergrafu hazitengenezi moja kwa moja embedding ya mtumiaji katika hatua ya kwanza. Kwanza hujifunza embedding za vipengee zinazobeba mahusiano ya kiwango cha juu. Kisha, kwa kila mtumiaji, uwakilishi wa mwisho wa hipergrafu wa vipengee alivyoviingiliana hupigwa wastani ili kupata vekta ya awali ya mtumiaji:
\[ h_u^{(0)} = \frac{1}{|I_u|} \sum_{v\in I_u} x_v^{(L_h)} \]
Tofauti hii ni muhimu kwa kuelewa usanifu wa modeli: tawi la hipergrafu halichakati moja kwa moja “nodi za watumiaji”; huchakata vipengee kupitia kingo-hipa zinazoundwa na historia ya mtumiaji, na uwakilishi wa mtumiaji hutolewa baadaye kutoka kwenye uwakilishi huo wa vipengee.
Kwa Nini Grafu ya Ufanano wa Watumiaji Inaongeza Hatua ya Pili ya Uundaji wa Mtumiaji?
Grafu ya ufanano wa watumiaji ni hatua ya pili ya uwakilishi wa mtumiaji inayounda ufanano wa mapendeleo wa ndani kwa kusambaza embedding za awali za watumiaji zilizotokana na hipergrafu miongoni mwa watumiaji walio karibu. Wakati hipergrafu hunasa muundo mpana wa pamoja wa vipengee katika kiwango cha kikundi, grafu ya ufanano hushughulikia moja kwa moja taarifa za watumiaji walio karibu katika nafasi ya embedding kama mahusiano ya ujirani.
Ufanano kati ya watumiaji wawili huhesabiwa kwa ufanano wa cosine wa vekta zao za awali:
\[ S(u_i,u_j) = \frac{ h_{u_i}^{T}h_{u_j} }{ \|h_{u_i}\|\|h_{u_j}\| } \]
Kwa kuwa kufanya jozi zote za watumiaji kuwa grafu iliyounganishwa kikamilifu kungeongeza gharama ya hesabu na pia miunganisho dhaifu isiyo na maana, modeli huhifadhi kwa kila mtumiaji watumiaji 50 pekee wenye ufanano wa juu zaidi. Hivyo hupatikana grafu ya watumiaji ya top-k iliyofanywa haba.
Katika utekelezaji wa sasa wa utafiti, grafu hii ya watumiaji haijengwi upya kwa njia ya mienendo katika kipindi cha mafunzo. Huundwa mara moja kutoka kwenye vekta za awali za watumiaji zilizokusanywa kutoka hipergrafu na kisha huwekwa thabiti. Katika tawi la grafu ya watumiaji hutumika tabaka moja tu la usambazaji wa grafu; waandishi huwasilisha hili kama muundo unaopunguza hatari ya oversmoothing.
Dhana ya hipergrafu tuli
Hipergrafu pia hutumiwa kama taswira thabiti ya nje ya mtandao iliyotokana na mwingiliano wa zamani. Chaguo hili linaendana na seti za benchmark thabiti kama MovieLens-1M, Last.FM na Book-Crossing. Hata hivyo, kwa sababu mapendeleo ya watumiaji yanaweza kubadilika kwa muda, dhana hii inapaswa kujaribiwa tofauti katika mazingira hai ya uzalishaji. Utafiti wenyewe hauundi mabadiliko ya mapendeleo ya muda na unaacha ukuzaji wa hipergrafu yenye mienendo kuwa mada ya kazi ya baadaye.
Grafu ya Maarifa Inatengenezaje Uwakilishi wa Kipengee Mahususi kwa Mtumiaji?
Tawi la grafu ya maarifa hulinganisha kila kipengee na entity inayolingana katika grafu ya maarifa na kukusanya taarifa ya kisemantiki kutoka kwa majirani wa hatua moja wa entity hiyo. Mchakato huu wa ukusanyaji si wastani thabiti wa majirani; umuhimu wa kila uhusiano hupewa uzani kulingana na mtumiaji lengwa. Hivyo uwakilishi wa kisemantiki wa kipengee kilekile unaweza kuwa na msisitizo tofauti wa mahusiano kwa watumiaji tofauti.
Katika modeli huhifadhiwa majirani 16 wa grafu ya maarifa kwa kila kipengee. Embedding za entity na relation kwanza hupitia mafunzo ya awali mepesi kwa DistMult na baadaye husanifiwa zaidi pamoja na mfumo wa mapendekezo.
Kwa mtumiaji \(u\) na aina ya uhusiano \(r\), mgawo wa mapendeleo huhesabiwa kwa muundo wa softmax:
\[ \alpha_{u,r} = \frac{ \exp(z_u^{T}r) }{ \sum_{r'\in\mathcal{R}_u} \exp(z_u^{T}r') } \]
Mgawo huu hufanya aina fulani za mahusiano kuwa na ushawishi mkubwa au mdogo kulingana na ulinganifu kati ya embedding ya mtumiaji na embedding ya uhusiano. Kisha entity lengwa \(e_v\) huunganishwa na entity jirani ili kuzalisha uwakilishi wa kisemantiki wa kipengee unaotegemea mtumiaji:
\[ z_{u,v} = \sigma \left( W_e \left[ e_v+ \sum_{(r,e_j)\in\mathcal{N}(e_v)} \alpha_{u,r}e_j \right] \right) \]
Utaratibu huu si ujumbe wa KG wa hatua nyingi. Utafiti hutumia hasa ujirani wa hatua moja. Kwa hiyo matokeo hayapaswi kutafsiriwa kama “ufikiri wa kina wa grafu ya maarifa”.
Vekta ya utabiri na MLP
Katika hatua ya mwisho, embedding iliyoboreshwa ya mtumiaji huunganishwa na embedding ya kipengee mahususi kwa mtumiaji. Katika mlinganyo mfupi wa chanzo hutumika mwingiliano wa kipengee-kwa-kipengee kati ya vekta za mtumiaji na kipengee, ilhali maelezo ya algorithm pia yanaeleza kuwa sehemu ya tofauti kamili imejumuishwa katika descriptor kamili. Kwa hiyo kuna tofauti ya kiwango cha uwasilishaji kati ya maelezo ya maandishi ya utafiti na Mlinganyo mfupi (8); tofauti hii haipaswi kufichwa katika maelezo ya Verianla.
Utabiri wa MLP kwa ujumla ni:
\[ \hat y_{u,v} = \sigma \left( W_2\, \phi(W_1x_{u,v}+b_1)+b_2 \right) \]
Katika hili, \(\phi\) huwakilisha uanzishaji wa ReLU; tabaka la mwisho la sigmoid hutoa alama inayolingana na uwezekano wa mwingiliano chanya wa jozi ya mtumiaji–kipengee.
Je, Marekebisho ya Umaarufu Ndiyo Utaratibu Mkuu Unaofunzwa na Modeli?
Hapana. Uchakataji unaozingatia umaarufu si utaratibu mkuu wa kujifunza unaochukua nafasi ya usanifu wa mafunzo wa modeli msingi, bali ni calibration nyepesi ya baada ya uchakataji inayoweza kutumika kwa hiari kwenye alama za mapendekezo zilizotengenezwa. Utafiti unaweka wazi kwamba hatua hii haipaswi kutafsiriwa kama “utaratibu unaotoa utendaji wa long-tail peke yake”.
Marekebisho ya alama ya mwisho yaliyotolewa katika chanzo ni:
\[ y'_{u,v} = \hat y_{u,v} - \lambda\log(1+\mathrm{pop}(v)) \]
Katika hili, \(\mathrm{pop}(v)\) huwakilisha idadi ya mwingiliano wa kipengee katika data ya mafunzo; \(\lambda\) ni mgawo unaorekebishwa katika itifaki ya uthibitishaji. Kadiri idadi ya mwingiliano wa kipengee maarufu inavyoongezeka, adhabu ya logarithmic huongezeka na utawala wake wa kupita kiasi katika upangaji wa mwisho unaweza kupunguzwa.
Hata hivyo, utafiti hauna ablation huru inayopima athari iliyotengwa ya sehemu hii ya baada ya uchakataji. Kwa hiyo haiwezekani kutenganisha kwa uhakika kiasi gani cha mabadiliko katika tabia ya long-tail ya modeli kinatokana na marekebisho haya na kiasi gani kinatokana na muundo wa hipergrafu/KG.
Hasara ya mafunzo
Modeli hufunzwa kwa pointwise binary cross-entropy juu ya jozi chanya za mtumiaji–kipengee zilizoonekana na jozi hasi zilizochukuliwa kwa sampuli:
\[ \mathcal{L} = - \sum_{(u,v)\in\mathcal{Y}^{+}} \log \hat y_{u,v} - \sum_{(u,v)\in\mathcal{Y}^{-}} \log(1-\hat y_{u,v}) \]
Hasara hii huhamasisha mwingiliano chanya kupata alama za juu na sampuli hasi kupata alama za chini. “Hasi” hapa haimaanishi lazima kwamba mtumiaji kwa kweli hakupenda kipengee; inarejelea jozi za mafunzo zilizochukuliwa kwa sampuli kutoka miongoni mwa vipengee ambavyo havikuzingatiwa katika itifaki ya utafiti.
Vipimo vya tathmini
Utafiti hutumia Accuracy (ACC) na AUC, inayowakilisha eneo chini ya mviringo wa ROC, kwa utabiri wa miunganisho; na Recall@K kwa mapendekezo ya Top-K.
\[ ACC= \frac{TP+TN} {TP+TN+FP+FN} \]
AUC hupima uwezo wa modeli kutofautisha katika upangaji kwa msingi wa uwezekano wa kuipa mwingiliano chanya uliochaguliwa nasibu alama ya juu kuliko mwingiliano hasi uliochaguliwa nasibu.
Kwa mtumiaji mmoja, Recall@K:
\[ Recall@K(u) = \frac{ |\mathcal{R}_u(K)\cap\mathcal{T}_u| }{ |\mathcal{T}_u| } \]
huhesabiwa hivyo. Hapa \(\mathcal{R}_u(K)\) huwakilisha vipengee K vya kwanza vilivyopendekezwa kwa mtumiaji; \(\mathcal{T}_u\) huwakilisha vipengee chanya halisi katika data ya majaribio. Recall@K ya kiwango cha mfumo ni wastani mkuu wa thamani za kila mtumiaji.
Mbinu na Matokeo ya Utafiti
Seti za data na uchakataji wa awali
Utafiti hutumia benchmark za MovieLens-1M, Last.FM na Book-Crossing zinazowakilisha maeneo matatu tofauti. Kutathmini kwa pamoja maeneo ya filamu, muziki na vitabu ni muhimu ili kuona kama modeli inategemea tu aina moja ya muundo wa mwingiliano.
| Seti ya data | Mtumiaji | Kipengee | Mwingiliano | Aina ya uhusiano wa KG | KG entity | Triplet ya KG |
|---|---|---|---|---|---|---|
| MovieLens-1M | 5.148 | 2.380 | 553.277 | 2 | 96 | 6.706 |
| Last.FM | 1.265 | 606 | 41.879 | 1 | 9.749 | 28.383 |
| Book-Crossing | 8.380 | 12.634 | 91.810 | 3 | 5.213 | 36.375 |
Katika MovieLens-1M, alama za 4 na zaidi huwekwa kama mrejesho fiche chanya. Kwa sababu ya muundo wa mrejesho fiche wa Last.FM na uhaba mkubwa wa Book-Crossing, mwingiliano wa awali uliobaki huchukuliwa kuwa chanya. Kizingiti cha chini cha usaidizi ni mwingiliano 20 kwa MovieLens-1M na Last.FM; na mwingiliano 3 kwa Book-Crossing baada ya fallback iliyorekebishwa.
Baada ya uchakataji, uhaba wa seti za data uliripotiwa kuwa kwa mpangilio %95,48, %94,54 na %99,91. Thamani hizi zinaonyesha hasa jinsi taarifa katika matriki ya mtumiaji–kipengee ya Book-Crossing zilivyo finyu.
| Seti ya data | Uhaba | Uwiano wa vipengee vya long-tail | Sehemu ya mwingiliano ya vipengee maarufu zaidi vya %20 | Kipimo cha Gini |
|---|---|---|---|---|
| MovieLens-1M | %95,48 | %63,36 | %61,79 | 0,581 |
| Last.FM | %94,54 | %49,01 | %52,58 | 0,449 |
| Book-Crossing | %99,91 | %45,27 | %53,73 | 0,441 |
Mipangilio ya mafunzo
- Ukubwa wa embedding: 128.
- Mafunzo ya awali ya KG DistMult: Adam, kiwango cha kujifunza 1×10⁻³, weight decay 1×10⁻⁵, batch size 2048, 5 epoch.
- Modeli kuu: Adam, 30 epoch.
- Kiwango kikuu cha kujifunza: 5×10⁻⁴.
- Weight decay: 5×10⁻⁵.
- Batch size: 2048.
- Idadi ya majirani wa KG: 16.
- Top-k katika grafu ya ufanano wa watumiaji: 50.
- Katika mafunzo ya MovieLens-1M na Last.FM, hasi 4 kwa kila chanya.
- Katika mafunzo ya Book-Crossing, hasi 8 kwa kila chanya.
- Katika ablation ya kurudiwa, hasi 6 kwa kila chanya.
- Katika tathmini ya AUC/ACC, hasi 1 kwa kila chanya.
- Katika tathmini ya Recall@K, vipengee wagombea 100 kwa kila mtumiaji.
Utekelezaji ulifanywa kwa Python 3.12 na PyTorch 2.5.1 kwenye Windows 11. Pia iliripotiwa kuwa NumPy 2.3.5, pandas 3.0.1 na Pillow 12.2.0 zilitumika katika utafiti; na hesabu zilifanywa kwa kichakataji Intel Core i7-12800HX na NVIDIA GeForce RTX 4070 Laptop GPU.
Mbinu zilizolinganishwa
Modeli iliyopendekezwa iliendeshwa tena na kulinganishwa dhidi ya baseline nne chini ya mgawanyo uleule wa data na itifaki ileile ya tathmini:
- LightGCN
- ENMF
- NeuMF
- HMKRec
Jambo hili ni muhimu katika kutafsiri matokeo. Utafiti haukusanyi matokeo ya mbinu zote katika fasihi ili kutengeneza upangaji wa jumla. Dai la waandishi limewekewa mipaka kwenye seti hii ya baseline iliyolinganishwa chini ya itifaki ileile ya majaribio.
Matokeo ya AUC na ACC ya benchmark thabiti
| Seti ya data | Modeli | AUC | ACC |
|---|---|---|---|
| MovieLens-1M | Mbinu iliyopendekezwa | 0,8737 | 0,7202 |
| MovieLens-1M | HMKRec | 0,8384 | 0,6565 |
| MovieLens-1M | LightGCN | 0,8085 | 0,6489 |
| MovieLens-1M | ENMF | 0,7722 | 0,6081 |
| MovieLens-1M | NeuMF | 0,8650 | 0,7057 |
| Last.FM | Mbinu iliyopendekezwa | 0,8620 | 0,6954 |
| Last.FM | HMKRec | 0,7891 | 0,5917 |
| Last.FM | LightGCN | 0,8549 | 0,6885 |
| Last.FM | ENMF | 0,7809 | 0,6009 |
| Last.FM | NeuMF | 0,8249 | 0,6593 |
| Book-Crossing | Mbinu iliyopendekezwa | 0,7287 | 0,5623 |
| Book-Crossing | HMKRec | 0,6887 | 0,5360 |
| Book-Crossing | LightGCN | 0,6797 | 0,5587 |
| Book-Crossing | ENMF | 0,5528 | 0,5388 |
| Book-Crossing | NeuMF | 0,6611 | 0,5375 |
Katika matokeo ya benchmark thabiti, mbinu iliyopendekezwa inatoa thamani ya juu zaidi ya AUC kati ya modeli za baseline zilizolinganishwa kwenye seti zote tatu za data. Kwa ACC pia, katika jedwali hili kuu la benchmark, thamani za juu zaidi ni za mbinu iliyopendekezwa.
Matokeo ya Recall@K
| Seti ya data | Recall@10 | Recall@20 | Recall@50 |
|---|---|---|---|
| MovieLens-1M | 0,3584 | 0,5597 | 0,8455 |
| Last.FM | 0,4665 | 0,6569 | 0,9233 |
| Book-Crossing | 0,3817 | 0,4996 | 0,7541 |
Mikondo ya Recall@K inaonyesha kwamba mbinu iliyopendekezwa ilitoa utendaji mzuri wa upangaji dhidi ya modeli za baseline zilizolinganishwa katika utafiti. Hata hivyo, kwa kuwa Recall@K katika jaribio hili ilihesabiwa katika itifaki ya upangaji iliyotumia sampuli ya vipengee wagombea 100, si sawa moja kwa moja na utendaji wa mapendekezo katika katalogi nzima. Pia Recall@K ya juu peke yake haithibitishi kwamba vipengee vya long-tail vinaonyeshwa zaidi.
Utafiti wa Ablation Unaonyesha Ni Vipengele Gani vya Modeli Vilivyo Muhimu?
Utafiti wa ablation unalinganisha jinsi utendaji unavyobadilika pale grafu ya ufanano wa watumiaji au tawi la hipergrafu linapoondolewa kutoka kwenye modeli kamili, kupitia random seed tano huru. Matokeo yanaonyesha kuwa hipergrafu na tawi la ufanano wa watumiaji vyote vinachangia utendaji wa jumla wa upangaji, na kwa AUC, kuondoa hasa tawi la ufanano wa watumiaji kunasababisha kushuka zaidi.
| Seti ya data | AUC ya modeli kamili | AUC bila ufanano | AUC bila hipergrafu |
|---|---|---|---|
| MovieLens-1M | 0,8398 | 0,7980 | 0,8255 |
| Book-Crossing | 0,7205 | 0,6893 | 0,6896 |
| Last.FM | 0,8210 | 0,8012 | 0,8048 |
Kuna nuansa muhimu katika matokeo ya ablation. Katika MovieLens-1M, thamani ya ACC ya modeli kamili ilikuwa 0,6210, ilhali toleo lililoondolewa hipergrafu lilifikia ACC 0,6353. Kwa hiyo tafsiri kwamba “modeli kamili lazima iwe bora zaidi katika kila seti ya data na kila kipimo” haiungwi mkono na chanzo. Waandishi pia hufasiri matokeo kwa tahadhari zaidi, wakisema modeli kamili ina nguvu hasa kwa AUC na kwa usawa wa vipimo vingi katika seti za data.
Kutolingana kwa thamani za modeli kamili katika benchmark kuu na zile katika grafu ya ablation si kosa. Chanzo kinaeleza wazi kwamba Kielelezo 2 kinaonyesha itifaki thabiti ya benchmark kuu, huku Kielelezo 4 kikionyesha itifaki tofauti ya ablation ya seed zilizorudiwa.
Ugumu wa kihesabu
Vipengele muhimu vya gharama ya modeli ni hivi:
- Usambazaji wa hipergrafu: \(O(L_h \cdot nnz(H)\cdot d)\)
- Kujenga grafu ya ufanano wa watumiaji kupitia jozi zote: kabla ya kufanya iwe haba, takriban \(O(|U|^2d)\)
- Usambazaji wa grafu ya watumiaji: \(O(L_g\cdot |E_u|\cdot d)\)
- Ukusanyaji wa KG wa hatua moja: \(O(B\cdot K\cdot d)\)
- Uwekaji alama wa MLP: takriban \(O(B\cdot d^2)\)
Katika muundo huu wa ugumu, hasa hesabu ya ufanano wa jozi kati ya watumiaji inaweza kuwa kikwazo cha scalability katika nafasi zenye idadi kubwa ya watumiaji. Katika sehemu ya majadiliano ya chanzo pia imeelezwa wazi kama kikomo kwamba grafu ya ufanano wa watumiaji inaweza kuwa ghali kwa seti kubwa zaidi za watumiaji.
Matokeo yanayoungwa mkono na utafiti
- Hipergrafu inaweza kutoa ishara ya ushirikiano wa kiwango cha juu kutoka kwa kuonekana pamoja kwa vipengee katika kiwango cha kikundi ndani ya historia ya mtumiaji.
- Kuboresha embedding za awali za watumiaji zilizoundwa kutoka hipergrafu kwa grafu tofauti ya ufanano wa watumiaji kumetoa mchango wa ziada katika majaribio.
- Kukusanya majirani wa hatua moja wa grafu ya maarifa kwa uzani wa mahusiano unaotegemea mtumiaji huongeza taarifa kwenye uwakilishi wa kisemantiki wa kipengee.
- Modeli inayotumia vipengele vyote vitatu kwa pamoja imetoa matokeo mazuri dhidi ya seti ya baseline iliyolinganishwa katika itifaki kuu ya benchmark iliyoripotiwa.
- Ablation inaonyesha kuwa tawi la ufanano wa watumiaji na tawi la hipergrafu huchangia hasa kwa AUC.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kwamba modeli ni bora kwa ujumla kuliko mifumo yote iliyopo ya mapendekezo.
- Matokeo ya benchmark ya nje ya mtandao hayathibitishi moja kwa moja kuridhika halisi kwa watumiaji au conversion ya kibiashara.
- Utafiti hauna jaribio hai la A/B.
- Modeli haifanyi uundaji wa mienendo wa mabadiliko ya mapendeleo ya watumiaji kwa muda.
- Tawi la grafu ya maarifa ni la hatua moja; ufikiri wa kina wa kisemantiki wa hatua nyingi haujajaribiwa.
- Mchango huru wa marekebisho ya mwisho ya alama yanayozingatia umaarufu haujapimwa kwa ablation maalum.
- Matokeo ya Recall@K peke yake si ushahidi wa kuongezeka kwa mwonekano wa long-tail.
- Ujumlishaji kwenda sekta nje ya filamu, muziki na vitabu haujathibitishwa kwa majaribio ndani ya utafiti huu.
Maana ya kisayansi
Jambo muhimu la utafiti ni kwamba badala ya kufanya uwakilishi mmoja wa grafu kuwa “wa kina zaidi”, unaunganisha aina tatu tofauti za taarifa zikiwa na majukumu tofauti. Hipergrafu hubeba tabia ya kiwango cha kikundi, grafu ya ufanano wa watumiaji hubeba ukaribu wa ndani wa watumiaji, na grafu ya maarifa hubeba semantiki ya mahusiano ya vipengee. Mgawanyo huu ni mkakati wa kujifunza uwakilishi unaolenga kukamilisha tatizo lilelile kutoka kwenye vyanzo tofauti vya taarifa chini ya data haba.
Hata hivyo, ugumu wa usanifu pia huongezeka. Kudumisha hipergrafu, grafu ya watumiaji, grafu ya maarifa na MLP kwa pamoja kunahitaji maandalizi zaidi ya data, ulinganishaji wa entity na hatua za hesabu. Hasa katika maeneo ambapo ubora wa grafu ya maarifa ni mdogo au vipengee haviwezi kulinganishwa kwa kuaminika na entity za nje, mchango unaotarajiwa wa tawi la KG unaweza kupungua.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Knowledge-Aware Recommendation Based on Hypergraph and Knowledge Graph
Waandishi: Shunping Niu; Kuo Chi; Ting Su; Yongqin Yang; Jiabao Gao.
Mwandishi anayewasiliana: Kuo Chi.
Taasisi: School of Information and Communication Engineering, Hainan University, Haikou 570228, China.
Jarida: AI, 2026, Juzuu 7, Toleo 6, Makala 215.
DOI: 10.3390/ai7060215
Mchapishaji: MDPI.
Iliwasilishwa: 22 Aprili 2026. Ilifanyiwa marekebisho: 7 Juni 2026. Ilikubaliwa: 8 Juni 2026. Ilichapishwa: 11 Juni 2026.
Leseni: Creative Commons Attribution (CC BY). Maandishi haya ya Verianla hayazalishi upya muundo wa sentensi wa makala chanzo au kompozisheni asili za vielelezo; ukweli wa kisayansi, milinganyo, mbinu na matokeo ya vipimo yameelezwa katika mpangilio huru wa kielimu.
Ufadhili: Utafiti uliungwa mkono na ruzuku mbalimbali chini ya Hainan Provincial Natural Science Foundation, Hainan Province Key Research and Development Program na National Natural Science Foundation of China.
Upatikanaji wa data: MovieLens-1M, Last.FM na Book-Crossing ni seti za data za benchmark zinazopatikana kwa umma. Miundo ya grafu ya maarifa iliyotumika katika utafiti inategemea kazi za awali za maandalizi ya data zilizorejelewa katika makala.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Vikwazo vikuu vya kimetodolojia: Grafu ya ufanano wa watumiaji ni thabiti na imefanywa haba kwa top-k; gharama ya kuijenga inaweza kuongezeka kadiri idadi ya watumiaji inavyoongezeka. Encoder ya KG ni ya hatua moja na inategemea ubora wa ulinganishaji wa entity. Hakuna ablation maalum inayopima athari huru ya sehemu ya kupanga upya inayozingatia umaarufu. Majaribio yamewekewa mipaka kwenye itifaki ya benchmark ya nje ya mtandao.
Matumizi ya vielelezo na grafu: Miundo asili ya Vielelezo 1–5 vya makala chanzo haipaswi kunakiliwa moja kwa moja. Katika toleo la Verianla, ikiwa data ya ukweli inatumika, grafu huru zenye mhimili, tipografia na kompozisheni mpya; na kwa usanifu wa modeli, mchoro wa kiufundi unaohifadhi mahusiano yale yale ya kisayansi lakini ulio huru kwa mwonekano unapaswa kutayarishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *