

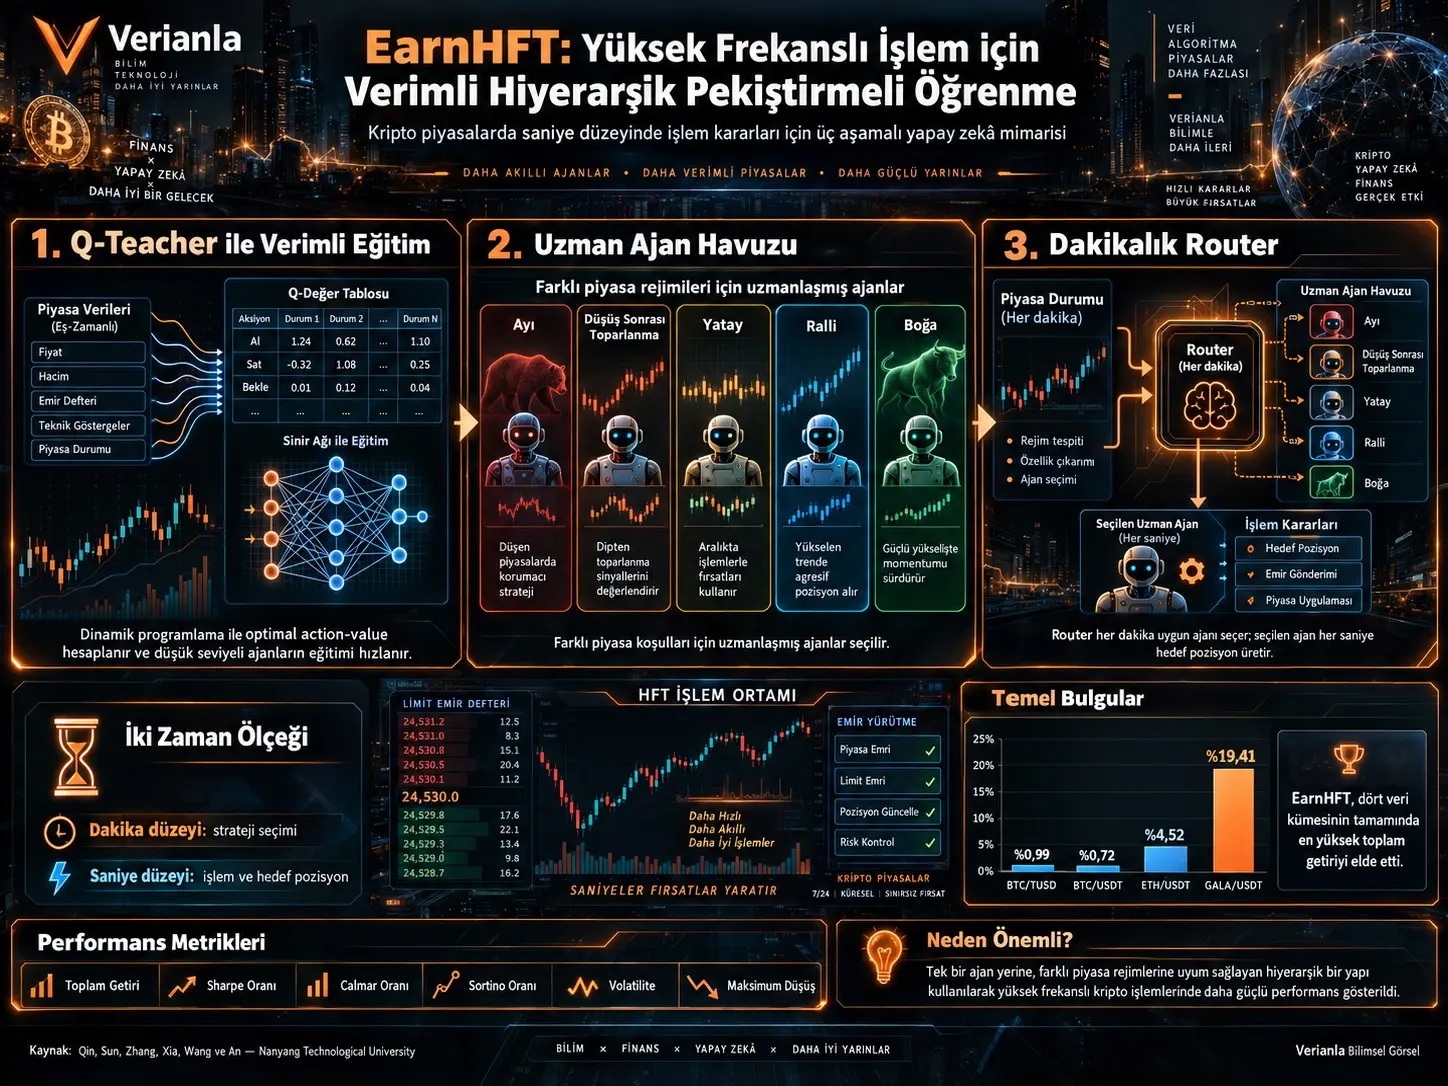
EarnHFT, kriptovalyuta bazarlarında saniyə səviyyəsində əməliyyat aparan möhkəmləndirici öyrənmə agentlərinin iki əsas problemini həll etmək məqsədilə hazırlanmış üçmərhələli iyerarxik möhkəmləndirici öyrənmə sistemidir. Birinci problem yüksək tezlikli ticarətdə təlim trayektoriyalarının fövqəladə dərəcədə uzun olmasıdır. Tədqiqatdakı nümunədə cəmi 12 günlük saniyəlik məlumat təxminən 1.036.800 qərar addımı yaradır; aylıq miqyasda isə bu rəqəm milyonlarla addıma çata bilər. İkinci problem kriptovalyuta bazarlarında bazar rejimlərinin sürətlə dəyişməsi səbəbindən tək bir agentin öyrəndiyi strategiyanın fərqli bazar şəraitində uğursuz ola bilməsidir.
EarnHFT bu problemləri tək və ümumi bir trading agenti öyrətmək əvəzinə tapşırıqları müxtəlif zaman miqyaslarına bölməklə həll edir. Saniyə səviyyəsindəki aşağı səviyyəli agentlər real alqı-satqı qərarlarını və hədəf mövqeni müəyyənləşdirərkən, dəqiqə səviyyəsindəki yüksək səviyyəli router bazarın mövcud makro davranışına uyğun aşağı səviyyəli agenti seçir. Beləliklə sistem mikro bazar hərəkətlərini saniyə səviyyəsində emal edərkən trend dəyişimini dəqiqə səviyyəsində qiymətləndirə bilir.
Birinci mərhələdə gələcək qiymət məlumatından istifadə etməklə dinamik proqramlaşdırma ilə hesablanan Q-teacher, aşağı səviyyəli DDQN agentinə yalnız öz sınaq-səhv təcrübəsini deyil, eyni vəziyyətdəki alternativ hərəkətlərin hesablanmış optimal action-value məlumatını da verir. İkinci mərhələdə müxtəlif bull, bear, pullback, sideways və rally davranışlarında ixtisaslaşması nəzərdə tutulan yüzlərlə agent öyrədilir; onların yalnız müxtəlif bazar rejimlərində ən gəlirli olan kiçik bir hissəsi strategiya hovuzuna daxil edilir. Üçüncü mərhələdə dəqiqə səviyyəli DDQN router bu agentlərdən birini seçir və seçilmiş agent növbəti bir dəqiqə ərzində saniyə-saniyə hədəf mövqe yaradır.
BTC/TUSD, BTC/USDT, ETH/USDT və GALA/USDT məlumat dəstlərində aparılan simulyasiya təcrübələrində EarnHFT dörd bazarın hamısında test dövrünün ən yüksək ümumi gəlirini əldə etmişdir. Ümumi gəlirlər müvafiq olaraq təxminən %0,99, %0,72, %4,52 və %19,41 olaraq bildirilmişdir. Bununla belə metod bütün risk göstəricilərində ən yaxşı deyil; müəlliflər EarnHFT-nin profit-oriented Q-teacher quruluşuna görə nisbətən aqressiv trader olduğunu və bəzi məlumat dəstlərində risk performansının orta səviyyədə qaldığını açıq şəkildə qeyd edirlər.
Normal möhkəmləndirici öyrənmə HFT üçün niyə çətinlik çəkir?
Möhkəmləndirici öyrənmədə agent mövcud vəziyyəti müşahidə edir, bir hərəkət seçir və həmin hərəkətin nəticəsində aldığı mükafata əsasən siyasətini təkmilləşdirir. Gündəlik və ya saatlıq trading problemlərində bir təlim trayektoriyası nisbətən qısa ola bilər. Yüksək tezlikli ticarətdə isə eyni model saniyədə bir qərar verirsə, problem milyonlarla ardıcıl addımdan ibarət olur.
Tədqiqatda verilən nümunə:
Bu qədər uzun horizon RL agentinin müsbət və mənfi davranışların uzunmüddətli təsirini öyrənməsini çətinləşdirir və təlim üçün daha çox təcrübə tələb edir.
İkinci problem non-stationary market dynamics vəziyyətidir. Kriptovalyuta bazarında eyni mikro qiymət hərəkəti müxtəlif makro bazar rejimlərində fərqli məna daşıya bilər. Məsələn, yüksələn bazarda qısamüddətli qiymət enişi müvəqqəti pullback ola bilər, halbuki düşən bazarda oxşar hərəkət daha böyük aşağı istiqamətli hərəkətin davamına çevrilə bilər. Buna görə vahid siyasətin bütün bazar rejimlərində eyni uğuru göstərməsi çətinləşir.
EarnHFT niyə iyerarxik quruluşdan istifadə edir?
EarnHFT bazar məlumatını iki fərqli zaman miqyasına ayırır. Aşağı səviyyəli MDP saniyə səviyyəsindəki mikro bazar hərəkətlərini və əməliyyat execution prosesini modelləşdirir. Yüksək səviyyəli MDP isə dəqiqə miqyasında daha yavaş dəyişən bazar trendlərini və hansı trading strategiyasının istifadə olunacağını modelləşdirir.
Aşağı səviyyəli agent hər saniyə hədəf mövqe yaradır, yüksək səviyyəli router isə hər dəqiqə bir aşağı səviyyəli agent seçir. Beləliklə “hazırda neçə coin saxlanmalıdır?” və “bu bazar rejimində hansı trader istifadə edilməlidir?” qərarları bir-birindən ayrılır.
Aşağı səviyyəli vəziyyət hansı məlumatları ehtiva edir?
Aşağı səviyyəli state iki əsas komponentdən ibarətdir. Birincisi saniyəlik bazar məlumatından çıxarılan 54 texniki xüsusiyyət, ikincisi isə agentin saxladığı cari mövqedir. Texniki xüsusiyyətlər 60 saniyəlik rolling window daxilindəki OHLC məlumatı və Limit Order Book snapshot-larından əldə edilir.
Action birbaşa “buy” və ya “sell” etiketi deyil. Agent əvvəlcədən müəyyən edilmiş sonlu action pool daxilindən bir hədəf mövqe seçir. Cari mövqe hədəf mövqedən fərqlidirsə, aradakı miqdar market order ilə dərhal alınır və ya satılır.
Yüksək səviyyəli vəziyyət və action nədir?
Yüksək səviyyəli state 60 dəqiqəlik rolling OHLC window-dan çıxarılan 19 makro xüsusiyyət və cari mövqeni ehtiva edir. Action isə birbaşa mövqe deyil, strategiya hovuzundakı aşağı səviyyəli RL agentlərindən birinin seçilməsidir.
Router tərəfindən seçilən agent bir dəqiqə ərzində işləyir və saniyə səviyyəsində hədəf mövqe yaradır. Router-in aldığı reward həmin bir dəqiqə ərzində seçilmiş aşağı səviyyəli agentin yaratdığı net-value dəyişməsidir.
Limit Order Book niyə vacibdir?
EarnHFT simulyasiyası yalnız bağlanış qiyməti ilə əməliyyat aparıldığını fərz etmir. Limit Order Book daxilindəki bid və ask qiymətlərindən və bu səviyyələrdə mövcud miqdarlardan istifadə edir. Böyük bir market order ilk qiymət səviyyəsindəki likvidlikdən çox olduqda, sifariş növbəti qiymət səviyyələrinə keçir.
Mənbənin market-order xərcini izah etmək üçün istifadə etdiyi quruluş:
Burada \(p_t^i\) müvafiq order-book səviyyəsinin qiymətini, \(q_t^i\) həmin səviyyədəki miqdarı, \(R_{i-1}\) əvvəlki səviyyələrdən sonra qalan sifariş miqdarını və \(\sigma\) commission-fee nisbətini ifadə edir.
Bunun mühüm nəticəsi odur ki, komissiya sıfır olsa belə trading pulsuz olmur. Market order alış zamanı ask tərəfini, satış zamanı isə bid tərəfini istehlak etdiyinə görə bid–ask spread özü ayrıca əməliyyat xərci yaradır.
Mərhələ I: Q-teacher necə işləyir?
Normal RL agenti hansı hərəkətin yaxşı olduğunu sınaqdan keçirərək öyrənir. EarnHFT isə istifadə olunan simulyasiya mühitində qiymət seriyasının agentin hərəkətlərindən təsirlənmədiyi fərziyyəsindən yararlanır. Gələcək qiymətlər təlim zamanı məlum olduğuna görə hər zaman–mövqe–action kombinasiyasının optimal action-value dəyəri dinamik proqramlaşdırma ilə geriyə doğru hesablana bilər.
Bu Q-cədvəli trading zamanı istifadə edilmir; təlim zamanı bir müəllim siqnalı kimi xidmət edir.
DDQN-nin normal temporal-difference xətasına şəbəkənin action-value paylanması ilə optimal action-value paylanması arasındakı Kullback–Leibler divergence əlavə edilir:
TD komponenti:
Burada məqsəd agentin yalnız seçdiyi action-ın nəticəsini deyil, eyni vəziyyətdəki digər action-ların nisbi dəyərlərini də öyrənə bilməsini təmin etməkdir. Mənbədə \(\alpha\) təlim irəlilədikcə azalan əmsal kimi istifadə olunur.
Optimal Actor nə əlavə edir?
Təkcə Q-teacher-dan istifadə kifayət hesab edilməmişdir. Agent optimal siyasətdən uzaqlaşdıqda tutduğu mövqe dəyişdiyi üçün müəllim siqnalı da fərqlənə bilər. Bunu azaltmaq məqsədilə EarnHFT ikinci bir təcrübə mənbəyi yaradır.
Bir təcrübə qrupu normal \(\epsilon\)-greedy siyasətlə agent tərəfindən yaradılır, digər qrup isə birbaşa \(Q^*\) dəyərində maksimum action-ı seçən optimal actor tərəfindən yaradılır. Beləliklə replay buffer həm kəşf zamanı əldə edilən keçidləri, həm də hesablanmış optimal siyasətin yaratdığı keçidləri ehtiva edir.
Mərhələ II: Niyə tək agent əvəzinə yüzlərlə agent öyrədilir?
Tədqiqatın əsas hipotezlərindən biri budur ki, bull market üçün yaxşı olan siyasət bear market üçün eyni dərəcədə yaxşı olmaya bilər. Buna görə təlim məlumatı müxtəlif bazar trendlərini təmsil edən hissələrə bölünür və agentlərin bu hissələri fərqli ehtimallarla görməsi təmin edilir.
Məlumat dəsti üç milyondan çox zaman addımına malik multivariate time series bölmələrindən ibarətdir. Hər agent üçün üstünlük parametri \(\beta\) dəyişdirilir. Buy-and-hold return yüksək və ya aşağı olan market segmentlərinin sampling çəkisi bu parametr vasitəsilə dəyişdirilərək müxtəlif bazar rejimlərində ixtisaslaşan agentlər yaradılmağa çalışılır.
Bazar segmentləri necə etiketlənir?
Mənbə əvvəlcə yüksək tezlikli səs-küyü low-pass filtering ilə azaldır. Daha sonra qiymət/net-value əyrisindəki lokal istiqamət dəyişmələrindən segmentlər yaradır. Qonşu segmentlər slope fərqi və Dynamic Time Warping oxşarlığı kifayət qədər kiçikdirsə birləşdirilir.
Daha sonra buy-and-hold return meyllərinin quantile dəyərlərindən istifadə etməklə segmentlər müxtəlif trend siniflərinə ayrılır. Tədqiqatın vizuallarında istifadə olunan beş kateqoriya:
- Bear,
- Pullback,
- Sideways,
- Rally,
- Bull.
Hər trend və başlanğıc mövqeyi üçün validation məlumatında ən yüksək orta profitability dəyərini yaradan agentlər seçilir. Beləliklə yüzlərlə namizədin hamısı router action space-ə daxil edilmir; yalnız kiçik və müxtəlif strategiya hovuzu saxlanılır.
Neçə agent öyrədildi?
Tədqiqatda sampling-preference parametri \(\beta\) üçün \(-90\), \(-10\), \(30\) və \(100\) dəyərləri istifadə edilmişdir. Hər dəyər 50 epoch işlədilmiş və ümumilikdə 200 aşağı səviyyəli agent yaradılmışdır.
Mərhələ III: Router nə edir?
Router DDQN əsaslı yüksək səviyyəli agentdir. Hər dəqiqə mövcud makro bazar vəziyyətini təhlil edir və agent pool daxilindən bir trader seçir.
Router-in saniyə əvəzinə dəqiqə səviyyəsində qərar verməsi high-level trajectory uzunluğunu:
nisbətində, yəni mənbənin ifadəsi ilə təxminən %98,33 azaldır.
Router həmçinin yalnız mövcud mövqeyə uyğun başlanğıc mövqeyinə malik agentləri qiymətləndirdiyinə görə action space daha da kiçilir. Müəlliflər high-level mərhələdə Q-teacher istifadə etməmişlər; trayektoriya artıq xeyli qısaldığı və agent seçimi üçün optimal action-value hesablaması daha mürəkkəb olduğu üçün normal DDQN-ni daha səmərəli hesab etmişlər.
Router həqiqətən bazar rejiminə görə fərqli davranırmı?
Mənbədə router seçim paylanması dörd test məlumat dəstində araşdırılmışdır. Daha aşağı volatilitetə malik BTC/TUSD və BTC/USDT məlumatlarında router seçimləri bir neçə market-state agentində cəmləşərkən, ETH və GALA kimi daha dəyişkən bazarlarda seçim paylanmasının beş bazar rejimi üzrə daha balanslı yayıldığı görünür.
Məsələn, GALA testində seçimlərin təxminən %67,6-sı Bull agentinə yönəlmişdir. BTC/USDT testində isə təxminən %64,8 Sideways və %32,6 Rally agenti seçilmişdir. ETH-də Pullback agentinin payı təxminən %43,9-dur. Bu dəyərlər router-in bütün bazarlarda eyni alt agentdən istifadə etmədiyini göstərir.
Metod və Tapıntılar
Məlumat dəstləri
| Trading Pair | Mənbədə göstərilən bazar dinamikası | Saniyə sayı | Dövr |
|---|---|---|---|
| BTC/TUSD | Sideways | 4.057.140 | 30 Mart 2023 – 15 May 2023 |
| BTC/USDT | Sideways | 3.884.400 | 1 Sentyabr 2022 – 15 Oktyabr 2022 |
| ETH/USDT | Bear | 3.970.800 | 1 May 2022 – 15 İyun 2022 |
| GALA/USDT | Bull | 3.970.740 | 1 İyul 2022 – 15 Avqust 2022 |
Hər məlumat dəstində son 9 gün test, ondan əvvəlki 9 gün validation, daha köhnə məlumatlar isə training üçün istifadə edilmişdir. Bu xronoloji ayrım gələcək test məlumatının təlim mərhələsində birbaşa istifadə edilməsinin qarşısını almaq məqsədi daşıyır.
Validation və test dövrləri eyni deyildi
Tədqiqat xüsusilə validation və test bazar trendləri arasında mühüm fərqlər yaratmışdır. BTC/TUSD test setində validation-da olmayan aydın bear trend meydana çıxmışdır. ETH/USDT-də fərq daha da böyükdür: validation dövründə trend yüksələrkən, test dövründə mənbə təxminən %30-luq eniş bildirir.
Bu vəziyyət EarnHFT-nin yalnız təlim dövrünə bənzər bazarlarda deyil, market regime dəyişikliklərində də sınaqdan keçirildiyini göstərmək üçün istifadə edilmişdir.
Müqayisə edilən metodlar
EarnHFT dörd RL və iki rule-based baseline ilə müqayisə edilmişdir: PPO, DRA, DQN, CDQNRP, MACD və Imbalance Volume (IV). Beləliklə policy-based RL, value-based RL və klassik bazar göstəricilərinə əsaslanan metodlar eyni təcrübədə qiymətləndirilmişdir.
Qiymətləndirmə göstəriciləri
Altı maliyyə göstəricisindən istifadə edilmişdir: Total Return (TR), Annual Sharpe Ratio (ASR), Annual Calmar Ratio (ACR), Annual Sortino Ratio (ASoR), Annual Volatility (AVOL) və Maximum Drawdown (MDD).
Total Return:
Annual Sharpe Ratio:
Calmar Ratio:
Sortino Ratio isə ümumi volatilitet əvəzinə yalnız mənfi return-ların downside deviation dəyərini risk göstəricisi kimi istifadə edir.
Əsas performans nəticələri
| Bazar | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) |
|---|---|---|---|---|---|---|
| BTC/USDT | 0,72 | 1,22 | 10,77 | 0,93 | 27,08 | 3,07 |
| BTC/TUSD | 0,99 | 1,34 | 7,76 | 1,01 | 32,40 | 5,61 |
| ETH/USDT | 4,52 | 2,92 | 14,30 | 1,78 | 67,92 | 13,89 |
| GALA/USDT | 19,41 | 9,77 | 79,08 | 7,79 | 74,94 | 9,26 |
EarnHFT dörd məlumat dəstinin hamısında Total Return baxımından ən yüksək nəticəni əldə etmişdir. Mənbə həmçinin dörd məlumat dəstinin üçündə risk-adjusted profit göstəricilərində ən yaxşı performansın EarnHFT-yə aid olduğunu bildirir.
BTC/TUSD istisnadır. Bu məlumat dəstində DQN-nin bəzi risk-adjusted göstəriciləri EarnHFT-dən daha yüksəkdir; məsələn, DQN üçün ASR 4,21 və ACR 27,94 olduğu halda EarnHFT üçün eyni dəyərlər 1,34 və 7,76-dır. Buna görə sistemin gəlir üstünlüyü bütün göstəricilərdə mütləq üstünlük demək deyil.
ETH əməliyyatı nümunəsi
Mənbənin Şəkil 2-sində ETH üzərində EarnHFT tərəfindən açılan mövqenin təxminən 30 saniyə ərzində yenidən bağlandığı nümunə göstərilir. Dəqiqə miqyasında kiçik pullback kimi görünə biləcək qiymət hərəkəti saniyə səviyyəli agent tərəfindən qısamüddətli trading fürsəti kimi istifadə olunur.
Bu nümunə sistemin iki zaman miqyasını niyə ayırdığını vizual olaraq göstərir: router daha geniş bazar kontekstini seçərkən aşağı səviyyəli agent eyni dəqiqə daxilindəki daha kiçik qiymət hərəkətlərinə reaksiya verir.
Q-teacher həqiqətən təlimi sürətləndirdimi?
Ablation təcrübəsində Optimal Value Supervisor (OS) və Optimal Actor-un (OA) təsiri ayrıca araşdırılmışdır.
GALA məlumat dəstində normal DDQN təxminən 30.720 addımda yaxınlaşdığı halda yalnız OS istifadə edilən quruluş 4.608 addımda yaxınlaşmışdır. Bu, mənbənin ifadəsi ilə təxminən %15-i qədər təlim addımı deməkdir. Converged reward sum eyni müqayisədə -0,01-dən 2,89-a yüksəlmişdir.
OS və OA birlikdə istifadə edildikdə GALA reward sum 4,43-ə çatmış, lakin convergence step 78.848 olmuşdur. Bu nəticə optimal actor-un gəliri artıra bilməsinə baxmayaraq daha çox təlim addımı tələb edə bildiyini göstərir.
ETH-də yalnız OS convergence step-i baseline ilə müqayisədə azaltmamışdır; hər ikisi 30.720 addım səviyyəsindədir. Buna baxmayaraq reward sum təxminən -29,6-dan 4,87-yə yüksəlmişdir. Hər iki komponent birlikdə istifadə edildikdə mənbə 12,32 reward sum bildirir.
Niyə EarnHFT bəzi risk göstəricilərində daha zəifdir?
Müəlliflərin öz izahına görə Q-teacher və optimal actor xüsusilə gəlirli təcrübələri öyrədir. Risk cəzası optimal supervision-a eyni ağırlıqla daxil edilmədiyi üçün EarnHFT daha aqressiv trading davranışı göstərə bilər.
Buna görə tədqiqatın nəticələri “daha yüksək profit = daha aşağı risk” kimi şərh edilməməlidir. Məsələn, GALA-da EarnHFT %19,41 total return ilə ən yüksək nəticəni versə də annual volatility dəyəri %74,94-dür və daha aşağı volatilitetə malik alternativ modellər mövcuddur.
Təlim infrastrukturu
Təcrübələr NVIDIA RTX 4090 GPU üzərində aparılmışdır. Mənbə dörd məlumat dəstindəki bütün təcrübələrin təxminən 10 saat davam etdiyini bildirir. EarnHFT-nin replay buffer ölçüsü \(10^6\), mini-batch size 512, learning rate \(5\times10^{-4}\), Q-teacher əmsalı \(\alpha=128\) və soft-update əmsalı \(\tau=0.005\) olaraq verilmişdir.
Komissiya nisbətində mənbədaxili fərq
Əsas təcrübə bölməsində BTC/TUSD üçün komissiya nisbəti 0, digər məlumat dəstləri üçün %0,02 kimi yazılmışdır. Əlavə D.3-dəki parameter table isə BTC/TUSD üçün 0, BTC/USDT, ETH/USDT və GALA/USDT üçün %0,015 verir.
Mənbə bu iki dəyərin fərqli təcrübələrə, fərqli dövrlərə və ya yazı xətasına aid olub-olmadığını açıqlamır. Buna görə Verianla mətni bu iki dəyərdən birini “doğru dəyər” kimi seçmir.
Nəzəri yaxınlaşma
Əlavə C.2-də müəlliflər Q-teacher supervisor ilə dəyişdirilmiş Q-learning operatorunun sonlu MDP altında optimal action-value funksiyası \(Q^*\)-a yaxınlaşacağını göstərmək üçün riyazi törəmə təqdim edirlər.
Yanaşma əvvəlcə \(Q^*\)-ın müəyyən edilmiş operatorun fixed point-i olduğunu, daha sonra operatorun sup-norm altında contraction olduğunu göstərməyə çalışır. Bu nəticə tədqiqatın nəzəri arqumentidir; eksperimental nəticələrdən ayrıca qiymətləndirilməlidir.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə göstərir ki, müxtəlif bazar rejimlərində ixtisaslaşmış aşağı səviyyəli agentlərdən ibarət hovuzun dəqiqə səviyyəli router tərəfindən seçilməsi sınaqdan keçirilən kripto məlumat dəstlərində tək agentli və ya rule-based baseline-larla müqayisədə daha yüksək ümumi gəlir yarada bilər. Q-teacher-ın xüsusilə bəzi məlumat dəstlərində təlim səmərəliliyini və converged reward-u artırdığı ablation təcrübələri ilə dəstəklənir.
Tədqiqatın dəstəkləmədiyi nəticələr
Nəticələr EarnHFT-nin real exchange üzərində canlı pulla eyni gəliri təmin edəcəyini göstərmir. Tədqiqat simulyasiya mühitində aparılmışdır. Market impact, real order latency, exchange queue priority, packet loss, API throttling, co-location, rəqib HFT sistemlərinin reaksiyası və canlı bazarın bütün execution qeyri-müəyyənlikləri təcrübə mühitində tam şəkildə təmsil olunmur.
Bundan əlavə, seçilmiş dörd kripto trading pair üzərindəki uğur bütün kripto aktivlərinə, səhmlərə, fyuçerslərə və ya fərqli market-microstructure quruluşlarına avtomatik şəkildə ümumiləşdirilə bilməz.
Mənbə və Metod Qeydi
Orijinal iş: EarnHFT: Efficient Hierarchical Reinforcement Learning for High Frequency Trading.
Müəlliflər: Molei Qin, Shuo Sun, Wentao Zhang, Haochong Xia, Xinrun Wang və Bo An.
Qurum: Nanyang Technological University, Singapore.
Bərabər töhfə: Mənbə PDF, Molei Qin və Shuo Sun-ı bərabər töhfə verən müəlliflər kimi işarələyir.
arXiv: 2309.12891v1 [q-fin.TR].
arXiv tarixi: 22 Sentyabr 2023.
Mənbədəki nəşr qeydi: Copyright © 2024, Association for the Advancement of Artificial Intelligence (AAAI). Mənbə PDF-dən kənar biblioqrafik yoxlama aparılmadığı üçün resenziya/nəşr statusu bundan artıq şərh edilməmişdir.
Metod növü: Yüksək tezlikli kripto trading üçün üçmərhələli hierarchical reinforcement learning; dinamik proqramlaşdırma əsaslı Q-teacher; DDQN; fərqli bazar trendlərində ixtisaslaşdırılmış agent pool; dəqiqə səviyyəli dynamic strategy router.
Aşağı səviyyəli zaman miqyası: 1 saniyə.
Yüksək səviyyəli zaman miqyası: 1 dəqiqə.
Aşağı səviyyəli market representation: 60 saniyəlik rolling OHLC + LOB pəncərəsindən 54 xüsusiyyət və cari mövqe.
Yüksək səviyyəli market representation: 60 dəqiqəlik rolling OHLC pəncərəsindən 19 xüsusiyyət və cari mövqe.
Öyrədilən aşağı səviyyəli agent sayı: 200.
Trend preference parametrləri: \(\beta\in\{-90,-10,30,100\}\), hər biri 50 epoch.
GPU: NVIDIA RTX 4090.
Ümumi təcrübə müddəti: Mənbə təxminən 10 saat bildirir.
Məlumat dəstləri: BTC/TUSD, BTC/USDT, ETH/USDT və GALA/USDT saniyəlik bazar məlumatları.
Validation/test ayrımı: Son 9 gün test, əvvəlki 9 gün validation, qalan keçmiş dövr training.
Müqayisələr: PPO, DRA, DQN, CDQNRP, MACD və Imbalance Volume.
Maliyyə göstəriciləri: Total Return, Annual Sharpe Ratio, Annual Calmar Ratio, Annual Sortino Ratio, Annual Volatility və Maximum Drawdown.
Əsas eksperimental tapıntı: EarnHFT dörd test məlumat dəstinin hamısında ən yüksək Total Return dəyərini və üç məlumat dəstində ən güclü risk-adjusted profit nəticələrini bildirir.
Risk məhdudiyyəti: Müəlliflər metodun Q-teacher və optimal actor səbəbindən profit-oriented və nisbətən aqressiv olduğunu, bəzi risk göstəricilərində yalnız orta səviyyəli performans verdiyini qeyd edirlər.
Mənbədaxili uyğunsuzluq 1: Əsas mətndəki %0,02 komissiya nisbəti ilə Əlavə D.3-dəki %0,015 nisbəti uyğun gəlmir.
Mənbədaxili uyğunsuzluq 2: Məlumat dəsti cədvəli ETH/USDT-ni Bear kimi təsnif etdiyi halda ablation izahında bir yerdə ETH üçün “market is bull” ifadəsi istifadə edilmişdir. Eyni tədqiqatın digər bölmələri ETH test dövrünü düşüş bazarı kimi təsvir edir.
Əsas məhdudiyyət: Təcrübələr yüksək dəqiqlikli simulyasiya trading environment daxilində aparılmışdır; canlı istehsal HFT sistemi üzərində uçdan-uca real pul trading performansı sınaqdan keçirilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib