

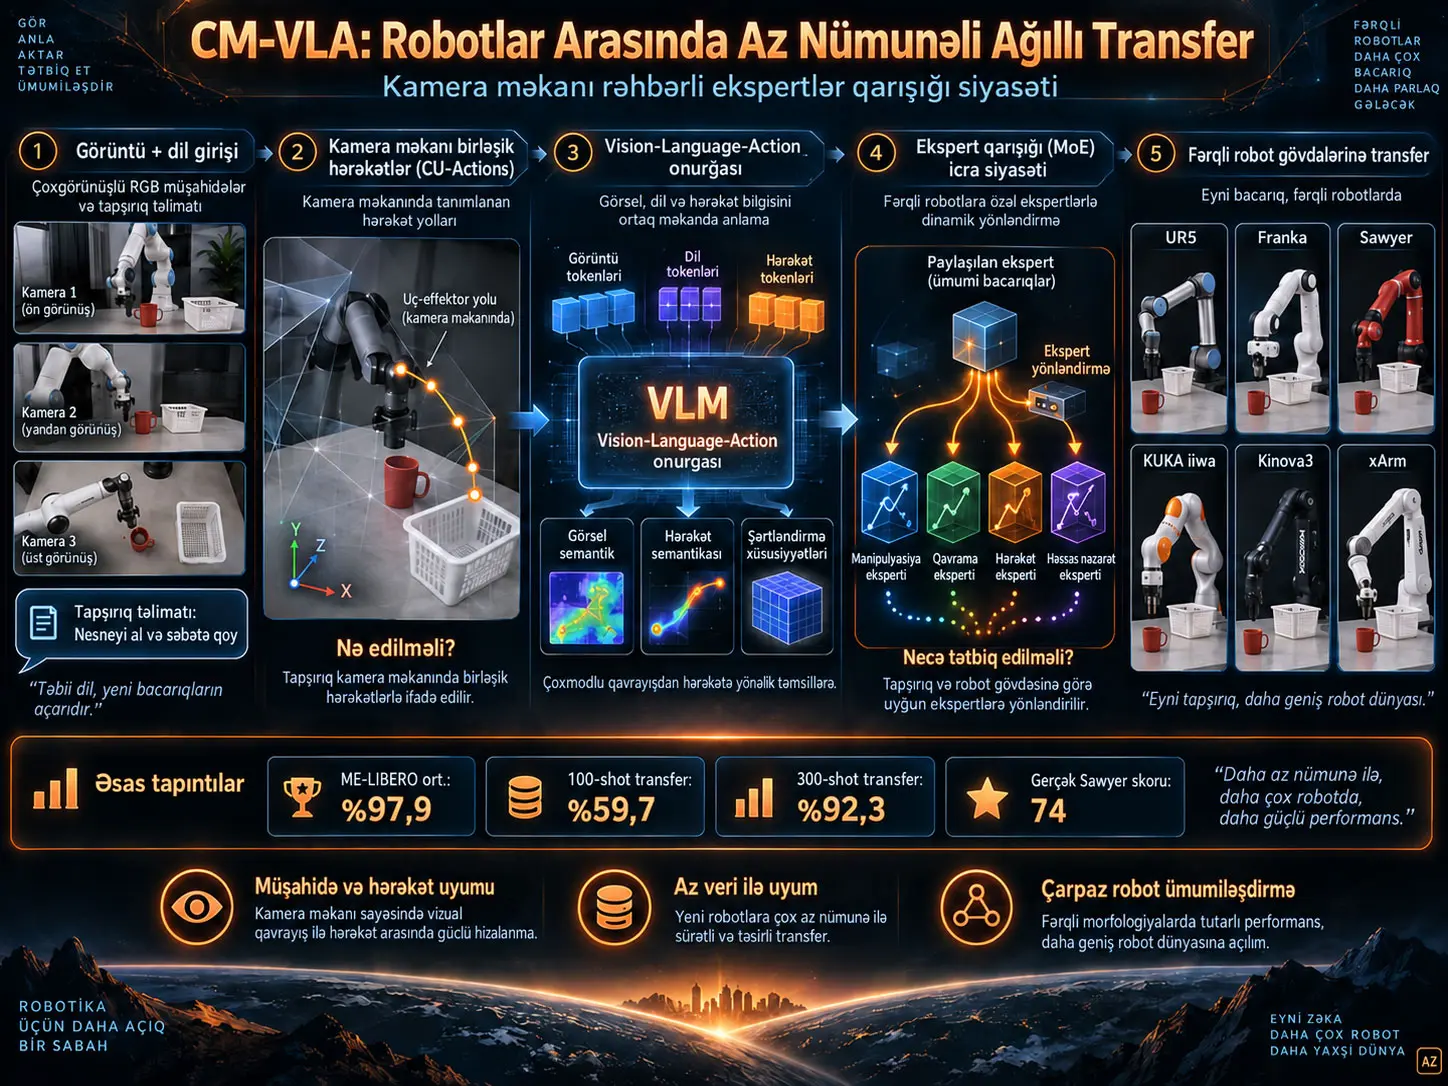
CM-VLA, fərqli robot gövdələri arasında az sayda yeni nümayişlə tapşırıq transferini asanlaşdırmaq üçün kamera məkanında ortaq hərəkət semantikası ilə robota xas icra siyasətini bir-birindən ayıran Vision-Language-Action arxitekturasıdır. Model Camera-space Unified Actions (CU-Actions) adlanan kamera-məkanı hərəkətlərini VLM onurğası üçün köməkçi nəzarət kimi istifadə edir; sonra embodiment-aware Mixture-of-Experts (MoE) flow policy ortaq semantikanı hədəf robotun kinematik quruluşuna və idarəetmə xüsusiyyətlərinə uyğun davamlı robot-məkanı hərəkətlərinə çevirir. Tədqiqatda CM-VLA ME-LIBERO üzərində %97,9 orta uğura, görünməmiş robotlara 100 nümayişlik transferdə %59,7 və 300 nümayişdə %92,3 orta uğura çatmışdır. Real Sawyer robot təcrübələrində orta normallaşdırılmış skor %74 kimi bildirilmişdir. Bununla birlikdə nəticələr tək qollu end-effector delta nəzarəti kontekstində əldə edilmişdir və modelin iki qollu robotlara, bacarıqlı əllərə və ya fərqli hərəkət məkanlarına eyni performansla genişlənəcəyi göstərilməmişdir.
Vision-Language-Action modeli vizual müşahidə və təbii dil təlimatlarını robotun icra edə biləcəyi hərəkətlərə çevirən çoxmodallı robotika siyasəti sinfidir. CM-VLA-nın ayırıcı xüsusiyyəti “nə ediləcəyinə” dair robotlar arasında paylaşıla bilən semantikanı kamera məkanında öyrənməsi və “necə icra ediləcəyinə” dair robota xas icranı ayrıca ekspertlər qarışığı siyasətinə buraxmasıdır.
Niyə fərqli robotlar arasında tapşırıq transferi çətindir?
Robot manipulyasiya tapşırığı semantik olaraq eyni qalsa belə, tapşırığı yerinə yetirən fiziki robot dəyişəndə problem sadə koordinat çevrilməsindən daha mürəkkəb olur. Robotların oynaq sayları, link uzunluqları, iş məkanları, sensorları, proprioseptiv vəziyyət paylanmaları, kamera mövqeləri, idarəetmə tezlikləri və gripper mexanizmləri fərqli ola bilər.
Məsələn, “yaşıl parçanı götür və boşqabın üzərinə qoy” təlimatı UR5, Franka Panda, Sawyer, KUKA iiwa, Kinova3 və xArm üçün eyni tapşırıq semantikasını daşıyır. Ancaq hər robotun eyni sonlandırıcı hərəkətini yerinə yetirmək üçün ehtiyac duyduğu aşağı səviyyəli hərəkət komandaları eyni deyil.
Tədqiqatın ələ aldığı əsas problem bu iki səviyyənin mövcud VLA sistemlərində kifayət qədər ayrışdırılmamasıdır. Vizual kodlayıcı kameradan gələn görüntünü emal edərkən, hərəkət etiketi çox məlumat dəstində robotun öz koordinat sistemində müəyyən edilir. Beləliklə model tapşırığı öyrənməklə yanaşı, kamera ilə robot koordinat sistemi arasındakı çevrilməni də örtük şəkildə həll etməyə məcbur qalır.
CM-VLA nədir?
CM-VLA kamera məkanında müəyyən edilmiş gövdədən asılı olmayan hərəkət semantikasını vision-language onurğasında öyrənən və bu semantikanı embodiment-aware Mixture-of-Experts flow policy vasitəsilə hədəf robotun davamlı idarəetmə komandalarına çevirən cross-embodiment VLA arxitekturasıdır. Modelin əsas fərqi kamera məkanındakı qavrayış yönlü “nə edilməlidir?” təmsili ilə robot məkanındakı icra yönlü “necə edilməlidir?” idarəetməsini iki ayrı öyrənmə problemi kimi ele almasıdır.
Kamera-məkanı birləşik hərəkətlər
Tədqiqatın əsas ara təmsili Camera-space Unified Action, yəni CU-Action-dır. Hər zaman addımındakı kamera-məkanı hərəkəti belə müəyyən edilir:
\[ a_t^c=(\Delta p_t^c,\Delta r_t^c,g_t) \]
Burada:
- \(\Delta p_t^c\) sonlandırıcının kamera koordinat sistemindəki translasiya dəyişimini;
- \(\Delta r_t^c\) kamera koordinat sistemindəki fırlanma dəyişimini;
- \(g_t\) gripper komandasını təmsil edir.
Bu göstərimin elmi rolu robotun öz oynaq və ya baza koordinatlarından mümkün qədər müstəqil ara hərəkət semantikası yaratmaqdır. Kamera görüntüsü də kamera məkanında müşahidə edildiyi üçün hərəkət nəzarətinin eyni həndəsi bağlama daşınması müşahidə ilə hərəkət etiketi arasındakı uyğunsuzluğu azaltmağı məqsədləyir.
Əhəmiyyətli bir detal CU-Actions-ın birbaşa son robot idarəetmə komandası kimi istifadə edilməməsidir. Tədqiqatda discretized CU-Actions VLM onurğasının təlimi üçün köməkçi nəzarət vəzifəsi görür. Gerçək icra edilə bilən davamlı robot hərəkətləri ayrıca downstream policy tərəfindən yaradılır.
CM-VLA “nə ediləcəyini” və “necə ediləcəyini” necə ayırır?
CM-VLA-da kamera-məkanı VLM qatı vizual müşahidə və dil təlimatından embodiment-agnostic hərəkət semantikasını öyrənərək “nə ediləcəyini” təmsil edir; robot-məkanı MoE flow policy isə robotun proprioseptiv vəziyyəti və embodiment şərtindən istifadə edərək eyni semantikanın konkret robot üzərində “necə tətbiq ediləcəyini” davamlı idarəetmə siqnallarına çevirir.
Vision-language onurğası
VLM onurğası PaliGemma əsaslıdır. PaliGemma SigLIP vizual kodlayıcısı ilə Gemma dil modelini birləşdirir. Modelə bir neçə RGB müşahidəsi və dil təlimatı verilir:
\[ \pi_\phi(a_t^c,\hat l_t \mid I_t^1,\ldots,I_t^n,l) \]
Burada \(a_t^c\) CU-Action, \(\hat l_t\) isə tapşırıq planı, alt tapşırıq ayrımı, hərəkət primitive-ləri və gripper mövqeyi kimi əlavə qavrayış yönlü tapşırıq quruluşunu təmsil edən tokenləşdirilmiş reasoning çıxışıdır.
VLM-in seçilmiş qatlarından alınan gizli vəziyyətlər açar-dəyər xüsusiyyətlərinə proyeksiya edilir:
\[ K_t^{(m)}=H_t^{(m)}W_K^{(m)}, \qquad V_t^{(m)}=H_t^{(m)}W_V^{(m)} \]
Bu xüsusiyyətlər:
\[ C_t=\{(K_t^{(m)},V_t^{(m)})\}_{m\in M} \]
şərtləndirmə çoxluğunu yaradır və cross-attention üzərindən davamlı robot hərəkəti yaradan alt siyasətə ötürülür. Müəlliflərin dizaynında vacib məqam yalnız son VLM qatından istifadə etmək əvəzinə seçilmiş qatlar üzrə zəngin KV şərtləndirməsi təmin etməkdir.
CU-Action təlim hədəfləri
Mətn reasoning çıxışı üçün causal attention və token-token proqnozu istifadə olunur:
\[ L_{cot}=-\sum_{k=1}^{K}\log\pi_\phi(l_t^k\mid v_t,l_t^{<k}) \]
Discretized CU-Actions üçün isə bütün hərəkət ardıcıllığındakı əlaqələri birlikdə modelləyə bilmək məqsədilə full-attention istifadə olunur:
\[ L_{cu\_action}=-\sum_{m=1}^{M}\log\pi_\phi(a_m^c\mid v_t,l) \]
Müəlliflər bu seçimin CU-Action ardıcıllığında daha bütöv və yumşaq keçidli hərəkət quruluşları öyrənməyə kömək etdiyini bildirirlər.
Robot-məkanı Mixture-of-Experts siyasəti
İkinci mərhələdə model kamera-məkanı semantikasını gerçək robotun işlədə biləcəyi davamlı robot-space action, yəni RS-Actions-a çevirir. Bunun üçün flow matching əsaslı Transformer siyasəti istifadə olunur.
Siyasətin ilk qatları bütün robotlar üçün ortaq emal aparır. Daha dərindəki son altı blok isə MoE bloklarıdır. Embodiment şərti \(e_k\) ortaq təmsillə birləşdirilərək robota xas ekspert yönləndirməsi üçün istifadə olunur.
Hər token üçün router yönləndirilə bilən ekspertlər üzərində ehtimal paylanması yaradır:
\[ \alpha_{t,u}^{(\ell)} = \operatorname{Softmax} \left( Router_\ell( LN(\tilde z_{t,u}^{(\ell)}) ) \right) \]
Yalnız ən yüksək skorlu Top-K ekspert aktivləşdirilir.
Paylaşılan ekspert ilə yönləndirilən ekspertlərin fərqi
Hər MoE blokunda davamlı aktiv olan bir shared expert və embodiment fərqlərini modelləyən ekspert hovuzu vardır:
\[ MoE_{\ell,u}(\tilde z) = E_{\ell}^{sh}(\tilde z) + \sum_{j\in TopK(\alpha)} \alpha_jE_{\ell,j}(\tilde z) \]
Shared expert robotlar arasında ortaq olan icra quruluşunu öyrənməyə yönəlib. Routed experts isə kinematik sərhədlər, idarəetmə tezliyi, hərəkət interfeysi və icra forması kimi robotlar arasında dəyişən xüsusiyyətləri udur.
Buradakı elmi fikir “hər robot üçün tək ekspert” yaratmaq deyil. Müəlliflər xüsusilə overcomplete expert pool istifadə edir və ekspertlərin fərqli robotlar arasında qismən paylaşılmasını istəyirlər.
Embodiment-aware routing loss
CM-VLA-nın mühüm yeniliklərindən biri router-in yalnız tapşırıq məzmununa deyil, robot gövdəsinin icra xüsusiyyətlərinə də həssas ekspert seçimləri öyrənməsini təşviq edən \(L_{emb}\) itkisidir.
Əsas forması:
\[ L_{emb}=L_{intra}+\lambda_{sep}L_{inter} \]
\(L_{intra}\) eyni embodiment üçün fərqli tapşırıqlardakı yönləndirmə nümunələrinin bir-birinə yaxın qalmasını təşviq edir. \(L_{inter}\) isə fərqli embodiment prototiplərinin müəyyən margin daxilində bir-birinə həddindən artıq yaxınlaşmasını cəzalandırır.
Bu itkinin məqsədi tapşırıq fərqi ilə robot fərqini qarışdırmadan, eyni tapşırıq semantikası altında robot icrasından qaynaqlanan fərqlərin ekspert seçimində görünən hala gəlməsidir.
Load-balancing loss
Sparse MoE sistemlərində bir neçə ekspertin davamlı seçilməsi və digərlərinin istifadə edilməməsi “expert collapse” probleminə yol aça bilər. CM-VLA bunu azaltmaq üçün ekspertlərin empirik istifadə tezliyi ilə gözlənən routing ehtimalını istifadə edən balanslaşdırma termini tətbiq edir:
\[ L_{bal}=\sum_{j=1}^{N_E}f_jP_j \]
Mənbədə bu terminin embodiment ayrımını aradan qaldırmaq üçün deyil, ekspert hovuzunun həddindən artıq bir neçə ekspertdə sıxlaşmasının qarşısını almaq üçün istifadə edildiyi xüsusilə vurğulanır.
Flow-matching loss
Robot-məkanı davamlı hərəkətləri flow matching ilə yaradılır. Gerçək hərəkət chunk-ı \(A_t^r\), Gaussian səs-küyü \(\epsilon\) və axın zamanı \(\tau\) istifadə edilərək:
\[ x_t^\tau=(1-\tau)\epsilon+\tau A_t^r \]
şəklində səs-küylü ara vəziyyətə çevrilir. Hədəf vektor sahəsi:
\[ u_t^\tau=A_t^r-\epsilon \]
kimi müəyyən edilir və siyasət bu vektor sahəsini öyrənir:
\[ L_{fm} = \mathbb{E} \left[ \|v_\theta(x_t^\tau,\tau,q_t,e_k;C_t)-u_t^\tau\|_2^2 \right] \]
Ümumi təlim itkisi:
\[ L=L_{fm}+\lambda_{bal}L_{bal}+\lambda_{emb}L_{emb} \]
şəklindədir. Mənbədə \(\lambda_{bal}=0.15\) və \(\lambda_{emb}=1\) kimi verilmişdir.
CU-Actions gerçək dünyada necə yaradılır?
Simulyasiyada robot sonlandırıcı pozu və kamera kalibrlənməsi birbaşa əlçatan olduğundan robot məkanındakı pose kamera koordinatlarına çevrilir. Ardıcıl iki kadr arasındakı nisbi kamera-məkanı hərəkəti:
\[ \Delta T_t^c=T_{t+1}^c(T_t^c)^{-1} \]
ilə hesablanır və translasiya, fırlanma ilə gripper vəziyyətinə ayrılaraq CU-Action etiketi yaradılır.
Gerçək robotda birbaşa kamera-robot extrinsic çevrilməsindən istifadə etmək oynaq sıfır sürüşmələri, link toleransları, lens distorsiyası, intrinsic xəta və hand-eye kalibrləmə xətalarından təsirlənə bilər. Buna görə tədqiqat gerçək dünya etiketlərində marker-free FEEPE metodundan yararlanır.
Əlavə B-də göstərildiyi kimi end-effector CAD modeli üçün 80 baxış bucağı və 12 in-plane rotasiya istifadə edilərək ümumilikdə 960 referans template yaradılmışdır. DINOv2 xüsusiyyətləri ilə hədəf görüntüyə ən yaxın beş referans görünüş seçilmiş, 2D–3D uyğunluqları və PnP ilə başlanğıc pozu təxmin edilmişdir. Temporal keyframe metodu ən çox səkkiz keyframe istifadə edir və keyframe yeniləmə bucağı 10° kimi verilmişdir.
Tədqiqatın metodu və tapıntıları
Model və təlim infrastrukturu
- Təxmini model ölçüsü: 4 milyard parametr.
- VLM başlanğıcı: PaliGemma-3B.
- VLM qat sayı: 18.
- Gizli ölçü: 2048.
- Vizual encoder: SigLIP.
- Görüntü ölçüsü: 224 × 224.
- Təlim avadanlığı: 16 NVIDIA A800, hər biri 80 GB.
- Ön təlim müddəti: 14 gün.
- Global batch size: 512.
- Optimizer: AdamW.
- \(\beta_1=0.9\), \(\beta_2=0.95\).
- Təlim addımı: 60.000.
- Başlanğıc learning rate: 5×10⁻⁵.
- Warm-up: 2.000 addım.
- Learning-rate schedule: cosine decay.
- Action horizon: H=50.
- MoE: 16 routed expert + 1 davamlı aktiv shared expert.
- Routing: Top-4.
- \(L_{inter}\) margin dəyəri: 0,25.
Ön təlim məlumat mənbələri
Ön təlim məlumat hovuzu Open X-Embodiment (OXE), LIBERO və DROID məlumat dəstlərindən yaradılmışdır və ümumilikdə 19 embodiment ilə müxtəlif manipulyasiya tapşırıqlarını əhatə edir.
ME-LIBERO nədir?
ME-LIBERO orijinal LIBERO benchmark-ını eyni tapşırıq semantikasını fərqli robot gövdələri altında qiymətləndirəcək şəkildə genişləndirən çox-embodiment test mühitidir. Tədqiqatda altı tək qollu robot istifadə edilmişdir:
- UR5
- Franka Panda
- Sawyer
- KUKA iiwa
- Kinova3
- xArm
Dil təlimatı, obyektlər, səhnə düzəni, tapşırıq hədəfi və bitirmə şərtləri sabit saxlanarkən robotun vizual müşahidəsi, CU-Actions, RS-Actions, kinematik quruluşu, iş geometriyası və proprioseptiv statistikaları dəyişir. Bu dizayn embodiment heterogenliyinin tapşırıq semantikasından mümkün qədər ayrışdırılmasını məqsədləyir.
CM-VLA Few-Shot robot transferində nə qədər uğurludur?
ME-LIBERO leave-one-robot-out qiymətləndirməsində CM-VLA-nın altı hədəf robot üzərində orta uğur nisbəti 50 nümayişdə %33,7, 100 nümayişdə %59,7, 300 nümayişdə %92,3, 500 nümayişdə %93,5 və 1000 nümayişdə %97,0-dır. Tədqiqatın qiymətləndirmə protokolunda model 100-shot şərtində altı hədəf robotun hamısında ən yüksək nəticəni əldə etmiş, 300-shot şərtində isə altı robotun dördündə ən yüksək performansı göstərmişdir.
LIBERO və ME-LIBERO nəticələri
| Metod | LIBERO orta | ME-LIBERO orta |
|---|---|---|
| OpenVLA | 76,5% | 73,2% |
| π0 | 92,1% | 84,9% |
| π0.5 | 96,9% | 94,5% |
| OC-VLA | 95,0% | 95,7% |
| CM-VLA | 97,0% | 97,9% |
Tək embodiment LIBERO mühitində CM-VLA %97,0 ilə ən yüksək orta nəticəni vermişdir. Çox embodiment ME-LIBERO mühitində isə fərq daha da aydın olmuş və CM-VLA %97,9-a çatmışdır.
Gerçək Sawyer robotu qiymətləndirməsi
Gerçək dünya təcrübələri Sawyer robotu üzərində dörd fərqli ümumiləşdirmə şərtində aparılmışdır:
- fərqli məkan münasibətləri,
- fərqli hədəf rəngləri,
- eyni səhnədə fərqli hədəflər,
- fərqli səhnələrdən ibarət out-of-domain ümumiləşdirmə.
| Metod | Orta normallaşdırılmış skor |
|---|---|
| OpenVLA | 19 |
| π0 | 44 |
| π0.5 | 60 |
| OC-VLA | 55 |
| CM-VLA | 74 |
CM-VLA dörd gerçək dünya şərtinin hamısında müqayisə edilən metodlardan daha yüksək nəticə vermişdir. Ən böyük nisbi üstünlüyün səhnənin tam dəyişdiyi out-of-domain şərtdə müşahidə olunması müəlliflərin kamera-məkanı semantikasının vizual paylanma dəyişmələrinə qarşı daha möhkəm transfer edilə bildiyi şərhini dəstəkləyir.
Leave-one-robot-out few-shot transferi
Bu təcrübədə altı robotdan biri təlim zamanı tamamilə kənarda saxlanır. Qalan beş robotla model öyrədildikdən sonra görünməyən hədəf robota yalnız 50, 100, 300, 500 və ya 1000 nümayiş verilərək fine-tuning aparılır.
| Hədəf robot nümayiş sayı | Orta uğur |
|---|---|
| 50-shot | 33,7% |
| 100-shot | 59,7% |
| 300-shot | 92,3% |
| 500-shot | 93,5% |
| 1000-shot | 97,0% |
Müəlliflər praktiki mənalılıq həddini %90 orta uğur kimi götürdükdə CM-VLA-nın bu həddə çatmaq üçün lazım olan nümayiş sayı baxımından rəqib metodlara görə təxminən %13,6–69,7 məlumat səmərəliliyi artışı təmin etdiyini bildirirlər.
100-shot şərtində robota xas CM-VLA nəticələri UR5 üçün %59,8; Franka üçün %60,9; Sawyer üçün %52,6; KUKA iiwa üçün %61,0; Kinova3 üçün %60,4 və xArm üçün %63,4 kimi verilmişdir.
Kamera-məkanı nəzarəti həqiqətən fərq yaradırmı?
| VLM nəzarəti | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|
| Standart | 91,8% | 50,9% | 84,2% |
| Discretized RS-Actions | 94,1% | 55,8% | 87,3% |
| Discretized CU-Actions | 97,9% | 59,7% | 92,3% |
RS-Actions əvəzinə CU-Actions ilə VLM nəzarəti ME-LIBERO uğurunu %94,1-dən %97,9-a, 100-shot transferini %55,8-dən %59,7-yə və 300-shot transferini %87,3-dən %92,3-ə çıxarmışdır.
MoE siyasətinin ablasiyası
| Siyasət | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|
| Dense Flow Policy | 95,2% | 22,3% | 50,0% |
| Vanilla Sparse MoE | 98,0% | 4,8% | 15,7% |
| MoE + Shared Expert | 97,8% | 7,8% | 25,7% |
| Shared Expert + Lbal | 94,7% | 6,8% | 23,4% |
| Shared Expert + Lemb | 95,2% | 40,6% | 82,0% |
| Tam CM-VLA | 97,9% | 59,7% | 92,3% |
Bu cədvəl mühüm elmi nəticəni ortaya qoyur: yalnız daha böyük və ya sparse bir MoE istifadə edilməsi cross-embodiment transfer üçün yetərli deyil. Vanilla Sparse MoE təlim paylanmasında yüksək nəticə versə də, görünməyən robotlarda ciddi şəkildə uğursuz olmuşdur.
Ən böyük transfer yaxşılaşması embodiment-aware routing loss əlavə edildikdə ortaya çıxmışdır. Load-balancing loss isə təkbaşına yüksək transfer yaratmasa da, ekspert istifadəsinin bir neçə ekspertə çökməsinin qarşısını alan tamamlayıcı rol oynayır.
Ekspertlər həqiqətən robotlara görə ixtisaslaşırmı?
Mənbənin 14-cü səhifəsindəki Şəkil 6-da 16 routed expert-in altı robot üçün aktivləşmə statistikaları verilir. UR5 xüsusilə E1, E6, E9 və E12; Franka Panda isə E2, E8, E10 və E11 ekspertlərini daha güclü aktivləşdirmişdir. Bununla birlikdə heç bir ekspert yalnız bir robota xas deyil və bütün ekspertlərdə sıfırdan böyük istifadə müşahidə olunur.
Bu davranış modelin “robot kimliyi = ekspert” kimi kobud uyğunlaşdırma öyrənmədiyini; bəzi icra xüsusiyyətlərini robotlar arasında paylaşarkən bəzilərini embodiment-a xas ayırdığını düşündürür.
Franka üçün MoE dərinliyi boyunca aparılan analizdə ən sıx istifadə olunan dörd ekspertin ümumi aktivləşmə payı birinci qatda təxminən %43,4 ikən altıncı MoE qatında təxminən %63,4-ə yüksəlmişdir. Müəlliflər bunu embodiment-spesifik ixtisaslaşmanın erkən qatda qəfil ortaya çıxmadığı, hərəkət təmsili dərinləşdikcə mərhələli şəkildə formalaşdığı kimi şərh edirlər.
Ekspert sayı və Top-K həssaslığı
Əlavə E-dəki təcrübələrdə ən yaxşı kombinasiya 16 routed expert və Top-4 kimi tapılmışdır:
| Ekspert sayı | Top-K | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|---|
| 8 | 2 | 96,9% | 54,2% | 88,1% |
| 8 | 4 | 97,2% | 56,4% | 89,7% |
| 16 | 2 | 97,4% | 57,9% | 90,8% |
| 16 | 4 | 97,9% | 59,7% | 92,3% |
| 32 | 8 | 97,3% | 57,9% | 90,9% |
Çox az ekspert embodiment fərqlərini modelləmə tutumunu məhdudlaşdırarkən, həddindən artıq çox ekspert paylaşımı azaldaraq routing-in parçalanmasına yol aça bilər. Bənzər şəkildə çox aşağı Top-K ifadə tutumunu məhdudlaşdırır; çox yüksək Top-K isə sparse ixtisaslaşmanı zəiflədir.
Embodiment şərtinin məzmunu
Tam embodiment embedding \(e_k\) dörd növ məlumat ehtiva edir:
- robot kimliyi,
- qolun sərbəstlik dərəcəsi,
- link uzunluğu statistikaları,
- gripper tipi.
Yalnız ID istifadə edildikdə 100-shot nəticəsi %53,9 və 300-shot nəticəsi %87,0 ikən tam embodiment açıqlaması ilə bu dəyərlər müvafiq olaraq %59,7 və %92,3-ə yüksəlmişdir. Bu nəticə qazancın yalnız robot etiketinin əzbərlənməsindən qaynaqlanmadığına dair ablasion dəstək təmin edir.
Tədqiqatın dəstəklədiyi nəticələr
- Kamera-məkanı CU-Action nəzarəti bu təcrübə düzənində robot-space action nəzarətindən daha yüksək cross-embodiment transfer performansı təmin etmişdir.
- Paylaşılan ekspert, embodiment-aware routing və load-balancing birlikdə istifadə edildikdə görünməyən robotlara transfer aydın şəkildə yaxşılaşmışdır.
- CM-VLA həm LIBERO, həm də ME-LIBERO-da müqayisə edilən əsas VLA baseline-larından daha yüksək orta uğur vermişdir.
- Gerçək Sawyer robot qiymətləndirməsində CM-VLA ən yüksək orta normallaşdırılmış skoru yaratmışdır.
- Few-shot leave-one-robot-out təcrübələrində xüsusilə 50–300 nümayiş aralığında güclü nümunə səmərəliliyi əldə edilmişdir.
- Routing analizi fərqli robotların fərqli, lakin qismən paylaşılmış ekspert istifadə naxışları inkişaf etdirdiyini göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
- CM-VLA-nın bütün robot növlərində eyni uğuru göstərəcəyi sübut edilməmişdir.
- Bimanual manipulyasiya qiymətləndirilməmişdir.
- Dexterous-hand nəzarəti qiymətləndirilməmişdir.
- End-effector delta xaricində yüksək ölçülü hərəkət məkanlarında eyni performans göstərilməmişdir.
- ME-LIBERO simulyasiya nəticələri təkbaşına geniş miqyaslı sənaye sahə uğuru mənasına gəlmir.
- Gerçək dünya təcrübələri Sawyer robotu və mənbədə müəyyən edilən tapşırıq şərtləri ilə məhduddur.
- “State-of-the-art” ifadəsi yalnız tədqiqatın seçdiyi baseline və qiymətləndirmə protokolları kontekstində şərh edilməlidir.
Məhdudiyyətlər
Tədqiqatın ilk əsas məhdudiyyəti arxitekturanın əsasən tək qollu end-effector delta nəzarət probleminə görə inkişaf etdirilmiş olmasıdır. Müəlliflər iki qollu manipulyasiya, dexterous hand və daha yüksək ölçülü idarəetmə interfeyslərini gələcək iş sahələri kimi açıq göstərirlər.
İkinci məhdudiyyət gerçək dünyadakı CU-Action etiketlərinin FEEPE əsaslı pose estimation sistemindən gəlməsidir. Üst gripper müstəvisinin kamera baxışına təxminən paralel olduğu hallarda poz təxmin xətası arta bilər.
Üçüncü olaraq gerçək robot təcrübələrinin əhatəsi simulyasiya benchmark-ına nisbətən daha dardır. Nəticələr fərqli fiziki robotlar, fabrik şəraitləri, uzunmüddətli iş, təhlükəsizlik baxımından kritik tapşırıqlar və ya idarəetmə gecikmələrinin geniş spektri üçün birbaşa ümumiləşdirilə bilməz.
Dördüncü olaraq təxminən 4 milyard parametrli modelin 16 ədəd 80 GB NVIDIA A800 üzərində 14 gün ön təlim tələb etməsi metodun hesablama xərcinin aşağı olmadığını bildirir. Məqalənin “few-shot” üstünlüyü hədəf robot üçün lazım olan yeni nümayiş sayına aiddir; əsas modelin ilkin təlim xərcinin kiçik olduğu anlamına gəlmir.
Mənbə və metod qeydi
Orijinal başlıq: CM-VLA: Camera-Space-Guided Mixture-of-Experts Policy for Few-shot Cross-Embodiment Transfer
Müəlliflər: Bo Liu, Liming Zhang, Yuhan Wang, Yong Liu.
Məsul müəllif: Yong Liu.
Qurum: Nanjing University of Science and Technology, Nanjing, Jiangsu, China.
Əlavə afiliyasiya: State Key Laboratory of Intelligent Manufacturing of Advanced Construction Machinery, Xuzhou, Jiangsu, China.
Mənbə növü: Preprint tədqiqat məqaləsi; rəyçi qiymətləndirməsindən keçməmişdir.
Platforma: SSRN.
SSRN DOI: 10.2139/ssrn.6915199.
Yayın tarixi: 10 iyun 2026.
Rəsmi qeyd: https://ssrn.com/abstract=6915199
Maliyyələşdirmə: National Natural Science Fund of China, Grant No. 61473155.
Maraqlar toqquşması: Müəlliflər bilinən rəqib maliyyə marağı və ya işi təsirləyə biləcək şəxsi münasibət olmadığını bəyan etmişdir.
Müəllif töhfələri: Bo Liu metod, tədqiqat, məlumat kurasiyası və ilk qaralama; Liming Zhang proqram təminatı və məlumat kurasiyası; Yuhan Wang məlumat kurasiyası; Yong Liu konseptuallaşdırma, maliyyə təminatı və yazı qiymətləndirməsi vəzifələrini üzərinə götürmüşdür.
Kod və nümayişlər: Mənbə tədqiqat kod və demonstrasiyaların lbycdy.github.io/CM-VLA/ ünvanında yayımlanacağını bildirir.
Metodik sərhəd: Tapıntılar tək qollu end-effector delta nəzarəti, LIBERO/ME-LIBERO benchmark-ları və mənbədə müəyyən edilən gerçək Sawyer robot qiymətləndirmələrinə aiddir. Daha geniş embodiment və hərəkət məkanlarında müstəqil doğrulama lazımdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib