

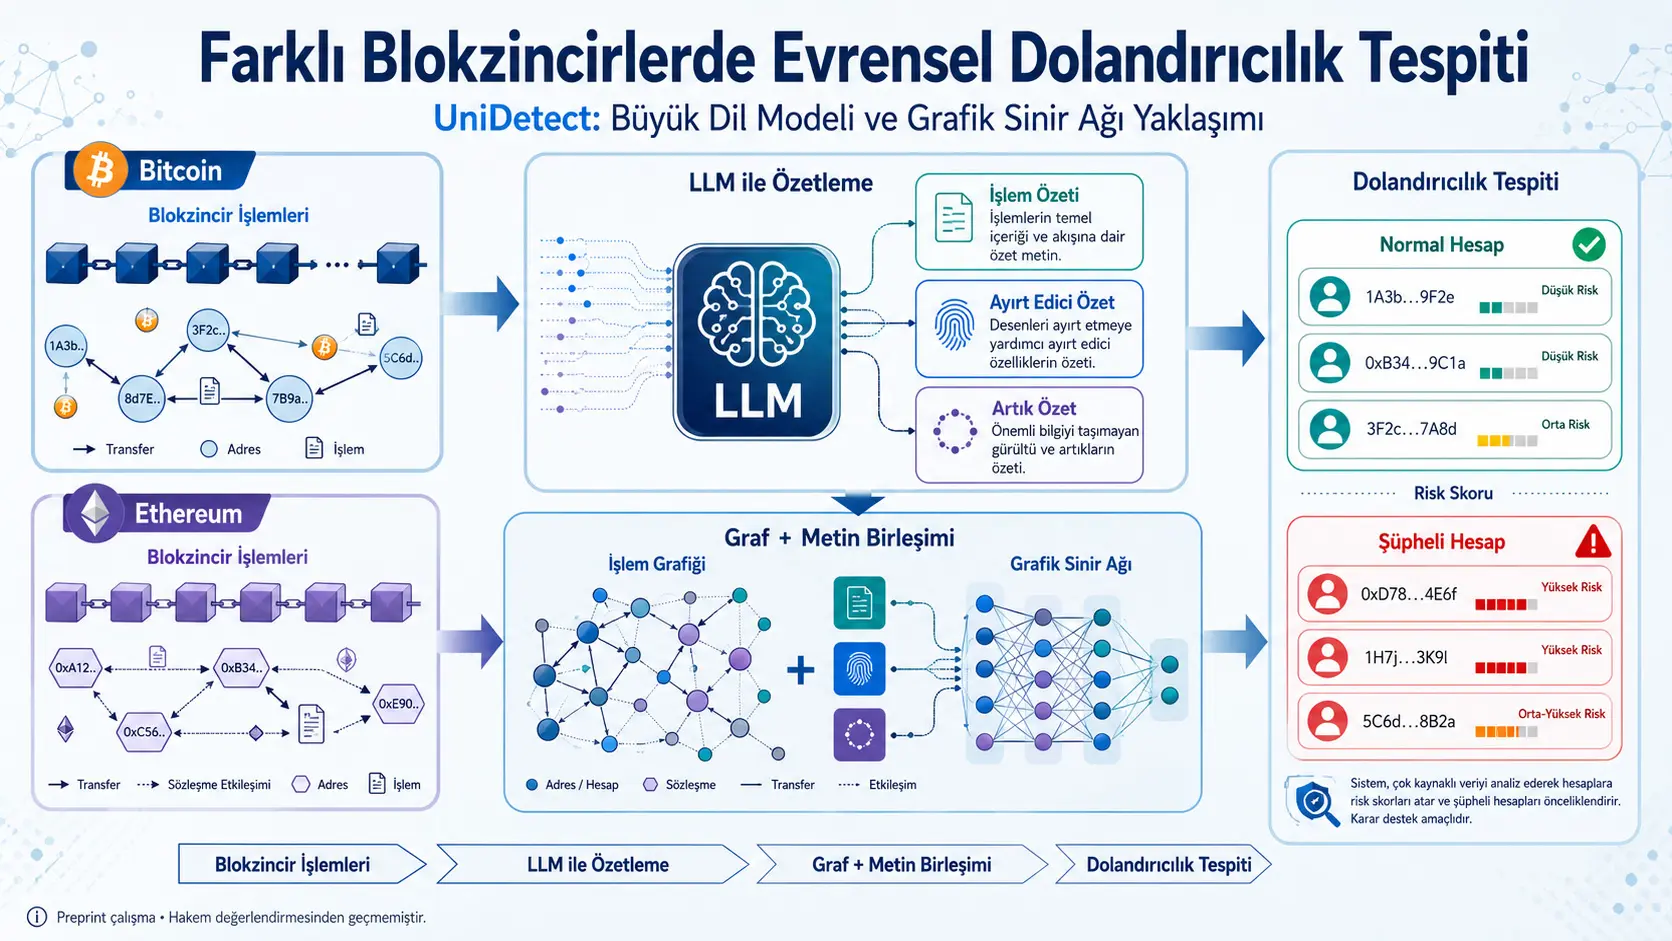
Bu çalışma, Ethereum ve Bitcoin gibi veri yapıları birbirinden farklı blokzincirlerdeki dolandırıcılık hesaplarının tek bir modelle tespit edilip edilemeyeceğini incelemektedir. Araştırmacılar, hesapların işlem geçmişini büyük dil modeliyle metinsel özetlere dönüştüren, bu özetlerdeki ayırt edici bilgiyi olası halüsinasyon ve görev dışı içerikten ayıran ve elde edilen metin temsillerini işlem grafiğiyle birleştiren UniDetect adlı bir yöntem geliştirmiştir. Ethereum deneylerinde UniDetect yüzde 92,65 F1, yüzde 94,82 AUC ve yüzde 68,94 Kolmogorov-Smirnov değeri; Bitcoin-M ve Bitcoin-L veri setlerinde ise sırasıyla yüzde 92,98 ve yüzde 93,41 F1 değeri bildirmiştir. Bununla birlikte çalışma bir preprinttir; çapraz zincir sıfır örnekli uygulamada dolandırıcılık hesapları için geri çağırma yüzde 94,58’in üzerinde kalırken kesinliğin yaklaşık yüzde 60-63 düzeyinde olması, çok sayıda normal hesabın yanlış alarm olarak işaretlenebileceğini göstermektedir.
UniDetect’in temel fikri, blokzincir işlemlerini yalnızca miktar, sıklık veya düğüm derecesi gibi sayısal özelliklerle değerlendirmemektir. Model; para akışının toplanma ya da dağıtılma biçimini, işlem zamanlamasını, karşı taraf çeşitliliğini ve işlem grafiğindeki komşuluk örüntülerini ortak bir temsil içinde birleştirmektedir. Büyük dil modeli hesapların işlem geçmişini açıklayan metinsel kanıt üretirken grafik sinir ağı, hesabın işlem ağındaki yapısal konumunu ve ilişkilerini değerlendirmektedir.
Çalışmanın en dikkat çekici sonucu, aynı modelin farklı blokzincirlerde yüksek geri çağırma elde edebilmesidir. Ancak “dolandırıcılık hesaplarının yüzde 94,58’inden fazlasını belirleme” sonucu genel doğruluk anlamına gelmemektedir. Bu değer dolandırıcılık sınıfındaki geri çağırmayı ifade eder; aynı deneylerde kesinliğin düşük kalması, modelin gerçek bir denetim sisteminde tek başına nihai karar mekanizması olarak kullanılmaması gerektiğini göstermektedir.
Araştırmanın temel sorusu nedir?
Çalışmanın temel sorusu, veri yapıları, işlem mekanizmaları ve olay anlamları birbirinden farklı olan blokzincirlerde dolandırıcılık hesaplarının ortak bir temsil ve ortak bir sınıflandırıcı kullanılarak belirlenip belirlenemeyeceğidir. Geleneksel yöntemlerin önemli bir bölümü Ethereum veya Bitcoin gibi belirli bir zincire göre elle hazırlanmış özelliklere dayanır. Ethereum için yararlı olan gaz harcaması, akıllı sözleşme çağrıları veya girdi mesajları gibi özellikler Bitcoin’de aynı biçimde bulunmaz. Bitcoin’in işlem girişleri, çıkışları ve çoklu adres yapısı da Ethereum’daki hesap temelli işlem mantığından farklıdır.
Yazarların aktardığı sektör raporlarına göre 2025 yılının ilk yarısındaki kripto para dolandırıcılığı kayıpları 2,47 milyar ABD dolarını aşmış; karmaşık yasa dışı vakaların yaklaşık yüzde 20’si ondan fazla blokzincire yayılmış ve çapraz zincir suç faaliyetlerinin hacmi 21,8 milyar ABD dolarını geçmiştir. Bu rakamlar çalışmada araştırma motivasyonu olarak kullanılmıştır; UniDetect deneyleri bu ekonomik kayıpları doğrudan ölçmemiştir.
Mevcut yöntemlerde hangi boşluk hedeflenmiştir?
Çalışma mevcut yaklaşımlardaki üç temel sınırlığı hedeflemektedir:
- Zincire özgü özellik mühendisliği: Birçok model, belirli bir blokzincir için uzmanlar tarafından tanımlanan sayısal özelliklere dayanır. Bu özellikler başka bir zincire taşındığında aynı anlamı veya veri karşılığını bulamayabilir.
- İşlem semantiğinin sınırlı temsili: İşlem miktarı, sıklığı ve graf yapısı önemli olsa da bazı blokzincirlerde işlem mesajları, sözleşme günlükleri ve davranış dizileri gibi metinsel veya yarı yapılandırılmış bilgi de bulunmaktadır.
- Dil ve graf modellerinin birbirinden kopuk kullanılması: Önceki çok zincirli modeller işlem dizilerini veya graf yapısını ortaklaştırmaya çalışsa da alan bilgisi, metinsel anlam ve işlem topolojisi çoğu zaman aynı öğrenme süreci içinde birlikte optimize edilmemektedir.
Yazarlar UniDetect’i, büyük dil modellerini özel ince ayar stratejileriyle heterojen blokzincir dolandırıcılığına uygulayan ilk girişim olarak sunmaktadır. Bu “ilk” nitelemesi araştırmacıların kendi iddiasıdır; çalışma bağımsız bir sistematik literatür doğrulaması sunmamaktadır.
Büyük dil modelinin uygulanmasındaki üç zorluk
C1: Heterojen blokzincirleri ortak biçimde anlamak
Modelin Ethereum, Bitcoin ve ileride başka zincirlerde karşılaşabileceği farklı işlem kayıtlarını ortak bir davranış dili içinde açıklaması gerekir. UniDetect bunun için ham işlemleri doğrudan aynı sayısal sütunlara zorlamak yerine, her zincirin işlem verisinden hesap düzeyinde doğal dil özeti üretmektedir.
C2: Halüsinasyon ve aşırı çıkarımı sınırlamak
Büyük dil modeli işlem kaydında bulunmayan bir ilişkiyi, zamanı, kurumu veya suç bağlantısını üretebilir. Dolandırıcılık tespitinde bu durum yalnızca metinsel bir hata değil, normal bir hesabın yanlış biçimde suçla ilişkilendirilmesi anlamına gelebilir. UniDetect bu riski azaltmak için ayırt edici özet ile artık özet üreten iki ayrı analiz ajanı kullanmaktadır.
C3: Metin ile büyük işlem grafiğini verimli biçimde birleştirmek
Milyonlarca düğüm ve yüz milyonlarca kenardan oluşan bir işlem grafiğinin tamamını metne dönüştürüp dil modeline vermek hesaplama açısından uygulanabilir değildir. UniDetect bu nedenle önce merkez hesap çevresinde küçük bir altgraf örneklemekte, ardından yapısal önem sıkıştırması uygulamakta ve yalnızca seçilen düğümlerin metinsel özetlerini grafik sinir ağına aktarmaktadır.
İşlem grafiği nasıl tanımlanmıştır?
İşlem ağı yönlü bir graf olarak tanımlanmıştır:
[ G = (V,E) ]
Burada V hesap veya adres düğümlerini, E ise yönlü işlem kenarlarını göstermektedir. Grafın n düğümü ve m işlem kenarı bulunmaktadır. Kenar özellikleri şu matrisle temsil edilmektedir:
\[ X_E \in \mathbb{R}^{m \times d} \]
Her satır bir işlem kenarına, d ise o kenar için tutulan özellik sayısına karşılık gelir. Özellikler zincire göre işlem miktarı, işlem sayısı, giriş değeri, çıkış değeri veya ücret gibi farklı bilgiler içerebilir.
Dolandırıcılık tespiti ikili düğüm sınıflandırması olarak formüle edilmiştir:
\[ f:(V,E,X_E,Y_L)\longrightarrow Y_U \]
YL etiketli düğümleri, YU etiketi tahmin edilecek düğümleri göstermektedir. Çıktı, hesabın normal veya dolandırıcılık sınıfına ait olma tahminidir.
Altgraf örnekleme nasıl yapılmaktadır?
UniDetect, etiketli bir hesabı merkez düğüm olarak seçmekte ve bu hesabın çevresinde iki atımlı bir komşuluk örneklemektedir. Her atımda ortalama işlem değeri en yüksek olan en fazla K komşuya öncelik verilmektedir:
\[ C_h = \bigcup_{v \in C_{h-1}} \operatorname{topK}\left(\mathcal{N}_v,K,R[v,\mathcal{N}_v]\right) \]
- Ch: h’inci atımda seçilen düğümler kümesidir.
- C0: merkez hesabın kendisidir.
- \mathcal{N}v: v düğümünün bir atımlı komşularıdır.
- K: her atımda tutulacak azami komşu sayısıdır; deneylerde 10 olarak belirlenmiştir.
- R[v,\mathcal{N}v]: merkez ile aday komşu arasındaki ortalama işlem değeridir.
İşlem değerinin birimi kullanılan blokzincire bağlıdır; Ethereum için ETH, Bitcoin için BTC veya veri setinde kullanılan dönüştürülmüş değer olabilir. Makale, farklı zincirlerdeki miktarların bu örnekleme skoru için nasıl ölçeklendirildiğini ayrıntılı biçimde açıklamamaktadır. Eşit ortalama işlem değerleri oluştuğunda toplam işlem değeri daha yüksek olan işlem bilgisinin seçildiği belirtilmiştir.
Yapısal önem graf sıkıştırması nasıl çalışmaktadır?
İki atımlı ve her atımda 10 komşulu örnekleme teorik olarak hızla büyüyebilir. Araştırmacılar bu grafı küçültmek için Structural Importance Graph Compression adlı SIGC algoritmasını geliştirmiştir. Her komşu düğümün yapısal önem skoru şöyledir:
\[ S_u = \frac{\log(a_u^{in}+a_u^{out}+1)+\beta\log(d_u^{in}+d_u^{out}+1)}{L_u+1} \]
- auin ve auout: komşu düğümün gelen ve giden işlem miktarlarıdır.
- duin ve duout: düğümün altgraf içindeki gelen ve giden derece sayılarıdır.
- Lu: merkez düğümden komşu düğüme en kısa yol uzunluğudur ve genişlik öncelikli aramayla hesaplanır.
- \beta: parasal davranış ile yapısal bağlantı arasında denge kuran boyutsuz katsayıdır; deneylerde 2 olarak kullanılmıştır.
İşlem hacmi ve derece yükseldikçe önem skoru artarken merkez hesaptan uzaklık arttıkça skor düşmektedir. Altgraf Nc düğüm sınırını aşarsa en yüksek skorlu düğümler tutulmaktadır. Bağlantının kopmaması için merkez düğüm ile tutulan düğümler arasındaki en kısa yollar üzerindeki ara düğüm ve kenarlar da sıkıştırılmış grafa eklenmektedir. Deneylerde Nc değeri 10’dur.
Adli analiz ajanı hangi bilgileri özetlemektedir?
Graf oluşturulduktan sonra büyük dil modeli tabanlı adli analiz ajanı her hesabın işlem geçmişini üç ila beş cümlelik bir metne dönüştürmektedir. Ek materyaldeki istem şablonu dört boyuta odaklanmaktadır:
| Analiz boyutu | Değerlendirilen bilgi | İstemde verilen örnek eşikler |
|---|---|---|
| Değer akışı | Hesabın net alıcı, net dağıtıcı veya dengeli olup olmadığı | Ethereum örneğinde 1.000 ETH üzeri büyük, 100 ETH altı küçük işlem hacmi |
| Karşı taraf oranı | Gelen ve giden işlem ortaklarının oranı ile toplama veya dağıtma eğilimi | Oranın 2’den büyük olması toplama, 0,5’ten küçük olması dağıtma işareti olarak kullanılıyor |
| İşlem zamanlaması | Etkinliğin süresi, ani yoğunlaşma, gece veya hafta sonu ağırlığı | Sabit bir genel eşik yerine zamansal kümelenme aranıyor |
| Gaz harcaması | Toplam gaz ve giden işlem başına ortalama gaz | 1 milyar gwei üzeri toplam veya 100.000 gwei üzeri ortalama yoğun kullanım; 50.000 gwei altı düşük kullanım |
Bu eşikler modelin isteminde kullanılan yönlendirici kurallardır; çalışma bunların bütün blokzincirler için evrensel dolandırıcılık sınırları olduğunu deneysel olarak kanıtlamamaktadır. Özellikle ETH ve gwei cinsinden örnekler Ethereum’a özgüdür. Bitcoin gibi gaz kavramı bulunmayan zincirlerde aynı istemin nasıl dönüştürüldüğü ayrıntılı olarak gösterilmemiştir.
Ayırt edici özet ve artık özet neden ayrılmıştır?
İlk işlem özeti iki farklı ajana gönderilmektedir:
- Ayırt edici özet ajanı: Dolandırıcılık sınıflandırmasıyla ilişkili işlem örüntülerini, fon akışlarını, ilişkili adresleri ve zamansal işaretleri çıkarmaktadır. Kısa sürede yoğun transfer, çok kaynaktan tek hesapta toplama, ardından çok sayıda hedefe dağıtma, çok atımlı fon hareketi veya yüksek riskli adreslerle etkileşim gibi göstergelere odaklanır.
- Artık özet ajanı: Sınıflandırmayla doğrudan ilişkili olmayan nesnel ifadeleri ve modelin üretebileceği desteklenmeyen yorumları ayırmaktadır. Hesabın dokuz yıldır aktif olması gibi doğru fakat tek başına suç göstergesi olmayan bilgiler ile uydurulmuş kurum bağlantıları bu kanala yönlendirilir.
Ayırt edici ajan her adres için en belirleyici örüntüyü tek cümleyle vermek üzere yönlendirilmiştir. Artık ajan ise yalnızca doğrulanabilir işlem sayısı, zaman aralığı veya hacim gibi çıplak olguları tutmalı; normal, dolandırıcı, riskli veya önemli gibi değerlendirme sözcükleri kullanmamalıdır.
Metinsel özetler graf temsiline nasıl dönüştürülmektedir?
Ayırt edici özet, artık özet ve özgün işlem özeti sabit parametreli Sentence-BERT dil modeliyle vektörlere dönüştürülmektedir. Bu vektörler graf düğümlerinin başlangıç özellikleri olarak kullanılmaktadır. Ardından Dual-PGNN adlı çift yollu grafik sinir ağı, metinsel özellikleri işlem komşuluklarıyla birlikte işlemektedir.
İki yolun amacı komşuluk bilgisini hesaba katarken merkez hesabın kendi metinsel özelliklerinin komşu düğümlerin etkisi altında kaybolmasını önlemektir. Bu sorun, dolandırıcı hesapların normal hesaplarla yoğun etkileşim kurarak komşuluk yapısında kendilerini gizleyebilmesi nedeniyle “komşuluk kamuflajı” olarak ele alınmaktadır.
Üç görünümlü kayıp fonksiyonu nasıl kurulmuştur?
Ayırt edici özet kaybı
Ayırt edici özetin dolandırıcılık sınıfını doğru tahmin etmesi ikili çapraz entropiyle ölçülmektedir:
\[ \mathcal{L}_v^D = -\sum_{v \in V}\left[y_v\log(p_v^D)+(1-y_v)\log(1-p_v^D)\right] \]
- yv: düğümün gerçek ikili etiketidir.
- pvD: ayırt edici özetten elde edilen dolandırıcılık olasılığıdır.
- Kayıp boyutsuzdur ve doğru sınıfa yüksek olasılık verildiğinde küçülür.
Artık özet kaybı
Artık özetin sınıflandırıcıya ayırt edici bilgi taşımaması istenmektedir. Bunun için tahmin dağılımı, sınıflar arasında eşit olasılıklı dağılıma yaklaştırılmaktadır:
\[ \mathcal{L}_v^R = \sum_{v \in V}D_{KL}(p_v^R\parallel U_v) = \sum_{v \in V}\sum_{k\in\{0,1\}}p_v^R(k)\log\frac{p_v^R(k)}{U_v(k)} \]
- pvR: artık özetten üretilen sınıf olasılık dağılımıdır.
- Uv: eşit dağılımdır; iki sınıflı durumda her sınıf için 0,5’tir.
- DKL: Kullback-Leibler ayrışmasıdır.
Bu kayıp küçüldüğünde artık özet normal ve dolandırıcı sınıfları arasında belirgin tercih üretmemektedir. Formül gösteriminde kayıp simgesi düğüm alt indisi taşımasına rağmen toplamın tüm V düğümleri üzerinde yazılması, makaledeki notasyonun düğüm düzeyi ile toplu kayıp düzeyi arasında tam olarak ayrıştırılmadığını göstermektedir.
Ortogonal kayıp
Ayırt edici ve artık temsilin birbirine karışmaması için iki temsilin iç çarpımı küçültülmektedir:
\[ \mathcal{L}_v^O = \left\lVert S_v^D \cdot S_v^R \right\rVert_2^2 \]
SvD ayırt edici, SvR artık düğüm temsilidir. İç çarpımın sıfıra yaklaşması, temsillerin vektör uzayında birbirinden ayrılmasını amaçlamaktadır.
Toplam kayıp
\[ \mathcal{L}_v = \mathcal{L}_v^D+\lambda_1\mathcal{L}_v^R+\lambda_2\mathcal{L}_v^O \]
Deneylerde \lambda1 0,05 ve \lambda2 0,3 olarak belirlenmiştir. Bu katsayılar ayırt edici sınıflandırma hedefi, artık bilginin nötrleştirilmesi ve iki temsilin ayrılması arasındaki dengeyi kontrol etmektedir.
Pekiştirmeli öğrenme büyük dil modelini nasıl yönlendirmektedir?
Birinci eğitim aşamasında graf kodlayıcı dondurulmakta, özet ajanlarının büyük dil modeli LoRA ile ince ayarlanmaktadır. Toplam kayıp önce ödüle çevrilmektedir:
\[ R_v = \exp(-\mathcal{L}_v) \]
Kayıp küçüldükçe ödül 1’e yaklaşır. Ardından üstel hareketli ortalama tabanı çıkarılarak avantaj hesaplanmaktadır:
\[ \hat{A}_v = R_v-b_t \]
bt, eğitim adımındaki hareketli ortalama ödüldür. Bir örneğin ödülü son dönem ortalamasından yüksekse avantaj pozitif olur.
Dizi düzeyindeki REINFORCE kaybı şöyledir:
\[ \mathcal{L}_v^{RL}=-\hat{A}_v\left(\log p_v^{Disc}+\log p_v^{Resi}\right) \]
pvDisc ve pvResi, ayırt edici ve artık özet ajanlarının ürettiği metin dizilerinin olasılıklarıdır. Yüksek avantaj alan özetlerin üretim olasılığı artırılmakta, düşük avantaj alanlarınki azaltılmaktadır.
Şekil 9’daki yakınsama grafiğinde yumuşatılmış ödül ilk yaklaşık 50 adımda sıfıra yakın düzeyden 0,5’e yükselmekte ve kalan eğitim boyunca yaklaşık 0,5-0,6 aralığında kalmaktadır. Ham ödüldeki dalgalanma sürse de yazarlar bunu farklı altgrafların zorluk derecesine bağlamaktadır.
İkinci eğitim aşamasında grafik sinir ağı nasıl eğitilmektedir?
İkinci aşamada büyük dil modeli dondurulmakta, Dual-PGNN eğitilmektedir. Ayırt edici veya artık özet temsili ile özgün özet temsili ayrı yollardan işlenmektedir:
\[ \hat{Z}_v^{D/R}=\operatorname{GNN}(\hat{r}_v^{D/R},A_v)+\theta(\hat{r}_v^{D/R}) \]
\[ \hat{Z}_v^O=\operatorname{GNN}(\chi_v,A_v)+\theta(\chi_v) \]
- Av: merkez hesap altgrafının komşuluk matrisidir.
- \hat{r}vD/R: ince ayarlı ajanların ayırt edici veya artık özet temsilidir.
- \chiv: özgün işlem özetinin temsilidir.
- \theta: merkez düğümün kendi özelliğini doğrudan taşıyan doğrusal katmandır.
Son temsil dikkat ağırlıklarıyla birleştirilmektedir:
\[ \hat{S}_v^{D/R}=W_1\hat{Z}_v^{D/R}+W_2\hat{Z}_v^O \]
W1 ve W2 öğrenilebilir dikkat ağırlıklarıdır. Böylece model, ayırt edici özet ile özgün işlem özetinin göreli önemini her temsil için ayarlayabilmektedir.
Şekil 1 ve Şekil 2 ne anlatmaktadır?
Şekil 1, geleneksel zincire özgü modeller ile UniDetect arasındaki temel farkı görselleştirmektedir. Geleneksel tarafta Bitcoin ve Ethereum için ayrı kurallar, ayrı özellik mühendisliği ve ayrı GNN süreçleri bulunmaktadır. UniDetect tarafında ise farklı zincirlerin işlemleri önce ortak bir işlem özeti diline çevrilmekte, ardından çok zincirli graf ve metin temsili tek sınıflandırıcıya aktarılmaktadır.
Şekil 2, eğitim ve çıkarım akışını ayrıntılı göstermektedir. Eğitim bölümünde altgraf oluşturma, işlem özeti üretme, ayırt edici ve artık özetleri ayırma, pekiştirmeli öğrenmeyle özet ajanlarını ayarlama ve Dual-PGNN’i eğitme adımları yer almaktadır. Çıkarım aşamasında artık özet kolu nihai tahminde kullanılmamakta; adli analiz özeti ile ayırt edici özet, graf kodlayıcı üzerinden dolandırıcılık olasılığına dönüştürülmektedir.
Hangi veri setleri kullanılmıştır?
Çalışmada üç blokzincir veri seti ve zincir dışı genelleme deneyi için bir Instagram grafı kullanılmıştır:
| Veri seti | Toplam düğüm | Kenar | Dolandırıcılık veya pozitif etiket | Normal veya negatif etiket | Dolandırıcılık/pozitif oranı |
|---|---|---|---|---|---|
| Ethereum | 187.960 | 397.038 | 1.991 | 1.439 | %1,06 |
| Bitcoin-M | 2.505.841 | 14.181.316 | 46.930 | 213.026 | %1,87 |
| Bitcoin-L | 20.085.231 | 203.419.765 | 362.391 | 1.271.556 | %1,80 |
| 11.339 | 198.448 | 4.115 işletme hesabı | 7.224 normal kullanıcı hesabı | %36,29 |
Ethereum dolandırıcılık etiketleri Etherscan Label Cloud, XLabelCloud ve CryptoScamDB’den alınmıştır. Etiketler kimlik avı, Upbit güvenlik açığı saldırıları, kumar ve honeypot hesaplarını kapsamaktadır. Madenciler ve finansal hizmet sağlayıcıları gibi bilinen özel kimlikli hesaplar normal sınıfa eklenmiştir.
Ethereum işlemleri 7 Ağustos 2015 ile 10 Nisan 2025 arasından Etherscan API ile toplanmıştır. Sıfır miktarlı ve başarısız işlemler çıkarılmıştır. Aynı iki hesap arasındaki birden fazla transfer tek bir yönlü kenarda birleştirilmiş; toplam transfer miktarı ile toplam işlem sıklığı kenar özelliği olarak tutulmuştur.
Bitcoin-M, Haziran 2015’ten önceki ilk 1,5 milyon işlemi kapsamaktadır. Kenarlarda giriş değeri, giriş miktarı, çıkış değeri ve çıkış miktarı bulunmaktadır. Bitcoin-L, Haziran-Eylül 2015 arasındaki işlemleri kapsamakta ve aynı özelliklere ek olarak işlem ücretini içermektedir. Kumar ve karıştırıcı hizmetlerle ilişkili adresler dolandırıcılık sınıfına alınmış, kalan hesaplar normal kabul edilmiştir.
Bu etiketleme biçimi önemli bir yorum sınırı doğurmaktadır. Kumar veya karıştırıcı hizmetleriyle ilişki, tek başına her hesabın hukuken dolandırıcılık yaptığı anlamına gelmeyebilir. Benzer şekilde “geri kalan bütün hesapları normal kabul etme” yaklaşımı, henüz etiketlenmemiş yasa dışı hesapları normal sınıfa dahil edebilir.
Instagram deneyinde düğümler kullanıcıları, kenarlar takip ilişkilerini, profil açıklamaları başlangıç metinsel özelliklerini temsil etmektedir. Görev dolandırıcılık tespiti değil, işletme hesabı ile normal kullanıcı hesabını ayırmaktır. Bu deney modelin farklı bir graf sınıflandırma görevine aktarılabildiğini göstermektedir; finans dışındaki dolandırıcılığı tespit ettiğini göstermemektedir.
Veriler nasıl bölünmüş ve hangi modellerle karşılaştırılmıştır?
Tüm veri setleri yüzde 80 eğitim, yüzde 10 doğrulama ve yüzde 10 test olarak ayrılmıştır. Makale, ortalama sonuçlar ile standart sapmaların birden fazla çalıştırmadan hesaplandığını belirtmekte; ancak ana metin ve ek materyalde tekrar sayısını açıkça vermemektedir.
UniDetect toplam 20 temel yöntemle karşılaştırılmıştır:
- Genel graf temsil yöntemleri: DeepWalk, Node2Vec, GCN, GAT, GIN, GraphSAGE ve APPNP.
- Graf anomali yöntemleri: CARE-GNN, BWGNN, GRIT, DGA-GNN, PMP ve FLAG.
- Tek zincirli yöntemler: Trans2Vec, TSGN, Ethident ve TEGDetector.
- Çok zincirli yöntemler: SIGTRAN, BERT4ETH ve DIAM.
UniDetect’in temel büyük dil modeli Gemma-3-4B-it, metin gömme modeli Sentence-BERT, graf omurgası CARE-GNN’dir. Dual-PGNN iki katman ve 64 gizli boyutla kurulmuştur. AdamW eniyileyicisi, 5 × 10⁻⁶ öğrenme oranı ve erken durdurma kullanılmıştır. Eğitim iki dış dönem ve 10 iç dönemden oluşmaktadır.
Değerlendirme ölçütleri ne anlama gelmektedir?
- Kesinlik: Dolandırıcı olarak işaretlenen hesapların ne kadarının gerçekten dolandırıcılık etiketli olduğunu ölçer.
- Geri çağırma: Etiketli dolandırıcılık hesaplarının ne kadarının model tarafından yakalandığını ölçer.
- F1: Kesinlik ve geri çağırmanın harmonik ortalamasıdır.
- AUC: Modelin farklı eşiklerde iki sınıfı sıralama kabiliyetini ölçer.
- Kolmogorov-Smirnov: Normal ve dolandırıcılık hesaplarının tahmin skoru dağılımları arasındaki en büyük ayrımı ölçer.
KS ölçütü çalışmada şu şekilde tanımlanmıştır:
\[ KS=\max_x\left|F_1(x)-F_2(x)\right| \]
Buradaki F1(x) ve F2(x), iki sınıfın birikimli dağılım fonksiyonlarıdır; bu semboller F1 sınıflandırma puanıyla karıştırılmamalıdır. Bütün ölçütlerde yüksek değer daha iyi sonuç anlamına gelmektedir.
Ana deney sonuçları nelerdir?
| Veri seti | Kesinlik | Geri çağırma | F1 | AUC | KS |
|---|---|---|---|---|---|
| Ethereum | %91,39 ± 0,60 | %93,95 ± 0,56 | %92,65 ± 0,34 | %94,82 ± 0,24 | %68,94 ± 0,12 |
| Bitcoin-M | %90,61 ± 0,48 | %95,47 ± 0,99 | %92,98 ± 0,64 | %93,83 ± 0,32 | %70,45 ± 1,16 |
| Bitcoin-L | %90,61 ± 0,50 | %96,43 ± 1,16 | %93,41 ± 0,49 | %95,22 ± 0,71 | %72,25 ± 0,66 |
Ethereum’da en güçlü karşılaştırma yöntemine göre UniDetect’in artışları kesinlikte 8,71, geri çağırmada 5,40, F1’de 8,56, AUC’de 12,15 ve KS’de 7,58 yüzde puandır. İnce ayar yapılmadan kullanılan UniDetect sürümünün Ethereum F1 değeri yüzde 85,38 iken tam modelde yüzde 92,65’e çıkmıştır. Bu fark, büyük dil modelinin görev geri bildirimiyle ince ayarlanmasının sonuçlara önemli katkı verdiğini göstermektedir.
Bitcoin-M’de en güçlü karşılaştırmaya göre F1 artışı 5,41, AUC artışı 6,47 ve KS artışı 5,57 yüzde puandır. Bitcoin-L’de F1 artışı 3,61, AUC artışı 5,17 ve KS artışı 6,49 yüzde puandır.
Tablolarda ortalama ve standart sapmalar verilmiş olsa da yöntemler arasındaki farklar için hipotez testi, güven aralığı veya p değeri sunulmamaktadır. Bu nedenle “istatistiksel olarak anlamlı üstünlük” yerine, raporlanan ölçüt ortalamalarında üstünlük ifadesi daha doğrudur.
Çapraz zincir sıfır örnekli deney ne göstermektedir?
Ethereum üzerinde eğitilen model doğrudan Bitcoin’e uygulanmıştır. Şekil 5a’da sınıflandırma eşiği 0,45 ile 0,70 arasında değiştirildiğinde geri çağırma yüzde 94,58 ile yüzde 100 arasında kalmıştır. Buna karşılık kesinlik yaklaşık yüzde 60,07 ile yüzde 63,25; F1 ise yaklaşık yüzde 73,46 ile yüzde 77,50 aralığındadır.
Bu sonuç iki farklı yönü birlikte göstermektedir:
- Model, zincir değiştiğinde dolandırıcılık etiketli hesapların büyük bölümünü yakalayabilmektedir.
- Normal hesapları güvenilir biçimde ayırma başarısı belirgin ölçüde düşmektedir ve yanlış pozitif oranı yükselebilmektedir.
Dolayısıyla çalışmadaki “yüzde 94,58’den fazla dolandırıcılık hesabını belirleme” ifadesi, yüksek geri çağırmayı anlatmaktadır. Bu sonuç tek başına yüksek kesinlik, düşük yanlış alarm oranı veya üretim ortamında güvenli otomatik karar anlamına gelmez.
Zincir dışı aktarım deneyi ne göstermektedir?
Instagram işletme hesabı sınıflandırmasında UniDetect, karşılaştırılan yöntemlerden F1’de 6,06 ve AUC’de 4,47 yüzde puan daha yüksek sonuç bildirmiştir. Bu deney metin ve graf füzyonunun yalnızca blokzincir işlem grafına bağlı olmadığını göstermektedir. Ancak görev dolandırıcılık tespiti olmadığı için sonuç, modelin başka sektörlerde finansal suç veya sahtekârlık yakaladığının kanıtı değildir.
Bileşen çıkarma deneyleri ne anlatmaktadır?
| Model sürümü | F1 | AUC | Graf oluşturma süresi | Yorum |
|---|---|---|---|---|
| SIGC sıkıştırması olmadan | %93,62 | %94,14 | 40,37 saniye/hesap | F1 tam modelden biraz yüksek, AUC biraz düşük; süre yaklaşık 32 kat artıyor |
| İki aşamalı eğitim olmadan | %85,65 | %82,52 | Bildirilmemiş | Özet kalitesinin ortak eğitimle geliştirilmesi önemli |
| Artık özet ajanı olmadan | %78,37 | %79,81 | Bildirilmemiş | En büyük performans düşüşü görülüyor |
| Pekiştirmeli öğrenme olmadan | %87,50 | %86,63 | Bildirilmemiş | Görev geri bildiriminin özet üretimine katkısını gösteriyor |
| Dual-PGNN olmadan | %88,50 | %89,63 | Bildirilmemiş | Merkez düğümün kendi özelliklerini koruyan çift yol önemli |
| Tam UniDetect | %92,65 | %94,82 | 1,26 saniye/hesap | Performans ve hesaplama maliyeti arasında seçilen denge |
Artık özet ajanının çıkarılması F1’i 14,28 ve AUC’yi 15,01 yüzde puan düşürmektedir. Bu, halüsinasyon veya görev dışı içeriği ayrı bir temsil olarak modellemenin merkezi rolünü desteklemektedir.
SIGC sıkıştırmasının kaldırılması ise farklı bir sonuç vermektedir: F1 yüzde 92,65’ten yüzde 93,62’ye yükselirken AUC yüzde 94,82’den yüzde 94,14’e düşmekte ve graf oluşturma süresi 1,26 saniyeden 40,37 saniyeye çıkmaktadır. Bu nedenle sıkıştırmanın her ölçütü artırdığı söylenemez; asıl katkısı çok büyük hız kazanımını küçük bir performans değişimiyle sağlamasıdır.
Hiperparametre grafikleri ne göstermektedir?
Şekil 6, altgraf düğüm sınırı Nc, yapısal ağırlık \beta ve kayıp katsayıları \lambda1 ile \lambda2 için duyarlılık analizini göstermektedir.
- Nc çok küçük olduğunda komşuluk bilgisi yetersiz kalmaktadır. Çok büyük olduğunda normal komşular dolandırıcı merkez düğümün örüntüsünü seyreltebilmektedir.
- \beta çok küçük olduğunda işlem miktarı gürültüsü baskın hâle gelmektedir. Çok büyük olduğunda borsa veya ICO cüzdanı gibi yüksek bağlantılı düğümler gereğinden fazla önemli kabul edilebilmektedir.
- \lambda1 ve \lambda2 arttıkça F1 ve KS önce yükselmekte, daha sonra düşmektedir. Geniş bir orta aralıkta performansın görece kararlı kaldığı görülmektedir.
Grafikler seçilen Nc=10, \beta=2, \lambda1=0,05 ve \lambda2=0,3 ayarlarının tek mümkün değer olmadığını, ancak dengeli bölgelerde bulunduğunu desteklemektedir.
Hesaplama maliyeti nedir?
| Bileşen | Bildirilen maliyet |
|---|---|
| Altgraf örnekleme ve sıkıştırma | 1,26 saniye/hesap |
| Aşama 1: LLM pekiştirmeli ince ayarı | 12,42 saat |
| Aşama 2: GNN eğitimi | 0,38 saat |
| Çevrim içi çıkarım gecikmesi | 1,47 milisaniye/örnek |
| Çıkarım verimi | 680 örnek/saniye |
| Gemma-3-4B-it ve LoRA toplam parametresi | 4.303,30 milyon |
| Eğitilebilir LLM parametresi | 3,22 milyon; toplamın yaklaşık %0,07’si |
| Dual-PGNN parametresi | 0,04 milyon |
Eğitim Intel Xeon Gold 6248R işlemci, 128 GB RAM ve iki NVIDIA A6000 GPU bulunan bir sistemde gerçekleştirilmiştir. Çıkarım gecikmesi düşük olsa da 12,42 saatlik LLM eğitimi, yüksek kapasiteli GPU ihtiyacı ve hesap başına 1,26 saniyelik ön işleme maliyeti, sistemin toplam operasyonel yükünün yalnızca 1,47 milisaniyelik sınıflandırma süresiyle değerlendirilmemesi gerektiğini göstermektedir.
Gerçek hesap örneği halüsinasyon sorununu nasıl göstermektedir?
Örnek olayda bir Ethereum hesabının yaklaşık dokuz yılda 81 benzersiz adresle 3.742 işlem yaptığı ve toplam 5.454,23 ETH giriş aldığı belirtilmiştir. İlk adli analiz özeti, net çıkışın baskın olduğunu ve çok taraflı, çok atımlı transfer örüntüsü bulunduğunu yazmıştır.
Aynı özet ayrıca işlemlerin çoğunlukla Avrupa çalışma saatlerinde yapıldığını ve hesabın Europol’ün 2022 raporunda işaretlendiğini ileri sürmüştür. Bu iki bilgi modelin girdisindeki işlem verilerinden doğrulanabilir değildir. Artık özet ajanı bu ifadeleri ayırt edici kanıttan ayırmış; ayırt edici özet ise para toplama, yoğun net çıkış ve çok atımlı dağıtım gibi işlem grafından desteklenen örüntüleri korumuştur.
Bu örnek, UniDetect’in halüsinasyonu tamamen önlediğini kanıtlamamaktadır. İlk ajan halüsinasyon üretmeye devam etmekte, sonraki ajan bunu filtrelemeye çalışmaktadır. Gerçek uygulamada filtreleme ajanının da hata yapabileceği ve desteklenmeyen bir suç bağlantısını ayırt edici özette bırakabileceği göz önünde bulundurulmalıdır.
Farklı büyük dil modelleri nasıl karşılaştırılmıştır?
Ek materyalde Gemma-3-4B-it, Qwen2.5-3B-it, Qwen2.5-7B-it ve Llama-3.1-8B-it karşılaştırılmıştır. Gemma-3-4B-it beş ölçüt genelinde en dengeli sonuçları vermiştir. Llama-3.1-8B-it biraz daha yüksek kesinlik sağlarken yaklaşık iki kat parametre ve eğitim yükü gerektirmiştir. Qwen2.5-7B-it benzer F1 ve AUC üretmiş ancak KS değeri daha düşük kalmıştır. Qwen2.5-3B-it özellikle KS bakımından en zayıf sonuçları vermiştir.
Şekil 10’un görsel içeriği bu model karşılaştırmasını göstermesine rağmen şekil altyazısında yanlışlıkla “adli analiz ajanının CoT istem şablonu” ifadesi yazılmıştır. Bu, PDF’deki görsel-altyazı tutarsızlığıdır; grafik gerçekte LLM omurgası karşılaştırmasını göstermektedir.
Çalışmanın güçlü yönleri nelerdir?
- Ethereum ve Bitcoin gibi veri modelleri farklı iki blokzincirde aynı mimari değerlendirilmiştir.
- Üç blokzincir veri seti, 20 karşılaştırma yöntemi ve dört değerlendirme ölçütüne ek olarak KS kullanılmıştır.
- Bileşen çıkarma, hiperparametre duyarlılığı, hesaplama maliyeti, yakınsama ve örnek olay analizleri sunulmuştur.
- Dil modelinin hesap adreslerini önceden bilerek etiket sızdırmasını önlemek için hesap kimlikleri ve gerçek etiketler istemlerden çıkarılmıştır.
- Ayırt edici ve artık özetlerin ayrılması, yalnızca daha iyi metin üretmek yerine halüsinasyonun sınıflandırma üzerindeki etkisini doğrudan eğitim hedefi hâline getirmektedir.
- LoRA sayesinde 4,3 milyarlık modelin yalnızca 3,22 milyon parametresi eğitilmektedir.
- Çapraz zincir deneyinde eşik değişimleri gösterilerek yüksek geri çağırmanın kesinlik maliyeti görünür kılınmıştır.
Çalışmanın sınırlılıkları nelerdir?
- Hakemlik: Çalışma bir arXiv preprintidir ve bağımsız hakem değerlendirmesinden geçtiği doğrulanmamıştır.
- Kod erişimi: PDF kaynak kod ve veri setinin erişilebilir olduğunu söylese de bağlantılı GitHub deposunda kodun daha sonra yayımlanacağı belirtilmektedir.
- Zincir kapsamı: “Evrensel” nitelemesine rağmen gerçek blokzincir deneyleri Ethereum ile iki Bitcoin veri setiyle sınırlıdır.
- Eski Bitcoin dönemi: Bitcoin-M ve Bitcoin-L verileri 2015 dönemine aittir; güncel karıştırma, köprü, merkeziyetsiz finans ve katman-2 davranışlarını temsil etmeyebilir.
- Etiket gürültüsü: Kamuya açık etiket bulutları eksik veya hatalı olabilir. Kumar ve karıştırıcı adreslerinin tamamını dolandırıcı kabul etmek kavramsal olarak geniş bir eşlemedir.
- Normal sınıfın temsili: Ethereum’daki normal etiketler madenci ve finansal hizmet sağlayıcı gibi özel hesaplardan seçilmiştir; sıradan kullanıcıların bütün davranış çeşitliliğini temsil etmeyebilir.
- Yanlış pozitifler: Çapraz zincir deneyinde kesinliğin yaklaşık yüzde 60-63 olması, normal hesapların önemli bölümünün yanlış alarm üretme ihtimalini göstermektedir.
- İstemlerin zincire özgü unsurları: ETH, gwei ve gaz harcaması eşikleri evrensel blokzincir kuralları değildir. Bunların Bitcoin veya başka zincirlere uyarlanma yöntemi ayrıntılı verilmemiştir.
- İstatistiksel sınır: Ortalama ve standart sapma bildirilmiş, ancak tekrar sayısı ve yöntemler arası anlamlılık testleri açıkça sunulmamıştır.
- Instagram yorumu: İşletme hesabı sınıflandırması, finansal suç veya dolandırıcılık genellemesi değildir.
- Gerçek saha doğrulaması: Modelin bir borsa, düzenleyici kurum, kolluk sistemi veya kara para aklamayı önleme altyapısında canlı olarak sınandığı gösterilmemiştir.
- Uzun dönem değişim: Suç örüntülerinin zaman içinde değişmesi, yeni zincirlere geçiş, saldırgan uyarlaması ve kavram kayması ayrıntılı olarak test edilmemiştir.
- Hesaplama altyapısı: Eğitim iki A6000 GPU ile yapılmıştır; daha sınırlı donanımlardaki maliyet gösterilmemiştir.
Çalışma neyi desteklemektedir?
- LLM tarafından üretilen işlem özetlerinin graf düğüm özelliği olarak kullanılması, incelenen veri setlerinde geleneksel graf yöntemlerinden daha yüksek raporlanan performans üretmiştir.
- Ayırt edici ve artık özetleri ayıran eğitim, Ethereum bileşen çıkarma deneyinde önemli katkı sağlamıştır.
- Altgraf sıkıştırması, hesap başına graf oluşturma süresini 40,37 saniyeden 1,26 saniyeye indirirken AUC’yi hafifçe artırmış, F1’i ise hafifçe düşürmüştür.
- Ethereum’da eğitilen model Bitcoin’de dolandırıcılık etiketli hesapların büyük bölümünü yakalayabilmiştir.
- Metin-graf füzyonu, Instagram’daki işletme hesabı sınıflandırmasına da aktarılabilmiştir.
Çalışma neyi kanıtlamamaktadır?
- UniDetect’in bütün blokzincirlerde aynı doğrulukla çalışacağını kanıtlamamaktadır.
- Bir hesabın hukuken suçlu veya dolandırıcı olduğunu kesin olarak belirlememektedir.
- Yüksek geri çağırmanın düşük yanlış alarm oranıyla birlikte elde edildiğini göstermemektedir.
- LLM halüsinasyonlarının tamamen ortadan kaldırıldığını göstermemektedir.
- Gerçek zamanlı bir düzenleyici sistemde insan denetimi olmadan güvenli otomatik yaptırım uygulanabileceğini göstermemektedir.
- Instagram deneyine dayanarak başka sektörlerde dolandırıcılık tespiti başarısını kanıtlamamaktadır.
- Modelin saldırgan manipülasyonuna, işlem bölme stratejilerine, köprü kullanımına veya bilinçli graf kamuflajına karşı dayanıklı olduğunu göstermemektedir.
- Kaynak kod ve veri seti erişime açılmadan sonuçların bağımsız olarak yeniden üretilebildiğini göstermemektedir.
Günlük yaşam ve uygulama açısından ne ifade etmektedir?
UniDetect benzeri bir sistem, bir blokzincir inceleme uzmanının binlerce işlemi tek tek okumak yerine hesap davranışını özetleyen metinsel ipuçları ve graf ilişkileri üzerinden önceliklendirme yapmasını sağlayabilir. Potansiyel kullanım alanları borsa uyum ekipleri, kara para aklamayı önleme süreçleri, zincir analiz hizmetleri ve soruşturma destek sistemleridir.
Ancak düşük çapraz zincir kesinliği nedeniyle modelin ürettiği işaretler kesin suç tespiti değil, inceleme önceliği olarak değerlendirilmelidir. Bir hesabın dondurulması, kullanıcıya yaptırım uygulanması veya hukuki sonuç doğuracak karar verilmesi için model çıktısının işlem kanıtları, karşı taraf analizi ve insan uzman değerlendirmesiyle doğrulanması gerekir.
Çalışmanın Yöntemi ve Bulguları
Teknik yöntem özeti
| Teknik unsur | Uygulanan yöntem |
|---|---|
| Görev | Normal ve dolandırıcılık hesapları için ikili düğüm sınıflandırması |
| Blokzincirler | Ethereum, Bitcoin-M ve Bitcoin-L |
| Zincir dışı deney | Instagram işletme hesabı ile normal hesap sınıflandırması |
| Veri bölme | %80 eğitim, %10 doğrulama, %10 test |
| Komşuluk örnekleme | İki atım; her atımda ortalama işlem değerine göre en fazla 10 komşu |
| Graf sıkıştırma | SIGC; yapısal önem katsayısı β=2, son düğüm sınırı Nc=10 |
| Adli analiz ajanı | Değer akışı, karşı taraf oranı, zamanlama ve gaz harcamasından 3-5 cümlelik işlem özeti |
| Ayırt edici ajan | İşlem örüntüsü, fon akışı, ilişkili adres ve zamansal risk işaretlerini çıkarma |
| Artık ajan | Görev dışı olgular, halüsinasyonlar ve desteklenmeyen yorumları ayırma |
| LLM omurgası | Gemma-3-4B-it ve LoRA ince ayarı |
| Metin kodlayıcı | Sentence-BERT |
| Graf kodlayıcı | İki katmanlı, 64 gizli boyutlu Dual-PGNN; CARE-GNN omurgası |
| Kayıp | İkili çapraz entropi, KL ayrışması ve ortogonal düzenleyici |
| Kayıp ağırlıkları | λ1=0,05 ve λ2=0,3 |
| Eniyileyici | AdamW, 5 × 10⁻⁶ sabit öğrenme oranı, erken durdurma |
| Eğitim döngüsü | 2 dış dönem, 10 iç dönem |
| Donanım | Intel Xeon Gold 6248R, 128 GB RAM, 2 NVIDIA A6000 GPU |
| Karşılaştırmalar | 20 graf, anomali, tek zincir ve çok zincir yöntemi |
| Ölçütler | Kesinlik, geri çağırma, F1, AUC ve KS |
Temel bulgular
- Ethereum’da UniDetect yüzde 92,65 F1, yüzde 94,82 AUC ve yüzde 68,94 KS değerine ulaşmıştır.
- Bitcoin-M’de yüzde 92,98 F1, Bitcoin-L’de yüzde 93,41 F1 elde edilmiştir.
- Ethereum’da en güçlü karşılaştırmaya göre F1 artışı 8,56 ve KS artışı 7,58 yüzde puandır.
- Çapraz zincir sıfır örnekli deneyde dolandırıcılık geri çağırması bütün incelenen eşiklerde yüzde 94,58’in üzerinde kalmıştır.
- Aynı çapraz zincir deneyinde kesinlik yaklaşık yüzde 60-63 düzeyindedir; sonuç yüksek yanlış pozitif riskine işaret etmektedir.
- Instagram aktarım deneyinde F1’de 6,06 ve AUC’de 4,47 yüzde puan artış bildirilmiştir.
- Artık özet ajanının kaldırılması Ethereum F1 değerini yüzde 92,65’ten yüzde 78,37’ye düşürmüştür.
- SIGC sıkıştırması graf oluşturma süresini hesap başına 40,37 saniyeden 1,26 saniyeye indirmiştir.
- Çevrim içi sınıflandırma gecikmesi örnek başına 1,47 milisaniye ve verim 680 örnek/saniyedir.
- LoRA ile yalnızca 3,22 milyon LLM parametresi eğitilmiştir; bu toplam parametrelerin yaklaşık yüzde 0,07’sidir.
Sonuçların teknik yorumu
Deneyler UniDetect’in incelenen test bölmelerinde güçlü bir sınıflandırıcı olduğunu göstermektedir. En büyük katkı, dil modelinin tek başına kullanılması değil; özet kalitesinin graf sınıflandırma kaybından gelen geri bildirimle eğitilmesi, görev dışı metnin ayrı tutulması ve merkez hesabın kendi özelliğinin graf toplama sırasında korunmasıdır.
En önemli operasyonel sınır çapraz zincir kesinliğidir. Model Ethereum’dan Bitcoin’e geçtiğinde dolandırıcılık hesaplarını kaçırmama konusunda güçlü, normal hesapları yanlış işaretlememe konusunda zayıf kalmaktadır. Bu nedenle UniDetect’in çalışmada gösterilen en gerçekçi rolü, otomatik nihai hüküm vermek yerine yüksek riskli hesapları insan incelemesine yönlendiren bir tarama katmanıdır.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: UniDetect: LLM-Driven Universal Fraud Detection across Heterogeneous Blockchains
Yazarlar ve sıraları: Shuyi Miao; Wangjie Qiu; Shengda Zhuo; Fei Shen; Dan Lin; Xingtong Yu; Tat-Seng Chua; Zhiming Zheng.
Eş birinci yazar: PDF’de eş katkı veya eş birinci yazar bildirimi bulunmamaktadır.
Sorumlu yazar: PDF’de Wangjie Qiu ve Fei Shen adlarının yanında yıldız işareti bulunmaktadır. Bununla birlikte dipnotta “Corresponding authors” ifadesinin ardından Shuyi Miao’ya ait shuyimiao@buaa.edu.cn adresi verilmiştir. Yıldız işaretleri ile iletişim adresi arasında tutarsızlık bulunmaktadır.
Kurumlar:
- Shuyi Miao, Wangjie Qiu ve Zhiming Zheng: Beihang University, Pekin, Çin.
- Shengda Zhuo: Jinan University, Guangzhou, Çin.
- Fei Shen ve Tat-Seng Chua: National University of Singapore, Singapur.
- Dan Lin: Sun Yat-Sen University, Guangzhou, Çin.
- Xingtong Yu: The Chinese University of Hong Kong, Hong Kong.
DOI: 10.48550/arXiv.2604.12329. Bu, arXiv tarafından verilen DataCite DOI’sidir; hakemli dergi DOI’si değildir.
Kaynak türü: Bilgisayar bilimi alanında yöntem, modelleme ve deneysel veri analizi içeren preprint araştırma makalesi.
Yayın yılı: 2026.
Yayın platformu: arXiv.
arXiv kategorileri: Cryptography and Security (cs.CR) ve Social and Information Networks (cs.SI).
Hakemlik durumu: Bu çalışma bir preprinttir ve hakem değerlendirmesinden geçtiği doğrulanmamıştır.
Dergi veya konferans: Doğrulanmış bir dergi veya konferans bilgisi bulunmamaktadır. PDF’deki “Conference’17, July 2017, Washington, DC, USA” metni doldurulmamış yayın şablonu ifadesidir.
Özgün yayınevi: Hakemli bir dergi veya konferans yayınevi doğrulanamamıştır. arXiv yayın platformudur.
Resmî kaynak:https://arxiv.org/abs/2604.12329
Proje deposu:https://github.com/msy0513/UniDetect
PDF veri seti ve kaynak kodun erişilebilir olduğunu belirtmektedir. Ancak resmî GitHub deposunun mevcut README metninde kaynak kodun makalenin yayımlanması üzerine paylaşılacağı yazmaktadır. Bu nedenle çalışmanın kodu ve deney verileri üzerinden bağımsız olarak yeniden üretilebilirliği şu aşamada doğrulanamamaktadır.
Bu Verianla makalesi yüklenen PDF’nin ana metni, matematiksel yöntemi, tabloları, grafik ve şemaları, ek materyali, deney sonuçları ve sınırlılıkları incelenerek hazırlanmıştır. PDF dışından yeni bir bilimsel bulgu eklenmemiştir. Dış kaynaklar yalnızca arXiv kimliği, DOI, yayın durumu, resmî bağlantı ve proje deposunun mevcut durumu için kullanılmıştır.
Çalışmanın başlıca sınırlılıkları; hakem değerlendirmesinin bulunmaması, yalnızca Ethereum ve Bitcoin üzerinde blokzincir deneyi yapılması, Bitcoin verilerinin 2015 döneminden gelmesi, etiket kaynaklarındaki olası gürültü, zincire özgü istem eşikleri, çapraz zincir kesinliğinin düşük kalması, saha uygulaması bulunmaması ve kaynak kodun henüz doğrulanabilir biçimde yayımlanmamış olmasıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir