

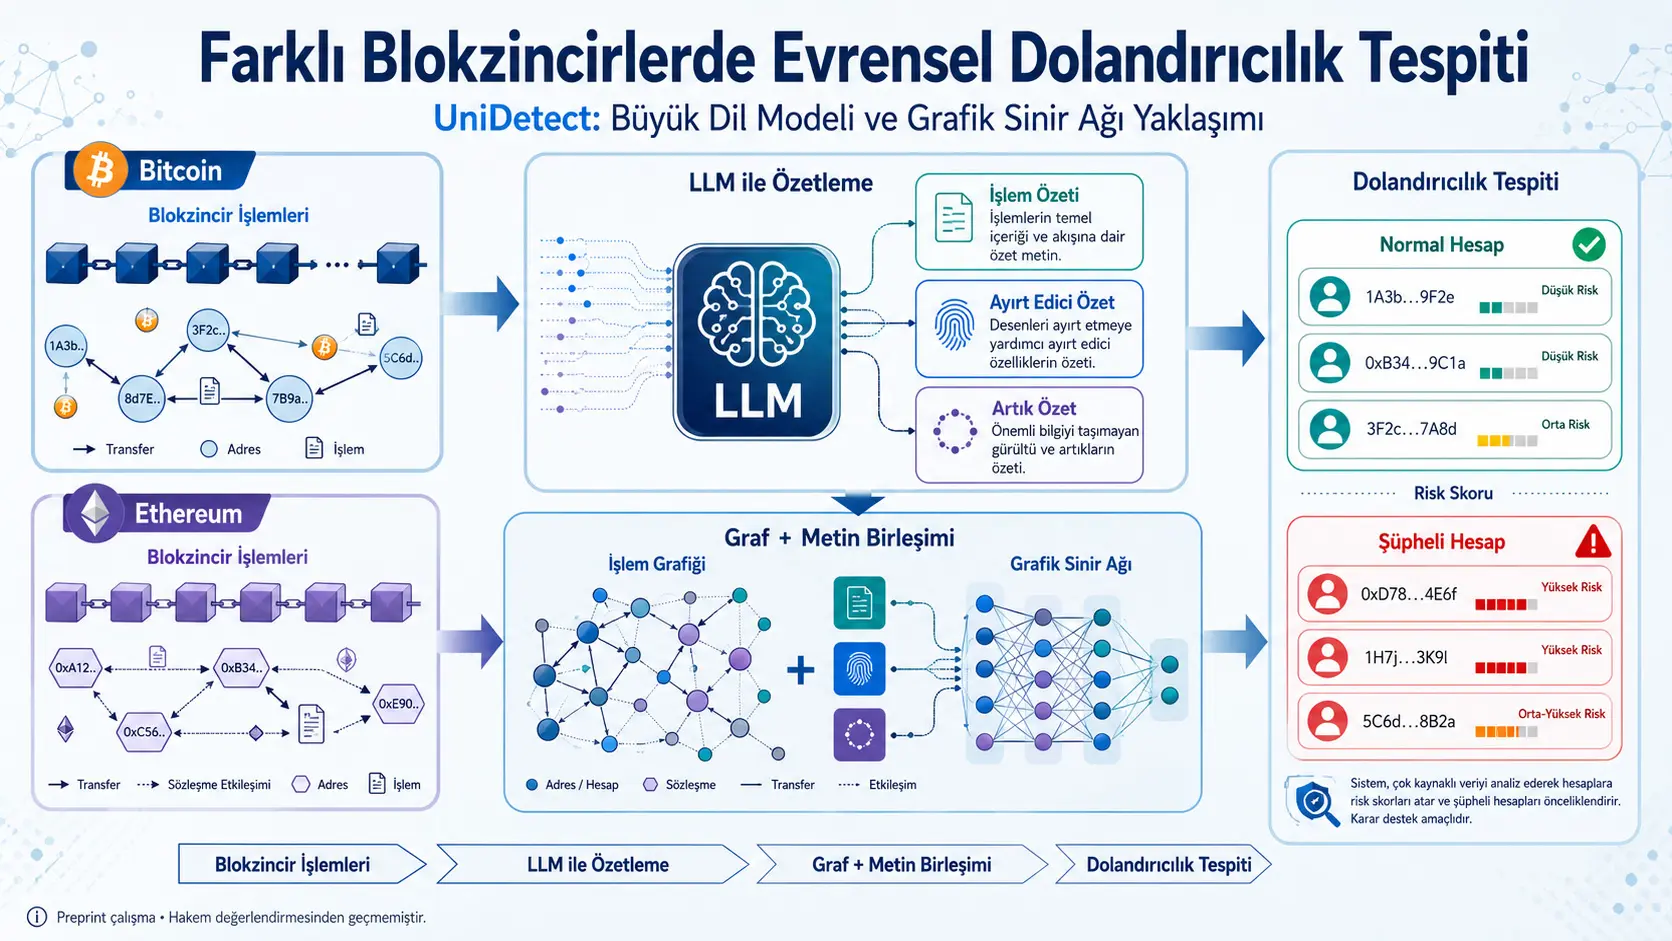
Utafiti huu unachunguza ikiwa akaunti za ulaghai kwenye minyororo ya bloku yenye miundo tofauti ya data, kama Ethereum na Bitcoin, zinaweza kutambuliwa kwa kutumia modeli moja ya pamoja. Watafiti walitengeneza mbinu iitwayo UniDetect, ambayo hubadilisha historia ya miamala ya akaunti kuwa muhtasari wa maandishi kwa kutumia modeli kubwa ya lugha, hutenganisha taarifa bainifu katika muhtasari huo na maudhui yanayoweza kuwa ya kubuniwa au yasiyohusiana na kazi, na huunganisha uwakilishi wa maandishi uliopatikana na grafu ya miamala. Katika majaribio ya Ethereum, UniDetect iliripoti F1 ya asilimia 92,65, AUC ya asilimia 94,82 na thamani ya Kolmogorov-Smirnov ya asilimia 68,94; katika seti za data za Bitcoin-M na Bitcoin-L iliripoti F1 ya asilimia 92,98 na asilimia 93,41 mtawalia. Hata hivyo, utafiti huu ni preprint; katika matumizi ya cross-chain zero-shot, recall kwa akaunti za ulaghai ilibaki juu ya asilimia 94,58 huku precision ikiwa takribani asilimia 60-63, hali inayoonyesha kuwa idadi kubwa ya akaunti za kawaida inaweza kuwekewa alama kimakosa kama tahadhari.
Wazo kuu la UniDetect ni kutotathmini miamala ya blockchain kwa kutegemea tu vipengele vya nambari kama kiasi, marudio au degree ya node. Modeli huunganisha namna mtiririko wa fedha unavyokusanywa au kusambazwa, muda wa miamala, utofauti wa counterparties na mifumo ya ujirani katika grafu ya miamala ndani ya uwakilishi mmoja wa pamoja. Wakati modeli kubwa ya lugha hutengeneza ushahidi wa maandishi unaoeleza historia ya miamala ya akaunti, graph neural network hutathmini nafasi ya kimuundo ya akaunti na mahusiano yake ndani ya mtandao wa miamala.
Matokeo yanayovutia zaidi katika utafiti huu ni kwamba modeli hiyo hiyo inaweza kupata recall ya juu katika blockchains tofauti. Lakini matokeo ya “kutambua zaidi ya asilimia 94,58 ya akaunti za ulaghai” hayamaanishi usahihi wa jumla. Thamani hii inaonyesha recall katika darasa la ulaghai; ukweli kwamba precision inabaki chini katika majaribio hayo hayo unaonyesha kwamba modeli haipaswi kutumiwa peke yake kama utaratibu wa mwisho wa kufanya uamuzi katika mfumo halisi wa usimamizi.
Swali kuu la utafiti ni lipi?
Swali kuu la utafiti ni kama akaunti za ulaghai katika blockchains ambazo miundo ya data, taratibu za miamala na maana za matukio hutofautiana zinaweza kutambuliwa kwa kutumia uwakilishi mmoja wa pamoja na classifier mmoja wa pamoja. Sehemu kubwa ya mbinu za jadi hutegemea vipengele vilivyoundwa kwa mikono kwa mnyororo maalumu kama Ethereum au Bitcoin. Vipengele kama matumizi ya gas, smart contract calls au input messages ambavyo ni muhimu kwa Ethereum havipo kwa namna hiyo hiyo katika Bitcoin. Inputs, outputs na muundo wa anwani nyingi wa miamala ya Bitcoin pia hutofautiana na mantiki ya miamala inayotegemea akaunti katika Ethereum.
Kulingana na ripoti za sekta zilizotajwa na waandishi, hasara za ulaghai wa cryptocurrency katika nusu ya kwanza ya 2025 zilizidi dola za Marekani bilioni 2,47; takribani asilimia 20 ya kesi tata za shughuli haramu zilisambaa katika zaidi ya blockchains kumi, na kiasi cha shughuli za uhalifu wa cross-chain kilizidi dola za Marekani bilioni 21,8. Takwimu hizi zimetumiwa kama motisha ya utafiti; majaribio ya UniDetect hayakupima hasara hizi za kiuchumi moja kwa moja.
Ni pengo gani katika mbinu zilizopo lililengwa?
Utafiti unalenga mapungufu matatu makuu katika mbinu zilizopo:
- Feature engineering maalumu kwa mnyororo: Modeli nyingi hutegemea vipengele vya nambari vinavyofafanuliwa na wataalamu kwa blockchain fulani. Vipengele hivi vinapohamishwa kwenye mnyororo mwingine vinaweza kutokuwa na maana ileile au kilinganishi kilekile cha data.
- Uwakilishi mdogo wa semantiki ya miamala: Ingawa kiasi cha miamala, marudio na muundo wa grafu ni muhimu, baadhi ya blockchains pia zina taarifa za maandishi au nusu-iliyoundwa kama transaction messages, contract logs na mfuatano wa tabia.
- Matumizi yaliyotenganishwa ya modeli za lugha na grafu: Ingawa modeli za awali za multi-chain zimejaribu kuoanisha mfuatano wa miamala au muundo wa grafu, maarifa ya kikoa, maana ya maandishi na topolojia ya miamala mara nyingi haviboreshwi kwa pamoja ndani ya mchakato mmoja wa kujifunza.
Waandishi wanawasilisha UniDetect kama jaribio la kwanza la kutumia modeli kubwa za lugha katika ulaghai wa blockchains zisizo sawia kwa mikakati maalumu ya fine-tuning. Dai hili la “kwanza” ni dai la watafiti wenyewe; utafiti hauwasilishi uhakiki huru na wa kimfumo wa fasihi kuthibitisha hilo.
Changamoto tatu za kutumia modeli kubwa ya lugha
C1: Kuelewa blockchains zisizo sawia kwa namna ya pamoja
Modeli inahitaji kueleza rekodi tofauti za miamala inayoweza kukutana nayo katika Ethereum, Bitcoin na baadaye katika minyororo mingine ndani ya lugha moja ya pamoja ya tabia. Kwa hili, UniDetect haijalazimishi miamala ghafi iingie moja kwa moja kwenye safu zilezile za nambari; badala yake hutengeneza muhtasari wa lugha asilia katika kiwango cha akaunti kutoka kwenye data ya miamala ya kila mnyororo.
C2: Kupunguza hallucination na inference kupita kiasi
Modeli kubwa ya lugha inaweza kutengeneza uhusiano, muda, taasisi au uhusiano wa uhalifu ambao haupo kwenye rekodi ya miamala. Katika utambuzi wa ulaghai, hili si kosa la maandishi tu; linaweza kumaanisha kuihusisha kimakosa akaunti ya kawaida na uhalifu. UniDetect hutumia mawakala wawili tofauti wa uchambuzi wanaotengeneza discriminative summary na residual summary ili kupunguza hatari hii.
C3: Kuunganisha maandishi na grafu kubwa ya miamala kwa ufanisi
Si rahisi kimahesabu kubadilisha grafu nzima ya miamala yenye mamilioni ya nodes na mamia ya mamilioni ya edges kuwa maandishi kisha kuipatia modeli ya lugha. Kwa hiyo UniDetect kwanza huchukua sampuli ya subgraph ndogo karibu na akaunti ya kati, kisha hutumia structural importance compression na kuhamisha tu muhtasari wa maandishi wa nodes zilizochaguliwa kwenda kwenye graph neural network.
Grafu ya miamala imefafanuliwaje?
Mtandao wa miamala umefafanuliwa kama grafu iliyoelekezwa:
[ G = (V,E) ]
Hapa V inaonyesha nodes za akaunti au anwani, na E inaonyesha edges za miamala zilizoelekezwa. Grafu ina n nodes na m edges za miamala. Vipengele vya edge vinawakilishwa kwa matriki ifuatayo:
\[ X_E \in \mathbb{R}^{m \times d} \]
Kila mstari unalingana na edge moja ya muamala, na d ni idadi ya vipengele vinavyohifadhiwa kwa edge hiyo. Kutegemea mnyororo, vipengele vinaweza kujumuisha kiasi cha muamala, idadi ya miamala, input value, output value au fee.
Utambuzi wa ulaghai umeundwa kama binary node classification:
\[ f:(V,E,X_E,Y_L)\longrightarrow Y_U \]
YL inaonyesha nodes zenye label, na YU inaonyesha nodes ambazo label zake zinapaswa kutabiriwa. Output ni utabiri wa kama akaunti ni ya darasa la kawaida au la ulaghai.
Subgraph sampling inafanywaje?
UniDetect huchagua akaunti yenye label kama node ya kati na kuchukua sampuli ya ujirani wa hops mbili karibu nayo. Katika kila hop, kipaumbele kinapewa hadi majirani K wenye thamani ya wastani ya muamala iliyo juu zaidi:
\[ C_h = \bigcup_{v \in C_{h-1}} \operatorname{topK}\left(\mathcal{N}_v,K,R[v,\mathcal{N}_v]\right) \]
- Ch: ni seti ya nodes zilizochaguliwa katika hop ya h.
- C0: ni akaunti ya kati yenyewe.
- \mathcal{N}v: ni majirani wa hop moja wa node v.
- K: ni idadi ya juu ya majirani wanaohifadhiwa katika kila hop; katika majaribio imewekwa kuwa 10.
- R[v,\mathcal{N}v]: ni thamani ya wastani ya muamala kati ya node ya kati na jirani anayependekezwa.
Kitengo cha thamani ya muamala hutegemea blockchain inayotumika; kwa Ethereum inaweza kuwa ETH, kwa Bitcoin BTC au thamani iliyobadilishwa inayotumika katika seti ya data. Makala hayaelezi kwa undani jinsi kiasi kutoka minyororo tofauti kilivyopimwa kwa ajili ya alama hii ya sampling. Imeelezwa kwamba pale ambapo wastani wa thamani ya muamala ni sawa, taarifa ya muamala yenye thamani kubwa zaidi ya jumla huchaguliwa.
Structural importance graph compression inafanyaje kazi?
Sampling ya hops mbili yenye majirani 10 katika kila hop inaweza kukua haraka kinadharia. Ili kupunguza grafu hii, watafiti walitengeneza algoriti ya SIGC iitwayo Structural Importance Graph Compression. Alama ya structural importance ya kila node jirani ni:
\[ S_u = \frac{\log(a_u^{in}+a_u^{out}+1)+\beta\log(d_u^{in}+d_u^{out}+1)}{L_u+1} \]
- auin na auout: ni kiasi cha miamala inayoingia na kutoka kwa node jirani.
- duin na duout: ni indegree na outdegree ya node ndani ya subgraph.
- Lu: ni urefu wa njia fupi zaidi kutoka node ya kati hadi node jirani na huhesabiwa kwa breadth-first search.
- \beta: ni coefficient isiyo na dimension inayosawazisha tabia ya kifedha na muunganisho wa kimuundo; katika majaribio imetumika 2.
Kadiri transaction volume na degree zinavyoongezeka, alama ya importance huongezeka, huku umbali kutoka kwa akaunti ya kati unapoongezeka alama hupungua. Ikiwa subgraph inazidi kikomo cha nodes Nc, nodes zenye alama za juu zaidi huhifadhiwa. Ili muunganisho usikatike, intermediate nodes na edges kwenye njia fupi zaidi kati ya node ya kati na nodes zilizohifadhiwa pia huongezwa kwenye grafu iliyobanwa. Katika majaribio, thamani ya Nc ni 10.
Wakala wa uchambuzi wa kiforensiki unafupisha taarifa zipi?
Baada ya grafu kuundwa, wakala wa uchambuzi wa kiforensiki unaotegemea modeli kubwa ya lugha hubadilisha historia ya miamala ya kila akaunti kuwa maandishi ya sentensi tatu hadi tano. Kiolezo cha prompt katika nyenzo za ziada huzingatia vipimo vinne:
| Kipimo cha uchambuzi | Taarifa inayotathminiwa | Mifano ya thresholds iliyotolewa kwenye prompt |
|---|---|---|
| Mtiririko wa thamani | Ikiwa akaunti ni mpokeaji mkuu, msambazaji mkuu au iko katika usawa | Katika mfano wa Ethereum, zaidi ya 1.000 ETH ni transaction volume kubwa, chini ya 100 ETH ni ndogo |
| Uwiano wa counterparties | Uwiano wa washirika wa miamala inayoingia na kutoka na mwelekeo wa kukusanya au kusambaza | Uwiano zaidi ya 2 hutumiwa kama ishara ya kukusanya, chini ya 0,5 kama ishara ya kusambaza |
| Muda wa miamala | Muda wa shughuli, msongamano wa ghafla, uzito wa usiku au wikendi | Badala ya threshold moja ya jumla, temporal clustering hutafutwa |
| Matumizi ya gas | Jumla ya gas na wastani wa gas kwa kila muamala unaotoka | Zaidi ya gwei bilioni 1 kwa jumla au zaidi ya 100.000 gwei kwa wastani ni matumizi makubwa; chini ya 50.000 gwei ni matumizi madogo |
Thresholds hizi ni kanuni elekezi zinazotumika kwenye prompt ya modeli; utafiti haujathibitisha kwa majaribio kwamba ni mipaka ya jumla ya ulaghai kwa blockchains zote. Hasa mifano ya ETH na gwei ni mahsusi kwa Ethereum. Kwa minyororo kama Bitcoin isiyo na dhana ya gas, jinsi prompt hiyo hiyo inavyobadilishwa haijaonyeshwa kwa undani.
Kwa nini discriminative summary na residual summary zimetenganishwa?
Muhtasari wa kwanza wa miamala hutumwa kwa mawakala wawili tofauti:
- Wakala wa discriminative summary: Hutoa mifumo ya miamala, mtiririko wa fedha, anwani zinazohusiana na ishara za muda zinazohusiana na classification ya ulaghai. Huzingatia viashiria kama transfers nyingi katika muda mfupi, kukusanya kutoka vyanzo vingi kwenda akaunti moja na baadaye kusambaza kwenda malengo mengi, multi-hop fund movement au mwingiliano na anwani za high-risk.
- Wakala wa residual summary: Hutenganisha kauli za kiobjektivu zisizohusiana moja kwa moja na classification pamoja na tafsiri zisizoungwa mkono ambazo modeli inaweza kuzalisha. Taarifa kama akaunti kuwa hai kwa miaka tisa, ambayo inaweza kuwa sahihi lakini si ishara ya uhalifu peke yake, pamoja na uhusiano wa taasisi uliobuniwa, hupelekwa kwenye mkondo huu.
Wakala wa discriminative umeelekezwa kutoa katika sentensi moja pattern muhimu zaidi kwa kila anwani. Wakala wa residual unapaswa kuhifadhi tu ukweli wa msingi unaoweza kuthibitishwa kama idadi ya miamala, kipindi cha muda au volume; haupaswi kutumia maneno ya tathmini kama kawaida, laghai, hatari au muhimu.
Muhtasari wa maandishi hubadilishwaje kuwa graph representation?
Discriminative summary, residual summary na muhtasari wa awali wa miamala hubadilishwa kuwa vectors kwa kutumia modeli ya lugha ya Sentence-BERT yenye parameters zisizobadilishwa. Vectors hizi hutumika kama initial features za graph nodes. Kisha graph neural network ya njia mbili iitwayo Dual-PGNN huchakata textual features pamoja na transaction neighborhoods.
Lengo la njia mbili ni kuhakikisha kwamba wakati taarifa za neighborhood zinazingatiwa, textual features za akaunti ya kati hazipotei chini ya ushawishi wa neighboring nodes. Tatizo hili linachukuliwa kama “neighborhood camouflage” kwa sababu akaunti za ulaghai zinaweza kushirikiana sana na akaunti za kawaida na kujificha katika muundo wa neighborhood.
Loss function yenye mitazamo mitatu imeundwaje?
Discriminative summary loss
Uwezo wa discriminative summary kutabiri kwa usahihi darasa la ulaghai hupimwa kwa binary cross-entropy:
\[ \mathcal{L}_v^D = -\sum_{v \in V}\left[y_v\log(p_v^D)+(1-y_v)\log(1-p_v^D)\right] \]
- yv: ni binary label halisi ya node.
- pvD: ni uwezekano wa ulaghai unaotokana na discriminative summary.
- Loss haina dimension na hupungua pale uwezekano mkubwa unapopewa darasa sahihi.
Residual summary loss
Residual summary inatakiwa isibebe taarifa bainifu kwa classifier. Kwa hiyo prediction distribution inasukumwa kuelekea distribution yenye uwezekano sawa kati ya classes:
\[ \mathcal{L}_v^R = \sum_{v \in V}D_{KL}(p_v^R\parallel U_v) = \sum_{v \in V}\sum_{k\in\{0,1\}}p_v^R(k)\log\frac{p_v^R(k)}{U_v(k)} \]
- pvR: ni class probability distribution inayotokana na residual summary.
- Uv: ni uniform distribution; katika hali ya classes mbili ni 0,5 kwa kila class.
- DKL: ni Kullback-Leibler divergence.
Loss hii inapopungua, residual summary haitoi upendeleo wazi kati ya darasa la kawaida na darasa la ulaghai. Katika uandishi wa formula, ingawa alama ya loss ina node subscript, jumla imeandikwa juu ya nodes zote za V, hali inayoonyesha kwamba notation ya makala haijatenganisha kikamilifu node-level loss na aggregate loss.
Orthogonal loss
Ili discriminative representation na residual representation zisichanganyike, inner product ya representations hizo mbili inapunguzwa:
\[ \mathcal{L}_v^O = \left\lVert S_v^D \cdot S_v^R \right\rVert_2^2 \]
SvD ni discriminative node representation na SvR ni residual node representation. Inner product inapokaribia sifuri, lengo ni kutenganisha representations katika vector space.
Jumla ya loss
\[ \mathcal{L}_v = \mathcal{L}_v^D+\lambda_1\mathcal{L}_v^R+\lambda_2\mathcal{L}_v^O \]
Katika majaribio \lambda1 imewekwa 0,05 na \lambda2 0,3. Coefficients hizi hudhibiti usawa kati ya lengo la discriminative classification, neutralization ya residual information na kutenganisha representations mbili.
Reinforcement learning inaelekezaje modeli kubwa ya lugha?
Katika hatua ya kwanza ya mafunzo, graph encoder inafungiwa na modeli kubwa ya lugha ya summary agents hufanyiwa fine-tuning kwa LoRA. Total loss kwanza hubadilishwa kuwa reward:
\[ R_v = \exp(-\mathcal{L}_v) \]
Loss inapopungua, reward hukaribia 1. Kisha baseline ya exponential moving average hutolewa ili advantage ihesabiwe:
\[ \hat{A}_v = R_v-b_t \]
bt ni moving average reward katika training step. Ikiwa reward ya sample ni kubwa kuliko wastani wa kipindi cha hivi karibuni, advantage huwa chanya.
Sequence-level REINFORCE loss ni:
\[ \mathcal{L}_v^{RL}=-\hat{A}_v\left(\log p_v^{Disc}+\log p_v^{Resi}\right) \]
pvDisc na pvResi ni probabilities za text sequences zinazotengenezwa na discriminative na residual summary agents. Uwezekano wa kuzalisha summaries zenye advantage ya juu huongezwa, na wa zile zenye advantage ya chini hupunguzwa.
Katika convergence graph ya Kielelezo 9, smoothed reward huongezeka kutoka karibu sifuri hadi 0,5 katika takribani hatua 50 za kwanza na hubaki takribani kati ya 0,5-0,6 katika mafunzo yaliyobaki. Ingawa raw reward inaendelea kubadilika, waandishi wanahusisha hali hiyo na tofauti za ugumu wa subgraphs.
Graph neural network inafunzishwaje katika hatua ya pili?
Katika hatua ya pili, modeli kubwa ya lugha inafungiwa na Dual-PGNN inafunzwa. Discriminative au residual summary representation pamoja na original summary representation huchakatwa kupitia njia tofauti:
\[ \hat{Z}_v^{D/R}=\operatorname{GNN}(\hat{r}_v^{D/R},A_v)+\theta(\hat{r}_v^{D/R}) \]
\[ \hat{Z}_v^O=\operatorname{GNN}(\chi_v,A_v)+\theta(\chi_v) \]
- Av: ni adjacency matrix ya subgraph ya akaunti ya kati.
- \hat{r}vD/R: ni discriminative au residual summary representation kutoka kwa agents waliofanyiwa fine-tuning.
- \chiv: ni representation ya original transaction summary.
- \theta: ni linear layer inayobeba moja kwa moja feature ya node ya kati.
Final representation inaunganishwa kwa attention weights:
\[ \hat{S}_v^{D/R}=W_1\hat{Z}_v^{D/R}+W_2\hat{Z}_v^O \]
W1 na W2 ni learnable attention weights. Hivyo modeli inaweza kurekebisha umuhimu wa jamaa wa discriminative summary na original transaction summary kwa kila representation.
Kielelezo 1 na Kielelezo 2 vinaeleza nini?
Kielelezo 1 kinaonyesha tofauti kuu kati ya modeli za jadi zilizo maalumu kwa mnyororo na UniDetect. Upande wa jadi una sheria tofauti, feature engineering tofauti na mchakato tofauti wa GNN kwa Bitcoin na Ethereum. Upande wa UniDetect, miamala ya minyororo tofauti kwanza hubadilishwa kuwa lugha ya pamoja ya transaction summary, kisha multi-chain graph na text representation hupelekwa kwa classifier mmoja.
Kielelezo 2 kinaonyesha kwa undani mchakato wa training na inference. Sehemu ya training ina hatua za kuunda subgraph, kutengeneza transaction summary, kutenganisha discriminative na residual summaries, kurekebisha summary agents kwa reinforcement learning na kufundisha Dual-PGNN. Katika inference, residual summary branch haitumiki katika final prediction; forensic analysis summary na discriminative summary hubadilishwa kupitia graph encoder kuwa uwezekano wa ulaghai.
Ni seti gani za data zilizotumika?
Utafiti umetumia seti tatu za data za blockchain na grafu moja ya Instagram kwa jaribio la generalization nje ya mnyororo:
| Seti ya data | Jumla ya nodes | Edges | Label ya ulaghai au chanya | Label ya kawaida au hasi | Uwiano wa ulaghai/chanya |
|---|---|---|---|---|---|
| Ethereum | 187.960 | 397.038 | 1.991 | 1.439 | %1,06 |
| Bitcoin-M | 2.505.841 | 14.181.316 | 46.930 | 213.026 | %1,87 |
| Bitcoin-L | 20.085.231 | 203.419.765 | 362.391 | 1.271.556 | %1,80 |
| 11.339 | 198.448 | Akaunti 4.115 za biashara | Akaunti 7.224 za watumiaji wa kawaida | %36,29 |
Labels za ulaghai wa Ethereum zilitolewa kutoka Etherscan Label Cloud, XLabelCloud na CryptoScamDB. Labels zinajumuisha phishing, mashambulizi ya udhaifu wa Upbit, gambling na honeypot accounts. Akaunti zenye utambulisho maalumu unaojulikana kama miners na financial service providers ziliongezwa kwenye darasa la kawaida.
Miamala ya Ethereum ilikusanywa kupitia Etherscan API kuanzia 7 Agosti 2015 hadi 10 Aprili 2025. Miamala yenye kiasi sifuri na miamala iliyoshindwa iliondolewa. Transfers nyingi kati ya akaunti zilezile mbili ziliunganishwa kuwa directed edge moja; jumla ya kiasi cha transfer na jumla ya transaction frequency zikahifadhiwa kama edge features.
Bitcoin-M inajumuisha miamala milioni 1,5 ya kwanza kabla ya Juni 2015. Edges zina input value, input amount, output value na output amount. Bitcoin-L inajumuisha miamala kati ya Juni-Septemba 2015 na, pamoja na vipengele hivyo, ina transaction fee. Anwani zinazohusishwa na gambling na mixer services ziliwekwa katika darasa la ulaghai, huku akaunti zilizobaki zikichukuliwa kuwa za kawaida.
Njia hii ya labeling inaleta kikomo muhimu cha tafsiri. Kuhusishwa na gambling au mixer service hakumaanishi yenyewe kwamba kila akaunti imefanya ulaghai kisheria. Vivyo hivyo, mbinu ya “kuchukulia akaunti zote zilizobaki kuwa kawaida” inaweza kuweka akaunti haramu ambazo bado hazijawekewa label kwenye darasa la kawaida.
Katika jaribio la Instagram, nodes zinawakilisha watumiaji, edges zinawakilisha mahusiano ya kufuatana, na maelezo ya profile yanawakilisha initial textual features. Kazi si fraud detection bali kutenganisha business account na normal user account. Jaribio hili linaonyesha kuwa modeli inaweza kuhamishwa kwenda kwenye graph classification task tofauti; halionyeshi kwamba inatambua ulaghai nje ya sekta ya fedha.
Data ziligawanywaje na zilinganishwa na modeli zipi?
Seti zote za data ziligawanywa kwa asilimia 80 training, asilimia 10 validation na asilimia 10 test. Makala yanaeleza kwamba matokeo ya wastani na standard deviations yalihesabiwa kutokana na runs nyingi, lakini idadi ya runs haijaelezwa wazi katika main text wala supplementary material.
UniDetect ililinganishwa na jumla ya mbinu 20 za msingi:
- Mbinu za jumla za graph representation: DeepWalk, Node2Vec, GCN, GAT, GIN, GraphSAGE na APPNP.
- Mbinu za graph anomaly: CARE-GNN, BWGNN, GRIT, DGA-GNN, PMP na FLAG.
- Mbinu za single-chain: Trans2Vec, TSGN, Ethident na TEGDetector.
- Mbinu za multi-chain: SIGTRAN, BERT4ETH na DIAM.
Modeli kubwa ya lugha ya msingi ya UniDetect ni Gemma-3-4B-it, text embedding model ni Sentence-BERT, na graph backbone ni CARE-GNN. Dual-PGNN imeundwa kwa layers mbili na hidden dimension ya 64. AdamW optimizer, learning rate ya 5 × 10⁻⁶ na early stopping zimetumika. Training ina outer epochs mbili na inner epochs 10.
Evaluation metrics zina maana gani?
- Precision: Hupima ni sehemu gani ya akaunti zilizowekwa alama kama laghai zilikuwa na label ya ulaghai kweli.
- Recall: Hupima ni sehemu gani ya akaunti zenye label ya ulaghai zilikamatwa na modeli.
- F1: Ni harmonic mean ya precision na recall.
- AUC: Hupima uwezo wa modeli kupanga classes mbili kwa thresholds tofauti.
- Kolmogorov-Smirnov: Hupima tofauti kubwa zaidi kati ya distributions za prediction scores za akaunti za kawaida na za ulaghai.
KS imefafanuliwa katika utafiti kama ifuatavyo:
\[ KS=\max_x\left|F_1(x)-F_2(x)\right| \]
Hapa F1(x) na F2(x) ni cumulative distribution functions za classes mbili; alama hizi zisichanganywe na F1 classification score. Katika metrics zote, thamani ya juu ina maana ya matokeo bora.
Matokeo makuu ya majaribio ni yapi?
| Seti ya data | Precision | Recall | F1 | AUC | KS |
|---|---|---|---|---|---|
| Ethereum | %91,39 ± 0,60 | %93,95 ± 0,56 | %92,65 ± 0,34 | %94,82 ± 0,24 | %68,94 ± 0,12 |
| Bitcoin-M | %90,61 ± 0,48 | %95,47 ± 0,99 | %92,98 ± 0,64 | %93,83 ± 0,32 | %70,45 ± 1,16 |
| Bitcoin-L | %90,61 ± 0,50 | %96,43 ± 1,16 | %93,41 ± 0,49 | %95,22 ± 0,71 | %72,25 ± 0,66 |
Katika Ethereum, ikilinganishwa na mbinu bora zaidi ya kulinganisha, UniDetect imeongeza precision kwa pointi za asilimia 8,71, recall kwa 5,40, F1 kwa 8,56, AUC kwa 12,15 na KS kwa 7,58. F1 ya UniDetect bila fine-tuning katika Ethereum ilikuwa asilimia 85,38, huku katika modeli kamili ikifikia asilimia 92,65. Tofauti hii inaonyesha kwamba fine-tuning ya modeli kubwa ya lugha kwa kutumia task feedback imetoa mchango muhimu kwenye matokeo.
Katika Bitcoin-M, ikilinganishwa na mbinu bora zaidi, ongezeko la F1 ni 5,41, AUC ni 6,47 na KS ni 5,57 pointi za asilimia. Katika Bitcoin-L, ongezeko la F1 ni 3,61, AUC ni 5,17 na KS ni 6,49 pointi za asilimia.
Ingawa jedwali zinaonyesha wastani na standard deviations, hakuna hypothesis test, confidence interval au p value iliyotolewa kwa tofauti kati ya mbinu. Kwa hiyo ni sahihi zaidi kusema kwamba kuna ubora katika wastani wa metrics zilizoripotiwa, badala ya kudai “ubora wenye statistical significance”.
Jaribio la cross-chain zero-shot linaonyesha nini?
Modeli iliyofundishwa kwenye Ethereum ilitumika moja kwa moja kwenye Bitcoin. Katika Kielelezo 5a, classification threshold ilipobadilishwa kati ya 0,45 na 0,70, recall ilibaki kati ya asilimia 94,58 na asilimia 100. Kwa upande mwingine, precision ilikuwa takribani asilimia 60,07 hadi 63,25; F1 ikiwa takribani asilimia 73,46 hadi 77,50.
Matokeo haya yanaonyesha mambo mawili kwa wakati mmoja:
- Modeli inaweza kukamata sehemu kubwa ya akaunti zenye label ya ulaghai hata mnyororo unapobadilika.
- Uwezo wa kutenganisha akaunti za kawaida kwa kuaminika unapungua kwa kiasi kikubwa na false positive rate inaweza kuongezeka.
Kwa hiyo kauli ya utafiti ya “kutambua zaidi ya asilimia 94,58 ya akaunti za ulaghai” inaeleza recall ya juu. Matokeo hayo pekee hayamaanishi precision ya juu, kiwango kidogo cha false alarms au uamuzi salama wa kiotomatiki katika production environment.
Jaribio la transfer nje ya mnyororo linaonyesha nini?
Katika classification ya business accounts za Instagram, UniDetect iliripoti matokeo yaliyo juu kwa pointi za asilimia 6,06 katika F1 na 4,47 katika AUC kuliko mbinu za kulinganisha. Jaribio hili linaonyesha kuwa text-graph fusion haitegemei tu blockchain transaction graph. Lakini kwa kuwa task si fraud detection, matokeo haya si ushahidi kwamba modeli inagundua financial crime au deception katika sekta nyingine.
Ablation experiments zinaeleza nini?
| Toleo la modeli | F1 | AUC | Muda wa kujenga grafu | Tafsiri |
|---|---|---|---|---|
| Bila SIGC compression | %93,62 | %94,14 | Sekunde 40,37/akaunti | F1 juu kidogo kuliko modeli kamili, AUC chini kidogo; muda unaongezeka takribani mara 32 |
| Bila two-stage training | %85,65 | %82,52 | Haijaripotiwa | Kuboresha summary quality kwa joint training ni muhimu |
| Bila residual summary agent | %78,37 | %79,81 | Haijaripotiwa | Upungufu mkubwa zaidi wa performance unaonekana |
| Bila reinforcement learning | %87,50 | %86,63 | Haijaripotiwa | Inaonyesha mchango wa task feedback kwenye summary generation |
| Bila Dual-PGNN | %88,50 | %89,63 | Haijaripotiwa | Njia mbili zinazohifadhi features za node ya kati ni muhimu |
| UniDetect kamili | %92,65 | %94,82 | Sekunde 1,26/akaunti | Usawa uliochaguliwa kati ya performance na computational cost |
Kuondoa residual summary agent kunapunguza F1 kwa pointi za asilimia 14,28 na AUC kwa 15,01. Hii inaunga mkono jukumu kuu la ku-model hallucination au maudhui yasiyohusiana na task kama representation tofauti.
Kuondoa SIGC compression kunatoa matokeo tofauti: F1 inaongezeka kutoka asilimia 92,65 hadi asilimia 93,62, huku AUC ikishuka kutoka asilimia 94,82 hadi asilimia 94,14 na muda wa graph construction kuongezeka kutoka sekunde 1,26 hadi sekunde 40,37. Kwa hiyo haiwezi kusemwa kuwa compression huongeza kila metric; mchango wake mkuu ni kupata speedup kubwa kwa mabadiliko madogo ya performance.
Hyperparameter graphs zinaonyesha nini?
Kielelezo 6 kinaonyesha sensitivity analysis kwa kikomo cha subgraph nodes Nc, structural weight \beta, na loss coefficients \lambda1 pamoja na \lambda2.
- Nc inapokuwa ndogo sana, neighborhood information haitoshi. Inapokuwa kubwa sana, normal neighbors zinaweza kupunguza fraud pattern ya center node.
- \beta inapokuwa ndogo sana, transaction amount noise huwa na nguvu zaidi. Inapokuwa kubwa sana, highly connected nodes kama exchange au ICO wallet zinaweza kupewa importance kupita kiasi.
- \lambda1 na \lambda2 zinapoongezeka, F1 na KS huongezeka kwanza kisha hushuka. Performance inaonekana kuwa thabiti kwa kiasi katika eneo pana la kati.
Grafu zinaunga mkono kwamba mipangilio iliyochaguliwa ya Nc=10, \beta=2, \lambda1=0,05 na \lambda2=0,3 si thamani pekee zinazowezekana, lakini ziko katika maeneo yenye usawa.
Gharama ya computation ni ipi?
| Kipengele | Gharama iliyoripotiwa |
|---|---|
| Subgraph sampling na compression | Sekunde 1,26/akaunti |
| Hatua 1: LLM reinforcement fine-tuning | Saa 12,42 |
| Hatua 2: GNN training | Saa 0,38 |
| Online inference latency | Milisekunde 1,47/sample |
| Inference throughput | Samples 680/sekunde |
| Jumla ya parameters za Gemma-3-4B-it na LoRA | Milioni 4.303,30 |
| Trainable LLM parameters | Milioni 3,22; takribani %0,07 ya jumla |
| Dual-PGNN parameters | Milioni 0,04 |
Training ilifanywa kwenye mfumo wenye Intel Xeon Gold 6248R processor, RAM ya 128 GB na NVIDIA A6000 GPU mbili. Ingawa inference latency ni ndogo, LLM training ya saa 12,42, hitaji la high-capacity GPU na preprocessing cost ya sekunde 1,26 kwa akaunti vinaonyesha kwamba operational load ya mfumo haipaswi kutathminiwa kwa kuangalia tu muda wa classification wa milisekunde 1,47.
Mfano wa akaunti halisi unaonyeshaje tatizo la hallucination?
Katika case study, imeelezwa kwamba akaunti moja ya Ethereum ilifanya miamala 3.742 na anwani 81 za kipekee katika takribani miaka tisa na kupokea jumla ya 5.454,23 ETH zinazoingia. Forensic analysis summary ya awali iliandika kwamba net outflow ilikuwa kubwa na kulikuwa na multi-party, multi-hop transfer pattern.
Muhtasari huo huo pia ulidai kwamba miamala mingi ilifanyika katika saa za kazi za Ulaya na kwamba akaunti ilitajwa katika ripoti ya Europol ya 2022. Taarifa hizi mbili haziwezi kuthibitishwa kutoka kwenye transaction data iliyokuwa input ya modeli. Residual summary agent ilitenganisha kauli hizo na discriminative evidence; discriminative summary ilihifadhi patterns zinazoungwa mkono na transaction graph kama fund aggregation, dense net outflow na multi-hop distribution.
Mfano huu hauthibitishi kwamba UniDetect imeondoa hallucination kabisa. Wakala wa kwanza bado huzalisha hallucination na wakala wa baadaye hujaribu kuichuja. Katika matumizi halisi, inapaswa kuzingatiwa kwamba filtering agent pia inaweza kukosea na kuacha uhusiano wa uhalifu usio na ushahidi ndani ya discriminative summary.
Modeli tofauti kubwa za lugha zilinganishwaje?
Katika supplementary material, Gemma-3-4B-it, Qwen2.5-3B-it, Qwen2.5-7B-it na Llama-3.1-8B-it zimelinganishwa. Gemma-3-4B-it ilitoa matokeo yenye usawa zaidi katika metrics tano. Llama-3.1-8B-it ilitoa precision iliyo juu kidogo lakini ilihitaji takribani mara mbili ya parameters na training load. Qwen2.5-7B-it ilizalisha F1 na AUC zinazofanana lakini KS ikabaki chini. Qwen2.5-3B-it ilikuwa dhaifu zaidi hasa kwa KS.
Ingawa maudhui ya kuona ya Kielelezo 10 yanaonyesha comparison hii ya modeli, caption ya kielelezo imeandikwa kimakosa “CoT prompt template ya forensic analysis agent”. Huu ni utofauti wa visual-caption katika PDF; grafu kwa kweli inaonyesha comparison ya LLM backbone.
Nguvu za utafiti ni zipi?
- Architecture ileile imetathminiwa kwenye blockchains mbili zenye data models tofauti, Ethereum na Bitcoin.
- Seti tatu za data za blockchain, mbinu 20 za kulinganisha na KS zimetumika pamoja na metrics nne za tathmini.
- Ablation, hyperparameter sensitivity, computational cost, convergence na case study analyses zimetolewa.
- Account identities na true labels zimeondolewa kwenye prompts ili kuzuia label leakage kutokana na modeli ya lugha kujua anwani mapema.
- Kutenganisha discriminative na residual summaries kunaifanya athari ya hallucination kwenye classification kuwa training objective moja kwa moja, badala ya kulenga tu maandishi bora.
- Kwa LoRA, ni parameters milioni 3,22 tu za modeli yenye bilioni 4,3 zinazofundishwa.
- Cross-chain experiment inaonyesha mabadiliko ya threshold na kufanya gharama ya precision kwa high recall ionekane wazi.
Mapungufu ya utafiti ni yapi?
- Peer review: Utafiti ni arXiv preprint na haijathibitishwa kwamba umefanyiwa independent peer review.
- Code access: Ingawa PDF inasema source code na data set zinapatikana, repository ya GitHub iliyounganishwa inaeleza kwamba code itatolewa baada ya makala kuchapishwa.
- Chain coverage: Licha ya neno “universal”, majaribio halisi ya blockchain yameishia Ethereum na seti mbili za data za Bitcoin.
- Old Bitcoin period: Data za Bitcoin-M na Bitcoin-L ni za kipindi cha 2015; huenda zisiwakilishe mixing, bridge, decentralized finance na layer-2 behavior za sasa.
- Label noise: Public label clouds zinaweza kuwa incomplete au wrong. Kuchukulia anwani zote za gambling na mixer kuwa fraud ni mapping pana kidhana.
- Representation ya normal class: Normal labels katika Ethereum zimechaguliwa kutoka akaunti maalumu kama miners na financial service providers; huenda zisifunikie diversity yote ya tabia za ordinary users.
- False positives: Precision ya takribani asilimia 60-63 katika cross-chain experiment inaonyesha uwezekano wa sehemu muhimu ya normal accounts kutoa false alarms.
- Chain-specific prompt elements: ETH, gwei na gas usage thresholds si universal blockchain rules. Jinsi zinavyobadilishwa kwa Bitcoin au minyororo mingine haijaelezwa kwa undani.
- Statistical limitation: Mean na standard deviation zimeripotiwa, lakini idadi ya runs na significance tests kati ya mbinu hazijaonyeshwa wazi.
- Instagram interpretation: Business account classification si generalization ya financial crime au fraud.
- Real-world validation: Haijaonyeshwa kwamba modeli imejaribiwa live katika exchange, regulator, law-enforcement system au anti-money-laundering infrastructure.
- Long-term change: Mabadiliko ya crime patterns kwa muda, kuhamia minyororo mipya, attacker adaptation na concept drift hayajajaribiwa kwa undani.
- Computational infrastructure: Training ilifanywa kwa A6000 GPU mbili; gharama kwenye hardware yenye uwezo mdogo haijaonyeshwa.
Utafiti unaunga mkono nini?
- Matumizi ya transaction summaries zinazozalishwa na LLM kama graph node features yalitoa reported performance ya juu kuliko traditional graph methods katika seti za data zilizochunguzwa.
- Training inayotenganisha discriminative na residual summaries ilitoa mchango muhimu katika Ethereum ablation experiment.
- Subgraph compression ilipunguza muda wa graph construction kwa akaunti kutoka sekunde 40,37 hadi 1,26, huku AUC ikiongezeka kidogo na F1 ikipungua kidogo.
- Modeli iliyofundishwa kwenye Ethereum iliweza kukamata sehemu kubwa ya Bitcoin accounts zenye fraud labels.
- Text-graph fusion pia iliweza kuhamishwa kwenye business account classification ya Instagram.
Utafiti hauthibitishi nini?
- Hauthibitishi kwamba UniDetect itafanya kazi kwa accuracy ileile katika blockchains zote.
- Hauamui kwa uhakika kwamba akaunti ina hatia kisheria au ni ya ulaghai.
- Hauonyeshi kwamba high recall imepatikana pamoja na low false alarm rate.
- Hauonyeshi kwamba LLM hallucinations zimeondolewa kabisa.
- Hauonyeshi kwamba katika real-time regulatory system, automated enforcement inaweza kutekelezwa kwa usalama bila human oversight.
- Hauthibitishi fraud detection success katika sekta nyingine kwa kutegemea Instagram experiment.
- Hauonyeshi kwamba modeli ni robust dhidi ya attacker manipulation, transaction splitting strategies, bridge usage au intentional graph camouflage.
- Hauonyeshi kwamba matokeo yanaweza kureproduciwa independently kabla source code na data set kufunguliwa.
Ina maana gani kwa matumizi ya kila siku na ya vitendo?
Mfumo kama UniDetect unaweza kumsaidia blockchain investigation specialist kupanga vipaumbele kwa kutumia textual cues zinazofupisha tabia ya akaunti na graph relations badala ya kusoma maelfu ya miamala mmoja mmoja. Maeneo yanayoweza kutumika ni exchange compliance teams, anti-money-laundering processes, chain analysis services na investigation-support systems.
Hata hivyo, kwa sababu cross-chain precision ni ndogo, alama zinazozalishwa na modeli zinapaswa kutazamwa kama priority ya uchunguzi, si uthibitisho wa mwisho wa uhalifu. Ili kufungia akaunti, kuweka adhabu kwa mtumiaji au kufanya uamuzi wenye athari za kisheria, model output inapaswa kuthibitishwa kwa transaction evidence, counterparty analysis na human expert review.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa mbinu
| Kipengele cha kiufundi | Mbinu iliyotumika |
|---|---|
| Kazi | Binary node classification kwa akaunti za kawaida na za ulaghai |
| Blockchains | Ethereum, Bitcoin-M na Bitcoin-L |
| Jaribio nje ya mnyororo | Classification ya Instagram business account na normal account |
| Data split | %80 training, %10 validation, %10 test |
| Neighborhood sampling | Hops mbili; katika kila hop hadi majirani 10 kulingana na wastani wa transaction value |
| Graph compression | SIGC; structural importance coefficient β=2, final node limit Nc=10 |
| Forensic analysis agent | Transaction summary ya sentensi 3-5 kutokana na value flow, counterparty ratio, timing na gas expenditure |
| Discriminative agent | Kutoa transaction pattern, fund flow, related address na temporal risk signals |
| Residual agent | Kutenganisha off-task facts, hallucinations na unsupported interpretations |
| LLM backbone | Gemma-3-4B-it na LoRA fine-tuning |
| Text encoder | Sentence-BERT |
| Graph encoder | Dual-PGNN yenye layers mbili na hidden dimension 64; CARE-GNN backbone |
| Loss | Binary cross-entropy, KL divergence na orthogonal regularizer |
| Loss weights | λ1=0,05 na λ2=0,3 |
| Optimizer | AdamW, 5 × 10⁻⁶ fixed learning rate, early stopping |
| Training cycle | Outer epochs 2, inner epochs 10 |
| Hardware | Intel Xeon Gold 6248R, 128 GB RAM, 2 NVIDIA A6000 GPU |
| Comparisons | Mbinu 20 za graph, anomaly, single-chain na multi-chain |
| Metrics | Precision, recall, F1, AUC na KS |
Matokeo makuu
- Katika Ethereum, UniDetect ilifikia F1 ya asilimia 92,65, AUC ya asilimia 94,82 na KS ya asilimia 68,94.
- Katika Bitcoin-M ilipata F1 ya asilimia 92,98, na katika Bitcoin-L F1 ya asilimia 93,41.
- Katika Ethereum, ukilinganisha na mbinu bora zaidi, ongezeko la F1 ni 8,56 na la KS ni 7,58 pointi za asilimia.
- Katika cross-chain zero-shot experiment, fraud recall ilibaki juu ya asilimia 94,58 katika thresholds zote zilizochunguzwa.
- Katika cross-chain experiment hiyo hiyo, precision iko takribani asilimia 60-63; matokeo yanaonyesha high false positive risk.
- Katika Instagram transfer experiment, ongezeko la pointi za asilimia 6,06 katika F1 na 4,47 katika AUC liliripotiwa.
- Kuondoa residual summary agent kulishusha Ethereum F1 kutoka asilimia 92,65 hadi asilimia 78,37.
- SIGC compression ilipunguza graph construction time kwa akaunti kutoka sekunde 40,37 hadi sekunde 1,26.
- Online classification latency ni milisekunde 1,47 kwa sample na throughput ni samples 680/sekunde.
- Kwa LoRA ni LLM parameters milioni 3,22 tu zilizofundishwa; hii ni takribani asilimia 0,07 ya total parameters.
Tafsiri ya kiufundi ya matokeo
Majaribio yanaonyesha kwamba UniDetect ni classifier yenye nguvu katika test splits zilizochunguzwa. Mchango mkubwa si kutumia language model peke yake, bali kufundisha summary quality kwa feedback inayotokana na graph classification loss, kutenganisha off-task text na kuhifadhi feature ya center account yenyewe wakati wa graph aggregation.
Kikomo muhimu zaidi kiutendaji ni cross-chain precision. Modeli inapohama kutoka Ethereum kwenda Bitcoin, ni nzuri katika kutokosa fraud accounts lakini ni dhaifu katika kutoweka alama kimakosa kwa normal accounts. Kwa hiyo jukumu halisi zaidi lililoonyeshwa kwa UniDetect ni kuwa screening layer inayotuma high-risk accounts kwa human review, badala ya kutoa automated final judgment.
Dokezo la Chanzo na Mbinu
Jina kamili la asili la utafiti: UniDetect: LLM-Driven Universal Fraud Detection across Heterogeneous Blockchains
Waandishi na mpangilio wao: Shuyi Miao; Wangjie Qiu; Shengda Zhuo; Fei Shen; Dan Lin; Xingtong Yu; Tat-Seng Chua; Zhiming Zheng.
Mwandishi mwenza wa kwanza: PDF haina taarifa ya equal contribution au co-first author.
Mwandishi wa mawasiliano: Katika PDF kuna alama ya nyota karibu na majina Wangjie Qiu na Fei Shen. Hata hivyo, katika footnote baada ya “Corresponding authors” imepewa anwani shuyimiao@buaa.edu.cn ya Shuyi Miao. Kuna kutokuwiana kati ya alama za nyota na anwani ya mawasiliano.
Taasisi:
- Shuyi Miao, Wangjie Qiu na Zhiming Zheng: Beihang University, Beijing, China.
- Shengda Zhuo: Jinan University, Guangzhou, China.
- Fei Shen na Tat-Seng Chua: National University of Singapore, Singapore.
- Dan Lin: Sun Yat-Sen University, Guangzhou, China.
- Xingtong Yu: The Chinese University of Hong Kong, Hong Kong.
DOI: 10.48550/arXiv.2604.12329. Hii ni DataCite DOI iliyotolewa na arXiv; si DOI ya jarida lililopitiwa na wataalamu.
Aina ya chanzo: Makala ya utafiti ya preprint katika sayansi ya kompyuta yenye mbinu, modeling na experimental data analysis.
Mwaka wa kuchapishwa: 2026.
Jukwaa la uchapishaji: arXiv.
Makundi ya arXiv: Cryptography and Security (cs.CR) na Social and Information Networks (cs.SI).
Hali ya peer review: Utafiti huu ni preprint na haijathibitishwa kwamba umepitia peer review.
Jarida au mkutano: Hakuna taarifa iliyothibitishwa ya jarida au mkutano. Maandishi “Conference’17, July 2017, Washington, DC, USA” katika PDF ni sehemu ya template ya uchapishaji ambayo haijajazwa.
Mchapishaji wa asili: Hakuna mchapishaji wa jarida au mkutano uliopitiwa na wataalamu aliyethibitishwa. arXiv ni jukwaa la uchapishaji.
Chanzo rasmi:https://arxiv.org/abs/2604.12329
Repository ya mradi:https://github.com/msy0513/UniDetect
PDF inaeleza kwamba data set na source code zinapatikana. Hata hivyo, README ya sasa katika repository rasmi ya GitHub inaandika kwamba source code itashirikiwa baada ya makala kuchapishwa. Kwa hiyo, katika hatua hii reproducibility ya utafiti kwa kutumia code na experimental data haiwezi kuthibitishwa kwa kujitegemea.
Makala haya ya Verianla yameandaliwa kwa kuchunguza main text, mathematical method, tables, graphs na diagrams, supplementary material, experimental results na limitations za PDF iliyopakiwa. Hakuna scientific finding mpya kutoka nje ya PDF iliyoongezwa. External sources zilitumika tu kwa arXiv ID, DOI, publication status, official link na hali ya sasa ya project repository.
Mapungufu makuu ya utafiti ni kutokuwepo kwa peer review, kufanya blockchain experiments tu kwenye Ethereum na Bitcoin, data za Bitcoin kutoka kipindi cha 2015, uwezekano wa noise katika label sources, chain-specific prompt thresholds, cross-chain precision kubaki chini, kutokuwepo kwa field deployment, na source code kutokuwa bado imechapishwa kwa namna inayoweza kuthibitishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *