

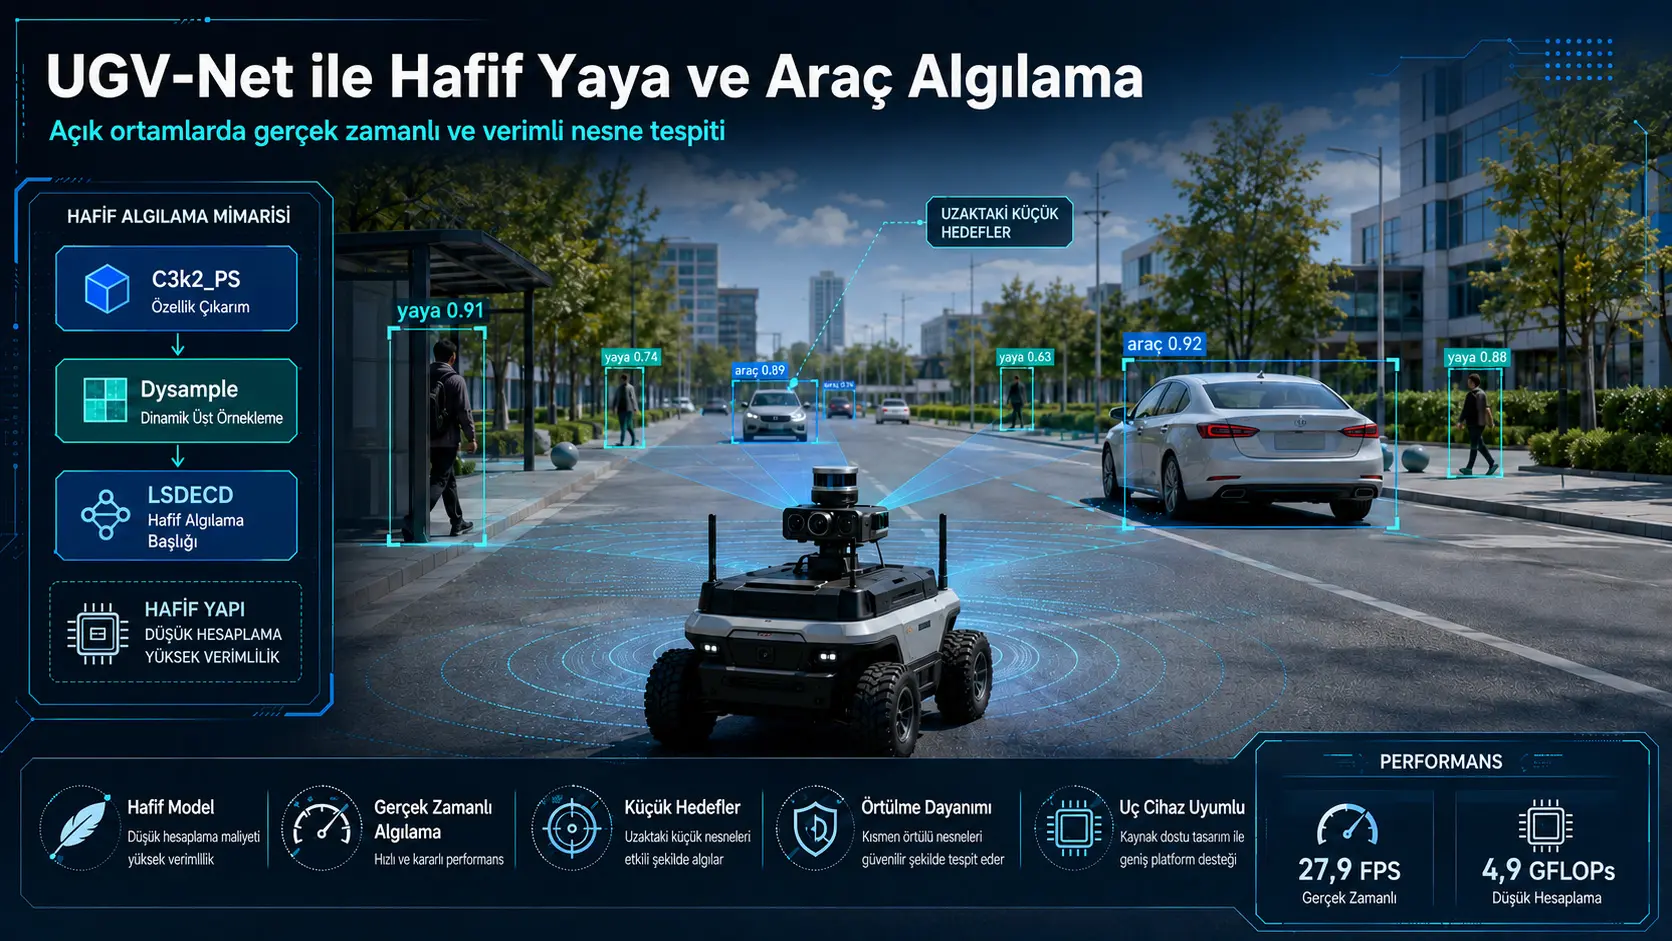
Bu araştırma, açık ve karmaşık ortamlarda çalışan insansız kara araçlarının (Unmanned Ground Vehicles, UGV) yaya ve araçları gerçek zamanlı olarak algılayabilmesi için YOLO11n tabanlı hafif bir nesne tespit modeli olan UGV-Net'i geliştirmektedir. Model; özellik temsilini ve küresel bağlam kullanımını güçlendiren C3k2_PS, küçük nesnelerde ayrıntı kaybını azaltmayı amaçlayan içerik duyarlı Dysample dinamik üst örnekleme ve algılama başlığındaki hesaplama tekrarını azaltırken ayrıntı temsilini korumaya çalışan LSDECD olmak üzere üç temel değişiklik içerir. KITTI testlerinde YOLO11n taban çizgisine göre F1 skoru %83,44'ten %85,63'e, mAP50 %87,18'den %89,44'e ve mAP50-95 %63,97'den %66,07'ye yükselirken hesaplama maliyeti 6,3 GFLOPs'tan 4,9 GFLOPs'a ve parametre sayısı 2,58 milyondan 2,41 milyona düşmüştür. Jetson Orin Nano üzerinde UGV-Net ortalama 27,9 FPS ve 35,84 ms gecikme vermiştir. Bununla birlikte sonuçlar tam bir gerçek UGV saha sürüşü veya bütün hava/aydınlatma koşullarının doğrulaması değildir; araştırmacılar aşırı ışık değişimleri, yağmur, sis, düşük gece görüşü ve çoklu sensör birleştirmeyi gelecekteki çalışmalar arasında göstermektedir.
Çalışmanın ana problemi doğruluk ile hesaplama verimliliğinin aynı anda korunmasıdır. Açık yol görüntülerinde uzaktaki küçük nesneler az sayıda piksel kaplamakta, yayalar veya araçlar kısmen örtülebilmekte ve direk, bitki, bina kenarı gibi yüksek kontrastlı arka plan yapıları yanlış pozitifleri artırabilmektedir. Öte yandan mobil robotlarda kullanılan uç donanımın işlem gücü, bellek ve güç bütçesi sınırlıdır. UGV-Net bu iki gereksinimi aynı mimaride ele almayı amaçlamaktadır.
Çalışmadaki en güçlü nicel sonuç yalnız doğruluk artışı değildir. Üç modül birlikte kullanıldığında KITTI'de taban YOLO11n'e göre F1'de 2,19 yüzde puanı, mAP50'de 2,26 yüzde puanı ve mAP50-95'te 2,10 yüzde puanı artış elde edilirken GFLOPs yaklaşık %22,22 azaltılmıştır. Böylece doğruluk artışı hesaplama maliyetinin artırılmasıyla değil, aynı anda daha düşük hesaplama yüküyle elde edilmiştir.
SODA10M ve FLIR sonuçları da farklı görüntü dağılımlarında performansın korunabildiğini desteklemektedir. SODA10M'de UGV-Net'in F1 skoru %58,10, mAP50 değeri %58,48 ve mAP50-95 değeri %39,37; FLIR'in çalışmada kullanılan RGB görüntülerinde ise sırasıyla %74,23, %78,36 ve %39,82'dir. Ancak bu veri kümeleri de eğitim/doğrulama/test bölünmesine tabi tutulduğu için sonuçlar, eğitim görmemiş yeni bir alanda doğrudan zero-shot genelleme kanıtı değildir.
Türkiye açısından anlamı: Çalışmanın yöntemi; kampüs içi mobil robotlar, lojistik robotları, fabrika dış saha araçları, tarımsal mobil platformlar veya başka UGV türleri için düşük güçlü uç donanım üzerinde yaya ve araç algılamasının nasıl hafifletilebileceğine dair uygulanabilir bir araştırma yaklaşımı sunmaktadır. Ancak KITTI, SODA10M ve FLIR'deki başarı oranlarının Türkiye'deki farklı yol geometrileri, kamera sistemleri, hava koşulları, yaya davranışları veya UGV sensör yerleşimlerinde aynen korunacağı çıkarılamaz. Böyle bir uygulamada yerel veriyle yeniden eğitim ve gerçek araç üzerinde saha doğrulaması gerekir.
Araştırmanın temel problemi nedir?
UGV algı sisteminin temel görevi çevresindeki dinamik engelleri yeterince hızlı ve doğru biçimde tespit ederek sonraki karar verme ve yol planlama katmanlarına güvenilir bilgi sağlamaktır. Araştırmacılar özellikle üç zor koşula odaklanmaktadır: uzaktaki küçük hedefler, kısmi örtülme ve karmaşık arka plan.
Hafif nesne tespit modelleri uç cihazlarda hızlı çalışabilse de ağ kapasitesinin azaltılması küçük nesnelerin ince kenar ve doku özelliklerini kaybetme riskini artırabilir. Daha ağır modeller ise yüksek doğruluk sağlasa bile UGV üzerindeki sınırlı işlemci/GPU gücü ve enerji bütçesi nedeniyle gerçek zamanlı kullanım için uygun olmayabilir. Çalışmadaki tasarım problemi bu doğruluk–verimlilik dengesidir.
UGV-Net hangi modelden geliştirildi?
UGV-Net'in taban mimarisi YOLO11n'dir. YOLO11n; backbone, neck ve detection head olmak üzere üç temel bölümden oluşmaktadır. Backbone görüntüden çok seviyeli özellikleri çıkarır; neck, yüksek düzey semantik bilgi ile yüksek çözünürlüklü konumsal ayrıntıları birleştirir; detection head ise farklı ölçeklerde sınıflandırma ve konum tahmini üretir.
Araştırmacılar YOLO11n'i tamamen yeniden tasarlamak yerine üç noktayı değiştirmiştir:
- C3k2_PS: backbone içindeki özellik çıkarımını ve kanal-bağlam etkileşimini geliştirmek,
- Dysample: neck bölümündeki üst örneklemede küçük hedef ayrıntılarını ve uzamsal hizalamayı korumak,
- LSDECD: detection head hesaplama tekrarını azaltırken kenar ve doku gibi ayrıntıları korumak.
C3k2_PS modülü neyi değiştiriyor?
YOLO11n'deki C3k2 yapısında özellik çıkarımı ağırlıklı olarak yerel evrişimlerle gerçekleştirilir. Araştırmacılar bunun karmaşık arka planda veya örtülmüş hedeflerde uzak bölgeler arasındaki ilişkiyi temsil etmekte sınırlı kalabileceğini savunmaktadır.
C3k2_PS içinde geleneksel Bottleneck yapısının yerini StarNet'ten alınan Star Block alır. Star Block iki dalda üretilen özelliklerin eleman bazında çarpımı üzerinden yüksek dereceli özellik etkileşimi üretir. Ardından PCSA — Progressive Channel-wise Self-Attention, kanallar arasındaki bağımlılıkları modelleyerek arka plan veya gereksiz kanalları baskılamayı ve hedefle ilgili semantik kanalları güçlendirmeyi amaçlar.
PCSA'ya girmeden önce özellik haritası:
\[ X_s \in \mathbb{R}^{B\times C\times H\times W} \]
biçimindedir. Burada \(B\) batch büyüklüğü, \(C\) kanal sayısı, \(H\) yükseklik ve \(W\) genişliktir. Uzamsal sıkıştırma:
\[ X_p = Pool_{(7,7)}^{(H,W)\rightarrow(H',W')}(X_s) \]
ile yapılır. Ardından sorgu, anahtar ve değer temsilleri:
\[ Q=F_{\mathrm{proj}}^{Q}(X_p),\quad K=F_{\mathrm{proj}}^{K}(X_p),\quad V=F_{\mathrm{proj}}^{V}(X_p) \]
olarak elde edilir.
Kanal boyutundaki tek başlı öz-dikkat işlemi:
\[ X_{\mathrm{attn}} = Softmax\left(\frac{QK^T}{\sqrt{C}}\right)V \]
ile tanımlanır. Son aşamada sigmoid ile oluşturulan kanal ağırlıkları giriş özelliklerine uygulanır. Araştırmadaki amaç, Star Block sonrasında güçlenen ancak arka plan gürültüsünü de içerebilen özelliklerden hedefle ilişkili kanalları seçici biçimde öne çıkarmaktır.
Ablasyonda C3k2_PS tek başına ne yaptı?
C3k2_PS tek başına eklendiğinde büyük bir performans sıçraması oluşmamıştır. Taban YOLO11n'in F1 değeri %83,44 iken yalnız C3k2_PS kullanımında %83,35 olmuştur. Buna karşılık mAP50 %87,18'den %87,32'ye ve mAP50-95 %63,97'den %64,05'e yükselmiştir. Bu sonuç modülün tek başına sınırlı kazanç sağladığını, asıl etkinliğin diğer iki modülle birlikte ortaya çıktığını göstermektedir.
Çalışmada farklı dikkat mekanizmaları da Star yapısı üzerinde karşılaştırılmıştır. PCSA kullanılan nihai yapı; CA, CBAM, EMA ve C2PSA seçeneklerine göre F1, mAP50 ve mAP50-95 birlikte değerlendirildiğinde en yüksek sonuçları vermiştir: %85,63 F1, %89,44 mAP50 ve %66,07 mAP50-95.
Dysample neden kullanıldı?
YOLO11n'in varsayılan üst örnekleme işlemi nearest-neighbor interpolasyona dayanır. Bu yöntem hızlıdır ancak her konumu içerikten bağımsız biçimde büyüttüğü için küçük hedef kenarlarında ayrıntı kaybı ve çok ölçekli özelliklerin hizalanmasında hata oluşabilir.
Dysample, özellik haritasını sabit pikseller kümesi yerine örnekleme yapılabilen sürekli bir alan gibi ele alır. Düzenli örnekleme konumuna öğrenilen bir \(\Delta p\) ofseti eklenir:
\[ p' = p + \Delta p \]
Ardından yeni özellik değeri komşu örneklerden:
\[ Y(p) = \sum_{q\in N(p')} w_qX(q) \]
ifadesiyle yeniden örneklenir. \(N(p')\), yeni örnekleme konumunun çevresindeki noktaları; \(w_q\) ise interpolasyon ağırlıklarını temsil eder.
Böylece ağ, nesne sınırı veya yerel yapıya göre örnekleme konumunu değiştirebilir. Çalışmanın ablasyon sonuçlarında üç iyileştirme arasında tek başına en belirgin doğruluk katkılarından biri Dysample'dan gelmiştir: yalnız Dysample kullanılan modelde F1 %84,75, mAP50 %88,29 ve mAP50-95 %65,42'ye ulaşmıştır.
LSDECD algılama başlığı nasıl hafifliyor?
Standart YOLO algılama başlığında farklı ölçeklerdeki özellik haritaları için sınıflandırma ve kutu regresyon dalları ayrı işlemler gerçekleştirir. Bu yapı yüksek temsil kapasitesi sağlasa da benzer konvolüsyonların farklı ölçeklerde tekrarlanması hesaplama maliyetini artırır.
LSDECD'nin dayandığı LSCD yaklaşımı, bazı konvolüsyon ağırlıklarını ölçekler arasında paylaşarak bu tekrarı azaltır. Araştırmacılar bunun ince ayrıntıların aşırı yumuşamasına yol açabileceğini belirterek standart hafif konvolüsyonun yerine Detail Enhancement Convolution (DEConv) eklemiştir.
DEConv; standart konvolüsyon yanıtına merkezi, açısal, yatay ve dikey fark bileşenlerini ekler:
\[ Y_{\mathrm{VC}} = Conv(X) \]
\[ Y_{\mathrm{CDC}}(i,j)=X(i,j)-X(i+1,j+1) \]
\[ Y_{\mathrm{ADC}}(i,j)=X(i,j)-X(i+1,j-1) \]
\[ Y_{\mathrm{HDC}}(i,j)=X(i,j)-X(i,j+1) \]
\[ Y_{\mathrm{VDC}}(i,j)=X(i,j)-X(i+1,j) \]
ve toplam çıktı:
\[ Y = Y_{\mathrm{VC}} + Y_{\mathrm{CDC}} + Y_{\mathrm{ADC}} + Y_{\mathrm{HDC}} + Y_{\mathrm{VDC}} \]
olarak oluşturulur. Amaç yatay, dikey ve çapraz kenar/doku farklılıklarını daha görünür hâle getirmektir. Çalışmada ayrıca bu çok dallı yapıların çıkarım aşamasında eşdeğer tek bir konvolüsyona yeniden parametrize edilebildiği, dolayısıyla eğitimdeki ayrıntı çıkarımının çalışma anında aynı ölçüde ek dallı hesaplama gerektirmediği belirtilmektedir.
LSDECD tek başına doğruluğu artırdı mı?
Her metrikte değil. Yalnız LSDECD eklendiğinde GFLOPs 6,3'ten 4,8'e ve parametre sayısı 2,58 milyondan 2,46 milyona düşmüştür. Buna karşılık mAP50 %87,27 ile tabana yakın kalırken mAP50-95 %63,87'ye hafifçe gerilemiştir.
Bu sonuç önemli bir tasarım ayrıntısıdır: LSDECD'nin temel rolü tek başına büyük doğruluk artışı sağlamak değil, algılama başlığındaki hesaplama tekrarını azaltmaktır. En yüksek performans C3k2_PS ve Dysample ile birlikte kullanıldığında ortaya çıkmıştır.
Üç modül birlikte kullanıldığında ne oldu?
Nihai UGV-Net, üç değişikliği birlikte kullanmaktadır. KITTI ablasyonundaki temel sonuçlar şöyledir:
| Metrik | YOLO11n | UGV-Net | Kaynakta bildirilen fark |
|---|---|---|---|
| Precision | %90,33 | %91,80 | +1,47 yüzde puanı |
| Recall | %78,14 | %80,95 | +2,81 yüzde puanı |
| F1 | %83,44 | %85,63 | +2,19 yüzde puanı |
| mAP50 | %87,18 | %89,44 | +2,26 yüzde puanı |
| mAP50-95 | %63,97 | %66,07 ± 0,02 | +2,10 yüzde puanı |
| GFLOPs | 6,3 | 4,9 | %22,22 azalma |
| Parametre | 2,58 M | 2,41 M | Kaynakta yaklaşık %6,5 azalma |
F1, mAP ve diğer ölçütler neyi ifade ediyor?
Precision, model tarafından hedef olarak işaretlenen kutuların ne kadarının gerçek hedef olduğunu ölçer. Recall ise gerçek hedeflerin ne kadarının tespit edilebildiğini gösterir. İki değerin harmonik ortalaması olan F1:
\[ F1 = 2\times \frac{Precision\times Recall} {Precision+Recall} \]
ile hesaplanır.
Bir sınıf için Average Precision (AP), precision–recall eğrisinin altında kalan alan üzerinden:
\[ AP = \int_{0}^{1} Precision(r)\,dr \]
şeklinde tanımlanmıştır. N sınıfın AP değerinin ortalaması:
\[ mAP = \frac{1}{N}\sum_{i=1}^{N}AP_i \]
olarak hesaplanır. mAP50, IoU eşiği 0,50 için; mAP50-95 ise farklı IoU eşiklerinde daha sıkı konum doğruluğunu da hesaba katan ölçüttür.
Hangi veri kümesi ana deney için kullanıldı?
Ana eğitim ve karşılaştırma veri kümesi KITTI'dir. Çalışmada KITTI'nin resmî eğitim bölümündeki toplam 7481 görüntü önce karıştırılmış ve 7:2:1 oranında ayrılmıştır:
| Bölüm | Görüntü sayısı |
|---|---|
| Eğitim | 5237 |
| Doğrulama | 1496 |
| Test | 748 |
KITTI'de Car, Van, Truck, Pedestrian, Person_sitting, Cyclist, Tram ve Misc sınıfları kullanılmaktadır. Çalışmadaki etiket istatistikleri Car sınıfının açık ara en fazla örneğe sahip olduğunu, Pedestrian ve Van sınıflarının onu izlediğini göstermektedir.
Bounding-box boyut dağılımının düşük normalize genişlik ve yükseklik değerlerinde yoğunlaşması, veri kümesindeki çok sayıda hedefin görüntü içinde küçük alan kapladığını göstermektedir. Nesne merkezleri de ağırlıklı olarak görüntünün orta ve alt-orta kısmında, yani aracın ileri görüş alanında toplanmaktadır.
Model hangi koşullarda eğitildi?
| Eğitim parametresi | Çalışmadaki değer |
|---|---|
| İşletim sistemi | Windows 11 |
| CPU | Intel Core Ultra 7-265K |
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 GB |
| RAM | 32 GB |
| Python | 3.9 |
| PyTorch | 2.7.0 |
| CUDA | 12.8 |
| Girdi boyutu | 640 × 640 |
| Learning rate | 0,01 |
| Optimizer | SGD |
| Momentum | 0,937 |
| Batch size | 32 |
| Epoch | 300 |
| Weight decay | 0,0005 |
| Thread sayısı | 8 |
Farklı nesne tespit modellerine karşı sonuç neydi?
Araştırmacılar Faster R-CNN, SSD, RT-DETR, YOLOv5n, YOLOv8n, YOLO11n, YOLOv12n, YOLOv13n, LP-YOLO ve PV-YOLO'yu aynı deney düzeninde UGV-Net ile karşılaştırmıştır. KITTI sonuçlarında UGV-Net, raporlanan modeller arasında F1, mAP50 ve mAP50-95 metriklerinin üçünü birlikte en yüksek düzeyde veren model olmuştur.
| Model | F1 | mAP50 | mAP50-95 | GFLOPs | Parametre |
|---|---|---|---|---|---|
| YOLOv8n | %83,16 | %86,75 | %63,76 | 8,9 | 2,69 M |
| YOLO11n | %83,44 | %87,18 | %63,97 | 6,3 | 2,58 M |
| YOLOv13n | %85,15 | %88,02 | %64,89 | 6,1 | 2,50 M |
| LP-YOLO | %82,79 | %86,75 | %62,34 | 5,5 | 1,88 M |
| PV-YOLO | %80,71 | %85,66 | %61,05 | 6,3 | 1,46 M |
| UGV-Net | %85,63 | %89,44 | %66,07 | 4,9 | 2,41 M |
UGV-Net'in en az parametreye sahip model olduğu sonucu çıkarılamaz; örneğin PV-YOLO 1,46 M ve LP-YOLO 1,88 M parametreye sahiptir. Çalışmanın UGV-Net için gösterdiği avantaj, daha düşük parametreli bütün modelleri geçmek değil, kendi deney düzeninde doğruluk ve hesaplama yükü arasında daha iyi bir birlikte performans sağlamasıdır.
Görsel tespit karşılaştırmaları ne gösterdi?
Çalışmadaki tespit görsellerinde büyük Van gibi belirgin nesnelerde YOLO11n, YOLOv13n ve UGV-Net arasında büyük fark görülmemiştir. Fark özellikle uzaktaki küçük Pedestrian ve Cyclist hedeflerinde ve kısmen örtülü Person_sitting hedefinde ortaya çıkmaktadır.
Bir diğer örnekte YOLO11n ve YOLOv13n'in yol kenarındaki ince, yüksek kontrastlı bir direği “Pedestrian” olarak yanlış sınıflandırdığı; UGV-Net'in aynı bölgede bu yanlış pozitif yanıtı üretmediği gösterilmiştir. Bu tekil görseller bütün olası açık ortamlar için hata oranı kanıtı değildir, ancak nicel test sonuçlarıyla birlikte modelin arka plan bastırma davranışını görsel olarak desteklemektedir.
Isı haritaları modelin neye baktığını gösteriyor?
Grad-CAM benzeri ısı haritası karşılaştırmalarında YOLOv8n, YOLO11n ve YOLOv13n yanıtlarının büyük nesne yüzeylerine veya yüksek kontrastlı arka plan bölgelerine daha fazla yayılabildiği görülmektedir. UGV-Net'te yüksek yanıt bölgeleri hedef gövdesi ve hedefin yapısal bölgelerinde daha yoğun görünmektedir.
Uzak Pedestrian ve Cyclist hedeflerinde UGV-Net'in ısı haritası aktivasyonu diğer bazı modellerden daha belirgin kalmıştır. Direğin yanlış yaya olarak algılandığı örnekte ise UGV-Net'in direk çevresindeki aktivasyonu zayıf, gerçek yaya ve uzaktaki araç çevresindeki aktivasyonu daha yoğun görünmektedir. Bu görseller performans mekanizmasını tek başına kanıtlamaz; çalışmadaki tespit ve ablasyon sonuçlarını açıklamaya yönelik nitel destek sunar.
SODA10M sonuçları neydi?
| Model | Precision | Recall | F1 | mAP50 | mAP50-95 |
|---|---|---|---|---|---|
| YOLOv8n | %66,16 | %51,02 | %56,98 | %57,01 | %38,27 |
| YOLO11n | %67,84 | %49,79 | %56,39 | %56,81 | %38,38 |
| YOLOv13n | %66,51 | %50,01 | %55,91 | %55,68 | %37,09 |
| UGV-Net | %65,84 | %53,58 | %58,10 | %58,48 | %39,37 |
SODA10M'de UGV-Net'in precision değeri YOLO11n'den düşük olsa da recall, F1, mAP50 ve mAP50-95 daha yüksektir. Dolayısıyla “bütün metriklerde en yüksek” gibi bir ifade doğru değildir. Çalışmanın ana kazancı kaçırılan hedefleri azaltan recall artışı ile genel F1/mAP performansında görülmektedir.
FLIR sonuçları neydi?
FLIR veri kümesi RGB ve termal görüntüler içerse de bu araştırmada yalnız RGB görüntüler eğitim ve değerlendirme için kullanılmıştır. Dolayısıyla sonuçlar termal görüntü algılama performansı olarak yorumlanmamalıdır.
| Model | Precision | Recall | F1 | mAP50 | mAP50-95 |
|---|---|---|---|---|---|
| YOLOv8n | %77,56 | %69,19 | %73,01 | %75,83 | %38,44 |
| YOLO11n | %79,52 | %67,35 | %72,82 | %75,97 | %39,16 |
| YOLOv13n | %77,82 | %66,32 | %71,52 | %74,84 | %37,89 |
| UGV-Net | %78,85 | %70,29 | %74,23 | %78,36 | %39,82 |
Burada da UGV-Net en yüksek precision'a sahip değildir; YOLO11n %79,52 precision ile UGV-Net'in %78,85 değerinin üzerindedir. Buna karşılık UGV-Net recall, F1, mAP50 ve mAP50-95 bakımından daha yüksek sonuç vermiştir.
“Genelleme” sonucunun sınırı nedir?
Çalışma SODA10M ve FLIR deneylerini generalization/cross-dataset değerlendirmesi olarak adlandırmaktadır. Bununla birlikte yöntem bölümünde iki veri kümesinin de 7:2:1 oranında eğitim, doğrulama ve test bölümlerine ayrıldığı açıkça yazmaktadır. Bu nedenle sonuçlar, yalnız KITTI üzerinde eğitilmiş tek bir modelin SODA10M veya FLIR üzerinde yeniden eğitim olmaksızın denenmesi şeklindeki zero-shot domain transfer deneyi değildir.
Daha güvenli bilimsel yorum, UGV-Net mimarisinin üç farklı veri kümesi üzerinde ayrı eğitim/değerlendirme düzenlerinde tutarlı avantaj gösterdiği yönündedir. Bu, mimarinin veri kümesine özel tek bir sonuçtan ibaret olmadığını destekler; fakat tamamen görülmemiş bir alan üzerindeki aktarım performansını tek başına kanıtlamaz.
Jetson Orin Nano'ya nasıl aktarıldı?
Eğitilmiş PyTorch modeli önce ONNX formatına dışa aktarılmış, ardından Jetson Orin Nano üzerinde TensorRT motoruna dönüştürülmüştür. Cihaz üzerindeki çıkarım ayarları:
| Dağıtım parametresi | Değer |
|---|---|
| Çıkarım motoru | TensorRT |
| Girdi boyutu | 640 × 640 |
| Çıkarım hassasiyeti | FP16 |
| Batch size | 1 |
Video kareleri yeniden boyutlandırılıp normalize edildikten sonra TensorRT motoruna verilmiş ve algılama sonuçları cihaz üzerinde üretilmiştir.
Jetson Orin Nano'da ne kadar hızlı çalıştı?
| Model | Ortalama FPS | Gecikme | Bellek kullanımı | Ek güç |
|---|---|---|---|---|
| YOLOv8n | 22,3 FPS | 44,84 ms | 2,9 GB | 1,4 W |
| YOLO11n | 25,8 FPS | 38,76 ms | 3,0 GB | 1,3 W |
| UGV-Net | 27,9 FPS | 35,84 ms | 2,9 GB | 1,2 W |
UGV-Net bu üç model arasında en yüksek ortalama FPS, en düşük gecikme ve en düşük raporlanan ek güç değerini vermiştir. Bellek kullanımı YOLOv8n ile aynı, YOLO11n'den 0,1 GB daha düşüktür.
Çalışmada anlık FPS'nin kare karmaşıklığı, donanım yükü ve önbellek durumu nedeniyle değişebildiği; bu nedenle ana hız ölçütü olarak ortalama FPS'nin kullanıldığı belirtilmektedir:
\[ FPS_i=\frac{1}{t_i} \]
ve bütün video için:
\[ FPS_{\mathrm{avg}}=\frac{N}{T} \]
Burada \(t_i\) tek karenin toplam işlem süresi, \(N\) video kare sayısı ve \(T\) bütün karelerin işlenmesi için geçen toplam süredir.
Jetson testi gerçek UGV saha doğrulaması anlamına geliyor mu?
Hayır. Çalışma UGV-Net'in kaynak kısıtlı bir uç donanımda gerçek zamanlı çıkarım yapabildiğini göstermektedir; ancak yayımlanan deney, robotun gerçek açık ortamda otonom sürüş sırasında uzun süreli algılama, karar verme, frenleme veya yol planlama döngüsünü uçtan uca doğrulayan bir saha testi değildir.
Bu ayrım önemlidir. 27,9 FPS sonucu modelin Jetson Orin Nano üzerindeki çıkarım hızını destekler; UGV'nin gerçek dünya güvenliğinin veya bütün trafik senaryolarında yeterli tepki süresinin kanıtı değildir.
Çalışmanın güçlü yönleri nelerdir?
- Aynı anda doğruluk, GFLOPs ve parametre sayısını değerlendiren açık bir hafiflik–performans analizi yapılmıştır.
- Üç mimari değişiklik ayrı ve kombinasyonlu ablasyonlarla test edilmiştir.
- C3k2 varyantları ve farklı detection head tasarımları ayrıca karşılaştırılmıştır.
- Ana KITTI karşılaştırmasına ek olarak SODA10M ve FLIR üzerinde ek veri kümesi deneyleri yapılmıştır.
- Nicel sonuçların yanında tespit görselleri ve ısı haritalarıyla küçük nesne, örtülme ve yanlış pozitif davranışı incelenmiştir.
- Model yalnız masaüstü GPU'da değil, Jetson Orin Nano üzerinde TensorRT/FP16 çıkarımla da denenmiştir.
Çalışmanın başlıca sınırlılıkları nelerdir?
Birincisi, SODA10M ve FLIR deneyleri veri kümelerinin kendi eğitim bölümlerini kullanmaktadır. Bu nedenle bunları bütünüyle “görülmemiş veri alanına zero-shot genelleme” olarak yorumlamak doğru olmaz.
İkincisi, FLIR deneyinde termal kanal kullanılmamıştır; yalnız RGB görüntüler değerlendirilmiştir. Bu çalışma UGV-Net'in termal algılama performansını göstermemektedir.
Üçüncüsü, Jetson Orin Nano testi uç donanım performansını doğrular ancak tam bir saha UGV deneyi değildir. Araştırmada gerçek UGV'nin uzun süreli sürüşü, yol planlama ile entegrasyon, acil durma davranışı veya güvenlik sertifikasyonu incelenmemiştir.
Dördüncüsü, araştırmacılar aşırı aydınlatma değişimi, yağmur, sis ve gece düşük görüş koşullarını mevcut model için gelecekte geliştirilmesi gereken alanlar olarak açıkça belirtmektedir. Dolayısıyla mevcut sonuçların bu koşullarda aynı düzeyde korunacağı varsayılamaz.
Beşincisi, çalışma görüntü tabanlı algılamaya odaklanmaktadır. LiDAR, radar, termal kamera veya başka sensörlerin ortak kullanımı mevcut UGV-Net deneylerinin kapsamında değildir; çoklu sensör füzyonu gelecek çalışma olarak bırakılmıştır.
Çalışmanın söylediği nedir?
Çalışma, YOLO11n üzerine C3k2_PS, Dysample ve LSDECD modüllerinin birlikte eklenmesinin incelenen veri kümeleri ve deney koşullarında daha yüksek F1/mAP sonuçları ile daha düşük hesaplama maliyetini aynı modelde sağlayabildiğini; ayrıca bu modelin Jetson Orin Nano üzerinde yaklaşık 28 FPS seviyesinde çalışabildiğini göstermektedir.
Çalışmanın söylemediği nedir?
UGV-Net'in bütün açık ortamlar, bütün hava koşulları veya bütün UGV platformları için güvenli ve hatasız algılama sağladığı gösterilmemiştir. Model, gerçek araç güvenlik sistemi sertifikasyonu değildir; bütün küçük nesneleri algıladığı veya yanlış pozitif üretmediği sonucu çıkarılamaz. SODA10M ve FLIR sonuçları da tamamen yeniden eğitim gerektirmeyen bir domain-transfer kanıtı değildir.
Çalışmanın Yöntemi ve Bulguları
Ağ mimarisinin teknik özeti
| UGV-Net bileşeni | Temel teknik işlev | Hedeflenen problem |
|---|---|---|
| C3k2_PS | Star Block ile yüksek dereceli özellik etkileşimi ve PCSA ile kanal bağımlılıklarının yeniden ağırlıklandırılması | Karmaşık arka plan, örtülme, küçük hedef özelliklerinin zayıflaması |
| Dysample | Öğrenilen ofsetlerle içerik duyarlı örnekleme | Üst örneklemede ayrıntı kaybı ve uzamsal hizalama hatası |
| LSDECD | Ölçekler arası paylaşımlı konvolüsyon ve DEConv ayrıntı güçlendirmesi | Algılama başlığında hesaplama tekrarı ve ince ayrıntı kaybı |
Ablasyon deneyinin tamamı
| Yapı | Precision | Recall | F1 | mAP50 | mAP50-95 | GFLOPs | Params |
|---|---|---|---|---|---|---|---|
| YOLO11n | %90,33 | %78,14 | %83,44 | %87,18 | %63,97 | 6,3 | 2,58 M |
| C3k2_PS | %90,68 | %77,94 | %83,35 | %87,32 | %64,05 | 6,4 | 2,52 M |
| Dysample | %87,77 | %82,35 | %84,75 | %88,29 | %65,42 | 6,3 | 2,60 M |
| LSDECD | %87,05 | %81,01 | %83,76 | %87,27 | %63,87 | 4,8 | 2,46 M |
| C3k2_PS + Dysample | %89,46 | %80,74 | %84,65 | %88,16 | %65,84 | 6,4 | 2,53 M |
| C3k2_PS + LSDECD | %87,91 | %80,66 | %83,86 | %88,30 | %64,16 | 4,9 | 2,39 M |
| Dysample + LSDECD | %84,68 | %82,52 | %83,25 | %87,87 | %64,24 | 4,8 | 2,47 M |
| C3k2_PS + Dysample + LSDECD | %91,80 | %80,95 | %85,63 | %89,44 | %66,07 ± 0,02 | 4,9 | 2,41 M |
Ablasyon sonuçları modüllerin katkılarının doğrusal biçimde toplanmadığını göstermektedir. Örneğin Dysample tek başına recall'ı %82,35'e çıkarırken nihai UGV-Net'in recall'ı %80,95'tir; buna rağmen nihai model daha yüksek precision, F1 ve mAP sağlamaktadır. Araştırmacılar bunu özellik temsili, çok ölçekli füzyon ve hafif algılama başlığı arasındaki etkileşimle açıklamaktadır.
Algılama başlığı karşılaştırması
| Detection head | F1 | mAP50 | mAP50-95 | GFLOPs | Parametre |
|---|---|---|---|---|---|
| Base | %84,65 | %88,16 | %65,84 | 6,4 | 2,53 M |
| Efficient | %84,68 | %87,29 | %64,66 | 5,2 | 2,27 M |
| LSCD | %85,37 | %88,76 | %64,75 | 5,7 | 2,37 M |
| LSDECD | %85,63 | %89,44 | %66,07 | 4,9 | 2,41 M |
Efficient head en düşük parametre sayısını sağlamış ancak doğruluk kaybı oluşturmuştur. LSCD F1 ve mAP50'yi yükseltmiş fakat mAP50-95 değerinde gerilemiştir. LSDECD ise bu deneyde hem en düşük GFLOPs değerini hem de en yüksek üç ana doğruluk metriğini birlikte sağlamıştır.
Uç cihaz deneyinin teknik sınırı
Jetson Orin Nano sonuçları TensorRT, FP16, 640 × 640 girdi ve batch 1 koşullarında elde edilmiştir. Başka TensorRT sürümleri, güç modları, kamera işleme boru hatları veya eş zamanlı robotik yazılım yükleri altında aynı FPS'nin korunacağı kaynak çalışma tarafından test edilmemiştir.
Tablo 9'daki “Additional Power” değeri cihazın toplam elektrik tüketimi değildir; model çalıştırma sırasında raporlanan ek güç ölçütüdür. Bu nedenle 1,2 W değeri Jetson Orin Nano sisteminin toplam güç gereksinimi olarak yorumlanmamalıdır.
Genel sonuç
Araştırmanın kendi deney düzeninde UGV-Net, YOLO11n tabanına göre daha yüksek F1 ve mAP sonuçları elde ederken GFLOPs ve parametre sayısını azaltmış ve Jetson Orin Nano'da daha yüksek ortalama FPS sağlamıştır. Çalışmanın en önemli teknik sonucu, küçük ve örtülü nesne temsilini güçlendirmeye yönelik özellik çıkarımı ve dinamik üst örnekleme değişikliklerinin, hafif bir algılama başlığıyla birlikte kullanılmasının doğruluk–hesaplama dengesi açısından faydalı olabildiğidir.
Bulguların uygulama değeri özellikle düşük hesaplama bütçeli mobil algı sistemleri açısından önemlidir; ancak tam UGV operasyon güvenliği için gerçek saha koşulları, kötü hava ve düşük ışık, farklı kamera/sensör sistemleri ve algılama sonrası karar verme zinciri ayrıca doğrulanmalıdır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: A Method for Lightweight Pedestrian and Vehicle Detection for Unmanned Ground Vehicles in Open Environments
Yazarlar, kaynak sırasıyla: Xulong Zhang; Hong Jiang; Dong Han; Hai Guo; Xiangfeng Zhang; Kaige Sun.
Eş katkı/eş birinci yazar: Kaynakta eş katkı veya eş birinci yazarlık bildirimi bulunmamaktadır.
Sorumlu yazar: Hong Jiang.
Kurumlar: School of Mechanical Engineering, Xinjiang University, Urumqi, Çin; Xinjiang Academy of Building Research Co., Ltd., Urumqi, Çin; School of Mechanical Engineering, Zhejiang University, Hangzhou, Çin.
Dergi: Machines.
Yayınevi: MDPI, Basel, Switzerland.
Yayın kimliği: Machines 2026, 14(5), 527.
DOI: 10.3390/machines14050527.
Resmî yayın bağlantısı:https://doi.org/10.3390/machines14050527
Alınma / revizyon / kabul / yayın: 24 Mart 2026 / 30 Nisan 2026 / 5 Mayıs 2026 / 8 Mayıs 2026.
Kaynak türü ve hakemlik durumu: Machines dergisinde yayımlanmış hakemli araştırma makalesi.
Lisans: Creative Commons Attribution (CC BY); telif hakkı © 2026 yazarlara aittir.
Finansman: Çalışma Tianshan Talent Program: Youth Support Talent Project tarafından 2024TSYCQNTJ0020 numaralı destekle ve China State Construction Engineering Corporation Technology R&D Projects tarafından CSCEC-2025-Z-27 numaralı destekle finanse edilmiştir.
Veri erişilebilirliği: Çalışmada kullanılan verilerin sorumlu yazarla iletişime geçilmesi hâlinde talep üzerine sağlanabileceği belirtilmektedir.
Çıkar çatışması: Xulong Zhang ve Hai Guo'nun Xinjiang Academy of Building Research Co., Ltd. bünyesinde çalıştığı belirtilmiştir. Diğer yazarlar araştırmayı etkileyebilecek ticari veya mali ilişki bulunmadığını beyan etmektedir.
Yazar katkıları: Kavramsallaştırma Xulong Zhang ve Hong Jiang; metodoloji ve biçimsel analiz Xulong Zhang; yazılım Kaige Sun; doğrulama Xulong Zhang, Hong Jiang ve Xiangfeng Zhang; araştırma Xulong Zhang ve Dong Han; kaynaklar Dong Han; veri düzenleme Kaige Sun ve Dong Han; ilk taslak Xulong Zhang; inceleme ve düzenleme Hong Jiang, Dong Han ve Xiangfeng Zhang; görselleştirme Xulong Zhang; danışmanlık Hong Jiang; proje yönetimi ve finansman edinimi Hai Guo tarafından yürütülmüştür.
Veri kümesi notu: Ana deney KITTI üzerinde yapılmıştır. KITTI'nin 7481 görüntülük eğitim kümesi 5237 eğitim, 1496 doğrulama ve 748 test görüntüsü olarak 7:2:1 oranında bölünmüştür. SODA10M ve FLIR de 7:2:1 oranında eğitim, doğrulama ve test bölümlerine ayrılmıştır. FLIR deneylerinde yalnız RGB görüntüler kullanılmıştır.
“Genelleme” yorum sınırı: Kaynak, SODA10M ve FLIR deneylerini generalization/cross-dataset testleri olarak adlandırmaktadır; ancak bu veri kümelerinin kendi eğitim bölümleri kullanıldığından sonuçlar zero-shot domain transfer olarak değerlendirilmemelidir. Bu Verianla aktarımında kaynak terminolojisi korunmuş, fakat deney düzeninin gerçek kapsamı ayrıca açıklanmıştır.
Uç cihaz doğrulama sınırı: Jetson Orin Nano deneyi modelin TensorRT/FP16 koşullarında uç cihazda çalıştırılabilirliğini ve video çıkarım hızını göstermektedir. Çalışma, UGV'nin gerçek açık sahada uzun süreli otonom sürüş güvenliği, algılama–planlama–kontrol entegrasyonu veya sertifikasyon düzeyinde güvenilirlik doğrulaması değildir.
Gelecek çalışma sınırları: Araştırmacılar aşırı aydınlatma değişimleri, yağmur, sis, düşük gece görüşü ve çoklu sensör füzyonunu gelecekte geliştirilmesi gereken başlıklar arasında göstermektedir.
İçeriğin hazırlanma yöntemi: Bu Verianla içeriğinin bilimsel bölümü yüklenen çalışmanın metnine, denklemlerine, tablolarına, ağ mimarisi şekillerine, ablasyon deneylerine, tespit görsellerine, ısı haritalarına ve Jetson Orin Nano sonuçlarına dayanmaktadır. Dış kaynaklardan yeni deneysel sonuç, yeni performans değeri veya ek mekanizma eklenmemiştir. Dış doğrulama yalnızca bibliyografik yayın kimliğinin kontrolü için kullanılmıştır. Inline SVG'ler kaynakta raporlanan kesin tablo verilerinden yeniden çizilmiş veya çalışmanın yöntemine dayanarak hazırlanmış açıklayıcı özgün şemalardır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir