

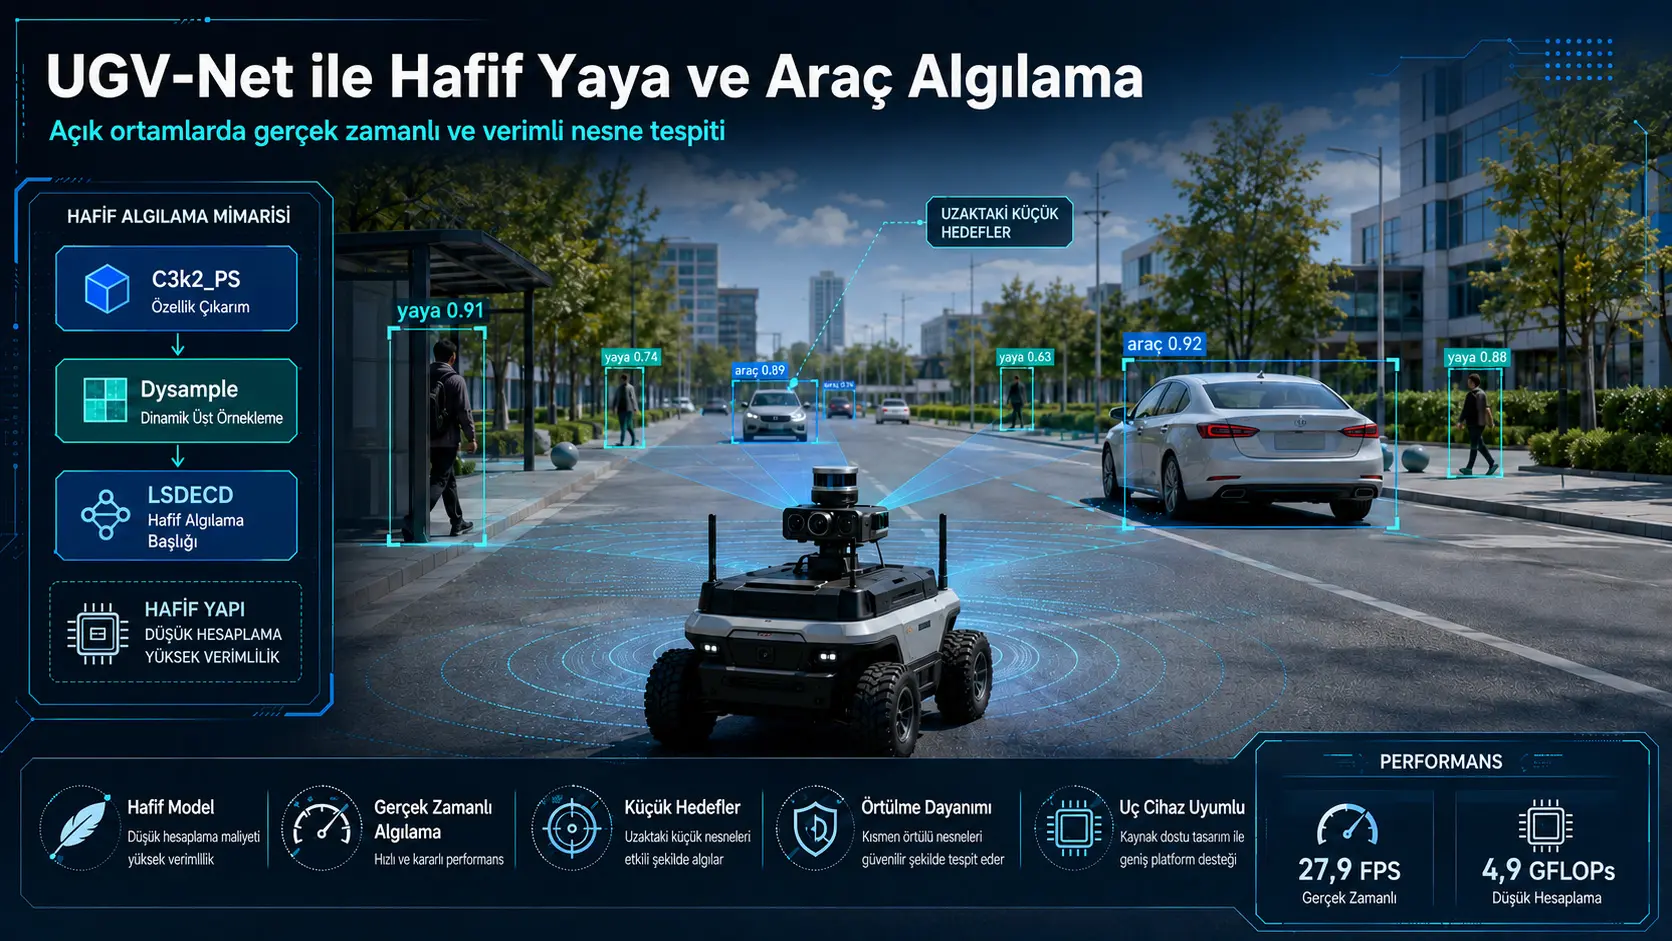
Utafiti huu unatengeneza UGV-Net, modeli nyepesi ya utambuzi wa vitu inayotegemea YOLO11n, ili magari ya ardhini yasiyo na dereva (Unmanned Ground Vehicles, UGV) yanayofanya kazi katika mazingira ya wazi na tata yaweze kutambua watembea kwa miguu na magari kwa wakati halisi. Modeli ina marekebisho matatu makuu: C3k2_PS, inayolenga kuimarisha uwakilishi wa vipengele na matumizi ya muktadha wa kimataifa; Dysample, mbinu ya kuongeza sampuli kwa nguvu inayojali maudhui ili kupunguza upotevu wa maelezo katika vitu vidogo; na LSDECD, inayolenga kupunguza urudiaji wa hesabu katika kichwa cha utambuzi huku ikihifadhi uwakilishi wa maelezo. Katika majaribio ya KITTI, ikilinganishwa na msingi wa YOLO11n, alama ya F1 iliongezeka kutoka %83,44 hadi %85,63, mAP50 kutoka %87,18 hadi %89,44 na mAP50-95 kutoka %63,97 hadi %66,07, huku gharama ya hesabu ikipungua kutoka 6,3 GFLOPs hadi 4,9 GFLOPs na idadi ya vigezo kutoka milioni 2,58 hadi milioni 2,41. Kwenye Jetson Orin Nano, UGV-Net ilitoa wastani wa 27,9 FPS na ucheleweshaji wa 35,84 ms. Hata hivyo, matokeo haya si uthibitisho kamili wa uendeshaji halisi wa UGV shambani au wa hali zote za hali ya hewa/mwangaza; watafiti wanataja mabadiliko makali ya mwanga, mvua, ukungu, mwonekano mdogo wa usiku na muunganisho wa vihisi vingi kama maeneo ya kazi za baadaye.
Tatizo kuu la utafiti ni kuhifadhi usahihi na ufanisi wa kihesabu kwa wakati mmoja. Katika picha za barabara za wazi, vitu vidogo vilivyo mbali huchukua pikseli chache, watembea kwa miguu au magari yanaweza kufunikwa kwa sehemu, na miundo ya mandharinyuma yenye utofauti mkubwa kama nguzo, mimea au kingo za majengo inaweza kuongeza matokeo chanya ya uongo. Kwa upande mwingine, nguvu ya uchakataji, kumbukumbu na bajeti ya nishati ya vifaa vya pembeni vinavyotumiwa kwenye roboti za rununu ni ndogo. UGV-Net inalenga kushughulikia mahitaji haya mawili ndani ya usanifu mmoja.
Matokeo yenye nguvu zaidi ya kiasi katika utafiti si ongezeko la usahihi pekee. Moduli zote tatu zinapotumiwa pamoja, ikilinganishwa na YOLO11n msingi kwenye KITTI, ongezeko la pointi 2,19 za asilimia katika F1, pointi 2,26 za asilimia katika mAP50 na pointi 2,10 za asilimia katika mAP50-95 lilipatikana, huku GFLOPs ikipunguzwa kwa takribani %22,22. Hivyo ongezeko la usahihi lilipatikana si kwa kuongeza gharama ya hesabu, bali sambamba na mzigo mdogo wa kihesabu.
Matokeo ya SODA10M na FLIR pia yanaunga mkono kwamba utendaji unaweza kudumishwa katika usambazaji tofauti wa picha. Kwenye SODA10M, alama ya F1 ya UGV-Net ni %58,10, mAP50 ni %58,48 na mAP50-95 ni %39,37; katika picha za RGB za FLIR zilizotumiwa katika utafiti, ni %74,23, %78,36 na %39,82 mtawalia. Hata hivyo, kwa kuwa seti hizi za data pia ziligawanywa katika mafunzo/uthibitishaji/majaribio, matokeo haya si uthibitisho wa moja kwa moja wa generalization ya zero-shot katika eneo jipya ambalo halikufundishwa.
Kwa mtazamo wa Türkiye: Mbinu ya utafiti inatoa njia ya utafiti inayoweza kutumika kuhusu jinsi ya kufanya utambuzi wa watembea kwa miguu na magari kuwa mwepesi kwenye vifaa vya pembeni vyenye nguvu ndogo kwa roboti za rununu za ndani ya kampasi, roboti za vifaa, magari ya maeneo ya nje ya viwanda, majukwaa ya rununu ya kilimo au aina nyingine za UGV. Hata hivyo, haiwezi kuhitimishwa kwamba viwango vya mafanikio vya KITTI, SODA10M na FLIR vitadumishwa vilevile katika jiometri tofauti za barabara, mifumo ya kamera, hali za hewa, tabia za watembea kwa miguu au mipangilio ya vihisi vya UGV nchini Türkiye. Katika matumizi kama haya, mafunzo upya kwa data ya ndani na uthibitishaji wa shambani kwenye gari halisi vinahitajika.
Tatizo kuu la utafiti ni nini?
Kazi ya msingi ya mfumo wa utambuzi wa UGV ni kugundua vizuizi vinavyobadilika vinavyoizunguka kwa kasi na usahihi wa kutosha na kutoa taarifa za kuaminika kwa tabaka zinazofuata za kufanya maamuzi na kupanga njia. Watafiti wanazingatia hasa hali tatu ngumu: malengo madogo yaliyo mbali, kufunikwa kwa sehemu na mandharinyuma tata.
Modeli nyepesi za utambuzi wa vitu zinaweza kufanya kazi haraka kwenye vifaa vya pembeni, lakini kupunguza uwezo wa mtandao kunaweza kuongeza hatari ya kupoteza sifa nyembamba za kingo na muundo wa vitu vidogo. Modeli nzito zaidi zinaweza kutoa usahihi wa juu lakini zisiwe zinazofaa kwa matumizi ya wakati halisi kwa sababu ya uwezo mdogo wa CPU/GPU na bajeti ya nishati kwenye UGV. Tatizo la usanifu katika utafiti ni usawa huu wa usahihi–ufanisi.
UGV-Net ilitengenezwa kutoka modeli gani?
Usanifu msingi wa UGV-Net ni YOLO11n. YOLO11n ina sehemu tatu kuu: backbone, neck na detection head. Backbone huchota vipengele vya viwango vingi kutoka kwenye picha; neck huunganisha taarifa za semantiki za kiwango cha juu na maelezo ya nafasi yenye azimio kubwa; detection head hutoa utabiri wa uainishaji na nafasi katika mizani tofauti.
Badala ya kubuni upya YOLO11n kabisa, watafiti walibadilisha maeneo matatu:
- C3k2_PS: kuboresha uchotaji wa vipengele na mwingiliano wa kanal-muktadha ndani ya backbone,
- Dysample: kuhifadhi maelezo ya malengo madogo na upangaji wa nafasi wakati wa upsampling katika sehemu ya neck,
- LSDECD: kupunguza urudiaji wa hesabu wa detection head huku ikihifadhi maelezo kama kingo na muundo.
Moduli ya C3k2_PS inabadilisha nini?
Katika muundo wa C3k2 wa YOLO11n, uchotaji wa vipengele hufanywa kwa kiasi kikubwa kwa konvolusheni za ndani. Watafiti wanaona kwamba hii inaweza kuwa na kikomo katika kuwakilisha mahusiano kati ya maeneo ya mbali katika mandharinyuma tata au malengo yaliyofunikwa.
Ndani ya C3k2_PS, muundo wa kawaida wa Bottleneck unabadilishwa na Star Block kutoka StarNet. Star Block huzalisha mwingiliano wa vipengele wa daraja la juu kupitia kuzidisha kipengele kwa kipengele cha vipengele vilivyotolewa katika matawi mawili. Kisha PCSA — Progressive Channel-wise Self-Attention hulenga kukandamiza kanal za mandharinyuma au zisizo muhimu na kuimarisha kanal za semantiki zinazohusiana na lengo kwa kuunda utegemezi kati ya kanal.
Kabla ya kuingia PCSA, ramani ya vipengele iko katika umbo:
\[ X_s \in \mathbb{R}^{B\times C\times H\times W} \]
Hapa \(B\) ni ukubwa wa batch, \(C\) ni idadi ya kanal, \(H\) ni urefu na \(W\) ni upana. Ukandamizaji wa nafasi hufanywa kwa:
\[ X_p = Pool_{(7,7)}^{(H,W)\rightarrow(H',W')}(X_s) \]
. Kisha uwakilishi wa query, key na value hupatikana kama:
\[ Q=F_{\mathrm{proj}}^{Q}(X_p),\quad K=F_{\mathrm{proj}}^{K}(X_p),\quad V=F_{\mathrm{proj}}^{V}(X_p) \]
.
Operesheni ya self-attention yenye kichwa kimoja katika kipimo cha kanal inafafanuliwa kwa:
\[ X_{\mathrm{attn}} = Softmax\left(\frac{QK^T}{\sqrt{C}}\right)V \]
. Katika hatua ya mwisho, uzito wa kanal unaoundwa kwa sigmoid hutumika kwenye vipengele vya ingizo. Lengo katika utafiti ni kuimarisha kwa uteuzi kanal zinazohusiana na lengo kutoka kwenye vipengele vilivyoimarishwa baada ya Star Block lakini ambavyo vinaweza pia kuwa na kelele za mandharinyuma.
Katika ablation, C3k2_PS peke yake ilifanya nini?
Kuongeza C3k2_PS peke yake hakukusababisha mruko mkubwa wa utendaji. Thamani ya F1 ya YOLO11n msingi ilikuwa %83,44, huku matumizi ya C3k2_PS pekee yakitoa %83,35. Kwa upande mwingine, mAP50 iliongezeka kutoka %87,18 hadi %87,32 na mAP50-95 kutoka %63,97 hadi %64,05. Hii inaonyesha kuwa moduli peke yake hutoa faida ndogo na athari kuu hujitokeza inapounganishwa na moduli nyingine mbili.
Mbinu tofauti za attention pia zililinganishwa juu ya muundo wa Star. Muundo wa mwisho unaotumia PCSA ulitoa matokeo ya juu zaidi wakati F1, mAP50 na mAP50-95 zilizingatiwa kwa pamoja dhidi ya chaguo za CA, CBAM, EMA na C2PSA: %85,63 F1, %89,44 mAP50 na %66,07 mAP50-95.
Kwa nini Dysample ilitumika?
Operesheni chaguomsingi ya upsampling ya YOLO11n inategemea nearest-neighbor interpolation. Njia hii ni ya haraka, lakini kwa kuwa huongeza kila nafasi bila kujali maudhui, inaweza kusababisha kupotea kwa maelezo kwenye kingo za malengo madogo na hitilafu katika upangaji wa vipengele vya mizani mingi.
Dysample huichukulia ramani ya vipengele si kama seti thabiti ya pikseli bali kama uga endelevu ambao sampuli zinaweza kuchukuliwa. Offset iliyojifunza \(\Delta p\) huongezwa kwenye nafasi ya kawaida ya sampuli:
\[ p' = p + \Delta p \]
Kisha thamani mpya ya kipengele husampuliwa upya kutoka kwa sampuli jirani kwa:
\[ Y(p) = \sum_{q\in N(p')} w_qX(q) \]
. \(N(p')\) huwakilisha pointi zinazozunguka nafasi mpya ya sampuli na \(w_q\) ni uzito wa interpolation.
Hivyo mtandao unaweza kubadilisha nafasi ya sampuli kulingana na mpaka wa kitu au muundo wa eneo. Katika matokeo ya ablation, mojawapo ya michango iliyoonekana zaidi kwa usahihi kati ya maboresho matatu ilitoka kwa Dysample peke yake: modeli inayotumia Dysample pekee ilifikia F1 %84,75, mAP50 %88,29 na mAP50-95 %65,42.
Kichwa cha utambuzi cha LSDECD kinakuwa chepesi vipi?
Katika kichwa cha kawaida cha utambuzi cha YOLO, matawi ya uainishaji na regression ya kisanduku hufanya operesheni tofauti kwa ramani za vipengele katika mizani tofauti. Muundo huu hutoa uwezo mkubwa wa uwakilishi, lakini kurudiwa kwa konvolusheni zinazofanana katika mizani tofauti huongeza gharama ya hesabu.
Mbinu ya LSCD ambayo LSDECD inategemea hupunguza urudiaji huu kwa kushiriki baadhi ya uzito za konvolusheni kati ya mizani. Watafiti wanasema hili linaweza kusababisha kulainishwa kupita kiasi kwa maelezo madogo, na hivyo wameongeza Detail Enhancement Convolution (DEConv) badala ya konvolusheni nyepesi ya kawaida.
DEConv huongeza vipengele vya tofauti ya kati, ya pembe, ya usawa na ya wima kwenye mwitikio wa konvolusheni ya kawaida:
\[ Y_{\mathrm{VC}} = Conv(X) \]
\[ Y_{\mathrm{CDC}}(i,j)=X(i,j)-X(i+1,j+1) \]
\[ Y_{\mathrm{ADC}}(i,j)=X(i,j)-X(i+1,j-1) \]
\[ Y_{\mathrm{HDC}}(i,j)=X(i,j)-X(i,j+1) \]
\[ Y_{\mathrm{VDC}}(i,j)=X(i,j)-X(i+1,j) \]
na pato la jumla:
\[ Y = Y_{\mathrm{VC}} + Y_{\mathrm{CDC}} + Y_{\mathrm{ADC}} + Y_{\mathrm{HDC}} + Y_{\mathrm{VDC}} \]
. Lengo ni kufanya tofauti za kingo/muundo za usawa, wima na diagonalionekane zaidi. Utafiti pia unasema kwamba miundo hii yenye matawi mengi inaweza kurekebishwa upya kuwa konvolusheni moja sawia katika hatua ya inference, hivyo uchotaji wa maelezo wakati wa mafunzo hauhitaji hesabu za ziada zenye matawi mengi kwa kiwango sawa wakati wa utekelezaji.
Je, LSDECD peke yake iliongeza usahihi?
Si katika kila kipimo. LSDECD pekee ilipopachikwa, GFLOPs ilipungua kutoka 6,3 hadi 4,8 na idadi ya vigezo kutoka milioni 2,58 hadi milioni 2,46. Kwa upande mwingine, mAP50 ilibaki karibu na msingi kwa %87,27, huku mAP50-95 ikipungua kidogo hadi %63,87.
Hili ni jambo muhimu la usanifu: jukumu kuu la LSDECD si kutoa ongezeko kubwa la usahihi peke yake, bali kupunguza urudiaji wa hesabu katika kichwa cha utambuzi. Utendaji wa juu zaidi ulijitokeza ilipotumika pamoja na C3k2_PS na Dysample.
Ni nini kilitokea moduli zote tatu zilipotumiwa pamoja?
UGV-Net ya mwisho hutumia marekebisho yote matatu pamoja. Matokeo msingi ya ablation ya KITTI ni haya:
| Kipimo | YOLO11n | UGV-Net | Tofauti iliyoripotiwa katika chanzo |
|---|---|---|---|
| Precision | %90,33 | %91,80 | +pointi 1,47 za asilimia |
| Recall | %78,14 | %80,95 | +pointi 2,81 za asilimia |
| F1 | %83,44 | %85,63 | +pointi 2,19 za asilimia |
| mAP50 | %87,18 | %89,44 | +pointi 2,26 za asilimia |
| mAP50-95 | %63,97 | %66,07 ± 0,02 | +pointi 2,10 za asilimia |
| GFLOPs | 6,3 | 4,9 | upungufu wa %22,22 |
| Kigezo | 2,58 M | 2,41 M | takribani upungufu wa %6,5 katika chanzo |
F1, mAP na vipimo vingine vina maana gani?
Precision hupima ni visanduku vingapi ambavyo modeli imevitambua kama malengo ni malengo halisi. Recall huonyesha ni malengo mangapi halisi yameweza kugunduliwa. F1, ambayo ni wastani wa harmoniki wa maadili hayo mawili, huhesabiwa kwa:
\[ F1 = 2\times \frac{Precision\times Recall} {Precision+Recall} \]
.
Average Precision (AP) kwa darasa moja hufafanuliwa kupitia eneo chini ya curve ya precision–recall:
\[ AP = \int_{0}^{1} Precision(r)\,dr \]
. Wastani wa AP wa madarasa N huhesabiwa kwa:
\[ mAP = \frac{1}{N}\sum_{i=1}^{N}AP_i \]
. mAP50 ni kwa kizingiti cha IoU 0,50; mAP50-95 ni kipimo kinachojumuisha pia usahihi mkali zaidi wa uwekaji katika vizingiti tofauti vya IoU.
Ni seti gani ya data ilitumika kwa jaribio kuu?
Seti kuu ya data ya mafunzo na ulinganisho ni KITTI. Katika utafiti, jumla ya picha 7481 katika sehemu rasmi ya mafunzo ya KITTI zilichanganywa kwanza na kugawanywa kwa uwiano wa 7:2:1:
| Sehemu | Idadi ya picha |
|---|---|
| Mafunzo | 5237 |
| Uthibitishaji | 1496 |
| Majaribio | 748 |
Katika KITTI, madarasa Car, Van, Truck, Pedestrian, Person_sitting, Cyclist, Tram na Misc hutumiwa. Takwimu za lebo katika utafiti zinaonyesha kwamba darasa Car lina idadi kubwa zaidi ya mifano kwa tofauti kubwa, likifuatiwa na Pedestrian na Van.
Mkusanyiko wa usambazaji wa ukubwa wa bounding-box katika thamani ndogo za upana na urefu zilizonormishwa unaonyesha kwamba malengo mengi katika seti ya data huchukua eneo dogo ndani ya picha. Vituo vya vitu pia vimejikusanya hasa katikati na chini-katikati mwa picha, yaani katika uwanja wa mbele wa kuona wa gari.
Modeli ilifundishwa katika hali gani?
| Kigezo cha mafunzo | Thamani katika utafiti |
|---|---|
| Mfumo wa uendeshaji | Windows 11 |
| CPU | Intel Core Ultra 7-265K |
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 GB |
| RAM | 32 GB |
| Python | 3.9 |
| PyTorch | 2.7.0 |
| CUDA | 12.8 |
| Ukubwa wa ingizo | 640 × 640 |
| Learning rate | 0,01 |
| Optimizer | SGD |
| Momentum | 0,937 |
| Batch size | 32 |
| Epoch | 300 |
| Weight decay | 0,0005 |
| Idadi ya thread | 8 |
Matokeo yalikuwa yapi dhidi ya modeli tofauti za utambuzi wa vitu?
Watafiti walilinganisha Faster R-CNN, SSD, RT-DETR, YOLOv5n, YOLOv8n, YOLO11n, YOLOv12n, YOLOv13n, LP-YOLO na PV-YOLO na UGV-Net katika mpangilio uleule wa majaribio. Katika matokeo ya KITTI, UGV-Net ilikuwa modeli iliyotoa kwa pamoja viwango vya juu zaidi vya F1, mAP50 na mAP50-95 kati ya modeli zilizoripotiwa.
| Modeli | F1 | mAP50 | mAP50-95 | GFLOPs | Kigezo |
|---|---|---|---|---|---|
| YOLOv8n | %83,16 | %86,75 | %63,76 | 8,9 | 2,69 M |
| YOLO11n | %83,44 | %87,18 | %63,97 | 6,3 | 2,58 M |
| YOLOv13n | %85,15 | %88,02 | %64,89 | 6,1 | 2,50 M |
| LP-YOLO | %82,79 | %86,75 | %62,34 | 5,5 | 1,88 M |
| PV-YOLO | %80,71 | %85,66 | %61,05 | 6,3 | 1,46 M |
| UGV-Net | %85,63 | %89,44 | %66,07 | 4,9 | 2,41 M |
Haiwezi kuhitimishwa kuwa UGV-Net ndiyo modeli yenye vigezo vichache zaidi; kwa mfano PV-YOLO ina 1,46 M na LP-YOLO ina 1,88 M. Faida ambayo utafiti unaonyesha kwa UGV-Net si kushinda kila modeli yenye vigezo vichache, bali kutoa utendaji wa pamoja ulio bora zaidi kati ya usahihi na mzigo wa hesabu katika mpangilio wake wa majaribio.
Ulinganisho wa kuona wa utambuzi ulionyesha nini?
Katika picha za utambuzi za utafiti, tofauti kubwa haikuonekana kati ya YOLO11n, YOLOv13n na UGV-Net kwa vitu vikubwa na dhahiri kama Van. Tofauti ilijitokeza hasa katika malengo madogo yaliyo mbali ya Pedestrian na Cyclist na katika lengo la Person_sitting lililofunikwa kwa sehemu.
Katika mfano mwingine, YOLO11n na YOLOv13n zilionyeshwa kuainisha vibaya nguzo nyembamba yenye utofauti mkubwa pembeni mwa barabara kama “Pedestrian”, wakati UGV-Net haikutoa jibu hilo chanya la uongo katika eneo hilo. Picha hizi binafsi si ushahidi wa kiwango cha makosa kwa mazingira yote ya wazi, lakini pamoja na matokeo ya kiasi zinaunga mkono kwa kuona tabia ya kukandamiza mandharinyuma ya modeli.
Ramani za joto zinaonyesha modeli inaangalia nini?
Katika ulinganisho wa ramani za joto zinazofanana na Grad-CAM, majibu ya YOLOv8n, YOLO11n na YOLOv13n yanaonekana kuenea zaidi kwenye nyuso za vitu vikubwa au maeneo ya mandharinyuma yenye utofauti mkubwa. Katika UGV-Net, maeneo yenye mwitikio mkubwa yanaonekana kujikita zaidi katika mwili wa lengo na maeneo ya kimuundo ya lengo.
Kwa malengo ya mbali ya Pedestrian na Cyclist, uamilishaji wa ramani ya joto ya UGV-Net ulidumishwa kwa uwazi zaidi kuliko baadhi ya modeli nyingine. Katika mfano ambapo nguzo ilitambuliwa vibaya kama mtembea kwa miguu, uamilishaji wa UGV-Net karibu na nguzo ulikuwa dhaifu, huku ukiwa mzito zaidi karibu na mtembea kwa miguu halisi na gari lililo mbali. Picha hizi hazithibitishi peke yake utaratibu wa utendaji; zinatoa msaada wa kimaelezo kwa matokeo ya utambuzi na ablation ya utafiti.
Matokeo ya SODA10M yalikuwa yapi?
| Modeli | Precision | Recall | F1 | mAP50 | mAP50-95 |
|---|---|---|---|---|---|
| YOLOv8n | %66,16 | %51,02 | %56,98 | %57,01 | %38,27 |
| YOLO11n | %67,84 | %49,79 | %56,39 | %56,81 | %38,38 |
| YOLOv13n | %66,51 | %50,01 | %55,91 | %55,68 | %37,09 |
| UGV-Net | %65,84 | %53,58 | %58,10 | %58,48 | %39,37 |
Kwenye SODA10M, ingawa precision ya UGV-Net ni ya chini kuliko YOLO11n, recall, F1, mAP50 na mAP50-95 ni za juu. Kwa hivyo kauli kama “ya juu zaidi katika vipimo vyote” si sahihi. Faida kuu ya utafiti inaonekana katika ongezeko la recall linalopunguza malengo yanayokosekana na katika utendaji wa jumla wa F1/mAP.
Matokeo ya FLIR yalikuwa yapi?
Ingawa seti ya data ya FLIR ina picha za RGB na za joto, katika utafiti huu picha za RGB pekee ndizo zilizotumiwa kwa mafunzo na tathmini. Kwa hivyo matokeo haya hayapaswi kufasiriwa kama utendaji wa utambuzi wa picha za joto.
| Modeli | Precision | Recall | F1 | mAP50 | mAP50-95 |
|---|---|---|---|---|---|
| YOLOv8n | %77,56 | %69,19 | %73,01 | %75,83 | %38,44 |
| YOLO11n | %79,52 | %67,35 | %72,82 | %75,97 | %39,16 |
| YOLOv13n | %77,82 | %66,32 | %71,52 | %74,84 | %37,89 |
| UGV-Net | %78,85 | %70,29 | %74,23 | %78,36 | %39,82 |
Hapa pia UGV-Net haina precision ya juu zaidi; YOLO11n iko juu kwa %79,52 dhidi ya %78,85 ya UGV-Net. Kwa upande mwingine, UGV-Net imetoa matokeo ya juu zaidi katika recall, F1, mAP50 na mAP50-95.
Kikomo cha matokeo ya “generalization” ni nini?
Utafiti unaita majaribio ya SODA10M na FLIR tathmini za generalization/cross-dataset. Hata hivyo, katika sehemu ya mbinu imeandikwa wazi kwamba seti zote mbili za data ziligawanywa kwa uwiano wa 7:2:1 katika mafunzo, uthibitishaji na majaribio. Kwa hivyo matokeo haya si jaribio la zero-shot domain transfer ambapo modeli moja iliyofundishwa kwenye KITTI pekee inajaribiwa kwenye SODA10M au FLIR bila mafunzo upya.
Tafsiri salama zaidi kisayansi ni kwamba usanifu wa UGV-Net umeonyesha faida thabiti katika seti tatu tofauti za data chini ya mipangilio tofauti ya mafunzo/tathmini. Hili linaunga mkono kwamba usanifu si matokeo maalum ya seti moja ya data pekee; lakini hali thabiti ya uhamishaji kwenye eneo lisiloonekana kabisa haijathibitishwa na hili pekee.
Ilihamishwaje kwenda Jetson Orin Nano?
Modeli ya PyTorch iliyofundishwa ilisafirishwa kwanza katika muundo wa ONNX, kisha ikabadilishwa kuwa injini ya TensorRT kwenye Jetson Orin Nano. Mipangilio ya inference kwenye kifaa ilikuwa:
| Kigezo cha usambazaji | Thamani |
|---|---|
| Injini ya inference | TensorRT |
| Ukubwa wa ingizo | 640 × 640 |
| Usahihi wa inference | FP16 |
| Batch size | 1 |
Fremu za video zilibadilishwa ukubwa na kunormishwa, kisha zikaingizwa kwenye injini ya TensorRT na matokeo ya utambuzi yakatolewa kwenye kifaa.
Ilifanya kazi kwa kasi gani kwenye Jetson Orin Nano?
| Modeli | FPS ya wastani | Ucheleweshaji | Matumizi ya kumbukumbu | Nguvu ya ziada |
|---|---|---|---|---|
| YOLOv8n | 22,3 FPS | 44,84 ms | 2,9 GB | 1,4 W |
| YOLO11n | 25,8 FPS | 38,76 ms | 3,0 GB | 1,3 W |
| UGV-Net | 27,9 FPS | 35,84 ms | 2,9 GB | 1,2 W |
UGV-Net ilitoa FPS ya wastani ya juu zaidi, ucheleweshaji wa chini zaidi na thamani ya chini zaidi iliyoripotiwa ya nguvu ya ziada kati ya modeli hizi tatu. Matumizi ya kumbukumbu yalikuwa sawa na YOLOv8n na chini kwa 0,1 GB kuliko YOLO11n.
Utafiti unaeleza kwamba FPS ya papo hapo inaweza kubadilika kwa sababu ya ugumu wa fremu, mzigo wa vifaa na hali ya cache; kwa hiyo FPS ya wastani ilitumika kama kipimo kikuu cha kasi:
\[ FPS_i=\frac{1}{t_i} \]
na kwa video nzima:
\[ FPS_{\mathrm{avg}}=\frac{N}{T} \]
Hapa \(t_i\) ni muda wa jumla wa kuchakata fremu moja, \(N\) ni idadi ya fremu za video na \(T\) ni muda wa jumla wa kuchakata fremu zote.
Je, jaribio la Jetson linamaanisha uthibitishaji halisi wa UGV shambani?
Hapana. Utafiti unaonyesha kwamba UGV-Net inaweza kufanya inference ya wakati halisi kwenye vifaa vya pembeni vyenye rasilimali chache; hata hivyo, jaribio lililochapishwa si jaribio la shambani linalothibitisha mwisho hadi mwisho utambuzi wa muda mrefu, kufanya maamuzi, breki au mzunguko wa kupanga njia wakati roboti inaendesha kwa uhuru katika mazingira halisi ya wazi.
Tofauti hii ni muhimu. Matokeo ya 27,9 FPS yanaunga mkono kasi ya inference ya modeli kwenye Jetson Orin Nano; si uthibitisho wa usalama wa UGV katika ulimwengu halisi au muda wa majibu wa kutosha katika hali zote za trafiki.
Nguvu za utafiti ni zipi?
- Uchambuzi wazi wa uzani–utendaji umefanywa unaotathmini usahihi, GFLOPs na idadi ya vigezo kwa wakati mmoja.
- Marekebisho matatu ya usanifu yamejaribiwa katika ablation za pekee na za mchanganyiko.
- Toleo tofauti za C3k2 na miundo mbalimbali ya detection head pia zimelinganishwa tofauti.
- Mbali na ulinganisho mkuu wa KITTI, majaribio ya ziada ya seti za data yamefanywa kwenye SODA10M na FLIR.
- Pamoja na matokeo ya kiasi, tabia ya vitu vidogo, kufunikwa na matokeo chanya ya uongo imechunguzwa kwa picha za utambuzi na ramani za joto.
- Modeli haikujaribiwa tu kwenye GPU ya mezani bali pia kwenye Jetson Orin Nano kwa TensorRT/FP16 inference.
Vikwazo vikuu vya utafiti ni vipi?
Kwanza, majaribio ya SODA10M na FLIR yanatumia sehemu za mafunzo za seti hizo za data. Kwa hiyo si sahihi kuyaeleza kikamilifu kama “generalization ya zero-shot kwenda eneo la data lisiloonekana”.
Pili, katika jaribio la FLIR, kanal ya joto haikutumiwa; picha za RGB pekee ndizo zilitathminiwa. Utafiti huu hauonyeshi utendaji wa UGV-Net kwa utambuzi wa picha za joto.
Tatu, jaribio la Jetson Orin Nano linathibitisha utendaji wa vifaa vya pembeni lakini si jaribio kamili la UGV shambani. Utafiti haukuchunguza uendeshaji wa muda mrefu wa UGV halisi, ujumuishaji na kupanga njia, tabia ya kusimama kwa dharura au uthibitishaji wa usalama.
Nne, watafiti wanataja wazi mabadiliko makali ya mwangaza, mvua, ukungu na mwonekano mdogo wa usiku kama maeneo yanayohitaji kuboreshwa baadaye kwa modeli ya sasa. Kwa hiyo haiwezi kudhaniwa kuwa matokeo ya sasa yatadumu katika kiwango kilekile katika hali hizi.
Tano, utafiti unalenga utambuzi unaotegemea picha. Matumizi ya pamoja ya LiDAR, radar, kamera ya joto au vihisi vingine hayamo katika upeo wa majaribio ya sasa ya UGV-Net; muunganisho wa vihisi vingi umeachwa kama kazi ya baadaye.
Utafiti unasema nini?
Utafiti unaonyesha kwamba kuongeza kwa pamoja moduli za C3k2_PS, Dysample na LSDECD juu ya YOLO11n kunaweza kutoa matokeo ya juu ya F1/mAP na gharama ndogo ya hesabu ndani ya modeli moja chini ya seti za data na hali za majaribio zilizochunguzwa; pia modeli hii inaweza kufanya kazi kwenye Jetson Orin Nano karibu na kiwango cha 28 FPS.
Utafiti hausami nini?
Haijaonyeshwa kwamba UGV-Net hutoa utambuzi salama na usio na makosa kwa mazingira yote ya wazi, hali zote za hewa au majukwaa yote ya UGV. Modeli si uthibitishaji wa mfumo halisi wa usalama wa gari; haiwezi kuhitimishwa kwamba inagundua vitu vyote vidogo au haitoi matokeo chanya ya uongo. Matokeo ya SODA10M na FLIR pia si ushahidi wa domain-transfer unaofanya kazi bila mafunzo upya kabisa.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa usanifu wa mtandao
| Sehemu ya UGV-Net | Kazi kuu ya kiufundi | Tatizo linalolengwa |
|---|---|---|
| C3k2_PS | Mwingiliano wa vipengele wa daraja la juu kupitia Star Block na uzani upya wa utegemezi wa kanal kupitia PCSA | Mandharinyuma tata, kufunikwa, kudhoofika kwa vipengele vya malengo madogo |
| Dysample | Sampuli inayojali maudhui kwa kutumia offset zilizojifunza | Upotevu wa maelezo wakati wa upsampling na hitilafu ya upangaji wa nafasi |
| LSDECD | Konvolusheni inayoshirikiwa kati ya mizani na uimarishaji wa maelezo wa DEConv | Urudiaji wa hesabu katika kichwa cha utambuzi na upotevu wa maelezo madogo |
Jaribio kamili la ablation
| Muundo | Precision | Recall | F1 | mAP50 | mAP50-95 | GFLOPs | Params |
|---|---|---|---|---|---|---|---|
| YOLO11n | %90,33 | %78,14 | %83,44 | %87,18 | %63,97 | 6,3 | 2,58 M |
| C3k2_PS | %90,68 | %77,94 | %83,35 | %87,32 | %64,05 | 6,4 | 2,52 M |
| Dysample | %87,77 | %82,35 | %84,75 | %88,29 | %65,42 | 6,3 | 2,60 M |
| LSDECD | %87,05 | %81,01 | %83,76 | %87,27 | %63,87 | 4,8 | 2,46 M |
| C3k2_PS + Dysample | %89,46 | %80,74 | %84,65 | %88,16 | %65,84 | 6,4 | 2,53 M |
| C3k2_PS + LSDECD | %87,91 | %80,66 | %83,86 | %88,30 | %64,16 | 4,9 | 2,39 M |
| Dysample + LSDECD | %84,68 | %82,52 | %83,25 | %87,87 | %64,24 | 4,8 | 2,47 M |
| C3k2_PS + Dysample + LSDECD | %91,80 | %80,95 | %85,63 | %89,44 | %66,07 ± 0,02 | 4,9 | 2,41 M |
Matokeo ya ablation yanaonyesha kwamba michango ya moduli haiungani kwa mstari. Kwa mfano, Dysample peke yake huongeza recall hadi %82,35, huku recall ya UGV-Net ya mwisho ikiwa %80,95; hata hivyo, modeli ya mwisho hutoa precision, F1 na mAP za juu zaidi. Watafiti wanaeleza hili kwa mwingiliano kati ya uwakilishi wa vipengele, muunganisho wa mizani mingi na kichwa chepesi cha utambuzi.
Ulinganisho wa vichwa vya utambuzi
| Detection head | F1 | mAP50 | mAP50-95 | GFLOPs | Kigezo |
|---|---|---|---|---|---|
| Base | %84,65 | %88,16 | %65,84 | 6,4 | 2,53 M |
| Efficient | %84,68 | %87,29 | %64,66 | 5,2 | 2,27 M |
| LSCD | %85,37 | %88,76 | %64,75 | 5,7 | 2,37 M |
| LSDECD | %85,63 | %89,44 | %66,07 | 4,9 | 2,41 M |
Efficient head ilitoa idadi ndogo zaidi ya vigezo lakini ikasababisha kupotea kwa usahihi. LSCD iliinua F1 na mAP50 lakini mAP50-95 ikapungua. LSDECD ilitoa kwa pamoja GFLOPs ya chini zaidi na vipimo vitatu vikuu vya usahihi vya juu zaidi katika jaribio hili.
Kikomo cha kiufundi cha jaribio la kifaa cha pembeni
Matokeo ya Jetson Orin Nano yalipatikana chini ya TensorRT, FP16, ingizo la 640 × 640 na batch 1. Utafiti chanzo haukujaribu kama FPS hiyo hiyo itadumishwa katika matoleo mengine ya TensorRT, hali tofauti za nguvu, mifumo ya uchakataji wa kamera au chini ya mizigo ya programu za roboti zinazotekelezwa kwa wakati mmoja.
Thamani ya “Additional Power” katika Jedwali 9 si matumizi ya jumla ya umeme ya kifaa; ni kipimo cha nguvu ya ziada kilichoripotiwa wakati modeli inaendeshwa. Kwa hiyo 1,2 W haipaswi kufasiriwa kama mahitaji ya jumla ya nguvu ya mfumo wa Jetson Orin Nano.
Hitimisho la jumla
Katika mpangilio wake wa majaribio, UGV-Net ilipata matokeo ya juu ya F1 na mAP kuliko msingi wa YOLO11n huku ikipunguza GFLOPs na idadi ya vigezo na kutoa FPS ya wastani ya juu zaidi kwenye Jetson Orin Nano. Matokeo muhimu zaidi ya kiufundi ya utafiti ni kwamba mabadiliko ya uchotaji wa vipengele na upsampling ya nguvu yanayolenga kuimarisha uwakilishi wa vitu vidogo na vilivyofunikwa yanaweza kuwa na manufaa kwa usawa wa usahihi–hesabu yanapotumiwa pamoja na kichwa chepesi cha utambuzi.
Thamani ya matumizi ya matokeo ni muhimu hasa kwa mifumo ya utambuzi wa rununu yenye bajeti ndogo ya hesabu; hata hivyo, kwa usalama kamili wa uendeshaji wa UGV, hali halisi za shambani, hali mbaya ya hewa na mwanga mdogo, mifumo tofauti ya kamera/vihisi na mnyororo wa kufanya maamuzi baada ya utambuzi vinahitaji kuthibitishwa tofauti.
Chanzo na Dokezo la Mbinu
Jina kamili la kazi asili: A Method for Lightweight Pedestrian and Vehicle Detection for Unmanned Ground Vehicles in Open Environments
Waandishi, kwa mpangilio wa chanzo: Xulong Zhang; Hong Jiang; Dong Han; Hai Guo; Xiangfeng Zhang; Kaige Sun.
Mchango sawa/mwandishi wa kwanza sawa: Chanzo hakina tamko la mchango sawa au uandishi wa kwanza sawa.
Mwandishi wa mawasiliano: Hong Jiang.
Taasisi: School of Mechanical Engineering, Xinjiang University, Urumqi, China; Xinjiang Academy of Building Research Co., Ltd., Urumqi, China; School of Mechanical Engineering, Zhejiang University, Hangzhou, China.
Jarida: Machines.
Mchapishaji: MDPI, Basel, Switzerland.
Utambulisho wa chapisho: Machines 2026, 14(5), 527.
DOI: 10.3390/machines14050527.
Kiungo rasmi cha chapisho:https://doi.org/10.3390/machines14050527
Kupokelewa / kusahihishwa / kukubaliwa / kuchapishwa: 24 March 2026 / 30 April 2026 / 5 May 2026 / 8 May 2026.
Aina ya chanzo na hali ya mapitio: Makala ya utafiti iliyopitiwa na wataalamu iliyochapishwa katika jarida la Machines.
Leseni: Creative Commons Attribution (CC BY); hakimiliki © 2026 ni ya waandishi.
Ufadhili: Utafiti ulifadhiliwa na Tianshan Talent Program: Youth Support Talent Project chini ya msaada namba 2024TSYCQNTJ0020 na China State Construction Engineering Corporation Technology R&D Projects chini ya msaada namba CSCEC-2025-Z-27.
Upatikanaji wa data: Imeelezwa kwamba data iliyotumiwa katika utafiti inaweza kutolewa kwa ombi baada ya kuwasiliana na mwandishi wa mawasiliano.
Mgongano wa maslahi: Imeelezwa kwamba Xulong Zhang na Hai Guo wanafanya kazi katika Xinjiang Academy of Building Research Co., Ltd. Waandishi wengine wanasema hakuna uhusiano wa kibiashara au kifedha unaoweza kuathiri utafiti.
Michango ya waandishi: Uundaji wa dhana Xulong Zhang na Hong Jiang; mbinu na uchambuzi rasmi Xulong Zhang; programu Kaige Sun; uthibitishaji Xulong Zhang, Hong Jiang na Xiangfeng Zhang; utafiti Xulong Zhang na Dong Han; rasilimali Dong Han; usimamizi wa data Kaige Sun na Dong Han; rasimu ya kwanza Xulong Zhang; mapitio na uhariri Hong Jiang, Dong Han na Xiangfeng Zhang; uonyeshaji Xulong Zhang; ushauri Hong Jiang; usimamizi wa mradi na upatikanaji wa ufadhili Hai Guo.
Dokezo la seti ya data: Jaribio kuu lilifanywa kwenye KITTI. Seti ya mafunzo ya KITTI yenye picha 7481 iligawanywa katika picha 5237 za mafunzo, 1496 za uthibitishaji na 748 za majaribio kwa uwiano wa 7:2:1. SODA10M na FLIR pia ziligawanywa kwa uwiano wa 7:2:1 katika mafunzo, uthibitishaji na majaribio. Katika majaribio ya FLIR, picha za RGB pekee ndizo zilizotumiwa.
Kikomo cha tafsiri ya “generalization”: Chanzo kinaita majaribio ya SODA10M na FLIR generalization/cross-dataset tests; hata hivyo, kwa kuwa sehemu za mafunzo za seti hizo za data zilitumiwa, matokeo hayapaswi kuchukuliwa kama zero-shot domain transfer. Katika uwasilishaji huu wa Verianla, istilahi ya chanzo imehifadhiwa, lakini upeo halisi wa mpangilio wa majaribio umeelezwa tofauti.
Kikomo cha uthibitishaji wa kifaa cha pembeni: Jaribio la Jetson Orin Nano linaonyesha kwamba modeli inaweza kuendeshwa kwenye kifaa cha pembeni chini ya TensorRT/FP16 na linaonyesha kasi ya video inference. Utafiti si uthibitisho wa usalama wa muda mrefu wa uendeshaji wa UGV halisi katika mazingira ya wazi, ujumuishaji wa utambuzi–upangaji–udhibiti au uaminifu wa kiwango cha uthibitishaji.
Vikwazo vya kazi ya baadaye: Watafiti wanataja mabadiliko makali ya mwangaza, mvua, ukungu, mwonekano mdogo wa usiku na muunganisho wa vihisi vingi kama mada zinazohitaji kuboreshwa katika kazi za baadaye.
Mbinu ya kuandaa maudhui: Sehemu ya kisayansi ya maudhui haya ya Verianla inategemea maandishi, milinganyo, majedwali, michoro ya usanifu wa mtandao, majaribio ya ablation, picha za utambuzi, ramani za joto na matokeo ya Jetson Orin Nano ya utafiti uliopakiwa. Hakuna matokeo mapya ya majaribio, thamani mpya ya utendaji au utaratibu wa ziada ulioongezwa kutoka vyanzo vya nje. Uthibitishaji wa nje ulitumika tu kuangalia utambulisho wa kibibliografia wa chapisho. Inline SVG zimechorwa upya kutoka data kamili za majedwali zilizoripotiwa katika chanzo au ni michoro ya asili ya kuelezea iliyoandaliwa kwa kutegemea mbinu ya utafiti.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *