

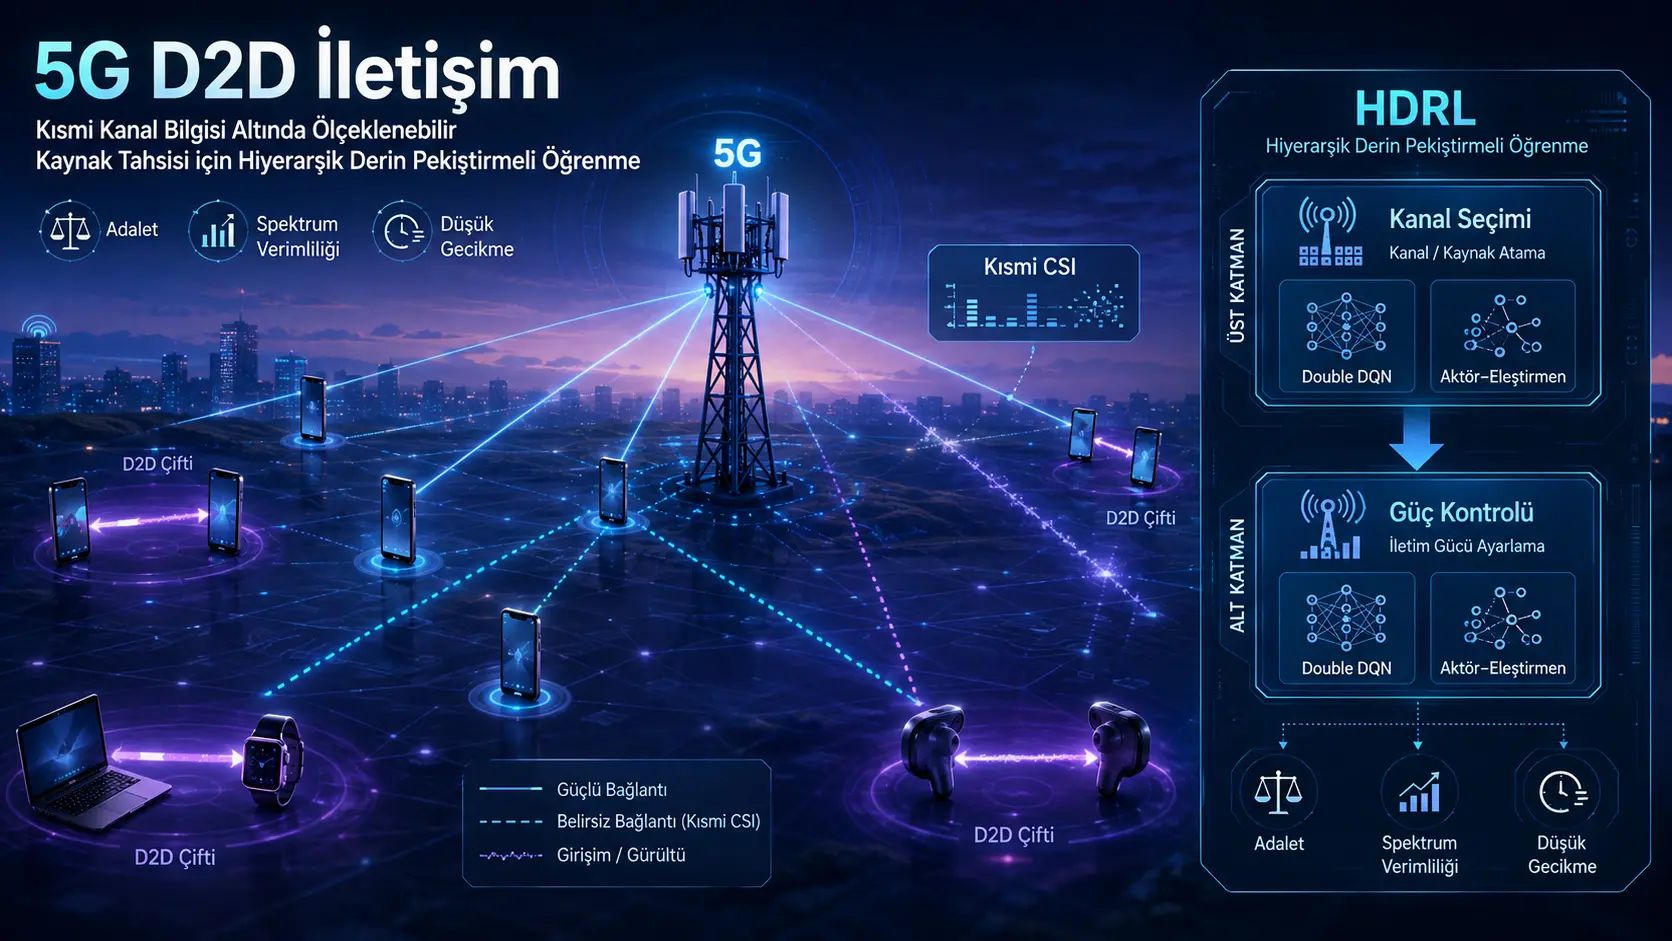
Bu çalışma, 5G hücresel ağlarında yakın cihazların baz istasyonuna uğramadan doğrudan haberleşmesini sağlayan cihazdan cihaza iletişim için kanal ve iletim gücü tahsisini incelemiştir. Araştırmacılar, tam kanal durum bilgisinin bulunmadığı koşullarda kaynak bloğu seçimini Double DQN, sürekli güç kontrolünü ise ikiz eleştirmenli aktör–eleştirmen yapısıyla gerçekleştiren iki katmanlı bir hiyerarşik derin pekiştirmeli öğrenme çerçevesi önermiştir. Simülasyonda önerilen yöntem 108,562 Mbps toplam veri hızına, 0,971 Jain adalet indeksine ve 1,542 ortalama ödüle ulaşmıştır. Bununla birlikte sistem formülasyonu ile kullanıcı sayıları arasında önemli bir kaynak tahsisi tutarsızlığı bulunmakta; kısmi kanal bilgisi modelinin parametreleri ve farklı hata düzeylerine karşı dayanıklılık sonuçları açıklanmamaktadır.
Önerilen yaklaşımın temel fikri, ayrık kanal seçimi ile sürekli güç kontrolünü aynı büyük eylem uzayında çözmek yerine iki bağlantılı karar katmanına ayırmaktır. Üst düzey denetleyici her D2D çifti için hangi hücresel kaynak bloğunun yeniden kullanılacağını belirler. Alt düzey denetleyici ise seçilen kaynak bloğunda kullanılacak iletim gücünü ayarlar. Ödül fonksiyonu toplam veri hızını ve kullanıcılar arasındaki adaleti artırmayı, girişim, güç ve hizmet kalitesi ihlallerini azaltmayı amaçlamaktadır.
Türkiye açısından değerlendirme: Yaklaşım; Türkiye’de özel 5G ağları, akıllı fabrikalar, yoğun IoT sistemleri, araçtan araca iletişim, kampüs ağları ve afet haberleşmesi üzerine çalışan araştırma ekipleri açısından uyarlanabilir bir kaynak yönetimi örneğidir. Ancak gerçek uygulama öncesinde Türkiye’de kullanılacak frekanslar, baz istasyonu yoğunluğu, hareketlilik, bina yapısı, girişim seviyesi ve kanal kestirim hatalarıyla çok merkezli simülasyonlar yapılmalıdır. Donanım döngülü deneyler, gerçek radyo test platformları, gecikme ve enerji ölçümleri ile farklı operatör ağlarında dış doğrulama da gereklidir. Bu çalışmadan Türkiye’deki canlı mobil ağlarda aynı veri hızı artışının elde edileceği veya yöntemin doğrudan kullanıma hazır olduğu sonucu çıkarılamaz.
Cihazdan cihaza iletişim nedir?
Cihazdan cihaza iletişim, birbirine yakın iki kullanıcı cihazının veriyi doğrudan aktarmasına olanak tanır. Böylece verinin her durumda baz istasyonuna gidip yeniden hedef cihaza iletilmesi gerekmez. D2D bağlantıları hücresel kullanıcılar için ayrılmış radyo kaynaklarını yeniden kullanarak spektrum verimliliğini yükseltebilir, baz istasyonundaki trafik yükünü azaltabilir ve iletişim gecikmesini düşürebilir.
Bu kazanç, D2D vericisinin hücresel kullanıcıya veya baz istasyonuna girişim oluşturabilmesi nedeniyle ücretsiz değildir. Aynı kaynak bloğunu kullanan bağlantıların kanalı ve iletim gücü birlikte seçilmelidir. Aşırı güç kullanımı bir D2D çiftinin veri hızını yükseltirken başka kullanıcıların sinyal kalitesini düşürebilir.
Kısmi kanal durum bilgisi neden önemlidir?
Kanal durum bilgisi, verici ile alıcı arasındaki radyo bağlantısının o andaki kalitesini temsil eder. Tam kanal bilgisinin elde edilmesi; kullanıcı hareketliliği, kestirim hataları, geri bildirim gecikmesi ve sinyalleşme yükü nedeniyle gerçek ağlarda güçtür. Kaynak tahsis sistemi bu nedenle gerçek kanalın kendisi yerine gürültü veya gecikme içeren bir kestirimle karar vermek zorunda kalabilir.
Çalışmada doğrudan D2D kanalları ve girişim kanalları tam değerleriyle değil, kestirilmiş değerleriyle durum uzayına aktarılmıştır. Simülasyon açıklamasında kısmi kanal bilgisinin Gauss gürültüsü ve zamansal korelasyon kullanılarak üretildiği belirtilmektedir. Ancak gürültü varyansı, korelasyon katsayısı ve kanal kestirim doğruluğu verilmemiştir. Bu eksiklik, deney koşullarının yeniden üretilmesini ve modelin farklı belirsizlik düzeylerinde karşılaştırılmasını güçleştirmektedir.
Sistem modeli nasıl kurulmuştur?
Araştırma tek hücreli bir ağ modeli kullanmıştır. Baz istasyonu, hücresel kullanıcı ekipmanlarına ve D2D çiftlerine hizmet vermektedir. Her hücresel kullanıcıya bir ortogonal kaynak bloğu ayrılmış, D2D çiftlerinin bu blokları yeniden kullanmasına izin verilmiştir.
Çalışmanın 4. sayfasındaki sistem şeması beş temel bağlantı türünü göstermektedir:
- Hücresel kullanıcıdan baz istasyonuna yararlı yukarı bağlantı,
- D2D vericisinden baz istasyonuna oluşan çapraz katman girişimi,
- Hücresel kullanıcıdan D2D alıcısına oluşan çapraz katman girişimi,
- D2D vericileri arasında oluşan eş katmanlı girişim,
- D2D vericisi ile kendi alıcısı arasındaki doğrudan bağlantı.
D2D çifti i için sinyal-girişim-artı-gürültü oranı çalışmada şu biçimde modellenmiştir:
\[ \gamma_i^{D} = \frac{p_i h_{i,i}} {\sum_{j \neq i} p_j h_{j,i} + p_{c_i}^{C} h_{c_i,i} + \sigma^2} \]
Pay, D2D vericisinden kendi alıcısına ulaşan yararlı sinyal gücünü temsil eder. Paydada diğer D2D vericilerinden gelen eş katmanlı girişim, aynı kaynak bloğunu kullanan hücresel kullanıcının girişimi ve termal gürültü bulunmaktadır.
Hücresel kullanıcı k için baz istasyonundaki SINR ise şu şekilde verilmiştir:
\[ \gamma_k^{C} = \frac{p_k^{C} h_{k,B}} {\sum_{i:c_i=k} p_i h_{i,B}+\sigma^2} \]
D2D bağlantılarının hücresel kaynağı yeniden kullanması, baz istasyonundaki hücresel sinyale girişim eklemektedir. Bu nedenle hücresel kullanıcıların SINR değerinin belirlenen asgari eşiğin üzerinde tutulması bir hizmet kalitesi kısıtı olarak tanımlanmıştır.
Veri hızı nasıl hesaplanmıştır?
Araştırmacılar D2D ve hücresel bağlantıların ulaşılabilir veri hızlarını Shannon kapasite ifadesiyle hesaplamıştır:
\[ R_i^{D}=B\log_2(1+\gamma_i^{D}) \]
\[ R_k^{C}=B\log_2(1+\gamma_k^{C}) \]
Burada B kanal bant genişliği, R veri hızı ve γ ilgili bağlantının SINR değeridir. Toplam D2D veri hızı bütün D2D çiftlerinin hızlarının toplamıdır:
\[ R_{\mathrm{sum}}^{D}=\sum_{i=1}^{N_d}R_i^{D} \]
Kullanıcılar arasındaki adalet nasıl ölçülmüştür?
Yalnızca toplam veri hızını en üst düzeye çıkarmak, iyi kanal koşullarına sahip kullanıcılara sürekli kaynak verilip diğerlerinin geride bırakılmasına yol açabilir. Çalışma bu nedenle Jain adalet indeksini kullanmıştır:
\[ J = \frac{\left(\sum_i R_i^{D}\right)^2} {N_d\sum_i\left(R_i^{D}\right)^2} \]
İndeks 0 ile 1 arasında değer alır. Değerin 1’e yaklaşması D2D kullanıcılarının veri hızlarının daha dengeli dağıldığını gösterir. Ancak yüksek Jain indeksi tek başına bütün kullanıcıların yeterli hizmet aldığı anlamına gelmez; düşük ama birbirine yakın veri hızları da yüksek adalet değeri üretebilir.
Kaynak tahsisi hangi optimizasyon hedefiyle tanımlanmıştır?
Araştırmacılar toplam veri hızı, adalet ve enerji verimliliğini artıran; güç kullanımı ile SINR ihlallerini cezalandıran çok amaçlı bir problem tanımlamıştır:
\[ \max_{\mathbf{c},\mathbf{p}} \alpha \bar{R}+\beta J+\eta E-\Phi_P-\Phi_S \]
Bu amaç; D2D ve hücresel iletim güçlerinin sınırlar içinde tutulması, her D2D çiftine kaynak bloğu atanması, SINR eşiklerinin korunması ve adalet indeksinin belirlenen alt sınırın üzerinde tutulması koşullarıyla birlikte ele alınmıştır.
Formülasyondaki kaynak bloğu sorunu nedir?
Çalışmanın C3 kısıtı her D2D çiftinin hücresel kaynak kümesinden bir blok seçmesini gerektirmektedir. C4 kısıtı ise bir hücresel kaynak bloğunu en fazla bir D2D çiftinin kullanabileceğini belirtmektedir:
\[ \sum_{i:c_i=k}1\leq 1 \]
Simülasyon tablosunda 75 hücresel kullanıcı ve 110 D2D çifti bulunmaktadır. Her hücresel kullanıcı yalnızca bir kaynak bloğuna sahipse 75 blok mevcuttur. Her D2D çifti bir blok seçmek zorunda ve her blok en fazla bir çift tarafından kullanılabiliyorsa 110 çiftin 75 bloğa atanması mümkün değildir.
Ağ yoğunluğu deneylerinde de 25 hücresel kullanıcıya karşı 40 D2D çifti, 50’ye karşı 75, 75’e karşı 110, 100’e karşı 150 ve 125’e karşı 200 çift kullanılmıştır. Bütün yapılandırmalarda D2D çifti sayısı kaynak bloğu sayısından fazladır. Modelin gerçekte birden fazla D2D çiftinin aynı bloğu kullanmasına izin verdiği, bazı çiftleri hizmet dışında bıraktığı veya C4 kısıtının yanlış yazıldığı açıklığa kavuşturulmamıştır.
Ayrıca C4 gerçekten uygulanıyorsa aynı kaynak bloğunda iki D2D çifti bulunmayacağı için D2D SINR denklemindeki D2D–D2D eş katmanlı girişim toplamının nasıl ortaya çıktığı belirsizdir. Bu iç tutarsızlık, sonuçların yorumlanmasında en önemli sınırlılıklardan biridir.
Problem neden hiyerarşik olarak ayrılmıştır?
Kanal seçimi ayrık, güç kontrolü ise sürekli bir karardır. Her iki kararı tek bir düz eylem uzayında birleştirmek, kullanıcı sayısı arttıkça çok büyük ve karmaşık bir karar problemi oluşturur. Çalışma bu nedenle görevi iki katmana ayırmıştır:
- Üst katman: Double DQN ile kaynak bloğu veya kanal seçimi.
- Alt katman: Aktör–eleştirmen ağı ile sürekli iletim gücü belirleme.
6. sayfadaki mimari şema üst katmanda giriş durumunun DQN ağına aktarıldığını, her kaynak bloğu için Q değerleri üretildiğini ve epsilon-açgözlü seçimle bir blok belirlendiğini göstermektedir. Alt katmanda aktör ağı sürekli bir güç değeri üretmekte, eleştirmen ağları ise durum–eylem çiftinin beklenen getirisini değerlendirmektedir.
Double DQN neden kullanılmıştır?
Standart DQN, bir eylemi seçerken ve aynı eylemin değerini hesaplarken aynı ağdan yararlandığı için Q değerlerini olduğundan yüksek tahmin edebilir. Double DQN, eylem seçimini çevrim içi ağla, değer değerlendirmesini hedef ağla yaparak bu yanlılığı azaltmayı amaçlar:
\[ y=r+\gamma Q\left( s', \arg\max_{a'}Q(s',a';\theta); \theta^{-} \right) \]
Burada θ çevrim içi ağın, θ− hedef ağın parametrelerini; γ ise gelecekteki ödüllerin ağırlığını belirleyen iskonto katsayısını ifade eder.
Güç kontrolü nasıl yapılmıştır?
Aktör ağı 0 ile 1 arasında bir uy çıktısı üretmektedir. Bu çıktı güç sınırına şu eşlemeyle dönüştürülmüştür:
\[ p_y=(0{,}05+0{,}95u_y)P_{\max} \]
Bu eşleme eğitim sırasında sıfır güç seçilmesini engeller ve en düşük gücü azami gücün %5’i olarak belirler. Ancak optimizasyon kısıtlarında gücün sıfır olmasına izin verildiği için matematiksel model ile uygulama arasında küçük bir fark oluşmaktadır.
Alt katmanda iki eleştirmen ağı kullanılmıştır:
\[ y=r+\gamma\min \left(Q_1(s',a'),Q_2(s',a')\right) \]
İki Q değerinden düşük olanının kullanılması, değerlerin aşırı tahmin edilmesini azaltmayı amaçlar. Geciktirilmiş politika güncellemesi ve hedef eylem yumuşatma gibi TD3 esintili tekniklerin kullanıldığı belirtilmiştir. Buna karşın ağ katmanları, gizli boyutlar, aktivasyon fonksiyonları, hedef güncelleme katsayısı ve keşif gürültüsü gibi ayrıntılar verilmemiştir.
Merkezî eğitim ve dağıtık yürütme ne anlama gelmektedir?
Çalışma merkezî eğitim–dağıtık yürütme yaklaşımını benimsemektedir. Eğitim sırasında küresel ağ bilgilerine erişildiği, gerçek yürütme sırasında ise her D2D kullanıcısının yerel gözlemine göre karar verdiği belirtilmiştir.
D2D ajanı y için yerel durum; kestirilmiş doğrudan kanal kazancı, gözlenen girişim, önceki güç ve önceki kanalın kodlanmış gösteriminden oluşmaktadır:
\[ s_y^{\mathrm{local}}= \left[ \hat{g}_y^{(d)}, \hat{I}_y, p_y^{\mathrm{prev}}, e(c_y^{\mathrm{prev}}) \right] \]
Ancak kaç bağımsız ajanın bulunduğu, ağ parametrelerinin kullanıcılar arasında paylaşılıp paylaşılmadığı, merkezî eleştirmenin hangi küresel bilgiyi aldığı ve eşzamanlı kararların nasıl koordine edildiği ayrıntılı biçimde açıklanmamıştır.
Ödül fonksiyonu neyi dengelemektedir?
Temel ödül ifadesi toplam veri hızını ve adaleti artırırken kısıt ihlallerini cezalandırmaktadır:
\[ r_t=\alpha R_{\mathrm{sum}}+\beta J-\lambda\cdot\mathrm{Penalty} \]
Ceza teriminin SINR ihlallerini, hücresel kullanıcılara verilen aşırı girişimi ve fazla güç tüketimini kapsadığı belirtilmiştir. SINR ihlali için ayrıca şu ifade verilmiştir:
\[ \Phi_S=\sum_{i=1}^{N_d} \max(0,\gamma_{\min}-\mathrm{SINR}_i) \]
Ödül ağırlıkları olan α, β ve λ için kullanılan sayısal değerler açıklanmamaktadır. Bu değerler veri hızı ile adalet arasında hangi tercihin yapıldığını doğrudan etkilediğinden yeniden üretilebilirlik açısından önemlidir.
Çalışma PPO kullanıyor mu?
Giriş bölümünde “PPO tarzı politika optimizasyonu” ifadesi bulunmaktadır. Ancak yöntem bölümünde PPO’nun olasılık oranı, kırpılmış vekil amaç fonksiyonu veya avantaj kestirimi tanımlanmamıştır. Açıklanan gerçek mimari Double DQN ile TD3 benzeri ikiz eleştirmenli aktör–eleştirmen bileşimidir. Bu nedenle çalışmayı PPO tabanlı bir sistem olarak tanımlamak doğru değildir.
Deney düzeni nasıldır?
Simülasyonlar Python ve PyTorch kullanılarak NVIDIA A100 GPU bulunan bir bilgisayarda yürütülmüştür. Kanal modeli Rayleigh sönümlemesine dayanmakta, kısmi kanal bilgisi ise zamansal korelasyonlu Gauss gürültüsüyle temsil edilmektedir.
| Parametre | Çalışmada verilen değer |
|---|---|
| Hücre yarıçapı | 500 metre |
| Hücresel kullanıcı sayısı | 75 |
| D2D çifti sayısı | 110 |
| Eğitim bölümü | 200 episode |
| Her bölümdeki adım | 40 |
| Mini yığın büyüklüğü | 64 |
| Double DQN öğrenme oranı | 1 × 10⁻⁴ |
| Aktör öğrenme oranı | 1 × 10⁻⁴ |
| Eleştirmen öğrenme oranı | 2 × 10⁻⁴ |
| Rastgele tohumlar | 0, 1 ve 2 |
| İşlemci | Intel Xeon w7-2575X |
| Bellek | 128 GB |
| GPU | NVIDIA A100, 40 GB |
| Yazılım | PyTorch 2.7.1, CUDA 12.5, cuDNN 9.3, Python 3.13.7 |
Karşılaştırma yöntemleri klasik Q-learning, DQN ve kanal kazancına göre kaynak tahsisi yapan RACG sezgisel yöntemidir. Daha yakın mimariye sahip PPO, DDPG, TD3, düz hibrit aktör–eleştirmen veya modern çok-etmenli DRL temel çizgileri bulunmamaktadır.
Ana sonuçlar nelerdir?
| Yöntem | Toplam veri hızı (Mbps) | Jain adalet indeksi | Ortalama ödül |
|---|---|---|---|
| Q-Learning | 84,932 | 0,969 | 1,368 |
| DQN | 85,193 | 0,968 | 1,359 |
| RACG | 84,740 | 0,968 | 1,347 |
| Önerilen HDRL | 108,562 | 0,971 | 1,542 |
Önerilen yöntem, çalışmadaki DQN temel çizgisine göre toplam veri hızını yaklaşık %27,4, ortalama ödülü yaklaşık %13,5 artırmıştır. Adalet indeksindeki mutlak fark yalnızca 0,003’tür. Q-learning ile karşılaştırıldığında veri hızı artışı yaklaşık %27,8, RACG ile karşılaştırıldığında yaklaşık %28,1’dir.
Bu değerler kullanılan simülasyon içinde belirgin bir toplam veri hızı farkı göstermektedir. Ancak adalet bakımından bütün yöntemler zaten 0,968 ile 0,971 arasındaki dar aralıkta bulunmaktadır. Dolayısıyla HDRL’nin temel sayısal kazanımı adaletten çok toplam veri hızındadır.
Yakınsama grafikleri ne göstermektedir?
8. sayfadaki toplam veri hızı grafiğinde bütün yöntemler eğitimin başında yaklaşık 85 Mbps düzeyindedir. HDRL eğrisi 40–60. bölümler arasında hızla yükselerek yaklaşık 108–109 Mbps düzeyine ulaşmakta, diğer yöntemler ise 85 Mbps çevresinde kalmaktadır.
Adalet grafiğinde HDRL’nin eğitim sırasında geçici bir düşüş yaşadığı, ardından 0,971 çevresine toparlandığı görülmektedir. Ödül grafiğinde de yaklaşık 40. bölümden sonra belirgin bir sıçrama ve 1,55 çevresinde kararlı seyir bulunmaktadır.
Grafik başlıklarında ortalama ve standart sapma gösterildiği belirtilse de standart sapmalar tablo hâlinde verilmemiştir. Yalnızca üç rastgele tohum kullanılması, özellikle yüksek değişkenlik gösteren pekiştirmeli öğrenme deneylerinde sınırlı bir tekrar sayısıdır.
Ağ yoğunluğu arttığında ne olmuştur?
9. sayfadaki deneylerde hücresel kullanıcı ve D2D çifti sayıları sırasıyla şu yapılandırmalarda artırılmıştır:
- 25 hücresel kullanıcı ve 40 D2D çifti,
- 50 hücresel kullanıcı ve 75 D2D çifti,
- 75 hücresel kullanıcı ve 110 D2D çifti,
- 100 hücresel kullanıcı ve 150 D2D çifti,
- 125 hücresel kullanıcı ve 200 D2D çifti.
Toplam veri hızı bütün yöntemlerde kullanıcı sayısıyla yükselmiş, HDRL grafikte en yüksek eğriyi üretmiştir. HDRL yaklaşık 40 Mbps’den 200 Mbps’ye yükselirken en yakın temel çizgi yoğun yapılandırmada yaklaşık 155 Mbps’ye ulaşmıştır.
Adalet eğrisinde HDRL bütün yoğunluklarda yaklaşık 0,973–0,975 aralığında kalmaktadır. Ortalama ödül eğrisinde HDRL yaklaşık 1,54–1,57 aralığını korurken temel çizgilerin ödülleri yoğunluk arttıkça düşmektedir. Bununla birlikte kaynak bloğu kısıtının bu kullanıcı sayılarıyla nasıl uygulandığı açıklanmadığından ölçeklenebilirlik sonucunun matematiksel modelle uyumu belirsizdir.
Öğrenme oranı sonuçları nasıl etkilemiştir?
10. sayfadaki ilk grafik grubu 10−5, 5×10⁻⁵, 10−4 ve 5×10⁻⁴ öğrenme oranlarını karşılaştırmaktadır. Daha yüksek öğrenme oranları toplam veri hızı ve ödül bakımından daha hızlı yakınsama göstermiştir. En düşük öğrenme oranı daha yavaş ilerlemiş ve 200 bölüm sonunda daha düşük performansta kalmıştır.
Adalet değerleri eğitim sırasında dalgalanmış, bazı ayarlarda geçici düşüşler görülmüş, fakat eğriler çoğunlukla 0,96’nın üzerinde toparlanmıştır. Çalışma farklı öğrenme oranlarının sonuçlarını grafikle sunmakta, ancak her oran için son performans değerlerini ve varyansları tablo hâlinde vermemektedir.
Hangi optimizatör daha iyi sonuç vermiştir?
Adam, AdamW, RMSProp ve SGD optimizatörleri karşılaştırılmıştır. Adam, AdamW ve RMSProp toplam veri hızında SGD’den biraz daha hızlı yakınsamıştır. SGD ödül ve adalet eğrilerinde daha yüksek dalgalanma göstermiştir.
Grafiklere göre uyarlamalı optimizatörler benzer son veri hızlarına ulaşmaktadır. Bu nedenle sonuç, tek bir optimizatörün açık üstünlüğünden çok SGD’nin bu deneyde daha kararsız kaldığını göstermektedir.
Veri hızı–adalet dengesi ne göstermektedir?
10. sayfadaki son grafik toplam veri hızı ile Jain adalet indeksini aynı düzlemde karşılaştırmaktadır. HDRL yaklaşık 109 Mbps ve 0,972 adalet ile sağ üst bölgede yer alırken temel çizgiler yaklaşık 85–86 Mbps aralığında toplanmıştır.
Bu görünüm, HDRL’nin kullanılan deneyde toplam veri hızını artırırken adalet değerini koruduğunu göstermektedir. Ancak tek noktalı özet grafik, farklı ödül ağırlıkları altında oluşabilecek gerçek Pareto eğrisini göstermemektedir. Veri hızı ve adalet arasındaki tercihlerin daha güçlü değerlendirilebilmesi için farklı α ve β değerleriyle deney yapılması gerekir.
Çalışmanın desteklediği sonuçlar nelerdir?
- Ayrık kanal seçimi ile sürekli güç kontrolü hiyerarşik iki denetleyiciye ayrılabilir.
- Double DQN ve ikiz eleştirmenli aktör–eleştirmen birleşimi, kullanılan simülasyonda Q-learning, DQN ve RACG’den daha yüksek toplam veri hızı üretmiştir.
- Önerilen yöntem, veri hızı artarken Jain adalet indeksini yaklaşık aynı yüksek düzeyde tutmuştur.
- Ağ yoğunluğu arttığında HDRL eğrileri kullanılan temel çizgilerin üzerinde kalmıştır.
- Öğrenme oranı ve optimizatör seçimi yakınsama hızını ve eğitim kararlılığını etkilemiştir.
Çalışma neyi göstermemektedir?
- Yöntemin gerçek bir 5G baz istasyonu veya fiziksel D2D cihazları üzerinde çalıştığını göstermemektedir.
- Gecikme, paket kaybı, güvenilirlik, sinyalleşme yükü veya gerçek enerji tüketimi ölçülmemiştir.
- Modelin farklı CSI hata büyüklüklerinde dayanıklı olduğunu sistematik biçimde göstermemektedir.
- HDRL’nin çağdaş PPO, TD3, DDPG veya çok-etmenli yöntemlerden üstün olduğunu kanıtlamamaktadır.
- Dağıtık yürütmenin haberleşme maliyetini, karar gecikmesini veya güvenliğini değerlendirmemektedir.
- Türkiye’deki operatör ağlarında aynı sonuçların elde edileceğini göstermemektedir.
- Formülasyondaki kaynak bloğu tutarsızlığı çözülmeden bildirilen ölçeklenebilirliğin fiziksel olarak uygulanabilir olduğunu kanıtlamamaktadır.
Çalışmanın Yöntemi ve Bulguları
Yöntem akışının özeti
- Tek hücreli D2D destekli ağ ortamı oluşturulmuştur.
- Hücresel ve D2D kullanıcıları 500 metrelik hücre içine rastgele yerleştirilmiştir.
- Rayleigh sönümlemesi kullanılarak kanal kazançları üretilmiştir.
- Kanal kestirimlerine zamansal korelasyonlu Gauss gürültüsü eklenerek kısmi CSI oluşturulmuştur.
- Durum vektörüne kestirilmiş kanallar, önceki kanal ve önceki güç bilgileri aktarılmıştır.
- Double DQN üst katmanı kaynak bloğunu seçmiştir.
- Aktör ağı seçilen blok için iletim gücü üretmiştir.
- SINR, veri hızı, adalet ve ceza değerleri hesaplanmıştır.
- Geçişler deneyim tekrarı belleğine kaydedilmiştir.
- Double DQN, aktör, iki eleştirmen ve hedef ağlar güncellenmiştir.
- 200 bölüm sonunda sonuçlar temel yöntemlerle karşılaştırılmıştır.
Yöntem ayrıntılarının tamlık değerlendirmesi
| Bileşen | Çalışmada açıklanan bilgi | Eksik veya belirsiz bilgi |
|---|---|---|
| Kanal modeli | Rayleigh sönümlemesi | Yol kaybı modeli, gölgeleme, taşıyıcı frekans ve bant genişliği |
| Kısmi CSI | Gauss gürültüsü ve zamansal korelasyon | Gürültü varyansı ve korelasyon katsayısı |
| Üst denetleyici | Double DQN | Ağ katmanları, keşif takvimi ve hedef güncelleme sıklığı |
| Alt denetleyici | Aktör–eleştirmen, ikiz eleştirmen, geciktirilmiş güncelleme | Ağ mimarisi, eylem gürültüsü ve yumuşak güncelleme katsayısı |
| Deneyim tekrarı | Tekrar belleği kullanımı | Bellek kapasitesi ve önceliklendirme yöntemi |
| Ödül | Veri hızı, adalet ve ceza bileşenleri | Ağırlık katsayılarının sayısal değerleri |
| Güç modeli | Azami gücün %5–100 aralığı | Azami gücün sayısal değeri |
| Hizmet kalitesi | Asgari SINR kısıtları | Asgari SINR eşiklerinin değerleri |
| Tekrar sayısı | Üç rastgele tohum | Sayısal standart sapma ve güven aralıkları |
| Yeniden üretilebilirlik | Yazılım ve donanım sürümleri | Kaynak kodu ve simülasyon veri dosyaları |
Sayısal kazanımların bağlamı
108,562 Mbps değeri gerçek bir saha ölçümü değil, tanımlanan simülasyon ortamındaki toplam D2D veri hızıdır. Yüzde 27–28 civarındaki artış yalnızca seçilen üç temel çizgiye, aynı kanal modeline ve çalışmada kullanılan ödül ayarlarına göre geçerlidir.
Adalet indeksindeki artış sayısal olarak küçüktür. HDRL’nin 0,971 değeri DQN ve RACG’nin 0,968 değerinden 0,003, Q-learning’in 0,969 değerinden 0,002 yüksektir. Bu nedenle “adil kaynak tahsisi korunmuştur” ifadesi desteklenirken “adalette büyük iyileşme” ifadesi desteklenmemektedir.
Sonuçların güvenilirliğini artırmak için gereken deneyler
- Kaynak bloğu kısıtları ve kullanıcı sayılarının matematiksel olarak tutarlı hâle getirilmesi,
- Farklı kanal kestirim hata varyansları ve geri bildirim gecikmeleriyle CSI dayanıklılık taraması,
- PPO, TD3, DDPG, düz hibrit aktör–eleştirmen ve çok-etmenli DRL karşılaştırmaları,
- Hiyerarşi, ikiz eleştirmen, adalet ödülü ve CTDE bileşenleri için ablasyon deneyleri,
- En az beş veya on rastgele tohumla güven aralıkları ve istatistiksel karşılaştırmalar,
- Gecikme, enerji tüketimi, paket kaybı, QoS ihlal oranı ve hesaplama süresi ölçümleri,
- Farklı hücre yarıçapları, hareketlilik hızları ve kanal modelleriyle dış simülasyon doğrulaması,
- Kaynak kodunun, yapılandırma dosyalarının ve rastgele tohumların yayımlanması,
- Yazılım tanımlı radyo veya donanım döngülü test platformunda doğrulama.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: Hierarchical Deep Reinforcement Learning for Scalable Resource Allocation in D2D Communication under Partial Channel State Information in 5G Networks
Yazarlar: Rohit Singh Thakur ve Pavan Kumar Mishra
Yazar sıralaması: Rohit Singh Thakur, Pavan Kumar Mishra
Eş katkı bilgisi: Çalışmada eşit katkı veya eş birinci yazarlık beyanı bulunmamaktadır.
Sorumlu yazar: Rohit Singh Thakur. Görünür çalışmada yıldız işaretiyle, SSRN kaydında “Contact Author” olarak gösterilmiştir.
Kurum: Department of Information Technology, National Institute of Technology Raipur, India
Dergi: Çalışma bir dergide yayımlanmamıştır.
Özgün dergi yayınevi: Bulunmamaktadır.
Yayın platformu: SSRN
Yüklenme tarihi: 24 Haziran 2026
Yayın yılı: 2026
Kaynak türü: Simülasyon temelli deneysel kablosuz haberleşme ve derin pekiştirmeli öğrenme preprinti
Hakemlik durumu: Çalışma hakem değerlendirmesinden geçmemiştir. Sayfaların altında da “Preprint not peer reviewed” uyarısı bulunmaktadır.
Resmî bağlantı:SSRN çalışma sayfası
SSRN kayıt sayfasında ilk yazarın adı “Rohit Singh Singh Thakur” biçiminde yinelenmiştir. Görünür çalışma kapağında ve e-posta satırında “Rohit Singh Thakur” adı kullanılmaktadır. Bu makalede görünür çalışmadaki ad esas alınmıştır.
Bu Türkçe makale, yüklenen 12 sayfalık çalışmanın metni, denklemleri, tabloları, algoritması ve 11 şekli incelenerek hazırlanmıştır. Bilimsel sonuçlar yalnızca çalışmada bildirilen simülasyonlara dayanmaktadır. Dış kaynaklar başlık, yazar, kurum, DOI, platform, tarih ve hakemlik durumunun bibliyografik doğrulanması amacıyla kullanılmıştır.
Çalışmanın sonuçları; kaynak bloğu kısıtları ile kullanıcı sayıları arasındaki uyumsuzluk, kısmi CSI parametrelerinin eksikliği, sınırlı temel çizgiler, üç rastgele tohum, yayımlanmamış kaynak kodu ve saha doğrulamasının bulunmaması dikkate alınarak okunmalıdır. Bu çalışma gerçek bir 5G şebekesinde operasyonel başarı veya ticari kullanıma hazır bir çözüm kanıtlamamaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir