

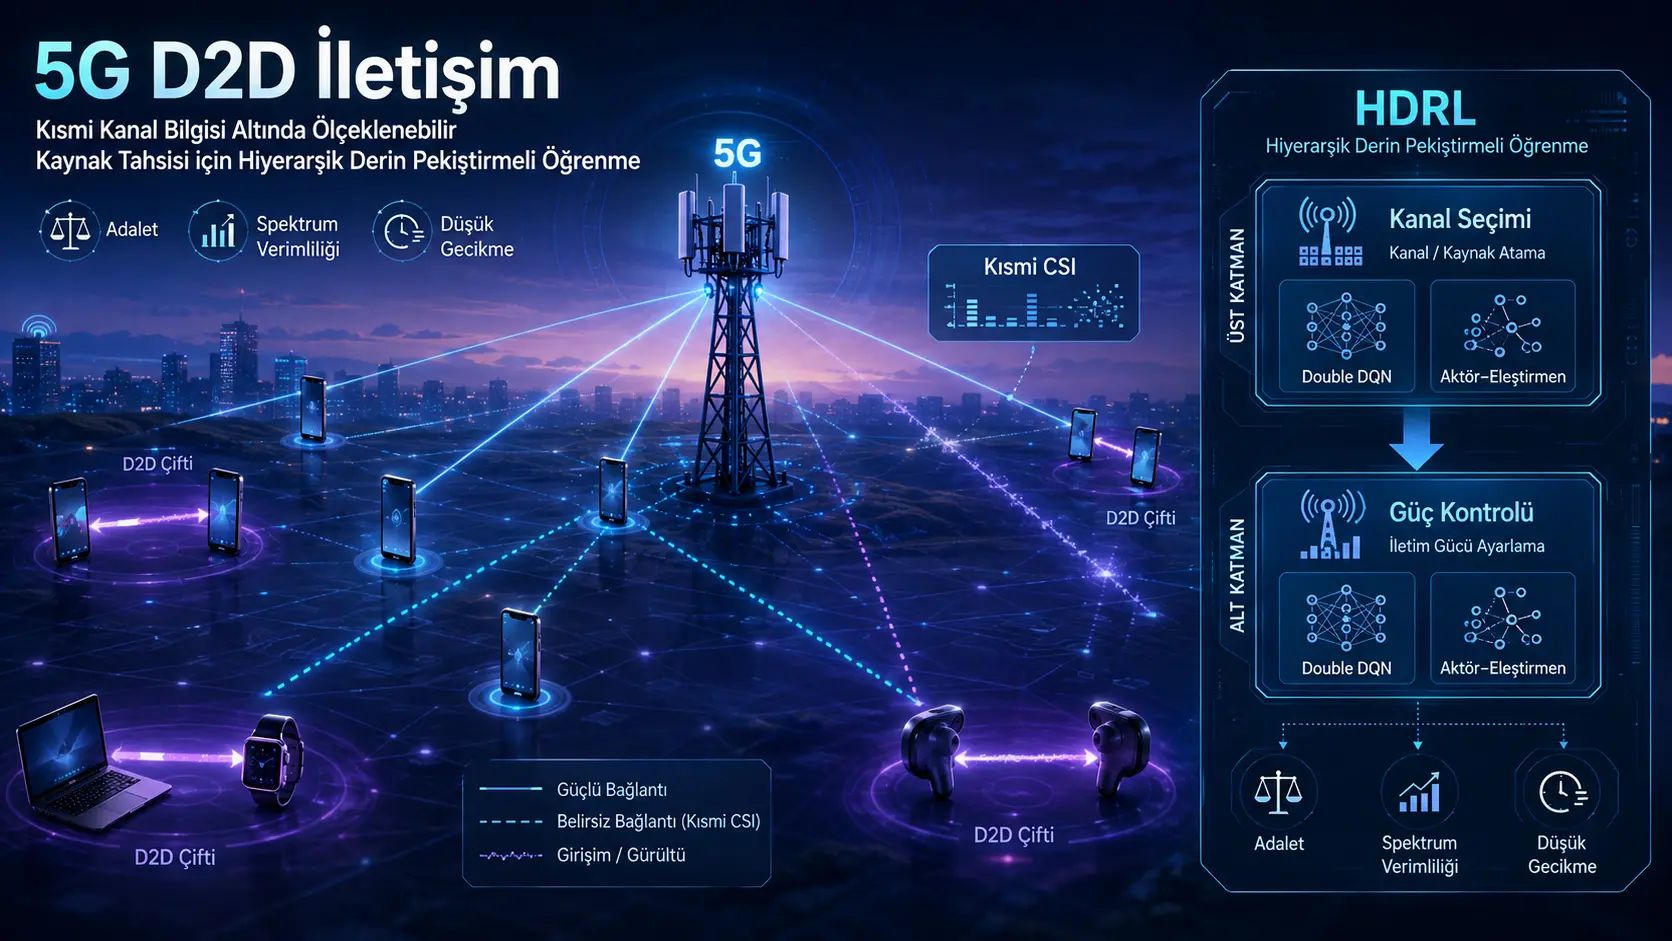
Utafiti huu umechunguza ugawaji wa chaneli na nguvu ya utumaji kwa mawasiliano ya kifaa-kwa-kifaa, ambayo huruhusu vifaa vilivyo karibu katika mitandao ya simu ya 5G kuwasiliana moja kwa moja bila kupitia kituo cha msingi. Watafiti wamependekeza mfumo wa tabaka mbili wa ujifunzaji wa kina wa uimarishaji wa kihierarkia ambao, katika hali ambapo taarifa kamili ya hali ya chaneli haipatikani, hufanya uteuzi wa kitalu cha rasilimali kwa Double DQN na udhibiti endelevu wa nguvu kwa muundo wa actor–critic wenye wakosoaji wawili. Katika uigaji, mbinu iliyopendekezwa ilifikia kasi ya jumla ya data ya 108,562 Mbps, faharasa ya haki ya Jain ya 0,971 na zawadi wastani ya 1,542. Hata hivyo, kuna kutolingana muhimu katika ugawaji wa rasilimali kati ya uundaji wa mfumo na idadi ya watumiaji; vigezo vya modeli ya taarifa ya sehemu ya chaneli na matokeo ya ustahimilivu dhidi ya viwango tofauti vya makosa hayajaelezwa.
Wazo kuu la mbinu iliyopendekezwa ni kutenganisha uteuzi wa chaneli wa kidijitali na udhibiti endelevu wa nguvu katika tabaka mbili zilizounganishwa za maamuzi badala ya kutatua zote katika nafasi moja kubwa ya vitendo. Kidhibiti cha ngazi ya juu huamua ni kitalu gani cha rasilimali ya selula kitakachotumiwa tena kwa kila jozi ya D2D. Kidhibiti cha ngazi ya chini hurekebisha nguvu ya utumaji itakayotumiwa katika kitalu cha rasilimali kilichochaguliwa. Kazi ya zawadi inalenga kuongeza kasi ya jumla ya data na haki kati ya watumiaji, huku ikipunguza ukiukaji wa mwingiliano, nguvu na ubora wa huduma.
Tathmini kwa mtazamo wa Uturuki: Mbinu hii inatoa mfano wa usimamizi wa rasilimali unaoweza kurekebishwa kwa timu za utafiti nchini Uturuki zinazofanya kazi kwenye mitandao binafsi ya 5G, viwanda mahiri, mifumo yenye msongamano mkubwa wa IoT, mawasiliano ya gari-kwa-gari, mitandao ya kampasi na mawasiliano wakati wa majanga. Hata hivyo, kabla ya matumizi halisi, uigaji wa vituo vingi unapaswa kufanywa kwa masafa yatakayotumiwa nchini Uturuki, msongamano wa vituo vya msingi, uhamaji, muundo wa majengo, kiwango cha mwingiliano na makosa ya ukadiriaji wa chaneli. Majaribio ya hardware-in-the-loop, majukwaa halisi ya majaribio ya redio, vipimo vya ucheleweshaji na nishati, pamoja na uthibitishaji wa nje kwenye mitandao ya waendeshaji tofauti pia vinahitajika. Haiwezi kuhitimishwa kutokana na utafiti huu kwamba ongezeko lilelile la kasi ya data litapatikana katika mitandao hai ya simu nchini Uturuki au kwamba mbinu hii iko tayari kutumiwa moja kwa moja.
Mawasiliano ya kifaa-kwa-kifaa ni nini?
Mawasiliano ya kifaa-kwa-kifaa huruhusu vifaa viwili vya watumiaji vilivyo karibu kuhamisha data moja kwa moja. Hivyo, si lazima kila wakati data iende kwenye kituo cha msingi na kisha itumwe tena kwa kifaa lengwa. Miunganisho ya D2D inaweza kutumia tena rasilimali za redio zilizotengwa kwa watumiaji wa selula ili kuongeza ufanisi wa wigo, kupunguza mzigo wa trafiki kwenye kituo cha msingi na kupunguza ucheleweshaji wa mawasiliano.
Faida hii si ya bure, kwa sababu kisambazaji cha D2D kinaweza kusababisha mwingiliano kwa mtumiaji wa selula au kituo cha msingi. Chaneli na nguvu ya utumaji ya miunganisho inayotumia kitalu kilekile cha rasilimali lazima ichaguliwe kwa pamoja. Matumizi ya nguvu kupita kiasi yanaweza kuongeza kasi ya data ya jozi moja ya D2D huku yakipunguza ubora wa ishara wa watumiaji wengine.
Kwa nini taarifa ya sehemu ya hali ya chaneli ni muhimu?
Taarifa ya hali ya chaneli huwakilisha ubora wa sasa wa kiungo cha redio kati ya kisambazaji na kipokezi. Kupata taarifa kamili ya chaneli ni vigumu katika mitandao halisi kutokana na uhamaji wa watumiaji, makosa ya ukadiriaji, ucheleweshaji wa mrejesho na mzigo wa kuashiria. Kwa hiyo, mfumo wa ugawaji wa rasilimali unaweza kulazimika kufanya maamuzi kwa kutumia makadirio yenye kelele au ucheleweshaji badala ya hali halisi ya chaneli.
Katika utafiti, chaneli za moja kwa moja za D2D na chaneli za mwingiliano ziliingizwa katika nafasi ya hali kwa thamani zilizokadiriwa badala ya thamani kamili. Maelezo ya uigaji yanasema kuwa taarifa ya sehemu ya chaneli ilitengenezwa kwa kutumia kelele ya Gaussian na uhusiano wa muda. Hata hivyo, varianzi ya kelele, mgawo wa uhusiano na usahihi wa ukadiriaji wa chaneli havijatolewa. Upungufu huu unafanya iwe vigumu kuzalisha upya hali za majaribio na kulinganisha modeli katika viwango tofauti vya kutokuwa na uhakika.
Modeli ya mfumo iliundwaje?
Utafiti ulitumia modeli ya mtandao wa seli moja. Kituo cha msingi huhudumia vifaa vya watumiaji wa selula na jozi za D2D. Kila mtumiaji wa selula alipewa kitalu kimoja cha rasilimali cha orthogonal, na jozi za D2D ziliruhusiwa kutumia tena vitalu hivyo.
Mchoro wa mfumo katika ukurasa wa 4 wa utafiti unaonyesha aina tano kuu za viungo:
- Kiungo muhimu cha uplink kutoka kwa mtumiaji wa selula hadi kituo cha msingi,
- Mwingiliano wa tabaka tofauti unaotoka kwa kisambazaji cha D2D kwenda kwenye kituo cha msingi,
- Mwingiliano wa tabaka tofauti unaotoka kwa mtumiaji wa selula kwenda kwa kipokezi cha D2D,
- Mwingiliano wa tabaka moja unaotokea kati ya visambazaji vya D2D,
- Kiungo cha moja kwa moja kati ya kisambazaji cha D2D na kipokezi chake chenyewe.
Kwa jozi ya D2D i, uwiano wa ishara-kwa-mwingiliano-pamoja-na-kelele umeundwa katika utafiti kama ifuatavyo:
\[ \gamma_i^{D} = \frac{p_i h_{i,i}} {\sum_{j \neq i} p_j h_{j,i} + p_{c_i}^{C} h_{c_i,i} + \sigma^2} \]
Sehemu ya juu inawakilisha nguvu ya ishara muhimu inayofika kutoka kwa kisambazaji cha D2D hadi kipokezi chake. Katika sehemu ya chini kuna mwingiliano wa tabaka moja kutoka kwa visambazaji vingine vya D2D, mwingiliano wa mtumiaji wa selula anayetumia kitalu kilekile cha rasilimali na kelele ya joto.
SINR ya mtumiaji wa selula k kwenye kituo cha msingi imetolewa kama ifuatavyo:
\[ \gamma_k^{C} = \frac{p_k^{C} h_{k,B}} {\sum_{i:c_i=k} p_i h_{i,B}+\sigma^2} \]
Matumizi tena ya rasilimali ya selula na miunganisho ya D2D huongeza mwingiliano kwenye ishara ya selula katika kituo cha msingi. Kwa hiyo, kudumisha thamani ya SINR ya watumiaji wa selula juu ya kizingiti cha chini kilichowekwa kumeainishwa kama sharti la ubora wa huduma.
Kasi ya data ilihesabiwaje?
Watafiti walihesabu kasi zinazoweza kufikiwa za data za miunganisho ya D2D na selula kwa kutumia usemi wa uwezo wa Shannon:
\[ R_i^{D}=B\log_2(1+\gamma_i^{D}) \]
\[ R_k^{C}=B\log_2(1+\gamma_k^{C}) \]
Hapa B ni upana wa chaneli, R ni kasi ya data na γ ni thamani ya SINR ya kiungo husika. Kasi ya jumla ya data ya D2D ni jumla ya kasi za jozi zote za D2D:
\[ R_{\mathrm{sum}}^{D}=\sum_{i=1}^{N_d}R_i^{D} \]
Haki kati ya watumiaji ilipimwaje?
Kuongeza tu kasi ya jumla ya data kunaweza kusababisha watumiaji wenye hali nzuri za chaneli kupewa rasilimali kila mara huku wengine wakiachwa nyuma. Kwa hiyo, utafiti ulitumia faharasa ya haki ya Jain:
\[ J = \frac{\left(\sum_i R_i^{D}\right)^2} {N_d\sum_i\left(R_i^{D}\right)^2} \]
Faharasa hupata thamani kati ya 0 na 1. Thamani inapokaribia 1, inaonyesha kuwa kasi za data za watumiaji wa D2D zimesambazwa kwa usawa zaidi. Hata hivyo, faharasa ya juu ya Jain peke yake haimaanishi kwamba watumiaji wote wanapata huduma ya kutosha; kasi ndogo lakini zinazokaribiana pia zinaweza kutoa thamani ya juu ya haki.
Ugawaji wa rasilimali ulifafanuliwa kwa lengo gani la uboreshaji?
Watafiti walifafanua tatizo la malengo mengi ambalo huongeza kasi ya jumla ya data, haki na ufanisi wa nishati, huku likiadhibu matumizi ya nguvu na ukiukaji wa SINR:
\[ \max_{\mathbf{c},\mathbf{p}} \alpha \bar{R}+\beta J+\eta E-\Phi_P-\Phi_S \]
Lengo hili lilizingatiwa pamoja na masharti ya kuweka nguvu za utumaji za D2D na selula ndani ya mipaka, kugawa kitalu cha rasilimali kwa kila jozi ya D2D, kudumisha vizingiti vya SINR na kuweka faharasa ya haki juu ya kikomo cha chini kilichowekwa.
Tatizo la kitalu cha rasilimali katika uundaji ni nini?
Sharti la C3 la utafiti linahitaji kila jozi ya D2D ichague kitalu kimoja kutoka kwenye seti ya rasilimali za selula. Sharti la C4 linasema kuwa kitalu kimoja cha rasilimali ya selula kinaweza kutumiwa na jozi moja tu ya D2D kwa kiwango cha juu:
\[ \sum_{i:c_i=k}1\leq 1 \]
Katika jedwali la uigaji kuna watumiaji 75 wa selula na jozi 110 za D2D. Ikiwa kila mtumiaji wa selula ana kitalu kimoja tu cha rasilimali, vitalu 75 vinapatikana. Ikiwa kila jozi ya D2D lazima ichague kitalu na kila kitalu kinaweza kutumiwa na jozi moja tu kwa kiwango cha juu, haiwezekani kugawa jozi 110 kwenye vitalu 75.
Katika majaribio ya msongamano wa mtandao pia zilitumika jozi 40 za D2D dhidi ya watumiaji 25 wa selula, 75 dhidi ya 50, 110 dhidi ya 75, 150 dhidi ya 100 na 200 dhidi ya 125. Katika usanidi wote idadi ya jozi za D2D ni kubwa kuliko idadi ya vitalu vya rasilimali. Haijawekwa wazi kama modeli kwa kweli inaruhusu jozi nyingi za D2D kutumia kitalu kilekile, inaacha baadhi ya jozi bila huduma au sharti la C4 limeandikwa vibaya.
Zaidi ya hayo, ikiwa C4 inatekelezwa kweli, hakutakuwa na jozi mbili za D2D katika kitalu kilekile cha rasilimali, hivyo haieleweki jinsi jumla ya mwingiliano wa tabaka moja wa D2D–D2D katika mlinganyo wa SINR wa D2D inavyotokea. Kutolingana huku kwa ndani ni mojawapo ya vikwazo muhimu zaidi katika kutafsiri matokeo.
Kwa nini tatizo liligawanywa kihierarkia?
Uteuzi wa chaneli ni uamuzi wa kidijitali, wakati udhibiti wa nguvu ni uamuzi endelevu. Kuunganisha maamuzi yote mawili katika nafasi moja tambarare ya vitendo huunda tatizo kubwa sana na changamano la maamuzi kadiri idadi ya watumiaji inavyoongezeka. Kwa hiyo, utafiti uligawa kazi katika tabaka mbili:
- Tabaka la juu: Uteuzi wa kitalu cha rasilimali au chaneli kwa Double DQN.
- Tabaka la chini: Uamuzi wa nguvu endelevu ya utumaji kwa mtandao wa actor–critic.
Mchoro wa usanifu katika ukurasa wa 6 unaonyesha kuwa katika tabaka la juu hali ya ingizo hupelekwa kwenye mtandao wa DQN, thamani za Q hutolewa kwa kila kitalu cha rasilimali na kitalu huchaguliwa kwa uteuzi wa epsilon-greedy. Katika tabaka la chini mtandao wa actor hutoa thamani endelevu ya nguvu, huku mitandao ya critic ikitathmini marejesho yanayotarajiwa ya jozi ya hali–kitendo.
Kwa nini Double DQN ilitumika?
DQN ya kawaida inaweza kukadiria thamani za Q juu kuliko zilivyo kwa sababu hutumia mtandao huo huo wakati wa kuchagua kitendo na kukokotoa thamani ya kitendo hicho. Double DQN inalenga kupunguza upendeleo huu kwa kufanya uteuzi wa kitendo kwa mtandao wa mtandaoni na tathmini ya thamani kwa mtandao lengwa:
\[ y=r+\gamma Q\left( s', \arg\max_{a'}Q(s',a';\theta); \theta^{-} \right) \]
Hapa θ inawakilisha vigezo vya mtandao wa mtandaoni, θ− vigezo vya mtandao lengwa, na γ mgawo wa punguzo unaoamua uzito wa zawadi za baadaye.
Udhibiti wa nguvu ulifanywaje?
Mtandao wa actor hutoa uy kati ya 0 na 1. Tokeo hili lilibadilishwa kuwa kikomo cha nguvu kwa ulinganishaji ufuatao:
\[ p_y=(0{,}05+0{,}95u_y)P_{\max} \]
Ulinganishaji huu huzuia kuchaguliwa kwa nguvu sifuri wakati wa mafunzo na huweka nguvu ya chini kuwa %5 ya nguvu ya juu. Hata hivyo, kwa kuwa vikwazo vya uboreshaji huruhusu nguvu kuwa sifuri, kuna tofauti ndogo kati ya modeli ya kihisabati na utekelezaji.
Katika tabaka la chini zilitumika mitandao miwili ya critic:
\[ y=r+\gamma\min \left(Q_1(s',a'),Q_2(s',a')\right) \]
Kutumia thamani ya chini kati ya thamani mbili za Q kunalenga kupunguza ukadiriaji wa juu kupita kiasi. Imeelezwa kuwa mbinu zilizoongozwa na TD3, kama sasisho lililocheleweshwa la sera na ulainishaji wa kitendo lengwa, zimetumika. Hata hivyo, maelezo kama tabaka za mtandao, vipimo vilivyofichwa, vitendaji vya uanzishaji, mgawo wa sasisho la lengo na kelele ya uchunguzi hayajatolewa.
Mafunzo ya kati na utekelezaji uliosambazwa yanamaanisha nini?
Utafiti unatumia mbinu ya mafunzo ya kati–utekelezaji uliosambazwa. Imeelezwa kuwa wakati wa mafunzo kuna ufikiaji wa taarifa za kimataifa za mtandao, lakini wakati wa utekelezaji halisi kila mtumiaji wa D2D hufanya uamuzi kulingana na uchunguzi wake wa ndani.
Kwa wakala wa D2D y, hali ya ndani inajumuisha faida ya chaneli ya moja kwa moja iliyokadiriwa, mwingiliano ulioonekana, nguvu ya awali na uwakilishi uliosimbwa wa chaneli ya awali:
\[ s_y^{\mathrm{local}}= \left[ \hat{g}_y^{(d)}, \hat{I}_y, p_y^{\mathrm{prev}}, e(c_y^{\mathrm{prev}}) \right] \]
Hata hivyo, idadi ya mawakala huru, kama vigezo vya mtandao vinashirikiwa kati ya watumiaji, ni taarifa gani za kimataifa critic wa kati anapokea na jinsi maamuzi ya wakati mmoja yanavyoratibiwa havijaelezwa kwa kina.
Kazi ya zawadi husawazisha nini?
Usemi mkuu wa zawadi huongeza kasi ya jumla ya data na haki huku ukiadhibu ukiukaji wa vikwazo:
\[ r_t=\alpha R_{\mathrm{sum}}+\beta J-\lambda\cdot\mathrm{Penalty} \]
Imeelezwa kuwa kipengele cha adhabu kinajumuisha ukiukaji wa SINR, mwingiliano wa kupita kiasi unaotolewa kwa watumiaji wa selula na matumizi makubwa ya nguvu. Kwa ukiukaji wa SINR pia umetolewa usemi ufuatao:
\[ \Phi_S=\sum_{i=1}^{N_d} \max(0,\gamma_{\min}-\mathrm{SINR}_i) \]
Thamani za nambari zilizotumiwa kwa uzito wa zawadi α, β na λ hazijaelezwa. Thamani hizi ni muhimu kwa uzalishaji upya kwa sababu zinaathiri moja kwa moja upendeleo kati ya kasi ya data na haki.
Je, utafiti unatumia PPO?
Katika utangulizi kuna usemi “uboreshaji wa sera wa mtindo wa PPO”. Hata hivyo, katika sehemu ya mbinu hakuna ufafanuzi wa uwiano wa uwezekano wa PPO, kazi ya lengo mbadala iliyokatwa au ukadiriaji wa faida. Usanifu halisi ulioelezwa ni mchanganyiko wa Double DQN na actor–critic wa critic wawili unaofanana na TD3. Kwa hiyo si sahihi kuuelezea utafiti kama mfumo unaotegemea PPO.
Mpangilio wa majaribio ulikuwaje?
Uigaji ulifanywa kwa kutumia Python na PyTorch kwenye kompyuta yenye GPU ya NVIDIA A100. Modeli ya chaneli inategemea Rayleigh fading, na taarifa ya sehemu ya chaneli inawakilishwa na kelele ya Gaussian yenye uhusiano wa muda.
| Kigezo | Thamani iliyotolewa katika utafiti |
|---|---|
| Radiusi ya seli | 500 metre |
| Idadi ya watumiaji wa selula | 75 |
| Idadi ya jozi za D2D | 110 |
| Kipindi cha mafunzo | 200 episode |
| Hatua katika kila kipindi | 40 |
| Ukubwa wa mini-batch | 64 |
| Kiwango cha kujifunza cha Double DQN | 1 × 10⁻⁴ |
| Kiwango cha kujifunza cha actor | 1 × 10⁻⁴ |
| Kiwango cha kujifunza cha critic | 2 × 10⁻⁴ |
| Mbegu nasibu | 0, 1 na 2 |
| Kichakataji | Intel Xeon w7-2575X |
| Kumbukumbu | 128 GB |
| GPU | NVIDIA A100, 40 GB |
| Programu | PyTorch 2.7.1, CUDA 12.5, cuDNN 9.3, Python 3.13.7 |
Mbinu za kulinganisha ni Q-learning ya kawaida, DQN na mbinu ya kihisabati ya RACG inayogawa rasilimali kulingana na faida ya chaneli. Hakuna mistari ya msingi yenye usanifu unaokaribiana zaidi kama PPO, DDPG, TD3, actor–critic mseto tambarare au DRL ya kisasa ya mawakala wengi.
Matokeo makuu ni yapi?
| Mbinu | Kasi ya jumla ya data (Mbps) | Faharasa ya haki ya Jain | Zawadi wastani |
|---|---|---|---|
| Q-Learning | 84,932 | 0,969 | 1,368 |
| DQN | 85,193 | 0,968 | 1,359 |
| RACG | 84,740 | 0,968 | 1,347 |
| HDRL iliyopendekezwa | 108,562 | 0,971 | 1,542 |
Mbinu iliyopendekezwa iliongeza kasi ya jumla ya data kwa takribani %27,4 na zawadi wastani kwa takribani %13,5 ikilinganishwa na mstari wa msingi wa DQN katika utafiti. Tofauti kamili katika faharasa ya haki ni 0,003 tu. Ikilinganishwa na Q-learning, ongezeko la kasi ya data ni takribani %27,8, na ikilinganishwa na RACG ni takribani %28,1.
Thamani hizi zinaonyesha tofauti dhahiri katika kasi ya jumla ya data ndani ya uigaji uliotumiwa. Hata hivyo, kwa upande wa haki, mbinu zote tayari ziko katika safu nyembamba ya 0,968 hadi 0,971. Kwa hiyo, faida kuu ya nambari ya HDRL iko zaidi katika kasi ya jumla ya data kuliko katika haki.
Grafu za muunganiko zinaonyesha nini?
Katika grafu ya kasi ya jumla ya data kwenye ukurasa wa 8, mbinu zote ziko takribani katika kiwango cha 85 Mbps mwanzoni mwa mafunzo. Mstari wa HDRL unapanda haraka kati ya vipindi vya 40–60. na kufikia takribani 108–109 Mbps, huku mbinu nyingine zikibaki karibu na 85 Mbps.
Katika grafu ya haki, inaonekana HDRL hupitia kushuka kwa muda wakati wa mafunzo na baadaye kurejea karibu na 0,971. Katika grafu ya zawadi pia kuna kuruka dhahiri baada ya takribani kipindi cha 40. na mwendo thabiti karibu na 1,55.
Ingawa vichwa vya grafu vinaeleza kuwa wastani na mkengeuko wa kawaida vinaonyeshwa, mkengeuko wa kawaida haujatolewa katika jedwali. Kutumia mbegu nasibu tatu tu ni idadi ndogo ya marudio, hasa kwa majaribio ya ujifunzaji wa uimarishaji yenye utofauti mkubwa.
Nini kilitokea msongamano wa mtandao ulipoongezeka?
Katika majaribio ya ukurasa wa 9, idadi ya watumiaji wa selula na jozi za D2D iliongezwa mtawalia katika usanidi ufuatao:
- Watumiaji 25 wa selula na jozi 40 za D2D,
- Watumiaji 50 wa selula na jozi 75 za D2D,
- Watumiaji 75 wa selula na jozi 110 za D2D,
- Watumiaji 100 wa selula na jozi 150 za D2D,
- Watumiaji 125 wa selula na jozi 200 za D2D.
Kasi ya jumla ya data iliongezeka kwa idadi ya watumiaji katika mbinu zote, na HDRL ikatoa mstari wa juu zaidi kwenye grafu. HDRL iliongezeka kutoka takribani 40 Mbps hadi 200 Mbps, huku mstari wa msingi wa karibu zaidi ukifikia takribani 155 Mbps katika usanidi wenye msongamano mkubwa.
Katika mstari wa haki HDRL inabaki katika safu ya takribani 0,973–0,975 katika msongamano wote. Katika mstari wa zawadi wastani HDRL inadumisha safu ya takribani 1,54–1,57, huku zawadi za mistari ya msingi zikishuka kadiri msongamano unavyoongezeka. Hata hivyo, kwa kuwa haijaelezwa jinsi sharti la kitalu cha rasilimali lilivyotumika kwa idadi hii ya watumiaji, ulinganifu wa matokeo ya scalability na modeli ya kihisabati hauko wazi.
Kiwango cha kujifunza kiliathirije matokeo?
Kundi la kwanza la grafu kwenye ukurasa wa 10 linalinganisha viwango vya kujifunza vya 10−5, 5×10⁻⁵, 10−4 na 5×10⁻⁴. Viwango vya juu zaidi vya kujifunza vilionyesha muunganiko wa haraka zaidi kwa kasi ya jumla ya data na zawadi. Kiwango cha chini kabisa cha kujifunza kiliendelea polepole zaidi na kubaki katika utendaji wa chini baada ya vipindi 200.
Thamani za haki zilibadilika wakati wa mafunzo, kushuka kwa muda kulionekana katika baadhi ya mipangilio, lakini mistari kwa ujumla ilirudi juu ya 0,96. Utafiti unaonyesha matokeo ya viwango tofauti vya kujifunza kwa grafu, lakini hautoi thamani za mwisho za utendaji na varianzi kwa kila kiwango katika jedwali.
Ni optimizer ipi ilitoa matokeo bora?
Optimizer za Adam, AdamW, RMSProp na SGD zililinganishwa. Adam, AdamW na RMSProp zilifikia muunganiko kwa kasi kidogo zaidi kuliko SGD katika kasi ya jumla ya data. SGD ilionyesha mabadiliko makubwa zaidi katika grafu za zawadi na haki.
Kulingana na grafu, optimizer zinazojibadilisha hufikia kasi za mwisho za data zinazofanana. Kwa hiyo, matokeo hayaonyeshi ubora wazi wa optimizer moja, bali yanaonyesha kwamba SGD ilikuwa na kutokuwa thabiti zaidi katika jaribio hili.
Usawazishaji wa kasi ya data–haki unaonyesha nini?
Grafu ya mwisho kwenye ukurasa wa 10 inalinganisha kasi ya jumla ya data na faharasa ya haki ya Jain katika tambarare moja. HDRL iko katika eneo la juu kulia ikiwa na takribani 109 Mbps na haki ya 0,972, huku mistari ya msingi ikikusanyika katika safu ya takribani 85–86 Mbps.
Mwonekano huu unaonyesha kwamba HDRL iliongeza kasi ya jumla ya data katika jaribio lililotumiwa huku ikihifadhi thamani ya haki. Hata hivyo, grafu ya muhtasari ya nukta moja haionyeshi mkunjo halisi wa Pareto ambao unaweza kutokea chini ya uzito tofauti za zawadi. Ili kutathmini kwa nguvu zaidi chaguo kati ya kasi ya data na haki, majaribio yanapaswa kufanywa kwa thamani tofauti za α na β.
Utafiti unaunga mkono matokeo gani?
- Uteuzi wa chaneli wa kidijitali na udhibiti endelevu wa nguvu unaweza kutenganishwa katika vidhibiti viwili vya kihierarkia.
- Mchanganyiko wa Double DQN na actor–critic mwenye wakosoaji wawili ulitoa kasi ya jumla ya data iliyo juu kuliko Q-learning, DQN na RACG katika uigaji uliotumiwa.
- Mbinu iliyopendekezwa ilidumisha faharasa ya haki ya Jain karibu na kiwango kilekile cha juu huku kasi ya data ikiongezeka.
- Msongamano wa mtandao ulipoongezeka, mistari ya HDRL ilibaki juu ya mistari ya msingi iliyotumiwa.
- Kiwango cha kujifunza na uteuzi wa optimizer viliathiri kasi ya muunganiko na uthabiti wa mafunzo.
Utafiti hauonyeshi nini?
- Hauonyeshi kwamba mbinu inafanya kazi kwenye kituo halisi cha msingi cha 5G au vifaa halisi vya D2D.
- Ucheleweshaji, upotevu wa pakiti, kutegemewa, mzigo wa kuashiria au matumizi halisi ya nishati hayajapimwa.
- Hauonyeshi kwa utaratibu kwamba modeli ni thabiti katika ukubwa tofauti wa makosa ya CSI.
- Haithibitishi kwamba HDRL ni bora kuliko mbinu za kisasa za PPO, TD3, DDPG au mawakala wengi.
- Hautathmini gharama ya mawasiliano, ucheleweshaji wa maamuzi au usalama wa utekelezaji uliosambazwa.
- Hauonyeshi kwamba matokeo yaleyale yatapatikana katika mitandao ya waendeshaji nchini Uturuki.
- Bila kutatua kutolingana kwa kitalu cha rasilimali katika uundaji, haithibitishi kwamba scalability iliyoripotiwa inaweza kutekelezwa kimwili.
Mbinu na Matokeo ya Utafiti
Muhtasari wa mtiririko wa mbinu
- Mazingira ya mtandao wa seli moja unaosaidia D2D yaliundwa.
- Watumiaji wa selula na D2D waliwekwa nasibu ndani ya seli ya metre 500.
- Faida za chaneli zilitengenezwa kwa kutumia Rayleigh fading.
- CSI ya sehemu iliundwa kwa kuongeza kelele ya Gaussian yenye uhusiano wa muda kwenye makadirio ya chaneli.
- Chaneli zilizokadiriwa, chaneli ya awali na taarifa ya nguvu ya awali ziliingizwa katika vekta ya hali.
- Tabaka la juu la Double DQN lilichagua kitalu cha rasilimali.
- Mtandao wa actor ulitoa nguvu ya utumaji kwa kitalu kilichochaguliwa.
- SINR, kasi ya data, haki na thamani za adhabu zilihesabiwa.
- Mabadiliko yalihifadhiwa katika kumbukumbu ya experience replay.
- Double DQN, actor, critics wawili na mitandao lengwa zilisasishwa.
- Baada ya vipindi 200, matokeo yalilinganishwa na mbinu za msingi.
Tathmini ya ukamilifu wa maelezo ya mbinu
| Kipengele | Taarifa iliyoelezwa katika utafiti | Taarifa iliyokosekana au isiyo wazi |
|---|---|---|
| Modeli ya chaneli | Rayleigh fading | Modeli ya path loss, shadowing, carrier frequency na channel bandwidth |
| CSI ya sehemu | Kelele ya Gaussian na uhusiano wa muda | Varianzi ya kelele na mgawo wa uhusiano |
| Kidhibiti cha juu | Double DQN | Tabaka za mtandao, ratiba ya uchunguzi na mzunguko wa sasisho la lengo |
| Kidhibiti cha chini | Actor–critic, critics wawili, sasisho lililocheleweshwa | Usanifu wa mtandao, kelele ya kitendo na mgawo wa soft update |
| Experience replay | Matumizi ya replay memory | Uwezo wa kumbukumbu na mbinu ya kuweka vipaumbele |
| Zawadi | Vipengele vya kasi ya data, haki na adhabu | Thamani za nambari za coefficients za uzito |
| Modeli ya nguvu | Safu ya %5–100 ya nguvu ya juu | Thamani ya nambari ya nguvu ya juu |
| Ubora wa huduma | Vikwazo vya SINR ya chini | Thamani za vizingiti vya SINR ya chini |
| Idadi ya marudio | Mbegu tatu nasibu | Mkengeuko wa kawaida wa nambari na vipindi vya kujiamini |
| Uzalishaji upya | Matoleo ya programu na maunzi | Source code na faili za data za uigaji |
Muktadha wa faida za nambari
Thamani ya 108,562 Mbps si kipimo halisi cha uwanjani, bali ni kasi ya jumla ya data ya D2D katika mazingira ya uigaji yaliyofafanuliwa. Ongezeko la takribani %27–28 linatumika tu dhidi ya mistari mitatu ya msingi iliyochaguliwa, modeli ileile ya chaneli na mipangilio ya zawadi iliyotumiwa katika utafiti.
Ongezeko la faharasa ya haki ni dogo kwa nambari. Thamani ya 0,971 ya HDRL ni 0,003 juu ya 0,968 ya DQN na RACG, na 0,002 juu ya 0,969 ya Q-learning. Kwa hiyo, kauli kwamba “ugawaji wa rasilimali wenye haki ulidumishwa” inaungwa mkono, lakini kauli kwamba “kulikuwa na uboreshaji mkubwa wa haki” haiungwi mkono.
Majaribio yanayohitajika kuongeza kutegemewa kwa matokeo
- Kufanya vikwazo vya kitalu cha rasilimali na idadi ya watumiaji viwe sawa kihisabati,
- Uchunguzi wa ustahimilivu wa CSI kwa varianzi tofauti za makosa ya ukadiriaji wa chaneli na ucheleweshaji wa mrejesho,
- Ulinganisho wa PPO, TD3, DDPG, actor–critic mseto tambarare na DRL ya mawakala wengi,
- Majaribio ya ablation kwa vipengele vya hierarchy, critics wawili, zawadi ya haki na CTDE,
- Vipindi vya kujiamini na ulinganisho wa takwimu kwa angalau mbegu tano au kumi nasibu,
- Vipimo vya ucheleweshaji, matumizi ya nishati, upotevu wa pakiti, kiwango cha ukiukaji wa QoS na muda wa kukokotoa,
- Uthibitishaji wa nje wa uigaji kwa radiusi tofauti za seli, kasi za uhamaji na modeli za chaneli,
- Kuchapisha source code, faili za usanidi na mbegu nasibu,
- Uthibitishaji kwenye jukwaa la software-defined radio au hardware-in-the-loop.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la utafiti: Hierarchical Deep Reinforcement Learning for Scalable Resource Allocation in D2D Communication under Partial Channel State Information in 5G Networks
Waandishi: Rohit Singh Thakur na Pavan Kumar Mishra
Mpangilio wa waandishi: Rohit Singh Thakur, Pavan Kumar Mishra
Taarifa ya mchango sawa: Hakuna tamko la mchango sawa au uandishi mwenza wa kwanza katika utafiti.
Mwandishi wa mawasiliano: Rohit Singh Thakur. Ameonyeshwa kwa alama ya nyota katika utafiti unaoonekana na kama “Contact Author” katika rekodi ya SSRN.
Taasisi: Department of Information Technology, National Institute of Technology Raipur, India
Jarida: Utafiti haujachapishwa katika jarida.
Mchapishaji wa jarida asilia: Hakuna.
Jukwaa la uchapishaji: SSRN
Tarehe ya kupakiwa: 24 Juni 2026
Mwaka wa uchapishaji: 2026
Aina ya chanzo: Preprint ya utafiti wa majaribio ya mawasiliano yasiyotumia waya na ujifunzaji wa kina wa uimarishaji unaotegemea uigaji
Hali ya mapitio ya kitaalamu: Utafiti haujapitia mapitio ya kitaalamu. Pia kuna onyo la “Preprint not peer reviewed” chini ya kurasa.
Kiungo rasmi:Ukurasa wa utafiti wa SSRN
Kwenye ukurasa wa rekodi ya SSRN jina la mwandishi wa kwanza limerudiwa kama “Rohit Singh Singh Thakur”. Kwenye jalada la utafiti unaoonekana na mstari wa barua pepe, jina “Rohit Singh Thakur” limetumika. Katika makala hii, jina lililo katika utafiti unaoonekana limechukuliwa kuwa msingi.
Makala hii ya Kituruki imeandaliwa kwa kuchunguza maandishi, milinganyo, majedwali, algoriti na vielelezo 11 vya utafiti wa kurasa 12 uliopakiwa. Matokeo ya kisayansi yanategemea tu uigaji ulioripotiwa katika utafiti. Vyanzo vya nje vimetumiwa tu kwa uthibitishaji wa kibibliografia wa kichwa, waandishi, taasisi, DOI, jukwaa, tarehe na hali ya mapitio ya kitaalamu.
Matokeo ya utafiti yanapaswa kusomwa kwa kuzingatia kutolingana kati ya vikwazo vya kitalu cha rasilimali na idadi ya watumiaji, ukosefu wa vigezo vya CSI ya sehemu, mistari ya msingi iliyo na mipaka, mbegu tatu nasibu, source code ambayo haijachapishwa na kutokuwepo kwa uthibitishaji wa uwanjani. Utafiti huu hauthibitishi mafanikio ya kiutendaji katika mtandao halisi wa 5G au suluhisho lililo tayari kwa matumizi ya kibiashara.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *