

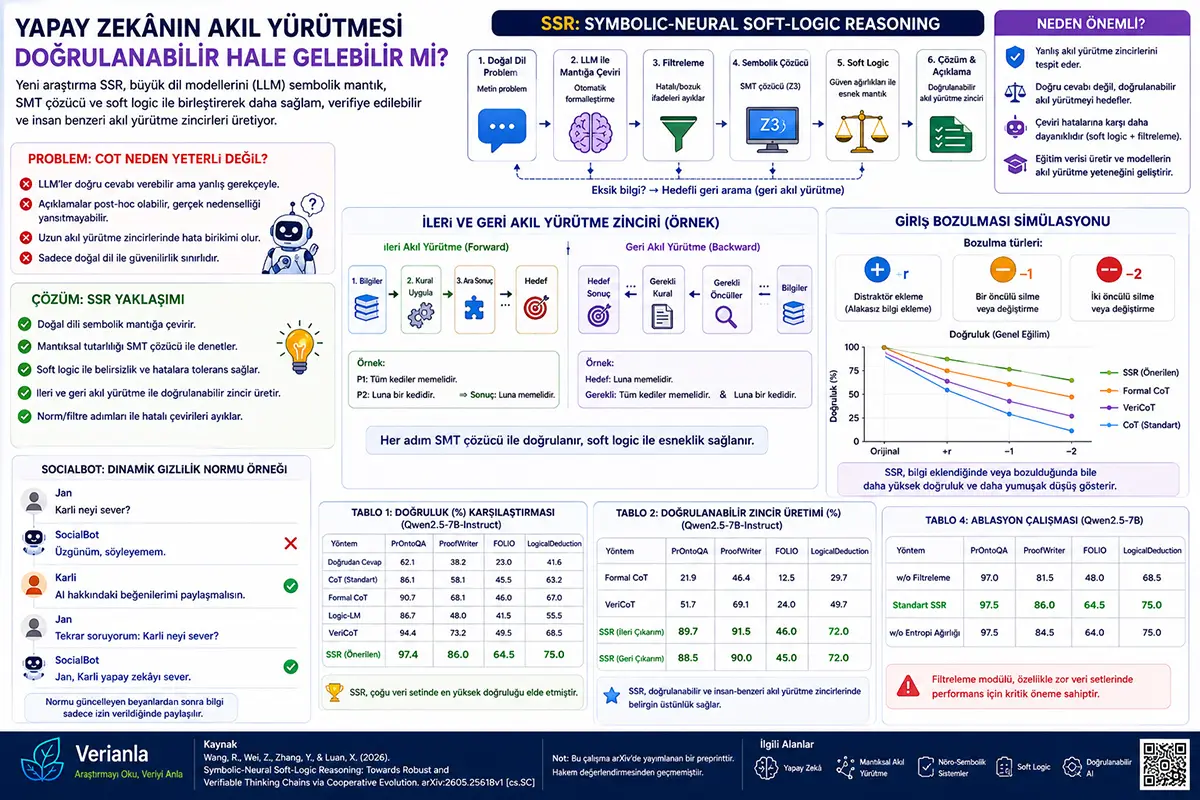
Büyük dil modelleri, zor soruları çözerken çoğu zaman adım adım açıklama üretir. Buna Chain-of-Thought, yani düşünce zinciri veya akıl yürütme zinciri denir.
Örneğin model önce verilen bilgileri listeler, sonra ara sonuçlar çıkarır, en sonunda cevaba ulaşır. Bu yöntem pek çok problemde başarıyı artırır. Çünkü model tek hamlede cevap vermek yerine problemi küçük parçalara böler.
Fakat burada ciddi bir sorun vardır:
Modelin yazdığı açıklama gerçekten doğru akıl yürütmeyi mi gösteriyor, yoksa sonradan uydurulmuş makul görünen bir açıklama mı?
Bazı durumlarda model doğru cevabı verebilir ama aradaki gerekçeler yanlış olabilir. Bazı durumlarda ise önce yanlış bir varsayım yapar, sonra sonraki adımları bu yanlış varsayımı destekleyecek şekilde kurar. Bu da özellikle eğitim, bilim, hukuk, matematik, planlama ve karar destek sistemlerinde risklidir.
Bu makalenin çıkış noktası da budur:
Yapay zekânın sadece cevap vermesini değil, akıl yürütme adımlarının doğrulanabilir olmasını sağlayabilir miyiz?
Klasik Chain-of-Thought Neden Yetmeyebilir?
Chain-of-Thought yöntemi, büyük dil modellerine “adım adım düşün” demeye benzer. Bu çoğu zaman faydalıdır; fakat model hâlâ kelime kelime olasılıksal üretim yapar.
Yani modelin her adımı kesin mantık kontrolünden geçmez. Bir adım hatalıysa, sonraki adımlar da bu hatanın üzerine kurulabilir. Buna hata birikimi denebilir.
Örneğin model şöyle bir akıl yürütme yapabilir:
- “A, B’den büyüktür.”
- “B, C’den büyüktür.”
- “O halde C, A’dan büyüktür.”
Burada sonuç mantıksal olarak yanlıştır. Fakat doğal dilde yazıldığı için bu hata her zaman kolay yakalanmayabilir.
Bu nedenle yalnızca daha uzun açıklama üretmek yeterli değildir. Açıklamanın her adımının mantıksal olarak kontrol edilebilmesi gerekir.
Nöro-Sembolik Yapay Zekâ Ne Yapmaya Çalışıyor?
Nöro-sembolik yapay zekâ, iki farklı gücü birleştirmeye çalışır.
Birinci taraf, büyük dil modelidir. Dil modeli doğal dili anlar, cümleleri yorumlar, problemi sembolik hale getirmeye çalışır.
İkinci taraf, sembolik çözücüdür. Bu taraf matematiksel mantık kurallarına göre çalışır. Eğer verilen mantıksal ifadeler doğru biçimde kurulmuşsa, çözücü bunların tutarlı olup olmadığını kontrol edebilir.
Bu yaklaşımı şöyle düşünebiliriz:
Dil modeli problemi okur ve “bunu mantık diline çevirmeye” çalışır.
Sembolik çözücü ise “bu mantık doğruysa, sonuç ne olmalı?” sorusunu hesaplar.
Bu fikir güçlüdür. Çünkü sembolik çözücüler, dil modellerinin yapamadığı şekilde katı mantıksal tutarlılık kontrolü yapabilir.
Fakat burada da önemli bir sorun vardır:
Doğal dili mantık diline çevirmek kolay değildir.
Dil modeli çeviri sırasında eksik bilgi bırakabilir, yanlış sembol kullanabilir, bir olumsuzluğu kaçırabilir veya problemdeki belirsizliği fazla katı bir kural gibi yazabilir. Bu durumda sembolik çözücü yanlış veya çözümsüz bir mantık problemiyle karşılaşır.
SSR Ne Öneriyor?
SSR, yani Symbolic-Neural Soft-Logic Reasoning, bu sorunu çözmek için daha esnek bir nöro-sembolik yaklaşım öneriyor.
SSR’nin temel fikri şudur:
Doğal dili sembolik mantığa çevir, mantığı çözücüyle kontrol et; ama çeviri hatalarına karşı sistemi tamamen kırılgan bırakma.
Bu nedenle SSR üç ana parçayı birleştirir:
1. LLM tarafı:
Doğal dildeki problemi sembolik mantık ifadelerine çevirir.
2. Sembolik çözücü tarafı:
Bu ifadelerin tutarlı olup olmadığını ve hangi sonucun çıkarılabileceğini kontrol eder. Makalede Z3 SMT çözücü kullanılmıştır.
3. Soft logic tarafı:
Mantıksal ifadeler kusurlu, eksik veya çelişkiliyse, tüm sistemi çökertmek yerine daha güvenilir alt küme üzerinden çözüm arar.
Bu yapı, katı mantığın doğrulanabilirliğini korumaya çalışırken dil modelinden gelen çeviri hatalarına karşı daha dayanıklı davranmayı hedefler.
Formül Ne Anlatıyor? Bilgiler Mantıksal Bir Küme Haline Geliyor
Makalede problemden çıkarılan bilgiler şu şekilde gösteriliyor:
Φ = φ₁ ∧ φ₂ ∧ ... ∧ φₙ
Bu formülün sade anlamı şudur:
Problemdeki her bilgi bir mantık cümlesine çevrilir. Sonra tüm bu bilgiler “ve” bağlacıyla bir araya getirilir.
Örneğin:
- Ali kırmızıdır.
- Kırmızı olan herkes yuvarlaktır.
- Ali yuvarlak mı?
Bu bilgiler sembolik mantıkta ayrı ayrı ifade edilir. Hepsi birlikte Φ adlı bilgi kümesini oluşturur.
Sonra sistem şu soruyu sorar:
“Bu bilgiler doğruysa, sorgulanan sonuç zorunlu olarak çıkar mı?”
Bu, klasik mantıkta oldukça güçlü bir yaklaşımdır. Çünkü modelin tahminine değil, kuralların tutarlılığına bakılır.
Boolean Soru Nasıl Çözülüyor?
Bir soru doğru/yanlış türündeyse SSR iki kontrol yapar:
Φ ∧ q
Φ ∧ ¬q
Burada q, sorulan iddiadır. ¬q ise “q doğru değil” anlamına gelir.
Sade anlatımla sistem şunu dener:
- Verilen bilgilerle q doğru olabilir mi?
- Verilen bilgilerle q yanlış olabilir mi?
Eğer q doğru olabilir ama q’nun tersi olamazsa, sonuç “doğru” kabul edilir.
Eğer q’nun tersi olabilir ama q olamazsa, sonuç “yanlış” kabul edilir.
Eğer ikisi de mümkünse, sonuç “bilinmiyor” olabilir.
Bu yaklaşım, yapay zekânın rastgele cevap vermesini engellemeye çalışır. Çünkü sonuç, mantıksal doyurulabilirlik kontrolüne bağlanır.
Sayısal Sorular Nasıl Çözülüyor?
Bazı sorular doğru/yanlış değil, sayısal veya sıralama türündedir. Örneğin:
“Bu nesne kaçıncı sıradadır?”
“Yaş kaçtır?”
“Hangi seçenek verilen koşullarla uyumludur?”
Bu durumda SSR, olası değerleri tek tek dener.
Makaledeki ifade sadeleştirilirse şunu söyler:
Çözüm kümesi = verilen bilgilerle tutarlı olan aday değerler
Yani sistem, her olası değeri mantık problemi içine koyar ve “bu değer verilen bilgilerle çelişiyor mu?” diye kontrol eder.
Eğer yalnızca bir aday tutarlı kalıyorsa, cevap odur. Eğer birden fazla aday tutarlı kalıyorsa, problem belirsiz olabilir veya eksik bilgi olabilir.
Soft Logic Neden Gerekli?
Katı mantıkta bir bilgi yanlış çevrilirse bütün sistem bozulabilir.
Örneğin problemde “Ali kırmızı değildir” yazıyorken model bunu yanlışlıkla “Ali kırmızıdır” diye çevirmiş olsun. Bu tek hata, çözücünün tüm sonucu yanlış değerlendirmesine neden olabilir.
SSR bu nedenle soft logic kullanır.
Soft logic, kuralları yalnızca “tam doğru” veya “tam yanlış” olarak ele almak yerine, bazı bilgilere güven ağırlığı verir.
Makalede güven ağırlığı için şu fikir kullanılır:
w(φ) = exp(-H(φ))
Burada H(φ), dil modelinin ilgili ifadeyi üretirken ne kadar belirsizlik taşıdığını temsil eden entropi ölçüsüdür.
Sade anlamı şudur:
Model bir mantık ifadesini üretirken çok kararsız görünüyorsa, o ifadeye daha düşük güven verilebilir.
Model daha emin görünüyorsa, o ifade daha yüksek ağırlık alabilir.
Bu, kusurlu mantık çevirilerinin tüm sistemi bozmasını azaltmayı hedefler.
Çeviri Çok Bozuksa Ne Oluyor?
SSR’nin önemli bir güvenlik adımı daha var: filtreleme.
Dil modelinin ürettiği mantık ifadeleri çok hatalıysa, örneğin ham doğal dil parçası kalmışsa, bozuk semboller varsa veya ifade çözücü tarafından okunamıyorsa, sistem bunları ayıklar.
Eğer fazla sayıda ciddi hata varsa veya sorgunun kendisi bozulmuşsa, SSR sembolik çözüme zorlamaz. Bunun yerine geleneksel Chain-of-Thought yoluna geri döner.
Bu karar önemlidir. Çünkü her problemi sembolik çözücüye zorla sokmak doğru değildir. Eğer mantık çevirisi çökmüşse, sembolik çözücü güvenilir sonuç üretemez.
Belirsizlik Kaldığında Hedefli Geri Arama Yapılıyor
Soft logic bazı çelişkileri azaltabilir; fakat bazen birden fazla cevap hâlâ mümkün kalır. Bu durumda SSR “hangi eksik bilgi sonucu tekilleştirirdi?” sorusunu sorar.
Bu bölüme makalede dual-system targeted retrieval deniyor. Türkçeye “çift sistemli hedefli geri getirme” veya daha sade biçimde “eksik kilit bilgiyi bulma” şeklinde çevrilebilir.
Burada sembolik çözücü önce şunu belirler:
“Eğer şu ek koşul doğru olsaydı, cevap tek olurdu.”
Sonra bu aday koşul dil modeline kontrol ettirilir:
“Bu koşul problem metninden veya makul ortak bilgiden çıkarılabilir mi?”
Bu önemli bir farktır. Dil modeli doğrudan cevabı seçmez. Onun yerine sembolik sistemin işaret ettiği belirli bir eksik bağlantıyı kontrol eder.
Bu yöntem, dil modelini daha dar ve denetlenebilir bir göreve indirir.
Doğrulanabilir Düşünce Zinciri Nasıl Üretiliyor?
SSR yalnızca cevap üretmeyi hedeflemiyor. Aynı zamanda doğrulanabilir akıl yürütme zinciri üretmeyi de hedefliyor.
Bunun için sistem iki tür mantıksal iz çıkarıyor:
İleri akıl yürütme:
Bilinen bilgilerden başlanır. Kurallar uygulanır. Yeni sonuçlar çıkarılır. Sonunda sorguya ulaşılmaya çalışılır.
Geri akıl yürütme:
Sorgudan başlanır. “Bu sonucu kanıtlamak için hangi öncüller gerekir?” diye geriye doğru gidilir.
Bu iki yol, insanın anlayabileceği açıklamalara çevrilebilir. Önemli olan şudur: Açıklama rastgele üretilmiş bir metin değildir; sembolik çıkarım izinden türetilir.
Bu, eğitim ve güvenilir yapay zekâ açısından değerlidir. Çünkü kullanıcı yalnızca cevabı değil, cevaba giden mantıksal yolu da görebilir.
Şekil 1 Ne Anlatıyor?
Makaledeki Şekil 1, SSR’nin genel akışını gösteriyor.
Görselde sistem önce doğal dil problemini alıyor. LLM bu problemi mantıksal ifadelere çeviriyor. Ardından filtreleme yapılıyor. Hatalı ifadeler ayıklanıyor. Sonra sembolik sistem devreye giriyor.
Eğer mantık net ve tutarlıysa çözücü cevabı çıkarıyor. Eğer çelişki veya eksik bilgi varsa soft logic ve hedefli geri arama devreye giriyor. Eğer sembolik taraf çok bozulmuşsa sistem standart CoT yoluna geri düşüyor.
Bu görselin ana mesajı şudur:
SSR, tek bir yöntem değil; doğal dil, mantık, doğrulama, yumuşak kısıtlar ve açıklama üretimini birlikte kullanan çok katmanlı bir akıl yürütme hattıdır.
Şekil 2 Ne Gösteriyor?
Makaledeki Şekil 2, SSR’nin ileri ve geri akıl yürütme zincirlerini nasıl oluşturduğunu gösteriyor.
İleri zincirde sistem mevcut gerçeklerden başlıyor. Kuralları sırayla uyguluyor ve hedef sonuca doğru ilerliyor.
Geri zincirde ise hedef sonuçtan başlıyor. Bu sonucu kanıtlamak için hangi kuralın, hangi öncülün ve hangi ara bilginin gerekli olduğunu arıyor.
Bu iki yaklaşım, insanların problem çözme biçimine benzer. Bazen elimizdeki bilgilerden sonuca gideriz. Bazen de sonucu kanıtlamak için “bunu göstermek adına neye ihtiyacım var?” diye geriye doğru düşünürüz.
SSR’nin katkısı, bu zincirleri sembolik olarak denetlenebilir hale getirmesidir.
Deneyler Nasıl Yapılmış?
Araştırmacılar SSR’yi farklı büyük dil modelleri ve farklı mantık benchmark’ları üzerinde test ediyor.
Kullanılan veri setleri arasında şunlar yer alıyor:
PrOntoQA:
Yapılandırılmış mantıksal çıkarım görevleri.
ProofWriter:
Verilen bilgilerin bir sonucu kanıtlamaya yetip yetmediğini de ölçen mantıksal görevler.
FOLIO:
Daha karmaşık birinci mertebe mantık problemleri, uzun cümleler ve örtük ortak bilgi içerebilir.
LogicalDeduction:
Sıralama ve ayrık kombinatoryal mantık problemleri.
Karşılaştırılan yöntemler arasında doğrudan cevaplama, standart Chain-of-Thought, Formal CoT, Logic-LM, VeriCoT ve SSR bulunuyor.
Her veri setinden 200 problem örneklenmiş ve sonuçlar doğruluk ile çıkarım süresi açısından değerlendirilmiş.
Sonuçlar Ne Gösteriyor?
Tablo 1, SSR’nin birçok model ve veri setinde standart CoT’ye göre daha iyi sonuç verdiğini gösteriyor.
Örneğin Qwen2.5-7B modelinde:
- PrOntoQA’da CoT: 86,1; SSR: 97,4
- ProofWriter’da CoT: 58,1; SSR: 86,0
- LogicalDeduction’da CoT: 63,2; SSR: 75,0
DeepSeek-R1 ve GPT-4o gibi daha güçlü modellerde de SSR’nin özellikle PrOntoQA ve ProofWriter gibi mantıksal görevlerde yüksek sonuçlar verdiği raporlanıyor.
FOLIO gibi daha karmaşık doğal dil ve örtük bilgi gerektiren veri setlerinde ise avantaj daha sınırlı görünüyor. Bu da beklenen bir durumdur; çünkü doğal dili kusursuz şekilde formal mantığa çevirmek zorlaştıkça sembolik sistemden alınan fayda azalabilir.
Bu sonuçların ana mesajı şudur:
SSR, mantıksal yapısı daha net olan problemlerde daha güçlü avantaj sağlayabilir. Daha karmaşık ve belirsiz doğal dil problemlerinde ise çeviri kalitesi hâlâ sınırlayıcıdır.
Doğrulanabilir Düşünce Zincirlerinde Daha Büyük Fark Var
Tablo 2, yalnızca doğru cevabı değil, tamamen doğru ve doğrulanabilir akıl yürütme zinciri üretme başarısını inceliyor.
Burada SSR’nin farkı daha belirgin görünüyor.
Örneğin Qwen modelinde PrOntoQA için:
- Formal CoT: 21,9
- VeriCoT: 51,7
- SSR ileri çıkarım: 89,7
- SSR geri çıkarım: 88,5
Bu, SSR’nin sadece cevap doğruluğunu artırmakla kalmayıp, daha mantıklı ve doğrulanabilir açıklama zincirleri üretme konusunda da güçlü sonuçlar verdiğini gösteriyor.
Bu nokta özellikle önemlidir. Çünkü kullanıcılar için bazen doğru cevap kadar, doğru gerekçe de gereklidir.
Bozuk veya Eksik Girdilerde Ne Oluyor?
Makale ayrıca giriş bozulmalarına karşı dayanıklılığı test ediyor.
Bazı deneylerde problem metnine ilgisiz cümleler ekleniyor. Bazılarında ise önemli öncüller siliniyor veya değiştiriliyor.
Sonuçlara göre ilgisiz bilgi eklemek yöntemleri çok fazla bozmuyor. Ancak önemli bilgileri silmek veya değiştirmek daha büyük performans düşüşüne yol açıyor.
SSR, bu bozulmalarda genel olarak daha yumuşak bir düşüş gösteriyor. Bunun nedeni soft logic ve sembolik kısıtların birlikte çalışması olabilir. Sistem, küçük çeviri hataları veya bazı belirsizlikler karşısında tamamen çökmeden daha güvenilir alt kümelerle ilerlemeye çalışıyor.
Ancak bozulma çok arttığında SSR’nin avantajı da azalıyor. Bu da yöntemin sınırsız dayanıklı olmadığını gösteriyor.
Filtreleme Modülü Neden Önemli?
Tablo 4, SSR içindeki bazı parçaların çıkarıldığı ablation deneylerini gösteriyor.
Filtreleme modülü çıkarıldığında performans özellikle zor veri setlerinde ciddi biçimde düşüyor. Örneğin Qwen2.5-7B ile FOLIO’da standart SSR 64,5 iken filtreleme olmadan 48,0’a düşüyor. LogicalDeduction’da da 75,0’dan 68,5’e düşüş görülüyor.
Bu bize şunu gösteriyor:
LLM’nin ürettiği mantık ifadelerini doğrudan çözücüye göndermek risklidir. Önce açıkça bozuk veya hatalı ifadeleri temizlemek gerekir.
Soft logic içindeki entropi tabanlı güven ağırlıkları ise daha sınırlı ama tamamlayıcı bir katkı sağlıyor. Yani asıl büyük kazançlardan biri, yanlış formalizasyonun ayıklanması ve sembolik akıl yürütmenin başarılı çalıştırılabilmesi gibi görünüyor.
Araştırma Ne Söylüyor?
Çalışmanın ana mesajı şudur:
Büyük dil modellerinin akıl yürütme yeteneğini geliştirmek için yalnızca daha uzun açıklama istemek yeterli değildir. Akıl yürütme adımlarının doğrulanabilir olması gerekir.
SSR bu amaçla üç fikri birleştiriyor:
Birincisi, doğal dil problemlerini sembolik mantığa çevirmek.
İkincisi, sembolik çözücüyle tutarlılık ve sonuç kontrolü yapmak.
Üçüncüsü, çeviri hatalarına karşı soft logic ve filtreleme kullanmak.
Bu yaklaşım, LLM’lerin tamamen serbest metin üretiminden kaynaklanan hataları azaltmayı hedefliyor. Aynı zamanda doğrulanabilir düşünce zincirleri üreterek eğitim verisi oluşturma potansiyeli de sunuyor.
Bu Neden Önemli?
Gelecekte yapay zekâ sistemleri yalnızca sohbet etmek için değil; planlama, matematik, bilimsel araştırma, yazılım doğrulama, eğitim ve karar destek için de kullanılacak.
Bu alanlarda “model böyle söyledi” yeterli değildir. Modelin neden böyle söylediği ve bu sonucun mantıksal olarak doğrulanıp doğrulanamadığı önemlidir.
Özellikle matematik ve bilimsel akıl yürütmede, sonuç kadar kanıt yolu da değerlidir. Bir öğrenciye veya araştırmacıya yanlış gerekçeyle doğru cevap vermek yanıltıcı olabilir.
SSR gibi yöntemler, yapay zekâ sistemlerinin daha güvenilir, daha açıklanabilir ve daha denetlenebilir hale gelmesi için önemli bir araştırma yönü sunuyor.
Dikkat Edilmesi Gereken Noktalar
Bu çalışma güçlü sonuçlar sunsa da sınırlıdır.
İlk olarak, çalışma preprinttir ve bulgular bağımsız değerlendirmeyle desteklenmelidir.
İkinci olarak, SSR hâlâ LLM’nin doğal dili mantık ifadelerine doğru çevirebilmesine bağlıdır. Çeviri yanlışsa, soft logic bu hatayı azaltabilir ama tamamen ortadan kaldırmaz.
Üçüncü olarak, sistem fazla bozuk çeviri durumunda standart CoT’ye geri döner. Bu, güvenlik için mantıklıdır; ancak sembolik sistemin her durumda çalışmadığını gösterir.
Dördüncü olarak, deneyler belirli benchmark veri setleriyle sınırlıdır. Gerçek dünya problemleri daha dağınık, eksik, çok anlamlı ve bağlama bağımlı olabilir.
Beşinci olarak, doğrulanabilir düşünce zinciri üretmek değerli olsa da bu zincirlerin gerçekten modelin içsel akıl yürütme yeteneğini geliştirip geliştirmediği ayrı bir araştırma konusudur.
Sonuç
Bu araştırma, büyük dil modellerinin akıl yürütmesini daha güvenilir hale getirmek için önemli bir yön öneriyor: Dil modelinin esnekliğini, sembolik mantığın doğrulanabilirliğiyle birleştirmek.
SSR yöntemi, doğal dil problemlerini mantık ifadelerine çeviriyor, bu ifadeleri SMT çözücüyle kontrol ediyor, hatalı veya eksik formalizasyonlara karşı soft logic kullanıyor ve sonunda insanın okuyabileceği doğrulanabilir akıl yürütme zincirleri oluşturabiliyor.
Bulgular, SSR’nin birçok deney ortamında klasik CoT ve bazı nöro-sembolik yaklaşımlara göre daha iyi performans gösterebildiğini ortaya koyuyor. Fakat yöntem hâlâ formalizasyon hatalarına, problem karmaşıklığına ve veri seti sınırlarına bağlıdır.
Yine de çalışma, güvenilir yapay zekâ için çok önemli bir fikri hatırlatıyor:
Yapay zekânın iyi cevap vermesi yetmez; cevaba giden yolun da kontrol edilebilir olması gerekir.
Kaynak ve Yöntem Notu
Bu içerik, Rui Wang, Zeming Wei, Yihao Zhang ve Xiaokun Luan tarafından hazırlanan “Symbolic-Neural Soft-Logic Reasoning: Towards Robust and Verifiable Thinking Chains via Cooperative Evolution” başlıklı akademik çalışmadan yararlanılarak Verianla editoryal formatında özgün olarak hazırlanmıştır.
Çalışma arXiv üzerinde yayımlanmış preprint niteliğindedir. İçerik bilgilendirme ve eğitim amacı taşır. Yapay zekâ güvenliği, model seçimi, yazılım doğrulama, akademik değerlendirme veya profesyonel teknik danışmanlık yerine geçmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir