

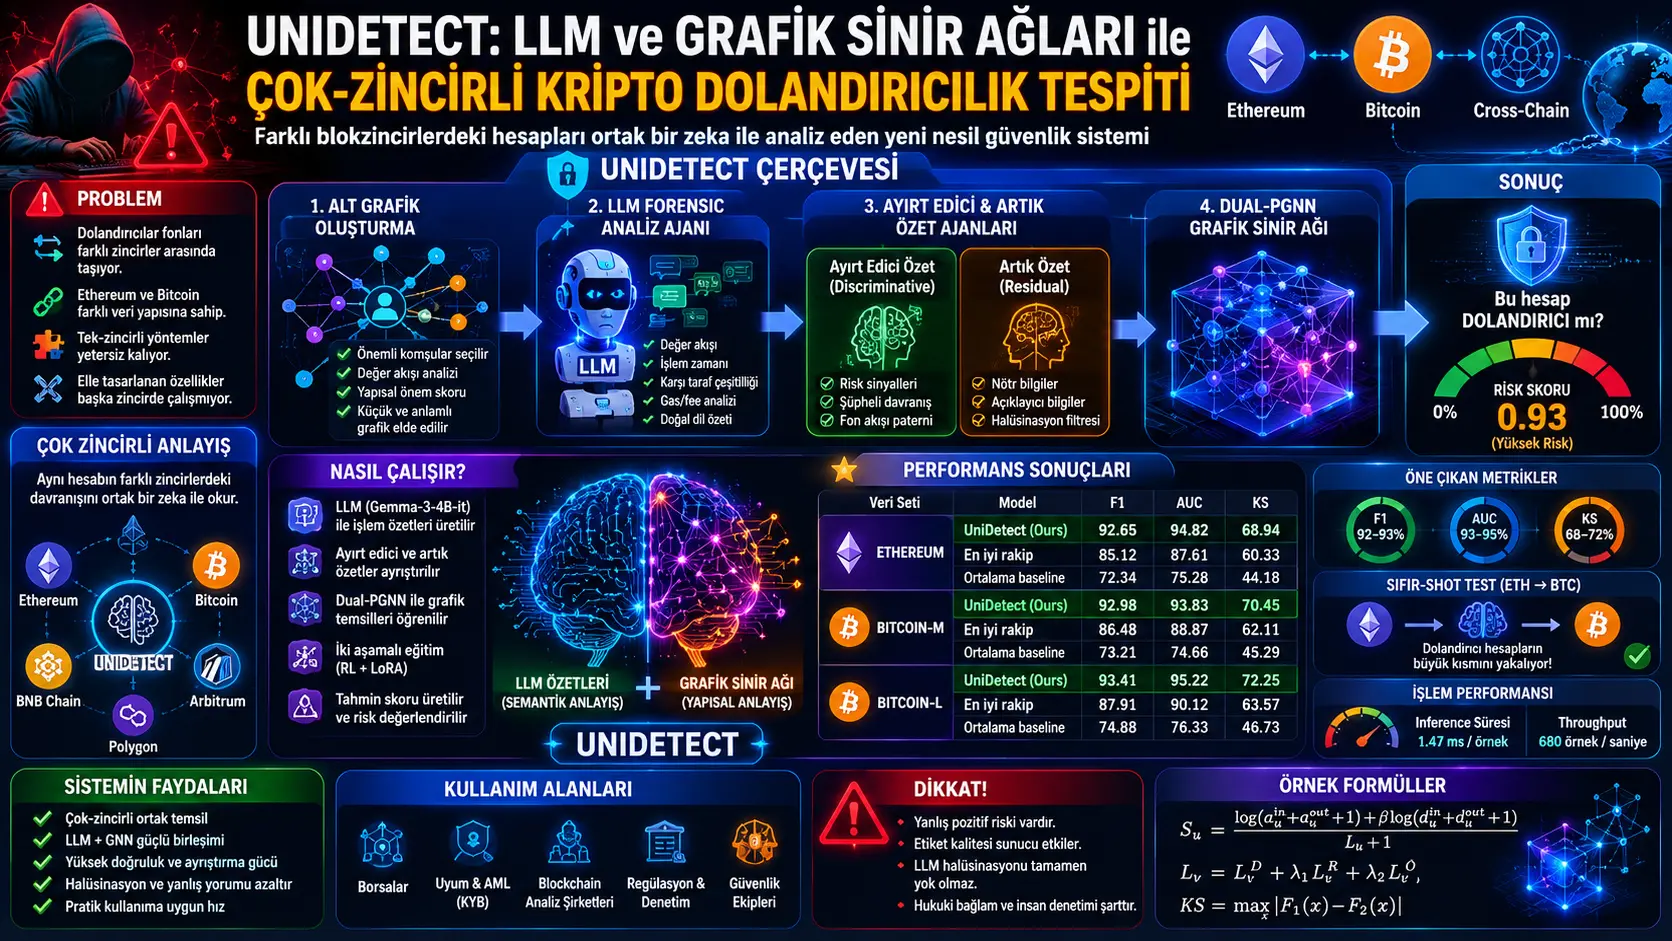
Kriptovalyuta ekotizimida firibgar hisoblarni aniqlash tobora qiyinlashmoqda. Buning muhim sabablaridan biri jinoyat maqsadidagi mablag‘lar endi bitta zanjirda qolmasligidir. Cross-chain ko‘priklar, markazlashmagan moliya protokollari va turli aktivlar o‘rtasida konvertatsiya qilish imkoniyati mablag‘larni bir blokcheyndan boshqasiga o‘tkazishni osonlashtiradi. Bu holat faqat Ethereum, Bitcoin yoki bitta zanjir uchun maxsus ishlab chiqilgan aniqlash tizimlarini zaiflashtirishi mumkin.
Ushbu tadqiqot UniDetect deb nomlangan ko‘p-zanjirli firibgar hisoblarni aniqlash usulini taklif qiladi. Tizim tranzaksiya grafigini tahlil qiladigan grafik neyron tarmoqlarini katta til modellari ishlab chiqargan tranzaksiya xulosalari bilan birlashtiradi. Maqsad turli blokcheynlardagi geterogen tranzaksiya tuzilmalarini umumiy va tushunarli tasvirga aylantirishdir.
UniDetect avval hisob markazli subgraphlar yaratadi. Keyin LLM asosidagi forensic analysis agent hisobning tranzaksiya tarixini qiymat oqimi, tranzaksiya vaqti, qarshi tomonlar xilma-xilligi va gas sarfi kabi o‘lchamlar bo‘yicha umumlashtiradi. So‘ng ikki alohida summary analysis agent ishga tushadi: biri firibgarlikni aniqlash uchun farqlovchi ma’lumotlarni ajratadi, ikkinchisi esa vazifa bilan bevosita bog‘liq bo‘lmagan residual/factual ma’lumotlarni ajratadi. Ushbu xulosalar Dual-PGNN deb ataladigan ikki yo‘lli grafik neyron tarmog‘iga node feature sifatida beriladi.
Tadqiqotda keltirilgan natijalarga ko‘ra UniDetect Ethereum, Bitcoin-M va Bitcoin-L datasetlarida klassik grafik o‘rganish usullari, bir-zanjirli aniqlash usullari va mavjud ko‘p-zanjirli yondashuvlarning aksariyatidan yaxshiroq natija ko‘rsatadi. Shuningdek, Ethereum’da o‘qitilib Bitcoin’da zero-shot sinovdan o‘tkazilganda firibgar hisoblarning katta qismini aniqlay olishi qayd etiladi. Biroq bunday tizimlar false positive riskiga ega bo‘lgani sabab real foydalanishda inson nazorati va huquqiy kontekst bilan birga baholanishi kerak.
Muammo nimada?
Blokcheynlar ochiq tranzaksiya yozuvlarini taqdim etgani uchun nazariy jihatdan firibgarlikni aniqlash uchun kuchli ma’lumot manbai hisoblanadi. Ammo amalda bir nechta asosiy qiyinchilik mavjud.
Birinchi muammo — zanjir geterogenligi. Ethereum account-based modelda ishlaydi; Bitcoin esa UTXO modeliga tayanadi. Tranzaksiya maydonlari, manzil xatti-harakati, gas/fee ma’lumotlari, input-output tuzilmasi va tranzaksiya semantikasi zanjirdan zanjirga o‘zgaradi. Shu sabab bir zanjir uchun qo‘lda ishlab chiqilgan feature’lar boshqa zanjirda ayni ma’noni bermasligi mumkin.
Ikkinchi muammo — cross-chain qochish xatti-harakati. Firibgarlar mablag‘larni bir nechta zanjir o‘rtasida ko‘chirishi, turli tokenlarga aylantirishi yoki ko‘priklar va DeFi protokollari orqali izlarni tarqatishi mumkin. Bunday holatda bir-zanjirga yo‘naltirilgan monitoring tizimlari xatti-harakatning to‘liq manzarasini ko‘ra olmasligi mumkin.
Uchinchi muammo — ma’lumot modaliteti. Blokcheyn ma’lumoti faqat sonli tranzaksiya summalaridan iborat emas. Tranzaksiya chastotasi, mablag‘ oqimi, qarshi tomonlar xilma-xilligi, vaqt, gas ishlatilishi, input data xabarlari, graph topology va manzillar o‘zaro aloqasi birgalikda ma’no beradi. Shu sabab faqat sonli jadval yoki faqat grafik tuzilmasi yetarli bo‘lmasligi mumkin.
To‘rtinchi muammo — LLM ishonchliligi. Katta til modellari tranzaksiya xulosalarini talqin qilishda kuchli bo‘lishi mumkin; ammo hallucination, ortiqcha talqin, unsupported risk xulosasi va false positive ishlab chiqarish xavfi bor. Firibgarlikni aniqlash kabi sezgir sohada modelning “dalilga asoslanmagan” sharhlar berishi jiddiy ishonch muammosini tug‘diradi.
Maqola hal qilishga urinayotgan asosiy muammo shuki: turli blokcheynlardan kelgan murakkab tranzaksiya ma’lumotlarini grafik tuzilmasini ham, tranzaksiya semantikasini ham saqlagan holda umumiy firibgarlikni aniqlash doirasida qanday birlashtirish mumkin?
Usul nimani taklif qiladi?
UniDetect usulini to‘rtta asosiy qismga ajratish mumkin.
1. Hisob markazli subgraph yaratish: Butun zanjir grafigini to‘g‘ridan-to‘g‘ri modelga berish juda qimmat bo‘lgani uchun, target hisob atrofidagi muhim qo‘shnilar tanlanadi. Tanlashda o‘rtacha tranzaksiya qiymati kabi xulqiy signallardan foydalaniladi. Keyin strukturaviy muhimlik skori bilan keraksiz node’lar olib tashlanib, kichikroq, ammo mazmunli subgraph olinadi.
2. LLM asosidagi tranzaksiya xulosasini yaratish: Forensic analysis agent har bir hisobning tranzaksiya tarixini tabiiy til xulosasiga aylantiradi. Bu xulosa qiymat oqimi, partner ratio, tranzaksiya vaqti va gas sarfi kabi o‘lchamlarni qamrab oladi. Shu tariqa turli zanjirlarning texnik farqlari umumiyroq semantik tilga o‘giriladi.
3. Discriminative va residual summary ajratilishi: Dastlabki xulosaning hammasi firibgarlikni aniqlash uchun bir xil qiymatga ega emas. Shu sabab discriminative summary analyst agent firibgarlik nuqtayi nazaridan farqlovchi bo‘lishi mumkin bo‘lgan mablag‘ oqimi, ko‘p qarshi tomonli aloqalar, zich tranzaksiya xatti-harakati va riskli manzillar bilan bog‘lanish kabi signallarni ajratadi. Residual summary analyst agent esa klassifikatsiyaga bevosita hissa qo‘shmaydigan, ko‘proq izohlovchi yoki neytral ma’lumotlarni ajratadi.
4. Ikki bosqichli navbatma-navbat o‘qitish: Birinchi bosqichda LLM asosidagi summary agentlar xulosa sifatini yaxshilash uchun LoRA va reinforcement learning bilan fine-tuning qilinadi. Ikkinchi bosqichda LLM muzlatiladi va grafik model o‘qitiladi. Shu tariqa til xulosalari va tranzaksiya grafigi tasvirlari bir-birini to‘ldiradigan tizimga aylanadi.
Yondashuvning asosiy g‘oyasi shuki: LLM tranzaksiya tarixini o‘qilishi oson va semantik jihatdan boy xulosaga aylantiradi; grafik neyron tarmog‘i esa hisobning tarmoq ichidagi xulqiy va strukturaviy o‘rnini o‘rganadi. UniDetect bu ikki kanalni birga ishlatib, umumiyroq ko‘p-zanjirli firibgarlikni aniqlash tizimini qurishga urinadi.
Formulalar nimani anglatadi?
PDF’dagi formulalar tranzaksiya grafigi ta’rifi, subgraph sampling, strukturaviy muhimlik skori, uch qismli loss funksiyasi, reinforcement learning asosidagi xulosa yaxshilash va Dual-PGNN representation learning jarayonini tushuntiradi. Formulalar quyida MathJax bilan mos shaklda berilgan.
1. Tranzaksiya grafigi ma’lumot modeli
Bu yerda \(G\) tranzaksiya grafigini ifodalaydi. \(V\) hisob node’lari to‘plami. \(E\) hisoblar o‘rtasidagi yo‘naltirilgan tranzaksiya edge’larini ko‘rsatadi. Kriptovalyuta tranzaksiyalarida bir manzildan boshqa manzilga mablag‘ yuborilishi grafikda yo‘naltirilgan edge sifatida modellashtiriladi.
\(X_E\) edge feature matritsasidir. \(m\) tranzaksiya edge’lari sonini; \(d\) har bir edge uchun ishlatiladigan feature o‘lchamini ifodalaydi. Bu feature’lar tranzaksiya summasi, tranzaksiya chastotasi, fee/gas kabi zanjirga qarab o‘zgaradigan tafsilotlarni o‘z ichiga olishi mumkin.
2. Firibgar hisoblarni aniqlash vazifasi
Bu formula vazifa node classification sifatida qurilganini ko‘rsatadi. Ba’zi hisoblarning label’lari \(Y_L\) ma’lum; modelning maqsadi labelsiz hisoblarning \(Y_U\) label’larini, ya’ni normal yoki firibgar ekanini bashorat qilishdir.
3. Semantics-aware qo‘shni sampling
Bu formula target hisob atrofi uchun qaysi qo‘shnilar tanlanishini ko‘rsatadi. \(N_v\), \(v\) node’ning one-hop qo‘shnilari. \(K\), har bir hop uchun tanlanadigan qo‘shnilar soni. \(R[v,N_v]\), nomzod qo‘shnilar bilan o‘rtacha tranzaksiya qiymatini ifodalaydi. Shu tariqa yuqori qiymatli yoki xulq jihatdan muhim aloqalar ustuvor qilinadi.
\(C_v\), target hisob \(v\) atrofida \(h\)-hop sampling bilan olingan node’lar to‘plami. Bu to‘plam hisobning tranzaksiya atrofini ifodalovchi account-centered subgraph uchun asos bo‘ladi.
4. Strukturaviy muhimlik skori
Bu formula qo‘shni node \(u\) ning strukturaviy muhimligini hisoblaydi. \(a_u^{in}\) va \(a_u^{out}\), node’ning kiruvchi va chiquvchi tranzaksiya summalarini; \(d_u^{in}\) va \(d_u^{out}\), kiruvchi va chiquvchi degree sonlarini ko‘rsatadi. \(L_u\), target node’ga eng qisqa yo‘l masofasi. \(\beta\), pul xatti-harakati bilan strukturaviy aloqa signali o‘rtasidagi muvozanatni boshqaradi.
Skor yuqori bo‘lsa node muhimroq deb qaraladi. Ammo faqat yuqori connectivity har doim firibgarlik signali emas; birjalar yoki yirik servis hamyonlari ham yuqori aloqador bo‘lishi mumkin. Shu sabab maqola \(\beta\) sozlamasi ehtiyotkor tanlanishi kerakligini ko‘rsatadi.
5. Discriminative summary loss
Bu loss discriminative summary yordamidagi klassifikatsiya haqiqiy label bilan qanchalik mos kelishini o‘lchaydi. \(p_v^D\), discriminative summary’dan olingan prediction probability. Maqsad firibgarlikni aniqlash uchun farqlovchi xulosalar klassifikatsiya muvaffaqiyatini oshirishidir.
6. Residual summary loss
Residual summary firibgarlikni aniqlash uchun bevosita farqlovchi bo‘lmasligi kutilgan ma’lumotlarni ifodalaydi. Shu sabab model residual xulosaning klassifikatsiyada kuchli yo‘nalish berishini istamaydi. \(U_v\) uniform distribution. Bu loss residual xulosa prediction’ini imkon qadar neytral saqlashni maqsad qiladi.
7. Ortogonallik loss
Bu formula discriminative va residual representation’larning bir-biriga aralashishini oldini olishga urinadi. Agar ikki representation juda o‘xshash bo‘lib qolsa, farqlovchi signal bilan neytral/factual ma’lumot ajratilishi zaiflashadi. Ortogonallik loss bu aralashuvni kamaytirish uchun ishlatiladi.
8. Uch qismli jami loss
UniDetect xulosa sifatini uch tomondan nazorat qiladi: firibgarlikni aniqlashga yordam beradigan discriminative ma’lumot, neytral qolishi kutilgan residual ma’lumot va bu ikki representation’ning bir-biridan ajralishi. \(\lambda_1\) va \(\lambda_2\) residual loss va ortogonallik loss og‘irliklarini belgilaydi.
9. RL mukofoti
Jami loss past bo‘lsa, mukofot yuqori bo‘ladi. Bu mukofot LLM asosidagi summary analyst agent’ni yaxshiroq xulosa ishlab chiqishga undash uchun ishlatiladi.
10. Advantage hisobi
\(b_t\), o‘qitish qadamidagi exponential moving-average baseline. Reward’dan baseline ayirilib advantage qiymati olinadi. Bu RL o‘qitishida variance’ni kamaytirishga va treningni barqarorroq qilishga yordam beradi.
11. RL maqsad funksiyasi
Bu formula discriminative va residual summary ishlab chiqarish ehtimollarini mukofot bilan bog‘laydi. Yaxshi xulosa ishlab chiqargan agentlar yuqoriroq mukofot oladi; zaif yoki keraksiz xulosa ishlab chiqargan agentlar jazolanadi.
12. Dual-PGNN node representation yaratish
Birinchi formula discriminative yoki residual xulosalardan grafik asosidagi node representation hosil qiladi. Ikkinchi formula original tranzaksiya xulosasidan alohida representation yaratadi. Bu yerda \(A_v\), target hisob atrofidagi subgraph adjacency matritsasi. \(\theta(\cdot)\), feature’ning o‘zini saqlovchi chiziqli qatlam.
13. Attention bilan representation fusion
Bu formula discriminative/residual summary representation’i bilan original summary representation’ining attention og‘irliklari orqali birlashtirilishini ko‘rsatadi. \(W_1\) va \(W_2\), ikki axborot kanalining nisbiy ahamiyatini o‘rganadigan parametrlardir.
14. KS metrikasi
KS metrikasi kredit scoring va risk modellashtirishda ko‘p ishlatiladigan ajratish o‘lchovidir. Bu yerda normal va firibgar hisoblarning skor taqsimotlari qanchalik ajralishini ko‘rsatadi. KS qanchalik yuqori bo‘lsa, modelning ikki klassni ajratish qobiliyati shunchalik kuchli deb qaraladi.
Grafik, jadval va sxemaning asosiy xabari
1-sahifadagi Figure 1: Vizual klassik zanjirga xos firibgarlikni aniqlash usullarini UniDetect bilan taqqoslaydi. An’anaviy usullar Bitcoin yoki Ethereum kabi bitta zanjirga xos qoidalar va feature’lardan foydalanadi, UniDetect esa LLM asosidagi tranzaksiya xulosalari bilan ko‘p-zanjirli umumiy representation yaratishga urinadi. Asosiy xabar: zanjirga xos feature engineering o‘rniga, zanjirlararo umumiy semantik va grafik representation maqsad qilinadi.
4-sahifadagi Figure 2: UniDetect’ning umumiy framework’i ko‘rsatiladi. Chap tomonda subgraph yaratish va transaction summary generation bosqichlari bor. O‘rta qismda ikki bosqichli trening mavjud: Stage 1’da summary agentlar o‘qitiladi, Stage 2’da graph inference training bajariladi. Pastda inference bosqichida tizim “bu hisob firibgarmi?” savoliga ehtimollik asosida javob berishi ko‘rsatiladi.
4–5-sahifadagi prompt shablonlari: Forensics analyst agent tranzaksiya ma’lumotlarini qiymat oqimi, partner ratio, tranzaksiya vaqti va gas sarfi bo‘yicha umumlashtiradi. Discriminative summary agent firibgarlik nuqtayi nazaridan farqlovchi tranzaksiya pattern’larini ajratadi. Residual summary agent esa bevosita risk hukmi bermaydigan factual ma’lumotlarni ajratadi. Asosiy xabar LLM erkin talqin qilishi emas, dalilga asoslangan va vazifaga yo‘naltirilgan xulosa ishlab chiqishidir.
6-sahifadagi dataset jadvali: Ethereum datasetida 187.960 node, 397.038 edge, 1.991 fraud va 1.439 normal hisob mavjud. Bitcoin-M datasetida 2.505.841 node va 14.181.316 edge; Bitcoin-L datasetida esa 20.085.231 node va 203.419.765 edge bor. Bu jadval usul kichik toy datasetda emas, katta ko‘lamli grafiklarda sinovdan o‘tkazilganini ko‘rsatadi.
7-sahifadagi Ethereum natijalari jadvali: UniDetect Ethereum’da Precision 91.39, Recall 93.95, F1 92.65, AUC 94.82 va KS 68.94 qiymatlari bilan eng yaxshi natijani beradi. Zero-shot LLM ishlatilgan UniDetect varianti ham kuchli natija ko‘rsatadi; ammo fine-tuning va ikki bosqichli o‘qitish to‘liq modelda sezilarli qo‘shimcha yutuq beradi.
8-sahifadagi Bitcoin-M va Bitcoin-L natijalari jadvali: UniDetect Bitcoin-M’da F1 92.98, AUC 93.83, KS 70.45; Bitcoin-L’da F1 93.41, AUC 95.22, KS 72.25 natijalarini beradi. Asosiy xabar usul faqat Ethereum’ga xos bo‘lib qolmay, Bitcoin ma’lumot tuzilmalarida ham kuchli natija ko‘rsatganidir.
8-sahifadagi hyperparameter sezgirlik grafiklari: \(N_c\), \(\beta\), \(\lambda_1\) va \(\lambda_2\) o‘zgarganda performance qanday ta’sirlanishi ko‘rsatiladi. Model keng oraliqda barqaror ko‘rinsa-da, juda kichik yoki juda katta parametrlar natijani yomonlashtirishi mumkinligi aytiladi. Ayniqsa \(\beta\) juda katta bo‘lsa, yuqori aloqador, ammo begunoh servis hamyonlari modelga ortiqcha muhim ko‘rinishi mumkin.
8-sahifadagi ablation jadvali: Model komponentlari olib tashlanganda performance o‘zgaradi. Residual agent olib tashlanganda F1’ning 78.37 ga tushishi residual/discriminative ajratish muhimligini ko‘rsatadi. RL olib tashlanganda va Dual-PGNN o‘rniga standart GNN ishlatilganda ham performance pasayadi.
9-sahifadagi samaradorlik jadvali: Subgraph yaratish o‘rtacha 1.26 soniya/sample, inference 1.47 ms/sample, throughput 680 sample/s deb xabar qilingan. LLM asosidagi trening qimmat bo‘lsa-da, inference bosqichida tizim amaliy deployment’ga yaqin ekani ilgari suriladi.
13-sahifadagi RL convergence grafigi: Mukofot egri chizig‘i dastlabki 50 qadam ichida tez ko‘tarilib, 0.5–0.6 oralig‘ida barqarorlashgani ko‘rsatiladi. Maqola buni RL asosidagi LLM fine-tuning jarayoni collapse bo‘lmasdan barqaror ketayotganini ko‘rsatuvchi qo‘llab-quvvatlovchi dalil sifatida taqdim etadi.
Tajribalar qanday o‘tkazilgan?
Tadqiqot Ethereum va Bitcoin’da tajribalar o‘tkazadi. Ethereum tomonida firibgar label’lar Etherscan label cloud, XLabelCloud va CryptoScamDB kabi manbalardan olingan. Phishing, Upbit vulnerability attack, gambling va honeypot kabi noqonuniy yoki riskli hisob turlari qamrab olingan. Miner va moliyaviy xizmat provayderlari kabi ma’lum maxsus identifikatsiyalangan hisoblar esa benign deb baholangan.
Ethereum tranzaksiyalari 7-avgust 2015 bilan 10-aprel 2025 oralig‘idan yig‘ilgan. Nol qiymatli va muvaffaqiyatsiz tranzaksiyalar chiqarib tashlangan. Sender va receiver hisoblar o‘rtasida yo‘naltirilgan tranzaksiya grafigi qurilgan. Takroriy transferlarda bir xil hisob jufti o‘rtasidagi tranzaksiyalar bitta edge’da jamlanib, cumulative transfer amount va transaction frequency kabi feature’lar ishlatilgan.
Bitcoin tomonida ikki dataset ishlatilgan: Bitcoin-M va Bitcoin-L. Bitcoin-M 2015-yil iyunidan oldingi dastlabki 1.5 million tranzaksiyani qamrab oladi. Bitcoin-L esa 2015-yil iyun–sentabr oralig‘idagi barcha tranzaksiyalarni o‘z ichiga oladi. Bitcoin datasetlarida gambling va mixing servislariga bog‘liq manzillar firibgarlik yoki noqonuniy faoliyat bilan bog‘liq positive class sifatida qaralgan.
Model training/validation/test uchun 8:1:1 nisbatida bo‘lingan. Taqqoslash uchun DeepWalk, Node2Vec, GCN, GAT, GIN, GraphSAGE, APPNP, CARE-GNN, BWGNN, GRIT, DGA-GNN, PMP, Trans2Vec, TSGN, Ethident, TEGDetector, SIGTRAN, BERT4ETH va DIAM kabi 20 baseline usul ishlatilgan.
UniDetect’da 2-hop qo‘shni sampling bajarilgan va har hop uchun ko‘pi bilan \(K=10\) qo‘shni saqlangan. Compression’dan keyingi final subgraph hajmi \(N_c=10\) qilib belgilangan. LLM backbone sifatida Gemma-3-4B-it, embedding uchun Sentence-BERT, grafik backbone sifatida CARE-GNN asosidagi Dual-PGNN ishlatilgan. Treningda LoRA bilan parameter-efficient fine-tuning amalga oshirilgan.
Baholash metrikalari Precision, Recall, F1, AUC va KS qilib belgilangan. Bundan tashqari cross-chain zero-shot testda Ethereum’da o‘qitilgan model Bitcoin’ga qo‘llangan; cross-domain transfer testda esa Instagram ijtimoiy tarmoq datasetida business account klassifikatsiyasi sinovdan o‘tkazilgan.
Natijalar nimani ko‘rsatadi?
1. UniDetect Ethereum’da kuchli natija beradi. Ethereum datasetida UniDetect F1 92.65, AUC 94.82 va KS 68.94 ga erishadi. Bu natijalar manual feature engineering ishlatadigan bir-zanjirli usullar va umumiy grafik o‘rganish modellari bilan solishtirganda sezilarli yaxshilanishni ko‘rsatadi.
2. Bitcoin datasetlarida ham generalizatsiya ko‘rinadi. Bitcoin-M’da UniDetect F1 92.98, AUC 93.83 va KS 70.45; Bitcoin-L’da F1 93.41, AUC 95.22 va KS 72.25 ni qayd etadi. Bu usul Ethereum’ga xos ma’lumot formatiga haddan tashqari bog‘lanmaganini ko‘rsatadi.
3. Cross-chain zero-shot test kuchli, ammo assimetrik. Ethereum’da o‘qitilgan model Bitcoin’ga to‘g‘ridan-to‘g‘ri qo‘llanganda firibgar hisoblarning katta qismini aniqlay oladi. Biroq maqola normal hisoblarni ajratishda precision bo‘yicha qiyinchilik borligini ham qayd etadi. Bu real dunyoda false positive nazoratining ahamiyatini oshiradi.
4. LLM xulosa sifati kritik rol o‘ynaydi. Ikki bosqichli trening olib tashlanganda performance tushadi. Bu natija LLM’dan shunchaki tasodifiy xulosa olish o‘rniga, firibgarlikni aniqlash vazifasiga moslashtirilgan va graph model bilan birga optimallashtirilgan xulosalar muhimligini ko‘rsatadi.
5. Residual agent hallucination va ortiqcha talqin riskiga qarshi foydali ko‘rinadi. Residual summary agent olib tashlanganda performance keskin pasayadi. Bu task-relevant ma’lumot bilan task-irrelevant yoki over-inference kontentni ajratish ishonchli fraud detection uchun muhimligini qo‘llab-quvvatlaydi.
6. Dual-PGNN neighbourhood camouflage muammosiga qarshi yordam beradi. Firibgar hisoblar o‘zini begunoh qo‘shnilar bilan camouflage qilishi mumkin. Dual-PGNN node’ning o‘z summary feature’larini qo‘shni aggregation’dan mustaqil kanal sifatida saqlab, bu ta’sirni kamaytirishga urinadi.
7. Samaradorlik amaliy foydalanish uchun umidli ko‘rinadi. Trening bosqichi LLM sabab qimmat bo‘lsa-da, inference 1.47 ms/sample va 680 sample/s throughput bilan qayd etilgan. Bu tizim offline training + tez online score ishlab chiqarish yondashuviga mos bo‘lishi mumkinligini ko‘rsatadi.
Bu nima uchun muhim?
Kripto jinoyat daromadlarining turli zanjirlar o‘rtasida ko‘chirilishi moliyaviy jinoyat monitoring tizimlari uchun jiddiy qiyinchilik tug‘diradi. Manzil Ethereum’da shubhali ko‘rinmasligi mumkin; ammo Bitcoin, bridge, mixer yoki boshqa zanjirlardagi harakatlari bilan birga baholanganda mazmunliroq risk profili paydo bo‘lishi mumkin.
UniDetect’ning muhim tomoni zanjir farqlarini har biriga alohida qo‘lda feature ishlab chiqib hal qilishga urinmasligidir. Buning o‘rniga LLM bilan tranzaksiya xatti-harakatini umumiy tabiiy til representation’ida umumlashtiradi, keyin bu xulosalarni tranzaksiya grafigi bilan birga ishlatadi. Shu tariqa “hisob nima qildi?” savoliga ham matnli, ham strukturaviy javob berishga harakat qilinadi.
Bu yondashuv faqat blokcheyn uchun emas, boshqa firibgarlik sohalari uchun ham g‘oya beradi. Bank, e-commerce, ijtimoiy tarmoqlar, to‘lov tizimlari va sug‘urta kabi sohalarda ham xulq grafiklari va matnli izohlarni birga ishlatish mumkin. Tadqiqotning Instagram datasetida cross-domain test qilishi ushbu umumiy yondashuv boshqa sohalarga ham ko‘chirilishi mumkinligini ko‘rsatishni maqsad qiladi.
Biroq bu ahamiyat ehtiyotkorlik bilan ko‘rilishi kerak. Firibgarlikni aniqlash tizimlari false positive ishlab chiqarishi mumkin. Hisobning “riskli” ko‘rinishi aniq jinoyat dalili emas. Shu sabab UniDetect kabi tizimlar avtomatik jazolash vositasi emas; analitiklarni qo‘llab-quvvatlaydigan, tushuntiriladigan dalil ishlab chiqaradigan va inson tekshiruviga ustuvorlik beradigan decision-support tizimlari sifatida ishlatilishi kerak.
E’tibor beriladigan jihatlar
1. Ushbu tadqiqot preprint. Natijalar yakuniy hakamlikdan o‘tgan versiya aniqligi bilan baholanmasligi kerak.
2. Xavfsizlikka oid axborot berish maqsadini ko‘zlaydi. Bu yerdagi kontent firibgarlikni aniqlash usulini tushuntiradi; undan biror hisob yoki shaxs haqida qat’iy hukm chiqarish uchun foydalanmaslik kerak.
3. False positive riski muhim. Cross-chain zero-shot testda firibgarlarni aniqlash darajasi yuqori ko‘rinsa-da, normal hisoblarni noto‘g‘ri belgilash riski ham alohida boshqarilishi kerak.
4. Label sifati natijalarga ta’sir qiladi. Etherscan, XLabelCloud, CryptoScamDB yoki Bitcoin label’lari to‘liq bo‘lmasligi, kechikishi yoki bahsli bo‘lishi mumkin. Model faqat ishlatgan label’lari qanchalik ishonchli bo‘lsa, shunchalik ishonchli o‘rganadi.
5. LLM hallucination to‘liq yo‘qolmaydi. Maqola residual agent va RL fine-tuning bilan bu riskni kamaytirishga urinadi. Ammo real dunyoda LLM chiqishlari baribir nazorat qilinishi va dalildan tashqari da’volar filtrlanishi kerak.
6. Zanjirlararo ma’lumot tuzilmalari doim o‘zgarib turadi. Yangi protokollar, bridge’lar, mixer texnikalari, privacy vositalari va DeFi xatti-harakatlari modelni vaqt o‘tishi bilan qayta o‘qitishni talab qilishi mumkin.
7. Regulyatsiya va etika o‘lchami mavjud. Firibgarlikni aniqlash, money laundering monitoring va account risk scoring kabi sohalar huquqiy mas’uliyat tug‘dirishi mumkin. Avtomatik qaror tizimlari inson huquqlari, e’tiroz mexanizmi va ma’lumot maxfiyligi bilan birga loyihalanishi kerak.
Xavfli soha eslatmasi: Tadqiqot kripto hisoblarda firibgarlikni aniqlash bilan bog‘liq. Ushbu yozuv xavfsizlik va tadqiqot maqsadida axborot beradi. U biror manzil, shaxs, tashkilot yoki tranzaksiya haqida o‘zi yolg‘iz qat’iy ayblov vositasi sifatida ishlatilmasligi kerak. Real dunyoda bunday tizimlar inson tekshiruvi, qo‘shimcha dalil, huquqiy jarayon va false positive nazorati bilan birga qo‘llanishi zarur.
Umumiy baholash: Maqola kriptovalyuta firibgarligi endi bitta blokcheyn bilan cheklanmasligini, mablag‘lar turli zanjirlar o‘rtasida ko‘chirilib monitoring tizimlaridan qochishi mumkinligini ta’kidlaydi. Shu sabab Ethereum uchun yaratilgan usul Bitcoin’ga, Bitcoin uchun yaratilgan usul esa boshqa zanjirlarga to‘g‘ridan-to‘g‘ri ko‘chirilmasligi mumkin. UniDetect’ning asosiy g‘oyasi turli zanjirlardan kelgan tranzaksiya xatti-harakatlarini umumiy til va grafik representation ostida birlashtirishdir.
Xulosa
UniDetect tadqiqoti kripto firibgarligini aniqlashdagi muhim tendensiyani ifodalaydi: faqat grafik neyron tarmog‘i yoki faqat qo‘lda ishlab chiqilgan zanjir feature’lari yetarli bo‘lmasligi mumkin. Cross-chain dunyoda tranzaksiya xatti-harakatini ham semantik tarzda umumlashtiradigan, ham grafik tuzilmasi ichida baholaydigan multimodal tizimlarga ehtiyoj ortmoqda.
Maqola LLM agentlari tranzaksiya ma’lumotini o‘qilishi oson xulosalarga aylantira olishini, ammo bu xulosalar albatta vazifaga yo‘naltirilgan holda filtrlanishi kerakligini ko‘rsatadi. Discriminative summary aniqlash uchun farqlovchi ma’lumotni ajratadi, residual summary esa hallucination va over-inference riskini kamaytirishga yordam beradi. Dual-PGNN bu matnli ma’lumotni hisob grafigi bilan birlashtirib node-level fraud detection qiladi.
Tajribalarda UniDetect Ethereum, Bitcoin-M va Bitcoin-L’da kuchli natija bergani qayd etiladi. Cross-chain va cross-domain testlar ham usul faqat bitta zanjirga bog‘lanib qolmaganini ko‘rsatadi. Shunga qaramay, real dunyoda bunday tizimlar yolg‘iz hukm chiqaradigan vosita emas, analitiklarni qo‘llab-quvvatlaydigan dalil ishlab chiqarish tizimlari sifatida ishlatilishi kerak.
Verianla o‘quvchisi uchun asosiy xabar shuki: kripto firibgarligini endi bitta zanjirda kuzatish yetarlicha sodda emas. Mablag‘ oqimlari zanjirlar bo‘ylab tarqalar ekan, aniqlash tizimlari ham til xulosasi, grafik tuzilmasi, xulq pattern’i va inson nazoratini birgalikda ishlatadigan universalroq yondashuvlarga o‘tishi kerak.
Manba va usul bo‘yicha izoh
Ushbu yozuv “UniDetect: LLM-Driven Universal Fraud Detection across Heterogeneous Blockchains” nomli akademik PDF asosida tayyorlangan original o‘zbekcha tahririy kontentdir. Matn so‘zma-so‘z tarjima emas; tadqiqotdagi muammo, usul, formulalar, grafiklar, jadvallar, tajribalar, natijalar va cheklovlar soddalashtirib bayon qilingan.
Xavfsizlik va firibgarlikni aniqlash mavzulari qat’iy ayblov tili bilan emas, risk tahlili va decision-support doirasida bayon qilingan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan