

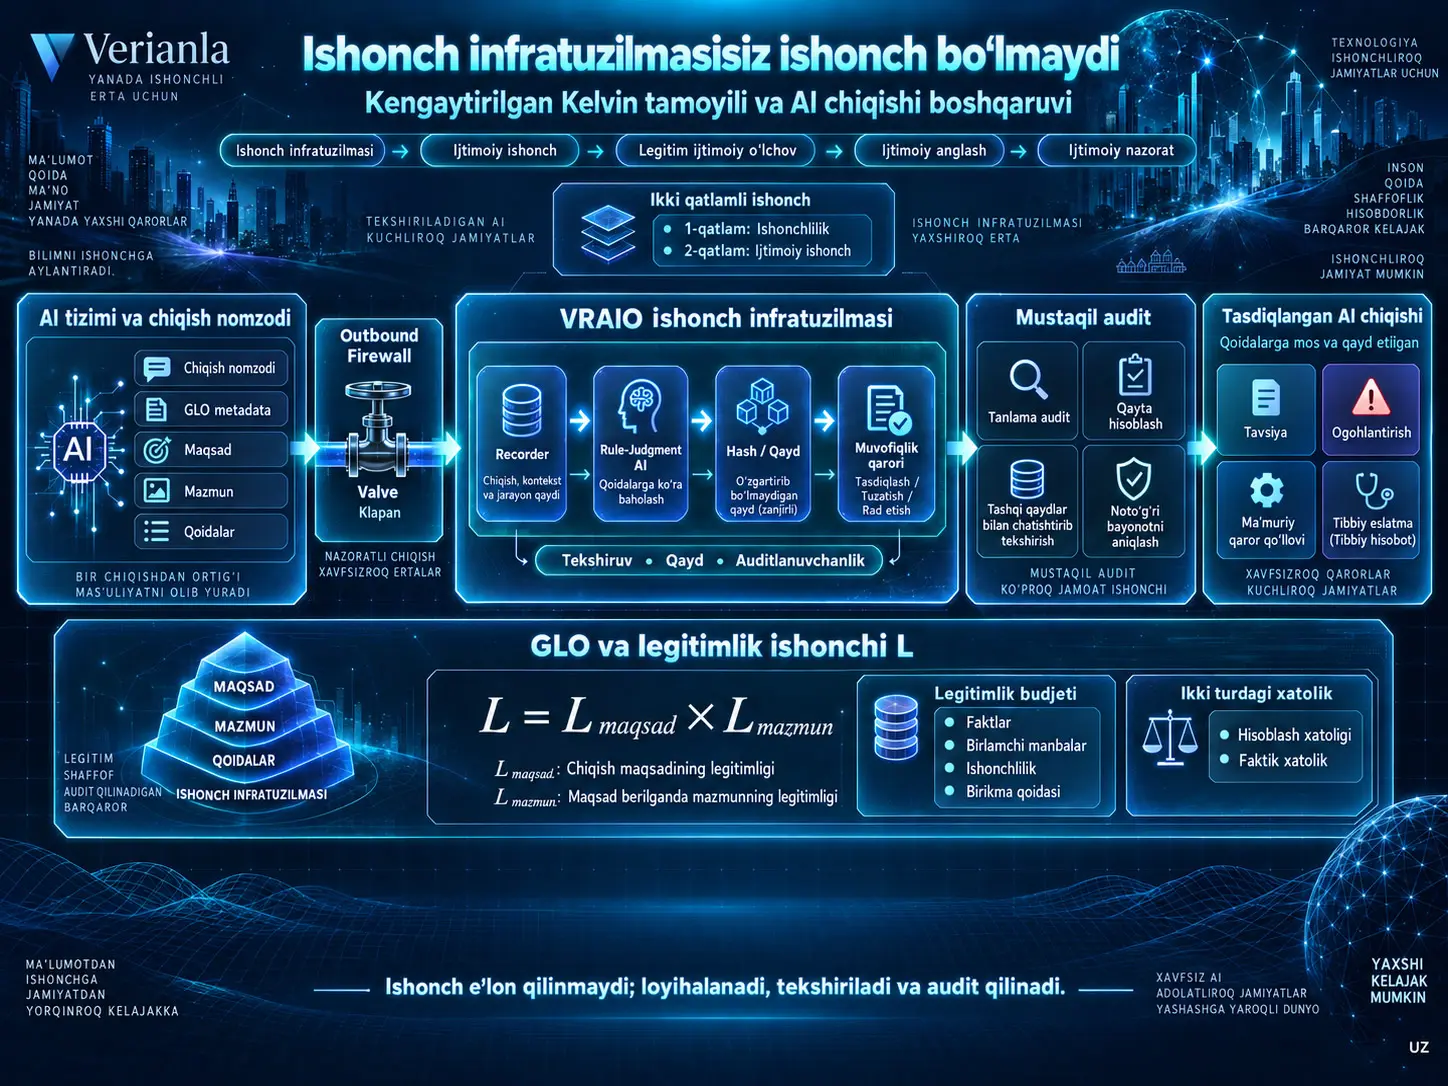
Ushbu tadqiqot sunʼiy intellektga nisbatan ijtimoiy ishonchni shaxslar yoki tashkilotlarning “bizga ishoning” turidagi bayonotlari orqali emas, balki natijalarni tekshiriladigan, qayd etiladigan va mustaqil ravishda audit qilinadigan holga keltiruvchi ishonch infratuzilmasi orqali tushuntiradigan konseptual boshqaruv doirasini taklif qiladi. Yusaku Fujii ishlab chiqqan Kengaytirilgan Kelvin Prinsipi klassik oʻlchash–tushunish–nazorat zanjiri oldiga ikkita yangi shartni qoʻshadi: ijtimoiy ishonch uchun ishonch infratuzilmasi, legitim ijtimoiy oʻlchash uchun esa ijtimoiy ishonch zarur. Tadqiqot ushbu nazariy prinsipni sunʼiy intellekt natijalarini boshqarishga qoʻllash uchun GLO (Guide to the Expression of Legitimacy of Output) deb ataluvchi umumiy natija-legitimlik tili va VRAIO (Verifiable Record of AI Output) deb ataluvchi tekshirish, qayd etish va audit infratuzilmasini birgalikda koʻrib chiqadi.
Doirada AI natijasi faqat matn, tasvir yoki qaror sifatida emas, balki qoidalarga muvofiqligi asoslanishi kerak boʻlgan daʼvo sifatida koʻriladi. Natijaning maqsadi va mazmuni uchun qoidalarga muvofiqlik darajasi \(L\) deb ataluvchi legitimlik ishonchi bilan ifodalanadi; biroq \(L\) yolgʻiz holda eʼlon qilinishi mumkin emas. Qiymatni shakllantirgan faktlar, birlamchi manbalar, ishonchlilik baholari va birlashtirish usuli keltirilgan legitimlik byudjeti ham boʻlishi kerak. Mustaqil Recorder, deterministik Rule-Judgment AI, oʻzgartirishga chidamli qayd infratuzilmasi va oldindan ogohlantirilmaydigan spot auditlar ushbu bayonotlarni keyinchalik tekshirish mumkin boʻlishini koʻzlaydi.
Maqolaning hissasi tajriba orqali tasdiqlangan global AI boshqaruv tizimini taqdim etish emas. GLO va VRAIO kelajakda konkretlashtirilishi va turli sohalarda sinab koʻrilishi kerak boʻlgan institutsional-texnik dizayn taklifidir. Xususan, \(L\)ning umumiy birlashtirish qoidasi, Rule-Judgment AI’ning real amaliyoti, xalqaro oʻzaro ishlash imkoniyati, audit tashkilotlarining mustaqilligi, safe-harbor mexanizmlari va kompensatsiya modeli tafsilotlari hanuz ochiq tadqiqot va siyosat dizayni sohalaridir.
Texnik jihatdan yaxshi tizim nega oʻzi yolgʻiz ijtimoiy ishonchni hosil qilmasligi mumkin?
Maqola boshlangʻich nuqtani COVID-19 davridagi raqamli kontaktlarni kuzatish ilovalaridan oladi. Texnik jihatdan maxfiylikni saqlovchi tizimlar ishlab chiqilgan boʻlsa ham, ilovaning ijtimoiy funksiyasi foydalanuvchilarning ilovani oʻrnatishi, undan foydalanishi, ijobiy holat haqidagi maʼlumotni qayd etishi va kelgan ogohlantirishlarga qarab xatti-harakatini oʻzgartirishiga bogʻliq edi. Odamlar tizimga ishonmasa, texnik oʻlchash infratuzilmasining oʻzi ishlasa ham ijtimoiy oʻlchash zanjirining birinchi boʻgʻini yetishmay qolishi mumkin.
Fizik oʻlchashda harorat, massa yoki elektr toki oʻlchanishga qarshilik bildirmaydi. Ijtimoiy oʻlchashda esa oʻlchanayotgan obyekt inson xatti-harakatidir. Odamlar maʼlumot toʻplanishiga ruxsat berishi, rad etishi, tizimdan chetlashishi yoki tizim bergan qarorga eʼtiroz bildirishi mumkin. Shu sababli ijtimoiy oʻlchash faqat sensor va algoritm masalasi emas; maxfiylik, rozilik, legitimlik, hisobdorlik va institutsional ishonch ham tizim ishlashining shartlariga aylanadi.
Kengaytirilgan Kelvin Prinsipi Nima?
Kengaytirilgan Kelvin Prinsipi klassik Kelvin yondashuvidagi “oʻlchash boʻlmasa tushunish, tushunish boʻlmasa nazorat boʻlmaydi” mantiqini ijtimoiy oʻlchash va sunʼiy intellekt boshqaruvi uchun kengaytiruvchi konseptual zanjirdir. Maqola taklif qilgan kengaytirilgan tuzilma ishonch infratuzilmasi → ijtimoiy ishonch → legitim ijtimoiy oʻlchash → ijtimoiy tushunish → ijtimoiy nazorat koʻrinishida davom etadi.
Manbada tuzilgan zanjirning mohiyati quyidagi mantiqdan iborat:
Ishonch infratuzilmasi boʻlmasa ijtimoiy ishonchni shakllantirib boʻlmaydi → ijtimoiy ishonch boʻlmasa legitim ijtimoiy oʻlchashni yoʻlga qoʻyib boʻlmaydi → ijtimoiy oʻlchash boʻlmasa ijtimoiy tushunishni shakllantirib boʻlmaydi → ijtimoiy tushunish boʻlmasa ijtimoiy nazoratni yoʻlga qoʻyib boʻlmaydi.
Bu yerda “nazorat” atamasi oʻzboshimchalik bilan amalga oshiriladigan ijtimoiy nazorat maʼnosida ishlatilmaydi; u Kelvin zanjirida oʻlchashdan bilimga va bilimdan aralashuv/qaror qabul qilish qobiliyatiga oʻtishning ijtimoiy oʻlchash kontekstidagi muqobilidir. Maqolaning oʻzi bu zanjirni ayniqsa demokratik jamiyatlarda legitim, rozilik va barqaror hamkorlikka asoslangan ijtimoiy oʻlchash bilan cheklaydi.
Legitim ijtimoiy oʻlchash nega alohida ajratiladi?
Muallif odamlardan maʼlumot yigʻish ishonchsiz texnik jihatdan imkonsiz, deb aytmaydi. Majburlash, yashirin maʼlumot yigʻish yoki haddan tashqari kuzatuv sharoitida ijtimoiy maʼlumot toʻplash mumkin. Biroq maqola muhokama qilayotgan tuzilma bu emas. Doira demokratik jamiyatda fuqarolar hamkorligi va roziligiga tayangan, uzoq muddat barqaror va legitim ijtimoiy oʻlchash bilan shugʻullanadi.
Shuning uchun Kengaytirilgan Kelvin Prinsipi “ishonchsiz hech qanday maʼlumot olib boʻlmaydi” tarzida talqin qilinmasligi kerak. Daʼvo yanada cheklangan: odamlarning oʻlchanishga va AI tomonidan baholanishga nisbatan legitim qabul qilishi talab qilinadigan ijtimoiy infratuzilmalarda ishonch oʻlchash tizimining institutsional shartlaridan biridir.
Ishonch va Ishonchlilik Oʻrtasidagi Farq Nima?
Maqola ishonchni ikki qatlamga ajratadi. Birinchi qatlam trustworthiness — ishonchlilik, yaʼni AI natijalari haqiqatan ham qoidalarga muvofiq ekanining obyektiv va tekshiriladigan boʻlishidir. Ikkinchi qatlam esa trust — ishonch, odamlarning ushbu tekshiriladigan shart ishlayotganini koʻrib, AI tomonidan maʼlum yoki baholanadigan subyekt boʻlishni qabul qilishidir.
Birinchi qatlam ijtimoiy bayonotlar orqali emas; tekshirish imkoniyati, qayd, oʻzgartirishga chidamlilik, mustaqil audit qilinish imkoniyati va notoʻgʻri bayonot xarajatini oshiruvchi sanksiya mexanizmlari orqali qurishga harakat qilinadi. Ikkinchi qatlamda esa odamlarning ushbu infratuzilma haqiqatan ishlayotganiga doir tajriba va bilim asosida shakllantirgan qabuli mavjud.
Maqola ikkinchi qatlamda ham muhim farq qiladi. Odamlar tizimni haqiqatan tekshiriladigan deb topgani uchun qabul qilishi mumkin; biroq faqat qarshilik koʻrsatishni bas qilgani uchun ham tizimga koʻnikishi mumkin. Muallif demokratik legitimlik nuqtai nazaridan afzal shaklni “tajriba bilan qoʻllab-quvvatlangan ongli qabul” deb taʼriflaydi.
Jamiyat ishonch infratuzilmasini oʻzgartira olishi
Ishonch modeli bir yoʻnalishli emas. Fuqarolik nazorati, ommaviy muhokama va demokratik jarayonlarda yuzaga keladigan eʼtirozlar qoʻllanadigan Rules mazmunini va shu tariqa birinchi qatlamdagi tekshirish mezonlarini oʻzgartirishi mumkin. Natijada ishonch infratuzilmasi oʻzgarmas texnik qurilma emas, balki jamiyatning fikr-mulohazalari asosida qoidalarini yangilay oladigan institutsional sikl sifatida qaraladi.
Kirish, model ichki va natija boshqaruvi
Tadqiqot mavjud AI boshqaruvi yondashuvlarini uch keng guruhda muhokama qiladi.
- Kirishni tartibga solish: shaxsiy maʼlumotlarning qanday yigʻilishi, saqlanishi va ishlatilishi.
- Ichki tuzilmani tartibga solish: model shaffofligi, tushuntiriladigan AI, algoritmik audit, model cards va datasheets.
- Natijani tartibga solish: kontent filtrlari, xavfsizlik tekshiruvlari va zararli natijani cheklash.
Maqola daʼvosiga koʻra, bu qatlamlarning hech biri keraksiz emas; biroq natijaga xos ravishda “qaysi qoida boʻyicha ruxsat berildi, qanday tekshiruv oʻtkazildi, qanday qayd yaratildi va keyin uni kim audit qilishi mumkin?” savollarini oʻzi yetarli darajada hal qilmaydi.
AI’ning jamiyatga bevosita tegadigan tomoni koʻpincha model vaznlari emas, balki hosil boʻlgan matn, tasvir, tavsiya, ogohlantirish, qarorni qoʻllab-quvvatlash yoki tasnifdir. Shu sababli tadqiqot natija darajasida alohida boshqaruv infratuzilmasini taklif qiladi.
GLO Nima va U Nimani Tushuntirishni Maqsad Qiladi?
GLO — Guide to the Expression of Legitimacy of Output — AI natijasining maqsadi va mazmuni oldindan belgilangan qoidalarga qay darajada mos kelishini strukturaviy metadata orqali ifodalashga qaratilgan umumiy tildir. GLO modelning ichki vaznlarini yoki toʻliq inferensiya yoʻlini tushuntirishga urinmaydi; natija nomzodining oʻzini “daʼvo” sifatida koʻradi va bu daʼvoning qoidalarga muvofiqligi faktlar orqali asoslanishini talab qiladi.
Shu jihatdan GLO’ning manbadagi roli oʻlchash fanidagi GUM’ning AI uchun aynan ekvivalenti boʻlish emas. Muallif ular oʻrtasida strukturaviy analogiya oʻrnatadi: GUM oʻlchash noaniqligining umumiy ifoda tilini taʼminlasa, GLO AI natijasi legitimligining umumiy ifoda tili boʻlishni maqsad qiladi.
GLO metadata maydonlari
| Maydon | Funksiya |
|---|---|
| Output ID | Har bir natija nomzodiga noyob identifikator beradi. |
| Timestamp | Natija yaratilgan vaqtni qayd etadi. |
| Operator ID | AI tizimini boshqarayotgan tomonni va masʼuliyat aloqasini belgilaydi. |
| Receiver ID / Category | Natija kimga yoki qaysi qabul qiluvchi sinfiga yuborilishini koʻrsatadi. |
| Output Type | Natijani oldindan belgilangan ontology/tasnifga bogʻlaydi. |
| Risk Classification | Natijaning belgilangan xavf sinfini koʻrsatadi. |
| Applicable Rules Reference | Qaysi qoidalar qoʻllanganini koʻrsatadi. |
| Legitimacy Confidence L | Maqsad va mazmunning Rules’ga muvofiqlik darajasining hosila qiymatidir. |
| Legitimacy Budget | L qaysi faktlar, manbalar va birlashtirish usuliga tayanganini koʻrsatadi. |
| Output Hash | Deklaratsiyani keyinchalik haqiqiy natija bilan moslashtirish imkonini beradi. |
| Domain-Specific Fields | Sohaga xos qoʻshimcha xavfsizlik va boshqaruv maʼlumotlarini tashiydi. |
Legitimlik Ishonchi L Nimani Ifodalaydi?
Legitimlik ishonchi \(L\), maqolada natija nomzodining maqsadi va mazmunining belgilangan Rules’ga muvofiqligiga oid hosila qiymat sifatida \(0\) bilan \(1\) orasida taʼriflanadi. Asosiy formulada maqsad legitimligi bilan, oʻsha maqsad berilganda mazmun legitimligining koʻpaytmasi ishlatiladi:
\[ L=L_{\mathrm{purpose}}\times L_{\mathrm{content}} \]
Bu yerda:
- \(L_{\mathrm{purpose}}\): natija maqsadining qoidalarga muvofiqligi boʻyicha ishonch darajasi,
- \(L_{\mathrm{content}}\): eʼlon qilingan maqsad hisobga olinganda mazmunning qoidalarga muvofiqligi boʻyicha ishonch darajasidir.
Koʻpaytma shaklining ikkita muhim oqibati bor. Birinchisi, maqsad yoki mazmundan biri nolga tushsa, umumiy \(L\) ham nolga tushadi. Ikkinchisi, ikkala komponent ehtimolli muvofiqlik sifatida talqin qilinsa, koʻpaytma maqsad va mazmunning birgalikda mos boʻlish ehtimoliga oʻxshash tuzilmani beradi.
Biroq maqola koʻpaytma qoidasini universal va oʻzgarmas standart deb eʼlon qilmaydi. \(L\) bitta qiymat sifatida yoki ikki alohida komponent koʻrinishida eʼlon qilinadimi va murakkabroq argumentlarda birlashtirish qoidasi qanday boʻladi — bular Rules doirasida hal qilinishi kerak boʻlgan dizayn muammolaridir.
Legitimlik Byudjeti Nega L Qiymatidan Koʻproq Narsani Talab Qiladi?
Legitimlik byudjeti \(L\)ning oʻzi alohida tarqalib ketishining oldini olish va qiymat bilan birga uni shakllantirgan faktlarni, har bir fakt tayangan birlamchi manbani, fakt ishonchliligini va birlashtirish usulini kuzatiladigan qilish uchun taklif etilgan strukturaviy asoslash qatlamidir.
Maqola bu yerda oʻlchash fanidagi noaniqlik byudjeti bilan strukturaviy oʻxshashlik oʻrnatadi. Oʻlchash qiymati yonida noaniqlik, noaniqlik yonida esa uni hosil qilgan komponentlar byudjeti boʻlishi mumkin boʻlgani kabi; AI natijasi yonida \(L\), \(L\) yonida esa legitimlik byudjeti turadi.
Shuning uchun \(L\) model yoki operatorning “0,94 ishonchli” kabi izohsiz ball berishini anglatmaydi. Qiymat qaysi faktlardan qanday hosil qilinganini qayta hisoblash mumkin boʻlishi kerak.
Maqolada alohida taʼkidlangan jihatlardan biri, legitimlik byudjeti hamma uchun ochiq boʻlishi shart emasligi. Byudjet maxfiylik nuqtai nazaridan nozik maʼlumotlarni oʻz ichiga olishi mumkin. Talab qilinadigan xususiyat “umumiy oshkor etish” emas, balki vakolatli audit kanali orqali kirish mumkinligi va tekshirilishi mumkinligidir.
VRAIO Nima va GLO bilan Qanday Birga Ishlaydi?
VRAIO — Verifiable Record of AI Output — GLO metadata bayonini institutsional jihatdan tekshiriladigan, qayd etiladigan va audit qilinadigan holga keltirishga qaratilgan natija boshqaruvi infratuzilmasidir. GLO “legitimlik qaysi til va formatda bayon qilinadi?” savoliga eʼtibor qaratsa, VRAIO “bu bayon haqiqatan qilinganini, qoidalar bilan taqqoslanganini va keyinchalik audit qilinishi mumkinligini qaysi infratuzilma kafolatlaydi?” savoliga javob berishni maqsad qiladi.
VRAIO’ning asosiy komponentlari
- Rules: qoʻllanadigan maqsadlar, nishonlar, shartlar va taqiqlarni belgilaydi.
- AI tizimi: natija nomzodi bilan birga GLO metadata bayonini yaratadi.
- Outbound Firewall: nomzod natijaning bevosita tashqariga chiqishini toʻsadigan chiqish qatlamidir.
- Recorder: GLO metadata va qoidalar oʻrtasidagi formal muvofiqlikni tekshiruvchi mustaqil uchinchi tomon rolidir.
- Valve: muvofiqlik sharti bajarilganda natijaning tashqariga chiqishiga ruxsat beruvchi darvozadir.
- Tamper-resistant ledger: natija identifikatori, metadata, qoʻllangan qoidalar, qaror, timestamp va output hash kabi maʼlumotlarni keyinchalik oʻzgartirishga chidamli tarzda qayd etadi.
- Audit body / fuqarolik nazorati: qaydlar va spot auditlardan foydalanib, tizim bayonotlari ustidan mustaqil nazoratni taʼminlaydi.
VRAIO jarayon oqimi
- Qoidalar ijtimoiy, huquqiy va demokratik protseduralar orqali belgilanadi.
- AI tizimi natija nomzodi va unga bogʻliq GLO metadata yaratadi.
- Recorder bayonotni Rules bilan taqqoslaydi; qaror va metadata qayd infratuzilmasiga yoziladi.
- Shartlar bajarilsa Valve ochiladi va natija qabul qiluvchiga yuboriladi.
- Fuqarolar yoki vakolatli audit organlari keyinchalik qaydlarni tekshirishi va spot auditlar oʻtkazishi mumkin.
- Audit natijalari zarur boʻlsa Rules yangilanishiga qayta aloqa sifatida kiritiladi.
Nega har bir natija doimiy kontent auditidan oʻtkazilmaydi?
VRAIO’ning asosiy dizayni har bir natijaning butun mazmunini real vaqt rejimida inson auditoriga oʻqitish emas. Doiraning tiyib turuvchi kuchi qayd, hash, qayta hisoblash, tasodifiy/spot audit va notoʻgʻri bayonot aniqlanganda jiddiy sanksiya ehtimolining birgalikda ishlashiga tayanadi.
Muallif argumentiga koʻra, maqsad notoʻgʻri deklaratsiyani iqtisodiy va institutsional jihatdan ratsional xatti-harakat boʻlishdan chiqarishdir. Shu sababli Valve’ning real vaqt rejimidagi bloklashi tizimning yagona kafolat nuqtasi emas.
Rule-Judgment AI Nima?
Rule-Judgment AI natija nomzodi va GLO doirasida bildirilgan fakt/argumentlarni qabul qilib, ularni oldindan belgilangan Rules boʻyicha baholaydigan, bir xil kirishga bir xil natija berishi koʻzlangan mustaqil va deterministik tekshiruvchi komponentdir. Maqolada bu komponentning “sealed” boʻlishi, yaʼni zarur maʼlumotni oʻqiy olsa ham tashqariga faqat \(L\) va muvofiqlik natijasi kabi cheklangan qarorni chiqarishi nazarda tutiladi.
Sealed tekshiruv nega ishlatiladi?
Legitimlik byudjeti tibbiy qayd, qidiruv vakolati, shaxsiy tasvir yoki boshqa nozik maʼlumotlarni oʻz ichiga olishi mumkin. Agar audit qilinish imkoniyati bu maʼlumotlarning barchasini jamoatchilikka ochishni talab qilsa, maxfiylik bilan jiddiy ziddiyat yuzaga keladi.
Maqola taklif qilgan assimetriya shunday: tekshiruvchi zarur boʻlgancha maʼlumotni oʻqishi mumkin; ammo tashqariga faqat minimal qaror maʼlumotini chiqaradi. Muallif bu yondashuvni zero-knowledge proofs, xavfsiz hisoblash va trusted execution environment kabi maxfiylikni kuchaytiruvchi texnologiya sinflari bilan strukturaviy jihatdan bogʻlaydi.
Hisoblash Xatosi va Faktik Xato Qanday Ajratiladi?
Tadqiqot notoʻgʻri bayonotni ikki xil qatlamda koʻrib chiqadi. Hisoblash xatosi, berilgan faktlar past \(L\)ni talab qilgan holda AI tizimining yuqori \(L\) bildirishi. Deterministik Rule-Judgment AI ayni faktlar bilan \(L\)ni qayta hisoblay olgani uchun bunday nomuvofiqlik bevosita aniqlanishi mumkin. Faktik xato esa hisoblashga kiritilgan faktning oʻzi toʻgʻri boʻlmasligidir; masalan, amalda mavjud boʻlmagan sud qarorini “mavjud” deb bildirish. Bu ikkinchi turdagi xato tashqi vakolatli qaydlar bilan oʻzaro tekshiruvni talab qiladi.
Shu sababli Rule-Judgment AI masʼuliyati “berilgan faktlardan \(L\) toʻgʻri hisoblandimi?” savoli bilan cheklanadi. “Faktlar haqiqatan toʻgʻrimi?” savoliga javob esa sud, sogʻliqni saqlash muassasasi yoki boshqa birlamchi qayd egasining vakolatli yozuvlaridan tekshiriladi.
Deterministik boʻlishi nega muhim?
Bir xil kirish turli vaqtlarda turli natija bersa, oldingi bayon haqiqatda toʻgʻri hisoblangan yoki hisoblanmaganini qatʼiy ravishda qayta tekshirish qiyinlashadi. Deterministik dizaynda bir xil maʼlumot va bir xil Rules bir xil \(L\)ni hosil qilishi kerak. Bu xususiyat maqola oʻlchash fanidagi oʻzgarmas etalon standart bilan oʻrnatgan analogiyaning markazidadir.
LLM roli nega cheklanadi?
Maqoladagi Rule-Judgment AI dizaynida LLM turidagi komponentning vazifasi yakuniy legitimlik qarorini berish emas. LLM tabiiy tildagi fakt va argumentlarni Rules belgilagan strukturaviy parametrlar makoniga aylantirish uchun ishlatilishi mumkin. Yakuniy muvofiqlik qarori esa ushbu strukturaviy parametrlarning qoidalar bilan mexanik taqqoslanishiga tayanishi kerak.
Agreement gate nimani kafolatlaydi?
AI tizimi bildirgan \(L\) bilan Rule-Judgment AI hisoblagan \(L\) sezilarli darajada mos kelsa, natija chiqarilishi mumkin. Biroq maqola bu “haqiqat kafolati” emasligini ochiq tan oladi. AI tizimi va tekshiruvchi bir xil tarafkashlik yoki bir xil notoʻgʻri taxminni baham koʻrishi va shunga qaramay bir-biri bilan mos kelishi mumkin. Shu sababli agreement gate dastlabki filtr xususiyatiga ega; tashqi qayd tekshiruvi va spot audit oʻrnini bosmaydi.
Tadqiqot Usuli va Natijalari
Tadqiqotning metodologik xususiyati
Bu tadqiqot klassik maʼnoda trening/test maʼlumotlar toʻplamlarida AI modelini sinab, aniqlik metrikasini hisobot qiladigan empirik maqola emas. Metod adabiyotdagi ishonch, ijtimoiy oʻlchash, AI boshqaruvi, algoritmik hisobdorlik va oʻlchash fani tushunchalari orqali institutsional muammoni belgilash, Kelvin prinsipini ijtimoiy oʻlchashga kengaytirish va undan soʻng GLO/VRAIO arxitekturasini shu muammoga yechim yoʻnalishi sifatida shakllantirishga asoslanadi.
Shu sababli “natija” soʻzi bu yerda eksperimental unumdorlik natijasi maʼnosini anglatmaydi. Tadqiqot natijasi muallif tuzgan konseptual zanjir va undan chiqarilgan institutsional arxitekturadir.
Kelvin prinsipi va AI boshqaruvi oʻrtasidagi nazariy oʻtish
Manba avval fizik oʻlchashda oʻlchash, tushunish va nazorat oʻrtasidagi munosabatni koʻrib chiqadi. Keyin inson oʻlchanishga nisbatan munosabat shakllantira oladigan ijtimoiy oʻlchash sohasida rozilik va ishonch ushbu zanjirning old sharti ekanini ilgari suradi.
Shundan ikki kengaytma kelib chiqadi:
- Legitim ijtimoiy oʻlchash ijtimoiy ishonchni talab qiladi.
- Ijtimoiy ishonch ishonch infratuzilmasini talab qiladi.
Yakuniy zanjir:
Trust Infrastructure → Social Trust → Legitimate Social Measurement → Social Understanding → Social Control
koʻrinishida tuziladi.
GUM va GLO oʻrtasidagi strukturaviy analogiya
| Oʻlchash fani | AI natijalarini boshqarish |
|---|---|
| Oʻlchash noaniqligining ifodasi | AI natijasi legitimligining ifodasi |
| GUM | GLO |
| Kalibrlash infratuzilmasi, milliy metrologiya tashkilotlari | VRAIO, Recorder, audit bodies, tamper-resistant ledger |
| Oʻlchash qiymatlariga ijtimoiy ishonch | AI natijalariga ijtimoiy ishonch |
| Xalqaro metrologiya tizimi | AI natijalari boshqaruvida xalqaro oʻzaro ishlash maqsadi |
Bu jadval fizik oʻlchash noaniqligi bilan AI legitimligini ayni narsa deb eʼlon qilmaydi. Muallif ikki sohaning normativ tuzilmalari farqli ekanini ochiq taʼkidlaydi. Oʻxshashlik umumiy ifoda tili bilan uni qoʻllab-quvvatlovchi institutsional tekshiruv infratuzilmasi oʻrtasidagi munosabatdadir.
Lning uch qatlamli axborot tuzilmasi
Tadqiqotning GUM analogiyasi individual-output darajasida uch qatlamga kengaytiriladi:
- Natija nomzodi
- Legitimlik ishonchi \(L\)
- Legitimlik byudjeti
Shu tariqa \(L\) birlamchi maʼlumot yoki AI natijasining oʻzi emas. U natijaga oid ikkinchi darajali muvofiqlik miqdoridir. Legitimlik byudjeti esa bu miqdor qaysi faktlar va birlashtirish mantiqiga tayanganini tushuntiruvchi uchinchi darajali axborotdir.
Murakkabroq natijalarda L
Oddiy holatda:
\[ L=L_{\mathrm{purpose}}\times L_{\mathrm{content}} \]
ishlatiladi. Biroq, masalan, koʻplab faktlar iyerarxik tarzda siyosiy tavsiyani qoʻllab-quvvatlaydigan murakkabroq holatlarda maqola argument grafigi haqida gapiradi. Bunday grafikning barglarida faktlar, ildizida esa xulosa boʻlishi mumkin.
Bu holatda fakt ishonchliliklari yakuniy \(L\)ga qanday oʻtkaziladi — dispersiya tarqalishiga oʻxshash birlashtirishmi yoki eng zaif argument ustun boʻladigan boshqa qoida mi — bu maqolada umumiy tarzda hal etilmaydi. Muallif buni kelajakdagi tadqiqot yoʻnalishlaridan biri sifatida qoldiradi.
Amaliy misol: toʻliq kuzatiladigan jamoat makonida yoʻqolgan bolani qidirish
Maqola taklif etilgan doirani yanada aniq koʻrsatish uchun FMPS — Fully Monitored Public Space — ssenariysidan foydalanadi. Koʻplab kameralar markaziy AI tizimiga ulangan jamoat makonida yoʻqolgan bolani topish misoli koʻrib chiqiladi.
Bu misol ayniqsa mos keladi, chunki ikki qiymat bir vaqtda yuqori:
- bolaning hayoti va xavfsizligi tufayli qidiruv ijtimoiy jihatdan katta ahamiyatga ega;
- kamera tasvirlari va odamlarning harakat yoʻllari tufayli maxfiylik xavfi ham yuqori.
Maqsad legitimligi
Yoʻqolgan bolani qidirish maqsadi, masalan, amal qiluvchi qidiruv vakolati, ota-ona murojaati yoki tasdiqlangan huquqni muhofaza qiluvchi organ talabi kabi faktlar bilan qoʻllab-quvvatlanishi mumkin. Agar bu faktlar vakolatli birlamchi qaydlarda tasdiqlansa \(L_{\mathrm{purpose}}\) yuqori boʻlishi mumkin.
Hech qanday vakolatli talab yoki huquqiy asos boʻlmasa, maqsad legitimligini asoslash zaiflashadi.
Mazmun legitimligi
Qidiruv maqsadi legitim boʻlsa ham, tizim kiradigan yoki tashqariga chiqaradigan maʼlumotlar koʻlami cheksiz emas. Bolaning joriy joylashuvini aniqlash uchun zarur harakat izi bilan hududda tasodifan boʻlgan barcha shaxslarning uzoq muddatli harakat tarixini chiqarish bir xil narsa emas.
Maqola yondashuviga koʻra, mazmun koʻlami eʼlon qilingan maqsaddan oshib keta boshlagan sari \(L_{\mathrm{content}}\) pasayishi kerak. Shu tariqa maʼlumotlarni minimallashtirish va mutanosiblik abstrakt prinsip boʻlish oʻrniga \(L\)ning mazmun komponentiga bogʻlangan boshqaruv mezoniga aylanadi.
Maxfiylik va audit qilinish imkoniyatini bir vaqtda saqlash
Yoʻqolgan bola ssenariysida legitimlik byudjetining oʻzi ham nozikdir: bolani harakat izi, qidiruv koʻlami va vakolat berish maʼlumotlari boʻlishi mumkin.
Muallifning yechim yoʻnalishi “hammasini oshkor qilish” emas. Byudjetni audit uchun ochiq, lekin ommaga oshkor qilinmaydigan shaklda saqlash va sealed Rule-Judgment AI nozik mazmunni tashqariga sizdirmasdan faqat \(L\) va muvofiqlik natijasini qaytarishi taklif etiladi.
Bu ssenariyda xatoni aniqlash
Agar tizim berilgan faktlarga koʻra past boʻlishi kerak boʻlgan \(L_{\mathrm{content}}\)ni yuqori deb bildirsa, deterministik qayta hisoblash buni koʻrsatishi mumkin.
Agar tizim aslida mavjud boʻlmagan qidiruv buyrugʻini “mavjud” deb bildirsa, qayta hisoblashning oʻzi yetarli emas; bildirilgan vakolatning haqiqatan mavjud yoki yoʻqligi sud yoki vakolatli organ qaydlari bilan oʻzaro tekshirilishi kerak.
Bu misol nega bir vaqtning oʻzida VRAIO chegarasini ham koʻrsatadi?
Yoʻqolgan bola ssenariysidagi muhim faktlarning koʻpi tashqi vakolatli qaydlardan tasdiqlanishi mumkin. Shu sababli VRAIO’ning notoʻgʻri bayonotni aniqlash mantiqi bu yerda nisbatan kuchli.
Aksincha, mutlaqo subyektiv qadriyat hukmlarida tashqi dunyoda tekshirilishi mumkin boʻlgan vakolatli qayd boʻlmasligi mumkin. Maqola buni doiraning muhim qoʻllanish cheklovlaridan biri sifatida tan oladi.
Ragʻbat va javobgarlik modeli
Tadqiqot faqat texnik tekshiruvni emas, operator ragʻbatlarini ham muhokama qiladi. Taklif etilgan mantiqda qoidalarga mos va haqqoniy bayon qilgan operator uchun tartibga soluvchi/jazolovchi javobgarlik nuqtai nazaridan oldindan bashorat qilinadigan safe-harbor yondashuvi koʻrib chiqilishi mumkin. Aksincha, notoʻgʻri bayonot aniqlansa jiddiy sanksiya qoʻllash nazarda tutiladi.
Maqola zarar koʻrgan tomonning kompensatsiyasini operatorning jinoiy/tartibga soluvchi javobgarligidan ajratadi. Operator halol bayon sabab tartibga soluvchi himoya olsa ham, real zarar yuzaga kelgan boʻlsa, jabrlanuvchining kompensatsiya olish huquqi yoʻqolmaydi. Shu maqsadda operator badallari hisobidan moliyalashtiriladigan kompensatsiya jamgʻarmasi kabi institutsional modellar muhokama qilinadi.
Bular amalda boʻlgan universal huquqiy qoidalar sifatida taqdim etilmaydi. Muallif exact safe-harbor koʻlami, jamgʻarma tuzilmasi va aybsiz xatoning qanday baholanishi kabi huquqiy tafsilotlarni kelajakdagi dizayn ishlariga ochiq qoldiradi.
Tadqiqot qoʻllab-quvvatlaydigan asosiy konseptual natijalar
- AI’ga nisbatan ijtimoiy ishonch faqat texnik sifat yoki etik deklaratsiya bilan tushuntirib boʻlmaydigan institutsional oʻlchovga ega.
- Natijalarni boshqarish AI tizimlari jamiyat bilan bevosita toʻqnashadigan yakuniy qatlamni alohida koʻrib chiqishi kerak.
- Natija nomzodining maqsad va mazmun legitimligi strukturaviy metadata bilan ifodalanishi mumkin.
- Bu ifoda audit qilinadigan legitimlik byudjeti bilan qoʻllab-quvvatlanishi kerak.
- Deterministik qayta hisoblash hisoblash xatosini aniqlashni kuchaytirishi mumkin.
- Faktik xato tashqi vakolatli qaydlar bilan oʻzaro tekshiruvni talab qiladi.
- Qayd, spot audit va sanksiya tuzilmasi notoʻgʻri deklaratsiya ragʻbatlarini oʻzgartirishi mumkin.
Tadqiqot qoʻllab-quvvatlamaydigan yoki hali koʻrsatmagan daʼvolar
- VRAIO real dunyoda keng miqyosda ishlashi eksperimental ravishda koʻrsatilmagan.
- GLO xalqaro miqyosda qabul qilingan amaldagi standart emas; u maqola taklif qilayotgan umumiy til yondashuvidir.
- \(L\) uchun universal va ilmiy jihatdan tasdiqlangan yagona birlashtirish qoidasi taqdim etilmaydi.
- Rule-Judgment AI’ning ishlab chiqarish muhitidagi xavfsizligi, xarajati va samaradorligi eksperimental ravishda tasdiqlanmagan.
- Agreement gate toʻgʻrilik yoki haqiqat kafolati emas.
- Bir xil tarafkashlikni baham koʻradigan prover va verifier birgalikda xato qilishi mumkin.
- Tashqi manbadan tekshiriladigan fakt mavjud boʻlmagan subyektiv sohalarda faktik xatoni aniqlash qiyinroq.
- Xalqaro oʻzaro ishlash imkoniyati hal etilmagan.
- Audit organlari mustaqilligini qanday kafolatlash ochiq amaliy muammodir.
- Safe-harbor, kompensatsiya jamgʻarmasi va aybsiz xato jarayonlarining batafsil huquqiy dizayni yakunlanmagan.
Tadqiqotning ilmiy va institutsional maʼnosi
Maqolaning markaziy hissasi “AI’ning oʻziga ishonaylik” fikridan “AI natijalarini boshqarish jarayonini keyinchalik sinab koʻrishga imkon beradigan infratuzilma quraylik” fikriga oʻtishni taklif qilishidir. Bu yondashuvda ishonch boshlangʻich faraz emas, balki tekshiriladigan ishonchlilikning vaqt oʻtishi bilan ijtimoiy qabul hosil qilishi mumkin boʻlgan natija sifatida qaraladi.
Biroq bu doiraning qoʻllanishi koʻp jihatdan Rules kim tomonidan va qanday jarayonlar orqali belgilanishiga, Rule-Judgment AI haqiqatan deterministik va mustaqil saqlana olishiga, tashqi birlamchi qaydlarning toʻgʻriligiga, audit tashkilotlarining mustaqilligiga va xalqaro tizimlar oʻrtasida umumiy standartlar oʻrnatilishiga bogʻliq.
Manba va Usul Haqida Izoh
Asl sarlavha: No Trust Without Trust Infrastructure: The Extended Kelvin Principle and Its Application to AI Output Governance
Muallif: Yusaku Fujii
Tashkilot: School of Science and Technology, Gunma University, Kiryu 376-8515, Japan.
Jurnal: AI, 2026, 7(6), 218.
DOI: 10.3390/ai7060218
Nashriyot: MDPI.
Nashr sanasi: 14 iyun 2026.
Manba turi: Taqrizdan oʻtgan tadqiqot maqolasi; konseptual va institutsional AI boshqaruvi doirasi.
Litsenziya: Creative Commons Attribution (CC BY).
Moliyalashtirish: Japan Society for the Promotion of Science, Grants-in-Aid for Scientific Research (JSPS KAKENHI), Grant No. 25K00735.
Etika qoʻmitasi: Qoʻllanilmaydi deb bildirilgan.
Axborotli rozilik: Qoʻllanilmaydi deb bildirilgan.
Maʼlumotlar mavjudligi: Tadqiqotning original hissalari maqolaning oʻzida mavjudligi, qoʻshimcha maʼlumot uchun muallif bilan bogʻlanish mumkinligi bildirilgan.
Manfaatlar toʻqnashuvi: Muallif manfaatlar toʻqnashuvi yoʻqligini bildirgan.
Asosiy metodologik cheklov: Tadqiqot VRAIO/GLO’ning empirik miqyos sinovini amalga oshirmaydi. \(L\)ning umumiy birlashtirish usulini shakllantirish, deterministik tekshiruvchining real qoʻllanilishi va baholanishi, safe-harbor va kompensatsiya mexanizmlarining huquqiy dizayni, demokratik Rules ishlab chiqish, xalqaro oʻzaro ishlash imkoniyati va audit organlarining mustaqilligi keyingi tadqiqot va institutsional dizayn ishlariga qoldirilgan.
Rasmlardan foydalanish: Manbadagi 1-rasm va 2-rasm toʻgʻridan-toʻgʻri koʻchirilmasligi kerak. Verianla uchun Kengaytirilgan Kelvin zanjiri va VRAIO arxitekturasi ayni ilmiy munosabatlarni saqlagan, biroq kompozitsiyasi, ikonografiyasi va vizual tili mustaqil boʻlgan ikkita yangi texnik sxema sifatida tayyorlanishi mumkin.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan