

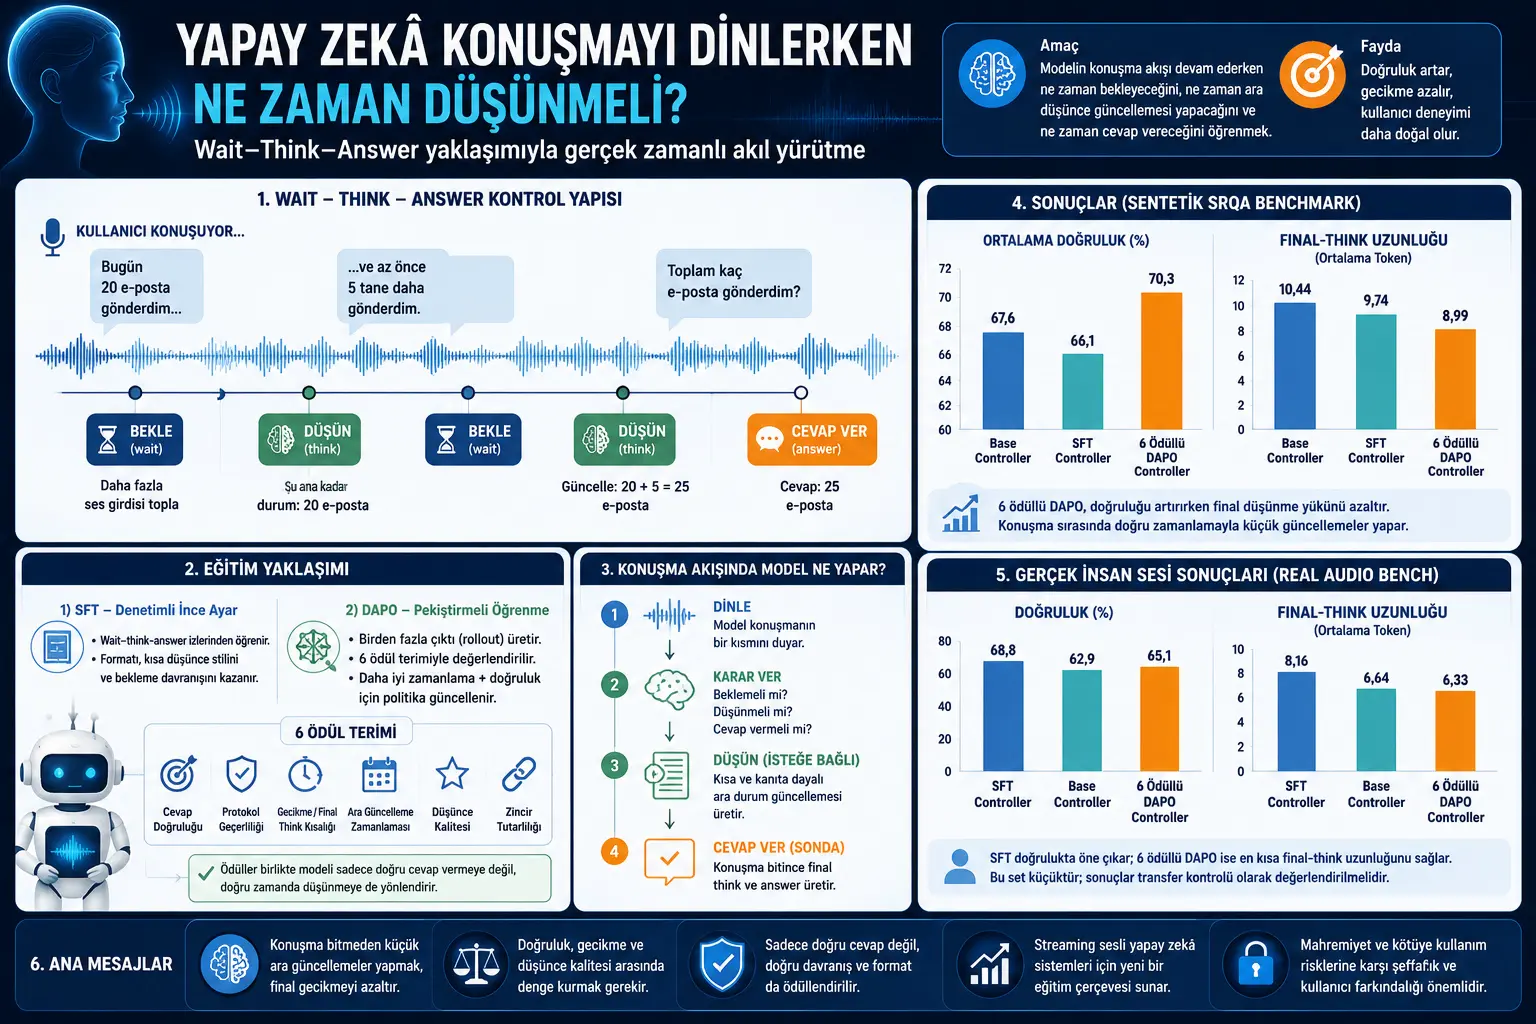
Zamonaviy yirik audio-til modellari nutqni qabul qilib, matn yoki ovozli javob ishlab chiqara oladi. Biroq real vaqtli suhbatda faqat to‘g‘ri javob berish yetarli emas. Model juda kech javob bersa, foydalanuvchi uzoq sukutga duch keladi. Juda erta javob bersa, gap oxirida keladigan muhim ma’lumotni o‘tkazib yuborishi mumkin.
Ushbu tadqiqot bu muvozanatni wait-think-answer deb ataladigan boshqaruv tuzilmasi orqali ko‘rib chiqadi. Modelning uchta asosiy harakati bor: kutish, oraliq fikr/yangilanish ishlab chiqish va javob berish. Kutish harakati ko‘proq audio kirishini yig‘ishga imkon beradi. Think harakati shu paytgacha eshitilgan ma’lumotga tayangan qisqa oraliq holat yangilanishini ishlab chiqadi. Answer harakati esa yakuniy javobni beradi.
Taklif etilgan yondashuv Qwen2.5-Omni-7B asosidagi audio-til modelida sinovdan o‘tkaziladi. Avval supervised fine-tuning, ya’ni SFT orqali model ushbu harakat tilini o‘rganadi. Keyin DAPO deb ataladigan reinforcement learning asosidagi policy optimization bilan model faqat to‘g‘ri javob berishi uchun emas; to‘g‘ri vaqtda fikrlashi, keraksiz uzoq fikrlamasligi, formatni buzmasligi va javob bilan oraliq fikrlar o‘rtasida izchillik o‘rnatishi uchun ham mukofotlanadi.
Natijalar streaming suhbat modellarida “fikrlashni oxiriga qoldirish” o‘rniga, suhbat davomida kichik va mazmunli oraliq yangilanishlar qilish javob aniqligi bilan kechikish o‘rtasidagi muvozanatni yaxshilashi mumkinligini ko‘rsatadi.
Muammo nimada?
Klassik ovozli savol-javob tizimlarida model odatda foydalanuvchi nutqini to‘liq tinglaydi, keyin fikrlaydi va javob beradi. Bu usul baholash uchun qulay, chunki model butun kirishni ko‘rgach bitta javob ishlab chiqadi. Biroq real vaqtli assistent tajribasida bu tabiiy emas.
Jonli suhbatda foydalanuvchi gapini bo‘lakma-bo‘lak quradi. Ba’zan muhim ma’lumot boshida keladi, ba’zan esa oxirgi daqiqadagi ibora javobni o‘zgartiradi. Masalan, foydalanuvchi “Bugun 20 ta e-mail yubordim...” degandan keyin model erta javob bersa 20 deyishi mumkin; ammo foydalanuvchi “...va hozirgina yana 5 ta yubordim” deb davom etsa, to‘g‘ri javob 25 bo‘ladi.
Bu holatda ovozli sun’iy intellekt uchun uch tomonlama ziddiyat yuzaga keladi:
1. Aniqlik: Model yetarli dalil kelmasdan javob bersa xato qilishi mumkin.
2. Kechikish: Model butun nutq tugagandan keyin uzoq vaqt fikrlasa, foydalanuvchi kutadi.
3. Oraliq reasoning sifati: Model suhbat paytida oraliq yangilanish qilsa, bu yangilanishlar qisqa, to‘g‘ri, dalilga bog‘langan va keyingi javobni qo‘llab-quvvatlaydigan bo‘lishi kerak.
Maqolaning asosiy savoli shuki: yirik audio-til modeli suhbat oqimi davom etar ekan, qachon kutishni, qachon qisqa oraliq yangilanish qilishni va qachon yakuniy javob berishni o‘rgana oladimi?
Usul nimani taklif qiladi?
Tadqiqot streaming suhbat reasoningini online boshqaruv muammosi sifatida ta’riflaydi. Model audio oqimi davomida muayyan qaror nuqtalarida shu paytgacha eshitgan audio prefiksini va oldin ishlab chiqargan oraliq holat yangilanishlarini ko‘radi. Keyin uch harakatdan birini tanlaydi:
<wait/>: Model javob yoki fikr ishlab chiqarmaydi, ko‘proq audio kirishini kutadi.
<think>...</think>: Model shu paytgacha eshitilgan dalilga tayangan qisqa oraliq holat yangilanishini ishlab chiqadi. Bu modelning ichki hisob-kitoblarini to‘liq oshkor qilish degani emas; tizimning ko‘rinadigan, qisqa va vazifaga yo‘naltirilgan holat qaydini ishlab chiqishidir.
<answer>...</answer>: Model yakuniy javobni beradi. Ushbu tadqiqotda javob berish harakati nutq tugaganidan keyingi bosqichga cheklangan; ya’ni tajribalarda model nutq tugamasdan final javob berishni o‘rganmaydi, asosiy e’tibor suhbat davomida kutish va oraliq yangilanish vaqtini boshqarishdir.
Usul ikki bosqichli o‘qitishdan foydalanadi:
1. SFT, ya’ni supervised fine-tuning: Model tayyorlangan wait-think-answer izlari orqali harakat formatini, qisqa fikrlash uslubini, kutish xatti-harakatini va final javob tuzilmasini o‘rganadi.
2. DAPO policy optimization: Keyin model mukofot funksiyasi bilan optimallashtiriladi. Mukofot faqat final javobning to‘g‘riligiga qaramaydi. Formatning haqiqiyligi, javob kechikishi, oraliq yangilanish vaqti, fikrlash sifati va zanjir izchilligi ham birgalikda baholanadi.
Bu yondashuvning maqsadi modelning barcha reasoningni suhbat tugagandan keyingi bosqichga yig‘ib qo‘yishiga yo‘l qo‘ymaslikdir. Agar model muhim ma’lumotlar kelishi bilan qisqa oraliq yangilanishlar qilsa, final javobdan oldin qoladigan fikrlash yukini kamaytirish mumkin.
Formulalar nimani anglatadi?
PDF’dagi formulalar wait-think-answer boshqaruv tuzilmasi, mukofot funksiyasi va DAPO optimallashtirishini tushuntiradi. Quyidagi formulalar MathJax bilan mos shaklda berilgan.
1. Controller kuzatuvi va harakat tanlovi
\[ o_k=(x_{1:t_k},z_{
Bu yerda \(o_k\), \(k\)-qaror paytidagi controller kuzatuvidir. \(x_{1:t_k}\), shu paytgacha eshitilgan audio prefiksini; \(z_{
2. Haqiqiy trajectory uchun shakllantirilgan mukofot
Ushbu formula haqiqiy wait-think-answer oqimi uchun jami mukofotni ko‘rsatadi. \(R_a\) javob aniqligini, \(R_f\) format haqiqiyligini, \(R_s\) kechikish/final-think qisqaligini, \(R_u\) oraliq yangilanish vaqtini, \(R_t\) fikrlash sifatini, \(R_c\) esa fikrlash zanjiri bilan final javob o‘rtasidagi izchillikni ifodalaydi.
Muhim jihat shuki: izchillik bonusi faqat javob to‘g‘ri bo‘lsa ishga tushadi. Ya’ni model noto‘g‘ri javobga izchil, lekin xato tushuntirish bergani uchun qo‘shimcha mukofot olmaydi.
3. Protokol bilan darvozalangan final mukofot
Ushbu formula format/protokol haqiqiyligi ustuvor ekanini ko‘rsatadi. Agar model noto‘g‘ri tartibda javob bersa, kerakli teglarni buzsa yoki yaroqsiz harakatlar ketma-ketligini ishlab chiqarsa, final javobning to‘g‘ri bo‘lishi uni qutqarmaydi. Avval o‘zaro ta’sir protokoli to‘g‘ri bo‘lishi kerak.
4. Ishlatilgan mukofot og‘irliklari
Bu og‘irliklar mukofot komponentlarining nisbiy ahamiyatini belgilaydi. Ayniqsa \(\lambda_u=3.0\), oraliq yangilanish vaqtiga katta og‘irlik berilganini ko‘rsatadi. Demak, modelning faqat fikr ishlab chiqishi emas, uni to‘g‘ri paytda ishlab chiqishi muhim.
5. DAPO guruhga nisbatan advantage hisobi
Ushbu formula bir xil prompt uchun ishlab chiqarilgan \(G\) rollout orasida \(i\)-rolloutning nisbiy advantage qiymatini hisoblaydi. Agar chiqish guruh o‘rtachasidan yuqori mukofot olsa, musbat advantage oladi; yomonroq bo‘lsa manfiy advantage oladi. Bu modelga qaysi harakat ketma-ketliklari yaxshiroq ekanini guruh ichida o‘rganishga yordam beradi.
6. Token darajasidagi DAPO maqsadi
Ushbu formula DAPO’ning token darajasidagi clipped policy update jarayonini ko‘rsatadi. \(M\) completion tokenlari maskasi. \(r_{i,t}\) yangi policy bilan eski policy o‘rtasidagi ehtimollik nisbatidir. Musbat advantage’ga ega tokenlar kuchaytiriladi; manfiy advantage’ga ega tokenlar susaytiriladi. Clipping yangilanishning haddan tashqari katta bo‘lishini cheklaydi.
7. Policy nisbati
Bu ifoda yangi policy’ning ma’lum tokenni ishlab chiqarish ehtimoli eski policy’ga nisbatan qanchalik o‘zgarganini ko‘rsatadi. Katta o‘zgarishlar clipping mexanizmi bilan cheklanadi. Bu RL o‘qitishini barqarorroq qiladi.
Grafik, jadval va sxemaning asosiy xabari
3-sahifadagi Figure 1: Sxema model suhbatni bo‘lakma-bo‘lak tinglashini va har bir qaror qadamida yoki kutishini, yoki qisqa oraliq fikr yangilanishini qilishini, yoki eng oxirida javob berishini ko‘rsatadi. “20 ta e-mail yubordim, yana 5 ta yubordim” misolida model avval “hozirgacha 20” degan oraliq holatni saqlashi, keyin “20 + 5 = 25” yangilanishi bilan final javobga tayyorlanishi tushuntiriladi. Asosiy xabar: model barcha fikrlashni suhbatdan keyinga qoldirish o‘rniga, suhbat davomida kichik va to‘g‘ri holat yangilanishlarini to‘plashi mumkin.
5-sahifadagi Table 1: Mukofot atamalari oltita sarlavhada jamlanadi: javob aniqligi, protokol haqiqiyligi, kechikish, oraliq yangilanish vaqti, fikrlash sifati va zanjir izchilligi. Jadval tadqiqot faqat “to‘g‘ri javob ber” mukofoti bilan cheklanmasligini; suhbat davomida to‘g‘ri xatti-harakat shaklini ham o‘rgatishini ko‘rsatadi.
6-sahifadagi Figure 2: Mukofot tizimi wait-think-answer oqimini qanday baholashi ko‘rsatiladi. Qoidaga asoslangan atamalar format, vaqt, aniqlik va final kechikishni nazorat qiladi; judge yordamidagi atamalar esa oraliq fikr sifati va final javobni qo‘llab-quvvatlovchi izchillikni baholaydi. Asosiy xabar: yaxshi model faqat to‘g‘ri final javob beradigan emas; to‘g‘ri vaqtda qisqa va foydali oraliq yangilanishlar qiladigan modeldir.
8-sahifadagi Table 2: Sintetik suhbatli SRQA natijalarida olti mukofotli DAPO controller Qwen streaming controller oilasida eng yaxshi o‘rtacha aniqlikni beradi. Base controller o‘rtacha %67,6 aniqlik va 10,44 final-think token uzunligini ko‘rsatsa, olti mukofotli DAPO %70,3 aniqlik va 8,99 final-think uzunligini beradi. Bu jadval model ham aniqlik, ham residual reasoning yuki bo‘yicha yaxshilanganini ko‘rsatadi.
8-sahifadagi Figure 3: Base controller bilan olti mukofotli DAPO’ning vazifa bo‘yicha aniqliklari solishtiriladi. DAPO ayniqsa ARC-E, SIQA, PIQA va GSM8K kabi vazifalarda yaxshilanish ko‘rsatadi. GSM8K alohida panelda beriladi, chunki umumiy aniqlik darajasi boshqa vazifalarga qaraganda pastroq qoladi.
9-sahifadagi Table 3: Real Audio Bench natijalari inson yozuvlaridan tuzilgan 186 namuna bo‘yicha beriladi. SFT controller %68,8 aniqlik bilan eng yuqori natijani bersa, olti mukofotli DAPO %65,1 aniqlik va 6,33 final-think uzunligi bilan base controller’dan qisqaroq final fikrlashni ishlab chiqargan yagona o‘rgatilgan variant sifatida ajralib turadi. Asosiy xabar: haqiqiy inson ovozi testida natijalar murakkabroq; aniqlik va past kechikish har doim bir xil variantda birlashmaydi.
14-sahifadagi Figure 4: SFT o‘qitish egri chiziqlari trening va validatsiya yo‘qotishining kamayganini, token aniqligining oshganini ko‘rsatadi. Bu SFT bosqichi DAPO uchun mustahkam boshlang‘ich policy yaratganini qo‘llab-quvvatlaydi.
18-sahifadagi ablation jadvali: Mukofot komponentlari ko‘paygani sari sintetik SRQA aniqligi oshadi. Base controller %67,6, SFT %66,1, to‘rt mukofotli DAPO %68,5, besh mukofotli DAPO %69,2, olti mukofotli DAPO %70,3 deb xabar qilingan. Bu jadval mukofot komponentlarining bosqichma-bosqich hissasini ko‘rsatadi.
Tajribalar qanday o‘tkazilgan?
Tadqiqotda ikkita asosiy baholash muhiti ishlatiladi.
1. Sintetik suhbatli SRQA benchmark: ARC-Easy, ARC-Challenge, PIQA, SocialIQA, GSM8K va LLaMA-QS dan iborat oltita vazifa oilasi ishlatiladi. Jami 8.959 namuna mavjud. Matn savollari suhbat shakliga aylantiriladi, TTS bilan audioga o‘giriladi va model shu audio kirishlari orqali baholanadi.
2. Real Audio Bench: Insonlar yozib olgan haqiqiy audiolardan tashkil topgan kichik transfer benchmark ishlatiladi. Besh nafar so‘zlovchi 200 nomzod namuna yozadi; noaniq yoki xato namunalar chiqarilgach 186 yozuv qoladi. Bu to‘plam katta ko‘lamli foydalanuvchi tadqiqoti emas, TTS’dan tashqariga transfer nazorati sifatida baholanadi.
Model oilasi sifatida Qwen2.5-Omni-7B ishlatiladi. SFT bosqichida LoRA bilan fine-tuning qilinadi. DAPO bosqichida esa streaming controller rolloutlari ishlab chiqariladi, bu chiqishlar oltita mukofot komponenti bilan baholanadi va policy token darajasida yangilanadi.
Baholashda ikkita protokol mavjud:
Offline mode: Model butun nutqni tinglagach bir marta fikrlaydi va javob beradi. Bu klassik full-audio baholash shaklidir.
Deployment mode: Audio 0,5 soniyalik qaror gridida keladi. Model har qadamda mavjud audio prefiksini va oldingi ko‘rinadigan fikr holatlarini ko‘radi. Nutq tugamasdan kutish yoki oraliq fikr ishlab chiqish harakatlaridan birini tanlaydi. Nutq oxirida final think va answer ishlab chiqadi.
Solishtirilgan modellar qatoriga Qwen2.5-Omni-7B base controller, SFT controller, to‘rt/besh/olti mukofotli DAPO controller, Audio Flamingo 3, GLM-4-Voice-9B va adabiyotda keltirilgan Moshi variantlari kiradi. Biroq uchinchi tomon modellari bir xil streaming controller interfeysini ochmagani uchun to‘g‘ridan-to‘g‘ri deployment mode solishtiruvi faqat Qwen oilasi ichida amalga oshiriladi.
Natijalar nimani ko‘rsatadi?
1. Streaming ovozli reasoning boshqaruv muammosi sifatida o‘qitilishi mumkin. Model faqat final javob ishlab chiqishni emas, suhbat oqimi davomida qachon kutishni va qachon qisqa oraliq holat yangilanishi qilishni ham o‘rgana oladi.
2. Olti mukofotli DAPO sintetik benchmark’da eng yaxshi muvozanatni beradi. Base controller %67,6 o‘rtacha aniqlikda qolsa, olti mukofotli DAPO %70,3 ga chiqadi. Shu bilan birga final-think uzunligi 10,44 dan 8,99 token’ga tushadi. Bu fikrlashning bir qismi suhbat davomida ertaroq va qisqa shaklda bajarilishi mumkinligini ko‘rsatadi.
3. SFT yakka o‘zi formatni o‘rgatsa-da, vazifa mukofotidek yetarli emas. SFT controller wait-think-answer tilini o‘rganadi; ammo sintetik o‘rtacha aniqlikda base controller’dan ortda qoladi. DAPO bosqichi vazifaga mos mukofot berib, samaradorlikni yana yuqoriga olib chiqadi.
4. Haqiqiy inson ovozidagi natijalar ehtiyotkorroq talqin qilinishi kerak. Real Audio Bench kichik dataset. SFT eng yuqori aniqlikni beradi, olti mukofotli DAPO esa eng qisqa final-think uzunligini ta’minlaydi. Ishonch intervallari ustma-ust tushgani sabab bu to‘plam qat’iy model reytingidan ko‘ra transfer nazorati sifatida o‘qilishi kerak.
5. Kechikish faqat tizim tezligi emas. Maqola final-think uzunligini foydalanuvchi nutqi tugagandan keyin qoladigan reasoning yukining ko‘rsatkichi sifatida ishlatadi. Ya’ni bu yerda kechikish faqat apparat yoki servis vaqti emas, balki model fikrlashning qanchasini oxiriga qoldirishi bilan ham bog‘liq.
6. Cache-native ishlab chiqarish hanuz kelajakdagi ish yo‘nalishidir. Maqola rasmiy Qwen serving yo‘li ushbu boshqaruv sikli uchun to‘g‘ridan-to‘g‘ri cache-native interfeys bermasligini; shu sababli benchmark’da full-prefix replay ishlatilganini ta’kidlaydi. Alohida prototip ayni axborot oqimi cache-native usulda amalga oshirilishi mumkinligini ko‘rsatsa-da, production darajasida optimallashtirilgan suhbat tizimi da’vo qilinmaydi.
Bu nima uchun muhim?
Ovozli sun’iy intellekt assistentlari tobora real vaqtli bo‘lib bormoqda. Foydalanuvchilar endi faqat matn oynasiga savol yozmaydi; ular gapiradi, tuzatadi, yarim gap bilan boshlaydi va oxirgi daqiqada muhim ma’lumot qo‘shadi. Bunday muhitda model nafaqat yaxshi javob ishlab chiqishi, balki suhbat oqimini ham yaxshi boshqarishi kerak.
Ushbu tadqiqot ovozli assistentlarda “fikrlash vaqti” muammosini ko‘rinadigan qiladi. Model suhbat tugaguncha hech narsa qilmasa, keyin uzoq fikrlashi mumkin. Suhbat davom etayotganda qisqa, dalilga tayangan oraliq yangilanishlar qilsa, final kechikish kamayishi mumkin. Biroq bu yangilanishlar keraksiz, uzoq yoki xato bo‘lmasligi kerak.
Bu g‘oya jonli ta’lim assistentlari, accessibility vositalari, real vaqtli tarjima, yig‘ilish assistentlari, call-center yordam tizimlari va ovozli foydalanuvchi interfeyslari uchun muhim. Ayniqsa nogironligi bo‘lgan foydalanuvchilar, real vaqt subtitr yoki nutqni qo‘llab-quvvatlash tizimlaridan foydalanadigan shaxslar uchun kechikish yanada katta foydalanuvchi tajribasi muammosini yaratishi mumkin.
Shuningdek, bu xavfsizlik va etika nuqtayi nazaridan ham muhim. Suhbat paytida fikrlay oladigan tizimlar foydalanuvchi sezmasdan tinglaydigan va nutqni oldindan tahlil qiladigan vositalarga aylansa, maxfiylik va manipulyatsiya riski yuzaga kelishi mumkin. Maqola shu sabab harakat makonini kutish/fikrlash/javob bilan cheklaydi va keraksiz fikr ishlab chiqarishni jazolaydi.
E’tibor beriladigan jihatlar
1. Tadqiqot preprint. Natijalar yakuniy hakamlikdan o‘tgan versiya aniqligi bilan baholanmasligi kerak.
2. Bu to‘liq optimallashtirilgan production tizimi emas. Maqola cache-native serving o‘rniga full-prefix replay asosidagi benchmark’dan foydalanadi. Shu sabab real mahsulot samaradorligi uchun qo‘shimcha muhandislik zarur.
3. Real Audio Bench kichik. 186 yozuv aksent, atrof-muhit shovqini, nutq uslubi va foydalanuvchi xilma-xilligini to‘liq ifodalash uchun yetarli emas.
4. Oraliq fikrning ko‘rinishi ehtiyotkorlik bilan loyihalanishi kerak. Modelning ko‘rinadigan oraliq yangilanish ishlab chiqishi foydalanuvchiga tushuntiriluvchanlik berishi mumkin; ammo keraksiz yoki noto‘g‘ri oraliq izohlar foydalanuvchini chalg‘itishi mumkin.
5. Final javob nutq tugaganidan keyinga cheklangan. Ushbu tadqiqotda modelning nutq tugamasdan yakuniy javob berishi asosiy o‘rganish maqsadi emas. Asosiy e’tibor suhbat davomida oraliq fikr yangilanishlarining vaqtiga qaratilgan.
6. Inson nutqi juda xilma-xil. Pauzalar, aksentlar, tez gapirish, shovqin, mavzu almashtirish va yarim gaplar real foydalanishda model xatti-harakatini qiyinlashtirishi mumkin.
7. Maxfiylik va noto‘g‘ri foydalanish riski mavjud. Qisman nutqni tahlil qiladigan tizimlar foydalanuvchi xabardorligi va ruxsat mexanizmlarisiz ishlatilmasligi kerak. Real vaqtli suhbat tahlilida ochiq xabardor qilish va xavfsizlik chegaralari muhim.
Xavfli soha eslatmasi: Tadqiqot nutqni real vaqtda tinglaydigan va qisman audio kirish asosida oraliq reasoning yangilanishlari qiladigan sun’iy intellekt tizimlari bilan bog‘liq. Bunday tizimlar accessibility, jonli tarjima, ta’lim va ovozli assistentlar uchun foydali bo‘lishi mumkin; biroq foydalanuvchi xabardorligisiz nutqni kuzatish, social engineering yoki maxfiylik buzilishi kabi risklarni ham tug‘dirishi mumkin. Ushbu yozuv texnik axborot berish maqsadida.
Umumiy baholash: Maqola ovozli sun’iy intellekt assistentlarining muhim muammosiga e’tibor qaratadi: foydalanuvchi gapirayotganida model kutishi kerakmi, oraliq ma’lumot yangilanishi qilishi kerakmi yoki darhol javob berishi kerakmi? Inson suhbatida tinglovchi ko‘pincha gap tugamasidan javobga tayyorlana boshlaydi. Ushbu tadqiqot shunga o‘xshash g‘oyani yirik audio-til modellariga olib kirib, “tinglayotganda qachon fikrlash kerak?” savolini o‘rganiladigan boshqaruv muammosi sifatida ko‘rib chiqadi.
Xulosa
Ushbu maqola yirik audio-til modellari uchun muhim savolni ko‘rib chiqadi: model nutqni tinglayotganda qachon fikrlashi kerak? Klassik yondashuvda model butun audioni kutadi, keyin fikrlaydi va javob beradi. Ammo real vaqtli suhbatda bu yondashuv kechikish yaratishi mumkin. Erta javob esa xatoga olib kelishi mumkin.
Wait-think-answer boshqaruvi bu muvozanatga amaliy doira beradi. Model suhbat davomida kutish va qisqa oraliq holat yangilanishi o‘rtasida tanlov qiladi. Muhim ma’lumotlar kelishi bilan kichik va vazifaga yo‘naltirilgan fikr yangilanishlarini to‘playdi. Shu tariqa final javob bosqichida qoladigan fikrlash yuki kamayishi mumkin.
Natijalar olti mukofotli DAPO controller sintetik suhbat benchmark’ida ham aniqlikni oshirganini, ham final-think uzunligini kamaytirganini ko‘rsatadi. Haqiqiy inson ovozi testida esa natijalar ehtiyotkorroq: o‘rgatilgan controllerlar ishlaydi, ammo aniqlik va qisqa final fikrlash har doim bir xil variantda birlashmaydi.
Verianla o‘quvchisi uchun asosiy xabar shuki: kelajakdagi ovozli sun’iy intellekt assistentlari faqat “nima javob berishni” emas, balki “suhbat oqayotganda qachon kutishni, qachon qisqa yangilanish qilishni va qachon javob berishni” ham o‘rganishga majbur bo‘ladi. Ushbu tadqiqot bu vaqt muammosini o‘lchanadigan va o‘rgatiladigan boshqaruv vazifasiga aylantiradi.
Manba va usul bo‘yicha izoh
Ushbu yozuv “Learning When to Think While Listening in Large Audio-Language Models” nomli akademik PDF asosida tayyorlangan original o‘zbekcha tahririy kontentdir. Matn so‘zma-so‘z tarjima emas; tadqiqotdagi muammo, usul, formulalar, vizuallar, jadvallar, tajriba protokoli, natijalar va cheklovlar soddalashtirib bayon qilingan.
Yozuvda “fikrlash” iborasi modelning foydalanuvchiga ko‘rinadigan qisqa holat yangilanishini ishlab chiqishini anglatadi; u real dunyodagi inson fikrlashi bilan aynan bir xil ma’noda baholanmasligi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan